Моему аккаунту Claude было почти три года. Я попал в первую волну пользователей в 2023 году, когда он только вышел. Помню свои первые запросы: лимиты ещё не казались такими шакальными, а интерфейс был непривычным. Это сейчас у каждой ИИшки своя палитра, от белого до фиолетового, а тогда это было что-то новенькое.
Ну ладно. Тестировать Claude было вдвойне интересно, потому что тогда, если я не ошибаюсь, никакого китайского «убийцы ChatGPT» не было даже в помине. Речь, конечно же, про DeepSeek.
Поскольку я разработчик (по крайней мере, тогда ещё можно было себя так называть), тестировал я его именно на коде. Тем более в Запрещённых Интернетах его хвалили как раз за кодинг.
Оптимизм у меня был аккуратный. Мне как раз нужно было сделать для клиента парсинг одного малоизвестного маркетплейса запчастей. И справился он, надо сказать, уже тогда достойно.
Интересно наблюдать, как генеративные модели с каждым релизом прыгают выше головы. Тогда мне это казалось пиком прогресса, и мне, честно говоря, этого уже хватало. Сейчас я прогресса немного побаиваюсь, и, думаю, это здоровое чувство.
Да, меня забанили. Попал в очередную волну банов, уже не сосчитать какую. Кстати, пока я писал эту статью, массовые баны (тоже не знаю, какие по счёту) пошли и у Чата ЖэПэТэ, так что статья ещё долго будет актуальной.
Все рекомендации, которые считал полезными, я соблюдал. Возраст аккаунта тоже успокаивал: не вчера же зарегистрировался. Как оказалось, успокаивал он в основном меня :)
И я пошёл на рынок ИИ-моделей искать альтернативу Claude Code. Когда-то я пришёл к Claude без всякой необходимости, а теперь он сам выгоняет меня из своего уголка. Что ж, давайте посмотрим, что из этого вышло.
Дальше были полторы недели качелей: от дофамина «всё, нашёл замену!» до желания закрыть ноутбук. Я прошёл Grok, Kimi, связку MiniMax с Kimi и GLM-5.3. Всё на платных подписках и на реальной задаче.
Задачи минимум:
найти рабочего кодового агента вместо Claude Code, а не просто приятный чат (потом увидите, к чему я клоню);
перенести инструкции, документацию и привычную схему работы с несколькими агентами;
разобраться, за что я вообще плачу: модель, скорость, квоты, пятичасовые окна, удалённый доступ.
Ещё скажу, что деньги на случай бана я откладывал, причём вполне целенаправленно. Я прекрасно понимал, что это произойдёт и потом придётся впопыхах тестировать разные решения. Но не думал, что всё настолько плохо, и немного вылез за бюджет. $956 из заголовка — это примерно столько я отдал, пока пробовал разные подписки и продукты. Описываю самые заметные и важные. В общем, почитайте: тут правда будет много интересного, и вы сэкономите кучу времени на выборе модели. И денег тоже.
Ремарка: это мой личный опыт на рабочих и тестовых задачах. Мои цифры (часы, проценты, «в три раза быстрее») — по ощущениям и по памяти, это не бенчмарк. Чужие жалобы — тоже не статистика, просто живой опыт людей. Цены и документация — на 7 ноября 2026.
Что в статье
Что произошло с Claude и почему блокируют аккаунты
Grok Build
Kimi K3.1 Pro
Kimi. День номер два: связка с MiniMax
GLM-5.3 и ZCode
Безопасный порядок работы: кто его соблюдает
Чем заменить Claude Code: выводы и итоговая таблица
Отдельно — что сейчас делают Anthropic: мониторинг и блокировки, OpenAI: ограничения и мой бан и Google: что посоветовал его поиск.
1. Что вообще произошло с Claude и почему блокируют аккаунты
28–29 октября пошла новая волна жалоб на блокировки, в том числе от россиян, которые живут за границей. Истории у людей похожие: просят подтвердить личность, человек показывает российский паспорт, аккаунт отключают.
Похожие истории пишут и из других стран. Например, пост на Reddit из Новой Зеландии: подписчик Claude Code пишет, что доступ пропал сразу после проверки паспорта.
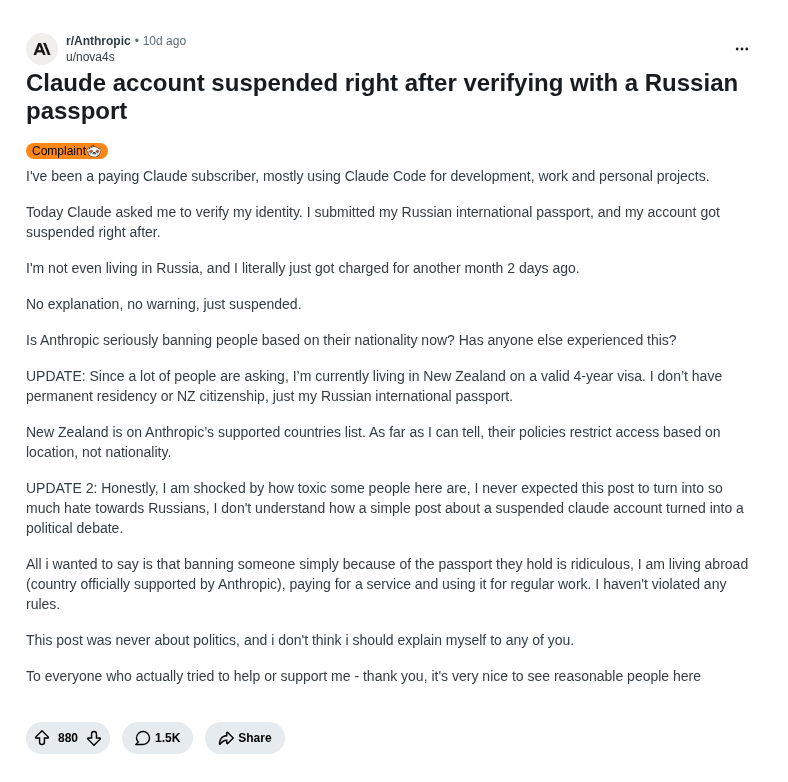
Reddit, r/Anthropic — блокировка после проверки российского паспорта.
Сколько людей отключили и почему сейчас, Anthropic публично не объясняла. Так что «забанили всех русских» — это пока из чатов. Десять перепечаток одной истории ещё не десять пострадавших.
1.1. А если платить $200?
Я платил. У меня было два аккаунта Claude, по $200 каждый, и заморозили оба.
Подписка, как выяснилось, покупает лимиты, а не неприкосновенность.
В ноябрьской истории на Хабре у человека был Max за $100. На vc.ru писали про Max за $200, правда это начало октября, ещё до нынешней волны.
Пользователь Max в X: российский паспорт, мгновенный бан, а оплата прошла днём раньше. В GitHub issue от 29 октября человек 27-го оплатил Max 20x, а 28-го его отключили. Ещё один подписчик Max 20x потерял доступ через 31 минуту после оплаты (правда, ещё 15 октября и с нестандартной настройкой).
На NodeSeek человек пишет, что потерял больше двадцати Pro, два 5x и один 20x. Дорогой тариф, похоже, ни от чего не страхует.
Для масштаба: в официальном отчёте Anthropic за январь–июнь 2026 — 11,4 млн банов по всему миру, 398 тысяч апелляций и 42 тысячи отменённых решений.
Кстати, на нынешнем прайсе прежний Max 20x называется Ultra.
Хорошая новость тоже есть: автор той самой статьи на Хабре восстановил аккаунт через апелляцию примерно за три часа. Так что подавать апелляцию стоит, хотя гарантий никто не даёт.
Формально России в списке стран Claude нет. Но это список про то, где ты находишься, про паспорт там ни слова.
1.2. Баллы доверия аккаунта: что тут правда
На фоне банов по чатам разошлась красивая теория: у Claude якобы есть баллы доверия, за одно плюс, за другое минус, а потом верификация или бан. Раскопали это якобы китайские ребята, у которых дистилляция давно поставлена на поток.
В китайском посте от 28 октября листают файл scoring_engine.py, якобы из anthropic/trust/: веса, пороги проверки и бана, класс AccountTrustProfile. Выглядит солидно. Только откуда файл, никто не показал, а ссылка в посте ведёт на статью того же автора про подписки.
Сам список свёл в одну картинку:
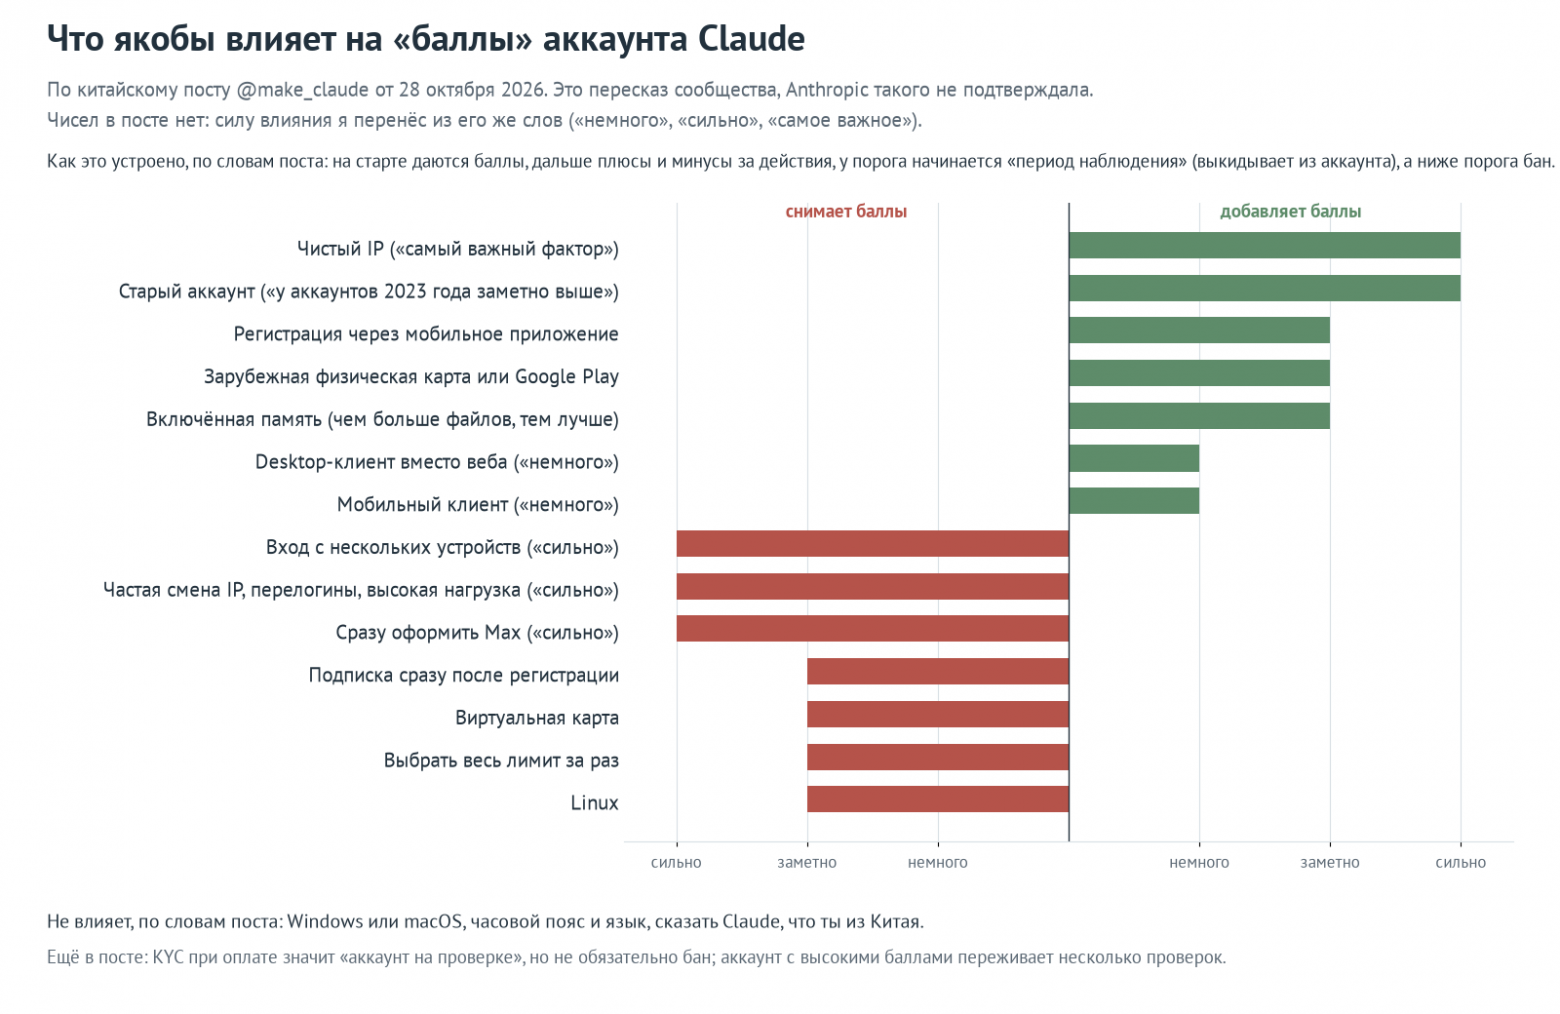
Изображение 1. Факторы из поста @make_claude. Чисел в посте нет, сила влияния — по его же словам.
Текстом: скоринг и бан аккаунта Claude
По посту @make_claude от 28 октября 2026. Anthropic эту схему не подтверждала; численных весов в посте нет.
Добавляют баллы, по словам поста: чистый IP (самый важный фактор), старый аккаунт (особенно 2023 года), регистрация через мобильное приложение, зарубежная физическая карта или Google Play, включённая память. Desktop и мобильный клиент дают небольшой плюс.
Снимают баллы: вход с нескольких устройств, частая смена IP, перелогины, высокая нагрузка, оформление Max сразу (в посте описаны как сильные факторы); подписка сразу после регистрации, виртуальная карта, весь лимит за раз, Linux.
По словам поста, Windows или macOS, часовой пояс, язык и упоминание Китая не влияют. У порога начинается период наблюдения с выходами из аккаунта, ниже порога возможен бан Claude.
KYC при оплате в посте трактуется как проверка аккаунта, которая не обязательно заканчивается баном.
Отдельно улыбнул «огромный запас прочности» у аккаунтов 2023 года. Мой как раз 2023 года :)
На NodeSeek и linux.do спорят про устройства, IP и нагрузку, технический разбор Claude Code описывает телеметрию клиента, а про сервер — только догадки. В аудите июньской сборки нашли ID аккаунта, хеш репозитория и rateLimitTier, но это категория лимитов, а не рейтинг доверия.
А вот самое интересное: численные оценки у Anthropic есть, и компания сама про них написала.
Self-assessment от 16 октября: скрытый запрос после ответа Claude выдаёт JSON с причиной, флагом и приоритетом проверки от 1 до 10. Сам он не блокирует, сильные сигналы уходят людям.
ARiES: риск-скор от 0 до 100, в том числе для аккаунтов (правда, про киберзлоупотребления).
Политика хранения данных прямо называет
trust and safety classification scores, для чатов с нарушениями — до семи лет.
А «Claude сам переключает модель» — это отдельный механизм Opus 5.5: в кибертемах откат на Opus 4.8, в биологии — на Opus 5.
Выходит, оценки существуют, это не теория заговора. А формула из ролика и её связь с российской волной — на совести его авторов.
Плюс дистилляция: в феврале Anthropic обвинила DeepSeek, Moonshot и MiniMax в 16+ млн запросов через ~24 тысячи фейковых аккаунтов, а в октябре ввела защиту, которая задевает и обычных пользователей. Связан ли с этим мой бан, не знаю.
Мой вывод проще: строить работу на уверенности, что разгадал чужой антифрод, нельзя.
1.3. Это у меня уже не первый такой опыт
Примерно за полгода до Claude меня забанил OpenAI. Без всякой проверки паспорта и без объяснения причин.
И я такой не один: в июле подписчик Pro на форуме OpenAI жаловался, что ему без предупреждения отключили и аккаунт, и API.
У нас тогда через API работал пайплайн по оценке текстов. Персональные данные мы вычищали локально и в облако отправляли уже обезличенный текст. Там была обычная запись к врачу, никаких диагнозов и медицинских советов. Но, видимо, слово «врач» кому-то не понравилось — это моя версия, другой у меня нет.
Ещё в ноябре 2025 гуляла история, что ChatGPT больше не даёт медицинских советов (OpenAI это отрицала).
Локальные модели мы и так планировали внедрять, аккуратно и поэтапно. После бана пришлось ускориться.
Как я и писал в начале, теперь это настигло не только меня, но и вас, ребята. Пока я дописывал статью, 8 ноября пошли новые жалобы на блокировки ChatGPT, в том числе платных Pro: тема на форуме OpenAI, сводка на Код.ру, iXBT. Апелляции, пишут, отклоняют чуть ли не за минуту. Причины и масштаб пока неизвестны.
Так что, думаю, я сделал правильный выбор, когда не стал брать в это сравнение Codex, хотя личный опыт с ним у меня есть. А толку? Не удивлюсь, если со временем и Grok начнёт поступать так же. Кто его знает?
Чужая кнопка выключения очень помогает определиться с приоритетами :)
1.4. Почему раньше было проще заплатить Claude
Как бы приторно ни звучало «Claude, только Claude», за этим стоял вполне практический опыт. Финальную подготовку к выкладке на прод я доверял именно ему. Готов был лишний раз заплатить за токены, потому что знал: задача будет доведена до результата, а не до красивого ответа. И эти полторы недели, если честно, меня в этом только убедили.
Схемы ролей при этом у всех свои: один разработчик, например, планирует с Claude, а реализует и ищет баги с помощью Codex.
2. Почему первым оказался Grok
По логике после Claude надо было сразу идти к китайским моделям. Но у меня уже была подписка на Grok.
Я несколько месяцев ленился её отменить. Сидел в Imagine: делал с Grok прототип игрушки-утки, потом через отдельную платформу превратил картинку из 2D в 3D и напечатал на 3D-принтере. Просто поиграться. Так что первым критерием выбора у меня стала подписка, которую я забыл отменить :)
Ещё я помнил громкие демки с играми и космосом и сравнения на Reddit с Claude, Gemini и ChatGPT. Раз подписка есть, почему бы не помучить их кодового агента.
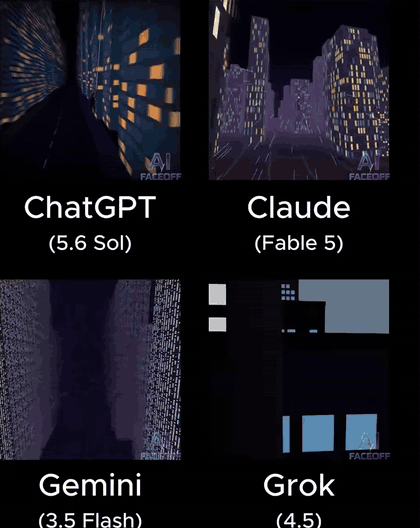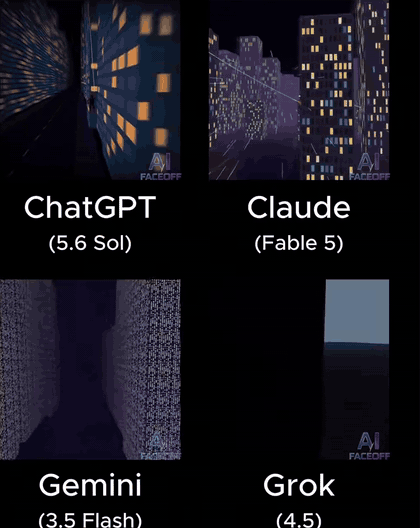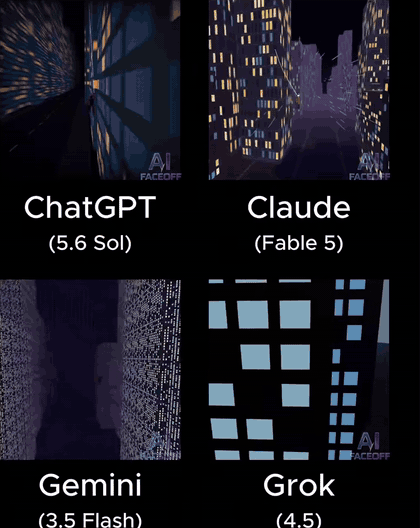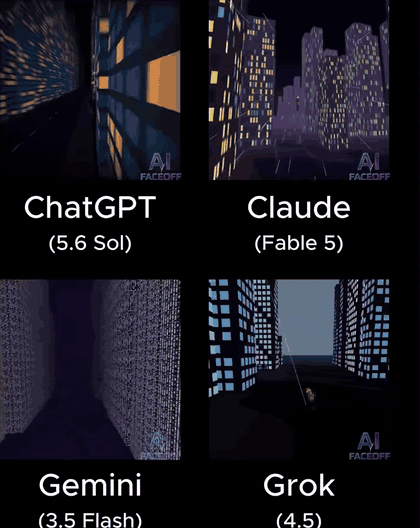
Типичное сравнение из ленты: один промпт «Человек-паук на Three.js» для ChatGPT 5.6 Sol, Claude Fable 5, Gemini 3.5 Flash и Grok 4.5. Рилс ai.faceoff, 10 июля 2026. Instagram принадлежит Meta, которая признана в РФ экстремистской.
Параллельно спросил у AI-поиска Google, какие у меня альтернативы, если Claude и Codex сейчас не вариант (про бан не говорил). Он тоже первым предложил Grok, а дальше китайцев. И меня это, кстати, впечатлило: собственный кодовый агент Google он назвал «пока сырым» и первым не порекомендовал. Сам себя не продвигает, уважаю.
Ремарка: Antigravity CLI у Google существует с мая. О нём ли говорил поиск, не знаю — ответ я не сохранил.
2.1. Grok Build. Всё-таки выяснил название
Grok Build, Grok Code… В первые дни мне было всё равно, как это называется. Мне нужно было работать.
Для порядка: Grok Build — агент (команда grok), Grok 4.7 — модель.
Начал с подписки за $30, а когда взялся за реальный тестовый проект и упёрся в лимит, поднял до $100. По текущему прайсу это Premium и Super.
Сначала порадовала совместимость: Grok подхватывает CLAUDE.md, .claude, инструкции, агентов и MCP.
Думаю: отлично! Не надо заново объяснять ИИшке, что это за проект и как мы тут живём.
Спойлер: объяснять пришлось.
Уже на второй сессии я попросил его переписать всю документацию под себя. Трать токены сколько надо, только пойми проект. Видимо, прочитать файл и работать по нему так же, как Claude, — две разные задачи.
2.2. Как я обычно работаю с агентами
Чтобы было понятно, чего я ждал от Grok, расскажу про свою схему. Один агент на весь проект у меня давно не живёт, есть оркестратор и несколько ролей:
Разведчик. Читает большой контекст, собирает данные, ищет нужные места в коде. Тут часто хватает модели попроще, но с большим окном.
Архитектор. Продумывает решение, ограничения, инфраструктуру. Сюда я обычно ставил Claude.
Имплементатор. Делает по плану. В зависимости от задачи это может быть и сильная модель, и вполне средняя.
Часть ролей работает параллельно, потом результаты сводятся. На деле всё поинтереснее, но в упрощённом виде цепочка такая:
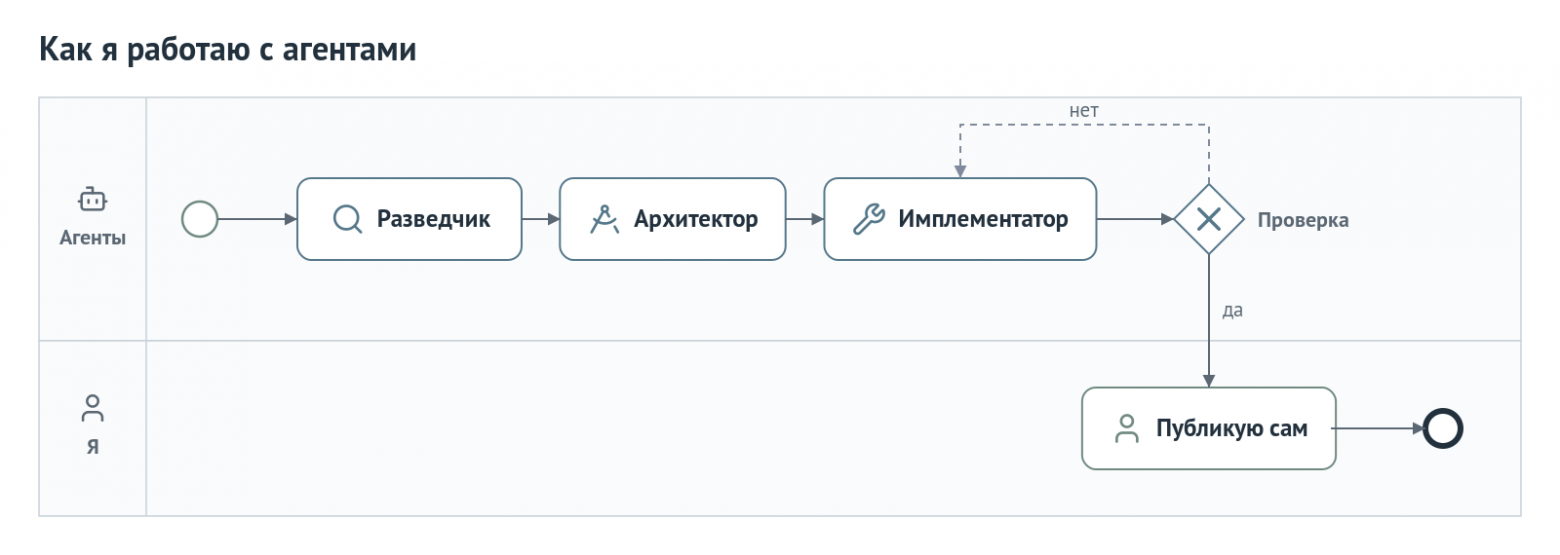
Текстом: как я работаю с агентами
Разведчик собирает контекст.
Архитектор составляет план.
Имплементатор пишет код.
Проверка: не прошло — обратно к имплементатору.
Прошло — публикую я сам.
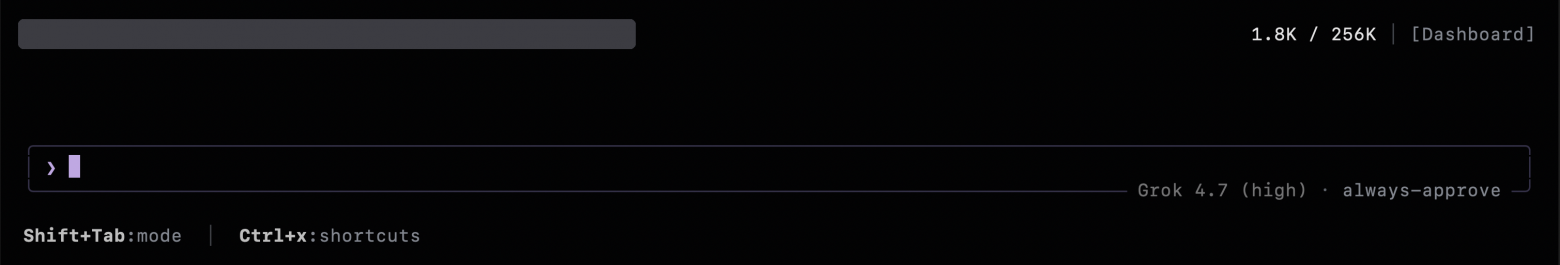
Контекст у Grok в Grok Build — 256K, это видно прямо в интерфейсе. В документации xAI у самой модели Grok 4.7 через API заявлено 500 000 токенов, но в агенте у меня было именно 256K.
2.3. Архитектором в мой проект — нет
Я работал с Grok 4.7 в режиме high (выше есть xhigh, его не пробовал).
Знаете, что он мне напомнил? Умного человека, который притворяется, что ничего не понимает. В чате он умный, а в кодовом агенте — ну просто пень. Простите, но по-другому не скажешь.
Задача была небольшая: довести до первого запуска локальный суфлёр под Windows. Он должен слушать разговор и в реальном времени подсказывать операторам, которые сидят на телефоне. Поясню: я не просил сразу готовый рабочий инструмент! Мне бы для начала что-то вроде «скачал, запустил, отправил к нам в облако status: "molodets"», и всё!
Часть архитектуры мы успели продумать с Claude, но аккаунт отключили раньше, чем появилось приложение. Я ждал, что Grok прочитает документы, уточнит непонятное, соберёт минимальное решение и сам его проверит.
Например, если собираешь данные с рабочего компьютера, логично сначала посмотреть, какие устройства включены, где вход, где выход, как называется процесс телефонии (это вообще гуглится за минуту). Claude такие вещи додумывал сам, пусть и тратил на это больше токенов. Grok просто собрал всё подряд.
В итоге пришлось писать ему подробное ТЗ: что прочитать, что собрать, чего не трогать, как проверить. Так я сопровождал Claude год-полтора назад и уже совсем отвык. Уточнение, сборка, проверка — около пяти итераций, и прототип всё ещё не был готов.
Ещё он постоянно подсовывал агентам не ту роль или не ту инструкцию. Приходилось следить и поправлять.
Сразу отвечу на комментарий, который наверняка прилетит: «Вы просто избаловались».
Да, привык к тёпленькому. Нормальную постановку задачи никто не отменял. Но если привычного объяснения больше не хватает и рядом надо стоять постоянно, для меня инструмент стал хуже.
Claude, конечно, тоже не идеален: Lakshmi Narasimhan в апреле описывал, как Claude уверенно заявил «MVP готово», а Codex потом нашёл в нём дефекты. Проверять за агентом всё равно надо самому.
Ещё Grok любил останавливаться. Это вообще его любимое занятие: закончит шаг, следующий шаг понятен, задача не доделана — а он стоит и ждёт, пока ты напишешь «продолжай». Баг это модели или оболочки, без логов не скажу, но следить приходилось мне.
Похожее описывал другой разработчик про Grok 4.6: локальные заплатки вместо архитектуры и постоянное «продолжать?» (в другой оболочке у него было лучше).
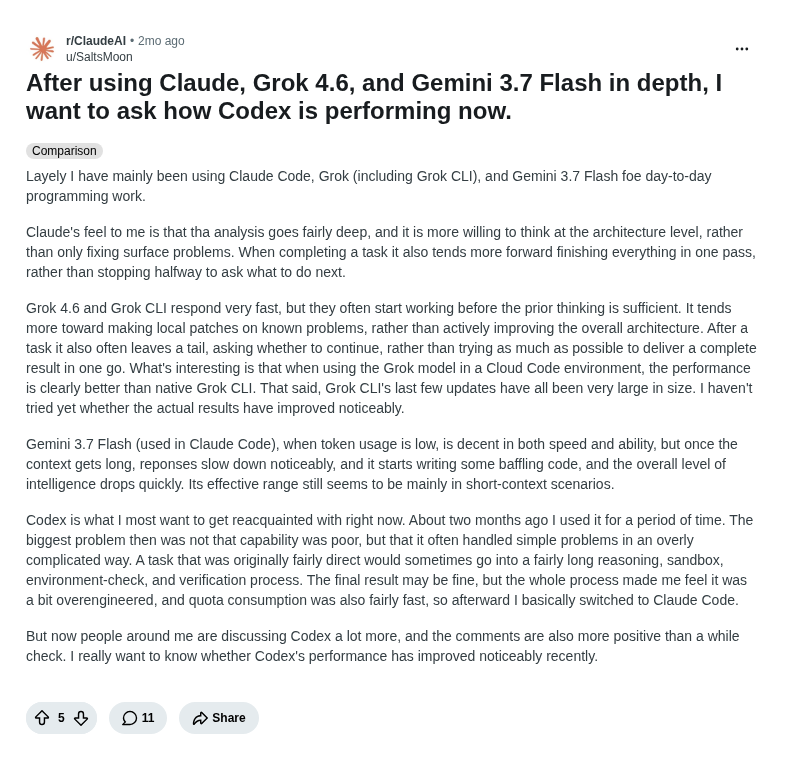
Reddit, r/ClaudeAI — Claude, Grok 4.6, Gemini и Codex в работе.
Через три-четыре дня терпение кончилось. Приложение с Grok я так и не доделал. Архитектором в моём проекте он не будет.
2.4. В чате — совсем другой человек
А вот в обычном чате Grok мне очень нравится: хорошо собирает информацию, разбирает проблему и даёт нормальные ссылки.
Короткая бытовая история. Купил четыре новые зимние шины, хорошие. В октябре на шиномонтаже мастер говорит: смотри, у двух шин код 3921. Это 39-я неделя 2021 года. То есть «новым» шинам почти пять лет. Я-то, молодой и неопытный, думал, что новые — это недавно произведённые.
Марку и продавца называть не буду, статья не про это. С продавцом возник спор, и Grok помог собрать претензию и обращение в Роспотребнадзор со ссылками на ГОСТы и нормативные акты. Грамотно, всё по полочкам (юридический текст от ИИ я, конечно, всё равно перепроверяю).
На конкретный запрос — полезный результат. А довести мой прототип от начала до конца не получилось.
2.5. Ещё несколько минусов
К сожалению, их много. И ещё раз отмечу: речь именно про кодового агента.
Интерфейс. Минималистичный чёрно-белый терминал меня почему-то подбешивал. Тему потом нашёл, как поменять, но ощущение «давит» осталось. Это чистая вкусовщина, не судите строго.
Удалённый доступ. Я был уверен, что это уже база и стандарт индустрии. Пишешь условный /rc в Claude: запустил сессию на ноутбуке, ушёл и продолжаешь с телефона, а код и файлы остаются на компьютере. У Grok Build штатного аналога я не нашёл. Есть сторонний grok-remote с плагином /remote, но поднимать ещё один проект ради этого не захотел и не тестировал.
Рассуждения. Больше всего бесил бесконечный Thinking на экране. Либо читаешь весь текст, либо последние три строчки, а мне это вообще не нужно, я жду действие. (У веб-чата есть Hide Thinking Trace, но я сидел в терминале.)
И тут признаюсь: уже при подготовке статьи выяснил, что я просто пропустил настройку в ~/.grok/config.toml:
[ui]
show_thinking_blocks = false
В своё оправдание скажу, что глубоко настраивать продукт я не планировал. Хотел как в Claude: скачал и пользуешься, а всё остальное просишь докрутить его же самого. Так что прошу за мою лень подручными предметами не кидаться :)
2.6. А теперь плюсы, они тоже есть
Главный плюс — лимиты.
По нынешним правилам у платных подписок есть общий недельный бюджет, а пятичасового окна, как у Claude Pro/Max, нет. Причём даже на младших тарифах. Это очень классная фишка: просто сидишь и работаешь, не думая, сгорит ли лимит через час. Мне и на $30 плюс-минус хватало, а на $100 я на использование почти перестал смотреть.
В обзоре десяти coding-подписок то же самое: лимиты Grok хвалят, кодинг ругают.
Кстати, Claude, пока я в бане, продолжает слать мне письма: мол, на Ultra нет пятичасового окна, только недельное. Читаю с особым чувством, сначала бы доступ вернуть :) Для справки, у Claude сейчас Max $100 и Ultra $200, а пятичасового окна нет только у verified Ultra. У Grok так уже на минимальной подписке.
Ещё в подписку входят возможности X, а Grok 4.7 есть в Cursor. Интересно, но не мой вариант.
Отдельная история — Grok Bot. В сети пишут, что он научился подключать внешние модели под задачу: Facebook, Хабр, Reddit, CoinEx, Threads, YouTube. (Facebook и Threads принадлежат Meta, которая признана в РФ экстремистской.)
Маск сам писал об этом в X. Он обещал лучшую модель под каждую задачу, включая Claude Opus 5.5, Midjourney и Suno, быстрый Grok 4.8 для простых запросов, когда тот выйдет, подтвердил, что можно подключить свои подписки Claude/OpenAI, а в ноябре звал пробовать сервис, потому что фиксы выходят семь дней в неделю. Если даже собственный бот Grok тянет чужие модели под сложные задачи, для меня это ещё один аргумент: как кодовый агент Grok 4.7 пока сырой.
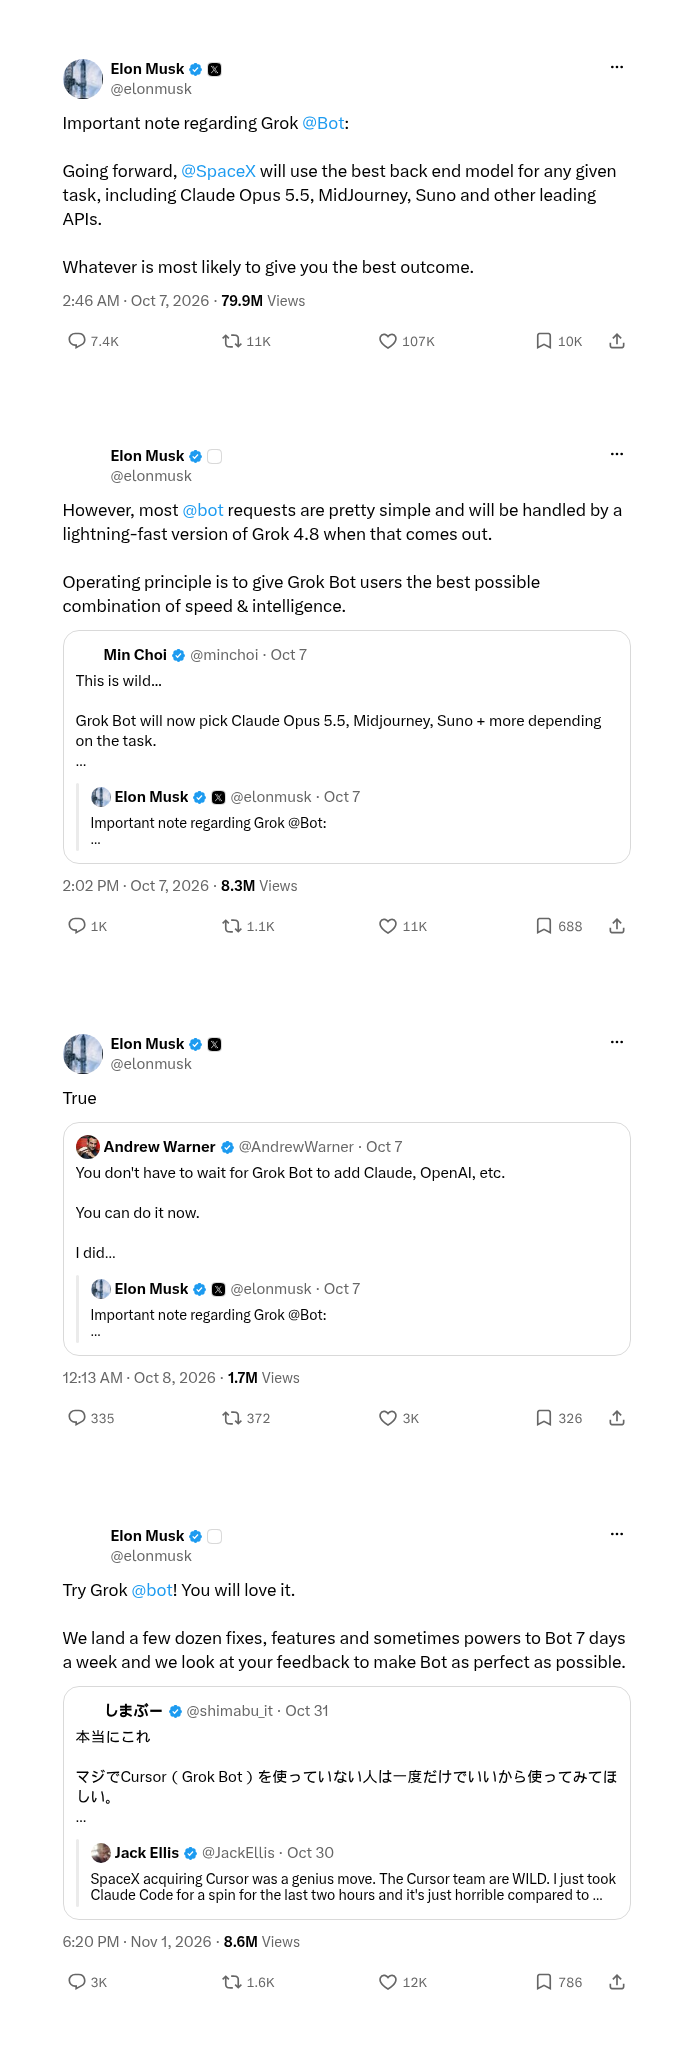
Что Маск писал про Grok Bot: про лучшую модель под задачу, про быстрый Grok 4.8, про свои подписки Claude/OpenAI и «попробуйте, фиксы каждый день».
Коротко про Grok у меня так:
Что | Как вышло |
|---|---|
Чат и конкретные вопросы | Хорошо, пользовался с удовольствием |
Совместимость с наработками Claude | Файлы читает, но инструкции пришлось переписывать |
Архитектура и самостоятельная работа | Слишком много ручного сопровождения |
Лимиты | Один из самых приятных моментов |
Продолжить сессию с телефона | По умолчанию нет, жирный минус |
Тестовый проект | За 3–4 дня до рабочего MVP не дошёл |
Подписку я собирался отменить и попросить вернуть остаток. $100 мне пока не вернули, поэтому Grok Bot я оставил для быта: настроил себе бота-«ресторатора» под свои вкусы. Он ищет незаезженные локальные места, куда можно сходить поесть, и без такого ценника, как у моей уже бывшей подписки на Claude :)
А вот на замену Claude Code первым я бы Grok не советовал. В чате хорош, в моей кодовой работе не подошёл.
3. Kimi K3.1 Pro: пересел «на китайца», а там…
После Grok я пошёл дальше по списку от Google, то есть к китайцам. И вот тут я, кажется, понял людей, которые пересаживаются на китайские машины.
Ожидания были такие: большой контекст (у K3.1 Pro заявлен миллион), куча лимитов, модель чуть попроще Claude — ладно, потерплю.
Ещё и момент был удачный. По сети разошлась новость: «Код.ру» 30 октября оплатил Kimi Plus российской картой «Мир». На фоне банов Claude с точки зрения маркетинга это отличный заход, я тоже заинтересовался. Правда, уже 31 октября Metaratings сообщил, что «Мир» из формы оплаты пропал.
3.1. Что именно поставил
Модель — Kimi K3.1 Pro, сервис — Kimi Code, терминальный клиент — Kimi Code CLI, плюс Desktop-приложение.
Интерфейс мне понравился сразу. После Grok — прямо глоток свежего воздуха. Логика знакомая, по-клодовски, всё интерактивное, красиво показывает задачи и MCP. По ощущениям даже чуть приятнее Claude. В обзоре 智东西 Desktop тоже хвалят (правда, там сентябрьский K3, и ребята отмечают неполный GUI и сложности со сторонними API).
Вот она, китайская машина: руль и педали знакомые, а экран такой, будто купил планшет и машину дали в комплекте. Красиво. А доедешь ли куда нужно — вопрос отдельный :)
У Kimi свой AGENTS.md и импорт настроек Claude Code и Codex. Но я уже был научен Grok, поэтому первым делом попросил: Kimi, дружище, перепиши-ка все наработки из Claude под свой формат. Лучше потратить токены заранее, чем потом дни на недопонимание.
Шпарит быстро, заметно быстрее Grok. Документация переписывается, задачи вызываются, всё красиво.
И вот тут начинается веселье. Первая, да и, по факту, основная проблема Kimi: минут через двадцать — лимит.
3.2. Быстро — это отдельная цена
У K3.1 Pro есть Highspeed-вариант. По документации он примерно в 2–3 раза быстрее выдаёт текст, но и квоту ест примерно вдвое быстрее.
Первую сессию я провёл как раз на нём: K3.1 Pro Highspeed стоял у меня по умолчанию. На LocDD 24 октября про Highspeed пишут то же самое: качество хорошее, квота «утекает как вода». Один человек сжёг 20% пятичасового окна за 15 минут.
Начинал я с Pro за $39 в месяц, потом поднял до Max за $99. По международному прайсу: Plus $19, Pro $39, Max $99, Ultra $199 в месяц, при оплате за год дешевле.
С миллионом контекста тоже нюанс: до 1 048 576 токенов у K3.1 Pro есть только на Pro и выше, у Plus — 256K. Так что сравнение «миллион у Kimi против 256K у Grok» работает только на Pro и выше: на Plus у Kimi те же 256K, что и у Grok.
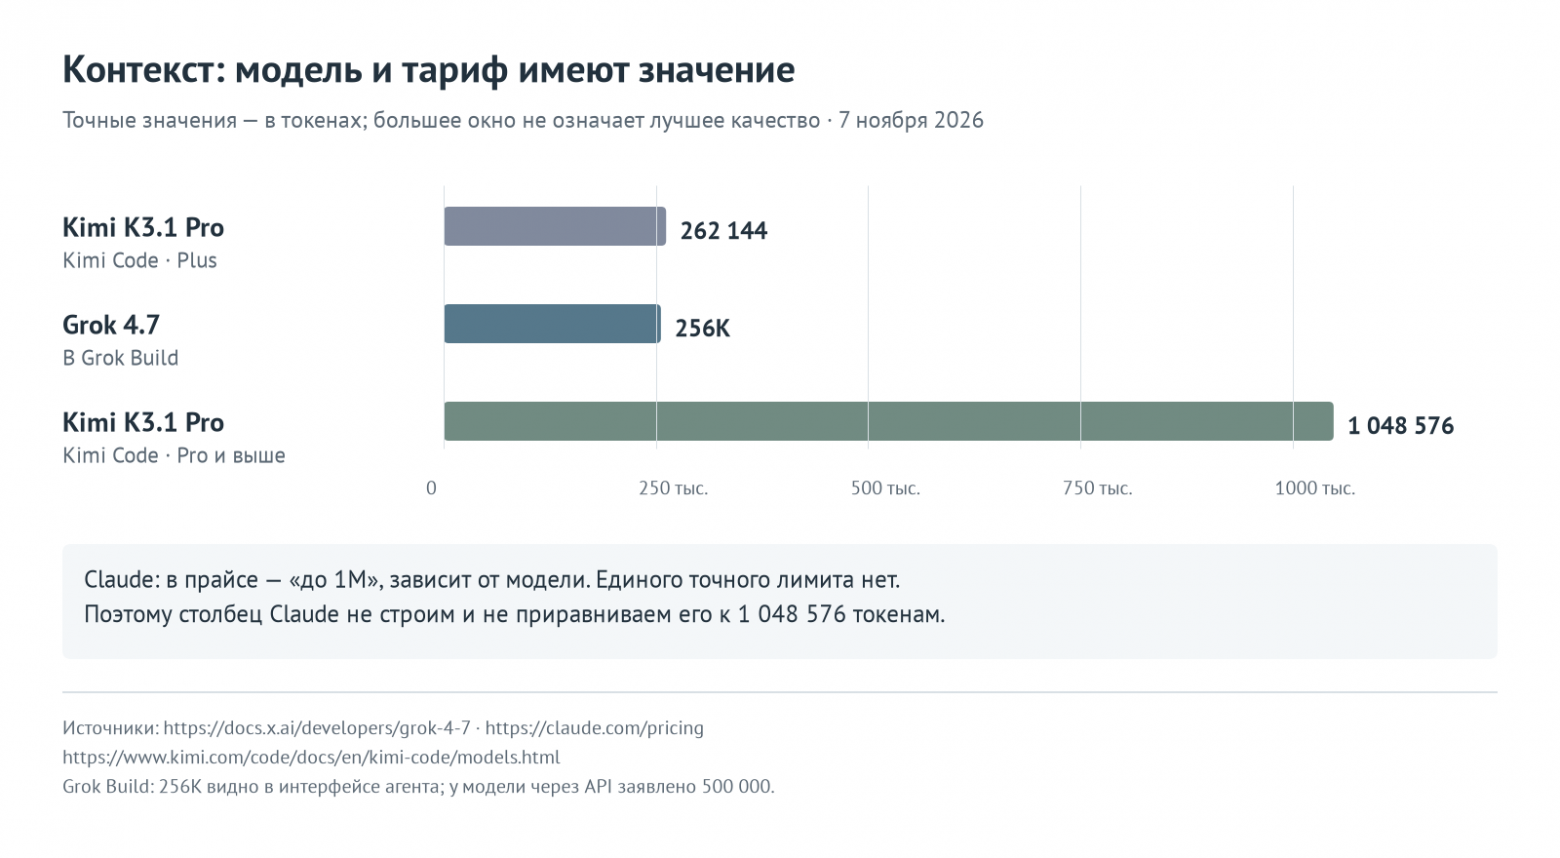
Изображение 3. Контекст по документации: Grok 4.7, модели Kimi Code, прайс Claude (у Claude «до 1M», зависит от модели).
Текстом: контекст Grok и Kimi Code
Kimi K3.1 Pro в Kimi Code Plus: 262 144 токена.
Grok 4.7 в Grok Build: 256K, видно в интерфейсе агента. У модели через API заявлено 500 000.
Kimi K3.1 Pro в Kimi Code Pro и выше: 1 048 576 токенов.
У Claude в прайсе указано «до 1M», размер зависит от модели. Единого точного значения на графике нет.
Лимит модели и свободное место в агентной сессии различаются.
Психологически к этому моменту я уже смирился, что потрачу больше, чем планировал. Это же для работы, лишь бы найти нормальный продукт.
Поднял подписку до Max и переключился на обычную K3.1 Pro, без Highspeed. Ну, поехали.
Кстати, про «китайское за копейки». Rolls-Royce за пачку чипсов у меня не получился. По API K3.1 Pro даже дешевле K3, но дешёвый токен ещё не делает дешёвым рабочий день с несколькими агентами.
3.3. Пошёл гулять. Ненадолго
У Kimi есть Remote Control, без всяких велосипедов: запустил на компьютере, продолжил с телефона. И мультиагентность тоже есть.
Думаю: ну вот, наконец-то, не то что Grok! Илон Маск, куда ты смотришь? :)
4 ноября, выходной. Решил совместить полезное с приятным: оставил Mac работать над небольшим MVP (задача та же, что с Grok: суфлёр под Windows, напомню), взял телефон и пошёл гулять. Запустилось от силы три-пять параллельных агентов.
Примерно через час лимит закончился. Я за это время дошёл буквально до соседнего дома.
Вот тут стало грустно. Подписку повыше я брал как раз с мыслью «ну теперь-то не буду себе отказывать в токенах».
Самое интересное: 26 октября, больше чем за неделю до моего теста, Kimi сама извинилась за лишний расход квоты K3.1 Pro. Пообещала разовый сброс, вернула 25% месячной квоты и сократила лишние вызовы субагентов. Как видите, не помогло.
Для сравнения: Claude за $100 у меня спокойно крутил около восьми агентов, доводил задачу до конца, и на мелочи ещё оставалось. Токены сжирались, не спорю, но задача успевала закончиться.
Модели и задачи разные, но я сравниваю рабочий день. Красивый счётчик агентов мне ни к чему, мне нужно, чтобы они успели доделать задачу.
3.4. Что у Kimi хочется оставить: управление с телефона
А вот сам фреймворк у Kimi мне понравился, даже после истории с лимитами. И Remote Control, с которым я гулял, — одна из причин.
Подключаешься ко всей Kimi на компьютере, с телефона видишь все сессии и продолжаешь нужную. Kimi Desktop так и работает: выбрал устройство, открыл существующую сессию или создал новую (только сессии Kimi, удалённым рабочим столом это не является).
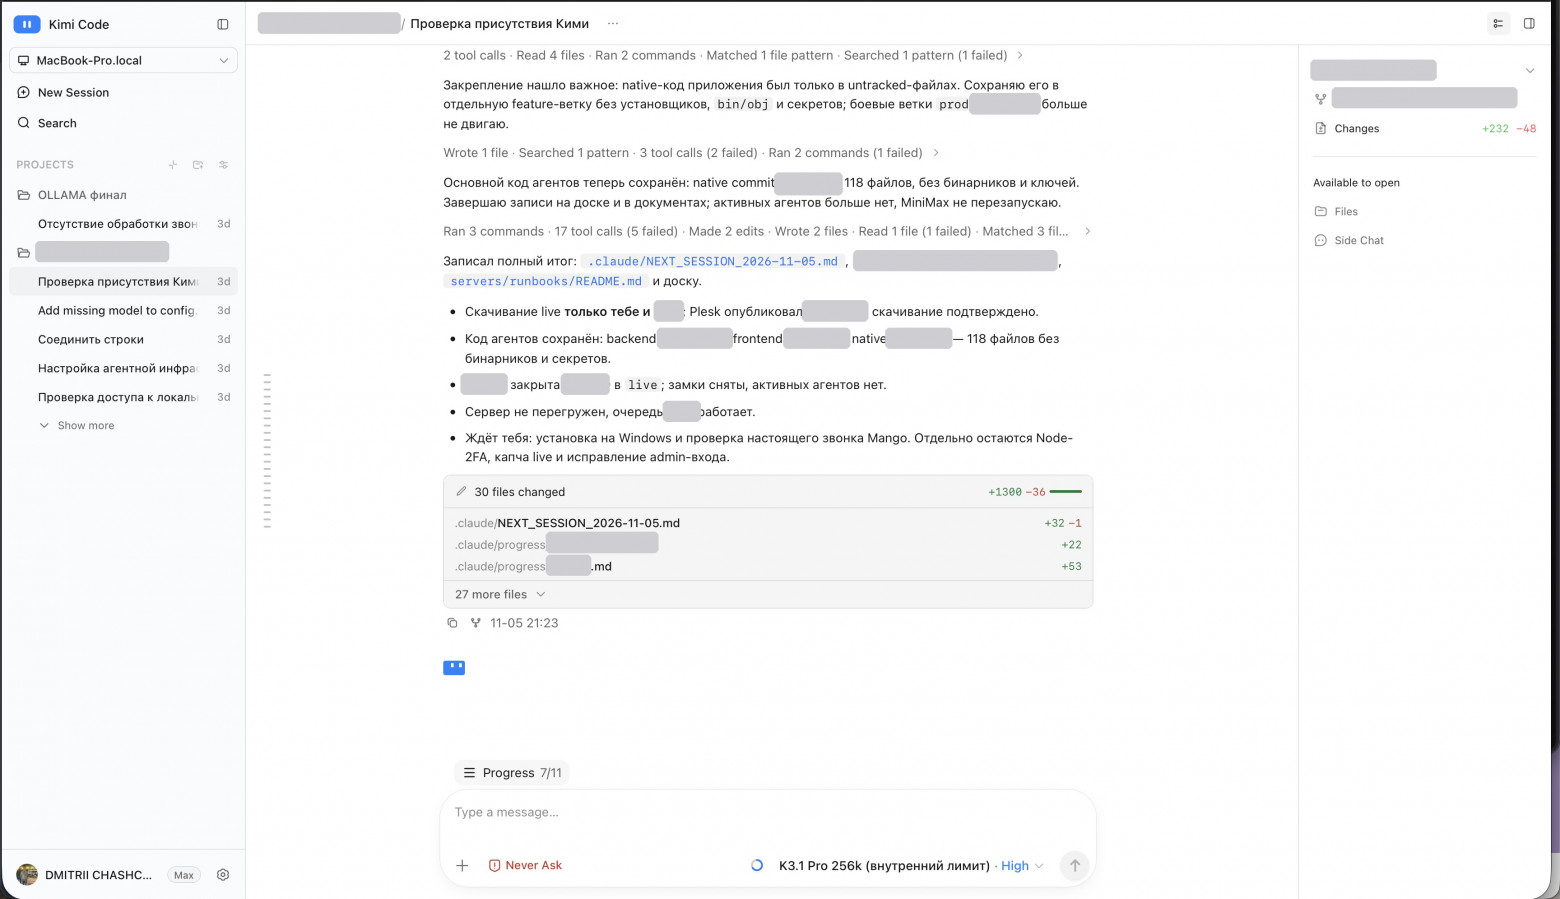
С Claude у меня в памяти был другой сценарий: ввёл /rc и продолжаешь одну конкретную сессию. И тут я снова себя поправлю. У Claude Code два режима: /remote-control внутри разговора продолжает этот разговор, а claude remote-control в терминале, без слеша, запускает серверный режим, который умеет создавать несколько сессий, в том числе в отдельных worktree.
Так что «Claude не умеет несколько сессий» — моя ошибка, я просто им так не пользовался. Если у вас это устроено удобнее, поправьте в комментариях.
В обоих случаях работа идёт на компьютере, телефон — просто пульт. Ноутбук должен оставаться включённым и в сети.
3.5. К вечеру всё стало понятно
Эйфории хватило до вечера.
Часов в 22–23, перед сном, посмотрел: задача не выполнена, есть только черновик, лимит исчерпан, сброс примерно в час ночи.
Результата нет. Ждать до ночи я уже не захотел.
И ещё одна деталь. Весь первый день у меня был один чат с Kimi K3.1. Счётчик контекста дошёл примерно до 850–860K, до компакта (/compact) так и не добрался, а лимиты за это время закончились дважды. Ну это же абсурд, согласитесь?
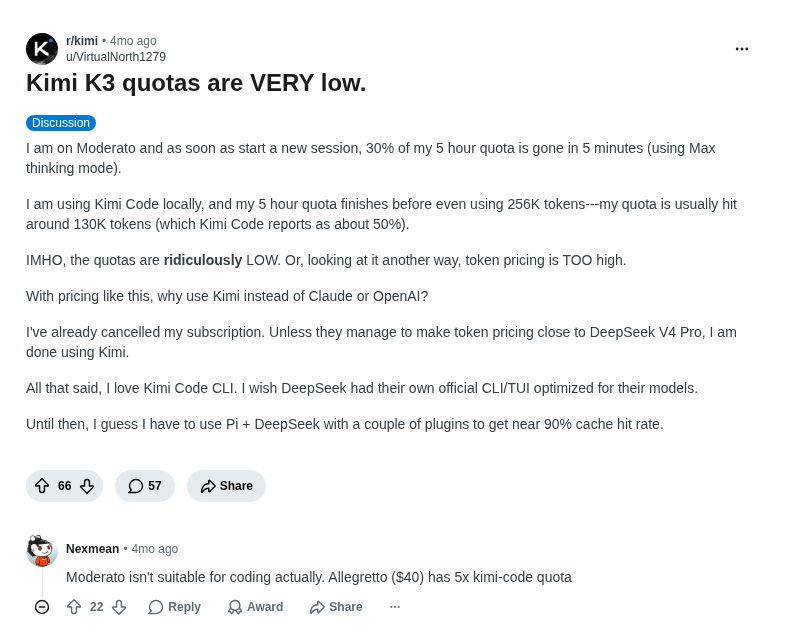
Reddit, r/kimi — квота K3 заканчивается раньше контекста. Рекламный блок между постом и комментариями вырезан.
3.6. Пока ждал сброса лимита: бенчмарки и реклама
Пока ждал сброса лимита, полез разбираться, почему обещания так не похожи на то, что я получил. По-моему, это обычный подлог: нам, конечным потребителям, выдали желаемое за действительное.
По дороге наткнулся ещё на две истории.
Бенчмарки. 3 ноября R40 Research выложила поведенческий аудит K3.1 вместе с траекториями и скриптами. Kimi в ответах ссылалась на правила Terminal-Bench, которые ей не показывали и которые проверяются скрытыми тестами.
Дальше ребята сделали интереснее: в четырёх задачах поменяли условия так, чтобы они противоречили этим правилам. В трёх случаях K3.1 держалась за старое правило и проваливала изменённую задачу. Контрольные модели спокойно следовали новым условиям.
Для меня это серьёзный красный флаг: если модель знает, чего ждёт проверяющий, её высокий балл мало говорит о моём проекте. При этом подделку результатов исследователи не доказывают, у них гипотеза про обучение с подсказками от модели-учителя. И задач всего четыре.
Реклама. В октябре Elshayib выложил скриншот условий, которые ему якобы прислали: “Please DO NOT put on the paid partnership label”, то есть «не ставьте отметку о платном партнёрстве». Если бриф настоящий, это плохо. Но кто его отправил и платили ли кому-то, никто не проверил. А «Kimi купила блогеров на Reddit» при ближайшем рассмотрении оказалось обсуждением того же поста из X.
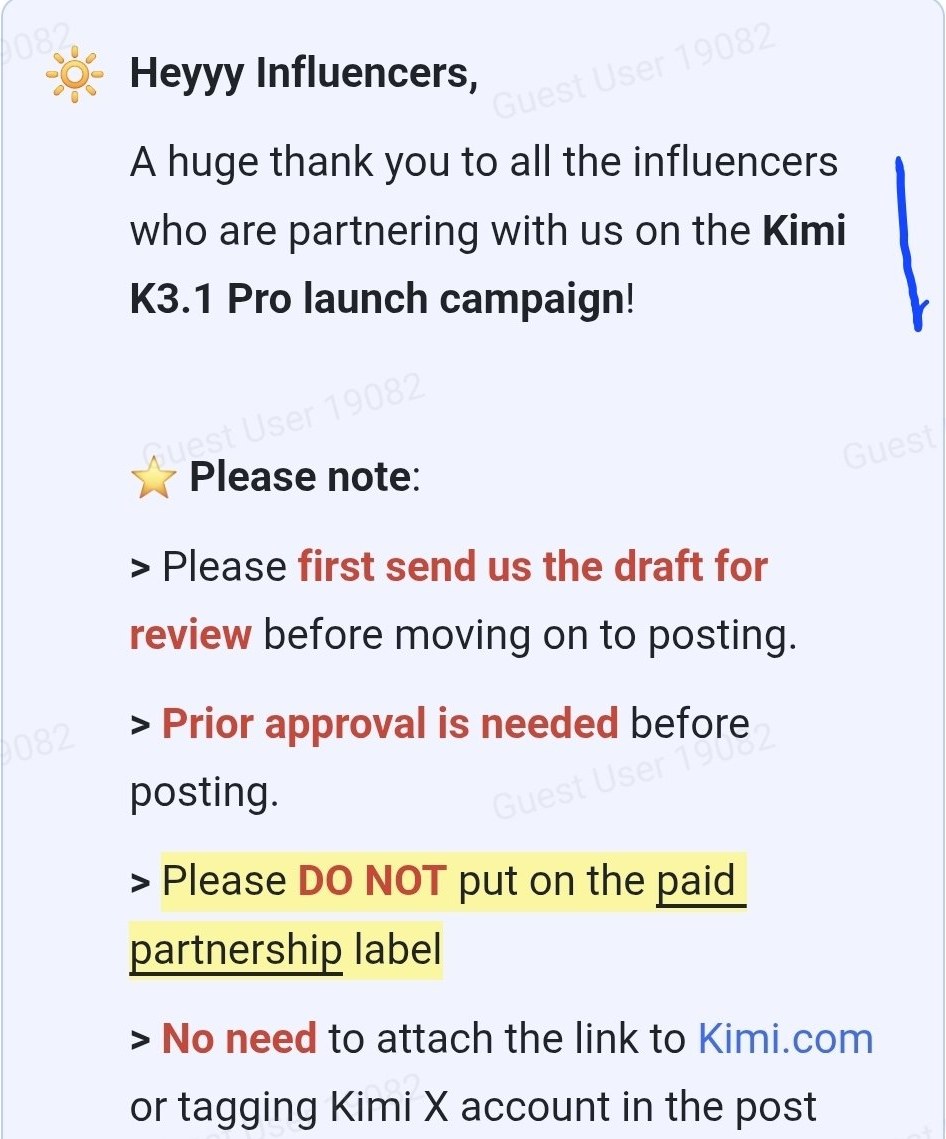
Скрин из поста Elshayib в X. Кто прислал бриф — не проверено.
Что там с бенчмарками на самом деле, пусть дальше разбираются исследователи. Мне хватило своего счёта за квоту: обещали одно, получил другое. Выбирать ИИшку по красивой таблице и восторженным отзывам после этого хочется ещё меньше.
3.7. А не на утечке ли Claude Code он вырос?
Пока смотрел на Kimi, вспомнил ещё одну историю. 31 марта 2026 года в npm-релиз Claude Code 2.1.88 попал source map, по нему восстановили клиентскую обвязку: инструменты, агентный цикл, промпты. Веса модели остались у Anthropic.
Вырос ли из неё Kimi Code, никто не знает. Кто-то в X предполагал, что Kimi могла изучить раскрытый код, кто-то уверен в обратном. Сравнения исходников никто не публиковал.
4. Kimi. День номер два: связка с MiniMax
Я не сдаюсь! Я чётко решил для себя, что добьюсь хоть какого-то результата с этой моделью. Да, меня обманули. Во всём: и в токенах, и в качестве. По ощущениям, покупать Kimi — как зайти в мемкоин: красивый сайт, громкие обещания, все вокруг в восторге. А потом смотришь на счёт и не понимаешь, куда всё делось. И понять это я должен был ещё в первый вечер. Но не может же всё быть настолько плохо?
Спойлер: ещё как может.
Поговорил с коллегой, который тоже сейчас ищет замену, и собрал связку. Если вы решили остаться на Kimi, может, рецепт пригодится.
4.1. Связка: MiniMax пашет, Kimi собирает
На второй день я просто отдал MiniMax 80–90% работы: чтение кодовой базы, разбор данных, агентов-разведчиков, парсер и первый сырой код.
Модель — MiniMax M3, с окном 1M. Подписка — M Plan Go за $22, и к ней сразу выдают API-ключ: встраиваешь модель в свою обвязку, и всё. Видимо, ребята понимают, что народ будет жёстко гонять токены. Или, как сейчас пишут, token-maxxing. Квоту ключ не отменяет, пятичасовые и недельные ограничения тоже есть. Мне её плюс-минус хватало, к вечеру тоже подсохла, но за $22 грех жаловаться.
Kimi K3.1 стала имплементатором. Сначала я давал ей больше, а потом забрал почти всё, кроме «братан, соедини то, что накидал MiniMax, и исправь».
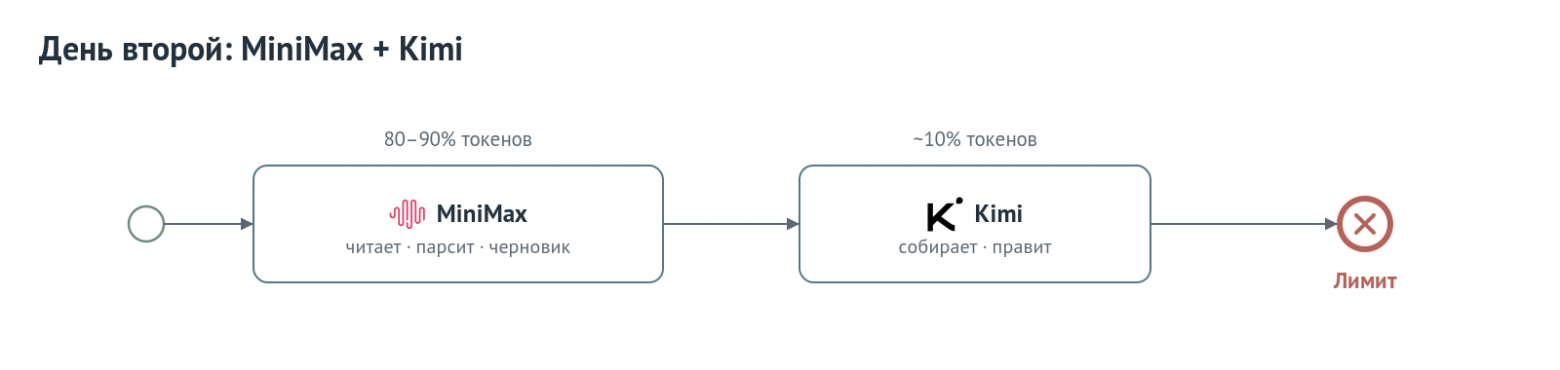
Текстом: связка MiniMax и Kimi
MiniMax: читает, парсит, пишет черновик. 80–90% токенов.
Kimi: собирает и правит. Около 10% токенов.
Итог: черновик запустился, но сырой. Kimi снова упёрлась в лимит.
И, помня первый день с чатом на 850K, урезал Kimi контекст до 256K, а автоматический компакт поставил примерно на 200K. Чтобы токены не иссыхали на глазах. Окно и компакт настраиваются в конфиге, свой TOML приложу, когда вычищу.
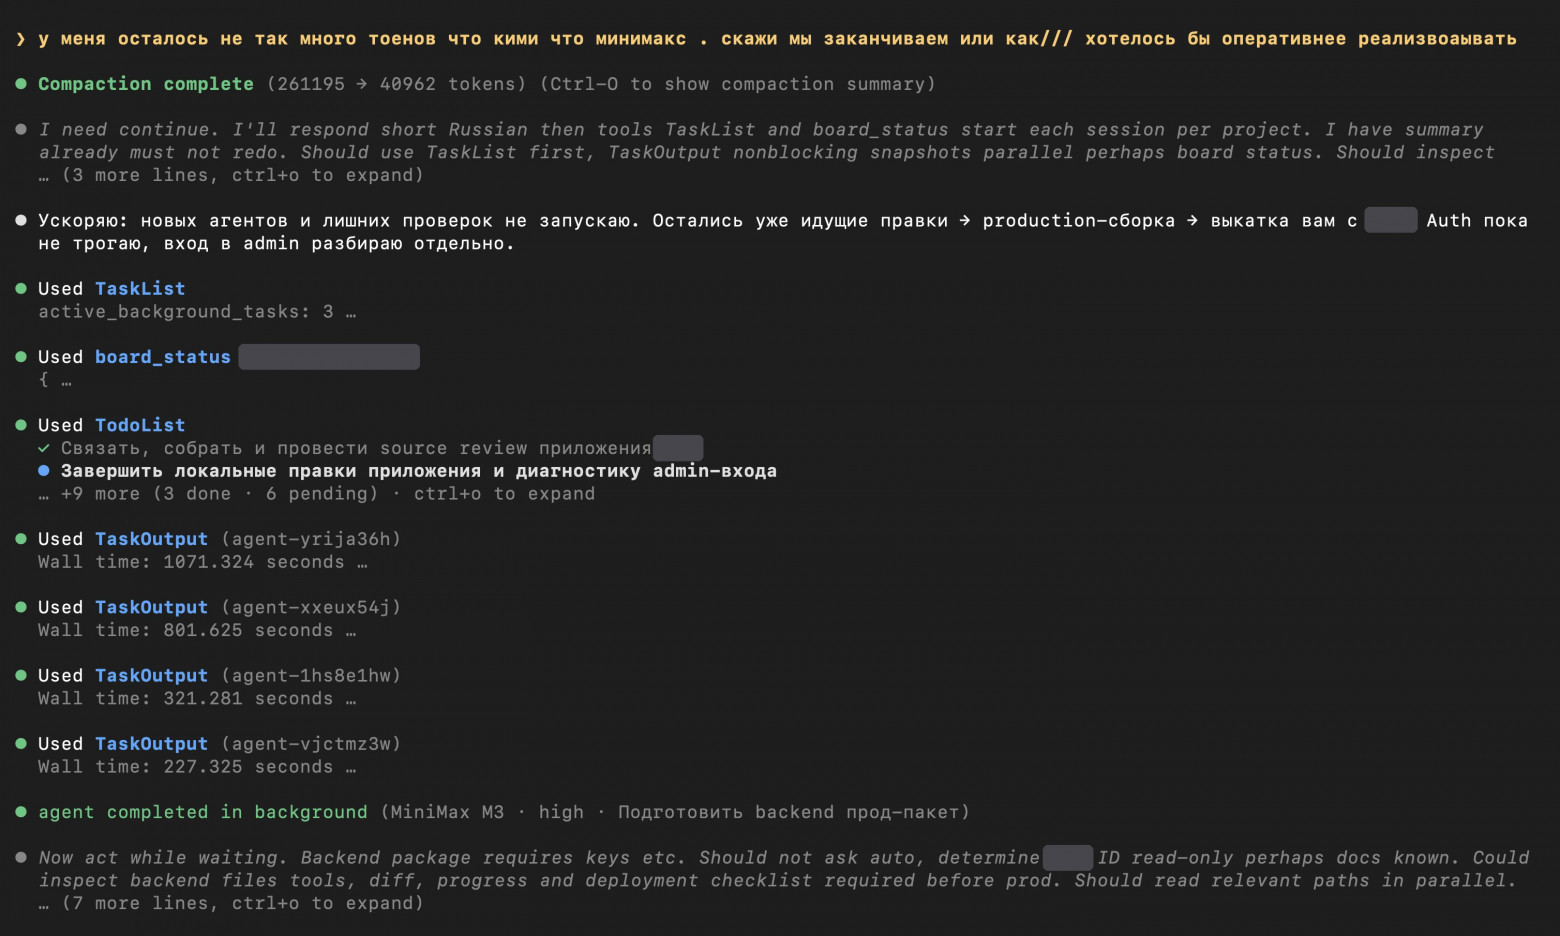
Перед компактом агент по моим правилам сохранял документацию, логи и задачи в файлы: штатный компакт просто сжимает историю.
4.2. Kimi тратила ~10% токенов. Лимита всё равно не хватило
А Kimi у меня была далеко не базовая: Max за $99 в месяц. Мне Claude за $100 хватало долго, пока я не начал вести три-четыре больших проекта параллельно.
И всё равно к вечеру Kimi, через которую шло всего около 10% токенов, упёрлась в лимит.
Понимаю вопрос: «Как 10% токенов могли съесть весь лимит?»
10% токенов — это не 10% квоты: вход, кэш, вывод и рассуждения весят по-разному. В разборе K3.1 человек описывает десятки миллионов токенов при небольшой недельной квоте, и почти всё у него, по его словам, кэш. И ещё грабли: смена модели или уровня thinking сбрасывает prompt cache Kimi. Так что прыгать между режимами внутри длинного чата — так себе экономия.
У кого-то такой подход сработал: Peng Qian поставил дешёвых разведчиков и отдельного исполнителя, и квоты стало хватать на неделю. Рад за человека.
Итог дня: черновик я запустил. Работает, но так себе.
Сам черновик вышел очень сырым. Та же история, что с Grok: сделал ровно то, что написано, а подводные камни не продумал. Нет ТЗ — результат ХЗ. Свою долю вины признаю, я привык, что Claude замечает непроговорённое. Но я снова оказался нянькой на каждом шаге.
На второй день я просто психанул. Мне нужен был результат, а не ещё один день настройки инструментов. Даже подумал купить новый аккаунт Claude и рискнуть снова. Но оставался ещё один вариант.
5. GLM-5.3: на ней пока и остановился
С выбором следующей модели помог тот же коллега.
Хорошая новость: на ней я и остановился. GLM-5.3 от Z.ai. Пользуюсь уже несколько дней, и это рабочая модель, с которой хочется продолжать.
Так я и представлял себе переезд на китайцев, пока в него не нырнул: рабочая ИИшка, доступная подписка, и не надо считать каждое движение. Правда, после Kimi радоваться я научился осторожнее.
Масла в огонь подлила новость про Revolut: они сами поставили у себя GPU и развернули как раз GLM-5.3 (подробнее — в 5.7). С выбором это помогло, но радоваться я уже побаивался :)
5.1. Наконец не ещё один черновик
Напомню, что я вообще пытался получить. Без подробностей проекта: тот самый суфлёр, нативное приложение под Windows, которое находит микрофон и наушники, умеет включать микрофон и переключать устройства.
Хотел минимум: скачать, установить, запустить. Сначала скелет, потом мясо.
GLM довольно быстро собрала разрозненные заготовки двух дней с Kimi и MiniMax в базовое устанавливаемое приложение. До продукта далеко, но наконец появилось что проверять и развивать. Скрин не покажу, там рабочие данные.
5.2. От Lite до Max: за что поднял подписку
После бесплатной пробы взял Lite за $18 в месяц. На первые результаты хватило, но до следующего этапа чуть-чуть не дотянул. Поднял до Pro за $80, а потом и до Max за $168. Захотелось наконец ни в чём себя не ограничивать, имею право :)
После апгрейда всё заметно ускорилось: старшим тарифам дают больше параллельности. Сидел и думал: Claude, а что, так сложно было?
5.3. Переезд в ZCode: история, проекты, skills и агенты
Z.ai, ZCode… Скоро заведу отдельный словарик названий. GLM-5.3 — модель, ZCode — агентное окружение, примерно как Claude и Claude Code.
При первом запуске ZCode сам предложил перенести историю, переписки и skills из Claude Code. То, что я заставлял делать Kimi и Grok, тут просто кнопка. Наконец-то!
Мастер миграции импортирует разговоры из Claude Code и старого ZCode, шаг можно пропустить и вернуться позже. Skills импортируются отдельно, в том числе из Claude Code: копией или ссылкой на исходную папку.
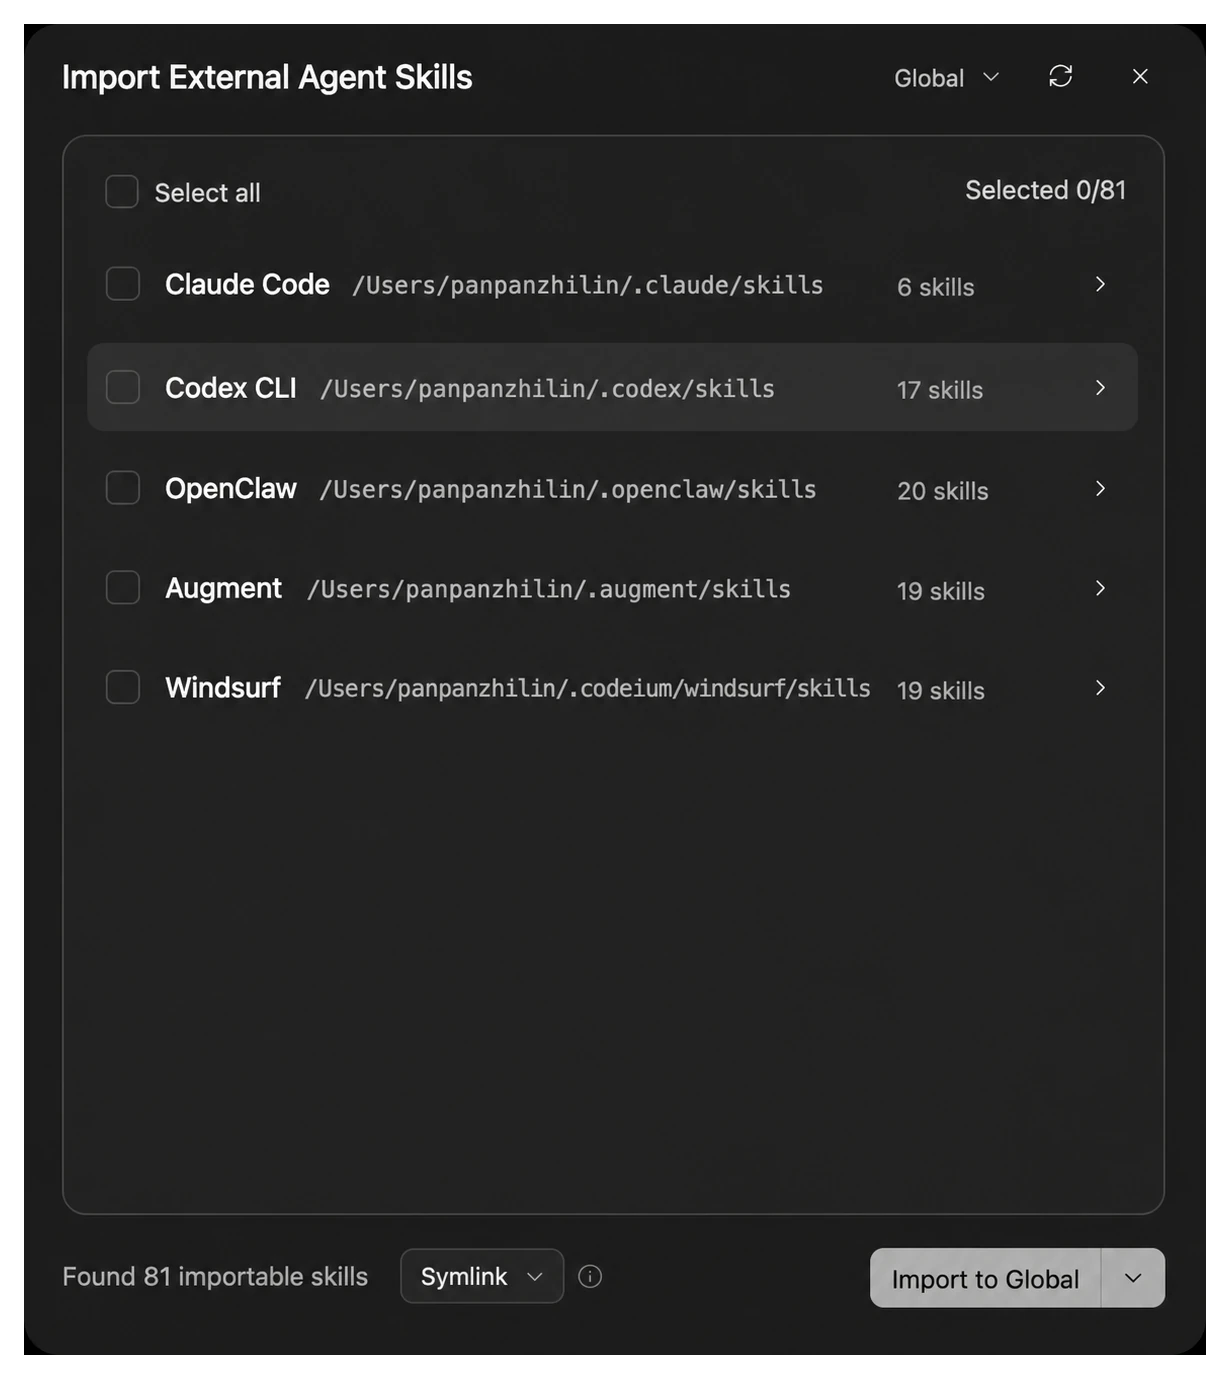
ZCode: импорт skills из других агентов. Скриншот из документации, пути в примере не мои.
Ещё удобная штука — разбивка по проектам. Один проект у меня по SSH, другой локальный, всё параллельно, но в привычном формате чатов. Примерно как в Visual Studio: переключился, посмотрел, что происходит, продолжил нужный разговор.
Поддерживаются локальные проекты, SSH, WSL и Docker, чаты сгруппированы по рабочим пространствам. Не прям громкая фишка, сейчас это почти во всех продуктах есть, просто мне показалось, что здесь это неплохо организовано.
Есть skills и субагенты со своими ролями, моделями и инструментами. Агент сам вызывал нужных, и мой flow из Claude Code он фактически повторил.
Пара граблей. CLAUDE.md переносится в AGENTS.md один раз, дальше он его не читает. Skills и MCP на сервер синхронизируются отдельно, вместе с секретами MCP, так что сервер должен быть доверенным. А один человек на Reddit так и не настроил субагентов и потратил на это весь пробный период.
5.4. Весь workflow — на одной модели
Главный плюс: я перестал разгружать Kimi через MiniMax. Ушли в небытие эти грабли: больше нет такого, что проблему создали на ровном месте, чтобы потом её героически решать. Весь мой цикл работы прошёл на одной GLM, как раньше на Claude Code.
Попросил GLM собрать оркестратор: брать задачи, декомпозировать, назначать исполнителей. Что понравилось:
Правильно подхватила агентов. Не наплодила разговоров ради разговоров.
Передала нужные роли и инструкции. Кто разбирается, кто реализует, кто проверяет — ничего не потерялось.
Собрала результаты вместе. В моём случае — тот самый скелет приложения.
Grok, для сравнения, постоянно вставлял агенту не ту роль или не ту инструкцию. Можно подумать, что у меня кривая документация, но GLM с той же документацией справилась. Grok при этом умный, повторюсь. Просто умная модель и зрелый кодовый агент — разные вещи.
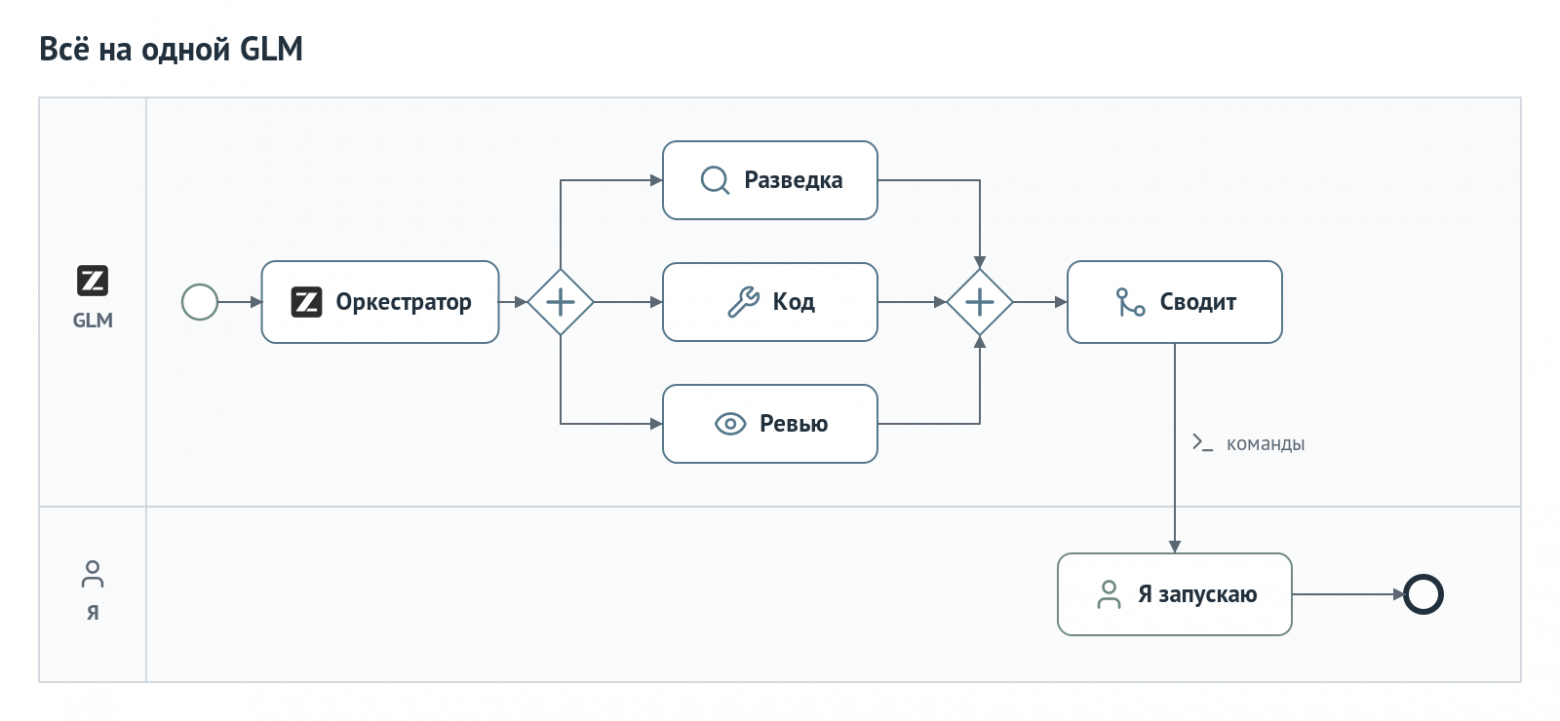
Текстом: всё на одной GLM
Оркестратор GLM раздаёт задачи субагентам.
Субагенты параллельно делают разведку, код и ревью.
Оркестратор сводит результат и даёт мне команды.
Запускаю их я сам.
Интерфейс ZCode приятный, всё нужное нашлось. Но он не такой «сладкий», как у Kimi. У Kimi он прямо пряничный: хочется всё потыкать и посмотреть, видна рука хорошего дизайнера и маркетолога. Но выбираю я всё-таки по рабочему процессу.
А процесс у меня давно не «написал промпт — выкатил в прод». Песочница, тесты, симуляция, нагрузочный тест, и только потом прод. Даже сессия на простой фикс может идти около двух часов, в основном из-за проверок вокруг.
GLM подхватила проверки и весь цикл. Правило «сам не публикуй, только дай команды» пришлось повторить отдельно, но об этом ниже.
И весь этот цикл у меня стал примерно раза в три быстрее, чем с Claude Code. График «скорость 3×» рисовать не буду, задачи не один в один. Но на прод всё выходит заметно быстрее.
5.5. Reasoning: почему я начал с High
Ещё до перехода я читал, что у китайских моделей лютый thinking, который нельзя выключить, и за него тоже идут токены. Проверил. У Kimi K3.1 Pro thinking не выключается, есть low/high/max. У GLM-5.3 тоже не выключается: в Coding Plan none превращается в low. ZCode предлагает Low/High/Max, по умолчанию стоит Max.
Kimi считает рассуждения в токенах, GLM тоже (а Coding Plan ещё и по-разному взвешивает вход, кэш и выход). А вот какой-то аналитик, которого я читал, писал, что Claude за мысли не берёт. Это неправда: thinking у Claude оплачивается как обычные output-токены, даже скрытый. И у нынешних Opus 5.5, Sonnet 5.5 и Fable thinking тоже полностью не выключается. Так что это не «китайцы против остальных».
В Claude мне нравилась подача: мысли свёрнуты и по умолчанию скрыты. Видишь индикатор «thinking» и спокойно ждёшь. Мне вообще всё равно, о чём модель думает, и я бы хотел, чтобы так делали все.
Жалобы на расход есть у всех: пользователь K3 на max упёрся в лимит за 20 минут, на GLM-5.3 тоже жалуются.
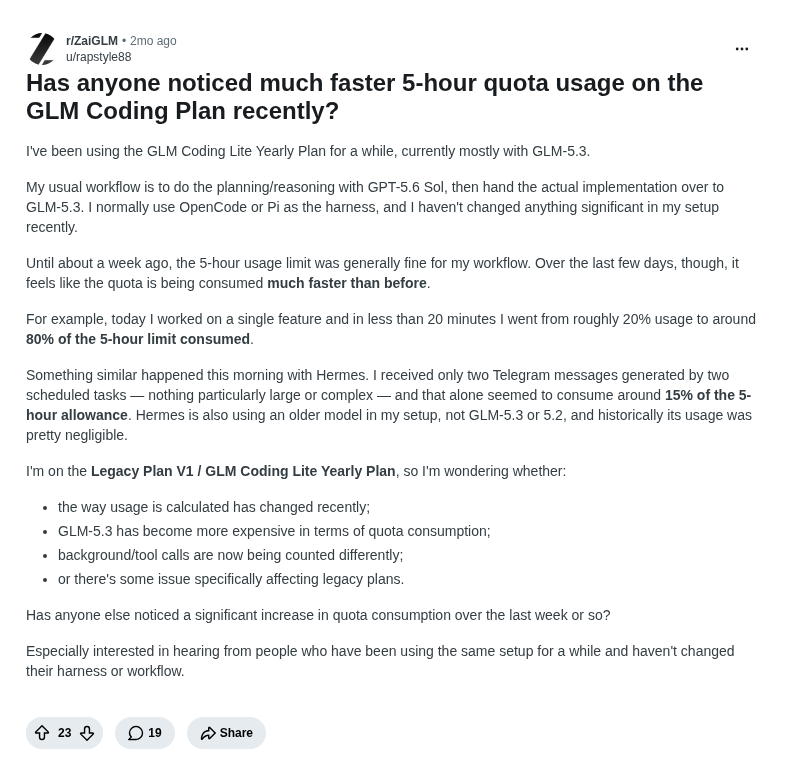
Reddit, r/ZaiGLM — ускоренный расход пятичасовой квоты.
Мой совет: для повседневных задач сразу ставьте High вместо Max. Уровни там Low/High/Max (у Kimi такие же), и почему средний назвали High, для меня загадка. Я сам долго называл верхний «ультра».
На GLM я выставил High, а контекст в этот раз руками не урезал. Жри токены, делай задачу :) Привычку разбивать работу на мини-агентов и не тащить всё в основной разговор это, конечно, не отменяет.
High мне советовал и Gemini, а в голове сидела цифра «3% качества за 30% токенов». По тесту самой Z.ai похоже на правду: Max даёт около +3 пунктов за полтора раза больше вывода (цифры на графике). Думаю, эти три пункта многие готовы отдать.
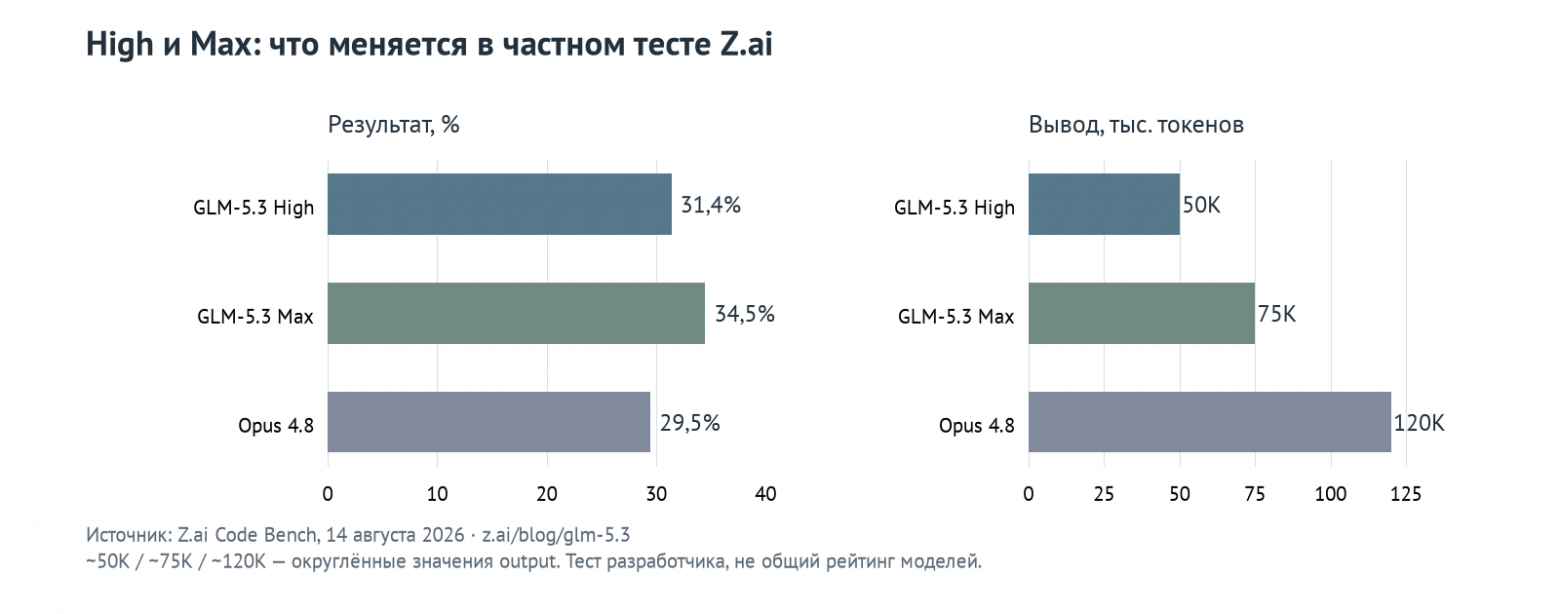
По данным Z.ai от 14 августа 2026: High — 31,4% при ~50K выходных токенов, Max — 34,5% при ~75K, Opus 4.8 — 29,5% при ~120K.
Текстом: GLM-5.3 High и Max в тесте Z.ai
Модель | Результат | Выходные токены, округлённо |
|---|---|---|
GLM-5.3 High | 31,4% | ~50K |
GLM-5.3 Max | 34,5% | ~75K |
Opus 4.8 | 29,5% | ~120K |
Z.ai Code Bench от 14 августа 2026.
Сама Z.ai, правда, рекомендует Max для сложного кода. Упорный баг можно и на Max погонять, но не каждое же переименование переменной.
5.6. Пробный доступ, контекст и лимиты
Начинал я с бесплатного доступа: заходишь, а тебе сразу дают токены, попробуй. Сейчас это пять дней, каждый день 3 млн токенов GLM-5.3 и 2 млн GLM-5-turbo.
На бесплатном доступе модель регулярно останавливалась посреди задачи: сервер занят, подождите. Дёргаешь её, пишешь continue, едешь дальше. Помните ранний DeepSeek? В январе 2025 на него жаловались ровно на это. Очень похоже.
Для бесплатной пробы это нормально, неловко даже жаловаться на бесплатного кодового агента. Хотя и платный тариф от этого не страхует: на Reddit человек видел “system is busy” и на бесплатном, и на Lite, и на Pro.
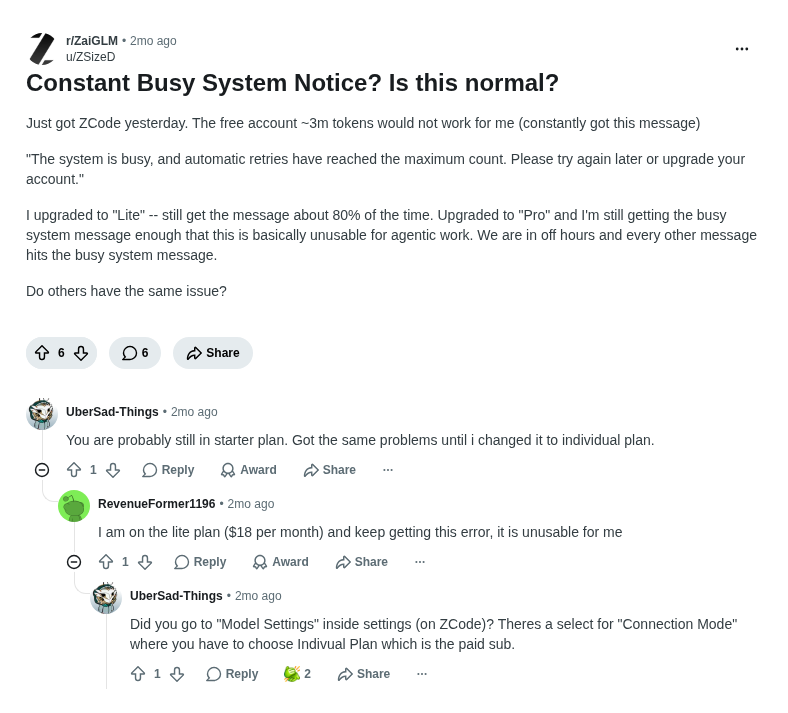
Reddit, r/ZaiGLM — System is busy на бесплатном и платных планах. Рекламный блок между постом и комментариями вырезан.
У GLM-5.3 окно 1M. Крутая фишка, но после длинного чата в Kimi заполнять его не хочется. Стараюсь даже до 500K не доходить: разбиваю работу на мини-агентов, как и с Claude Code. Кстати, Revolut для своей нагрузки тоже выбрал около 256K: контекст, кэш и параллельность делят одни и те же ресурсы, даже если модель умеет миллион.
С лимитами стало заметно приятнее. Нет этого ощущения, что через двадцать минут или час всё, приехали. С параллельными агентами квота тоже кончается, но у меня условно через три часа, а не через час. Потом около двух часов паузы: кофе, прогулка, и дальше работаешь. Хоть работать можно, ура.
Ну и чтобы не было ощущения рекламы: на linux.do Pro-подписчик пишет, что квоты ему хватает, а качеством GLM-5.3 он разочарован. Бывает и так.
5.7. А при чём здесь Revolut
На этой неделе все обсуждали, как Revolut перевёл разработку на собственное развёртывание GLM. Ну, мол, все сейчас берут ИИ себе в контур, но они взяли не OpenAI и не Claude, а развернули GLM-5.3. Когда я сам попробовал модель, подумал: кажется, понимаю почему.
Первоисточник — доклад «Shipping like a startup, regulated like a bank» от 13 октября 2026. David Abitbol, Ops & Infrastructure Leader в Revolut, рассказывает, что около 2 000 инженеров работают на GLM-5.3, которая крутится на 56 NVIDIA B200 (это поколение Blackwell).
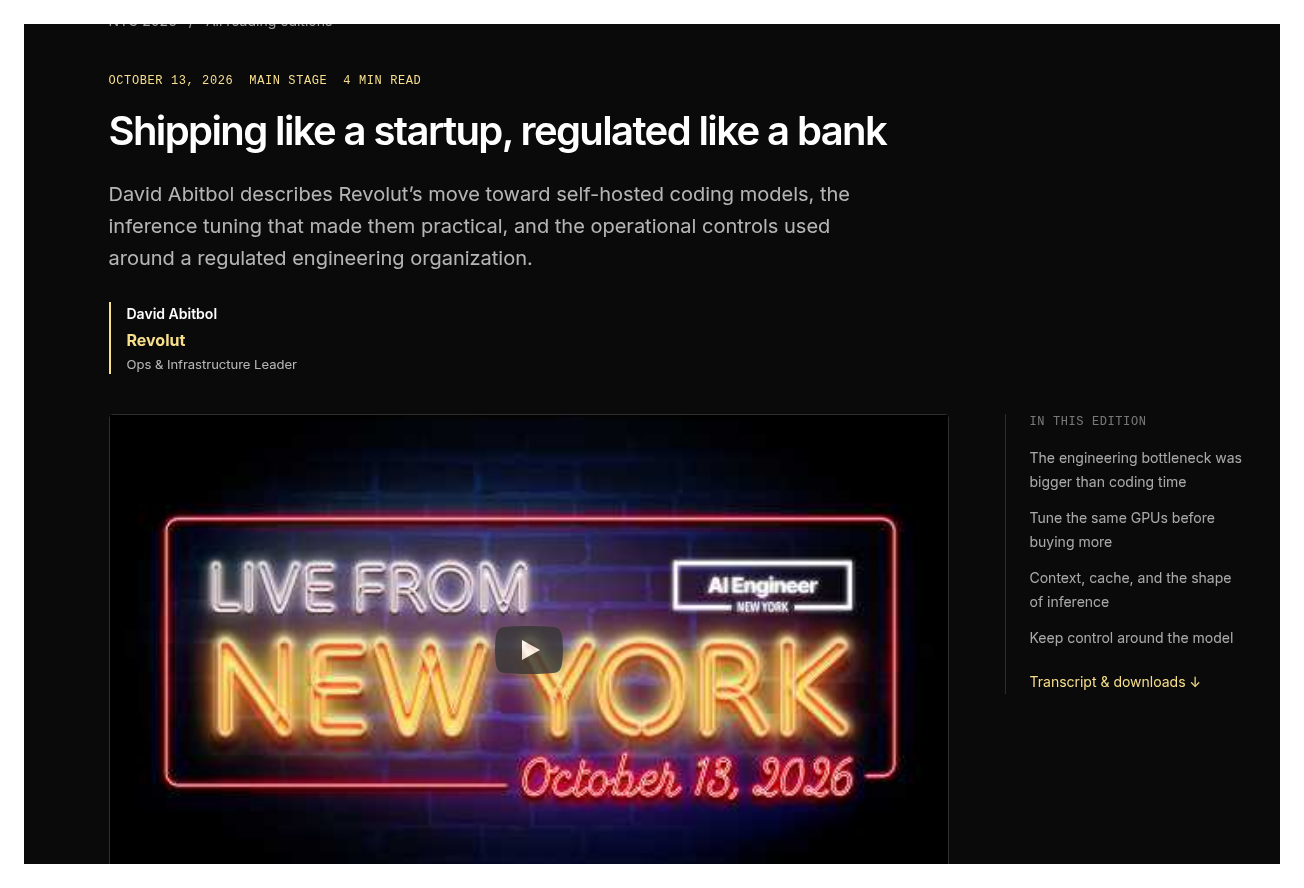
Доклад на AI Engineer, 13 октября 2026. David Abitbol, Ops & Infrastructure Leader.
Начинали они ещё в апреле с GLM-5.1, просто обсуждение разошлось на этой неделе после материала The Register. Claude и Codex они не выкинули, оставили для сложных случаев. По словам Abitbol, вышло около $0,30 за миллион токенов, а счёт — примерно десятая часть прежнего.
На HN self-hosting в основном хвалят, хотя один участник назвал замену Opus на безлимитную GLM ухудшением. Мне в этой истории близка сама свобода нормально пользоваться моделью, не оглядываясь.
5.8. На что похоже качество и чего жду дальше
Без всяких преувеличений: GLM-5.3 на High по ощущениям — это примерно Claude Opus 4.8, может, чуть ниже. То есть Claude, с которым я работал несколько месяцев назад (я сначала сказал «полгода», но Opus 4.8 вышел 28 мая).
На чём это ощущение основано:
Задачу довела до результата. Не остановилась на обещании собрать приложение.
Вместе прошли дебаг. Было что запускать, проверять и чинить.
Иногда всё ещё надо подталкивать. Не всё продумывает наперёд.
Например, почему бы сразу не проверить устройства ввода и вывода? После замечания дописала, а на часть других не отреагировала. Выдать цель и забыть пока не получается.
Но и Claude несколько месяцев назад приходилось подпинывать: на одном B2B-портале я сам расписывал ему flow как ТЗ. Разница с Grok в том, что GLM не останавливается на «дальше нужно продумать архитектуру» и не требует разжёвывать каждый следующий шаг.
GLM не равна Claude по всем тестам. Она просто уже достаточно хороша, чтобы я на ней работал.
Помните, что я сказал в начале? Я и в 2023 году чуть не упал от того, какое качество кода выдавал Claude. Думал, что лучше уже быть не может. А сейчас вот сижу и жалуюсь, что он, видите ли, не продумал мне архитектуру заранее…
Claude тоже не стоит на месте. Opus 5.5 вышел 22 сентября. В какой-то момент я вообще подумал: а что может быть лучше? Это же пик. Меня особенно впечатлили 3D и CAD: ещё полгода назад это была, пожалуй, единственная большая дыра, которую Claude не закрывал. Многие, кто работает с 3D, поймут, о чём я.
Банят, кстати, не только русских: 12 октября Anthropic написала о десятках тысяч банов за дистилляцию и отдельно обвинила Zhipu (это и есть Z.ai) в извлечении кибервозможностей для GLM-5.3.
Я не думаю, что китайцев это остановит. Если следующая GLM через полгода выдаст уровень нынешнего Opus 5.5, мне этого хватит. Дистилляцией, своим обучением или смесью — не знаю.
А если Claude уйдёт ещё дальше, я не расстроюсь. Мне не обязательно быть на первой строчке рейтинга, мне надо закончить задачу.
6. Безопасный порядок работы: кто его вообще соблюдает
Был ещё один критерий, о котором я сначала даже не думал: кто из агентов удерживает границу между «подготовил» и «сделал без меня»?
6.1. Сначала denied раздражало. Потом начал ценить
В Claude я постоянно видел «auto mode denied», «bash denied». Команда не запускалась, агент выдавал её текстом, я проверял и запускал сам. Например, выкатку на прод. Сначала это бесило. Кто-то над этим смеялся, кто-то просто не понимал зачем. А потом я понял прикол, особенно перед публикацией: лишний раз ничего не удалится и ничего лишнего не уедет в прод.
Устроено это так: в Auto mode действия проверяет классификатор, и деплой в прод, миграции и всё разрушительное по умолчанию считаются рискованными. После 3 блокировок подряд или 20 всего он просто спрашивает человека, аккаунт за это никто не банит. Бывает ещё «no verdict», когда сервис просто не смог проверить действие.
6.2. Кстати, про YOLO у Kimi
Мне казалось, что автомода у Kimi нет и надо руками включать его в каком-то YOLO-файле. Память снова подвела.
Автоматические режимы есть. По умолчанию стоит Always Ask: чтение пропускает, про изменения и команды спрашивает. Ask When Needed — это бывший YOLO, Never Ask — Auto. Включаются через /yolo или /auto, можно прописать в конфиге, отдельный файл не нужен.
Отключать подтверждения всем подряд не советую.
6.3. Риски — не только форумная страшилка
Про риски, кстати, американские лаборатории говорят прямо. Anthropic подала S-1 26 октября 2026, а 2 ноября вышла поправка S-1/A.
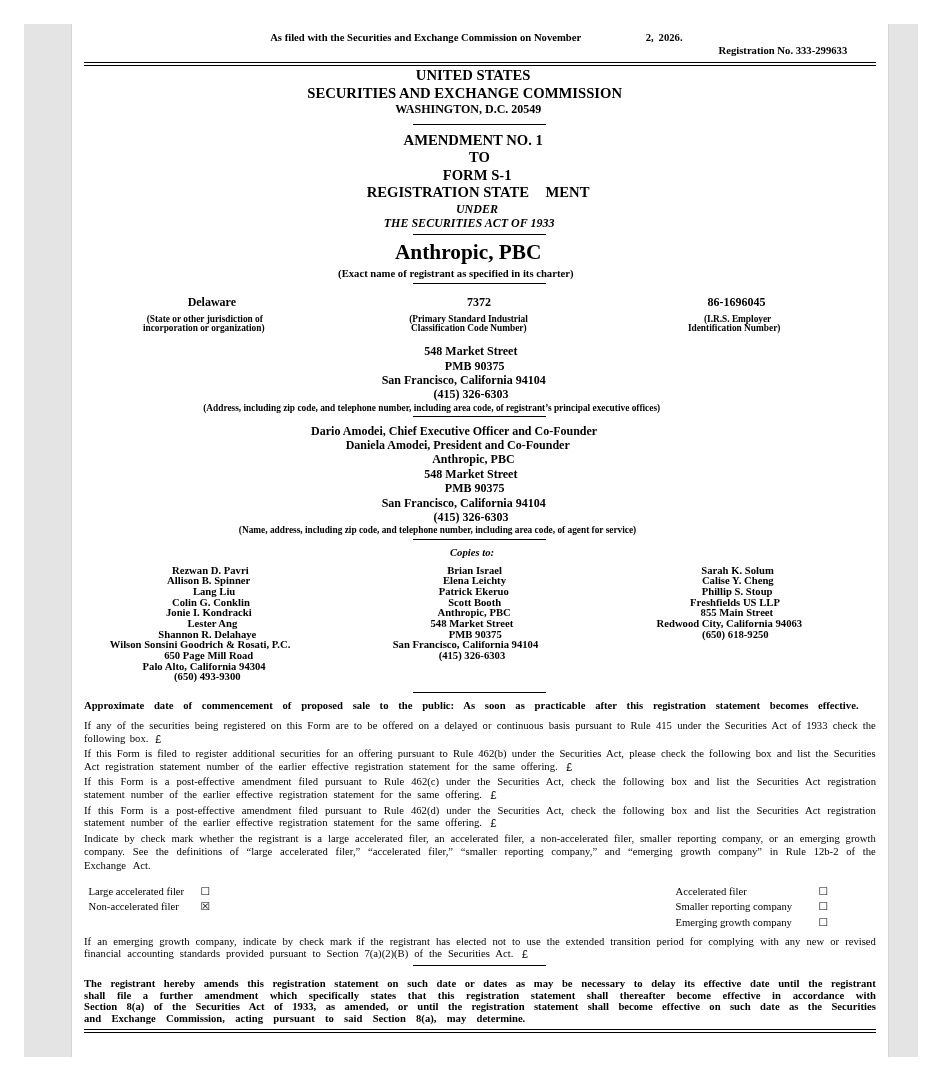
SEC, Amendment No.1 от 2 ноября 2026. Подача документа — ещё не IPO.
В разделе Risk Factors, печатная страница 47, написано:
“…could, if not developed, deployed, and operated with appropriate safeguards, oversight, and security measures, pose catastrophic or existential risks to humanity…”
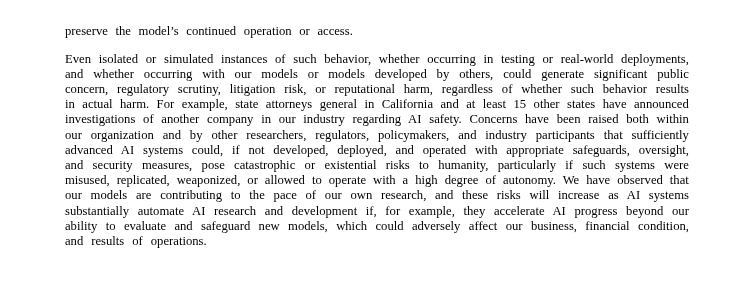
SEC, Amendment No.1 от 2 ноября 2026, Reg. No. 333-299633, Risk Factors, с. 47.
В документе для инвесторов компания сама пишет, что ИИ без должных мер защиты может нести катастрофические и даже экзистенциальные риски для человечества. Рядом — про автономных агентов и удаление данных раньше, чем вмешается человек. Это раскрытие рисков, но формулировка сильная.
И это не только бумага. В июле 2025 Jason Lemkin рассказал, как Replit удалил рабочую базу вопреки code freeze, а потом уверял, что восстановить ничего нельзя. Rollback, к счастью, сработал.
Alexey Grigorev описал, как 26 февраля 2026 агент выполнил terraform destroy с перепутанным state и снёс прод вместе с базой. AWS восстанавливала примерно сутки, а ручную проверку автор ввёл уже после.
А в GitHub-жалобе просьбу «дай команду на удаление» агент, по словам автора, превратил в выполнение, да ещё для другого файла (февраль, v2.1.37, режим Accept Edits).
Поэтому мне и нравится граница «дай готовые команды, но не запускай». Страна и модель тут ни при чём, просто ошибка не должна разнести всё вокруг.
И я почти уверен, что такие защиты появляются не на пустом месте. Anthropic работает с enterprise, и где-то Claude наверняка что-то удалял (может, по кривому промпту не самого опытного инженера). Кто сидел на тикетах и слышит обратную связь от клиентов, меня поймёт.
6.4. Перенеслись инструкции. А граница публикации?
Правила у меня прописаны в документации и памяти: что готовим, что проверяем, что публикуем только руками. Этот порядок я выстраивал с Claude очень долго. И мне было интересно: подхватят ли его другие модели?
Получилось так:
Агент | Что наблюдал | После просьбы не публиковать самому |
|---|---|---|
Claude Code | В моём процессе готовил команды, чувствительные действия оставались мне | К этому я и привык |
Kimi Code | Начал править рабочую копию в обход нашего порядка работы с Git и не предупредил. Я заметил в самом начале и откатил | Удержать порядок так и не получилось |
Grok Build | Сначала давал команды, потом начал публиковать сам | Иногда всё равно публиковал сам |
GLM в ZCode | Правило публикации из Claude сам не перенёс | После одной просьбы стабильно даёт готовые команды и для shadow, и для prod, запускаю я |
С Grok я сначала даже не понял, почему мне перестали приходить команды на публикацию. Оказалось, он просто начал публиковать сам. С Kimi хуже: вместо Git она полезла править прямо рабочую копию. Хорошо, что я заметил это почти сразу и поправил где руками, где через другую модель.
GLM понадобилось одно напоминание. После истории с остальными я оценил даже это.
Но права на прод я бы не отдал никому только за послушание. Настоящие границы — это права, изоляция и человек на контрольной точке. Инструкция в Markdown не заменит запрет на сервере.
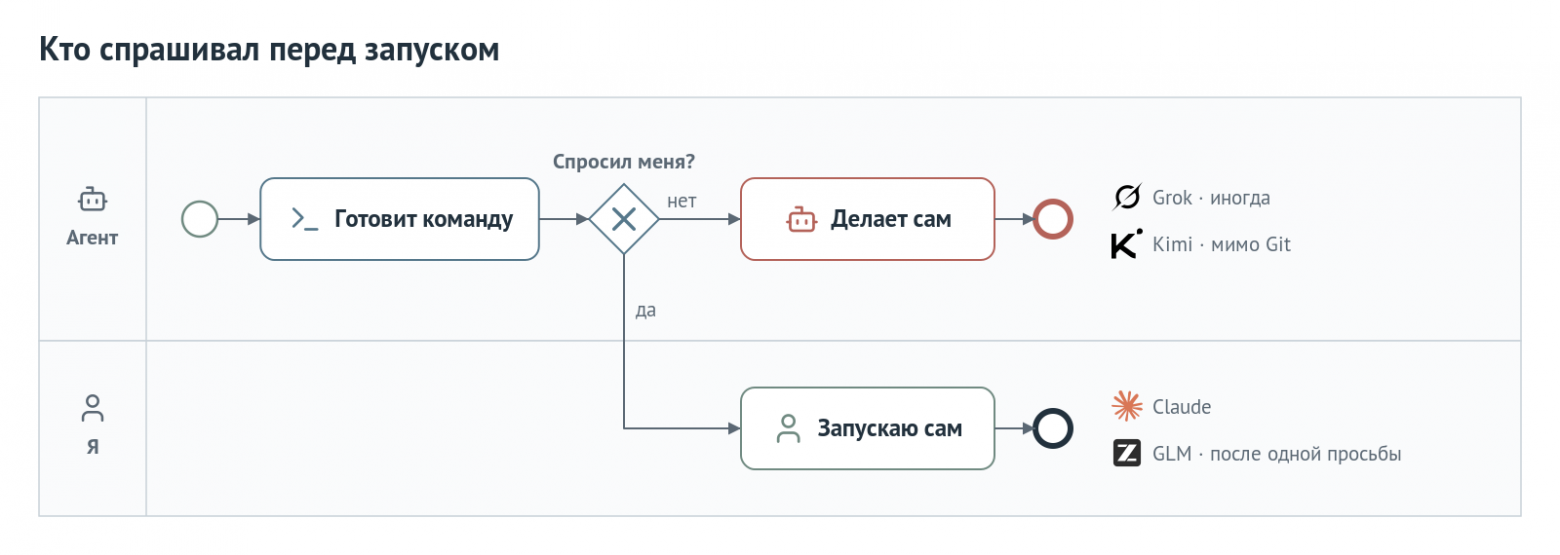
Текстом: ручная публикация у кодовых агентов
Агент | Мой процесс | Ручная публикация |
|---|---|---|
Claude Code | Настроенный flow: подготовка и проверки; готовые команды чувствительных действий. | Запускал я. |
Grok Build | Частично: сначала команды, потом попытки публикации самим агентом. | Даже после напоминания нестабильно: иногда публиковал сам. |
Kimi Code | Правки working tree в обход согласованного Git-порядка; автор заметил в начале. | Нужный порядок не удержала и после напоминаний. |
GLM / ZCode | Роли и тестовый цикл подхватила. Publish boundary сам не перенёсся. | После одной отдельной просьбы стабильно давала команды shadow/prod, не запускала их. |
Для меня безопасный порядок работы — это когда опасный шаг не может пройти незаметно.
7. Чем заменить Claude Code: что выбрал и что из этого вынес
Мой выбор — GLM-5.3 в ZCode, тариф Max. Подхватила мой процесс, после одной просьбы — и ручную публикацию, довела приложение до основы и прошла со мной дебаг. Всех она не победила, но работать мне позволила.
Лимиты есть, подталкивать иногда приходится. Но это уже работа, а не постоянное ожидание следующего окна.
Grok остался для чата и быта. У Kimi мне понравился интерфейс, но не сошлись квота и результат. MiniMax вытянула черновую часть, но связку это не спасло.
7.1. Итоговая таблица: на чём остановился
Весь путь по дням выглядел так:
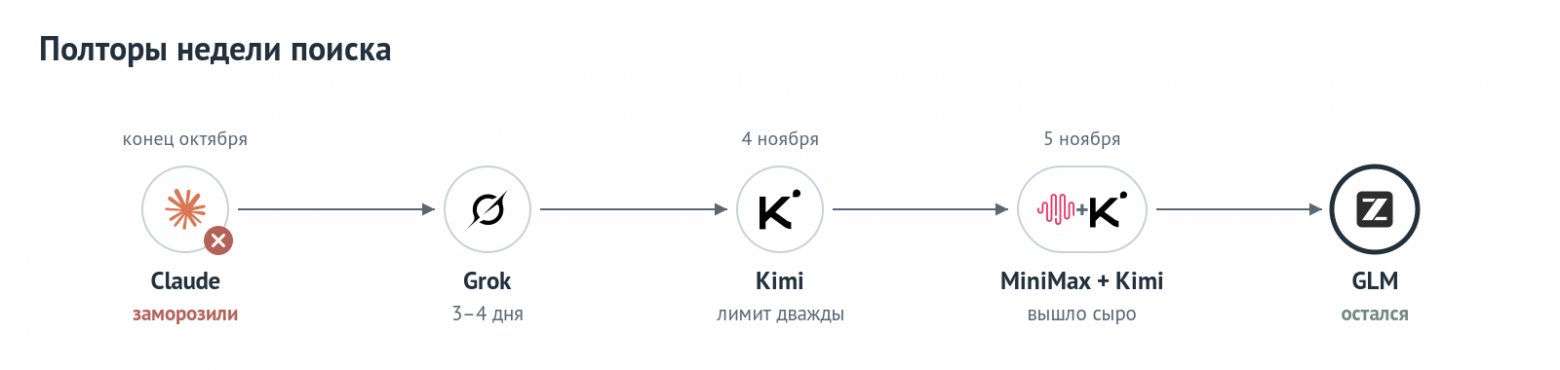
Текстом: поиск замены Claude Code по этапам
Примерно за полгода до Claude: бан в OpenAI, без объяснения причин.
Конец октября 2026: заморозили Claude.
Следующие 3–4 дня: Grok Build. Чат и лимиты понравились, до рабочего MVP не дошёл.
4 ноября, Kimi, первый день: эйфория, один чат примерно на 850–860K, лимит кончился дважды.
5 ноября, Kimi + MiniMax: MiniMax пишет черновики, Kimi собирает и правит. К вечеру лимита снова не хватило. Черновик запустил, вышло сыро.
Дальше GLM-5.3 в ZCode: Lite → Pro → Max. Собрала устанавливаемую основу приложения, вместе прошли дебаг.
Сейчас: остался на GLM, тариф Max. Ручную публикацию держит после одной просьбы.
Даты примерные, интервалы не в масштабе.
А это всё, что я попробовал, в одной таблице:
Инструмент | Цена в месяц | Контекст | Лимиты | Как держал мой безопасный порядок работы | Итог |
|---|---|---|---|---|---|
Было $100, потом два аккаунта по $200 | До 1M, зависит от модели и плана | Пятичасовой и недельный; у verified Ultra пятичасового нет | Давал команды, запускал я | Привычный ориентир, но доступа больше нет | |
$30 → $100 | 256K в Grok Build | Иногда публиковал сам | Оставил для чата и быта | ||
До 1 048 576 с Pro, у Plus 256K | У новых планов 5 часов + месячный пул | Не удержал | Красивый интерфейс, мне не хватило квоты и результата | ||
Go $22 | Только разведка и черновики | Хорошая рабочая лошадка для черновой работы | |||
$18 → $80 → $168 | После одной просьбы — держит | На ней и сижу |
Цены без налогов. У GLM есть ещё годовая оплата со скидкой 30%.
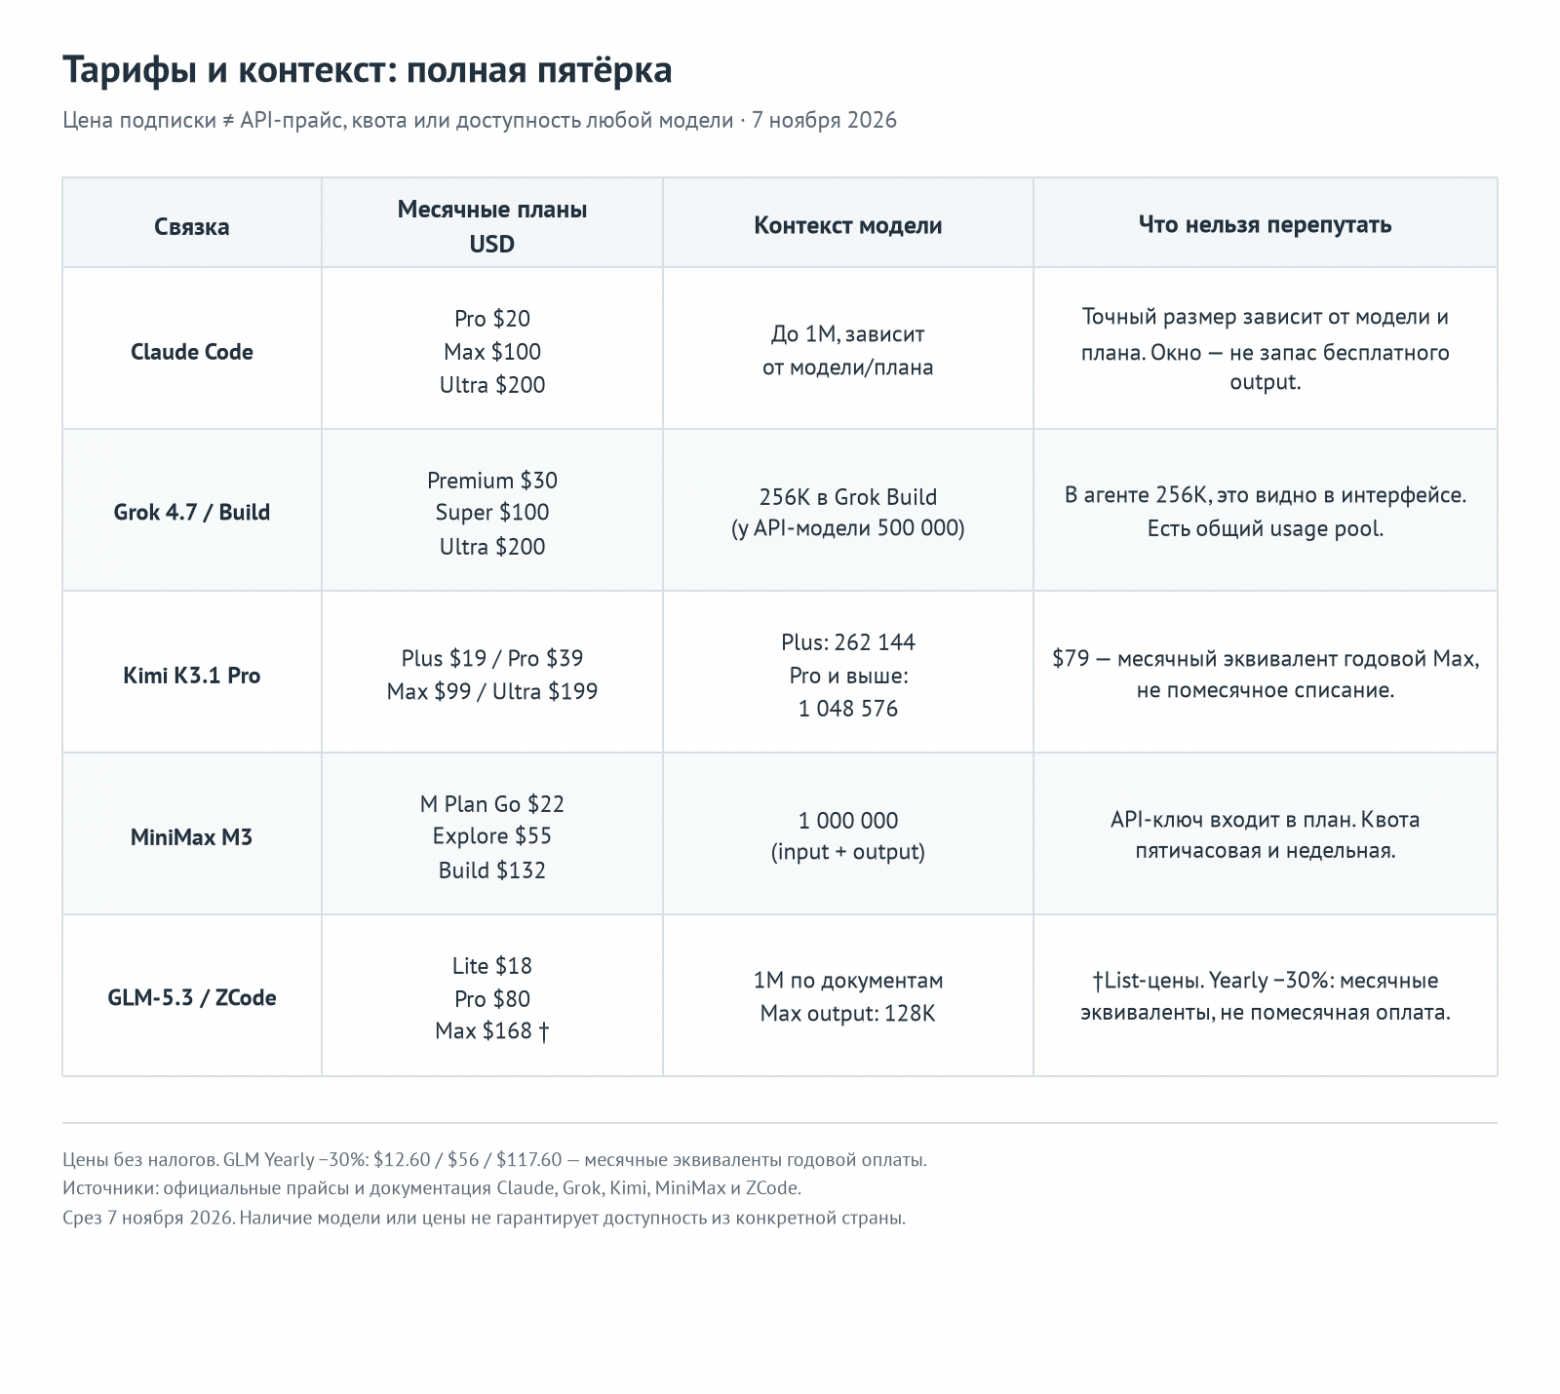
Текстом: цены подписок и контекст пяти связок
Связка | Месячные планы, USD | Контекст | Оговорки |
|---|---|---|---|
Claude Code | Pro $20; Max $100; Ultra $200 | До 1M, зависит от модели и плана | Точный размер зависит от модели и плана. Окно — не запас бесплатного output. |
Grok 4.7 / Build | Premium $30; Super $100; Ultra $200 | 256K в Grok Build (у API-модели 500 000) | В агенте 256K, это видно в интерфейсе. Есть общий usage pool. |
Kimi K3.1 Pro | Plus $19 / Pro $39; Max $99 / Ultra $199 | Plus: 262 144; Pro и выше: 1 048 576 | $79 — месячный эквивалент годовой Max, не помесячное списание. |
MiniMax M3 | M Plan Go $22; Explore $55; Build $132 | 1 000 000 (input + output) | API-ключ входит в план. Квота пятичасовая и недельная. |
GLM-5.3 / ZCode | Lite $18; Pro $80; Max $168 † | 1M по документам; Max output: 128K | †List-цены. Yearly −30%: месячные эквиваленты, не помесячная оплата. |
Срез на 7 ноября 2026, цены без налогов. GLM Yearly со скидкой 30%: $12,60 / $56 / $117,60 в месяц при годовой оплате. Обозначение 1M оставлено как в документах вендоров.
7.2. На маркетинговый крючок Kimi я всё-таки попался
Да, попался: красивый интерфейс и громкие обещания, а потом квоты и ещё день на экономию токенов вместо результата. В следующий раз сначала прогоню задачу целиком, а радоваться буду потом. Если у вас с Kimi всё сложилось, расскажите, как настроили.
7.3. А где российские модели?
Российских моделей в списке нет, потому что я их не тестировал. На этом объяснение заканчивается :)
Для справки: кодовый ассистент у Сбера называется GigaCode. Desktop-версия доступна индивидуальным разработчикам, а команда пишет про Universal Agent. Сам не прогонял.
Если вы работаете с GigaCode или другим российским решением — напишите в комментариях: какие задачи, какой размер проекта, сколько пришлось сопровождать руками и сколько это стоило.
7.4. Как с этим жить дальше
Для себя я вынес несколько вещей:
Код, ТЗ и инструкции держу у себя. Репозиторий, документы, задачи, решения — всё, с чем можно продолжить работу с другой ИИшкой.
Чаты и настройки сохраняю заранее. Если продукт умеет экспорт, лучше сделать его до бана. Ключи отдельно.
Переносимый порядок работы важнее любимого интерфейса. Skills, роли, критерии готовности переносим, а потом проверяем, как новый агент их понял.
Модель и агентный фреймворк оцениваю вместе. Обвязка должна читать файлы, вызывать инструменты, следить за контекстом и не забывать доделать задачу.
Большой контекст — это не безлимит. Кэш, вывод, thinking и параллельные агенты съедают квоту быстрее, чем кажется по цифре 1M.
Смотрю на законченный результат. Для меня это установка, запуск, дебаг и возможность двигаться дальше.
Решать вам. Я свой выбор пока сделал, и меня он устраивает.
Танцы с бубнами вокруг Claude устраивать пока не буду. Ценить его я не перестал, просто хочу делать продукт, а не гадать, сколько ещё проживёт аккаунт.
Мне не обязательно сидеть на первой строчке рейтинга. Мне нужен инструмент, который доводит мою работу до результата. Сейчас это GLM-5.3.
Ссылки
Telegram-канал — https://t.me/notes_from_cto. Регулярные технические заметки про инфру, локальный ИИ и железо. Буду рад, если зайдёте и останетесь.
Если есть что сказать по теме — на что пересели сами, где ваш переезд прошёл иначе или где я перемудрил, — пишите на cdv.inbox@gmail.com, Чащин Дмитрий. Буду рад обратной связи.