Комментарии 35

А что про локальные модели думаешь? Что пробовал ?

Пробовал Qwen 3.8 max - там тоже , пишешь обычный чат-запрос , ок. Как только опускаешься в код, то пишет откровенную чушь и за ним нужно следить.
Deepseek flash себя неплохо показал на удивление, я его не вписал в рейтинг, потому что решил сделать упор на подписочную историю. Но пока вот мой фаворит GLM5.3

Локальный Квин 3.8 макс? Мощная у вас “локалка” ) Если серьёзно: связка 2х локальных моделей: GLM 5.3 flash 4bit (архитектор, кодер) + Qwen 3.8 Flash Next 5bit (reviewer) = идеальный (ну почти) результат.
Спасибо заказчикам, что позволяют иногда потестировать такие модели, ага :) а она за счет квантификации glm до 4bit , не сильно качество теряется?
Вот цифры: https://huggingface.co/Mia-AiLab/GLM-5.3-Flash-EXL3-4bpw-TensorFold А по опыту - очень хорошее качество. Для 256Гб VRAM - народ или эту сборку берет или Дипсик 1017 2.9bpw

Щас придет Qwen 4 и чпокнет всех.


Пользуюсь Deepseek Flash/Pro для личных целей и Xiaomi Mimo на работе. Обоими вполне доволен, главное не торопиться и задерживаться на этапе планирования, что и как делать.

Mimo 2.6 flash - первая модель за полгода, которая сочинила несуществующий метод в kotlin, хотя у меня зоопарк модей, сильных и не очень, даже убогие minimax m3/m3.1 flash себе такое не позволяли. а вот 2.6 pro - очень хорош
Зато Flash очень сильна в анализе, на мой взгляд. Я сейчас задачи разбираю примерно так: описываю проблему и свои соображения на счёт неё (где может быть проблема, куда смотреть), прошу сделать анализ и выдать список возможных причин. После анализа смотрю, чего нашло, обобщаю анализ, а дальше по ситуации - если по мелочи, то правлю через Flash, если крупные правки - переключаюсь на Pro.

Deepseek Flash - самая рабочая история, кодит великолепно, в контекст 1м токенов ориентируется без проблем, цены - демпинговые (если хороший харнесс, который заточен на экономии за счет кэшированных токенов)... Вот сейчас посмотрел свою статистику за 30 дней: потрачено 1000 китайских юаней (12 300 р.) за 6 миллиардов токенов. По этом, если я буду жестко придерживаться правила, чтобы работать только в offpeak часы, то будет еще дешевле.
Локально ее тестировал. Она мне тоже очен понравилась, но в более комплексных задачах , где много вводных, начинает немного тупить.
Такое было у Клода год-полтора назад. То есть, как замена, чуть ниже, чем glm5.3 лично для меня, но в десятки раз лучше, чем распиаренный Kimi .
Смотря когда и какую версию тестировали, сейчас актуальная версия DeepSeek-V4.1-Flash-1017 . Очень сильно ее подтянули для работы в агентных сценариях и в коде. GLM (благо они любят сейчас бесплатные токены раздвать) как-то сравнивал решения на ней на одной и той же задаче, затем проводил оценку качества кода - Deepseek набирал больше баллов.
На OpenAI Luna столько можно потратить за неделю на 20-баксовой подписке
deepseek хорош, но бесит его не следование правилам. ловишь потом его "за руку", кается, что правила есть, но он их "почему-то" проигнорировал. опасносте, поэтому эта модель у меня только в роли имплементатора сидит, потому что его все равно ревьюер(glm-5.3/mimo-2.6 pro/sol) проверит

На коротких функциях разницу со старшими моделями почти не видно
Но на длинной кодовой базе у него быстро плывет контекст. Если проект больше пары тысяч строк, он начинает тихо терять типы и выдумывать сигнатуры методов в соседних файлах и приходится перепроверять каждый диф руками

Кими 3.1 мне не зашол, он стал тупее своей предыдущей версии, токинов жрет меньше, но и ошибается чаще, а так же проект понимает хуже, притом значительно, GLM 5.3 его явно уделывает.

Много текста ни о чем. Просто берешь OpenCode и туда интегрируешь GLM+Kimi, и по API токенам от OpenRouter используешь дешевые модели вроде Дипсика флеш на быстрые задачи. И с телефона, и с компа, и вообще когда угодно. Лучше чем Claude, разве что тратишь больше слегка.
Буду признателен, если поделитесь связкой, которая у вас получилась, особенно с Kimi. Возможно на api, модель ведет себя лучше. Мой опыт с ней я очень подробно описал . Хотелось понять, где именно мог ошибиться.
Прошу заметить, что речь в статье про то, кто привык именно к Клоду, и кому хочется практически на тот же клод и пересесть, с теми же пользовательскими привычками.
Поэтому, оркестратор с OpenCode конечно же имеет место быть , просто мы с вами про разное, на мой взгляд, говорим
Человек искал решение из коробки, а не конструктор на коленке...

Оплачивали на сайте z.ai? Российскую карту принимает к оплате?
К сожалению, придется через виртуальные карты оплачивать. Карты МИР нигде не принимают.
Кими делали на сутки такую акцию, но затем отменили. И то, пока никто не понял, это была фейк новость или нет.
Я кстати оплатил kimi тиньковым. Буквально недавно.

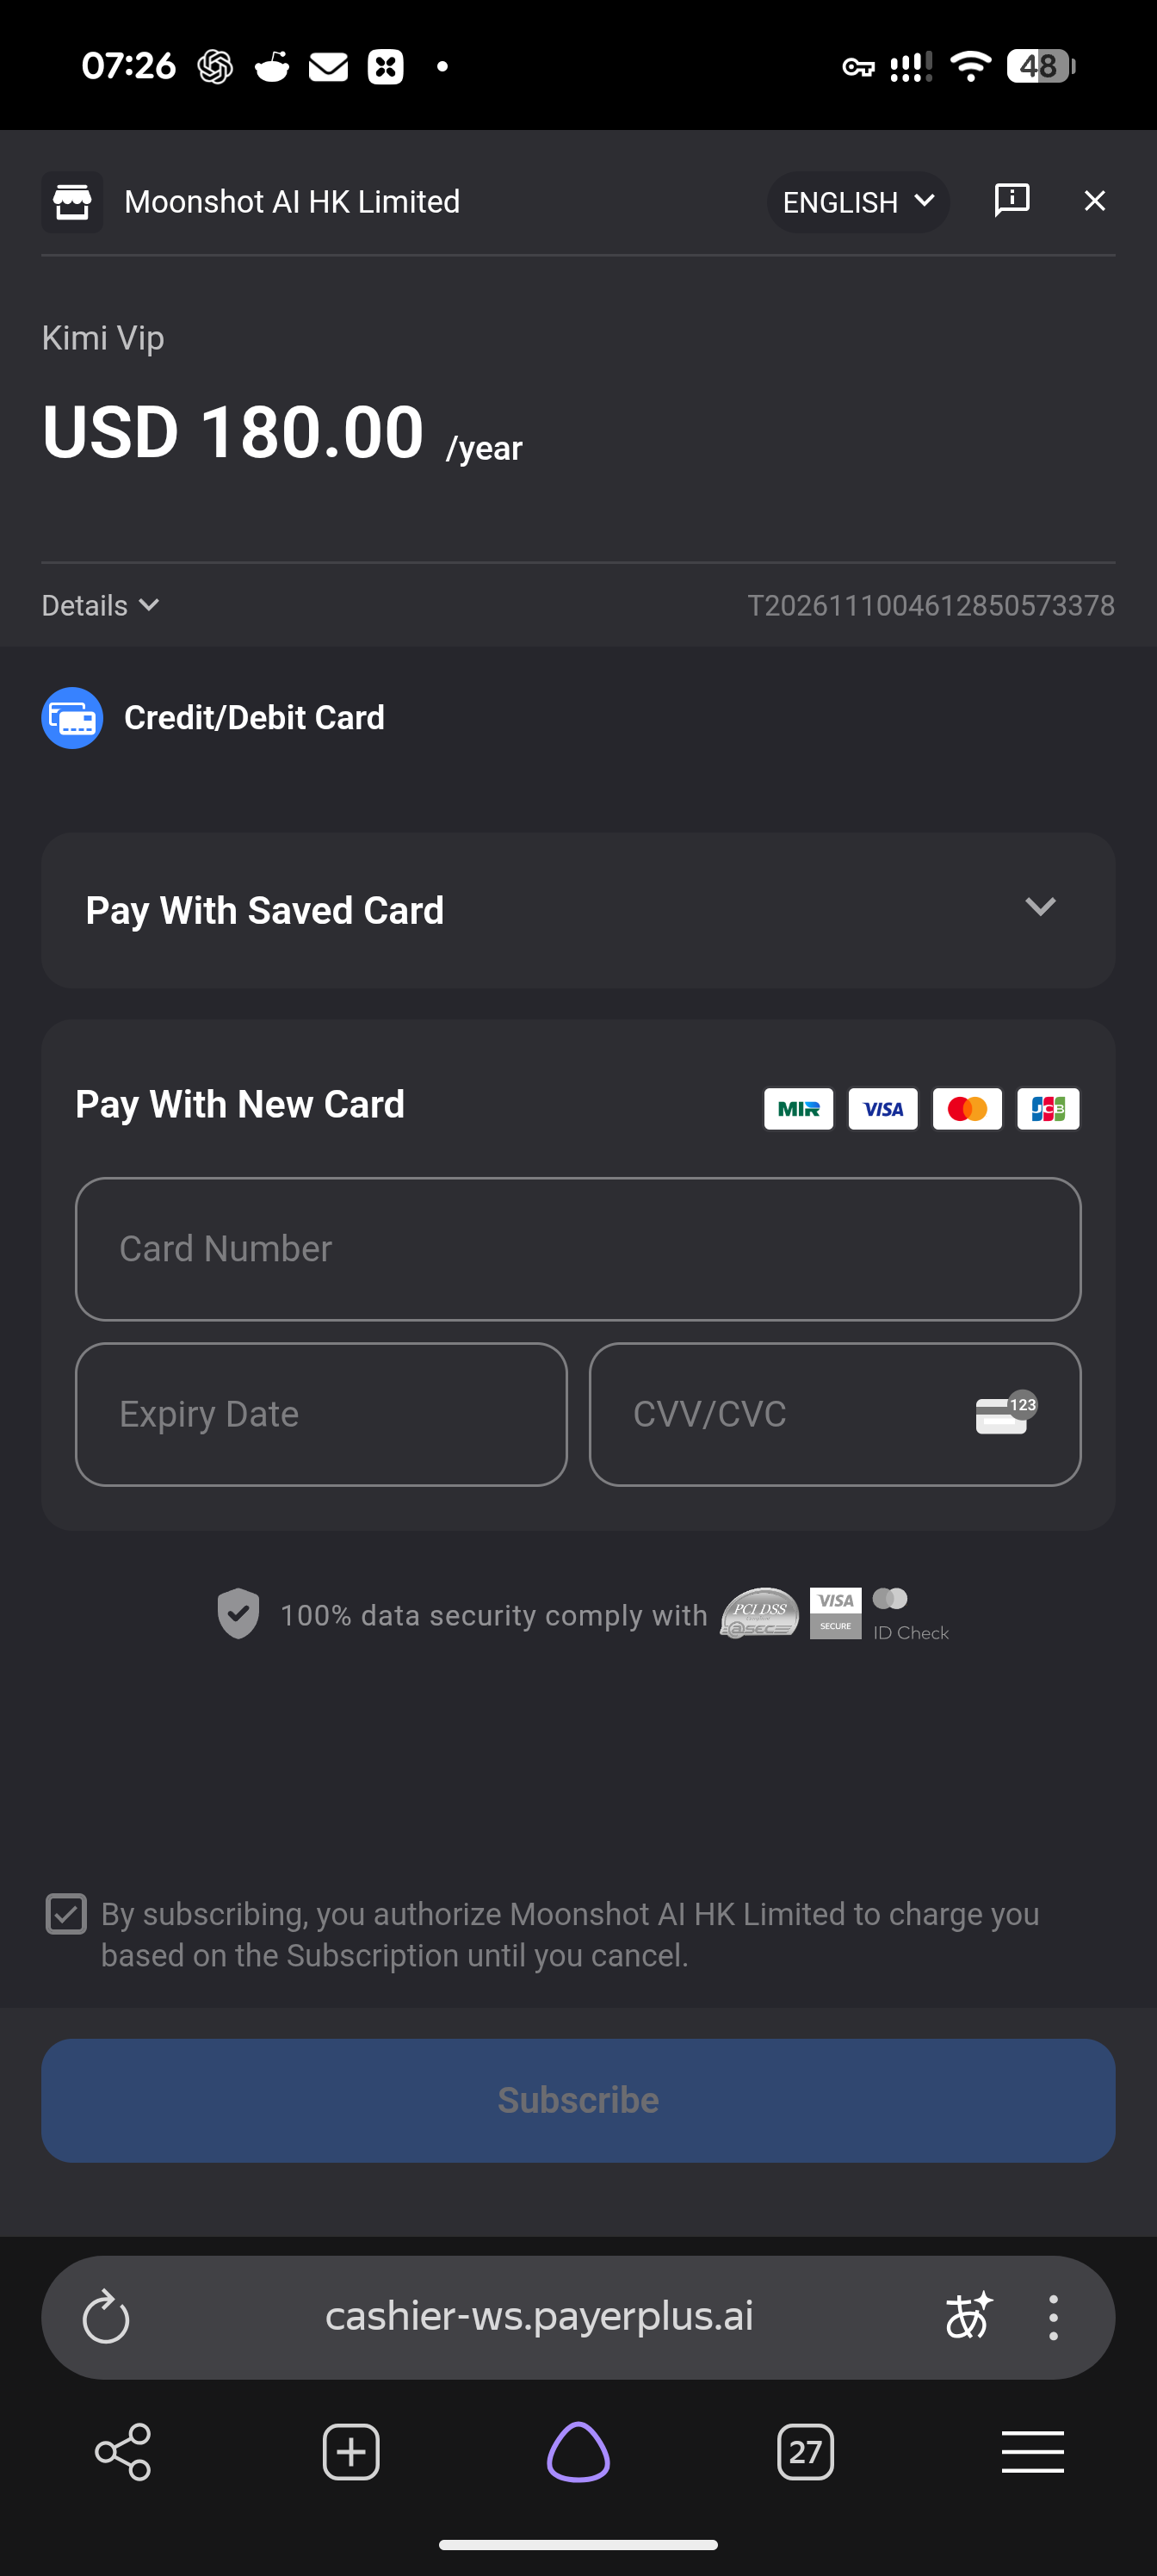
Это кто вам такое сказал? Оплатил прям недавно Kimi картой MIR. Всё они принимают, ничего не убрали. Просто без VPN и с российским DNS заходите к ним на сайт, и будет работать. На скриншоте я зашёл через браузер, который через split tunneling исключен из VPN.

При этом у меня не проходила Google авторизация без VPN, поэтому сначала вошел, потом отключил обход, и смог оплатить картой Мир. Но лимиты после Codex мягко говоря не порадовали. Решил попробовать как запасной вариант на случай, если OpenAI забанят за VPN. Видимо в следующий раз буду пробовать GLM.

Спасибо за статью, и за сэкономленное. Аналогичная ситуация и у меня с клодом. Первым делом побежал в Kimi на подписку. Разочаровался в скорости утечки сессионных лимитов. Побежал в deepseek, взял оплату через api. Понравился весьма, особенно в связке со своим харнессом, надеюсь однажды станет полноценным. Затем попробовал deepseek через подписку ollama, понравилось ещё больше в финансовом плане. Пока сижу так вторую неделю, осталось попробовать GLM, только после опыта с Kimi было боязно, после вашей статьи чуть менее боязно :)
Глм-ка 5.3 на кодовых задачках реально бодро держится, подтверждаю
Но у Z.ai по вечерам регулярно проседает скорость выдачи токенов, когда в Китае рабочий день пересекается с Европой, приходится держать фолбэк на готове

Почти $1000 на поиск замены — мощно 😅 Зато интересно посмотреть на реальный опыт, а не очередное сравнение по бенчмаркам.
Статья специально построена на базе моего личного опыта и не опирается на бенчмарки.
По бенчмаркам вам и нам бесплатно Гугл-ИИ и Алиса условные скажут, что хорошо и что плохо :) Как раз здесь 80% падают в яму маркетинга ( я в воронку точно попал), и покупают подписку на Kimi, который по уровню интеллекта как chatgpt 4o, а стоит как claude Max x5 с лимитами, как будто заплатил не 200$ а 10$.
P.S. какие то бенчмарки я все таки вставлял, но для полноты картины повествования, скорее. Упор на это не делался

тоже попал под блокировку по рос.паспорту.
сейчас тестирую deepseek harness, а также его обвязку через claude code. пока все нравится, токены жрутся терпимо, но хотелось бы меньше. все таки у claude лимиты были действительно большими, даже на 20$ подписке.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Я потратил $956 на ИИ-подписки, чтобы вы знали, на что пересесть вместо Claude Code