

Начнем с небольшого эксперимента. Перед вами три картинки: мышеловка, спичечный коробок и трубкозуб. Какая из них лишняя? Задачка на пару секунд: первые два предмета сделал человек, а третий — живое существо.
А теперь попробуем предложить то же самое мультимодальной нейросети. Шансы получить ответ, совпадающий с человеческим, окажутся не такими уж и большими. В эксперименте исследователей модели семейства Qwen3-VL при прямом опросе показывали результат от 37 до 41%. Для сравнения: случайный выбор в такой задаче дает 33,3%.
Вы, конечно, возразите: нейросеть создавали не для игры в «Третий лишний». Она разбирает изображения, распознает объекты, работает с текстом и справляется с задачами посложнее. Да и результаты популярных мультимодальных бенчмарков у современных моделей вполне приличные.
Только вот умение правильно отвечать на вопросы еще не значит, что модель видит мир так же, как мы. Она узнает и мышеловку, и коробок, и трубкозуба, но лишнее может выбрать по совсем другому признаку. И далеко не факт, что этот признак покажется нам логичным.
Это и разбирают авторы исследования Aligning MLLMs with the Latent Structure of Human Cognition. Обычно мультимодальные большие языковые модели (MLLM) учат выдавать ответы, которые нравятся людям. Ученые предлагают встроить в процесс обучения реальные закономерности человеческого восприятия.
Для этого исследователи взяли данные масштабного психофизического эксперимента, где миллионы человеческих суждений сведены к 66 смысловым измерениям, и построили на них фреймворк CogAlign. Его задача — изменить сам подход к обучению нейросетей: учить модель тем основаниям, по которым выбирает человек. Разберемся, как это устроено.
Почему стандартный alignment сводится к дрессировке ответов
Когда разработчики говорят об alignment, или выравнивании, они почти всегда имеют в виду методы вроде RLHF (обучение с подкреплением на основе обратной связи от человека) или DPO (прямую оптимизацию предпочтений). Оба подхода отлично работают, когда нужно отучить чат‑бота грубить пользователю, заставить его выдавать аккуратные списки и следовать формату инструкции. Но с точки зрения когнитивистики это лишь поверхностная мимикрия.
В RLHF люди сравнивают ответы модели и выбирают удачные. На этих оценках обучают отдельную модель вознаграждения, а уже она подстраивает нейросеть. DPO обходится без посредника: модель учится сразу на парах из удачного и отклоненного ответа.
Полезны оба метода, спору нет. Но у них есть особенность, на которую обращают внимание авторы CogAlign: совпадение итогового ответа с человеческими предпочтениями еще ничего не говорит о том, каким путем модель пришла к этому результату.
Представим, что мы показываем нейросети три предмета и просим выбрать лишний. Она отвечает правильно. Отлично, ставим галочку. Но почему она выбрала этот предмет? Потому что заметила, что два других сделаны из металла? Или потому что в ее обучающих данных похожие изображения чаще встречались в определенном контексте?
В первом случае модель думает по‑нашему. Во втором она угадала, и мы так и не узнаем, повезло ей или она зацепилась за что‑то, чего мы в картинке не видим.
Отсюда и идея CogAlign: учить нейросеть, кроме правильных ответов, еще и тому, на что смотрит человек, когда выбирает лишнее.
Впрочем, не стоит делать выводов, будто RLHF или DPO вообще не способны обучать модели рассуждать. Речь тут все‑таки о другом: стандартная настройка через предпочтения не гарантирует, что нейросеть усвоит человеческие основания выбора. CogAlign как раз и пытается закрыть этот пробел.
Карта человеческого восприятия в 66 измерениях
Возникает логичный вопрос: откуда вообще взялись эти 66 измерений и почему исследователи решили, что они имеют отношение к человеческому мышлению?
В основе работы лежит исследовательский проект THINGS, посвященный изучению того, как люди воспринимают и классифицируют окружающие объекты. В нем собрали 1854 понятия реальных предметов и провели масштабный психофизический эксперимент.
Участникам предлагали играть в тот самый «Третий лишний». Показывали три изображения и просили выбрать предмет, который меньше всего похож на два остальных. Задача максимально простая, и повторить ее можно огромное количество раз с разными комбинациями объектов.
В результате исследователи получили около 4,7 млн человеческих суждений. И это уже совсем другой разговор: вместо отдельных и однозначных ответов появилась большая база данных о том, какие признаки люди используют, когда сравнивают предметы между собой. Но как превратить эти ответы в понятную модель человеческого восприятия?
Эту работу исследователи поручили алгоритму SPoSE (Sparse Positive Similarity Embedding). Он размещает объекты в многомерном пространстве, где у каждого предмета есть набор смысловых признаков. Мышеловка, например, получит высокий балл по измерению «металлическое или искусственное», а трубкозуб — по измерению «животное».
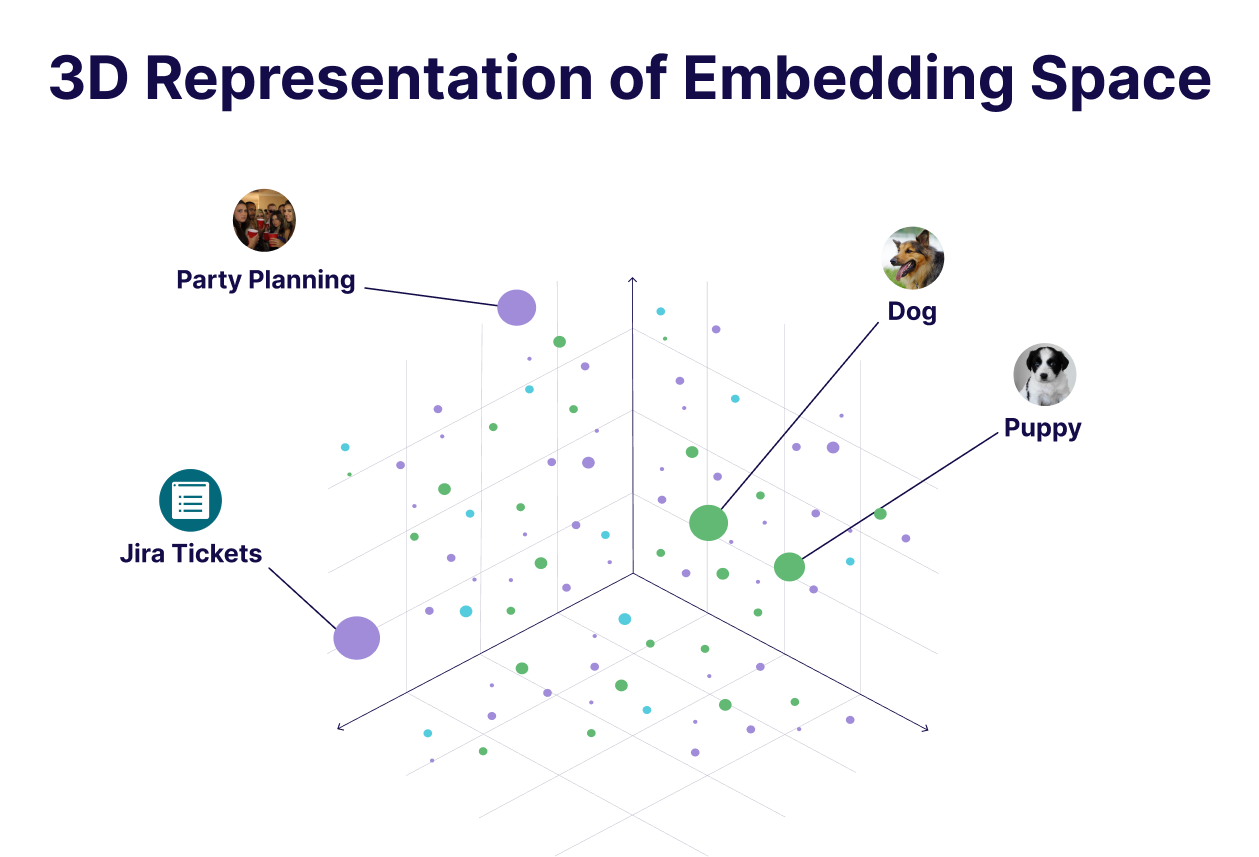
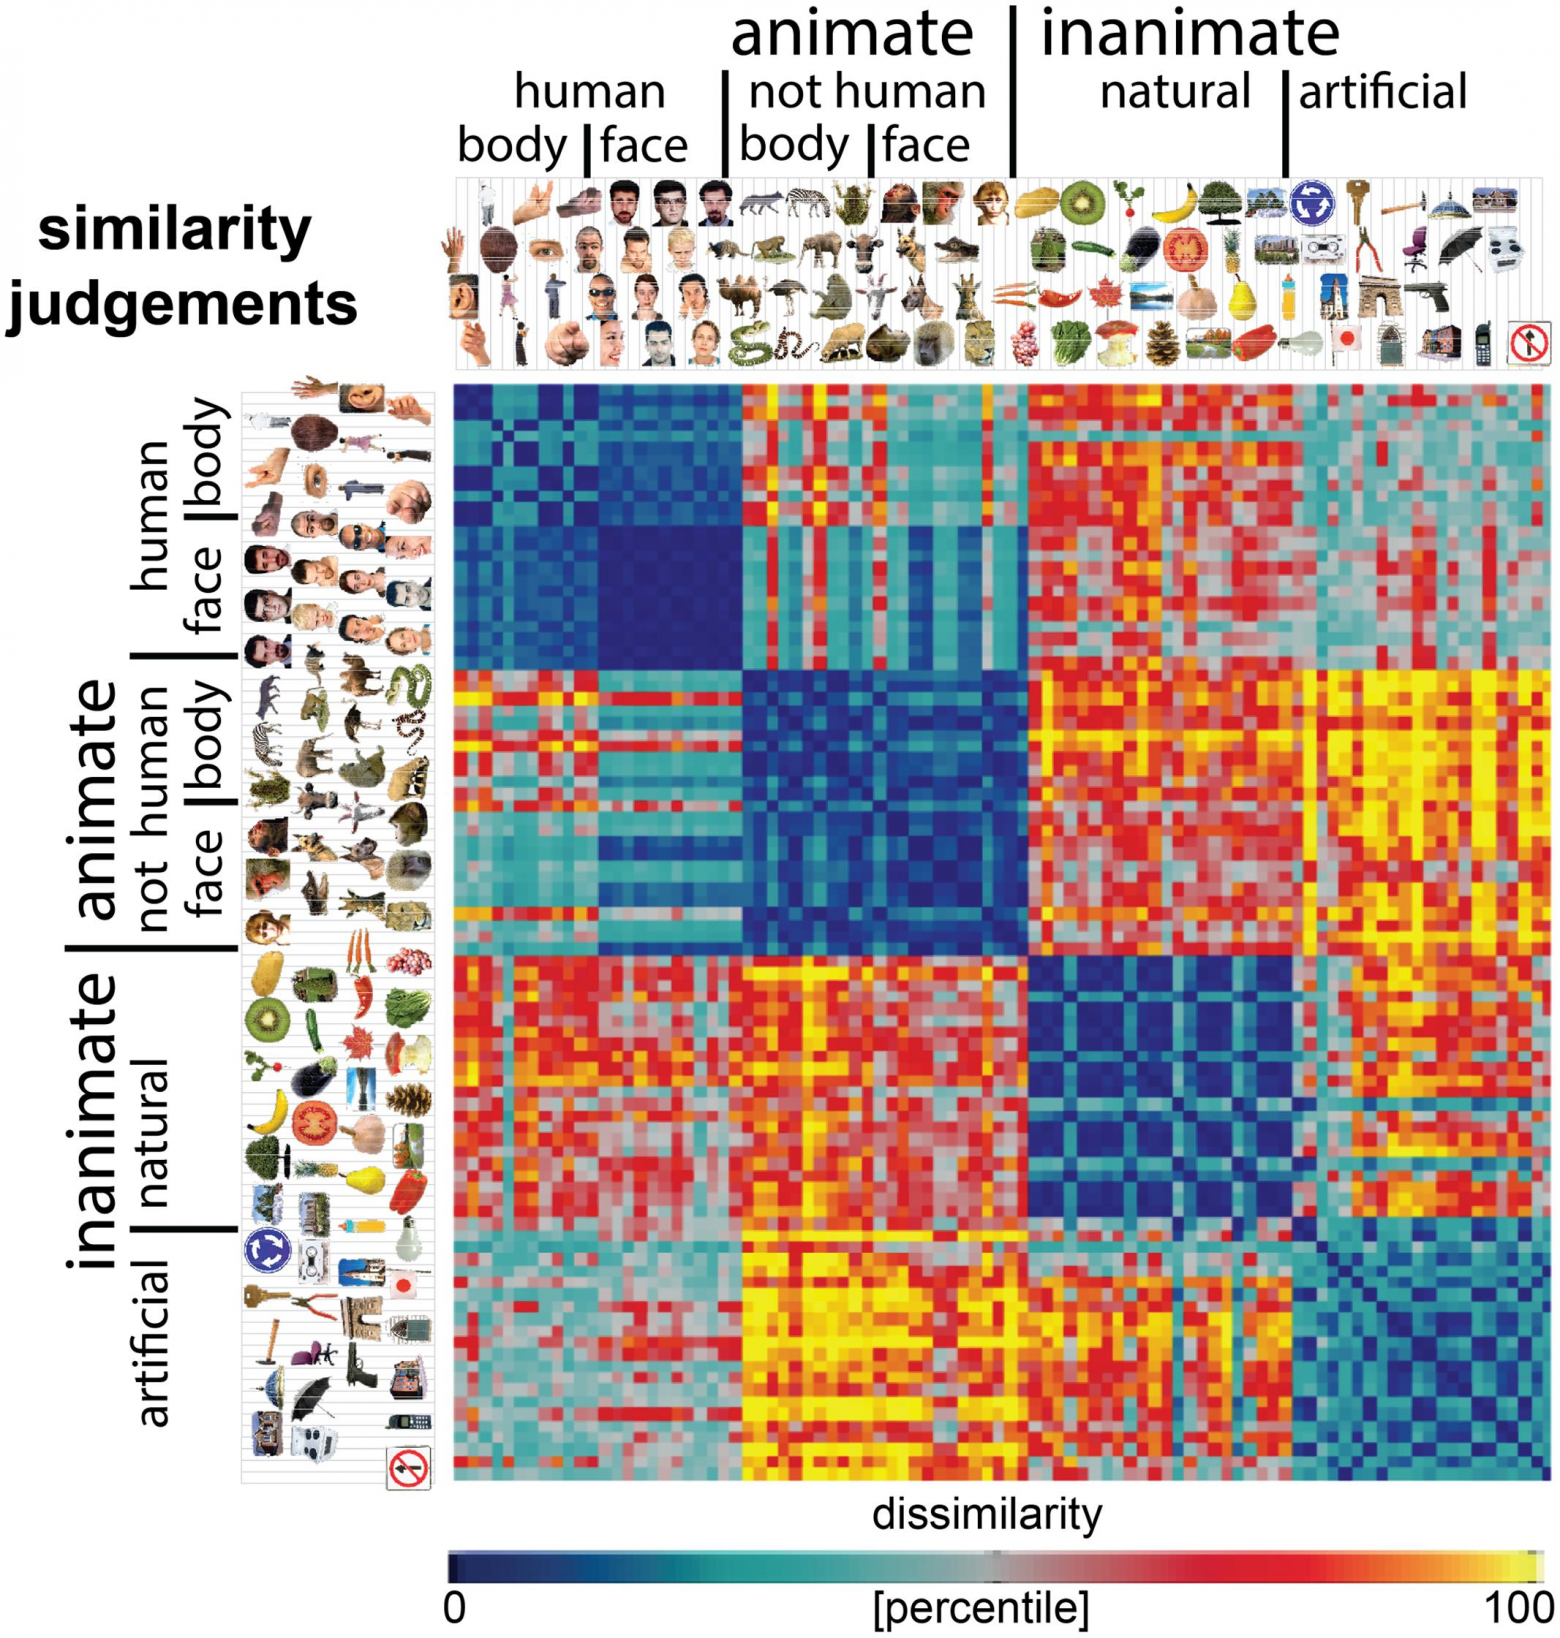
На выходе SPoSE выдал 66 измерений, и у каждого есть понятный человеку смысл. Многие ожидаемы: еда, животные, текстиль, электроника, транспорт, растения. Другие звучат необычнее: круглые предметы, пушистые и мягкие вещи, оружие и опасность, медицина.
Причем некоторые измерения довольно неожиданные. Например, в списке присутствуют стереотипно женственные и стереотипно мужественные признаки. К этому моменту мы еще вернемся.
Важный момент: речь не идет о том, что ученые обнаружили в человеческом мозге ровно 66 универсальных переключателей, отвечающих за восприятие мира. Это математическая модель, полученная из человеческих ответов. Она описывает, какие смысловые и визуальные свойства помогают людям сравнивать объекты.
Эту карту исследователи и решили использовать для обучения мультимодальных моделей. Почему один предмет похож на другой, ИИ теперь не угадывает сам: у него есть готовые критерии.
Как CogAlign превращает сухие векторы в цепочки рассуждений
CogAlign состоит из трех этапов. На первом нейросети вообще не нужны: все делает математическая модель человеческого восприятия.
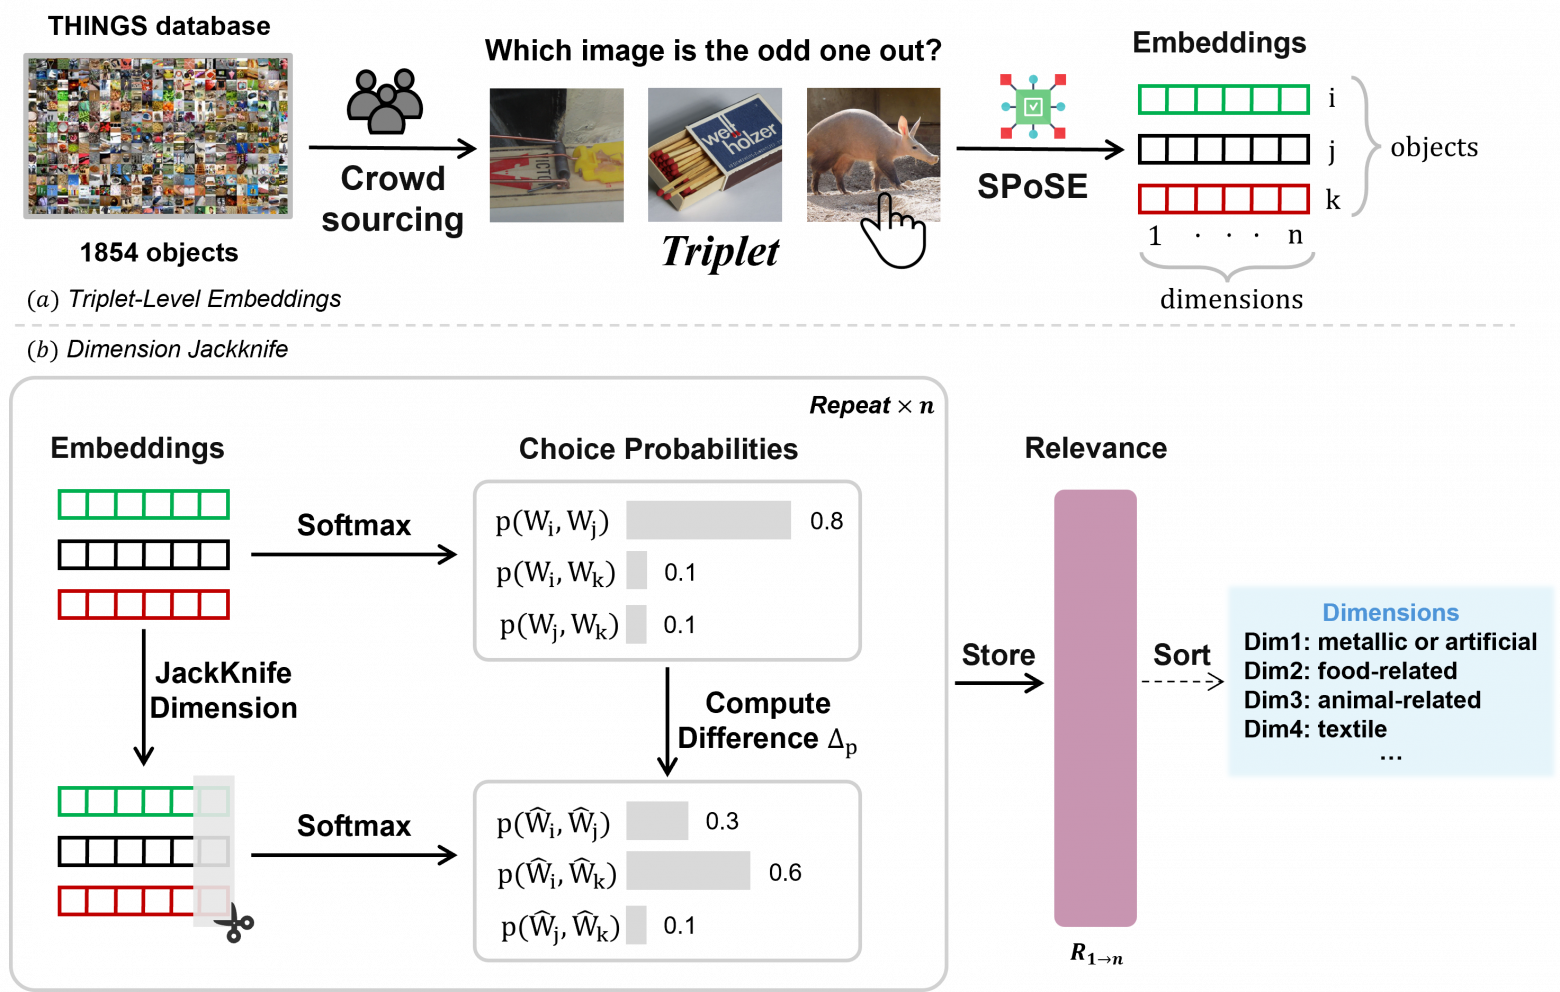
Если разобрать по шагам, получается такая картина.
Первый этап — определение главного признака
Возьмем любую тройку из «Третьего лишнего», например нашу: мышеловку, коробок и трубкозуба. У каждого предмета в пространстве SPoSE уже есть 66 оценок, по одной на каждое измерение.
Дальше в дело идет метод Jackknife — по‑английски складной нож, а по‑нашему, пожалуй, «выкидуха». Алгоритм по очереди выкидывает из расчета одно измерение за другим и смотрит, как после этого меняется шанс, что оставшаяся пара окажется самой похожей.
Если удаление определенного признака сильнее всего меняет результат, значит, он сыграл наиболее важную роль в выборе. Его и берут за основу дальнейшего объяснения.
Например, при сравнении двух искусственных предметов и животного важным может оказаться признак «создан человеком». В другой тройке решающим окажется то, что один объект связан с едой, а два остальных — нет.
Второй этап — перевод математического признака на человеческий язык
Получить метку вроде «относится к животным» или «металлический» недостаточно. Это всего лишь короткое обозначение, которое само по себе ничего не объясняет.
Поэтому авторы используют обычную LLM, которой передают описание трех объектов и найденное смысловое измерение. Задача модели — составить связное объяснение, показывающее, как этот признак влияет на человеческий выбор.
Так появляются текстовые цепочки рассуждений (Chain‑of‑Thought, CoT). Генеративная модель на этом этапе не должна самостоятельно определять правильный ответ. Она получает уже найденный когнитивный критерий и превращает его в понятное обоснование.
Третий этап — дообучение мультимодальной модели
Теперь у исследователей есть всё необходимое: изображения, правильный ответ и объяснение, по какому признаку его выбрал человек. На этих данных они дообучают модель методом Supervised Fine‑Tuning (SFT), то есть на готовых примерах с разобранными ответами.
Получившийся набор данных насчитывает 309 329 примеров. Из них около 80 тысяч относятся непосредственно к когнитивным задачам THINGS, а остальные нужны для сохранения общих мультимодальных навыков.
Последний момент, кстати, важнее всего. Если бесконечно учить ИИ решать одну конкретную задачу, можно получить отличного специалиста по поиску лишнего предмета, который при этом заметно хуже справляется со всем остальным. Поэтому в обучающую выборку добавили задания на распознавание изображений, сторителлинг, поиск различий и другие мультимодальные задачи.
Иными словами, авторы хотят сохранить существующие навыки модели и добавить к ним еще один способ обработки информации — с опорой на человеческие смысловые признаки.
Почему правила нельзя задать в промпте
Честно говоря, все это может показаться избыточным, да и мороки много. Зачем проводить дообучение, если можно загрузить в системный промпт список из 66 измерений и попросить нейросеть учитывать их при ответах?
Собственно, исследователи задались тем же вопросом и проверили. Результат их не порадовал.
Подопытной стала Qwen3-VL-4B‑Instruct. Со стандартной цепочкой рассуждений она давала 53,37% точности. Когда ее заставляли рассуждать через одно выбранное смысловое измерение, точность проваливалась до 49,01%, а со всеми 66 измерениями сразу — до 52,70%.
То есть перечисление когнитивных признаков в промпте не помогло. А в одном из вариантов оно заметно ухудшило результат.
Сбоила и сама генерация. Исследователи обнаружили, что с такими подсказками модели периодически уходили в повторяющиеся циклы. Вместо того чтобы выбрать подходящий критерий и закончить рассуждение, они начинали перечислять всевозможные положительные и отрицательные характеристики объектов. И продолжали это делать, пока не заканчивались токены.
С трубкозубом этот сбой выглядит особенно забавно. Модель перечисляет: животное не металлическое, не искусственное, не плоское, не зеленое и так далее. Каждый факт по отдельности верный, только к задаче всё это почти не относится. Информации у нейросети стало больше, а пользоваться ею она так и не научилась.
В этом и разница между промптом и дообучением. Промптом мы сообщаем модели, какие признаки существуют, и надеемся, что она применит их к месту. Дообучение показывает на множестве примеров, как признак связан с объяснением и итоговым ответом.
Авторы отдельно проверили, откуда берется прирост: от обучения на объяснениях или от того, что цепочек рассуждений стало больше. При замене полноценных объяснений на короткие метки смысловых измерений точность Qwen3-VL-4B падала до 42,81%. Не знаю, как еще нагляднее показать, что одного списка признаков недостаточно.
Что получилось на практике
Основные эксперименты проводили с семейством Qwen3-VL в трех конфигурациях: 4B, 8B и 30B‑A3B. Последняя построена по архитектуре Mixture of Experts.
В главном тесте исследователи сравнивали, насколько часто ответы нейросетей совпадают с человеческим выбором. Для этого использовали отдельную проверочную выборку из 453 642 троек изображений.
Результаты получились такие:
Модель | Прямой ответ | Обычный CoT | CogAlign |
Qwen3-VL-4B | 41,48% | 53,37% | 56,81% |
Qwen3-VL-8B | 40,46% | 52,28% | 56,99% |
Qwen3-VL-30B‑A3B | 37,09% | 55,38% | 56,21% |
Разницу видно издалека. Даже обычная цепочка рассуждений значительно повышает совпадение с человеческим выбором, а CogAlign дает дополнительный прирост для всех трех моделей.
Отдельно исследователи сравнили результаты с Centaur — это такая специальная модель на 70 млрд параметров, которую обучали на большом массиве данных о человеческом поведении. Она показала 51,96%. Все три версии Qwen3-VL после CogAlign оказались впереди.
Проверили и другие архитектуры. На выборке примерно из 75,6 тысячи заданий Qwen2.5-VL-7B улучшила результат с 56,63 до 59,29%, а Gemma3-12B — с 55,77 до 57,28%.
Но было бы неправильно говорить, что после такого обучения модели стали лучше абсолютно во всем.
Авторы отдельно проверили MMMU и MMBench — два популярных мультимодальных бенчмарка. На MMMU результаты улучшились у всех трех версий Qwen3-VL. А вот на MMBench обнаружилось небольшое снижение: например, у модели 4B показатель изменился с 82,96 до 81,39%.
Зато особенно интересно выглядят результаты на заданиях, где нужно понимать физические свойства предметов. В соответствующей категории MMBench модель Qwen3-VL-4B улучшилась с 67 до 75%, а версия 8B — с 61 до 77%. Это неплохой аргумент в пользу того, что работа с человеческими смысловыми признаками может помогать и за пределами игры в «Третий лишний».
Но самым необычным экспериментом стала проверка через фМРТ.
Для нее исследователи взяли независимый набор данных NSD (Natural Scenes Dataset), где записана активность мозга людей, смотревших на изображения. Модель и мозг сравнивали методом searchlight RSA (Representational Similarity Analysis). Он показывает, насколько похоже нейросеть и отдельные области мозга группируют и различают одни и те же картинки.
После CogAlign исследователи обнаружили положительный сдвиг сходства между внутренними представлениями Qwen3-VL и нейронной активностью человека. Причем изменения наблюдались у всех четырех участников исследования, для которых проводился соответствующий анализ.
Только вот надо учесть один момент. Никто не подключал модель к томографу и не обнаружил в ее слоях человеческие мысли. Я говорю исключительно о математическом сходстве представлений, которое удалось измерить независимым методом.
Но сам факт того, что такое сходство увеличилось после обучения, выглядит интересно.
Стереотипы идут в комплекте
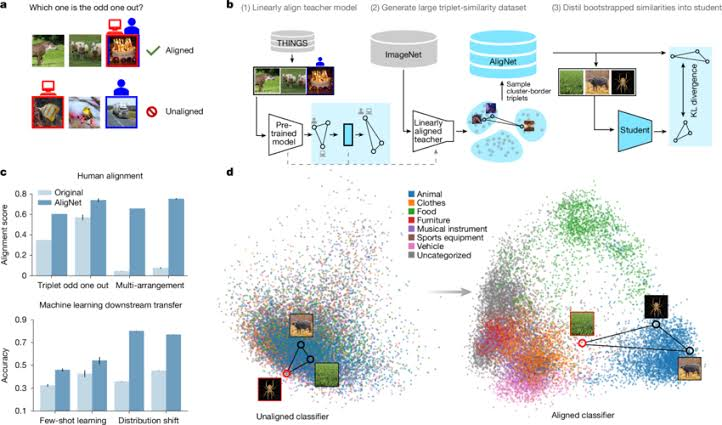
Ну и напоследок. У работы CogAlign есть занятная особенность: для улучшения мультимодальных моделей исследователи взяли данные психологического эксперимента, хотя обычно в таких случаях собирают очередной огромный датасет с картинками и подписями. И даже простая игра в поиск лишнего предмета помогла моделям заметно чаще отвечать так же, как люди.
При этом я бы не стал воспринимать CogAlign как готовый способ заставить ИИ думать точно так же, как мы. У самого исследования есть ограничения: авторы выбирают только одно главное измерение для каждой тройки, хотя в реальной жизни на наше решение вполне могут влиять несколько признаков одновременно. Кроме того, эти 66 измерений в первую очередь описывают объекты и их свойства. Для абстрактных математических или геометрических задач такой подход еще предстоит проверить.
Есть и другая проблема. Помните стереотипно женственные и мужественные признаки из списка измерений? Вместе с полезной физикой объектов нейросеть усваивает из ответов тысяч людей и их стереотипы — например, гендерные оси при оценке одежды или бытовых предметов. Поэтому когнитивные датасеты, скорее всего, придется тщательно фильтровать и проверять, прежде чем класть в основу базовых моделей.
Значит, сначала нужно решить, какие человеческие привычки мышления мы передаем ИИ, а какие лучше оставить за пределами обучающей выборки.
Мы привыкли оценивать нейросети по тому, насколько хорошо они отвечают на вопросы. CogAlign предлагает смотреть и на то, по каким основаниям модель выбирает ответ. Внятных результатов в этом направлении, мне кажется, ждать долго, а то, что получится в итоге, может по‑настоящему напугать восстанием машин.

