Цикл "Docs-as-code на максималках":
У нас уже есть движок публикации и настроенный GUI-редактор. Теперь обсудим рабочий флоу аналитика в новом окружении и как организовать переезд из Confluence, никого и ничего не поломав.
Зачем вообще жесткая структура
Первый же вопрос, который встает при командной работе в репозитории: как сделать, чтобы изменения по двум разным задачам не пересекались по файлам и не плодили конфликты на мерже.
Ответ - продуманная структура, где у каждой описываемой части системы есть свое место.
Мы потратили на согласование структуры достаточно много времени и остановились на следующем подходе:
Архитектура системы/— обзор, структура приложений, модули, ER-диаграммы (только критичные участки), модель данных по модулям, миграции данных, права доступаВнешние системы/— системы, с которыми интегрируется продукт; на каждую описание + сервисы (на каждую ручку REST отдельный файл)Внешний API/— слой сервисов, которые отдает наша система; методы сгруппированы по endpoint, на каждую ручку отдельный.mdПроцессы/— пользовательские пути, решающие бизнес-задачу; как правило, связаны с эпиком 1-к-1. Много графики и ссылок на UI/бэкендОписание Frontend/— UI-описание с привязкой к элементам интерфейсаОписание Backend/— объекты бэкенда как чорные ящеги: крон-сервисы, события, use cases и общая сервисная логика
И дополнительные принципы:
На все виды артефактов есть свои шаблоны в
templates/и их важно использовать, иначе однородность документации быстро теряется.Мы стараемся не копипастить решения: если одна и та же страница относится к нескольким модулям, ее не дублируют руками, а подключают через include, и за счет глубокой декомпозиции с этим проще работать.
На первый взгляд дерево может выглядеть монструозно, но на деле у каждого артефакта свое место, определенное вполне однозначно. Это позволяет во всю мощь использовать встроенный в Obsidian инструмент "Граф связей", который по ссылкам внутри md-артефактов строит полезнейшую диаграмму зависимостей.
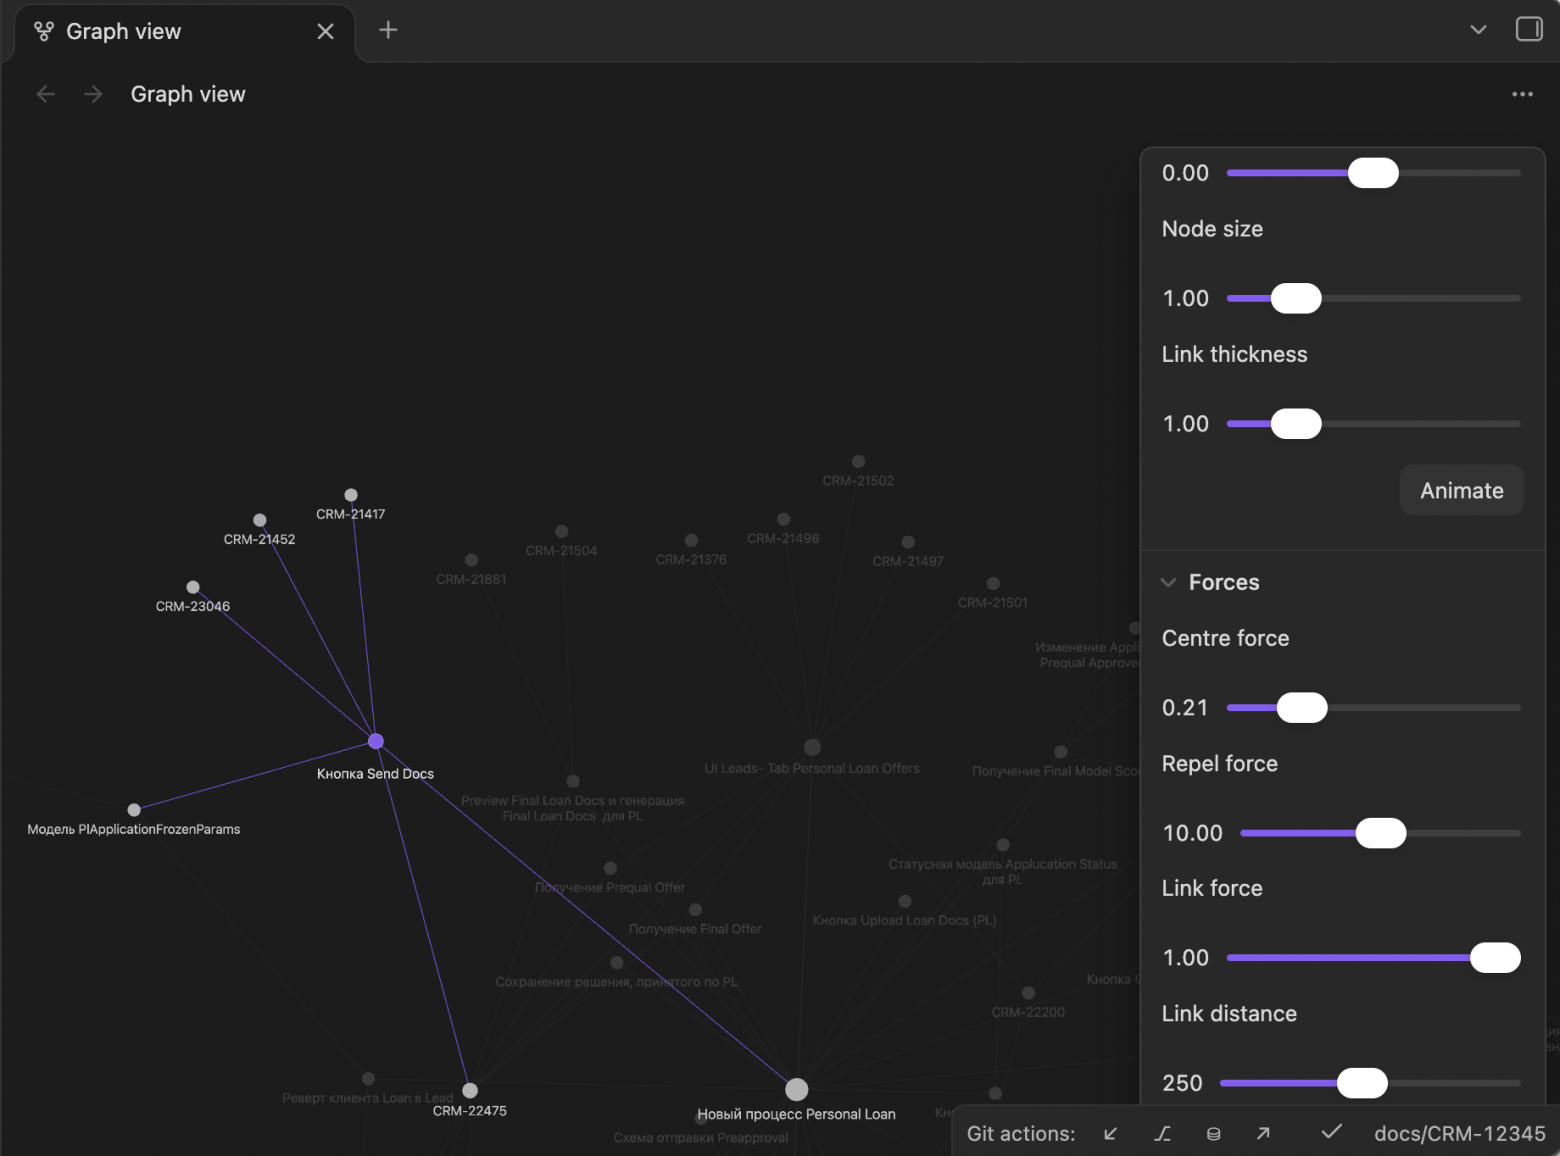
В идеальном мире это позволяет быстро оценить влияние изменений на другие части системы.
А еще, ограничив область графа поддеревом документов, можно:
Быстро построить подобие ER-диаграммы и разобраться с запутанными связями в БД.
Получить трассировку вызовов API и отыскать всех потребителей.
Конечно чтобы на практике это работало, нужно добиться 100% покрытия системы актуальной документацией, что в реальном мире недостижимо. Но даже в половинчатом виде инструмент невероятно полезен.
А еще жесткая структура будет очень полезна в следующей части, где мы будем настраивать AI-агента для автоматизации работы со спецификациями.
Выбор модели ветвления
Имеет смысл заранее договориться с командой о модели ветвления.
Мы взяли за основу GitHub Flow и определили для себя виды используемых веток:
master— документация соответствует текущему состоянию production.docs/CRM-XXXX— ответвление под каждую задачу (аналог feature-ветки). Содержит спеки и постановку на разработку. Долгоживущая.catch/CRM-XXXX— ответвление, чтобы описать уже реализованную ранее, но не задокументированную функциональность (нужно для корректного отображения ссылок и визуализации изменений в diff, чтобы разработка в задаче видела только то, что реально нужно изменить). Короткоживущая.
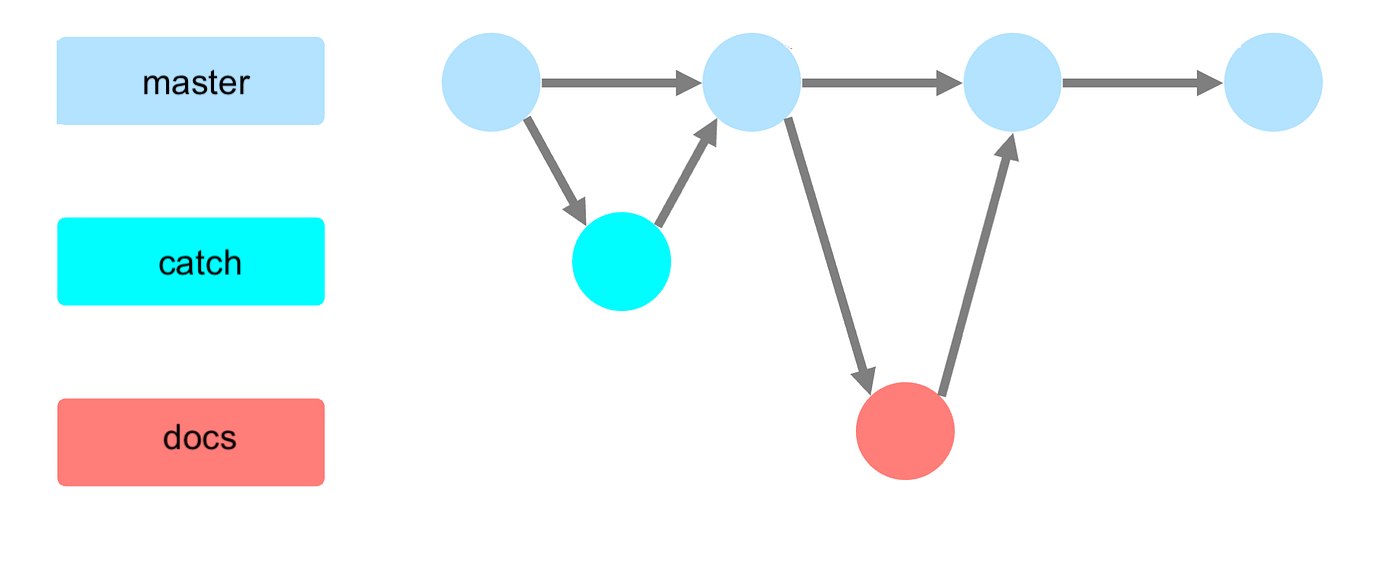
В чем разница docs и catch. Catch-ветку мержат в
masterсразу, как только описали недостающее, еще до отправки задачи в разработку. А docs-ветку не мержат до самого релиза: аналитик создает PR, проходит ревью, а дальше задача ждет, пока завершится разработка и фича зарелизится. Причина в том, что за время разработки договоренности могут измениться (имена атрибутов, логика), и если смержить спеку сразу, придется переделывать. Долгоживущий PR позволяет в момент релиза сверить спеку с реальностью и только тогда смержить.
Любые изменения напрямую в master запрещены, только через создание новой ветки и Pull Request.
Нейминг веток и коммитов происходит по шаблону, чтобы они связывались с задачей автоматически. В SimpleGit эти соглашения были предусмотрены и создать новую ветку можно только согласованного вида.
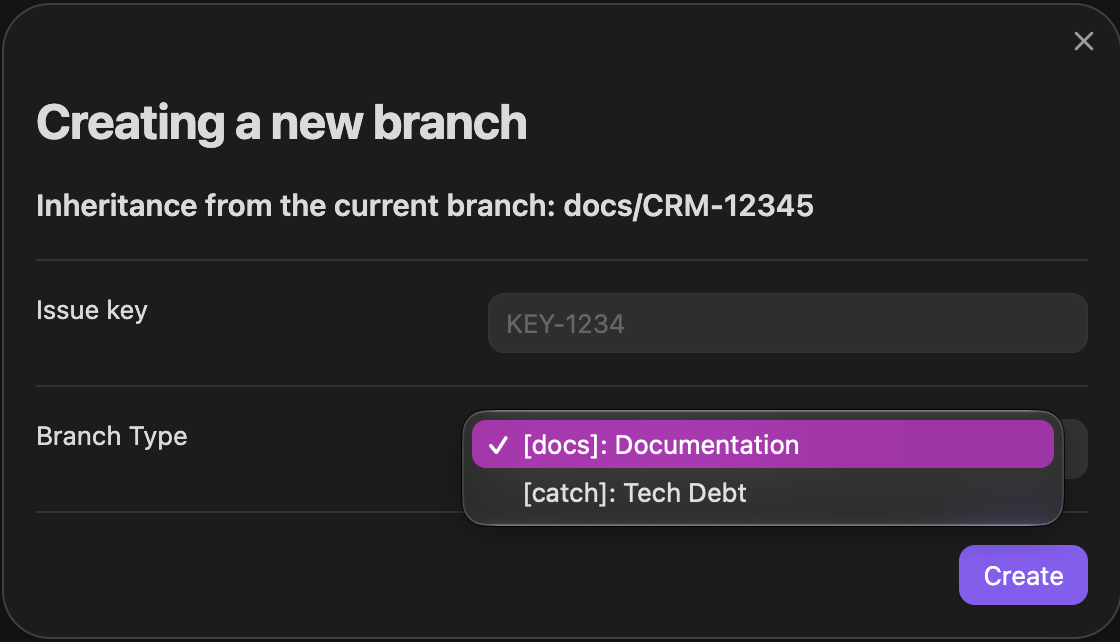
А при коммите изменений черновик сообщения формируется автоматически по шаблону.
Рабочий флоу аналитика
Как все это выглядит на практике:
Аналитик создает ветку, описывает изменения в
.md, создает Pull RequestПайплайн автоматически готовит постановку на разработку, публикует ее в Jira и Confluence
Опционально другие аналитики/разработчики проводят ревью постановки
Разработка разрабатывает. PR все это время открыт и, если что-то меняется, спеку можно актуализировать
После релиза фичи аналитик мержит изменения в
master, и пайплайн обновляет полную документацию
Так обеспечивается концепция "документация в master соответствует состоянию системы в production".
Для того, чтобы этот процесс работал, нужно предусмотреть соответствующие этапы в Jira-workflow: должны быть выделенные этапы для создания постановки на разработку и актуализации документации после релиза.
Ревью постановки при этом удобно проводить прямо в пространстве постановок в Confluence, оставляя inline-комментарии по ходу текста. Это позволяет вовлечь в процесс ревью не только технических, но и бизнес-специалистов.
Если на странице в Confluence кем-либо был оставлен комментарий, то после обновления и повторного запуска pipeline он переместится в специальный блок “История согласования (комментарии)” в начале страницы.
Будут отображаться все комментарии, даже те, которые были закрыты (они все еще будут видны, но у них появится дополнительная отметка Resolved).
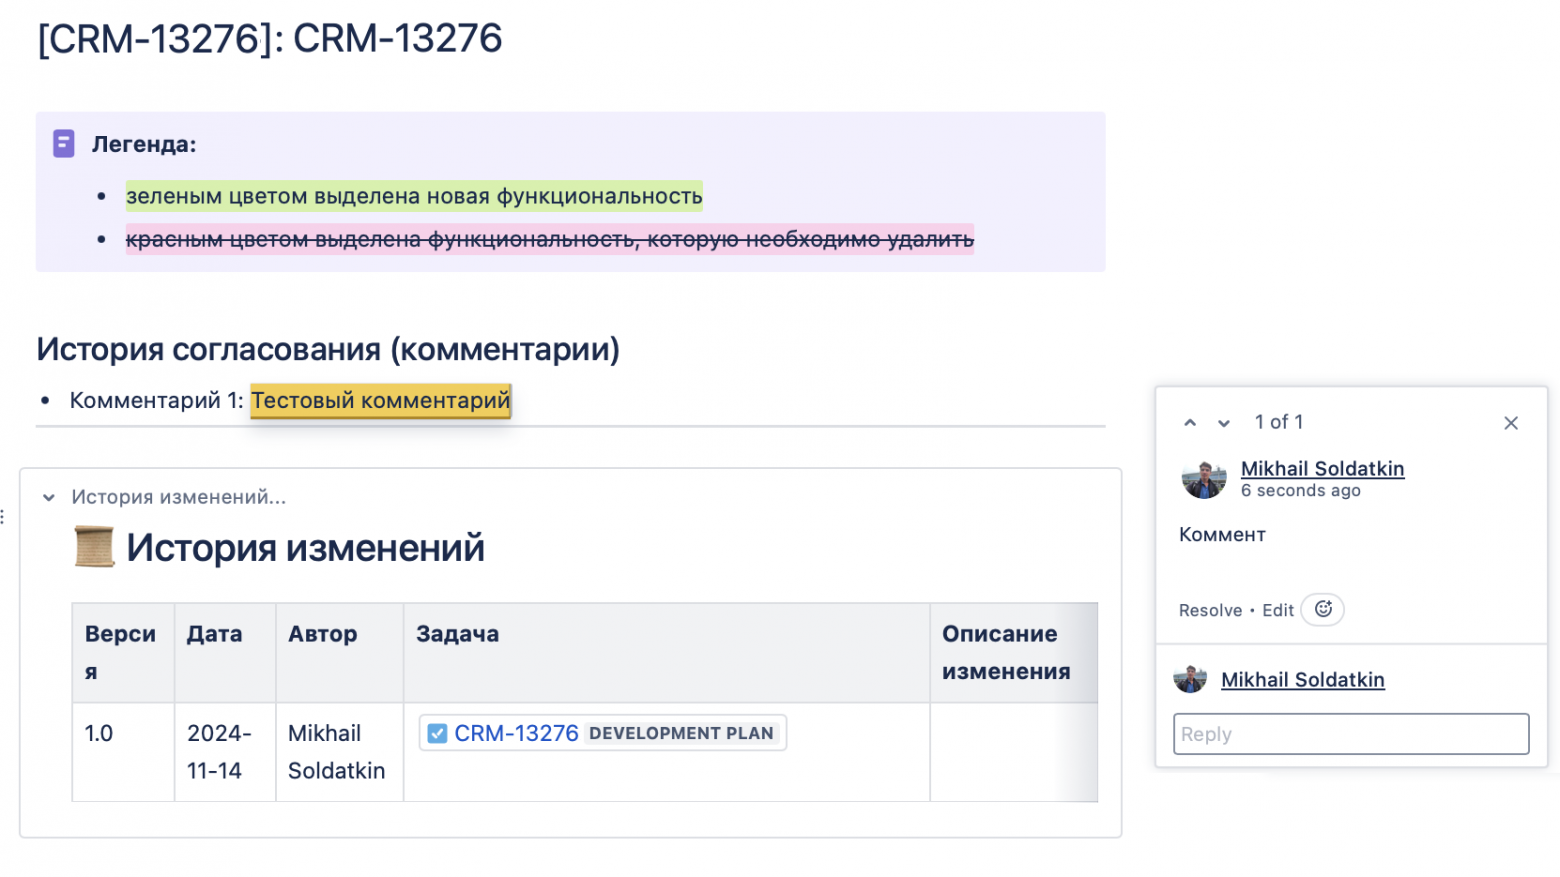
Перенос коммента, это скорее вынужденный
костыльмера, поскольку нельзя надежно определить, где изначально находился комментарий и куда его поместить после обновления страницы, т.к. могут возникать неразрешаемые коллизии.
Соблюдение баланса
Созданная строгая структура легко толкает в перфекционизм: описать процесс целиком, все хендлеры, весь UI и объем работы может раздуваться в несколько раз. Поэтому важно также зафиксировать глубину детализации ваших спецификаций (с учетом потребностей в вашей компании).
Например наши договоренности:
описывать нужно в первую очередь бизнес-логику, а не документировать все артефакты кода
внутренняя архитектура системы это зона ответственности разработки; аналитик не проектирует и не документирует эту часть;
допустимо создавать заглушки - пустые страницы, которые будут видны на графе зависимостей, но не будут содержать никакой информации внутри
описание ранее внедренного это техдолг, и цель здесь - пропорция 80/20 (80% времени на новые фичи, 20% на техдолг)
Структура в этом смысле работает как небольшой мотиватор: раньше разбирать накопленный техдлог не было стимула вообще, теперь это становится частью процесса - хочешь на что-то сослаться, будь добр это сначала хотя бы базово описать.
Плавная миграция и обратная совместимость
Построенный флоу позволяет постепенно мигрировать со старого процесса в Confluence на рельсы docs-as-code.
Наш принцип здесь обратная совместимость как стратегия.
Идея очень простая: вся документация из репозитория публикуется в то же пространство, где раньше велась документация в Confluence. Импортируемые страницы спокойно соседствуют со старыми:
Старые страницы по-прежнему можно редактировать; переносить их все равно надо, но это легко размазать во времени и брать как техдолг
Новые страницы (из репозитория) публикуются с ограничением на редактирование и пометкой-ссылкой на источник в Bitbucket.
Иметь разные версии документов в двух системах мы запрещаем организационно. Правило простое: если нужно писать в Markdown, сначала перенеси оригинальный документ и удали старую страницу в Confluence.
Что это дает компании: гораздо большую гибкость при внедрении. Можно закрыть Confluence на редактирование сразу, можно разрешить редактировать старое и запретить создавать новое, можно вести план переноса как техдолг. Вариантов масса.
Ценность именно в возможности выбора и плавном переходе. У нас, например, принят максимально либеральный подход: я продаю идею переезда команде и не ставлю жестких рамок.
Что дальше
У нас есть 2 готовых пайплайна, 1 GUI-редактор, 10 плагинов к нему, а также обозначенные правила игры. В последней статье поговорим о том, как сделать решение еще более удобным и эффективным - попробуем построить AI-агента на фундаменте всего созданного ранее.