
Неделю назад я рассказывал на Хабре про z3l.FastHtmlParser — HTML-парсер для .NET, который вместо DOM строит плоский список тегов и разбирает страницу в 10–30 раз быстрее HtmlAgilityPack и AngleSharp. Тогда у него не было ни CSS-селекторов, ни XPath, и жил он только в .NET.
За неделю появились и CSS-селекторы, и XPath 1.0, а сама библиотека переехала ещё на семь языков: Go, Rust, Java, TypeScript, Python, PHP и Ruby. Это не «Hello world»: 6–11 тысяч строк в каждой реализации — токенизатор, правила необязательных закрывающих тегов из HTML5, все 2125 именованных сущностей, XPath 1.0 и CSS-селекторы. Алгоритм везде один и тот же, и каждый порт сверяется с оригиналом на одних и тех же страницах.
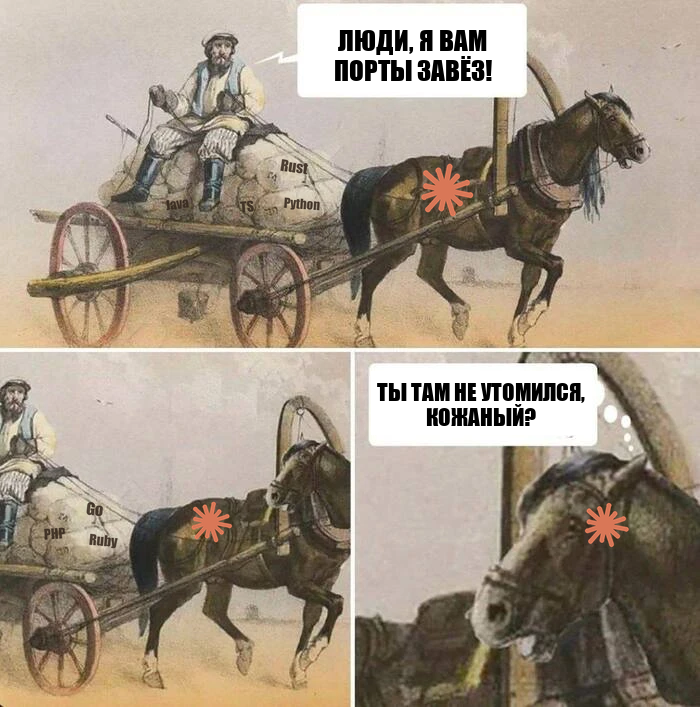
Семь портов за неделю — это, конечно, не я один. Кто на самом деле вёз телегу, видно по логотипу.
Получился эксперимент, который редко удаётся поставить: одна и та же настоящая задача, восемь языков, две ОС и один и тот же процессор. Значит, можно наконец ответить на вопрос, за который в комментариях убивают. Готовьте вилы.
Условия
Одно железо. Физический сервер с AMD Ryzen 7 3800X (8 ядер, 16 потоков).
Linux — Ubuntu 26.04 прямо на этом сервере, бенчмарки в Docker, официальные образы:
dotnet/sdk:10.0,golang:1.27,rust:1.100,maven:3-eclipse-temurin-21,node:26,python:3.14,php:8.4-cli,ruby:4.0.Windows — Windows 10 LTSC в виртуалке KVM на этом же сервере, 12 vCPU. Версии те же: .NET 10.0.12, Go 1.27.4, Rust 1.100, Java 21.0.13, Node 26.13, Python 3.14.10, PHP 8.4.27, Ruby 4.0.9.
PHP — с opcache и tracing JIT на обеих ОС. Ruby — без JIT, а на Linux ещё с YJIT и с новым ZJIT (в сборке RubyInstaller для Windows YJIT нет).
Строго по очереди. Ни один бенчмарк не работал одновременно с другим, Linux и Windows — тоже. Сервер боевой: на нём крутятся MySQL, RabbitMQ и десяток сервисов, так что фоновая нагрузка не нулевая (load average 1–3 из 16), зато одинаковая для обеих ОС.
Две задачи. Разбор страницы и скрапинг — разбор плюс извлечение 20 книг (название, цена, рейтинг) или 10 цитат. Страницы — сохранённые books.toscrape.com (51 KB), quotes.toscrape.com (11 KB), webscraper.io laptops (38 KB), books ×10 (510 KB) и books без
</li>и</p>. Перед замером каждый бенчмарк проверяет, что все библиотеки вернули одни и те же записи.Время — медиана на вызов после прогрева. В C# — BenchmarkDotNet, в Go —
testing.B(медиана трёх прогонов), в остальных — одинаковый цикл «секунда прогрева, потом партии вызовов, берём медиану».Погрешность — до 10%. Повторные прогоны одного и того же бенчмарка расходились до 10%: C# на books — 55 и 58 μs на Linux, 64 и 59 μs на Windows; Java на Windows — 73 μs вчера и 66 μs сегодня. Поэтому разница меньше 10% в этой статье — ничья.
Результат
Разбор books.toscrape.com, 51 KB (меньше — лучше):
Место | Язык | Linux | Windows |
|---|---|---|---|
1–4 | Python (Rust внутри) | 54 μs | 67 μs |
1–4 | C# | 55 μs | 64 μs |
1–4 | Rust | 56 μs | 61 μs |
1–4 | Java | 59 μs | 66 μs |
5 | Go | 84 μs | 102 μs |
6 | Node.js (TypeScript) | 183 μs | 201 μs |
7 | PHP + JIT | 360 μs | 516 μs |
8 | Ruby + YJIT | 818 μs | — |
9 | Ruby | 1.60 ms | 1.53 ms |
Первые четыре места — в пределах погрешности.
Разбор, все страницы — Linux и Windows
Linux:
Страница | Rust | C# | Python | Java | Go | Node.js | PHP | Ruby | Ruby + YJIT |
|---|---|---|---|---|---|---|---|---|---|
quotes, 11 KB | 15 μs | 16 μs | 17 μs | 17 μs | 24 μs | 65 μs | 110 μs | 466 μs | 240 μs |
laptops, 38 KB | 46 μs | 51 μs | 47 μs | 62 μs | 74 μs | 173 μs | 303 μs | 1.40 ms | 1.22 ms |
books, 51 KB | 56 μs | 55 μs | 54 μs | 59 μs | 84 μs | 183 μs | 360 μs | 1.60 ms | 818 μs |
books ×10, 510 KB | 563 μs | 611 μs | 546 μs | 617 μs | 857 μs | 2.27 ms | 3.59 ms | 15.3 ms | 8.02 ms |
books без | 52 μs | 61 μs | 55 μs | 63 μs | 82 μs | 234 μs | 390 μs | 1.83 ms | 1.49 ms |
Windows:
Страница | Rust | C# | Python | Java | Go | Node.js | PHP | Ruby |
|---|---|---|---|---|---|---|---|---|
quotes, 11 KB | 17 μs | 20 μs | 18 μs | 19 μs | 29 μs | 68 μs | 153 μs | 455 μs |
laptops, 38 KB | 50 μs | 54 μs | 56 μs | 66 μs | 88 μs | 204 μs | 448 μs | 1.31 ms |
books, 51 KB | 61 μs | 64 μs | 67 μs | 66 μs | 102 μs | 201 μs | 516 μs | 1.53 ms |
books ×10, 510 KB | 602 μs | 637 μs | 654 μs | 677 μs | 944 μs | 2.27 ms | 5.11 ms | 15.4 ms |
books без | 55 μs | 61 μs | 63 μs | 71 μs | 100 μs | 224 μs | 514 μs | 1.91 ms |
Скрапинг 20 книг (разбор + извлечение), Linux / Windows. У каждого порта три способа искать: свои методы Find, CSS-селекторы и XPath.
Язык | Find API | CSS | XPath |
|---|---|---|---|
Rust | 73 / 82 μs | 73 / 87 μs | 117 / 191 μs |
C# | 75 / 70 μs | 74 / 82 μs | 117 / 109 μs |
Java | 86 / 93 μs | 120 / 111 μs | 102 / 108 μs |
Go | 106 / 129 μs | 117 / 131 μs | 216 / 265 μs |
Python | 117 / 155 μs | 94 / 128 μs | 123 / 243 μs |
Node.js | 230 / 239 μs | 285 / 275 μs | 269 / 304 μs |
PHP | 514 / 636 μs | 609 / 758 μs | 784 / 927 μs |
Ruby + YJIT | 1.01 ms / — | 1.15 ms / — | 1.30 ms / — |
Ruby | 2.08 / 2.14 ms | 2.21 / 2.22 ms | 3.05 / 2.75 ms |
Порты против местных чемпионов
Сравнивать языки между собой весело, но пользователю важнее другое: стоит ли брать порт вместо того, чем уже пользуется его экосистема. Порты писались неделю, и вылизаны они явно меньше оригинала. Вот как они выглядят против лучшего, что было на своих платформах до них.
Разбор books.toscrape.com, 51 KB — во сколько раз порт быстрее (Linux / Windows; меньше 1 — порт медленнее):
Язык | Порт, Linux | Самый быстрый конкурент | Порт быстрее | Популярная альтернатива | Порт быстрее |
|---|---|---|---|---|---|
Rust | 56 μs | tl | 1.5x / 1.7x | scraper (html5ever) | 22x / 25x |
C# | 55 μs | HtmlAgilityPack | 12x / 12x | AngleSharp | 21x / 18x |
Python | 54 μs | selectolax (lexbor, C) | 8.4x / 6.3x | BeautifulSoup | 226x / 213x |
Java | 59 μs | Jericho | 6.7x / 6.0x | jsoup | 8.0x / 7.2x |
Go | 84 μs | 10x / 9.6x | goquery | 10x / 9.6x | |
Node.js | 183 μs | htmlparser2 | 5.3x / 4.3x | cheerio | 16x / 9.9x |
PHP | 360 μs | Dom\HTMLDocument (lexbor, C) | 1.5x / 1.5x | DOMDocument (libxml2, C) | 2.6x / 2.8x |
Ruby + YJIT | 818 μs | Nokogiri (libxml2, C) | 1.3x / — | Nokogiri | 1.3x / — |
Ruby | 1.60 ms | Nokogiri (libxml2, C) | 0.6x / 0.9x | Nokogiri | 0.6x / 0.9x |
Скрапинг 20 книг — лучший из трёх API порта против лучшего конкурента:
Язык | Порт, Linux | Самый быстрый конкурент | Порт быстрее |
|---|---|---|---|
Rust | 73 μs | tl (CSS) | 1.7x / 2.1x |
C# | 74 μs | HtmlAgilityPack (XPath) | 11x / 12x |
Python | 94 μs | selectolax (CSS) | 6.2x / 4.8x |
Java | 86 μs | jsoup (CSS) | 8.2x / 7.5x |
Go | 106 μs | goquery (CSS) | 9.1x / 8.3x |
Node.js | 230 μs | node-html-parser | 6.1x / 4.9x |
PHP | 514 μs | Dom\HTMLDocument (CSS) | 1.4x / 1.6x |
Ruby + YJIT | 1.01 ms | Nokogiri (XPath) | 1.9x / — |
Ruby | 2.08 ms | Nokogiri (XPath) | 0.9x / 1.1x |
В семи языках из восьми порт быстрее всего, что было в экосистеме, — на обеих ОС и в обеих задачах. Причём в Python, PHP и Ruby главные конкуренты написаны на C: selectolax и Dom\HTMLDocument — это lexbor, lxml, DOMDocument и Nokogiri — libxml2. Чистый PHP обгоняет встроенный в PHP 8.4 парсер на C в полтора раза.
Самый близкий конкурент — tl в Rust, всего в 1.5–2 раза медленнее. Но tl — zero-copy-парсер без декодирования сущностей и без комбинатора потомков в селекторах, то есть делает меньше.
Ruby — особый случай. Без JIT порт идёт вровень с Nokogiri на Windows (разбор на 8% медленнее, скрапинг на 14% быстрее) и проигрывает ей на Linux, где Nokogiri заметно быстрее: в 1.6 раза на разборе. С YJIT порт обгоняет Nokogiri: в 1.3 раза на разборе и в 1.9 раза на скрапинге.
Откуда такой разрыв? C-библиотеки делают в 10 раз больше работы: строят полное DOM-дерево с объектом на каждый узел, создают неявные <html> и <tbody>, а потом ещё и заворачивают найденные узлы в объекты Python, PHP или Ruby. Парсер, который хранит теги как пары чисел-смещений в исходной строке, делает ровно то, что нужно для скрапинга, и не больше.
А теперь — почему каждая строчка этих таблиц оскорбит кого-нибудь из читателей.
Тезис 1. Python догнал Rust
На Linux Python разбирает страницу за 54 μs, Rust — за 56. На Windows — 67 и 61.
Конечно, это жульничество: Python-версия — это 790 строк обвязки на PyO3 вокруг Rust-версии. Внутри fh.parse(html) работает не интерпретатор, а тот же машинный код, что и в Rust. А то, что на Linux Python на 2 μs быстрее самого Rust, — это шум и флаги сборки: Python-обёртка собрана с fat LTO, бенчмарк Rust — с thin LTO.
На скрапинге видно, чем платит Python: пересечением границы. Каждый найденный тег и каждая строка становятся объектами Python, и Find-API отстаёт от чистого Rust в 1.6 раза (117 μs против 73). А CSS-селекторы — всего на 30% (94 μs): весь поиск идёт внутри Rust, и граница пересекается один раз. Чем реже код переходит из Python в Rust и обратно, тем ближе он к Rust.
Провокация тут в другом. В споре «Python медленный» обычно забывают, что в продакшене Python и не исполняет горячий код: numpy, pandas, lxml, selectolax, pydantic-core, orjson написаны на C или Rust. Python — это язык, на котором вызывают быстрый код. И если для вашей задачи есть нативное ядро, Python-сервис окажется быстрее «честного» сервиса на Go, который всё делает сам.
Мораль: «быстрый язык» — это часто язык, который удачно делегирует.
Тезис 2. Go — самый медленный из компилируемых
Go разбирает страницу за 84 μs — в полтора раза медленнее Rust, C#, Java и даже Python. На Windows то же самое: 102 μs против 61–67.
При этом Go-версия написана аккуратно: на разбор — 2 аллокации, сборщик мусора в замере почти не участвует. Дело не в GC, а в компиляторе. Компилятор Go сознательно оптимизирует меньше — ради скорости сборки: скромнее инлайнинг, меньше устранённых проверок границ массивов, нет автовекторизации. В Go есть и PGO, но только по заранее снятому профилю (default.pgo), и включают его единицы. А JIT в .NET и HotSpot собирает профиль сам, прямо во время работы, и компилирует под горячие ветки.
Go остаётся прекрасным языком для сервисов — быстрая сборка, простота, предсказуемость. Но «Go быстрый, потому что компилируется» — это миф. Он быстрый относительно Python и Ruby. Не относительно JVM и .NET.
Тезис 3. C# и Java — это почти Rust. А «C# обогнал Rust» — это про Windows
На Linux разбор: C# — 55 μs, Rust — 56, Java — 59. Скрапинг: Rust — 73, C# — 75, Java — 86. Ничья, Java чуть позади.
На Windows картина другая: на скрапинге C# первый — 70 μs против 82 у Rust, а на XPath разрыв почти вдвое: 109 μs против 191. В первом черновике этой статьи заголовок был «C# обогнал Rust». А потом я посмотрел на Linux, где Rust и C# идут вровень, и стал разбираться.
Причина — аллокатор. .NET выделяет объекты в своей куче одинаково на любой ОС: сдвигом указателя. А Rust по умолчанию берёт системный аллокатор: на Linux это malloc из glibc, на Windows — HeapAlloc. XPath-движок создаёт много маленьких векторов и строк, и системная куча Windows на этом проседает. Две строчки — и Rust на Windows переходит на mimalloc:
#[global_allocator]
static GLOBAL: mimalloc::MiMalloc = mimalloc::MiMalloc;
Rust на Windows | HeapAlloc (по умолчанию) | mimalloc | Для сравнения: Linux |
|---|---|---|---|
Разбор books, 51 KB | 61 μs | 55 μs | 56 μs |
Скрапинг, Find API | 82 μs | 69 μs | 73 μs |
Скрапинг, XPath | 191 μs | 125 μs | 117 μs |
И C# снова не впереди: 70 μs против 69. На Linux mimalloc не меняет ничего (разбор — 55 против 56 μs, XPath — 117 против 117): malloc из glibc для этой нагрузки и так хорош.
Мораль: у языка со сборщиком мусора аллокатор свой и одинаковый везде, а у Rust — тот, что даст ОС. На Windows это стоит Rust до полутора раз.
И ещё о честности: C#-версия — оригинал, и она вылизана сильнее остальных: ArrayPool, Span<char>, векторизованные IndexOfAny, CollectionsMarshal.SetCount, Dictionary.AlternateLookup для поиска по span без аллокации строк. Но и Java-версия, где ничего такого нет, отстаёт от Rust на 5–18%. Если вам нужно «почти как Rust», но без borrow checker’а, — это ваши языки.
Тезис 4. NativeAOT медленнее JIT, а серверный GC не помогает
Раз уж C# в первой четвёрке, проверим, как его ускорить. Две популярные идеи: скомпилировать заранее (NativeAOT) и включить серверный сборщик мусора. BenchmarkDotNet собирал NativeAOT под тот же набор инструкций, что использует JIT на этом процессоре (x86-64-v3, AVX2), так что дело не в нём.
C#, время; в скобках — относительно обычного JIT на той же ОС:
Задача | ОС | JIT | JIT + server GC | NativeAOT | NativeAOT + server GC |
|---|---|---|---|---|---|
Разбор books, 51 KB | Linux | 58 μs | 66 μs (1.14) | 75 μs (1.30) | 81 μs (1.40) |
Windows | 59 μs | 64 μs (1.08) | 83 μs (1.40) | 87 μs (1.47) | |
Разбор books ×10, 510 KB | Linux | 614 μs | 625 μs (1.02) | 765 μs (1.24) | 823 μs (1.34) |
Windows | 600 μs | 626 μs (1.04) | 824 μs (1.37) | 864 μs (1.44) | |
Скрапинг 20 книг, Find API | Linux | 72 μs | 80 μs (1.11) | 89 μs (1.24) | 100 μs (1.40) |
Windows | 73 μs | 75 μs (1.02) | 100 μs (1.36) | 104 μs (1.41) | |
Скрапинг 20 книг, XPath | Linux | 121 μs | 150 μs (1.24) | 153 μs (1.26) | 181 μs (1.50) |
Windows | 129 μs | 132 μs (1.02) | 156 μs (1.21) | 169 μs (1.31) | |
Скрапинг 10 цитат | Linux | 25 μs | 27 μs (1.06) | 32 μs (1.27) | 35 μs (1.41) |
Windows | 25 μs | 26 μs (1.05) | 37 μs (1.45) | 38 μs (1.50) |
NativeAOT медленнее JIT на 20–50%. Главная причина — динамический PGO. JIT в .NET сначала компилирует метод быстро и с замерами, смотрит, какие ветки горячие и какие типы реально приходят в интерфейсные вызовы, и перекомпилирует под это: девиртуализирует вызовы, встраивает горячее, раскладывает код так, чтобы горячий путь шёл подряд. NativeAOT компилирует всё заранее, вслепую. Статический PGO для NativeAOT существует, но им почти никто не пользуется.
Серверный GC медленнее на 2–15%, а на XPath, где аллокаций больше всего, — до 24%. У серверного GC своя куча на каждое ядро и гораздо больший бюджет нулевого поколения: сборок меньше, но новые объекты ложатся в память, которой уже нет в кэше. В однопоточном парсере это чистый проигрыш; серверный GC окупается, когда память одновременно выделяют много потоков.
NativeAOT — это про старт за миллисекунды, компактный деплой и отсутствие JIT в рантайме. Не про пиковую скорость.
Тезис 5. Node.js в 3.3 раза медленнее Rust — и это отличный результат
V8 — чудо инженерии. Динамически типизированный язык с JIT держится в 3.3 раза от Rust на разборе (183 μs против 56) и в 3.1 раза на скрапинге. Ни один другой динамический язык в этой таблице и близко не подошёл: PHP вдвое медленнее Node.js, Ruby с YJIT — в 4.5 раза.
Главный тормоз тут даже не V8, а строки JavaScript: UTF-16, иммутабельные, без дешёвых срезов-представлений. Парсер, построенный на смещениях в исходной строке, хорошо ложится на эту модель — поэтому и разрыв такой небольшой.
Тезис 6. Ruby: YJIT удваивает скорость
Ruby 4.0 на Linux — порт и Nokogiri:
Задача | Порт, без JIT | Порт, ZJIT | Порт, YJIT | Nokogiri (libxml2) |
|---|---|---|---|---|
Разбор books, 51 KB | 1.60 ms | 1.25 ms | 818 μs | 1.01 ms |
Разбор books ×10, 510 KB | 15.3 ms | 12.1 ms | 8.02 ms | 9.58 ms |
Разбор books без | 1.83 ms | 1.64 ms | 1.49 ms | 1.01 ms |
Скрапинг 20 книг | 2.08 ms | 1.42 ms | 1.01 ms | 1.90 ms |
Скрапинг 10 цитат | 789 μs | 529 μs | 375 μs | 964 μs |
YJIT ускоряет чистый Ruby вдвое и на разборе, и на скрапинге. Новый ZJIT из Ruby 4.0 пока даёт меньше: +28% на разборе и +46% на скрапинге. Nokogiri от JIT не ускоряется вовсе — её горячий код написан на C, — поэтому с YJIT порт на чистом Ruby обгоняет её почти везде.
Исключение — страница без закрывающих тегов: Ruby-версия тратит на ней на 14–25% больше, чем на обычной, а с YJIT — на 80% больше, тогда как Rust, Go и Python разницы не замечают. Есть что оптимизировать.
Обидно за Windows: в сборках RubyInstaller YJIT нет, и там Ruby навсегда остаётся интерпретатором.
Тезис 7. Windows против Linux: виртуалка ни при чём
Windows здесь работает в виртуалке на том же сервере, что и Linux, так что первое подозрение — виртуализация. Rust с mimalloc снимает его: 55 μs в виртуалке Windows и 55 μs на голом железе Linux. Для этой нагрузки виртуализация не стоит почти ничего.
Насколько Windows медленнее Linux на том же железе (разбор books, 51 KB):
Что | Linux | Windows | Windows медленнее на |
|---|---|---|---|
Rust, системный аллокатор | 56 μs | 61 μs | 9% |
Rust + mimalloc | 55 μs | 55 μs | 0% |
C# (два прогона) | 55–58 μs | 59–64 μs | 2–17% |
Java | 59 μs | 66 μs | 12% |
Node.js | 183 μs | 201 μs | 10% |
Go | 84 μs | 102 μs | 22% |
Python (Rust внутри) | 54 μs | 67 μs | 24% |
PHP + JIT | 360 μs | 516 μs | 43% |
Ruby | 1.60 ms | 1.53 ms | −4% |
lxml (Python, libxml2) | 590 μs | 1.51 ms | 156% |
Dom\HTMLDocument (PHP, lexbor) | 524 μs | 777 μs | 48% |
Nokogiri (Ruby, libxml2) | 1.01 ms | 1.41 ms | 40% |
selectolax (Python, lexbor) | 455 μs | 421 μs | −7% |
htmlparser2 (Node.js) | 977 μs | 870 μs | −11% |
Что из этого следует:
Рантаймы со своим аллокатором — .NET, JVM, V8 — работают на обеих ОС одинаково, в пределах шума. Это касается и чужих библиотек на них: jsoup и AngleSharp отличаются на 1–3%.
Rust и Python-обёртка над Rust проседают на Windows из-за системной кучи (см. тезис 3). На XPath в Python разрыв почти двукратный: 243 μs против 123.
Интерпретаторы и C-библиотеки зависят от сборки. Одна из причин в PHP: официальные сборки под Windows делает MSVC, а он не умеет computed goto, поэтому Zend VM там работает в более медленном режиме CALL вместо HYBRID. lxml на Windows в 2.6 раза медленнее, Nokogiri — на 40%. Но бывает и наоборот: selectolax и htmlparser2 на Windows быстрее на 7–11%. Всё решает конкретная сборка конкретной библиотеки.
Go на Windows медленнее на 22%, хотя аллокатор у него свой. Объяснения у меня нет — буду рад подсказкам в комментариях.
Отдельная провокация: если ваш сервис на PHP или на Python с lxml крутится на Windows, переезд на Linux даст больше, чем переписывание на другой язык.
Тезис 8. Самый быстрый язык — не самый многословный
Сколько непустых строк заняла одна и та же функциональность:
Язык | Строк |
|---|---|
TypeScript | 5,950 |
C# | 6,950 |
Java | 7,170 |
Go | 8,800 |
Ruby | 8,900 |
PHP | 10,100 |
Rust | 10,750 |
Python | 790 (обвязка над Rust) |
Rust-версия — одна из самых быстрых и самая длинная. Ruby, известный своей лаконичностью, оказался длиннее C# и Java: когда пишешь на Ruby парсер, который должен быть быстрым, идиоматичный Ruby заканчивается и начинается ручная работа с индексами в строке. На TypeScript вышло короче всего.
Оговорки, без которых меня справедливо разнесут
Это один алгоритм, один автор и одна задача. Разбор HTML — это работа со строками и ветвлениями; на численных задачах, на многопоточности или на I/O картина может быть другой.
Порты оптимизированы неодинаково. C#-версия — оригинал, остальные — недельные порты. В Go и Ruby наверняка осталось что ускорить. Пулреквесты, которые двигают свой язык вверх по таблице, приветствуются.
Разные измерительные стенды и шум до 10%. BenchmarkDotNet,
testing.Bи самописный медианный цикл немного по-разному считают, а сервер не простаивает. Разница в 10% между соседними строками — ничья; разница в 2 раза — нет.Всё по умолчанию. Go без PGO, Rust без
target-cpu=nativeи с системным аллокатором, как в большинстве проектов. Векторизованный поиск символов в Rust (memchr) сам определяет AVX2 во время работы.Python — это Rust. Я это сказал. Чистая Python-реализация была бы в районе Ruby, а то и ниже.
Windows — в виртуалке. Для наших парсеров она ничего не стоит (Rust + mimalloc), но библиотекам, которые строят большие DOM-деревья, виртуализация может стоить больше: промахи TLB при двухуровневой трансляции адресов дороже.
Однопоточный замер. В многопоточном скрапинге в игру вступят GC, аллокаторы и модель потоков — и серверный GC может показать себя иначе. Это тема отдельной статьи.
Итог
Если для холивара всё-таки нужна одна строчка: на разборе Rust ≈ C# ≈ Java ≈ Python (Rust внутри) > Go > Node.js > PHP > Ruby + YJIT > Ruby.
Но если вы хотите, чтобы ваш скрапер стал быстрее, менять язык — не первое, что стоит делать:
Язык при одном и том же алгоритме даёт 1.5 раза между первой четвёркой и Go, 3.3 раза — до Node.js, 6.4 раза — до PHP.
Алгоритм внутри одного языка даёт от 1.5 до 226 раз против местных библиотек, причём порты на PHP и Ruby обгоняют библиотеки на C.
Настройки рантайма весят почти как язык: NativeAOT вместо JIT — на 20–50% дольше, системный аллокатор Windows — до полутора раз дольше для Rust, Windows вместо Linux — на 43% дольше для PHP.
Структуры данных важнее языка, а рантайм и ОС — почти так же важны, как язык.
Все восемь реализаций и бенчмарки открыты — запускайте на своём железе и присылайте свои цифры. Для C# варианты JIT/NativeAOT и workstation/server GC запускаются одной командой: dotnet run -c Release --project benchmarks/z3l.FastHtmlParser.Benchmarks -- --runtime-variants --filter '*ParseBenchmarks.FastHtmlParser' '*ScrapeBenchmarks.*_FastHtmlParser*'.
Первая статья, про C#-версию: https://habr.com/ru/articles/1106746/
C# (оригинал): https://github.com/romanti3172/z3l.FastHtmlParser
TypeScript: https://github.com/romanti3172/fasthtmlparser-js
