Обновить
64K+

SQL *

Формальный непроцедурный язык программирования

109,95
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Как посчитать всё на свете одним SQL-запросом. Оконные функции PostgreSQL

Время на прочтение5 мин
Охват и читатели656K

Я с удивлением обнаружил, что многие разработчики, даже давно использующие postgresql, не понимают оконные функции, считая их какой-то особой магией для избранных. Ну или в лучшем случае «копипастят» со StackOverflow выражения типа «row_number() OVER ()», не вдаваясь в детали. А ведь оконные функции — полезнейший функционал PostgreSQL.
Попробую по-простому объяснить, как можно их использовать.


Читать дальше →

Adminer — веб-интерфейс для баз данных размером в один .php файл

Время на прочтение1 мин
Охват и читатели87K


В свете недавнего поста про сравнение PostgreSQL и MySQL, в комментариях возникла проблема выбора удобного интерфейса для работы с постгресом. Я сам столкнулся с такой проблемой, решив поискать альтернативы всем известному phpMyAdmin / php*Admin, который считается стандартом у веб-мастеров.
Читать дальше →

Переход из SQL на NoSQL: опыт проекта СМЭВ 2.0

Время на прочтение4 мин
Охват и читатели37K
В последние годы NoSQL и BigData стали очень популярными в ИТ-индустрии, и на базе NoSQL успешно реализованы тысячи проектов. Часто на разных конференциях и форумах слушатели задают вопрос о том, как модернизировать или перенести старые системы (legacy) в NoSQL. К счастью, у нас был опыт перехода из SQL на NoSQL в крупном проекте СМЭВ 2.0, о котором я и расскажу под катом.


Читать дальше →

12 типичных ошибок при бэкапе баз данных

Время на прочтение8 мин
Охват и читатели128K

Изначально эта статья задумывалась только для разработчиков и администраторов СУБД Firebird, но после общения с администраторами других БД выяснилось, что большинство ошибок общие, и на очень похожие грабли наступают буквально все. Если Вы можете что-то добавить к этому списку (пусть даже специфическое для конкретной СУБД), пишите в личную почту или в комментариях.
In English: 12 Common Mistakes while Backing Up Databases

Наша компания занимается инструментами восстановления, резервного копирования, оптимизации и поддержкой СУБД (в основном Firebird, но есть и MSSQL, PostgreSQL, InterBase и др.) и, как результат многочисленных аудитов и ремонтов, накопила коллекцию ошибок, связанных с резервным копированием. Все пункты ниже изложены по мотивам реальных случаев с повреждением баз, потерей и повреждением бэкапов, дисков, сбоями серверов, и прочих «радостей» администраторов БД.

Хотелось бы о них рассказать, чтобы администраторы и разработчики могли поменять свои подходы к управлению бэкапами и предупредить возможные проблемы.

Итак, приступим.
Читать дальше →

PHP и OData: пересаживаемся с велосипедов на технологию от Microsoft

Время на прочтение15 мин
Охват и читатели24K
Нынче модно делать API и многие из нас уже реализовывали какие-то API на PHP. Одна из задач REST API — отдавать наборы данных, чтобы их в конечном итоге отобразить в табличном виде. Для этого, помимо прочего, приходится решать такие задачи:

  • провалидировать запрос,
  • отфильтровать данные,
  • отсортировать данные,
  • запрашивать и отдавать не все колонки, а только некоторые,
  • реализовать пагинацию.

Не знаю как вы, но я вижу, что часто это делается велосипедными решениями. Задачи с виду не сложные, но чтобы их решить качественно, приходится потратить немало времени на разработку, документацию и разъяснения коллегам, как работает ваше изобретение. Я расскажу о том, как можно реализовать эти задачи весьма технологично с помощью OData.

image
Читать дальше →

Бесплатный семинар по большим базам данных Firebird

Время на прочтение1 мин
Охват и читатели5.9K

Firebird Project и компания IBSurgeon (IBase.ru) приглашают администраторов и разработчиков Firebird SQL, работающих с большими БД, на бесплатный семинар. Семинар пройдет 21 октября 2015 года в Москве. Для участия в семинаре необходимо приглашение — см. ниже.

Краткие темы семинара:
Читать дальше →

Обновление русской документации по Firebird 2.5 и бета документации по Firebird 3.0

Время на прочтение1 мин
Охват и читатели10K
Многие из уважаемых читателей Хабра, интересующихся Firebird, знают, что в прошлом году вышла документация по языку Firebird SQL на русском языке версии 2.5. Создание документации спонсировала Московская Биржа (да-да, та самая, про курс рубля на которой мы слышим каждый день) — как платиновый спонсор и один из крупнейших пользователей Firebird в России, и компания IBSurgeon/IBase, представляющая Firebird в России.

Но на этом работа не закончилась:
Читать дальше →

Не пора ли реляционным базам данных на свалку истории?

Время на прочтение10 мин
Охват и читатели33K
Здравствуйте, меня зовут Дмитрий Карловский и я… антиконформист, то есть человек, который не держится за свои привычки и всегда готов их поменять, если в том есть необходимость. Например, как и многие разработчики, я начинал изучение баз данных с реляционных. Хотя реляционная алгебра и довольно красива в своей простоте, я постоянно ловил себя на мысли, что пытаюсь впихнуть круглую фигуру в квадратное отверстие и получалось как-то не герметично.


Нет, я не буду рассказывать вам про MongoDB или ещё какую неполноценную «убийцу SQL». Статей на тему «SQL vs NoSQL» сравнивающих на самом деле реляционные субд с документными и так полно:


Но у большинства из них есть фатальный недостаток — авторы просто не в курсе, что моделей данных в СУБД есть куда больше, чем два упомянутых: от узкоспециализированных «словарей», то универсальных «графов». А популярные «реляционные» и «документные» находятся лишь где-то по середине между универсальностью и специализированностью.

Давайте сравним типичных представителей упомянутых типов СУБД (от большего к меньшему).

  • Популярность: Oracle, MongoDB, Redis, HBase, OrientDB.
  • Функциональность: OrientDB, Oracle, MongoDB, HBase, Redis.
  • Скорость: очень сильно зависит от задачи, данных и реализации приложения. Я пересмотрел кучу бенчмарков, везде всё по разному.
Читать дальше →

Snaql. Raw SQL в Python-проектах

Время на прочтение3 мин
Охват и читатели21K
В последний год у меня появилось новое правило — каждые 3 месяца изучать новый язык программирования и его экосистему. На это есть несколько причин: новые парадигмы, концепции, инструменты, да и просто интересно что там, по ту сторону набившего с годами оскомину Python. Это простое правило позволило изучить за текущий год современные хипстерские Go, Clojure и Rust, проникнуться их идеями и best practices, что, кстати, очень положительно влияет на стиль и качество кода, когда я пишу на своём основном языке.

Рассматривая стек Luminus, я наткнулся на простую и в то же время шикарную, на мой вкус, библиотеку Yesql для организации SQL-запросов в проекте на Clojure и я не увидел чего-то похожего для Python (может плохо искал). Идея этой библиотеки простая — не морочьте себе голову, используйте обычные SQL-запросы, у вас есть возможность именования этих запросов и мапинга на соответствующие динамические функции. Всё это выглядит как набор микро-шаблонов с SQL и их рендер по какому-то контексту. Просто, эффективно, хочу такое у себя в проекте на Python.

Читать дальше →

Рефакторинг схем баз данных

Время на прочтение19 мин
Охват и читатели21K
Я хочу рассказать о рефакторинге схем баз данных MS SQL Server.

Рефакторинг — изменение во внутренней структуре программного обеспечения, имеющее целью облегчить понимание его работы и упростить модификацию, не затрагивая наблюдаемого поведения.
— Martin Fowler

О рефакторинге кода говорят уже давно. На данный момент написано немало литературы, создано множество инструментов, помогающих выполнять рефакторинг кода.
А вот про рефакторинг схем баз данных не так уж и много информации. Я решил немного восполнить этот пробел и поделиться своим опытом.
Читать дальше →

IBM Cognos BI и QlikView, с чего начать любопытному?

Время на прочтение4 мин
Охват и читатели22K
image

Некоторое время назад я написал статью, в которой относительно кратко описал механику работы с BI системами на примере IBM Cognos BI. Я решил немного развить тему, и сделать своеобразное «сравнение» аналитических продуктов IBM Cognos и QlikView.
Сам материал публикации нельзя назвать сравнением, это больше инструкция «с чего начать?». Я продемонстрирую как сделать относительно несложный отчет 2-мя инструментами — IBM Cognos BI и QlikView, а вы уже сами решите, какой из них больше вам подходит (или не подходит).
Материал статьи будет изложен в виде комбинации немного текста и много видео (любители почитать могут сходить в статью про IBM Cognos BI). Я надеюсь, что такой способ донесения информации будет удобен и сократит время создания материала
Читать дальше →

SQL Insert Injection в одном интернет магазине

Время на прочтение13 мин
Охват и читатели60K

Давно на Хабре не звучали истории про SQL injection. А уж рассказов из жизни про SQL INSERT injection вообще очень мало. Поэтому расскажу свою.
Лирическое вступление

Всё началось с моего желания купить себе нечто недешёвое в разборном виде в интернет-магазине A.B.ru фирмы B. После оформления, связи с менеджером по электронной почте, получения посылки и обзора её содержимого оказалось, что некоторых метизов очень не хватает. Полного перечня всего необходимого не было, лишь список болтов, гаек и шайб. Я начал сборку, дойдя до того места, где без отсутствующих болтов уже никак не обойтись. Поэтому мною было скурпулёзно составлено описание не найденных метизов и выслано электронным письмом той же девушке-менеджеру, с которой мы общались. К чести магазина стоит сказать, что практически всё необходимое было выслано второй посылкой. Поэтому я начал сборку, загоняя в дальний угол своего разума опасения о том, что может отсутствовать что-то ещё. Но, дойдя до финишной прямой, оказалось, что примерно 1/4-ой часть устройства не хватает в принципе, судя по фотографиям из руководства и здравому смыслу. Поэтому за первым письмом о недокомплекте последовало второе, куда более обширное, а сборка отложена.
Когда прошла вторая неделя ожидания, мне удалось убедить себя в том, что девушка-менеджер вышла в отпуск. Поэтому я переслал ей письмо двухнедельной давности ещё раз и перешёл к поиску других каналов электронной связи — очень уж не хотелось звонить в Москву. В первую очередь тоже самое письмо было отправлено на общий эл-адрес A@B.ru, на что был получен мгновенный ответ: почтовый сервер отказывается принимать письмо из-за переполненного ящика получателя <мужик>@B.ru. Тогда была найдена форма обратной связи на сайте — последняя ниточка соединяющая меня на текущий момент с интернет-магазином. В первую очередь я описал проблему переполненного почтового ящика и вставил сообщение об отказе доставить письмо, которое содержало в себе одинарные кавычки…

Начало

На попытку отправить отчёт об ошибке через форму обратной связи, на пару секунд на странице появилась ошибка, в которой угадывался голос MySQL. Поэтому я открыл консоль браузера, повторил запрос и заглянул в ответ сервера:
Читать дальше →

Поддержка PostgreSQL в Meteor

Время на прочтение2 мин
Охват и читатели10K


В популярной платформе для быстрого создания веб-приложений скоро появится официальная поддержка SQL. Ранее разработчики неоднократно отказывались это делать, мотивируя тем, что SQL не вписывается в философию проекта. Однако, настойчивость сообщества сделала своё дело и уже сейчас вы можете попробовать предварительную реализацию поддержки SQL в Meteor. Все подробности — под катом!
Читать дальше →

Ближайшие события

Tutorial: присваиваем название процессу, исполняемому внутри SOA SUITE

Время на прочтение4 мин
Охват и читатели2.8K
Возможно вы не знали, но Московская Биржа – это группа компаний, и одной из наших самых больших и важных составляющих является Национальный расчетный депозитарий (НРД). Без НРД у профучастников российского и международного рынка не было бы понятных и прозрачных расчетных и депозитарных услуг, так необходимых при совершении сделок. Как и положено ИТ-компании, НРД совместно с Биржей постоянно совершенствует свою внутреннюю IT-архитектуру.

Начиная с 2014 года осуществляется внедрение и перевод интеграционного взаимодействия между внутренними системами на промышленное ПО промежуточного слоя – стек продуктов Oracle Fusion Middleware, центральное место в котором занимает Oracle SOA Suite. Этот продукт является узкоспециализированным и материалов на русском языке по нему крайне мало. В блоге Биржи мы планируем регулярно рассказывать о наших находках и открытиях, связанных с внедрением SOA Suite. Не стоит ожидать здесь появления полноценного курса, скорее это будут заметки на разные проблемные темы, для которых мы не нашли чётко сформулированных рецептов и теперь хотим поделиться своими результатами с другими специалистами. Надеемся, что в каждой статье читатель сможет найти для себя что-то новое и полезное.
Подробности

Cartesius — метод хранения и извлечения древовидных структур в реляционных базах данных или SQL деревья без червей и тараканов

Время на прочтение9 мин
Охват и читатели10K
Лучше совсем не помышлять об отыскании каких бы то ни было истин, чем делать это без всякого метода. (Рене Декарт)

image

Разработчику баз данных очень часто приходится иметь дело с древовидными структурами. Все в этом мире является частью одной или многих иерархий и поэтому умение эффективно хранить и управлять данными такого рода является очень важной задачей.

Существует много методов от самых примитивных до очень сложных и возможно слишком сложных. Мы не будем описывать их в этой статье. При желании вы можете найти множество прекрасных обзорных статей в интернете “Google forever”.

Мы представляем на суд разработчиков метод Cartesius который основан на представлении иерархической структуры на координатной плоскости где каждый узел имеет свою координату в виде двух параметров ord и dep.
Читать дальше →

Создание Excel файла из селекта с параметрами при помощи чистого PL/SQL

Время на прочтение2 мин
Охват и читатели12K
Так получилось, что только после того, как я написал первую часть я понял, что создать Excel файл — не фокус, хотя чисто профессионально, это было достаточно трудно. Первая статья состояла из двух частей:
  • Примерное описание языка предварительной обработки селекта
  • Проблемы, которые были решены в процессе написания

Честно говоря, я думал, что вторая часть важнее, ради нее я и написал статью.
Сейчас я думаю, что тема языка обработки селекта более важна.
Читать дальше →

CHECK CONSTRAINT в MS SQL — Грабли по которым мы прошлись

Время на прочтение9 мин
Охват и читатели77K

Данная статья будет про то, как одна дружная команда веб разработчиков, не имея в своём составе опытного SQL разработчика, добавила Check Constraint в таблицу и прошлась по нескольким простым, но не сразу очевидным граблям. Будут разобраны особенности синтаксиса T-SQL, а также нюансы работы ограничений (СONSTRAINT’ов), не зная которые, можно потратить не мало времени на попытки понять, почему что-то работает не так. Так же будет затронута особенность работы SSDT, а именно как генерируется миграционный скрипт, при необходимости добавить или изменить ограничения (CONSTRAINT’ы).

Дабы читатель поскорей понял, стоит читать статью или нет, я сначала рассмотрю абстрактную задачу, по ходу решения которой будут заданы вопросы «А почему так?». Если вы сразу будете знать ответ, то смело бросайте чтение и переходите к следующей статье.

Читать дальше →

PostgreSQL: Приемы на продакшене

Время на прочтение9 мин
Охват и читатели93K
Можно прочитать много книг по базам данных, написать кучу приложений на аутсорс или для себя. Но при этом невозможно не наступить на грабли, при работе с действительно большими базами/таблицами особенно, когда downtime на большом проекте хочется свести к минимуму, а еще лучше совсем избежать. Вот здесь самые простые операции, как например изменение структуры таблицы может стать более сложной задачей. Наиболее интересные случаи, проблемы, грабли и их решения из личного опыта с которыми нам на проекте Pushwoosh пришлось столкнуться описаны под катом. В статье нет красивых картинок, зато есть много сухого текста.

image
Читать дальше →

Создание Excel файла из селекта с параметрами при помощи чистого PL/SQL, как альтернатива Oracle*Reports

Время на прочтение8 мин
Охват и читатели43K

Цели, которых я хотел достичь


  • Excel, как результат селекта, текст которого процедура узнает только в runtime
  • Селект перед выпонением видоизменяется в соответствии с параметрами, которые получает процедура
  • Процедуре передаются параметры файла, который будет создан
  • Возможность получения результирующего файла в форматах Excel Workbook,CSV,HTML,XML

Хранимая PL/SQL процедура получает в параметрах
  • текст селекта
  • параметры файла Excel
  • параметры выполнения
и создает полноценный Excel с несколькими таблицами(sheets).
Я знаю, что есть Crystal Reports и Oracle BI Publisher.
Но, во-первых, это крупные продукты(с большими ценами...), а Publisher, насколько я знаю не работает как отдельный модуль без Oracle Business Intelligence Enterprise Edition. И кроме того, речь шла о довольно узкой задаче создания файла без layout.

В конце, я написал один PL/SQL пакет, который находится в database и может быть вызван из любой аппликации. В ходе написания я столкнулся со многими ограничениями и хочу рассказать о том, как их поборол.

Для тех — кто сомневается, я этого, конечно не мог знать заранее, но за несколько лет, что пакет работает в большой компании, у меня не было проблем свести RDF любой сложности, с многими триггерами/формулами, в один селект, хвала Ораклу. Наоборот, так как селект — стринговый параметр и его можно построить динамически, это дает большую гибкость. В параметрах можно задать даже имя таблицы.
Читать дальше →

Эффективная работа с SQLite на примере ICQ

Время на прочтение9 мин
Охват и читатели30K
Как и во многих других приложениях, нам в мобильном ICQ приходится хранить достаточно много информации: сообщения, контакты и тому подобное. Когда количество запросов к этим данным достигает какого-то критического значения, приложение начинает тормозить. Долгий запуск, медленное открытие чата, медленная отправка сообщений, постоянные спиннеры — все это жутко напрягает. Чаще всего причиной тормозов является неудачная работа с данными. В статье я хочу поделиться нашим опытом рефакторинга структуры данных, оптимизации запросов и некоторыми удобными приемами для миграции.

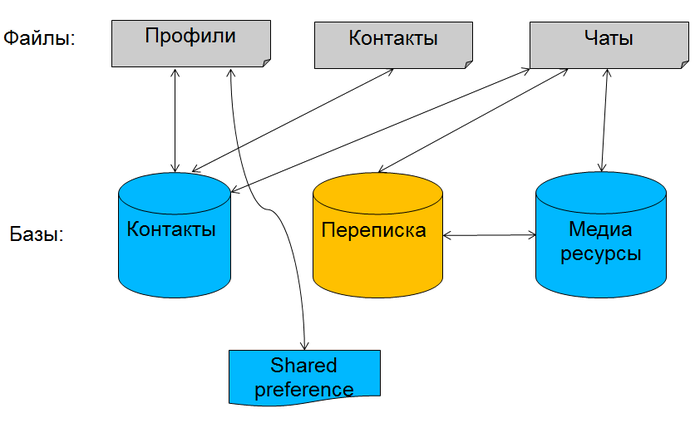
Несколько слов об исходной задаче. Основная сущность у нас — профиль ICQ, у которого есть список контактов, а у тех есть сообщения. Наше приложение существует уже много лет, разрабатывалось разными людьми с разными подходами, номер версии основной БД уверенно приближался к 30. Кроме того, количество фич в продукте невозможно предсказать заранее, это тоже повлияло на архитектуру. В общем, модель данных изначально была примерно такой:

Читать дальше →