Доказываем что любая сеть с любой памятью которая обновляется step-by-step - это аналог "быстрых весов".
Для начало быстро расскажу что такое концепт быстрых весов:
Быстрые веса - веса, которые сеть обновляет как "в контексте" (обновляет на основе контекста). Есть к этой концепции ещё и медленные веса - иными словами, самые обычные матрицы обучаемые и всё такое, что обучаем мы оптимизатором и бэкпропом.
С начало вспомним два правила обновления:
Ассоциативное правило обновления весов:
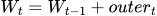
 - означает внешнее произведение двух разных (или не разных) векторов.
И правило обновления весов в любом нормальном оптимизаторе:
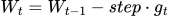
Где шаг может быть адаптивным.
Тогда, докажем что линейные трансформеры - и есть быстрые веса.
В линейном трансформере (ну, без "ядерного трюка") память обновляется как:
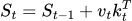
То есть внешнее произведение здесь -  .
Значит, линейный трансформер обновляет свою память как правило ассоциативного обновления весов (ассоциативная матрица иными словами).
Доказано.
Теперь возьмём, например, LSTM. Там память (векторная) обновляется как:
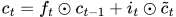
 здесь - это
 ,
 - это
 .
Но, чтобы доказать что состояние ячейки в LSTM - это быстрые веса - сделаем два допущения:
 - это аналог weight decay.
Операция прибавления может быть использованы для обновления весов (даже не быстрых)
Тогда - доказано.
Ну, а это означает что любая сеть которая обновляет свою память как LSTM (GRU например) - и есть аналог быстрых весов!
Но, RNN - единственная сеть с скрытым состоянием которая не может быть аналогом быстрых весов.
Всё из-за нелинейной функции.
RNN обновляет скрытое состояние как:
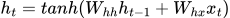
Обновление быстрых (и не только) весов не юзает нелинейность в самой формуле обновления - она обычно где то в другом месте.
Тогда можно убрать гиперболический тангенс, но тогда - это уже какой то линейный интегратор.
Всем удачи!
P.S: если вам кажется что мои доказательства неверные - не стоит сразу нажимать минус, напишите мне комментарий, я ещё учусь просто, и могу ошибаться.
UPD: оказалось, что это уже доказали ;( я думал я первый кто это сделал.
Правда, в том что большинство считают быстрые веса матрицей, но быстрые веса могут иметь ЛЮБУЮ размерность - хоть скаляр (0d).
Главное условие быстрых весов - они обновляются шаг-за-шагом и они обновляются на основе контекста.
Кстати - я забыл сказать что RWKV, Mamba, mLSTM (из xLSTM) - тоже аналоги быстрых весов (особенно mLSTM и RWKV).