Обновить

внезапно пришла идея - кажется витает в воздухе новый путь установки пакетов и вообще библиотек в приложения.

Начну как всегда из далека:
В последнее время, так как вместо человека теперь LLM чаще всего обращается к сайтам и приложениям, становится популярно добавлять специально написанные для llm страницы (как раньше sitemap, только теперь md файлы)

Это даже стало правилом для MCP серверов - например Cline добавляет только те MCP сервера, которые LLM может поставить в one shot или имеют llm-install.md файл.

По сути, кажется это становится файлом установки для llm - то есть, llm, следуя инструкциям этого файла ставит и конфигурирует MCP сервер на компьютере (прям как раньше, люди скачивали и устанавливали на windows).

Уязвимостей тут может быть много (потому что промпт может быть corrupt), но если следить за процессом и обязательно проверять команды исполнения - why not?

А теперь - представляете что можно сделать это для любого пакета и любого языка?

То есть, есть библиотека например для интеграции авторизации. Вместо того, чтобы разворачивать её вручную, автор библиотеки может написать llm-install и агент, имея контекст проекта в котором он работает, может целиком его развернуть!🙌
Креды например строго хранить в отдельном фале, не давать доступ (например использовать cursorignore etc..) и такие пакеты можно интегрировать как клиенту и бекенду!

И тоже самое можно применить и для удаления! И таким образом весь процесс интгерации станет больше как лего plug & play 🤩

Game changer?:)

Теги:
Всего голосов 1: ↑1 и ↓0+1
Комментарии0

125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

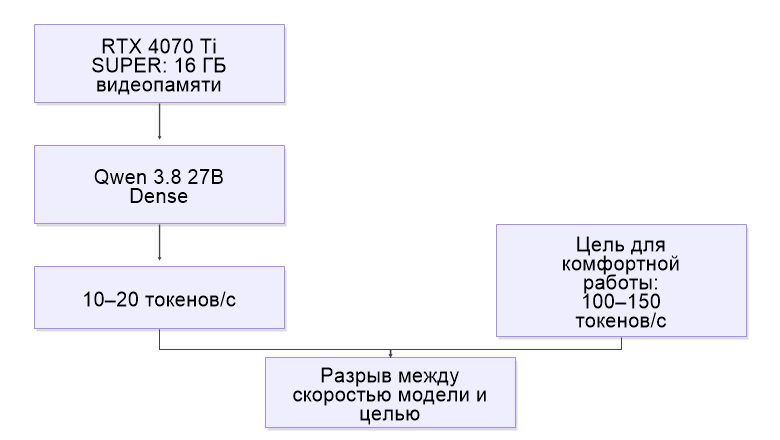
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом

Публикации