Обновить
128K+

Разработка мобильных приложений *

Android, iOS, Windows Phone и прочие

104,21
Рейтинг
Сначала показывать
Порог рейтинга

Когда результату проверки нельзя доверять: два кейса из практики iOS-разработки

После изменений в коде команда смотрит на результаты тестов и автоматических проверок: если все прошло успешно, кажется, можно двигаться дальше. Но успешный статус еще не означает, что проверка действительно выполнила свою задачу. А если тест обычно проходит, но иногда падает, такие сбои легко списать на случайность.
Ринат, iOS-разработчик в Naumen, рассказал о двух таких случаях из практики и о том, почему при оценке тестов он смотрит не только на покрытие.

Для меня тесты полезны, если после изменения быстро дают понятный ответ: нужное поведение сохранилось или что-то сломалось.

Если проверка выполняется сорок минут, периодически падает без причины или требует вручную разбираться в большом логе, ей перестают доверять разработчики. Вроде бы тесты есть, но перед релизом приложение все равно приходится перепроверять руками.

1️⃣ Проверка API прошла, но пропустила изменение 

В одном из наших SDK мы отдельно контролируем публичный интерфейс библиотеки. Проверка собирает актуальный артефакт, извлекает .swiftinterface и сравнивает его с сохраненной версией. Если публичный API изменился, разницу сразу видно в diff.

Однажды скрипт сравнил эталон с закэшированным фреймворком, который тоже был собран до правки. В итоге изменение осталось незамеченным, хотя проверка завершилась без ошибок.

После этого мы убрали автоматическое решение о том, можно ли использовать кэш. Проверка стала немного медленнее, зато снова начала отвечать на тот вопрос, ради которого существовала.

2️⃣ Интеграционный тест то проходил, то падал

Похожая история была с интеграционными тестами. Два параллельных запроса иногда забирали один и тот же одноразовый mock-ответ. Из-за этого тест обычно проходил, но время от времени падал.

Исправление заняло несколько строк синхронизации, но эффект оказался заметным: мы перестали относиться к случайному падению как к обычному шуму.

⭕️ Что для меня важнее покрытия

В обоих случаях проблема была не в количестве тестов. Одна проверка работала с неактуальной сборкой, другая давала нестабильный результат.

Поэтому я смотрю на три вещи: 

  • насколько быстро проверка сообщает об ошибке; 

  • понятно ли, что именно сломалось; 

  • можно ли доверять успешному результату.

Хорошая проверка не обязана охватывать всю систему. Чтобы проверить переходы между состояниями, достаточно юнит-теста. Для сетевой политики подойдет таблица ошибок и повторов, для публичного API — сравнение интерфейса.

Чем точнее тест проверяет то, что может сломаться при конкретном изменении, тем меньше времени уходит на разбор результата.

Теги:
+3
Комментарии0

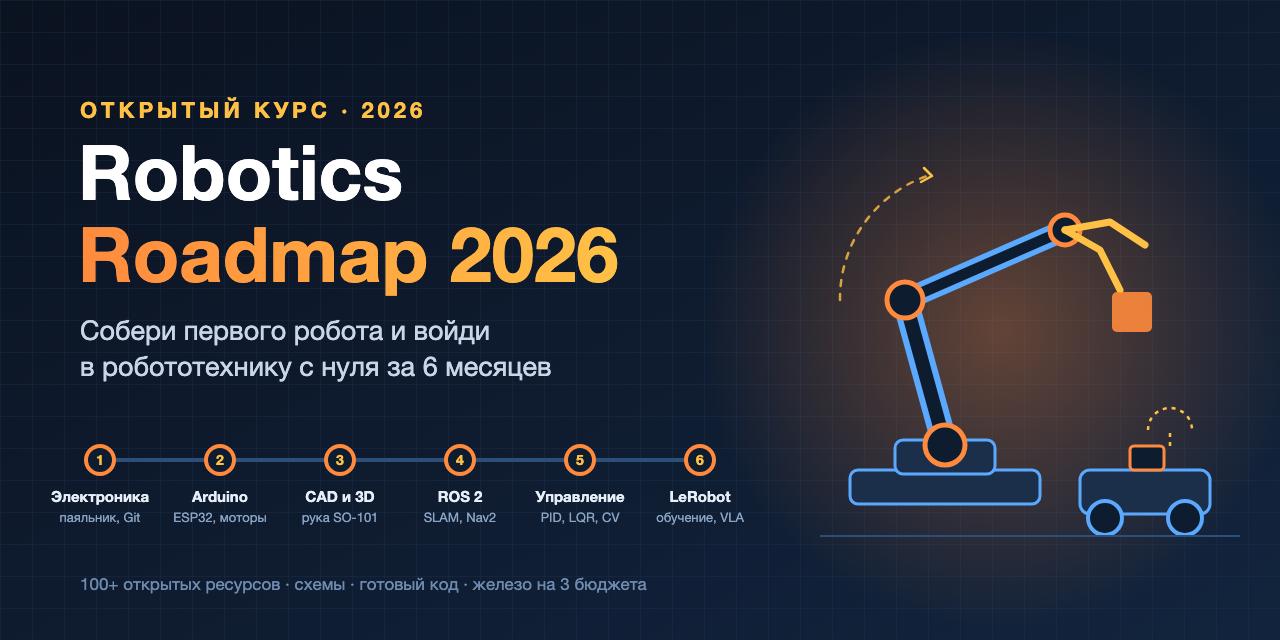
От первого мотора до робота, который учится по демонстрациям: открытая дорожная карта по робототехнике на русском.

Robotics Roadmap 2026 предлагает план на 24 недели при занятиях по 2–3 часа в день. Обучение начинается с электроники и постепенно переходит к управлению и машинному обучению.

Внутри шесть модулей:

- Электроника, Python и Git - базовые схемы и инструменты.

- Arduino и ESP32 — моторы, датчики, линейный робот и балансир.

- CAD и 3D-печать — сборка робота-манипулятора.

- ROS 2 — симуляция, построение карты и автономная навигация.

- Управление и компьютерное зрение — регуляторы, кинематика, работа с камерой.

- LeRobot — сбор демонстраций и обучение робота.

Есть схемы подключения, примеры кода, списки компонентов, справочник по отладке и 30 идей проектов.

Начать можно без покупки железа — в симуляторах. Дальше предлагается оформлять проекты в портфолио: видео, схема, код и разбор того, что сломалось и как удалось исправить.

Полезная отправная точка для программиста, который хочет заставить свой код двигаться в физическом мире.

https://github.com/justxor/robotics-roadmap-2026/

Теги:
+3
Комментарии0

Представлен открытый проект xtool для создания iPhone‑приложений на Windows — без покупки Mac и установки xCode. Решение является бесплатной альтернативой инструментам Apple для разработки iOS‑приложений.

Как работает проект:

  • пользователь пишет приложение на Swift прямо на Windows или Linux, а Xtool собирает его в полноценное iOS‑приложение;

  • Xtool получает все необходимые сертификаты Apple, подписывает приложение и устанавливает его на подключённый iPhone;

  • можно даже создавать приложения с интерфейсом SwiftUI и виджетами.

Теги:
+2
Комментарии0

Привет, Хабр! Меня зовут Антон, я сделал Android-приложение Watermark Studio для водяных знаков на фото и видео. Расскажу, как оно устроено, какие решения оказались удачными, а какие пришлось компромиссно упрощать. Это не обзор рекламы, а скорее заметки разработчика.

Задача и ограничения

Нужно было приложение, которое ставит знак (текст, логотип, QR-код, сетку) на фото и видео, работает на Android 9 и выше, не отправляет файлы на сервер и нормально чувствует себя на старых телефонах. Отсюда выбор стека: Kotlin, Jetpack Compose, Material 3, Navigation Compose, WorkManager для пакетной обработки, Room для шаблонов и истории. minSdk = 28, compileSdk = 35, сборка с R8.

Фото

Для фото всё довольно прямолинейно: знак рисуется на Bitmap через Canvas. Самое интересное тут не отрисовка, а то, что пользователь хочет видеть результат до сохранения и менять размер и поворот двумя пальцами. Я разделил модель знака (позиция, размер, прозрачность, угол, текст, логотип) и рендерер, который по этой модели собирает итоговую картинку. Один и тот же рендерер используется и для предпросмотра, и для пакетной обработки, поэтому результат на экране совпадает с сохранённым файлом.

Видео

Для видео я взял Media3 Transformer. Знак накладывается как оверлей на каждый кадр, звук при этом сохраняется. Для знака на весь ролик достаточно статического BitmapOverlay, а для движущейся метки нужен оверлей с меняющимся положением. Основные сложности тут не в самой накладке, а в том, что транскодирование на слабых телефонах идёт заметно дольше и требует аккуратной работы с памятью и прогрессом. Пакетная обработка до 10 видео за раз у меня идёт через WorkManager, чтобы задача переживала сворачивание приложения.

Удаление фона у логотипа

Логотипу нужен прозрачный фон, чтобы он нормально смотрелся поверх фото. Для этого я использую небольшую модель силуэтной сегментации в формате ONNX и ONNX Runtime на устройстве. Модель весит около 44 МБ, поэтому не зашита в APK: она скачивается один раз по запросу пользователя, дальше всё работает без интернета. Автоматический результат не всегда идеален, поэтому добавлена ручная подчистка кистью: пользователь стирает или возвращает участки маски. Это сильно улучшило практический результат.

Бесплатный лимит без аккаунтов

Тут пришлось подумать. Бесплатно доступно 5 фото и 1 видео в день, Pro выдаётся на срок. Аккаунты я заводить не хотел: это лишний барьер. Поэтому есть небольшой сервер (Python и SQLite), который хранит дневной счётчик по хешу устройства и проверяет коды активации Pro. Запросы подписываются HMAC-SHA256. Честный минус: секрет для подписи лежит в APK, так что клиентскую часть при желании можно обойти. Для моих целей это приемлемо, но вы должны это понимать, если делаете что-то подобное. Фото и видео на сервер не уходят вообще, только счётчик, активация и проверка обновлений.

Распространение

Пока приложение ставится по APK с сайта, оно само проверяет обновления и предлагает скачать новую версию. Установка только с подтверждения пользователя. Магазины приложений в планах, но на старте мне важнее получить живую обратную связь.

Что бы я сделал иначе

  • Сразу бы вынес рендерер знака в отдельный модуль и покрыл тестами: на нём держится вся логика.

  • Раньше бы начал тестировать на слабых телефонах, а не на своём.

  • Не стал бы класть секрет подписи в клиент, а продумал бы схему получше.

Буду рад вопросам и замечаниям в комментариях, особенно по Media3 на слабых устройствах и по схеме бесплатных лимитов без аккаунтов. Сайт проекта: https://watermarkstudio.ru

Теги:
0
Комментарии0

Превращаем смартфон во второй монитор за один клик на ПК с Windows. Японский разработчик представил бесплатный проект SlothMon, который расширяет рабочее пространство через беспроводное подключение:

  • на смартфон cкачивать и устанавливать ничего не нужно. Сканируем QR‑код с ПК и можно работать.

  • и это не отзеркаливание, а полноценный второй дисплей — на нём работает тач и перетаскиваются окна.

  • сайт решения пока только на японском.

Теги:
+5
Комментарии0

Как пройти путь от полного запрета ИИ до AI Native, где код пишут сотни агентов? Расскажем на GoCloud Tech 2026

Внедрение ИИ в разработку — это, к сожалению, не тумблер из легендарной Need for speed, который щелкнул и ускорился. По нашему опыту это путь через пять уровней зрелости, на каждом из которых свои бонусы и грабли. Расскажем, как мы продвигались от тотального запрета на ИИ к AI Native подходу, где сотни агентов пишут код практически без участия человека. Еще честно разберем, где ИИ реально дает +150% к продуктивности, а где превращается в −100% нервов. Обсудим потерю контекста, когнитивную усталость, боль с поддержкой легаси-кода и разный уровень зрелости внутри одной команды, а еще посмотрим на ситуацию глазами компании: безопасность, ценность SDD (spec-driven development) и границу между личными инструментами разработчика и корпоративной ИИ-инфраструктурой.

Спикеры:
Михаил Трифонов — лидер продуктовой платформы, Cloud.ru;
Руслан Таболин — руководитель направления, Cloud.ru.

Трек: Разработка

📅 Когда: 15 октября в 12:00–12:40 мск.

👉 Зарегистрироваться

А пока ждете выступление, можете посмотреть результаты нашего исследования: Почему пилотные ИИ‑проекты умирают, а теневое использование живет: итоги опроса

Теги:
Рейтинг0
Комментарии0

Голосовой ассистент в мессенджере Bitcord: живой разговор вместо переписки.

Наконец могу объявить о внедрении новой фишки в мессенджере Bitcord — функция живого голосового диалога с AI‑ассистентом. Не голосовое сообщение «записал — отправил — жду», а обычный разговор: говорите и сразу слышите ответ. При этом можно выбирать голос асистента и задавать его личные настройки: пол, возраст, манеру общения и прочее.

КАК ЭТО РАБОТАЕТ

  1. Запускаете мессенджер Bitcord.

  2. Выбираете в меню пункт — «GPT voice live».

  3. При необходимости настраиваете стиль ответа (промпт) и голос.

  4. Нажимаете «Connect».

  5. Удерживаете кнопку с изображением микрофона, пока общаетесь.

  6. Отпускаете кнопку — микрофон выключается для экономии ресурсов смартфона.

  7. Нажимаете снова и продолжаете общаться.

Это режим push‑to‑talk: контроль остаётся у вас. Пока кнопка зажата — идёт ваша речь; отпустили — микрофон выключается. Если ассистент ещё говорил, ответ можно оборвать тем же жестом.

Вcё ради удобства

Скорость. Иногда удобнее сказать в голос, чем набирать текст — особенно в пути, за рулём (если это безопасно) или когда руки заняты.

Естественность. Голосовой ответ воспринимается как короткий созвон, а не как переписка с ботом. Удобно уточнять детали, просить перефразировать, вести диалог «вопрос — ответ» без лишних тапов.

Контроль. Нет постоянного прослушивания: микрофон работает только пока вы держите кнопку. Настройки голоса и поведения ассистента сохраняются и применяются при создании новой сессии подключения.

Доступность. Голосовой канал проще для тех, кому тяжело много печатать, или когда экран неудобен.

Для чего в мессенджере?

Ассистент остаётся рядом с чатами, файлами и звонками — в том же привычном пространстве. Можно быстро спросить, уточнить формулировку, набросать план или просто «проговорить» мысль, не переключаясь в отдельное приложение. Можно настроить системный промпт на любого персонажа и даже включить взрослый контент. Указать имя, пол, возраст, описать игровую ситуацию и включиться в ролеплей без «тормозов».

Дальше, используя голосовой интерактив, планирую реализовать командный процессор, который будет вызывать другие сервисы: проверка погоды, курсы валют, актуальные новости с фильтром по теме и многое другое. И это в мессенджере размером в 3,5 мегабайта!

Github: https://github.com/BitcordMessenger

Теги:
Всего голосов 1: ↑0 и ↓1-1
Комментарии2

Нейросеть GPT-6 Astra собрала приложение Sweep, которое показывает прямо на полу, где уже прошлись пылесосом, а какие участки ещё пропустили. Камера смартфона отслеживает уборку и в реальном времени отмечает уже пройденные зоны.

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Хороший код: как понять, что его будет удобно менять

Понятные имена, небольшие методы и аккуратное форматирование делают код проще для чтения. Но даже аккуратный файл может оказаться дорогим в работе, если небольшое изменение требует восстановить много контекста и затронуть несколько частей системы.

Вместе с Ринатом, iOS-разработчиком в Naumen, разбираемся, почему хороший код проверяется следующей задачей, как проявляется сложность изменений и на что стоит смотреть при оценке кода.

Код проверяется следующей задачей

Пока работа над задачей еще свежая, почти любой код кажется понятным. Автор помнит, почему вызовы стоят именно в таком порядке, какой случай обсуждали на ревью и что здесь собирались переделать позже. Коллеги тоже держат часть контекста в голове.

Так что даже не самое удачное решение какое‑то время не доставляет особых проблем.

Через полгода ситуация меняется: исходная задача давно закрыта, участники обсуждения заняты другими частями проекта, а другому разработчику нужно внести небольшое изменение.

Именно в этот момент становится понятно, насколько код вообще рассчитан на изменения.

Простая задача может оказаться дорогой

Одна из задач у нас на планировании звучала безобидно:

После ошибки авторизации запрос повторять не нужно, после временной сетевой ошибки — нужно, причем с увеличивающейся задержкой.

Само условие укладывается в несколько строк. Но сначала приходится выяснить, где на самом деле живет это правило: в сетевом клиенте, в сервисе авторизации, в middleware.

А еще нужно понять, не запускает ли часть повторов таймер внутри другого объекта и не зависит ли соседний сценарий от текущего порядка вызовов. В итоге сам код меняется быстро, но день уходит на восстановление картины вокруг него.

Смотреть нужно на изменение, а не на файл

У кода есть свойства, которые легко заметить сразу: понятные имена, небольшие методы, аккуратное форматирование и простая структура. Все это полезно, но само по себе еще не говорит, насколько удобно систему менять.

Можно открыть класс и довольно быстро разобраться в каждом его методе. А потом выяснить, что для добавления одного состояния нужно исправить еще четыре модуля, обновить несколько почти одинаковых преобразований данных и соблюсти порядок вызовов, который нигде явно не зафиксирован.

Файл может выглядеть вполне нормально, а изменение при этом оказывается дорогим.

Мне в этом контексте близко описание сложности изменений у Джона Оустерхаута. Он выделяет три характерных проявления.

  • Маленькая правка расползается по системе

Добавили поле в модель и приходится менять сетевой слой, хранилище, аналитику, несколько экранов и тестовые данные.

Иногда это естественная цена изменения контракта, а иногда — признак того, что одно знание размазано по проекту.

  • Для локальной работы нужно слишком много контекста

Чтобы поправить один обработчик, нужно знать устройство навигации, жизненный цикл экрана, особенности кэша и два исторических обхода старых ошибок.

  • Есть зависимости, о которых разработчик даже не знает

Они обнаруживаются уже после изменения. Например, перестановка двух вызовов отключает сетевую проверку: первый метод использует закэшированное состояние и завершает сценарий раньше времени.

Эти признаки полезнее многих разговоров о «чистом коде»: о длине метода можно спорить, а вот с последствиями изменения — сложнее.

Обычно я смотрю на три вещи

  1. Сколько мест потребуется затронуть?

  2. Сколько информации нужно восстановить перед работой?

  3. Как быстро мы узнаем, что ошиблись?

Чем меньше ответ зависит от памяти конкретного человека, тем спокойнее живется проекту.

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

ИИ-ревью кода как сомнительное удовольствие

Этот пост написан как реакция на сегодняшнюю хабровскую публикацию - Проблема «принципал — агент» в эпоху ИИ‑агентов

В ней рассматривается "интересная" такая схема - отдавать результаты человеческого ревью кода ИИ-агенту.

Меня это в определенной мере удивило, потому что, судя по тому, что сейчас пишут в сети, то и код пишет агент, и ревью тоже агент делает. Чаще всего другой.

Например, код пишет Claude Code, а ревью делает Codex (И это еще хорошо, если они по своим возможностям в написании кода примерно равны, а то ведь агенты-ревьюверы могут быть и гораздо слабее агентов-кодеров).

Но вот остается вопрос: как решаются случаи, когда они расходятся во мнениях? Кому доверять больше? Устраивать дискуссии? И кто принимает окончательное решение?

Или, реальный случай: Claude Code в "холодной сессии" написал ревью своего же кода из порядка 20 пунктов. Тот же код и Codex пишет ревью на 8 пунктов.

Что дальше? - Разбираться самому человеку или снова устроить дискуссию между агентами?

И сколько токенов они сожгут в этой дискуссии? И сколько времени это займет? И где гарантия от того, что если они по отдельности галюционируют, то и вместе они не начнут делать то же самое, а то и провоцировать друг друга на эти самые галюцинации?

Т.е., получается, что выигрыш от такого "автоматизированного" под ИИ ревью становится сомнительным удовольствием.

Теги:
Всего голосов 3: ↑1 и ↓2+1
Комментарии4

Jetpack Room 3.0 теперь stable с кучей преимуществ для мультиплатформы и не только. Запланируйте интеграцию нового мажора.

У меня как раз есть статья

Теги:
Всего голосов 1: ↑1 и ↓0+3
Комментарии0

redb ecosystem
вышла версия 3.5.0(1) nuget
в ней Локальная база на клиенте
также новый коннектор redb.Route.As2 github
добавлены EIP паттерны
Message History EIP 
XSLT transformation
Routing Slip EIP 

посмотреть можно здесь github.com/redbase-app

хабр

Теги:
Всего голосов 2: ↑2 и ↓0+5
Комментарии0

Около €170 тыс. заработал разработчик, создавший приложение, которое позволяет светить вспышкой смартфона в лицо пользователя — за подписку в нём люди платят €70 в год. Автор уверяет, что такие вспышки помогают расслабиться, уснуть и войти в состояние, похожее на транс. За прошлый месяц приложение скачали 70 тысяч раз. Весь продукт состоит из фонарика и таймера.

Теги:
Всего голосов 2: ↑1 и ↓1+2
Комментарии0

Ближайшие события

Сравнение Code Fable и Codex по ходу работы над одним и тем же проектом

Вчера, 1-го июля, программисты и активисты начали бурную трудовую неделю. А именно: вернулась модель Fable 5 и она будет доступна в вольном режиме до (или по) 7 июля. Так что есть 7 дней, чтобы сделать буст своим проектам.

Я тоже не избежал этой участи и вот уже почти целый день делаю polishing своему текущему проекту мобильного приложения.

Что сказать про впечатления? - Ощущение вот того самого вайб кодинга, о котором говорил Карпаты. Говоришь ему что делать и он делает. Технических ошибок просто нет, от слова совсем. Есть ошибки архитектурные, но не существенные, исправляются одной-двумя итерациями.

И кстати, получилось сравнить с Codex'ом, который решил попробовать на старте этого же проекта. Результат сравнения такой: Codex очень сильно подтянулся в работе с кодом, иногда даже кажется, что нет различий.

Но вот вокруг кода хуже: болтливые они оба, но у Codex больше какой-то разболтанности, разбрасывания в стороны. Особенно это видно на написании документации, пишет незначительные детали, теряет главное. И слабее держит инструкции.

Code в этом отношении гораздо чётче действует. Более жёстко держит инструкции, больше памяти, что характерно, помнит предыдущий и даже предыдущие чаты. Меньше разбрасывания на второстепенные детали, чётче фокус. Даже чек-лист у него выглядит проще, чётче и понятнее, чем у Codex.

Единственное, что может я так натаскал Code. С другой стороны, не использую MCP, RAG, даже скилы и хуки. Зашил все в память, их там три: общая пользовательская, описание проекта и правила работы.

И напоследок обнаружил в Code очень полезную функцию оценки загруженности контекстного окна.

Может она уже давно там была, о ней вроде писали, но что-то казалось, что это в CLI. А теперь оказывается её можно использовать и в декстопной версии. Думаю и другим пользователям это тоже пригодится.

Обычно смотришь, если чат начинает тормозить, значит пора. Или спросишь саму модель, но она обычно отвечает, что если на глаз, то загружена на 75%, но лучше начать новый чат. А теперь можно точно увидеть процент загруженности. Более того, можно даже увидеть чем именно загружено контекстное окно.

Для этого в чате Code, в поле ввода достаточно ввести слэш команду - /context

Прикрепляю скриншот как это выглядит вживую

И ещё такое впечатление, что Fable стал жечь меньше токенов за счёт какого-то более делового, но все ещё дружелюбного стиля общения.

Так что, удачи всем с проектами на этой бурной трудовой неделе!))

Теги:
Всего голосов 3: ↑2 и ↓1+3
Комментарии0

Сравнение Claude Code Fable и Codex Open AI по ходу работы над одним и тем же проектом

Вчера, 1-го июля, программисты и активисты начали бурную трудовую неделю. А именно: вернулась модель Claude Fable 5 и она будет доступна в вольном режиме до (или по) 7 июля. Так что есть 7 дней, чтобы сделать буст своим проектам.

Я тоже не избежал этой участи и вот уже почти целый день делаю polishing своему текущему проекту мобильного приложения.

Что сказать про впечатления? - Ощущение вот того самого вайб кодинга, о котором говорил Карпаты. Говоришь модели что делать и она делает. Технических ошибок просто нет, от слова совсем. Есть ошибки архитектурные, но не существенные, исправляются одной-двумя итерациями.

И кстати, получилось сравнить с Codex'ом от Open AI, который решил попробовать на старте этого же проекта. Результат сравнения такой: Codex очень сильно подтянулся в работе с кодом, иногда даже кажется, что нет различий.

Но вот вокруг кода хуже: болтливые они оба, но у Codex больше какой-то разболтанности, разбрасывания в стороны. Особенно это видно на написании документации, пишет незначительные детали, теряет главное. И слабее держит инструкции.

Claude Code Fable в этом отношении гораздо чётче действует. Более жёстко держит инструкции, больше памяти, что характерно, помнит предыдущий и даже предыдущие чаты. Меньше разбрасывания на второстепенные детали, чётче фокус. Даже чек-лист у него выглядит проще, чётче и понятнее, чем у Codex.

Единственное, что может я так натаскал Claude. С другой стороны, не использую MCP, RAG, даже скилы и хуки. Зашил все в память, их там три: общая пользовательская, описание проекта и правила работы.

И напоследок обнаружил в Claude очень полезную функцию оценки загруженности контекстного окна.

Может она уже давно там была, о ней вроде писали, но что-то казалось, что это в CLI. А теперь оказывается её можно использовать и в декстопной версии. Думаю и другим пользователям это тоже пригодится.

Обычно смотришь, если чат начинает тормозить, значит пора. Или спросишь саму модель, но она обычно отвечает, что если на глаз, то загружена на 75%, но лучше начать новый чат. А теперь можно точно увидеть процент загруженности. Более того, можно даже увидеть чем именно загружено контекстное окно.

Для этого в чате Claude Code, в поле ввода достаточно ввести слэш команду - /context

Прикрепляю скриншот как это выглядит вживую

И ещё такое впечатление, что Claude Fable стал жечь меньше токенов за счёт какого-то более делового, но все ещё дружелюбного стиля общения.

Так что, удачи всем с проектами на этой бурной трудовой неделе!))

Теги:
Всего голосов 2: ↑1 и ↓1+2
Комментарии0

Сквозное шифрование, или как Telegram и Bitcord защищают переписку.

Хочу написать небольшой пост о сквозном шифровании, или, если использовать технический термин, E2EE (End-to-End Encryption).

Сегодня эта технология широко применяется во многих мессенджерах. Я тоже реализовал E2EE в мессенджере Bitcord . Однако далеко не все понимают, как именно работает этот механизм, поэтому попробую объяснить простыми словами.

Поскольку я являюсь разработчиком и основателем собственного мессенджера, реализовать эту схему для меня не составило особого труда. Главный секрет заключается в понимании принципов работы криптографических алгоритмов, таких как AES и RSA. Хотя современные реализации E2EE обычно используют не RSA, а алгоритмы на эллиптических кривых (например, X25519), я не стал прибегать к усложнениям.

Алгоритм AES я использовал для непосредственного шифрования текстового сообщения, которое один пользователь отправляет другому. Для шифрования применяется секретный ключ (или пароль). Основная проблема такого подхода заключается в том, что этот ключ необходимо каким-то образом передать получателю. Если злоумышленник перехватит ключ, он сможет расшифровать сообщение.

Чтобы этого не произошло, я использовал ещё один алгоритм - RSA. Для его работы требуется пара криптографических ключей: публичный и приватный. Так как RSA не предназначен для шифрования больших объёмов данных, я его использовал для безопасной передачи того самого секретного ключа, который используется алгоритмом AES.

В результате схема выглядит так.

Сначала текст сообщения шифруется алгоритмом AES с использованием случайного секретного ключа. Затем этот ключ шифруется алгоритмом RSA с использованием публичного ключа получателя. Когда получатель отправляет ответ, он выполняет ту же самую операцию, но уже с публичным ключом аппонента.

Важно понимать, что публичный ключ предназначен только для шифрования. Расшифровать данные с его помощью невозможно. Для расшифровки существует только соответствующий ему приватный ключ.

Когда получатель открывает сообщение, его устройство сначала с помощью приватного ключа RSA расшифровывает секретный ключ AES, а затем уже этим ключом расшифровывает само сообщение.

В моём приложении это работает следующим образом. Публичные ключи пользователей хранятся на сервере. Когда пользователь отправляет сообщение, приложение запрашивает у сервера публичный ключ получателя, шифрует сообщение на устройстве пользователя и отправляет на сервер уже зашифрованные данные. Сервер выступает лишь в роли посредника и пересылает этот зашифрованный пакет получателю. Сам сервер приватные ключи не хранит.

При этом приватные ключи никогда не покидают устройство пользователя. Они хранятся в защищённом хранилище смартфона, и получить к ним доступ не может ни сервер, ни разработчик приложения, ни кто-либо ещё. Поэтому расшифровать переписку может только владелец соответствующего приватного ключа.

В этом и заключается смысл сквозного шифрования: сервер передаёт сообщения, но не имеет возможности их прочитать.

Именно поэтому было довольно забавно наблюдать, как спецслужбы требовали у Павла Дурова "ключи шифрования", чтобы получить доступ к переписке пользователей Telegram. Никаких универсальных ключей у него нет и быть не может - приватные ключи находятся только на устройствах самих пользователей.

Именно поэтому требование "передать ключи" технически лишено смысла. Передавать попросту нечего.

П.С.

Я - сетевой долгожитель и начинал свой путь еще в эпоху Фидонета (FidoNet). Эта сеть была по-настоящему децентрализованной: никаких общих серверов и никакого DNS. Все строилось просто: компьютер, модем и терминальная программа для связи. Часто в роли узла (ноды) выступал сервер в банке, где знакомый сисадмин выделял адреса. При этом подключиться можно было к любому другому участнику, даже к частному лицу. Вот это и была настоящая децентрализация! Думаю, учитывая растущее давление регуляторов на современный интернет, мы скоро снова вернемся к проверенным идеям старого доброго Фидо.

Теги:
Всего голосов 5: ↑5 и ↓0+7
Комментарии0

Как я научил свою читалку различать примечания и комментарии в «Войне и мире»

Я не профессиональный программист. Пишу Android-читалку MRead для себя и для тех, кому тоже надоели комбайны. Код закрытый, всё работает локально, без серверов и трекинга. Раздаю через RuStore, 4PDA и GitHub.

В версии 1.4.0 я наконец победил баг, который меня лично бесил как читателя. Расскажу именно про него, потому что задача оказалась интереснее, чем выглядела.

Проблема

Открываю «Войну и мир». В одном предложении сразу два маркера сноски: примечание (перевод французского) и научный комментарий. В разных изданиях они нумеруются независимо, поэтому в тексте легко встретить два маркера с одинаковой цифрой. Старая логика по тапу вытаскивала из текста ближайшую цифру и искала абзац, начинающийся с этого числа, по всем главам, и показывала первое совпадение. Итог: тап по «6» открывал не ту сноску, а тап по числу вроде «1805» вообще пытался найти несуществующую сноску.

Почему наивный подход не работает

Цифра это не идентификатор. Она повторяется и в каждой главе, и между разделами «Примечания» и «Комментарии». А вот в исходнике всё однозначно: каждый маркер это ссылка с уникальным адресом.

EPUB: 1 FB2: [6] и {4}

То есть книга всегда знает правильный ответ. Беда была в том, что мой парсер при импорте выбрасывал href и оставлял только видимый текст маркера.

Что я поменял

  1. При разборе HTML сохраняю не только текст абзаца, но и ссылки-сноски с точной позицией маркера. Позицию считаю надёжно: оборачиваю маркер невидимыми символами из Private Use Area до очистки текста, а после очистки нахожу их и вычисляю смещение. Так цифры в обычном тексте (годы, числа) не путаются с маркерами.

  2. Позиции храню в абсолютных координатах главы. Это важно, потому что мой пагинатор режет абзацы на куски по строкам. Абсолютные смещения переживают нарезку без отдельной возни в пагинаторе.

  3. По тапу беру не цифру, а ссылку под пальцем, и резолвлю сноску по точному id из нужного файла. Для FB2 пришлось ещё и сохранить id секций сносок при конвертации в HTML, потому что примечания и комментарии лежат в отдельных главах.

  4. Старый поиск по цифре оставил как запасной вариант для книг без нормальной разметки, но убрал срабатывание на голые числа.

Результат: тап по примечанию открывает перевод, тап по комментарию открывает комментарий, а год «1805» больше никого не трогает.

Контекст для тех, кому интересно

Рендер текста у меня не WebView, а нативный движок на Canvas с собственной пагинацией (Jetpack Compose, Kotlin). Это даёт контроль над переносами, выравниванием по ширине и стабильной привязкой цитат и закладок, но за каждую такую фичу приходится платить ручной работой вроде этой истории со сносками.

Что ещё в 1.4.0, кратко

• Полнотекстовый поиск по PDF (для PDF с текстовым слоем)
• Озвучивание (TTS): голоса, скорость, таймер сна, автопереход, пауза с памятью места
• Передача слова во внешний словарь и контекст предложения в экспорт Anki
• Настраиваемые блоки настроек чтения, межабзацный интервал, Bold/Italic
• Полки, фоновый импорт из папок, оценки и заметки, Material You

Ссылки

• RuStore

• GitHub

• 4PDA

Если у вас была книга FB2, переоткройте её, чтобы заработали точные сноски (HTML генерится при импорте). EPUB подхватит сам.

Буду рад замечаниям по подходу. Если делали резолв сносок иначе, расскажите как, мне правда интересно.

Теги:
Всего голосов 3: ↑3 и ↓0+6
Комментарии0

Как я ускорил бэкапы в 20 раз и обошёл ловушку Jsoup: развитие самописной Android‑читалки MRead (v1.3.0)

Всем привет! Не так давно я рассказывал, как боль от перегруженных интерфейсов заставила меня открыть Android Studio и написать собственную читалку с кастомным движком рендеринга и точным выделением текста.

Статья получила теплый отклик и в комментариях набежало много отличных предложений. В этом посте я хочу поделиться техническими решениями, которые вошли в крупное обновление 1.3.0.

1. Бэкапы и боль от Storage Access Framework (SAF)

В приложении есть функция бэкапа: упаковка базы данных Room, настроек и распакованных HTML‑глав с картинками в один ZIP‑архив. Изначально я писал файлы напрямую в OutputStream, полученный через ContentResolver (SAF). Итог: библиотека на 500 МБ архивировалась около 5 минут. SAF проводит проверки безопасности для каждого записываемого чанка, что убивает I/O операции.

Решение: сборка архива переехала во внутренний кэш приложения. Туда пишем без ограничений SAF — буфером по 64 КБ и уровнем сжатия BEST_SPEED (картинки уже сжаты, гнать их через BEST_COMPRESSION бессмысленно). Когда ZIP готов целиком, он одним куском копируется в пользовательскую папку через SAF — вместо тысяч мелких защищённых записей получается одна

2. Material You: как получить правильные цвета обоев

При внедрении динамических тем (Android 12+) я столкнулся с тем, что стандартный вызов dynamicLightColorScheme().background на многих устройствах выдает просто унылый белый или бледно‑серый цвет, игнорируя сочные оттенки обоев.

Решение: Самые насыщенные цвета из системной палитры Monet хранятся в secondaryContainer и surface. Решение нашлось в самой палитре Monet: наиболее насыщенные цвета живут в secondaryContainer и surface, а не в background. Переориентировал маппинг цветов приложения на эти слоты и интерфейс действительно ожил. Теперь интерфейс действительно реагирует на смену обоев. Плюс привязал OnSharedPreferenceChangeListener, чтобы тема менялась мгновенно на всех экранах без перезапуска.

3. Странности парсинга FB2 и баги Jsoup

Иногда вместо обложки FB2 парсер ставил черно‑белую картинку из середины книги. FB2 хранит все изображения в тегах <binary> в конце файла в хаотичном порядке. Если тег <coverpage> отсутствует, старый алгоритм просто брал первую попавшуюся картинку из бинарной кучи.

Я переписал фоллбэк: теперь, если явной обложки нет, Jsoup ищет первый тег <image> прямо внутри <body> книги.

Попутно всплыло неочевидное поведение Jsoup: если атрибут отсутствует, attr() возвращает пустую строку, а не null — это задокументировано, но интуитивно ожидаешь null. Из‑за этого Элвис‑операторы (?:) молча проглатывали пустую строку вместо ухода в fallback. Написал строгую обертку takeIf { it.isNotEmpty() }, и теперь обложки извлекаются безошибочно.

4. Изолированный свайп яркости в Compose

Нужно было добавить регулировку яркости свайпом по левому краю экрана. Проблема: в режиме вертикального скролла (VerticalPager) свайпер страниц перехватывает вертикальные жесты на себя.

Решение: перехватывать жест на фазе Initial — до того, как пейджер успевает его обработать. Если касание началось в левых 15% ширины экрана, событие забирается себе и до пейджера не доходит.

Помимо этого в релизе 1.3.0:

  • Добавлен полноэкранный просмотрщик иллюстраций с pinch‑to‑zoom (на основе detectTransformGestures).

  • Написан собственный File Picker со сканированием вложенных папок и извлечением книг прямо из ZIP‑архивов на лету.

  • Добавлен поворот страниц для PDF с сохранением состояния в SharedPreferences.

  • Разделен UI верхнего меню: закладки теперь можно переименовывать, а тап по номеру страницы открывает быстрый переход.

  • Добавлен множественный выбор в библиотеке (массовое добавление на полки/удаление/скрытие).

Ссылки:

Теги:
Всего голосов 1: ↑1 и ↓0+3
Комментарии1

Дал большое интервью изданию Tazabek (деловое медиа Кыргызстана, входит в группу АКИpress) — про то, как мы с командой, начав с мобильного оператора, за пять лет собрали полноценную экосистему «Мой О!»: 3,5 млн клиентов и 10+ млн загрузок при населении страны около 7 млн.

Поговорили о том, что обычно остаётся за кадром историй успеха:

  • Почему телеком-финтех редкая история масштабного успеха не зависимо от географии, ведь стратегии и технологии у всех примерно одинаковые, но экосистемы получились не всех.

  • Какое архитектурное решение мы приняли на старте и ни разу не пожалели – про «сквозные», но не единые буквально данные, идентификацию и клиентский опыт.

  • Как устроенбаланс между скоростью и регулятором, и почему регуляторная песочница Национального банка — история не только про нас, но и про всю страну.

  • Трансграничные коридоры с Kaspi и Uzum — первые прямые финтех-коридоры в Центральной Азии.

  • Куда всё движется дальше: AI в каждом домене – от скоринга и антифрода до регуляторики.

И главный вывод, к которому мы пришли за эти годы: люди важнее технологий. Все провалившиеся проекты имели лучшие в мире технологии. Не хватило людей, которые собрали бы из этого работающую экосистему под конкретную страну.

Полный текст

А пока вопрос к вам: какие локальные финтех- или экосистемные проекты в ЦА и СНГ вы видели вблизи — и на чём они споткнулись? Интересны конкретные кейсы.

Теги:
Всего голосов 4: ↑3 и ↓1+4
Комментарии3

Помогите, кто чем может. Яндекс пробил дно

У меня айфон с маленьким экраном. Предпочитаю компактные модели, чтобы умещались в любом кармане. Это доставляет и некоторые неудобства. Например, часть приложений плохо работают, элементы интерфейса перекрывают друг друга, и из-за этого некоторые функции становятся недоступны. Иногда с такой проблемой я сталкивался в приложении Яндекс.Такси.

В связи с тем, что с продукцией Apple в России в последнее время ситуация постоянно ухудшается, планирую перейти на Android. Нашел подходящую модель на Яндекс.Маркете смартфон Conquest F3 Plus. Одна проблема — в этой модели экран еще меньше, чем у меня сейчас. Значит, есть риск, что приложения, которые глючили на старом смартфоне, вообще не смогут работать на новом.

С данным вопросом я обратился в поддержку Яндекса. Я был уверен, что получу точный ответ, будет работать приложение Яндекс.Go на интересующем меня устройстве или не будет. Ведь что может быть проще? Любой разработчик может, даже если не знает точно, в эмуляторе задать указанное разрешение экрана и прогнать тесты.

Ответом поддержки я был, мягко говоря, ошарашен. Ниже привожу текст нашего диалога со скринами.

Здравствуйте! Будет ли работать ваше приложение на вот такой модели смартфона?
https://market.yandex.ru/cc/9aPY2a
Разрешение экрана 540x1200.

Данную информацию вы можете уточнить в магазине приложений, из которого вы хотите скачать наше приложение

Я хочу купить новый смартфон, но мне нужно знать, будут ли работать нужные приложения. Ваше приложение очень плохо работает на экране с разрешением 1344x750. Хоть и работает. Какое разрешение поддерживает yandex.go? Будет ли оно работать на экране 540x200?

Данную информацию уточнить не получится, подсказать смогут в магазине приложений

Что значит, не получится? Напишите разработчикам, и они вам скажут.

Пожалуйста, обратитесь в магазин приложений для уточнения минимальных системных требований для корректной работы приложения

Какой магазин?

Магазин приложений вашего устройства

Итак, поддержка Яндекс.Go не смогла ответить на вопрос о системных требованиях собственного приложения. Неожиданно. У меня нет ни малейших идей, как такое стало возможно.

В связи с этим я решил обратиться за помощью к товарищам по отрасли. Может, кто-нибудь из читателей Хабра пробовал ставить Яндекс.Go на Android 12 с разрешением экрана 540x1200. Нормально работает?

Теги:
Всего голосов 8: ↑4 и ↓4+2
Комментарии29
1
23 ...