Обновить
3
Евгений Аблесов@Codebaker

Пользователь

Отправить сообщение

Тайм-менеджмент: эволюция

Время чтения1 мин
Охват и читатели23K
Года два назад я решил заняться тайм-менеджментом, так как мне казалось, что я живу крайне неэффективно и такими темпами никогда «не приду к успеху». Я прочитал несколько книжек и бесчисленное множество статей от доморощенных гуру тайм-менеджмента разной степени пришибленности. Я даже разработал собственную методику, включавшую в себя аспекты из нескольких систем, и написал специальный софт, так как всё, что имелось на рынке, было слишком жалким и недостойным моего внимания.

И только сейчас, когда 11 часов в день я трачу на работу, и реально свободное время появляется только в выходные, я понял, какая это всё хрень. Теперь я убеждён, что люди, которые занимаются тайм-менеджментом — банальные бездельники, которым просто некуда девать своё время. Они не находят для него лучшего применения, чем рисовать всякие хитровыкрученные схемки и вести десяток отдельных блокнотиков для дел типа «почистить зубы» и «пообедать». Их мозг изнывает от безделья, и они занимают его псевдонаучной жвачкой, которая даёт иллюзию продуктивной жизни.

Вы хотите жить эффективно? Устройтесь на работу с полным графиком, поступите в аспирантуру, начните ходить в спортзал и делать зарядку по утрам. Если покажется мало, то возьмитесь за два-три сторонних проекта. Через пару месяцев случится одно из двух: либо вы сдохнете, либо самоорганизуетесь и уже никогда не будете забивать голову ерундой вроде тайм-менеджмента.

О том, как я заставлял Ubuntu работать 10 часов от батареи

Время чтения11 мин
Охват и читатели200K
imageЯ являюсь рядовым линукс-пользователем и поэтому не стоит от этой статьи ожидать очень умных ходов или нестандартных программистских решений. Все по мануалам. Но раз результат достигнут, значит кому-то кроме меня это может оказаться полезным.

О том, как заставит ноутбук работать под линуксами как можно дольше, написано немало, в том числе и на хабре. В какой-то степени я еще раз соберу все советы воедино, от очевидных до обскурных, заодно опишу несколько проблем и решений, которые у меня оказались достаточно «индивидуальными».

Устанавливал я Ubuntu 10.10 на ноутбук Acer Aspire Timeline 5810TG. Эта машина обладает экраном в почти 16 дюймов и относительно производительным железом, зато батарея достаточно емкая, чтобы ставить с ней личные рекорды.
Читать дальше →

Поиск пути в гексагональной сетке (AS3)

Время чтения2 мин
Охват и читатели15K
imageЭта статья представляет собой описание компонента HexaPath, реализующего поиск пути по алгоритму А* в гексагональной сетке. В сети мной было найдено большое количество описаний алгоритма на примере квадратной сетки и некоторое количество реализаций, но ни одного упоминания о шестиугольной сетке. И я написал свою реализацию. Выкладываю исходники. Вдруг кому-нибудь понадобится это, а писать самому будет лень.

Читать дальше →

Применение алгоритмов нечеткого поиска в PHP

Время чтения7 мин
Охват и читатели31K
Вдохновленный топиками о нечетком поиске и фонетических алгоритмах, захотел попытаться реализовать нечто подобное похожее на гугловское «Возможно, вы имели в виду: ...» средствами PHP.

Для исправления опечаток в словах понадобится:
Расстояние Левенштейна (или расстояние Дамерау-Левенштейна — разница будет незначительной) — levenshtein()
Metaphone — metaphone()
Алгоритм Оливера — similar_text()
База русских слов (с падежами, учетом времен и т.д.).
Читать дальше →

Суффиксный массив — удобная замена суффиксного дерева

Время чтения14 мин
Охват и читатели37K
Здравствуйте, уважаемое сообщество! Думаю, многим знакома такая структура данных как суффиксное дерево. На Хабре уже было описание как его построить и зачем. Если вкратце, то оно нужно тогда, когда надо много раз искать какие-то произвольные образцы Xi в заранее заданном тексте A, а строится такое дерево мучительно с помощью алгоритма Укконена (есть и другие варианты, но они предполагают еще большее количество страданий). Общее наблюдение при работе с алгоритмами таково, что деревья — это, конечно, хорошо, но на практике их лучше избегать из за серьезных оверхэдов по памяти и не очень оптимального (с точки зрения эффективности оперирования данными компьютером) расположения. Кроме того, именно в таком дереве есть еще более существенная неприятность, а именно алфавитнозависимость структуры. Для решения этих проблем был придуман суффиксный массив. О том как его строить и как использовать и пойдет в этой статье.

Материал статьи предполагает знание понятий суффикса и префикса строки, а также знание того, как работает бинарный поиск. Надо также представлять, что такое стабильная сортировка и поразрядная сортировка, а также понимание, что имеется ввиду под стабильной сортировкой подсчетом. Для некоторых частей нам понадобится знание задачи о минимуме на отрезке — Range Minimum Query (RMQ). Ну, в общем, вас предупредили: никто не говорил, что будет просто.

Читать дальше →

Нечёткий поиск в тексте и словаре

Время чтения13 мин
Охват и читатели281K

Введение


Алгоритмы нечеткого поиска (также известного как поиск по сходству или fuzzy string search) являются основой систем проверки орфографии и полноценных поисковых систем вроде Google или Yandex. Например, такие алгоритмы используются для функций наподобие «Возможно вы имели в виду …» в тех же поисковых системах.

В этой обзорной статье я рассмотрю следующие понятия, методы и алгоритмы:
  • Расстояние Левенштейна
  • Расстояние Дамерау-Левенштейна
  • Алгоритм Bitap с модификациями от Wu и Manber
  • Алгоритм расширения выборки
  • Метод N-грамм
  • Хеширование по сигнатуре
  • BK-деревья
А также проведу сравнительное тестирование качества и производительности алгоритмов.
Читать дальше →

«Правильный» html парсинг

Время чтения7 мин
Охват и читатели112K
Логотип

Первый раз я запустил Eclipse еще весной, почитал книжки на английском, поставил SDK, немного поигрался и забросил. В начале зимы я купил себе первый смартфон на базе Android, но вновь вернутся к разработке меня подтолкнул недавний пост, в котором говорилось, что можно обойтись и знанием C#, с которым в отличии от Java я знаком. Мне было достаточно одного вечера, чтобы понять, что за связку Visual Studio и Monodroid я больше не сяду, позже я прочитал этот пост, где полностью согласился с автором.

После небольшого вступления перейду к теме топика. Довольно большое количество приложений под мобильные устройства взаимодействуют с сайтами и не секрет, что порой нужно получить какую-то информацию со страницы — это может быть курс валют или что-нибудь другое, и нет никакого желания делать это посредством браузера.

Большинство разработчиков, получают html код страницы и перегоняют его в xml, что является неправильным подходом, так как html является «правильным» xml не всегда, вроде на хабре писали, что для браузера не обязателен тег html (современный браузер и без него должен отобразить страницу) или просто будут ошибки, тогда на помощь приходят библиотеки. Из них я выбрал HtmlCleaner.

Под катом я расскажу, как подключить эту библиотеку, а также напишем простой парсер stackoverflow.com.
Читать дальше →

Облако тегов средствами XSLT

Время чтения7 мин
Охват и читатели3K
Не так давно столкнулся с необходимостью реализовать на одном из проектов то, что в народе называют «облаком тегов» — набор ссылок, в котором наиболее «весомые» элементы имеют бОльший размер. Для этого можно было бы, конечно, посчитать и получить все необходимые данные в PHP, на котором работает проект, но мне хотелось сделать конечный вариант отображения на XSLT и CSS, чтобы все необходимые величины для конфигурирования максимальных/минимальных размеров шрифта, например, были заданы в представлении, а не в логике приложения.

Возможно, кому-то мой опыт окажется полезным, поэтому публикую конечное решение здесь.

Итак, на входе у нас есть простейший XML с тегом и количеством его упоминаний:

Читать дальше →

Фонетические алгоритмы

Время чтения9 мин
Охват и читатели49K
Фонетические алгоритмы сопоставляют двум словам со схожим произношением одинаковые коды, что позволяет осуществлять сравнение и индексацию множества таких слов на основе их фонетического сходства.

Часто довольно трудно найти в базе нетипичную фамилию, например:
— Леха, поищи в нашей базе Адольфа Швардсенеггера,
— Шворцинегира? Нет такого!
В этом случае использование фонетических алгоритмов (особенно в сочетании с алгоритмами нечеткого сопоставления) может значительно упростить задачу.

Такие алгоритмы очень удобно использовать при поиске в базах по спискам людей, в программах проверки орфографии. Зачастую они используются совместно с алгоритмами нечеткого поиска (которые, несомненно, заслуживают отдельной статьи), предоставляя пользователям удобный поиск по именам и фамилиям в различных базах данных, списках сотрудников и так далее.

В этой статье я рассмотрю наиболее известные алгоритмы, такие как Soundex, Daitch-Mokotoff Soundex, NYSIIS, Metaphone, Double Metaphone, русский Metaphone, Caverphone.
Читать дальше →

Где спряталась логика?

Время чтения4 мин
Охват и читатели4.5K

Вопрос


Очень часто при обсуждении программ употребляется термин «логика» или «бизнес-логика».
Например:
  • (о юнит-тестах) не обязательно добиваться стопроцентного покрытия кода тестами, достаточно тестировать лишь логику.
  • (о веб-приложениях) контроллер не должен содержать никакой бизнес-логики, а должен только вызывать методы других классов
  • В слое VIEW (то есть в JSP-файлах) не должно быть бизнес-логики


Так вот, кто скажет мне, что такое «логика»? Надо ли понимать под этим любой IF в коде? Но разве бывает код без IF'ов? Или (бизнес-)«логика» означает любую информацию, которая исходит от клиента? Но разве можем мы на деньги клиента делать что-то, чего он не заказывал? Не можем. Стало быть, весь наш код — это целиком «бизнес-логика» от клиента. Вот поэтому я никогда не мог понять, что же такое эта чёртова логика.

Ответ:

Организация и оптимизация стилей

Время чтения9 мин
Охват и читатели24K
В этом посте я приведу пример организации стилей на типичном проекте.

Небольшое вступление, попробую объяснить актуальность проблемы и зачем это нужно.
Рассмотрим такую ситуацию. Разработчику ставят задачу, реализовать очередной функционал на сайте. Это допустим включает добавление новых разделов, блоков, элементов. Разработчики зачастую не доверяют чужому коду, и когда доходят до верстки, находят css-файл с названием типа main.css и дописывают в конец свои новые стили.
Проходит некоторое время, приходит новый разработчик, ему ставят подобную задачу, он если и пытается разобраться в стилях, то видит, что там нет никакой закономерности, и повторяет то же, что делали предыдущие.
Руководство ставит сроки, разрабатывается все новый и новый функционал, проект растет. В итоге css файлы превращаются в мусорку, сайт грузится дольше, появляется больше дефектов и т.д..
Я думаю, многим это знакомо.

Читать дальше →

Эффективная обработка фотографий в Gimp

Время чтения2 мин
Охват и читатели50K
Прочитав недавно на Хабре статью по обработке фотографий в Photoshop, захотелось рассказать, как можно cделать практически то же самое без использования таких монстров, как Photoshop, и без перезагрузок в windows.
Читать дальше →

SeekBar в настройках приложения

Время чтения5 мин
Охват и читатели22K


Для создания экранов настроек Android предоставляет очень удобный набор виджетов, таких как CheckBoxPreference, EditTextPreference, ListPreference. В случае, если существующие виджеты по каким-либо причинам не соответствуют требованиям, можно создать свой собственный на базе существующих.

Довольно часто встречается ситуация, когда та или иная целочисленная настройка имеет разумные пределы: яркость, громкость и т.д. В этом случае имеет смысл создать собственный виджет, чтобы многократно использовать его в приложении.
Читать дальше →

Знакомство с АОП

Время чтения10 мин
Охват и читатели134K

Парадигмы программирования


В современном мире IT-разработки существует довольно большое множество различных подходов к написанию программ. Так, например, кому-то нравиться представлять программу в виде последовательности действий, а кто-то считает, что программа должна представлять собой множество объектов, общающихся друг с другом. Совокупности этих идей и понятий образуют своего рода стиль написания программы, который принято назвать – парадигма программирования.

У каждой парадигмы есть свои особенности, однако, главным фактором, различающим их, является понятие основной единицы программы. Вот самые популярные из них:
  • инструкция (императивное программирование, FORTRAN/C/PHP),
  • функция (функциональное программирование, Haskell/Lisp/F#/Scala),
  • прототип (прототипное программирование, JavaScript),
  • объект (объектно-ориентированное программирование, С++/Java),
  • факт (логическое программирование, PROLOG).

Стоит заметить, что в общем случае язык программирования однозначно не определяет используемую парадигму: на том же PHP можно писать как императивные, так и объектно-ориентированные программы.

В этой статье я хочу рассказать о сравнительно молодой, но крайне, на мой взгляд, полезной парадигме программирования – аспектно-ориентированном программировании.

Читать дальше →

Простая защита от двойного запуска заданий cron

Время чтения2 мин
Охват и читатели26K
Хочу рассказать о простом скрипте, позволяющем защититься от двойного запуска заданий cron.

Допустим, раз в минуту вы обновляете некий кеш, чтобы стремительно отдать его миллионам посетителей сайта. Все идет прекрасно, но ровно до тех пор, пока глубокой ночью не запустится еженедельный бэкап и ваш кеш сформируется не за 10 секунд, а за 70, и на 60-й секунде его настигнет еще один процесс формирования кеша.

Что будет в таком сценарии дальше — вопрос весьма интересный. Велика вероятность, что два процесса будут активно мешать друг другу (они ведь работают с одними и теми же объектами), и их общее время выполнения будет отнюдь не в два раза больше, чем обычно, а если и третий настигнет…
Читать дальше →

[Перевод] 7 смертных грехов в разработке ПО

Время чтения6 мин
Охват и читатели3.9K
Друзья, представляю вам перевод статьи «The 7 deadly sins of software development» автора Neil McAllister, опубликованной на infoworld.com.

Читать дальше →

Заметки об объектной системе языка Python ч.3

Время чтения12 мин
Охват и читатели34K
Третья часть заметок об объектной системе python'a (первая и вторая части). В статье рассказывается о том, почему c.__call__() не то же самое, что и c(), как реализовать singleton с помощью метаклассов, что такое name mangling и как оно работает.

Читать дальше →

Детектор границ Канни

Время чтения6 мин
Охват и читатели102K
Доброго времени суток!

Последнее время, на Хабре часто стал упоминаться алгоритм выделения границ Канни (который, к моему удивлению, переводится дословно: хитрый). Итак, я созрел поделиться с общественностью своим опытом реализации этого детектора.
Читать дальше →

«Как доводить начатое до конца, если я …» или GTD и DISC для «нечайников»

Время чтения8 мин
Охват и читатели6.2K
image
В одном из предыдущих своих постов я пообещал продолжить тему о теории DISC для «нечайников». Сегодня очередной пост в эту сторону.
Наверное одним из ключевых моментов работы программиста, прожект-менеджера, да и вообще любого человека, как связанного с IT так и не связанного – это привычка, навык или умение доводить до конца начатые дела.
В этом посте мы разберёмся с этим вопросом.
Читать дальше →

Новая версия Developer Tools

Время чтения1 мин
Охват и читатели6.5K
В beta channel появилась новая версия инструментов разработчика с очень приятными изменениями.

Во вкладке Network

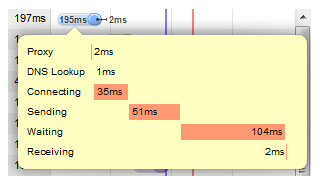
  • Появилась информация о фазах каждого запроса: сколько времени ушло на прокси, DNS, ожидание, отправку и получение данных


  • HTTP заголовки теперь берутся прямо из тела ответа, до того, как они были интерпретированы вебкитом, поэтому можно увидеть в точности то, что отправил сервер

  • Добавлена подсветка синтаксиса в теле ответа
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Москва, Москва и Московская обл., Россия
Работает в
Дата рождения
Зарегистрирован
Активность