Comments 96

Разработчики стали отказываться участвовать, потому что не хотят работать без ИИ. Один из участников не завершил ни одной задачи в условии "без ИИ". Другой признался: "У меня голова взорвется, если я попробую делать слишком много по-старому — это как идти пешком через весь город, когда привык вызывать такси".
METR заключает: "Разработчики, вероятно, ускоряются — но наши данные слишком слабы, чтобы доказать, насколько".
В оригинале:
METR заключает: "Разработчики, вероятно,
ускоряютсядеградируют — но наши данные слишком слабы, чтобы доказать, насколько".
Теперь пишет 99%

Разработчики стали отказываться участвовать, потому что не хотят работать без ИИ. Один из участников не завершил ни одной задачи в условии "без ИИ". Другой признался: "У меня голова взорвется, если я попробую делать слишком много по-старому — это как идти пешком через весь город, когда привык вызывать такси".
Ну если это так то наверно он прав. Правда правильнее было сказать что через 12 месяцев программисты деградируют настолько что уже не смогут сами писать код. Скорость деградации просто поражает.

Когда-то все писали в машинных кодах. (На компах лично я это не застал, но на ПМК я этим пару лет занимался с удовольствием.) Потом появился ассемблер, и разработчики деградировали - больше они писать в машинных кодах не способны.
Потом многие писали на ассемблере. (Тут я уже застал в полный рост, даже дипломную работу в компьютерном колледже написал на x86 ассемблере, а не на C/Pascal как большинство одноклассников. Было очень интересно делать разные системные штуки, которые на языках высокого уровня сделать было либо невозможно либо они делались крайне странно/неэффективно.) Увы, но я деградировал, и сегодня еле-еле способен асм читать, скорее догадываясь чем понимая современные диалекты. Писать точно не в состоянии.
Ещё вчера почти все писали на языках высокого уровня. А теперь они снова норовят деградировать, сволочи (и я тоже)! Никогда такого не было, и вот, опять! © (Ещё пару лет назад я писал тесты и учил других их писать так, чтобы это было не больно и полезно. А сегодня я тесты максимум проглядываю мельком, понимая их очень в общих чертах - примерно как ассемблер. Потому что их пишет ИИ, и от меня на ревью требуется убедиться, что тесты в принципе есть, и вроде бы тестируют реальный код на то, что нужно проверять - и всё. Вникать в реализацию тестов детальнее сегодня смысла вообще ноль.)
Так что да, скорость деградации поражает. Но, нет, это не проблема - потому что деградируют только ненужные навыки. Поэтому мы вполне можем называть этот процесс не деградацией, а развитием!
Вы хотели сказать отрицательным развитием.
Например в какой-то старой программе обнаружился баг. Но программисты код уже не понимают, поэтому исправить ничего не могут. И придется просить ИИ сгенерировать новую программу из-за бага.
Я теперь понимаю откуда берется выражение работает не трогай.
Но программисты код уже не понимают, поэтому исправить ничего не могут.
Такое имеет место давно, люди такое устраивали без всякого ИИ. Обычно в таких случаях либо ищут уникума, который ещё помнит как работать с этим кодом, либо переписывают на более современных технологиях, специалистов для которых на рынке хватает.
отрицательным развитием.
В каком-то смысле - так и есть. Но ручное написание кода - далеко не первый утерянный навык. Ещё мы (не программисты, а банально 99% городских жителей) разучились охотиться, строить себе дома, выращивать урожай, ковать оружие… деградировали, в общем.

Это еще что за манипуляции? Тут дураков нет. Строители разучились строить? Фермеры – растить урожай? Врачи – лечить? Только программисты теряют свои навыки, вот о чем речь. Везде нужен профессионализм, но именно программисты решили свалить свой труд на машину. Ни экскаваторы, ни самосвалы, ни комбайны не привели к деградации тех, кто на них работает. Машина может быть только помощником человека, но не может заменить его.
А программисты разучились программные продукты создавать?
Очень странные аналогии приводите
Операторы комбайна ничего не знают о пестицидах и удобрениях, без которых хоть сколько-то большая "ферма" не будет работать, да и о самом комбайне помимо кнопок, рычагов и удобности кресла тоже не особо знают, скорее всего
И они точно не возьмут в руки тяпки вместо комбайна чтобы самим грядки копать, даже если комбайн сломан
А программисты разучились программные продукты создавать?
К тому идет, разве не о том вся статья? Везде есть специалисты, которые отвечают за использование технологий, и только в IT решили переложить и работу, и ответственность на ИИ. Выживут те, кто сумел сохранить контроль и не утратить навыки.
Статья о том, что им лень писать код руками
Если есть специалист, то есть и ответственный
Как-то зашел к директору компании, разговариваем, он спрашивает – А что ты до сих пор машину не купил? – Да не нужна она мне, – говорю. А он, – А я без нее уже не могу, даже в магазин по соседству еду. Сам сидит такой, пузо до колен, еле дышит. Знакомы очень давно, весь его путь под горочку у меня на глазах прошел.
Нет уж, начинается может быть и с лени и экономии энергии, а кончается реальной деградацией, что умственной, что физической.
Как-то зашёл к владельцу 10 компаний, ему лень было заниматься операционкой, он все автоматизировал и делегировал и стал работать в 10 раз меньше, а зарабатывать в 10 раз больше, потому что появилось время на стратегию
О чем ваш коммент?

Нет, не выживут. Точнее, если и выживут, то не потому, что умеют кодить руками.
Еще раз, выживут те, кто не утратит навыки и сможет контролировать и исправлять то, что накодил ИИ, но лучше бОльшую часть делать руками, будет надежнее. Но нынешние надеются, что достаточно будет сказать трах-тибидох "исправь!". Он наисправляет. Амазон уже вляпался: https://t.me/banksta/89449

У вас правильные посылки, но нелогичный вывод из них. Действительно больше других будут ценится те кто может контролировать работоспособность проекта. Но это не значит, что лучше большую часть кода писать руками. Уже сейчас лучшие агенты вполне компетентно справляются с хорошо шаблонизируемыми задачами. Поэтому зачем продолжать писать большую часть кода руками? Я не знаю какие проекты Вы разрабатываете, но большая часть проектов в которых я работал состояла процентов на 40 минимум из рутины. Проектируешь БД, а потом руками пишешь CRUD который сравнительно простой по сути. Я не понимаю зачем возвращаться к написанию большей части руками. Проще попросить агента накидать тебе бойлерплейт, а потом довести его руками. Контроль сохранен, время и когнитивная энергия сохранена.

А программисты разучились программные продукты создавать?
Увы, разучились. Если приложение из трёх кнопок не работает без Интернет и весит 300 MB, то это не программный продукт, а говно.
Приложение из 3-х кнопок и 300мб это конечно сильный перебор. Но вот тейка относительно интернета не понял. Если апу требуется взаимодействие с сервером, то пардон, а как ему работать без интернета? Если взаимодействие с сервером не требуется, тогда вопрос, а почему оно вообще должно сломаться без интернета?

Ракетчики потеряли компетенции проектировать ракеты (в своих головах сначала). Медики потеряли компетенции лечить людей без программ. Учителя - учить детей без дивайсов.
Летчики современные, подозреваю, сами посадить самолет без вспоможения автопилота не смогут.
Компетенции теряются быстро и практически безвозвратно.

Летчики современные, подозреваю, сами посадить самолет без вспоможения автопилота не смогут
Конечно не могут, их же отдельно не тренируют и не обучают тому, как сажать самолёт в случае отказа автопилота))) И их конечно же не заставляют время от времени сажать самолёт вручную для поддержания навыков))) Так толсто не шутите уж, а то у меня животик лопнет

Охотиться разучились, когда начали заниматься сельским хозяйством. Ковать оружие 99% и так никогда не умели. Но охотники, строители, фермеры, спецы по работе с металлом остались и никуда не деградируют.

просить ИИ сгенерировать новую программу
Возможно процесс создания программ такой и станет.
Абсолютно верно. Уже много лет, как чтобы создавать программу, нужна грамотная среда разработки. Чтобы все можно было прокликать, чтобы везде был автосаджест, все подсвечивалось, линтеры, шминтеры. Уметь кодить в ноутпаде при прочих равных вряд ли давало какое-то важное преимущество. В простом текстовом редакторе можно было сделать только простые программы. Теперь просто всё шагнуло на следующий уровень.

Никто не мешает при наличии кода попросить ИИ исправить конкретный кусок. А потом допилить руками. Тем более, нормальные ИИ агенты уже некоторое время пишут достаточно читаемый код, а если просить к нему делать документацию, то можно получить и более-менее приличный проект, а не легаси из коробки

Например в какой-то старой программе обнаружился баг. Но программисты код уже не понимают, поэтому исправить ничего не могут. И придется просить ИИ сгенерировать новую программу из-за бага
Теперь будет 10 багов и снова никто не будет понимать код
ИИ точно так же починит баг в старой программе.
Мы 15 лет назад делали для одной компании CRM на PHP. И там до сих пор PHP был старой версии. Я просто скормил его claude. Пару дней пережевывал на легке. И теперь он крутится на восьмом. А я было уже отпустил это.

Осталось показать, что «машкоды → ассемблер → C/Pascal» и «неиспользование чатботов → использование чатботов» это процессы одного типа. А это не так. Полагаю, каждый думающий инженер давно пришёл пришёл к тому же выводу, что и я. Чатботы это новый способ реюза кода, пришедший на смену библиотекам, и по сравнению с библиотеками фундаментально поломатый:
Авторы библиотек несут хотя бы моральную ответственность за своё детище. Чатботы не несут никакой ответственности вообще.
Код библиотек обычно пишут грамотные инженеры, минимально прочитавшие документацию и знакомые с паттернами целевой платформы. Чатботы, судя по всему, не имеют никакого фильтра качества на входе, в датасетах (им бы побольше! ПОБОЛЬШЕ!), а в результате содержат (и щедро им делятся) код, написанный худшими макаками. За примерами далеко ходить не надо. Прямо тут, на Хабре, чел хвалился, что ему сгенерировали скрытие окна по имени заголовка — я бы за такой код руки вырвал. Вместо паттерна
pUserData(данные передаются к колбек через параметр) — явное использование стека (сохранение в переменную в общем скоупе), а это как моток провода вместо стяжечек и кабель-каналов. Работа со строками хреновая. Имена видаТутДолжноБытьИмяВашегоКолбекатупо скопированы из MSDN. Удачи с таким кодом, короче.Использование библиотек даёт стабильный результат, потому что код детерминирован. Чатботы принципиально работают с вероятностями (по сути, вероятностями того, какой кусок кода из базы тебе нужен — они же не понимают).
Код библиотек фиксится для всех. Например, рано или поздно автор кода для поиска окон в составе библиотеки WinAPI-полезняшек мог бы всё переписать, учтя вышеприведённую критику. Все, кому его код был выдан чатботом, будут вынуждены его фиксить по отдельности, потому что это самое пошлое копипастанье. В невиданных доселе масштабах.
При этом, память и диски подорожали в n раз, процессора на очереди, а окружающий четверг загажен отбросами дата-центров.
Осталось показать, что «машкоды → ассемблер → C/Pascal» и «неиспользование чатботов → использование чатботов» это процессы одного типа.
Думаю, это зависит от подхода к использованию ИИ. В моём случае это ощущается именно так - как повышение уровня абстракции, работа с кодом на более высоком уровне.
Я продумываю изменение функционала, проектирую - а ИИ потом тупо набирает и отлаживает тот код, который я в общих чертах себе представил по результату проектирования. В результате работа становится более творческой (в смысле, процент времени на проектирование увеличивается, а на механический набор кода и отладку уменьшается), фичи и багфиксы реализуются быстрее, процент покрытия тестами становится выше, документация обновляется оперативнее.
новый способ реюза кода
В моём подходе - это вообще не похоже на реюз кода, потому что ИИ просто набирает практически тот же код, который бы набрал и я сам. И на ревью я в основном сравниваю предложенный ИИ код с собственными ожиданиями и синхронизирую их.
А вот если подход не такой, как у меня, а вайб-кодинг - вот тогда да, это действительно похоже на то, что Вы описали. Ну так вайб-кодинг это не единственный вариант использования ИИ (как по мне - это вообще не вариант).

Так что да, скорость деградации поражает. Но, нет, это не проблема - потому что деградируют только ненужные навыки. Поэтому мы вполне можем называть этот процесс не деградацией, а развитием!
Тут есть один момент, который вы не учитываете: в истории человечества полно случаев когда они в своем развитии уходили не туда, и потом приходилось возвращаться назад и начинать заново.

А сегодня я тесты максимум проглядываю мельком, понимая их очень в общих чертах - примерно как ассемблер. Потому что их пишет ИИ, и от меня на ревью требуется убедиться, что тесты в принципе есть, и вроде бы тестируют реальный код на то, что нужно проверять - и всё. Вникать в реализацию тестов детальнее сегодня смысла вообще ноль.)
И что гарантируют такие тесты? Положим, что очередная правка функционала ИИ-моделью внесла ошибку. Так она и тесты соответствующим образом поправит, и таким образом ошибку замаскирует. И зачем тогда они нужны?
Я понимаю пользу создания костяка тестовой функции с помощью ИИ, например генерацию табличного теста (что вручную делалось в основном через копипаст). Возможно некоторые кейсы можно доверить. Но полностью отдать тесты ИИ... Это не тот уровень качества, с которым привык работать. В моей практике тесты это своего рода "двойная запись" из бухгалтерии, тщательная составленная манифестация ожиданий. И они не менее важны чем основной код, потому что грамотное покрытие позволяет релизиться в прод со спокойной душой.
И что гарантируют такие тесты?
Тесты, в том числе написанные людьми, вообще мало что гарантируют - из того, что нам бы хотелось, чтобы они гарантировали. Именно поэтому весь существующий код полон багов и уязвимостей, несмотря на покрытие тестами.
Если без иллюзий, то юнит-тесты гарантируют только то, что покрытый тестами код запускается и делает то, что от него ожидает автор тестов. Причём ожидания автора тестов могут быть далеки от реальных требований бизнеса к этому коду. Более высокоуровневые типы тестов проверяют что-то более близкое к реальным бизнес-требованиям, но из-за медленного выполнения таких тестов и сложности (из-за комбинаторного взрыва и невозможности мокать разные мелочи внутри) написания таких тестов - они проверяют незначительный процент реальных вариантов использования. В результате как ни танцуй, но никаких реально полезных для бизнеса гарантий никакие тесты не дадут - они просто проверят что базовые сценарии использования действительно работают (что уже не так и мало, но это нельзя назвать "гарантиями").
В случае ИИ у тестов появляется дополнительная задача: они нужны для того, чтобы автоматически вычистить из кода нейрослоп/галлюцинации, и сделать это до того, как показать сгенерированный код разработчику для ревью. Поэтому мельком глянуть наличие тестов, как я описал, обычно достаточно, чтобы появился смысл тратить своё время на ревью сгенерированного кода - по крайней мере это даёт уверенность, что это код более-менее рабочий.
Всё это не мешает отдельно попросить ИИ добавить тесты для конкретных use cases, и мельком глянуть что добавленные тесты действительно выполняют именно эти use cases. И в итоге обычно получается покрытие тестами (и качество этих тестов) не хуже, чем обычно при работе без ИИ - но как правило оно заметно лучше, потому что люди ленятся писать тесты, это всегда было самой неприятной частью работы.
Так она и тесты соответствующим образом поправит, и таким образом ошибку замаскирует.
Ну, люди тоже так частенько поступали. Иногда такое ловится на ревью, но нередко так и идёт в прод, пока этот баг не отрепортят пользователи.
И зачем тогда они нужны?
Убедиться что хоть что-то хоть как-то работает. Повысить шансы отловить регрессии при изменении кода. Это не те гарантии от наличия тестов, о которых мечтается, но тоже очень немало.
что вручную делалось в основном через копипаст
Через встроенные в IDE сниппеты оно делалось.
В моей практике тесты это своего рода "двойная запись" из бухгалтерии, тщательная составленная манифестация ожиданий.
Ну, никто не мешает и дальше настолько вкладываться в тесты. Просто эту манифестацию теперь достаточно изложить ИИ на русском чтобы он быстро набрал нужные тесты. И никто не мешает потом их тщательно ревьювить, если в этом ощущается необходимость. Но сам процесс набора этих тестов ИИ в любом случае сильно ускоряет, да и тесты обычно у него проверяют именно то, что сказано.

Как вы все любите сравнивать ухо с жопой. Переход от асм к си - это повышение уровня абстракции. А GPT - это лишь дополнительный инструмент, вроде появления текстовых редакторов и IDE. Да он может многое, но пока что нет такого GPT, решение которого бы сходились к правильному спустя какое-то количество итераций (без участия разработчика). Уже много было случаев когда из-за вайбкодеров компании потеряли деньги. И это только известные случаи.
пока что нет такого GPT, решение которого бы сходились к правильному спустя какое-то количество итераций (без участия разработчика)
Вы немного отстали - такой уже есть. При условии что проект не очень большого размера и приемлемости качества кода уровня миддл-разработчика. Но при росте размера проекта или заметном усложнении требований - проект начнёт разваливаться ровно так же, как он развалится если такой проект пишут одни миддлы. Хороший пример такой ситуации - как разраб Anthropic тестировал новую модель Opus 4.6 на задаче разработки компилятора C в стиле вайб-кодинга: https://www.anthropic.com/engineering/building-c-compiler
В это-то и суть моего утверждения, что взяв любой проект мы не можем быть убеждены что GPT доведёт решение а не надоедает кучу каши, не откроет кучу дыр в безопасности, не поломать логику. Даже было исследование - безопасность страдает очень сильно, ллм почти не справляются с ней.
А в вашем примере попросили написать код, который уже по факту написан, оно и не удивительно что зная исходный код компилятора можно и свой создать. Зная исходный код калькулятора тоже люди в ллм создают себе программы калькуляторы и радуются что скоро всех программистов заменят.
А почему интересно при замене программистов не говорят например про замену тех же самых топ менеджеров? Это же очевидно, ллм сама может прогнозировать, сама находить новые направления и анализировать ситуацию в команде и коде, сама анализировать рынок и много чего ещё. Можно я думаю все профессии заменить.
взяв любой проект мы не можем быть убеждены что GPT доведёт решение а не надоедает кучу каши, не откроет кучу дыр в безопасности, не поломать логику
Да, но с людьми ровно то же самое. Особенно если это максимум миддлы.
А в вашем примере попросили написать код, который уже по факту написан, оно и не удивительно что зная исходный код компилятора можно и свой создать.
Это, кстати, правда. И, тем показательнее описанный в блоге кейс: даже имея доступ (и на этапе обучения, и на этапе обработки промпта) к исходникам 100% рабочих компиляторов ИИ справилась с задачей далеко не на 100%. Но, опять же, я абсолютно уверен, что и обычные миддлы выдали бы примерно такой же результат, и тоже не смотря на доступ к исходникам других компиляторов.
А почему интересно при замене программистов не говорят например про замену тех же самых топ менеджеров?
Потому что топы - это не про работу руками (где ИИ что-то может), а про ответственность (где ИИ не может в принципе ничего). Прогнозируют и анализируют не топы, а аналитики/маркетологи/etc. - и вот их ИИ может заменить. (И да, в вырожденном случае, когда топ - это "племянник кого надо" и по факту никак не отвечает за свои решения - технически ИИ его заменить действительно может… только кто же позволит заменить племянника-то. Так что нет, ИИ топов не заменит никогда.)

Переход с ассемблера на высокоуровневые компилируемые языки - это нормально. Он произошёл почти без потерь в эффективности кода. Проблемы начались, когда программистам стало лень следить за памятью и они положились на сборщики мусора. А потом на типизацию забили. Хотя казалось бы, ну посидите вы подольше, напишите тот же код на плюсах. Или дождитесь появления раста. Нет, не хотят они ждать, хочется минимум приложения усилий и потом закинуть в продакшен. Наделали гигатонны веб легаси на жаваскрипте, которое жрет на пустом месте гигабайты памяти и простым людям теперь с этим жить. То есть программистам дали кость-заглушку и они на нее как псы набросились, да вот только зубами они ее грызут не только своими, но и пользовательскими. С нейронками так же по сути. Условный АГИ из будущего конечно же будет писать сверхвысокоэффективный код. Но его пока нет. И вы пишете говнокод прямо сейчас не с помощью "полноценного ИИ", а с помощью сраного т9. И людям потом ваш говнокод использовать и поддерживать. Очнитесь и осознайте, что вы тупо гадите.
Вы упускаете из виду, что гадят - не программисты. Программисты (настоящие, у которых глаза горят, а не вкатуны) как раз наоборот, по большей части перфекционисты и предпочли бы такого не делать. Ключевая причина в том, что бизнес требует "быстрее, больше, дешевле!!!" - и именно эту бизнес-задачу решают все упомянутые Вами подходы и технологии, включая текущий ИИ. А дальше в процессе работы программистам отбивают в принципе перефекционизм, они привыкают писать так, как нужно бизнесу - и потом тащат эти подходы даже в свои пет-проекты, к сожалению.
лень следить за памятью
А вот это не совсем правда. Без помощи инструментов (сборщика мусора или компилятора как в rust) люди за последние десятилетия однозначно продемонстрировали неспособность вручную уследить за выделением и освобождением памяти - нашего мозга на это физически не хватает, тут дело вовсе не в лени. (Во всём мире известны имена всего нескольких разработчиков, которым хватало мозгов писать надёжный и безопасный код на C. Добавим неизвестных героев - получим ну сотню, ну две сотни таких уникумов. В масштабе планеты это - погрешность.)
Проблемы сложности написания кода на сях решаема в масштабах человечества банальным наращиваем экспертизы со временем. Больше людей вовлекается в айти, больше пишет код, больше обучающих материалов и в какой-то момент количество переходит в качество. Вместо этого экспертиза размывается на множество разных парадигм и практик, из которых массы выбирают наиболее простые в написании и наименее эффективные в рантайме.
Ну а про бизнес это стандартная тема. И она не только в айти, но и во всех остальных сферах, вплоть до пищепрома. Вот только в пищепроме есть множество стандартов, за нарушение которых ушлый кабан может в тюрьму сесть, а так же акцизы на наиболее вредные продукты. А за медленный жрущий много ресурсов говнокод никаких санкций не наблюдается. Только если конкретная катастрофа случится с утечкой или порчей базы данных, только тогда что-то делают.
Проблемы сложности написания кода на сях решаема в масштабах человечества банальным наращиваем экспертизы со временем.
Так о том и речь. Мы наращивали экспертизу в C более 50 лет. И эта экспертиза нам однозначно говорит: ручное управление памятью абсолютно большинство разработчиков не вытягивают. Или Вы предлагаете ещё лет 50 понаращивать, в надежде что что-то изменится? :)

Не соглашусь, переход от низкоуровневых до высокоуровневых языков также сопровождался все более сложным функционалом. Например чтобы написать те же числа Фибоначчи на языке ассемблера нужно строчек 20 (если я правильно помню) ещё и с точным управлением памятью. А сейчас мы можем написать тот же функционал в одну строчку. И это очень минимальный пример, я даже не могу представить сколько строчек понадобилось бы чтобы написать какой-нибудь базовый сайт/приложение/программу, предполагаю, что поддерживать это было бы физически невозможно.
И тенденция с усложнением продолжалась все это время, сначала мы начали использовать библиотеки, потом фреймворки, потом уже целые экосистемы. То что мы пишем сегодня в объеме кратно меньше, чем даже 5 лет назад для одной и той же задачи.
А вот с приходом нейронок я начала видеть совсем другую тенденцию, задачи начали упрощаться, чтобы нейронка смогла хоть что-то сделать. Если раньше в моей компании около половины задач были достаточно интересными, приходилось посидеть подумать как их нормально сделать, рисовать диаграммы, то сейчас как будто ну процентов 15-20 от силы. Последние полгода я вообще какой-то фигнёй занимаюсь, и не могу даже показать свой потенциал не полную, тупо нет достаточно сложных задач. И это не только у меня, у многих моих друзей в других компаниях такая же история.
Так что как будто слово деградация более правильное, но не в контексте, что разработчики тупеют, а бизнес просто уже не хочет в качество и стабильность, теперь запрос на "быстро и костыльно, максимально с AI, но за баги по жопе получишь".
По личным ощущениям переход на AI вообще не оправдан, не понимаю почему многие прям с головой в это ныряют. Когда ты пишешь сам, ты отвечаешь за то, что ты пишешь, ты чётко знаешь где тестировать побольше, а где поменьше, тебе не нужно себя детально ревьюить. С AI ты не кодишь быстрее, просто круглосуточно делаешь ревью не оч опытного разраба, который ещё и вдолбится там, где ни один джун не споткнется. И тестишь как умалишенный. Я вообще не люблю code review и тестирование, а пытаясь использовать AI, я поняла, что только это и делаю сутками.
Сейчас мне вообще пофиг на эту движуху, если моя работа будет состоять в том, чтобы вечно читать плохой код, который ещё и фиг отрефакторишь, я лучше буду работать кем-то другим, но думаю останутся компании, которые будут ценить человеческий вклад.
Вы как-то не так используете AI.
Может модель слабая (попробуйте Claude Sonnet/Opus).
Может Вы режим агента не включили на полную (чтобы AI за один запрос написал и код, и тесты, запустил линтеры+тесты и исправил все ошибки, и только потом выдал результат на ревью).
Может Вы плохо ставите задачу модели, например не описав достаточно хорошо суть проекта и используемые подходы в CLAUDE.md/AGENTS.md (там должно быть примерно всё то, что выдаётся новичку при онбординге в проект). У Вас в профиле написано "ведущий", значит Вы умеете ставить задачи коллегам - вот ровно так же ставьте задачу и модели.
У меня вот эффект наблюдается прямо противоположный: задачи с ИИ стали крупнее, сложнее и интереснее. С ИИ я берусь за то, что раньше месяцами откладывал, потому что было сложно (или наоборот, нудно) подступиться к этим задачам.
И да, ровно как при переходе на высокоуровневые языки, количество строк уменьшилось на порядок - тех строк, что я набираю модели, чтобы получить тот же результат, как если бы я сам набрал код.
Нет разницы как я использую модель, проблема кроется глубже. Фундаментально меняется сам подход к работе, и тут уже неважно какого качества код выдаёт нейронка.
Я много лет вырабатывала навык понимания как кодить, с чего мне начать, где тестировать больше, где меньше. Я училась распознавать места где надо прям заложить какой-то паттерн, а где допустимо воткнуть костыль. У меня уже есть конкретный флоу по которому я работаю, я делаю небольшие изменения, смотрю как проект на это реагирует, проверяю слабые места, смотрю есть ли другие способы решить проблемы.
Когда я работаю сама, мне не нужно себя детально ревьюить, потому что каждая строчка продумана, я знаю что я лично ну какие-то логи могу пропустить или забыть написать комментарий на странном куске, но это в общем-то и все. Также мне не нужно тестировать каждую строчку, которую я пишу, потому что уже есть понимание, что сработает 100%, а что нужно проверить детальнее на разных сценариях.
Нейронка забирает на себя само написание кода, но зато приносит ряд других проблем. Ты не можешь доверять ей как себе, тебе нужно проводить детальное ревью каждую итерацию, тебе нужно вручную тестировать все, потому что сломаться может что угодно. И это просто совсем другой флоу. Работая с нейронками я 8ч просто делаю ревью и тестирую, а мне это вообще не нравится, это нагружает меня сильно больше, чем когда я пишу сама. Мне лично писать код нравится, нравится состояние потока, и нейронка не даёт мне в него войти.
Да, можно сказать, что вот когда-то она и сама будет делать ревью, и тестировать, но качество датасета всегда будет зависеть от публичных примеров использования, и если тебе нужен будет новый инструмент с плохо описанной документации или просто не самый часто используемый инструмент, качество кода очень сильно упадет, а навык разработки уже потеряется, потому что люди слишком легко привыкают не думать. И я пока не готова отказаться от своего опыта 🤷♀️
Когда я работаю сама, мне не нужно
Это правда. Но когда Вы работаете в команде (Вы же лид, ведущий - кого Вы "ведёте" если работаете в одиночку?) то всё, что Вы описали как "проблему работы с ИИ", ровно так же проявляется при работе с коллегами! И да, это совсем другой флоу. Но в одиночку много не наработаешь, к сожалению.
Мне лично писать код нравится, нравится состояние потока
Ну, у меня та же фигня. Но нейронка не может этому мешать. Есть поток и хочется писать код - пишите. Но когда поток сбивается из-за того, что происходит "неведомая фигня" или пора писать нудные тесты или нужно провести исследование - в этот момент вполне норм подключить ИИ.
Кроме того, состояние потока вполне норм использовать не для написания относительно низкоуровневого кода на конкретном языке программирования, а для проектирования решения текущей задачи на более высокоуровневом языке - русском. А потом спроектированную в потоке задачу выдать ИИ для механического набора кода, тестов, и отладки мелких проблем, которые Вы не предусмотрели. В целом это тоже очень близко к работе с коллегами, только если коллеге выдать настолько детально спроектированную задачу, то коллега может и обидеться, потому что Вы "съели всё самое вкусненькое, всю творческую часть задачи", а для ИИ это не проблема.
В целом, по моим наблюдениям, ИИ скорее способствует сохранению состояния потока более длительное время - потому что даёт возможность скидывать на него то, что раньше бы из потока выбивало. Да, с ИИ в потоке пишется меньше именно кода, но зато делается больше проектирования - что, на мой взгляд, намного лучше. Код я писать люблю, но разбираться с сутью вещей на более высоком уровне мне ещё интереснее.
я пока не готова отказаться от своего опыта 🤷♀️
И не нужно отказываться. Качество того, что ИИ выдаёт самостоятельно - очень и очень средненькое. И вряд ли станет лучше без какого-то принципиального изменения в подходах к обучению ИИ - потому что обученный на всём доступном коде ИИ не различает где код хороший а где плохой, считая средний по выборке нормой - а этот средний уровень очень далёк от нормы. Поэтому Ваш опыт - это именно то, что позволяет получать от ИИ результаты Вашего уровня, а не среднего. Описывая свои требования, приоритеты, отношения и подходы в AGENTS.md и промптах конкретной задачи, плюс показывая ИИ текущий код написанный в соответствии с Вашим опытом, Вы и формируете тот контекст, который необходим ИИ чтобы писать код "как Вы", а не как в среднем пишут на этой планете.
Во-первых, в оригинальном сообщении я описывала проблему со слишком высокоуровневым переходом, когда человек отказывается от программирования впринципе, полностью становясь менеджером агентов или как сейчас модно говорить - вайб-кодером. Изначальный комментарий, на который я отвечала, показывал эту динамику в положительном ключе, что это то же самое, как когда произошёл переход на верхне-уровневые языки.
Я не говорила, что я вообще не использую нейронки. Для всего, что связано с бизнес-логикой я действительно их не использую, но я использую их чтобы нарисовать диаграмму для Mermaid, написать юниты (по примеру, сначала сама делаю обертку и несколько важных тестов), или написать что-то связанное с алгоритмами, типа построить дерево, потому что она достаточно хорошо с этим справится.
Поэтому то что вы сказали о том, что нейронка не может мешать - не совсем правда в контексте утверждения, которое я оспаривала. Потому что когда мы говорим про кейс, где весь код пишет нейронная сеть, а ты выступаешь как менеджер/ревьюер/тестировщик - это ещё как мешает войти в поток 😅
Во-вторых, уже второй раз с каким-то что ли сарказмом говорите, вы же "ведущая". Доказывать вам свой опыт или оправдываться за что я получила такой грейд, я точно не собираюсь. Но похоливарить на эту тему можно.
Когда работаешь в команде или лидишь других разработчиков, ты изучаешь тех, с кем работаешь. Когда вы уже притерлись, ты очень хорошо знаешь, где человек попытается откосить, а где ему будет интересно работать. При проведении ревью у коллег, я подхожу к этому индивидуально, я знаю у кого особо можно не смотреть, а у кого стоит поподробнее, потому что например в прошлом были какие-то косяки.
Работа с людьми это впринципе не линейный процесс. Нет какого-то единого подхода для всех, или даже для каких-то грейдов, абсолютно с каждым это индивидуальный процесс. С опытом ты учишься быстрее узнавать самые важные детали, но у меня лично нет какого-то универсального подхода для всех.
Соответственно, сюрприз, но этот опыт не перекладывается на общение с нейронкой. Зная человека, я могу в 3 словах объяснить задачу и он сделает ровно то, что мне нужно. Более того, коллегу не нужно вводить в контекст, он работает там же где ты, а даже если нужно (например, если он не заходил ещё в это место), то можно на пальцах быстро объяснить что такие-то отличия/схожести есть от знакомого ему места.
Общение с нейронкой имеет вайб общения с человеком, который только вышел на испытательный срок и никогда с него не выйдет. Да даже с людьми, которые только приходят, мне не нужно сидеть и по полочкам объяснять все принятые решения в проекте, потому что они и так со временем поймут, если залезут достаточно глубоко.
Вот вы говорите, нужно вот написать правила, создать файлы с контекстом и все это, но это не работает на реальных проектах. Потому что на всех проектах будут места, где эти правила будут нарушены, и как только эти места попадут в контекст, это создаст противоречивые указания для нейронки. Человек умеет делать разный выбор исходя из ситуации и принимает во внимание срочность задачи, объем последующего рефакторинга (если добавляешь костыль), соизмеримость усилий (когда файл не придерживается последних стандартов, а тебе нужно добавить одну строчку). Все эти правила пытаются сделать видимость, что вот, мы же все описали, она теперь все правильно будет писать, ровно так как надо, вообще забывая что ценность инженера состоит не в правильном коде, а в его решениях.
Не со всеми людьми приятно работать, не со всеми ты сходишься в подходе, скорее всего будут какие-то мелкие конфликты, система не идеальна, как и люди не идеальны. Да, с нейронкой нет конфликтов. Да, ты скажешь ей что вот дурак, все неправильно сделал, и она переделает без жалоб, ещё и похвалит тебя. Но она не принесёт ничего нового, у нее нет опыта, как у твоих коллег, она не знает проект как свои 5 пальцев и какие там приколы были при его создании. Её ответы всегда максимально усредненные, ни туда ни сюда, вроде неплохо, а вроде можно и лучше. Так что даже несмотря на то что с людьми сложно, я лучше снова стану тим лидом (а я мягко говоря чуть чуть это не люблю и предпочитаю тех лидство), чем буду общаться с нейронкой на равных.
полностью становясь менеджером агентов или как сейчас модно говорить - вайб-кодером. Изначальный комментарий, на который я отвечала, показывал эту динамику в положительном ключе
Значит, или я плохо мысль изложил, или Вы что-то своё в ней увидели. Я никогда не говорил и не подразумевал ничего положительного в вайб-кодинге. Не для программистов, по крайней мере - я допускаю, что для бизнесмена ставить задачу что программисту (и получать в результате код, который бизнесмен не понимает) что ИИ (и получать ровно то же самое) - одна фигня и в таком качестве вайб-кодинг может иметь своё применение. Но программист обязан понимать код, который он коммитит в репо, и отвечать за него.
с каким-то что ли сарказмом говорите, вы же "ведущая"
Сарказм там был исключительно в отношении комбо "ведущей" с "работаю сама", а не в отношении грейда как такового. Прошу прощения, если прозвучало иначе.
Вызван этот сарказм исключительно тем, что у меня это тоже больное место - самому работать намного проще, но это не всегда возможно, поэтому приходится уметь работать не только самому… и при работе с ИИ эти навыки неожиданно сильно пригодились.
я подхожу к этому индивидуально, я знаю у кого особо можно не смотреть, а у кого стоит поподробнее
Возможно Вы удивитесь, но с разными моделями ИИ - ровно та же фигня!
коллегу не нужно вводить в контекст, он работает там же где ты
При качественном AGENTS.md и хорошими моделями (уровня не ниже Claude Sonnet, а лучше Opus) это работает практически точно так же.
Общение с нейронкой имеет вайб общения с человеком, который только вышел на испытательный срок и никогда с него не выйдет.
Так было. Но было это, по меркам скорости развитии ИИ-агентов, - очень давно! Сейчас это решил AGENTS.md для проекта в целом плюс дополнительные аналогичные файлы правил для отдельных-специфичных областей проекта, если проект достаточно сложный или просто большой. AGENTS.md добавляется автоматически всегда, дополнительные правила изредка нужно одно-два (про нужную часть проекта и про нужный тип задач) добавить в чат ручками, в зависимости от текущей задачи.
Человек умеет делать разный выбор исходя из ситуации и принимает во внимание срочность задачи, объем последующего рефакторинга (если добавляешь костыль), соизмеримость усилий (когда файл не придерживается последних стандартов, а тебе нужно добавить одну строчку).
А вот это как раз то место, где становится критичен Ваш личный опыт и донесение его до ИИ в промпте. Если этого не делать, то ИИ примет решения уровня среднего миддла, и количество несогласованного кода в проекте только вырастет. Но при работе с командой из тех же миддлов результат будет ровно такой же, и придётся всё-равно либо доносить свой опыт в процессе ревью PR либо мержить как есть.
Да, сильный сениор в такого рода руководстве не нуждается. И да, ИИ сейчас этому уровне не соответствует, и пока нет оснований считать что он дорастёт до этого уровня в обозримом будущем без очередного прорыва в технологиях. Но сениор и стоит сильно подороже, чем ИИ, нанять его сложнее, плюс не все задачи требуют такого уровня опыта, так что польза от ИИ всё-равно есть.
Но она не принесёт ничего нового, у нее нет опыта, как у твоих коллег, она не знает проект как свои 5 пальцев и какие там приколы были при его создании.
А вот из этого правда только последняя часть про "какие там приколы были при его создании". Остальное неверно. ИИ знает намного больше любого из нас, поэтому узнать от ИИ новое проще простого. Опыт у него сравним со средним миддлом. Он знает проект зачастую даже лучше тебя - просто потому, что ты уже успел забыть какие-то детали, которые ИИ только что выяснил тупо перечитав кучу файлов проекта.
Когда я писала "когда я работаю сама", я не имела в виду, что я работаю одна 😅 я имела в виду "без нейронки". А так я уже очень давно не работала одна, я предпочитаю продуктовые компании где ~100 разрабов хотя бы. В свое время наработалась в маленьких компаниях, где фиг в отпуск уйдёшь. В аутсорсе/аутстаффе тоже не работаю, так что давно уже не было опыта, где я именно единолично что-то делаю, что вообще никак не интегрируется/влияет на общую систему.
Разработчики теперь пишут с LLM 146% кода. Лиды подозревают подвох, но уже не могут понять почему.

Ну, свой код процентов на 50 передаю уже на генерацию ИИ, потом только перепроверяю или добиваюсь чтобы они сами исправляли. Тут много нюансов просто. Это зависит и от навыков работы с ИИ, и от доступных инструментов, харнеса, скилов, от возможности пользоваться MCP (в моей компании это пока недоступно, например, а без этого агенты слепы, приходится всё объяснять). Но тем не менее уже довольно много времени экономится и я не так боюсь уже оказаться в полном затыке, когда не понимаешь куда двигаться дальше, а пробовать множество решений очень трудоёмко.

Если в компании не могут поднять свой MCP с документацией, то эдак завтра могут и электричество в серверную забыть подать...
Там не в "не могут" дело. Вопросы безопасности во-первых, через MCP данные утекают на раз. Но уже вроде это решено, репозитарий MCP там будет, наверное, и теперь совместно с разработчиками Copilot по VS Code исправляют множество багов, чтоб с этим можно было работать. Запустят, но в консервативном режиме, без спешки. В общем, ждём Playwright и Chrome Dev MCP всяких.
Куда могут утечь данные через свой MCP... "Вопросы безопасности" стали универсальной отмазкой для любой лажи.
Может я недостаточно хорошо описал. Речь об использовании любых сторонних MCP из копайлота. Этот режим пока отключён. Там данные могут утекать куда угодно, поэтому вместе с Copilot допиливается репозитарий серверов. Свои сервера всем подряд давать клепать бесконтрольно тоже нельзя, с них данные могут бездумно куда-то слить тоже. Корпоративная безопасность и всё такое.
Сервер с документацией тут ни при чём, речь о том, чтобы агенты при разработке видели UI, для этого нужны соответствующие MCP-сервера.
Свои сервера всем подряд давать клепать бесконтрольно тоже нельзя, с них данные могут бездумно куда-то слить тоже.
Вот эта часть не имеет никакого смысла. Свои данные можно бездумно слить и без MCP, и свой MCP это проще никак не сделает. Это как запрещать ручки с чёрными чернилами, оставить только с синими, чтобы переписку не украли.

Почти 100%. Причем бесплатными тулзами. Сначала джемини читает то что уже есть и пишет что надо сделать, потом qwen code своими руками всё делает, причем он может делать даже что то отличное от написания и сборки кода, например зайти в бд на удаленном сервере и порыться в ней.
Страшно представить какие возможности есть у людей с большими подписками на клода и гпт.

90% кода писать реально. Но кто пишет промпты и проверяет? Здесь нужен человек, который понимает вглубь. Так что без разработчика пока никак.
А про деградацию я не уверен. Столько всего нового стал использовать в клауд кодом. Я часто прошу не писать код, а объяснить что к чему.

По моим меркам генерируется в основном трешкод - вплоть до самых мелких тасков. Из-за постоянной необходимости вникать и поправлять, на генерацию забил. Вместо этого проверяю LLM-ами дифы на предмет багов. Заметил, что некоторые баги выявляются только после нескольких вызовов с одинаковым промптом (+регулярные false alarms, когда LLM не схватывает логику происходящего)
Это сильно зависит от используемой модели. GPT-4.1 делает именно то, что Вы описали, а вот Claude Sonnet/Opus выдают вполне адекватный код.
У меня DeepSeek выдаёт рабочий код, кусами примерно по 1 странице на промпт. Больше я ему сам не позволяю, читать потом сложнее будет.
Если он выдаёт код неправильный, то одно из двух: либо он использовал API от не той библиотеки, но это надо подключать MCP правильно. Либо это логическая ошибка, но тогда, перечитав промпт внимательно, обычно понимаешь, что в режиме злобного джинна запрос можно было понять и так.
В итоге, ошибается он всё меньше, но пользоваться надо уметь.
Не надо просить модель выдавать код страницами. Надо использовать режим агента, чтобы она сама писала код в файлы, писала тесты в файлы, запускала тесты и линтеры, исправляла все ошибки, и только потом сообщала пользователю что она выполнила задачу. Это сразу исключит любые галлюцинации, API не тех библиотек и т.п. Но вместо этого добавит вопрос безопасности: если ИИ может запускать тесты, которые сама же и написала, то по факту у неё уже есть полный доступ к компу под аккаунтом текущего пользователя, даже если прямой доступ к шеллу ИИ не давать.
И потом никто не знает, что это за код и что он на самом деле делает. Даже ИИ не знает: из-за его рандомной натуры то, что он один раз что-то написал, вообще не означает, что в следующий раз он сможет это понять.
Невозможно проверить, что тесты покрывают весь желаемый функционал в деталях. Да и кода в таких тестах будет дохрена, становятся нужны тесты тестов и т.д.
Нет такой волшебной метрики, которая показала бы, что тесты описывают желаемый функционал полностью. Покрытие кода не означает покрытия логики. Поэтому ИИ "сам пишу-сам тестирую" может сделать завершённую, неглючащую систему, которая делает, однако, пёс знает что. Соответствия ТЗ это не даёт.
Такая разработка, со стороны человека, является по сути не разработкой, а приёмкой. А кто в этом деле опытен, тот знает, что действительно правильная приёмка ничуть не легче самой разработки. Поэтому обычно её правильно и не делают, а обходятся общими мерами, а в деталях полагаются на юридическую сторону, на ответственность разработчика. А тут получается, что вся ответственность возлагается на авось, потому что ИИ ответственности не несёт.
LLM - это случайный алгоритм. Даже без использования генератора случайных чисел, в LLM настолько огромное количество коэффициентов, что в контексте решаемой им задачи он всё равно, что случайный. И это не первый случайный алгоритм в истории. Их можно использовать надёжно и с большой пользой, если жёстко валидировать выхлоп. Так вот, написанные самим же LLM тесты такой валидацией не являются, а тестировать все возможные варианты вручную займёт больше труда, чем сама разработка.
И потом никто не знает, что это за код и что он на самом деле делает.
В смысле? Вы попросили реализовать фичу/пофиксить баг, агент сделал, дальше смотрите git diff и разбираетесь, что вы сейчас собираете закоммитить в репо - ровно так же, как при работе без ИИ.
Такая разработка, со стороны человека, является по сути не разработкой, а приёмкой.
Всё верно. И во всех компаниях этот подход активно практиковали задолго до ИИ - называется "сениор делает ревью PR созданного миддлом". Тут снова ничего не изменилось - кроме того, что миддл на жёсткие замечания в ревью мог обидеться и испортиться, а ИИ не обижается (пока, по крайней мере). Ну и переделывает в соответствии с замечаниями ИИ быстрее любого миддла.
вся ответственность возлагается на авось
Не на авось, а на разработчика использующего ИИ.
Соответствия ТЗ это не даёт.
LLM - это случайный алгоритм.
Да, но с людьми та же фигня: написанный людьми код часто не соответствует ТЗ, и качество написанного кода зависит от случайности - насколько хорошего разработчика удалось нанять и насколько этот разработчик был "в ресурсе" в день работы над этой задачей.
Ваша проблема - в Ваших ожиданиях. Вы привыкли, что если что-то делает программа/алгоритм, то она делает это надёжно и одинаково - в отличие от людей. Но ИИ в этом плане ближе к людям, чем к программам.
ИИ выполняет задачу быстрее и дешевле людей, но качество решения будет примерно как у среднего человека - такое же ненадёжное, но более-менее рабочее.
Так, стоп, это вы тут агитируете, чтобы "она сама писала код в файлы, писала тесты в файлы, запускала тесты и линтеры, исправляла все ошибки," и так далее. А у меня код одним запросом, тест другим, и всё это кусками не больше того, чтобы мне в голову умещалось, а не дураку железному. Тогда это всё ещё я разрабатываю, и вижу что куда и как подключается.
Работая вот так, по кусочкам, Вы не просто видите все куски - Вы видите промежуточные, часто некорректные куски. Если дать агенту самому выполнить весь цикл включая тесты, то Вам понадобится изучить только один, финальный вариант. Т.е. Ваших усилий это потребует меньше, весь процесс пройдёт быстрее, но при этом будет ровно тот же уровень контроля: Вы смотрите абсолютно все изменения до коммита в репо.

Ничего, что количество кода, особенно в императивных языках значит практически ничего? Тоже самое можно описать и в 10 строк и в 1000.
Где-то и до ИИ 90% кода генерировалось простой кодогенерацией.
Очень странная метрика выбрана.

Только опытный разработчик может поднять, что код написанный ИИ стоит дороже в обслуживании, в определённый момент вы перестаете владеть кодом.
Что касается руководителей ИИ стартапов - они вынуждены так говорить для рекламы.
Смотрим на других - думаем своей головой.
Только опытный разработчик может поднять, что код написанный ИИ стоит дороже в обслуживании, в определённый момент вы перестаете владеть кодом.
При вайб-кодинге - безусловно. Но если тщательное ревьювить сгенерированный код и доводить его (вручную, или уточнением промпта/добавлением правил в AGENT.md) до своего обычного уровня - то владение кодом сохраняется.

Так удалось ИИ написать 90% кода или нет?


Видимо чтобы выполнить обещание главы Anthropic, Claude стабильно расписывает на 1000 строк то, что человек уместил бы в 100.
Потом сидишь читаешь 5 реквестов в день по 1.5-2 тыс строк каждый

Как раз сегодня пример наблюдал :)

Как дела теперь ?
К черту политкорректность! Что с ебалом?

Главное прогнозы давать о многообещающем будущем, а то деньги сами по себе не придут.

ради прикола написал систему управления складом на AI... под своим жёстким контролем, сам переделывал архитектуру и давал ему продолжать, проверял всё что он сделал и правил всё что не так. понимаю почему у людей проблемы с AI - потому же почему интернет превратился в порнхаб, inshitification и всё прочее... потому что умных людей по принципу Парето 15%. они используют любые инструменты с умом. остальные просто заканчивают мыслить не начиная. полагаться на AI нелепо по определению - ты теряешь контроль над кодом. я всегда задаю вопрос себе - а что если завтра AI отключат? смогу я поддерживать проект? где я что не понимаю? вот и ответ на все вопросы. когда чтото сложное поломается и будет угроза потери данных я не хочу давать никому ничего править - я должен сделать это сам потому что понимаю риски и отвечаю за них перед клиентом. в отличие от AI или дурака который доверяет инструментам писать код без понимая
Вот наглядный пример, как привычка общения с алгоритмами убивает способность к ясному изложению мыслей ☺.

а что если завтра AI отключат? смогу я поддерживать проект?
А если завтра интернет отключат, сможете поддержать проект? А если электричество?
если интернет отключат я наверно смогу работать локально какое-то время потому что строю проекты так чтобы они имели минимум внешних зависимостей. если электричество отключат смогу в течение работы батарейки телефона и ноутбука быстро пофиксить какой-то критический баг. но если AI отключит мне мозги то тут ни электричество ни интернет не поможет
По прочтению комментариев я понял, что через год, два, три большинство итишников потеряет компетенции в писании и отладке кода.
Значит пузырь ИИ не сдуется.


METR не доказали ускорение но эксперимент развалился - разработчики отказались работать без AI. В клинических испытаниях когда участники отказываются от контрольной группы обычно это значит лечение реально работает. А тут вывод - "данные слишком слабы". Зависимость без доказанной пользы

Несмотря на все проблемы ИИ, всё же какие-то рутинные операции он делать может, и это сказывается на рабочих местах. Я думаю, в ближайшие 5 лет треть айтишников лишатся работы.


Слушал я вас слушал и, наконец, понял: есть халтуркинг, есть шабашкинг и есть вайб-кодинг :-)

Для нового эксперимента METR набрала 57 разработчиков и 800+ задач
Никто не сказал о качестве этих ребят и специфике задач
Если все так хорошо с llm, то почему вокруг одни кривые mvp, open source плачет от вайбкодеров, а amozon с macroslop'ом уже отстрелили себе все коннчности? Остался контрольный в голову.
Вот, что говорит профессор права из Northwestern University. И любой эксперт из иной сферы. Нынешний ИИ -- это пузырь, он не работает и не приносит реальной прибыли.
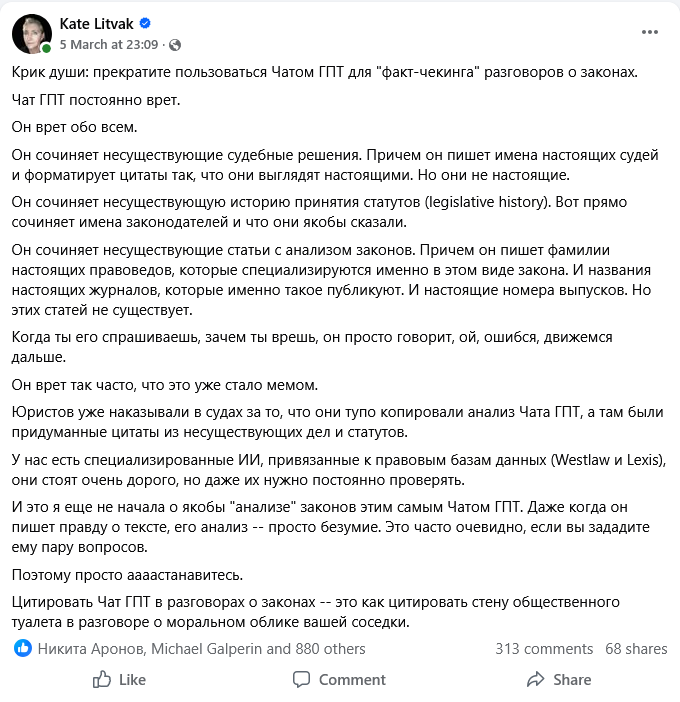
Год назад Амодеи говорил, что ИИ будет писать 90% кода. Как дела теперь?