Comments 85

И это будущая открытая модель. Открытая карл. Таки всё, разрыв сократился с 3-4 месяцев до отрицательных недель?...

Нет. Лидеры просто не выпускают свои лучшие модели из соображений или безопасности или что-то другого.

Хотите сказать, у Moonshot есть еще лучше модель, только они ее не показывают? :)

Когда агенты OpenAI хакнули HuggingFace, они работали на моделях Astra и еще одной, не названной пока что модели. Вполне возможно, что и у других разработчиков в процессе обучения находится сразу несколько моделей.

У всех нормальных контор находится на обочучении одна, а то и несколько моделей. И это ничего не значит. Судя по тому что публикуют они чаще неудачные чем удачные. И их просто удаляют.
Чтобы сделать что-то заметно лучше нужны новые подходы. Размер растить уже некуда и новых данных для обучения нет. И это сложно.
Фабл по слухам это 5 триллионов параметров. Оно даже в стойку не лезет. А за стойкой уже скорость света кажется не такой большой. Цена обоснована и неразумна для нормальных применений.
Замерный рост качества без изменения подхода дает рост модели х2 примерно. То есть надо 10 триллионов. Цена инференса поражает воображение. Как такое окупить непонятно.
Размер растить уже некуда и новых данных для обучения нет. И это сложно.
Справедливости ради. Размер скоро явно увеличится, как минимум из за ускорителей, сейчас все как я понимаю на b200/b300 обучают, а дальше будет Vera rubin который уже поставляется и позволит эффективный размер moe увеличить до 5-20трлн суммарных параметров. (Я честно говоря уверен что весь тяжёлый фронтир это 2-5трл максимум, ну очень уж долго и невыгодно обучать и использовать больше, так то эксперименты с 10трл все давно делали, но это просто невыгодная модель для дальнейшего инференса)
А вот про отсутствие новых данных для обучения это честно говоря немного смешно. Новые человеческие данные закончились пару лет назад. Хотя даже тут спорно, мы сейчас все активно создаём кучу данных на агентных сессиях которые и нужны для обучения пусть даже полезных там от силы 2-5%. Но вообще-то основной прирост возможностей последних месяцев это именно синтетика, качественный rl возможен только на ней. А её можно сгенерировать сколько угодно, и главное даже не обязательно иметь сильную модель, но в любом случае качество синтетики тоже улучшается с каждым поколением.

Но вообще-то основной прирост возможностей последних месяцев это именно синтетика, качественный rl возможен только на ней.
Так точно. Больше данных - лучше результат.
Автогенерация синтетики через спец. окружения - например симуляции реального мира, вот где золотая жила для добычи данных.
Вы описываете экстенсивный рост. Стало железо лучше - модельки выросли. Это уже как везде. Скорость роста так себе. Если верить планам Нвидии то 10 триллионные модели можно будет инференсить нормально только на еще не вышедшем железе 2027 года. Ну то есть в 2028 году или позже.
Думаете еще не все из синтетики выжато? Все по кругу уже представили свои дообученные модели. Улучшения на единицы процентов не считаем.
Думаете еще не все из синтетики выжато? Все по кругу уже представили свои дообученные модели. Улучшения на единицы процентов не считаем.
А почему вы думаете что выжато? Нет, я конечно допускаю небольшую вероятность что все последние улучшения моделей это самые последние капли выжимаемые из rl и концепции предварительных размышлений, но мне она видится очень маленькой. И даже если не обращать внимания на бенчмарки, то по субъективному ощущению модельки очень быстро и сильно продвигаются. То что было год назад не ищет абсолютно ни в какое сравнение в реальной работе с тем что есть сейчас. То что было пол года назад ощущается галлюцинирующей фигнёй. Ну просто никакого плато не видно, о котором рассказывают на протяжении последних пары лет. Предел сжатия интеллекта тоже пока не то чтобы видим. Я не удивлюсь если условная Qwen 4.5 27b + возможно небольшая ngram таблица или что-то аналогичное достигнет нынешнего opus 5.5.
И опять же справедливости ради - улучшение с 90% до 92% это уменьшение количества ошибок на 20%. Не то чтобы мало. А скачки по бенчмаркам обычно сильно больше. И ладно б только процентики в презентационных табличках увеличивались, так нет, оно реально каждый раз работает все лучше и лучше.
Я про качественные улучшения, небольшие оптимизации понятно что будут.
Да вроде все ровняются примерно на одних числах. Плюс-минус немного. И все делают одно и тоже. Дообучают то что сделали раньше. И архитектура у всех одинаковая. МОЕ. Разница остается в размере базовой модели и как следствие разница в деньгах на инференс и качестве.
Опус улучшают уже давно. И есть в рамках 4 версии улучшение было явно заметно. Примерно осень 25 - весна 26 годов. То на 5 версии улучшение не особо заметно. Весна 26 - осень 26. Выглядит как типичное сглаживание и выход на плато. И на это же плато подходят все остальные. Кими судя по всему на нем уже, Дипсику и GLM нужно размер нарастить и будут там же. Третий эшелон к весне 27 подтянется туда же. И будут все от Опуса до Гигачата примерно одинаковыми.
Если новую архитектуру или математику не придумают то рост только в размере моделей виден. А там уже проблема размеров, нужно железо которое в 27 году только обещают сделать.
А что есть качественное улучшение? Я примерно понимаю о чём вы, но на мой взгляд делать вывод о плато исходя из того что несколько моделей передовых лабораторий имеют +- один уровень ошибочно. Вот если opus 6, 6.5 или Astra 7.5 будут +- на том же уровне что и нынешний с незначительным улучшением тоя соглашусь. Ну да никто не не изобрёл ничего кардинально нового, и все остальные любое улучшение архитектуры тут же повторяют, но блин. Да, каждый ближайший релиз не кардинально отличается от предыдущего (и то спорно) но если взять релизы подальше то улучшение то существенно... Все потихоньку заменяют почти полностью гибридное внимание различными линейными по стоимости, добавляют выносные таблицы, улучшают rl, где тут плато то?
И кстати мне кажется что последние год-два минимум, размеры моделей были +- одинаковые. Все дошли до барьера в 3-5трлн параметров и начали улучшать rl.
Да и если архитектура эффективна и её можно улучшать то нафига с неё уходить? Ну точнее эффективнее всех остальных что человечество придумало по совокупности параметров. В смысле делать вывод о плато по последним 1-2 месяцам релизов странновато. По всем признакам у нас наоборот улучшение способностей только ускоряется по экспоненте, пусть и медленной. А там глядишь, через год другой модельки улучшат долгосрочное планирование и понимание в какую сторону им вообще стоит копать, станут лучше современных исследователей и запилят какую нибудь другую архитектуру на базе матричных операций (ибо какие альтернативы, все ускорители на них работают) которая будет на порядок эффективнее текущих по большинству параметров и будет нам счастье. Или нет.
Конечно есть.
Архитектурное. Все перешли на МОЕ и стало лучше. Постобучение. Все сделали правильно и получили агентов которые следуют инструкциям. Размер, все добрались до предела которые можно инференсить за разумные деньги и не сломали модели при этом. Это все качественные улучшения.
Когда начинаются небольшие улучшения без качественных изменений технологию можно считать состоявшейся и не ждать каких-то прорывов или резких улучшений от нее. Таких технологий уже очень много от автомобиля до телефона. Такие технологии хорошие и полезные. Но мир они уже не изменят.
Вопрос только где это плато. Пока выглядит так что текущий Опус это плато. Дальнейшие качественные изменения могут быть только на другом железе, которого пока нет. Или нужны новые математические модели. Почему так выглядит я чуть выше писал.
Подтверждение или опровержение моей теории будет ближе к НГ. Если у Антропиков и ОпенАи ничего принципиально сильнее не выйдет, а еще кто-то нибудь вроде Дипсика выпустит модель неотличимую от Опуса на тех же 2-3 триллионах параметров то это оно.

Все зависит от ценности которую приносит технология. Если оно того стоит - то и заводы по производству литографов начнут масштабировать на пределе возможностей, а это качественное изменение. По доступной электроэнергии или в сравнении с бюджетами стран - еще далеко до предела.
Кроме того, есть эффекты положительной обратной связи через относительно короткие кольца, как с законом мура, микроэлектроника десятилетиями развивалась и на плато не выходила.

Они вроде так и пишут, что часть модели загрубили, особенно связанную с кибер безопасностью и взломом.
Ну окей, среди доступных моделей. Понятно что у них у всех есть неопубликованные чекпоинты в обучении, без механизмов безопасности и прочее. Но что-то я не припомню чтобы открытая китайская модель обогнала почти все американские. Хотя может и было, я не следил пол года назад активно. И ведь уже просто дистилляцией сложно объяснить (хоть и возможно), у них вероятно было в разы если не на порядок меньше вычислительных мощностей и затрат и всё же...
ps. Где-то здесь, кажется, недавно читал про прогнозы появления открытой модели уровня astra, мол через 6-12 месяцев. Ну и через сколько после публикации весов k3.1 появится аблитерированная версия...

Смотря на новый deepseek v4.1 и его возможности за копейки (реально, даже если использовать самого быстрого провайдера на openrouter, который 250+ т/с херачит, это крайне дешево), даже 6 месяцев это очень консервативно. 6 месяцев назад это был уровень фронтира.

А зачем юзать Deepseek через провайдера, когда можно подключиться напрямую к его API без впн? И оплачивать тоже не проблема, используя сервисы-посредники.
Что касается качества и уровня Deepseek Flash-4.1 (последняя и самая мощная модель), то она вроде по разным бенчмаркам также почти не уступает тем же опусам и астрам. Но почему-то принято считать, что Kimi круче. Регулярно пользуюсь Deepseek, качество устраивает. При этом очень быстрый. Пробовал Kimi K3 через провайдера, намного медленнее, очень долго думает, какого-то более высокого качества по сравнению с Deepseek на тех же задачах не заметил.
Ну кими может то,, что диипсик не может. Например 3D, дизайн, презентахи, видео.
И зачем пользоваться через провайдера? Cli всегда работал напрямую из России.

Удивительным образом Kimi 2.7-code позавчера пыталась на винде использовать линуховые команды для консоли. К3 уже сообразила где находится. После кодекса я был удивлён )
Скрытый текст
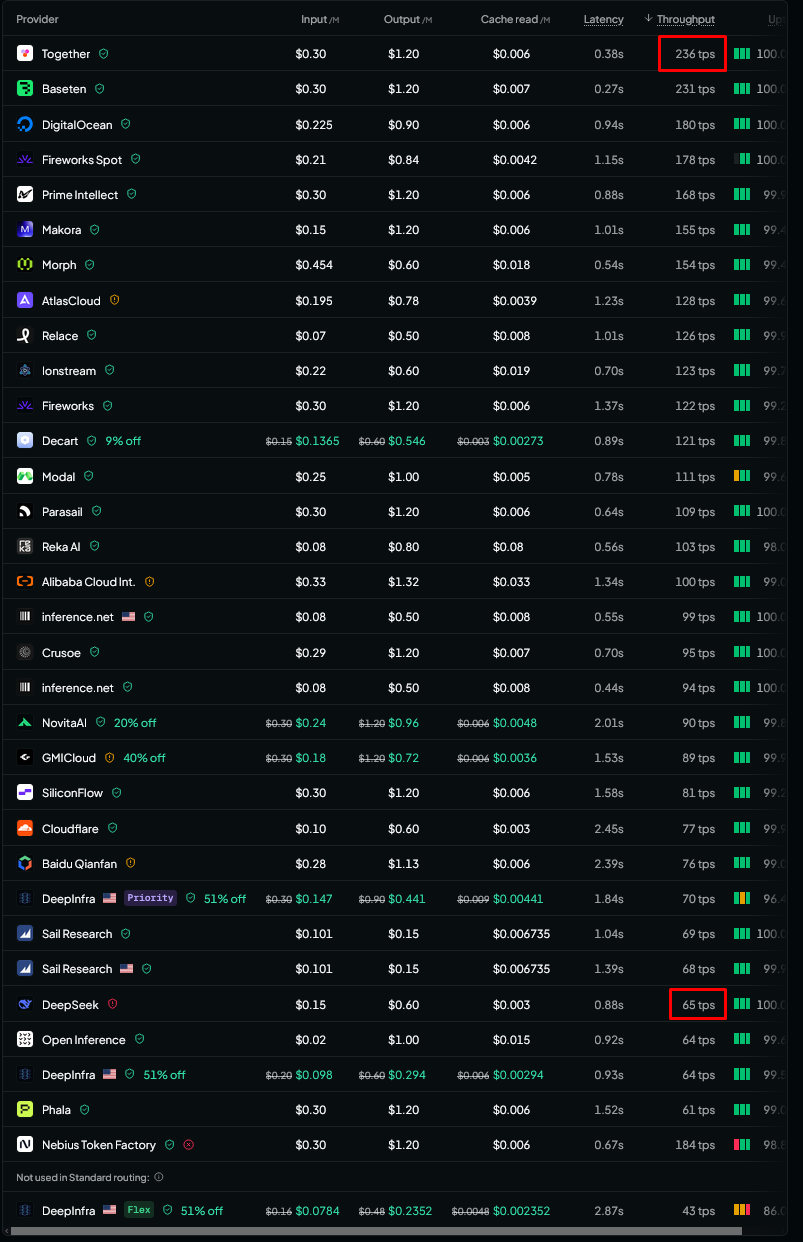
Скорость. Иногда проще заплатить всего в 2 раза дороже (ну будет 40 центов на задачу, а не 20, не очень большая разница), но получить существенно больше комфорта, не пытаясь взять смартфон после каждого запроса.
VPN не проблема, прокси на опенроутер поднять когда есть VPS дело пары минут.
Китайцы не просто так opensource поддерживают, у них железа не хватает, что бы на всех хватило.
Презентации все уже пол года-год как умеют делать хорошо через python, визуальный энкодер у ds есть, поэтому очевидно тупых ошибок не делает. Если один раз запариться и сделать пайплайн создания презентации по своим требованиям, то сделать презентацию можно по одному промту (если материал для презентации уже есть)

Я вот пока не уверен насчёт "обогнала" в принципе. Прошлые модели у Kimi тоже выдавали неплохие бенчмарки и обещали многое, а на практике достаточно часто лажали совершенно детским образом, в результате чего вместо них было эффективнее использовать формально более слабый DeepSeek V4 Flash, но зато работающий более стабильно в плане ожидаемого от него качества. Пока новую модель не получится потестировать на реальных задачах в достаточном количестве лично я настроен довольно скептически. Стабильность результатов вполне может быть важнее того, что часто модель выдаёт крутое но при этом каждый 10-й ответ содержит лютую чушь.

Если даже допустить, что они есть, эти лучшие модели, то их "невыпускание" это фактическое отсутствие на рынке.
У них через веб еще доступна 2.8 превью, а 2x линейка это 1Т 4-х битных параметров, общим размером 595Гб. Интересно будет на нее посмотреть, насколько хороша, по идее должна быть сильно дешевле/быстрее.


Может, Яндекс ее вместо Алисы возьмет? Или хотя бы базы для тренировки Алисы?
А то колонка Алиса всегда говорит "спросите что-то другое" )


Открытая только для небольших провайдеров.
Для обычного человека вроде разницы нету, но это влияет на цену у провайдеров.
Кажеться только deepseek продолжает выпускать с нормальной лицензией без ограничений.
Разница гигантская. Вам ни одно правительство (кроме вашего) не может запретить ей пользоваться. Это качественное отличие от закрытых моделей.
Имел ввиду разницу с полностью открытими лицензиями.
Полностью это вместе с данными для обучения? Такое никто открыть не может. В данных все. Прямо вообще все. Юристы не разрешат.
Имелось ввиду лицензии для весов, deepseek выпускает под MIT, а у kimi лицензия с ограничениями в зависимости от годичного дохода (20$ млн).
У мельких и средних провайдеров нету железа для такой модели, а большие должны договориться с moonshot, что влияет на цену.

OpenAI и Anthropic - это дуополия. Они специально выпускают модели +- на одном же уровне, просто иногда меняются местами, кто выгоднее. Релиз Kimi просто заставит их вывалить свой очередной SOTA раньше - что, в целом, конечно плюс. Основной плюс локальных моделей - это их безотказность (в частности Heretic и прочие). Вот тут будущий Kimi фору даст и ChatGPT, и Claude. А то те со своими "не хочу, не буду" местами совсем уже ошалели. Вот только какой провайдер вам даст abliterated - вопрос открытый.

За 100 баксов в месяц Opus можно просто юзать по полной, Kimi K3.1 выжигает 5 часовой лимит буквально за 1 сессию короткую. Я такого у Opus не видел давно.
Они может и SOTA но уже не конкурентноспособны в плане цены/качества.

У них квоты всегда падают при релизах из-за дефицита инференса. K3 на релизе тоже за день съедалась, тогда как сейчас уже можно сутками гонять, не дойдя и до середины.
Зато никаких ограничений для России.

Только все равно придется сидеть за VPN: они используют американских провайдеров
Блокировок не будет, да
При использовании китайских юаневых аккаунтов - не нужно. Оплата проходит в т.ч. через обычный туристический Alipay с карт Visa или UnionPay.
Да вроде так заходит и платится карточкой мир.

У меня в спб как не открывался без впн, так и не открывается, оплата соотвественно как была через Apple Pay, так и осталась


Смысл всего этого что бы бигтех не вливал доллары в open ai + anthropic а гонял у себя открытые модели , переставая спонсировать домашнее, постепенно все больше и больше полагаясь на Китай. А потом халява закончиться.

Посмотрите на первый график, она в разы дешевле, чем Opus 5.5. Просто у китайцев меньше доступного компьюта, чем у американцев
Я достаточно давно купил подписку, по цене за токены не покупаю, поэтому оцениваю как быстро сгорают лимиты
2.x была рабочей лошадкой - отлично кодила, лимиты выглядели бесконечными даже на тарифе $40.
K3(.1) - действительно умнее, но одна - две с сессия в 5 часов - это совсем не интересно. Даже спеку порой не написать.
Kimi k3 была событием, но успела морально устареть. За это время остальные успели вывести 2-3 обновления
P.S. у меня годовая подписка на них

Добавлю что Kimi не только работает без VPN, но и принимает карты Мир для оплаты подписки. Заходите платить без VPN, тогда вас отправят на правильный платежный шлюз.
???
Не было такого
У меня не открывается без впн. Не знаю проделки ли ркн, но так было весь этот год. Летом также не мог зайти в kimi code т.к там нельзя было ввести российский номер, как будто в разных реальностях живем.
Я уже хотел написать, что врете, но как оказалось надо было просто выключить прокси, действительно можно оплачивать через МИР

Коллеги, кто первый протестирует её взаимодействие с механическими CAD - отпишитесь, пожалуйста!
Подробные тесты

Работал к К3 - зарегистрировался по очереди, акк сжигался мгновенно, работал медленно мог issue сутками пилить. Потом вообще сказали все инференса нет оплатить пока не дадим. ну и не надо. сейчас swe2 для дизайна (кими производная) argon4 для анализа кода и deep seek v4.1pro + qwen рабочие лошади.

Но дипсик миром не оплачивается...

Дипсик можно оплачивать через алипей. Алипей можно пополнять через сбер, тбанк, ВТБ, может, и ещё какие-то банки умеют (минимальная сумма перевода обычно 4000-5000). Для регистрации в алипей достаточно иметь биометрический загранпаспорт. На то, чтобы разобраться, как это работает, и один раз настроить, понадобится примерно час времени.

версия про намекает, что будет ещё и версия флэш. ждем ещё больше.
Пока тестировал Kimi показалось что Claude стал лучше соображать.
Забавно. Возможно, на выходные сервера освободились

Сожрал 10$ +5$ бонусных за один промт, программирование примерно за 45 минут.
Я Кими попробовал. Бекенд разработка.
Опус однозначно лучше. Фабл вне конкуренции. Астра вроде как лучше. А вот Сол мне показался хуже.
Если Антропик вас забанил и планируете ехать на OpenAI, то рассмотреть Кими прямо стоит. Если уже используете OpenAI, то попробовать Кими тоже стоит. Может оказаться что не хуже. Но без риска бана, без ВПН и с понятной оплатой.
Я оценивал только качество работы. На задачах правильное решение для которых я знаю. Скорость и стабильность дотянут, это не сложно.
Ждем ответа от Дипсика и GLM. Они обычно быстро выкатывают что-то как минимум не хуже чем Муншоты выкатили. Может и лучше выйдет. До Опуса прямо немного осталось, надо чтобы выкатили немного лучше чем Кими и оно может оказаться не хуже Опуса.

Сегодня попробовал Kimi сравнивал на простой задаче запускал один и тот же запрос на нескольких нейронках:
Сравнил с DeepSeek 4.1 1017, Opus 5.5, Qwen 3.8 FN
Очень сильно удивил DeepSeek его анализ и ответ был самым информативным, вторым был Опус - его ответ был короче и лаконичнее но подсветил те же детали что и дипсик, а третим был Qwen который крутился на локальной машине, Kimi ответил очень шумно таблички сравнения много воды, но не увидел детали и как влиеет изменение на продукт.
Но у меня задачи ближе к фронтенд, ребята из бакенда даже прошлы Kimi 3 хвалили им зашел, а мне DeepSeek для повседневных задач и намного реже Opus для сложных с ресечем и логикой не в формате.
Moonshot выпустили Kimi K3.1 Pro: лучше GPT-6 Astra и почти догнала Opus 5.5