Comments 48

Наконец то хоть какая то статья про страту, а то тут некоторые до сих пор qwen3.5-9b запускают и удивляются чё она такая глупая. IQ3_XXS с 200к контекста стала моей постоянной моделью, быстрее iq3_s, но как будто бы не тупее. И у вас кстати какой то странный объём ОЗУ, куда то 2гб украли.

Встроенное ведро.
Спасибо за наводку, совсем забыл простроенную видюху. После отключения небольшого тюнинга удалось сильно увеличить скорость, Добавил апдейт.

Я пытаюсь 3.6 35b a3b на полистрата пустить на Quadro t1200))) в режиме чата несложные вопросы отвечает чётко уже, ещё и быстро. Не надеюсь, что выйдет что-то толковое, но…

А почему тесты проходят на delphi? Или это ваш рабочий стек?

Люди добрые неделю как разбираюсь с этими моделями. Упёрся в тяжелую модель стоит qwen 3.5 27 она жутко тормознутая ..B rtx4070 super 12 ddr5 32 nvme 5 7600x ollama 8k питон . Что мне поставить по максимуму что было приемлемые 20-30 токенов и более .. Посоветуйте ..лёгкая Gemma 4b быстрая но для легкой норм

У меня похожий сетап для эксперимента, но хост ос проксмокс, а страта уже в вм отдельной. Работает, но я бы не сказал, что это аналог сонета по вайбам (что бы там ни было по объективным замерам).

Отличный материал, спасибо большое !

Qwen3.6-35B-A3B UD-Q4_K_XL сильно будет хуже чем Qwen 3.8 Flash Next IQ3_XXS?

Подскажи есть ли для связки 24 + 32 что то лучшее чем qwen3.8-27b q4km для кодинга?
Она относительно неплоха, но просто даже с kv cache q8_0 влезает максимум 60-70k токенов.

Думаю стоит попробовать, может под ваши задачи подойдет: https://huggingface.co/peculiar-ragdoll/Tiel-Coder-35B-A3B-GGUF-MTP


я тут прибарахлил железку на 256гб оперативы пропускной способностью 100 гигабайт в секунду, правда видяха только 2060 на 6 gb есть. Надо будет потестить что-нибудь такое


наступил на грабли, в страте 2.10 гайки закрутили по безопасности, в итоге dsh desktop не вызывал инструменты некоторые - они выходили как текст и остановка, например skill. вот патч для frontend.py в инит class OutputParser
declared_only = False
deferred = True
if "skill" not in self.schemas:
self.schemas["skill"] = {"name": "skill", "parameters": {"type": "object", "properties": {}}}
if "compress" not in self.schemas:
self.schemas["compress"] = {"name": "compress", "parameters": {"type": "object", "properties": {}}}
там вроде какие-то флаги, но решил так сделать
кстати compress это tools от billion-context - ставится как прокси между агентом и локальным движком, благодаря ему контекст практически бесконечный и правильно жмется, попадание в кеш обеспечивает стабильно 80-95%
по ощущениям модель лучше 27-ой, по скорости точно (у меня две карты по 16)
да кстати страта с двумя картами лучше сделали работу (если карты разных поколений). А 3.8 некст хорошо понимает 1С специфику из коробки, в 27 такого нет и рядом.

А можно и на самом Delphi запустить Qwen. https://github.com/HemulGM/QuickNN при чем на GPU c Vulkan. Я и клиент сделал, тоже на Delphi
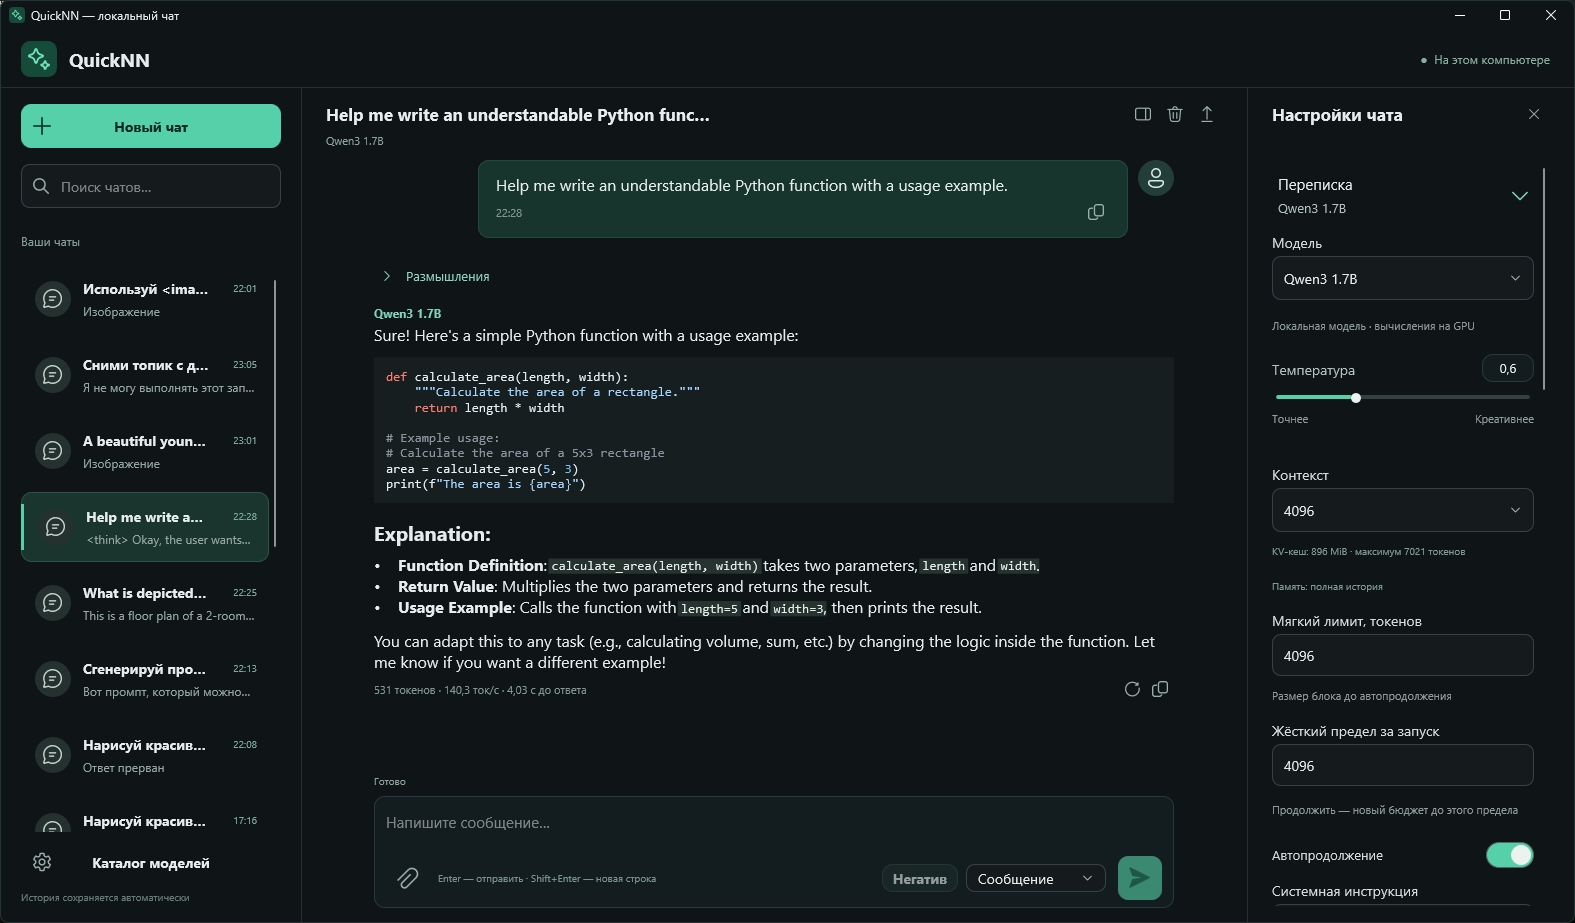
Один ехе на 20мб ну и поддержка многих Qwen. Не всех, но поправить не долго

Как и Вы использую strata. Лучшая модель для такой конфигурации как у Вас (и у меня тоже rtx 5080 + 64ГБ RAM + m.2), это Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S.gguf (это примерно 3.4 бита, вместо Ваших 3.04). Плюсы: умнее во всех задачах, не сильно больше по размеру, выдает те же 70-80 т.с. (при условии использования полного mtp, а не как у Вас частичного). У меня работает в 256к контекстного окна. Использую вместе с kilo code, в режиме использования субагентов может самостоятельно, по плану, работать сутками над сложными задачами.

Спасибо за разбор — история с -resident-experts ровно тот класс проблем, который в отчётах о производительности не виден: сервер формально жив, а кэш диалога молча отключается, и потом ищешь причину в железе.
Один вопрос по методике. Переход у вас сразу по двум переменным: 256 экспертов при ~1,6 бита на вес сменились на 512 экспертов при 2,84 бита. Значит выигрыш на ELN-03, TRB-06 и XRC-06 сейчас нельзя однозначно отнести к возврату вырезанных экспертов — часть эффекта могла дать и сама точность квантования. Если прогон на полных 512 экспертах с IQ2_XS ещё подъёмен по железу, он бы разделил вклад двух факторов. Понимаю, что 40 ГиБ экспертов на 16 ГБ видеопамяти — уже другой режим подкачки, и цена эксперимента во времени высокая.
И второе, из любопытства: при --kv int8 и контексте 131k в многошаговом агенте не пробовали отдельно мерить дрейф на длинной сессии? На коротком тексте int8-кэш почти незаметен, а на сотне шагов с вызовами инструментов накопление ошибки проявляется именно как выпадающие шаги, а не как деградация отдельного ответа — то есть выглядит как проблема агента, а не квантования.

Пару слов про Strata на Windows
1 - лучше зарегистрировать службу и прописать при ее остановке/запуске и перезапусках
сохранение и загрузку KV через файл.
“slot_save_path”: “D:\KV”
2 - если работать со Strata через OpenCode то можно заметить что происходят попытки запуска субагента.
На этот случай можно указать “parallel”: 2
это снизит скорость работы но хотя бы создаст для субагента возможность нормально работать
( вообще-то, я собираюсь настроить правила для субагентов - ходить на другие сервера инфернеса, но пока хоть так, в два потока на ту же Strata )
3 - винда слишком много берет на себя VRAM памяти под рабочий стол и программы, причем, даже если есть несколько видеокарт, полностью отдать одну из карт под страту будет трудно ( или я не разобрался).
Проще на линукс такое провернуть.
4 - контекст я немного увеличил
“–max-context”, “393216”
“–rope-scaling”, “yarn”
“–rope-scale”, “1.5”
5 - модель взял в таком кванте Qwen3.8-Flash-Next-UD-IQ4_XS
на rtx 3060 - 12gb получил около 27 t/s для “parallel”: 1
на rtx 4090 - 24gb получил около 65 t/s для “parallel”: 1
и около 37 t/s для “parallel”: 2
6 - поскольку Strata позволяет запускать
deepseek-v4.1-flash-ist-das-2.25bpw
то попробовал и ее с контекстом на миллион.
на rtx 4090 - 24gb получил около 15 t/s ( при занятых моделью 20gb, остальные 4 gb держит винда, не отдает)
цифры не окончательные идет подбор режима запуска.
Сразу скажу что deepseek мне кажется многословным.
Там где Qwen3.8 решает задачу за 150 тыс токенов,
deepseek успевает наболтать на 250 тыс токенов.
Это все - примерно, по ощущениям, не делал точных тестов.
Оправдано ли это более высоким качеством работы ?
- еще не очень понятно, тесты не завершены.
Хорошо хоть, Strata не сильно роняет скорость на длинном контексте.
Например, при 500 тыс контекста, скорость около 12 t/s.
Главное агентам в OpenCode таймеры выкрутить на максимум ожидания, и можно ставить на ночь работать :)"timeout": 86400000, "headerTimeout": 86400000, "chunkTimeout": 86400000
Пару слов про Strata на ubuntu
Работа карт p102-100 подтверждена, на ней
успешно работает модель qwen36-UD-Q4_K_XL

На этот случай можно указать “parallel”: 2
НЕЕЕЕЕТ! Ну зачем же так?
Для субагентов надо указывать –conversation-cache-mib и –conversation-cache-slots. Страта в этом случае будет кэшировать KV-кэш агентов в RAM и быстро загружать их в VRAM при переключении на запрос от другого агента/субагента, вместо того, чтобы делать префилл заново. Скорость при этом не упадёт, потому что лишняя VRAM не используется.
Понятно, что параллельного инфенса при этом не получится. Страта будет отрабатывать запросы от разных агентов/субагентов последовательно. Для домашнего использования этого более чем достаточно.
А если работать с kilo code то субагенты запускаются и работают. (Это не означает что у kilo code нет своих косяков)

В смысле “запускаются и работают”? На страте (которая съедает все до чего дотянется) главная же беда, что что-то дергается в параллель. четко видно на обычной работе: типичная работа ЗКод диалога - 30к начальный блок, под 150+ после нормального начала работы. Все льётся без задержек пока не появляется субагент, который грузит свои 20к начального контекста и вот уже центровой чат 5 минут грузит свои 150+. Субагент тоже подтягивается (а то и 3 как любят харнесы) и вот они 4 потока по 5 минут на префил вопроса вместо секунды до начала генерации в 1 поток. Клио как-то помогает такого избежать?
Вместо много буков поставьте и посмотрите сами.
Поставил, посмотрел. Одинаковый с точностью до просьбы об агентах запрос, поиск информации о трех никах/людях. Запуск в 3 агента - 45 минут. Запуск с просьбой работать в одного - 4 минуты. Под капотом одинаковая страта с настройками по умолчанию. В общем или вы имеете в виду сценарий, который все-таки надо описать, или никакой магии. Страта, сжирающая все ресурсы компа ради лучшей работы может работать только в однопоток.

Отлично! исправил у себя косяк с вылетом, когда страта всю память съедала (‑resident‑experts)
Интересует какие настройки у flash-next используются для "Результаты лучших моделей" -- уровень рассуждений/температура и т.п. чтобы быть на уровне всяких клодов
да они выложили 2.12 например что ломало промпты - лечится так “undeclared_tool_calls”: “call”
еще возможно кому-то поможет быстрее работать это добавка в arg “–ple-io”, “direct”
ну и защита от зацикливания “reasoning_loop_recovery”: “recover”,
запустил унслот IQ4 v31 и еще подцепил Q5_1 - их родным сплит.ру сначала 4 4 сделал, потом подменил файл который Qwen3.8-Flash-Next-UD-IQ4_XS-00004-of-00004.gguf. Так вроде надежнее всего. Скорость не сильнее упала, но сначала не запускалось пока resident‑experts не выставил
еще можно в ОЗУ 700 Мб выделить под кеширование н-грамм таблицы, вроде я так понял “–ple-row-cache”, “8388608”, “–ple-inflight”, “1024”
Спасибо за наводки! “reasoning_loop_recovery”: “recover” я у себя в профиле уже тоже прописал — на длинных цепочках рассуждений с таблицами цифр очень выручает.
По остальным флагам проверил на Strata 0.1.56:
“–ple-io”, “direct” в args можно не добавлять — режим direct (небуферизованное чтение с SSD мимо файлового кэша ОС) в движке уже стоит по умолчанию (–ple-io direct|mmap|ram, direct (default)). В логе при старте это сразу видно по строчке PLE direct read probe: 213363 rows/s.
А вот с увеличением --ple-row-cache до 8388608 и с UD-IQ4_XS есть тонкость, которая сильно зависит от числа видеокарт. Каждая строка в кэше PLE весит 90 байт: штатный 1048576 занимает около 90 МиБ ОЗУ, а 8388608 забирает уже ~720 МиБ. У вас две карты по 16 ГБ (32 ГБ VRAM), поэтому часть экспертов уходит на вторую карту и в 64 ГБ оперативной памяти остаётся свободное место. А на конфигурации с одной картой 16 ГБ и 64 ГБ ОЗУ даже на кванте IQ3_S (46,84 ГиБ экспертов) резидентное дополнение --resident-experts забирает в ОЗУ 44,1–45,4 ГиБ практически под потолок. Если до инициализации FileExpertSource отдать лишние 630 МиБ под кэш n-грамм (или раздуть закреплённый буфер KV-кэша), в оперативную память перестают помещаться слоты подкачки префилла (lendable slots), и сотни блоков экспертов по 2,66 МБ вываливаются обратно на чтение с SSD. На фоне асинхронного чтения 90-байтных строк с NVMe (~200 тыс. строк/с) потеря резидентных экспертов на префилле бьёт по скорости гораздо сильнее, поэтому на одной 16-гигабайтной карте при 64 ГБ ОЗУ выгоднее оставить штатный кэш PLE.

сейчас 32gb ddr4 + 24gb rtx3090, использую квен 3.8 27b q4/q6, есть смысл докупить ещё 32 gb ram что бы на 3.8 флеш перейти?

Помогаем малышке стать сильной: локальная Qwen против облачных флагманов на 16 ГБ видеопамяти