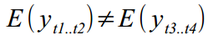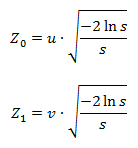Pull to refresh
20

Data Scientist

1
Subscribers
Send message

Фантастические сериалы — обзор от фаната

Reading time8 min
Reach and readers83K
Мне наступили на больную мозоль, сделав некий обзорный пост по нескольким фантастическим сериалам.
А так как субботним вечером делать особенно нечего, давайте-ка я сделаю свой, более полный.
Да, будут спойлеры, имейте в виду.
Да, и очень много картинок! Трафик!

Начнём со Stargate

Целое семейство сериалов, начавшихся с одноимённого фильма.
Это во-первых, конечно,

Stargate SG-1
10/10
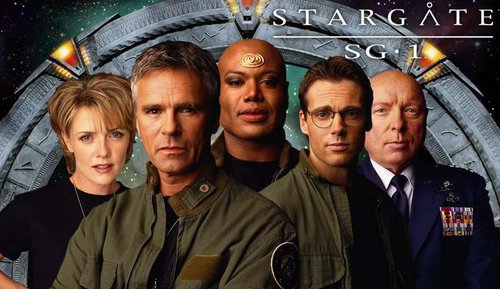
image
Читать дальше →

Что происходит в мозгах у нейронной сети и как им помочь

Reading time26 min
Reach and readers42K
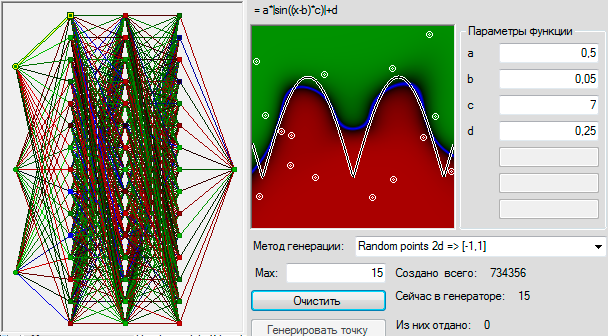
В последнее время на Хабре появилось множество статей о нейронных сетях. Из них очень интересными показались статьи о Перцептроне Розенблатта: Перцептрон Розенблатта — что забыто и придумано историей? и Какова роль первого «случайного» слоя в перцептроне Розенблатта. В них, как и во многих других очень много написано о том, что сети справляются с решением задач, и обобщают до некоторой степени свои знания. Но хотелось бы как-то визуализировать эти обобщения и процесс решения. Увидеть на практике, чему там научился перцептрон, и почувствовать, насколько успешно ему это удалось. Возможно, испытать горькую иронию относительно достижения человечества в области ИИ.
Языком у нас будет С#, только потому что я недавно решил его выучить. Я разобрал два наиболее простых примера: однослойный перцептрон Розенблатта, обучаемый коррекцией ошибки, и многослойный перцептрон Румельхарта, обучаемый методом обратного распространения ошибки. Для тех, кому, как и мне, стало интересно, чему они там на самом деле обучились, и насколько они на самом деле способны обобщать – добро пожаловать под кат.

ОСТОРОЖНО! Много картинок. Куски кода.
Читать дальше →

Математические выражения в .NET (разбор, дифференцирование, упрощение, дроби, компиляция)

Reading time19 min
Reach and readers43K
Мне со школьных времен был интересен алгоритм вывода аналитических производных и упрощения выражений. Данная задача была актуальна впоследствии и в вузе. Тогда-то я реализовал ее, только получилось все не так, как хотелось: вместо кода IL у меня просто генерировался C# код в текстовом виде, сборки не выгружались, ну и к тому же не было возможности вывода производных в аналитическом виде. Однако потом я решил все-таки реализовать такую библиотеку, так как интерес остался. Стоит отметить, что таких библиотек в интернете большое количество, но нигде я не нашел именно этапа компиляции выражений в IL код, т.е. по сути везде выполняется интерпретация, которая не столь эффективна, в отличие от компиляции. Ну и к тому же я это разрабатывал чисто для себя, для изучения новых технологий, особо не надеясь, что результат моих трудов может где-нибудь потребоваться. Для нетерпеливых: исходники, программа.

Используемые программы и библиотеки


  1. GOLD Parsing System — IDE для написания грамматик и генерации кода лексеров и парсеров под различные языки (C, C#, Java, JavaScript, Objective-C, Perl, Python, Ruby и др.). Основана на LALR парсинге.
  2. Visual Studio 2010
  3. GOLD.Engine — сборка под .NET, подключаемая для взаимодействия со сгенерированными таблицами.
  4. NUnit — Открытая среда юнит-тестирования приложений для .NET.
  5. ILSpy — OpenSource дизассемблер под .NET.

Этапы, на которые я разбил весь процесс:
  1. Построение дерева выражения
  2. Вычисление аналитической производной
  3. Упрощение (симплификация) выражения
  4. Обработка рациональных дробей
  5. Компиляция выражения

Читать дальше →

Алгоритм Улучшенной Самоорганизующейся Растущей Нейронной Сети (ESOINN)

Reading time6 min
Reach and readers34K

Введение


В моей предыдущей статье о методах машинного обучения без учителя был рассмотрен базовый алгоритм SOINN — алгоритм построения самоорганизующихся растущих нейронных сетей. Как было отмечено, базовая модель сети SOINN имеет ряд недостатков, не позволяющих использовать её для обучения в режиме lifetime (т.е. для обучения в процессе всего срока эксплуатации сети). К таким недостаткам относилась двухслойная структура сети, требующая при незначительных изменениях в первом слое сети переобучать второй слой полностью. Также алгоритм имел много настраиваемых параметров, что затрудняло его применение при работе с реальными данными.

В этой статье будет рассмотрен алгоритм An Enhanced Self-Organizing Incremental Neural Network, являющийся расширением базовой модели SOINN и частично решающий озвученные проблемы.
Читать дальше →

The Human Brain Project: откуда мы знаем, как устроен мозг?

Reading time6 min
Reach and readers56K


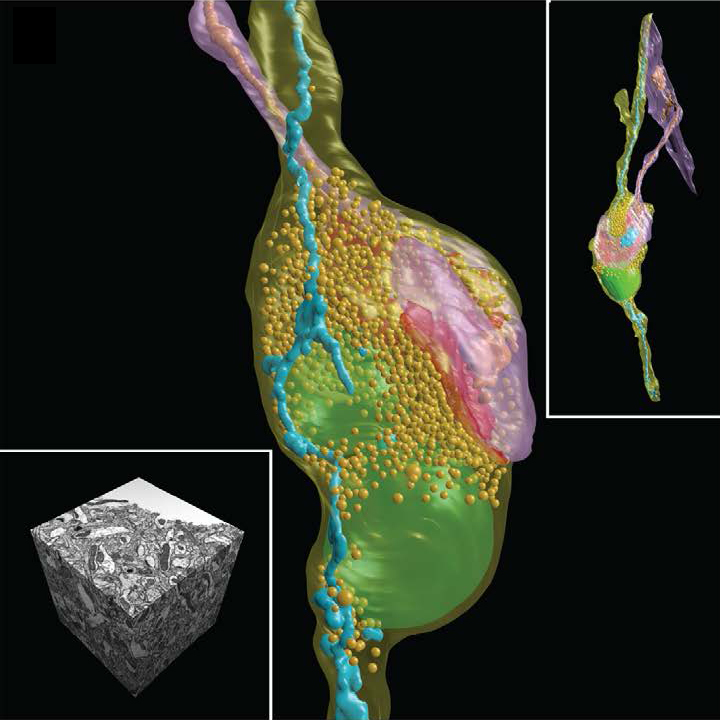
На Хабрахабре в самом начале 2013 года после объявления о старте европейского мега-проекта по изучению человеческого мозга с бюджетом более миллиарда евро, рассчитанного на 10 лет, была опубликована соответствующая заметка. В конце же минувшего года проект был официально запущен, и выделены первые средства, но до сих пор не было написано ни единого слова о том, какой научный базис лежит в основе предстоящего титанического труда, сравнимого по значимости и масштабу с расшифровкой генома человека и пилотируемой миссией на Марс.

В конце поста Вы сможете так же задать вопросы человеку, непосредственно работающему в команде The Blue Brain Project, ответы на которые выйдут отдельным постом.

Какой богатый внутренний мир

Калман, Матлаб, и State Space Models

Reading time15 min
Reach and readers29K
Недавно kuznetsovin опубликовал пост об использовании Питона для анализа временных рядов в экономике. В качестве модели была выбрана «рабочая лошадка» эконометрики — ARIMA, пожалуй, одна из наиболее распространенных моделей для временных данных. В то же время, главный недостаток АRIMA-подобных моделей в том, что они не приспособлены для работы с нестационарными рядами. Например, если в данных присутствует тренд или сезонность, то математическое ожидание будет иметь разное значение в разных участках серии — , что не есть хорошо. Для избежания этого, АRIMA предполагает работать не с исходными данными, а с их разностью (так называемое дифференцирование — от «taking a difference»). Все бы хорошо, но тут возникают две проблемы — (а) мы возможно теряем значимую информацию беря разницу ряда, и (б) упускается возможность разложить ряд данных на составляющие компоненты — тренд, цикл, и т.п. Поэтому, в данной статье я хотел бы привести альтернативный метод анализа — State Space Modeling (SSM), в русском переводе — Модель Пространства Состояний.
Читать дальше →

Уравнение Кеплера: перезагрузка

Reading time5 min
Reach and readers32K

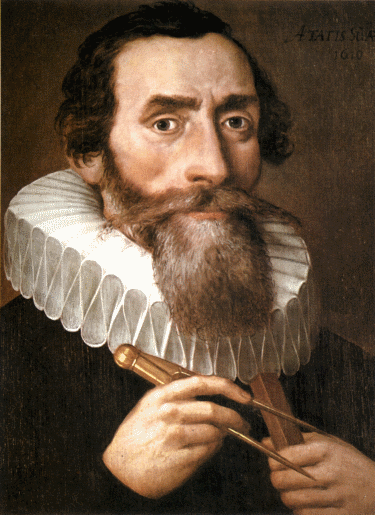
Добрый день! Недавно здесь проскакивал пост про уравнение Кеплера и я был слегка поражен тем, что ничего не написано про то, каким образом оно вообще выводится и откуда, как исторически, так и математически. Как известно, Кеплер вывел его из наблюдения движения планет, а Ландау и Лифшиц вывели движение планет из…
тут и начнем.

Зачем нам всем нужен SAT и все эти P-NP (часть вторая)

Reading time10 min
Reach and readers25K
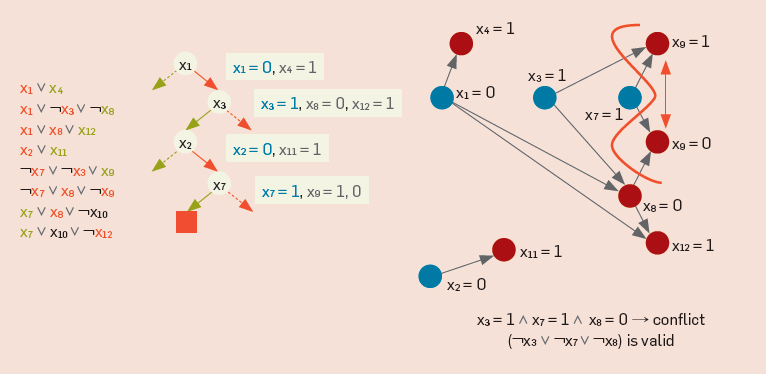
В предыдущей части были освещены общедоступные вопросы, касающиеся SAT и P-NP: история проблемы, интуитивные определения классов и задач, указаны основные приложения SAT и основные последствия, в случаи решения P ?= NP (там же можно найти достаточное число ссылок на различный материал для самостоятельного изучения тематики).

В данной статье мы рассмотрим техническую сторону вопроса, а так же формализуем и представим в деталях материал из предыдущей статьи.


картинка из статьи Boolean Satisfiability: From Theoretical Hardness to Practical Success (Communications of ACM)

Читать дальше →

Фильтр Калмана

Reading time10 min
Reach and readers503K


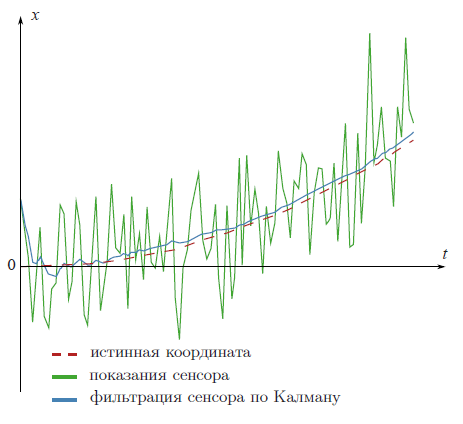
В интернете, в том числе и на хабре, можно найти много информации про фильтр Калмана. Но тяжело найти легкоперевариваемый вывод самих формул. Без вывода вся эта наука воспринимается как некое шаманство, формулы выглядят как безликий набор символов, а главное, многие простые утверждения, лежащие на поверхности теории, оказываются за пределами понимания. Целью этой статьи будет рассказать об этом фильтре на как можно более доступном языке.
Фильтр Калмана — это мощнейший инструмент фильтрации данных. Основной его принцип состоит в том, что при фильтрации используется информация о физике самого явления. Скажем, если вы фильтруете данные со спидометра машины, то инерционность машины дает вам право воспринимать слишком быстрые скачки скорости как ошибку измерения. Фильтр Калмана интересен тем, что в каком-то смысле, это самый лучший фильтр. Подробнее обсудим ниже, что конкретно означают слова «самый лучший». В конце статьи я покажу, что во многих случаях формулы можно до такой степени упростить, что от них почти ничего и не останется.
Читать дальше →

Преобразование равномерно распределенной случайной величины в нормально распределенную

Reading time6 min
Reach and readers138K
Этот вопрос уже давно подробно изучен, и наиболее широкое распространение получил метод полярных координат, предложенный Джорджем Боксом, Мервином Мюллером и Джорджем Марсальей в 1958 году. Данный метод позволяет получить пару независимых нормально распределенных случайных величин с математическим ожиданием 0 и дисперсией 1 следующим образом:
алгоритм марсалья marsaglia
где Z0 и Z1 — искомые значения, s = u2 + v2, а u и v — равномерно распределенные на отрезке (-1, 1) случайные величины, подобранные таким образом, чтобы выполнялось условие 0 < s < 1.
Многие используют эти формулы, даже не задумываясь, а многие даже и не подозревают об их существовании, так как пользуются готовыми реализациями. Но есть люди, у которых возникают вопросы: «Откуда взялась эта формула? И почему получается сразу пара величин?». Далее я постараюсь дать наглядный ответ на эти вопросы.

Читать дальше →

Алгоритмы и структуры данных поиска. Лекции и курсы от Яндекса

Reading time4 min
Reach and readers161K
Сегодня мы завершаем новогоднюю серию постов, посвященных лекциям Школы анализа данных. Последний по порядку, но никак не по важности курс — «Алгоритмы и структуры данных поиска».

В этом курсе рассматриваются базовые алгоритмы и структуры данных, включая хешировани, сложность и модели вычислений, деревья поиска, B-деревья, задачи геометрического поиска, динамическую связность в графах и другое.

Мы учли то, о чём нас просили в комментариях к прошлым курсам — теперь при желании можно не только смотреть/скачивать лекции по отдельности, но и загрузить всё разом в виде открытой папки на Яндекс.Диске. Кстати — в предыдущих постах тоже появились такие же апдейты (вот ссылки для удобства: «машинное обучение», «дискретный анализ и теория вероятностей», «параллельные и распределённые вычисления»).


Лекции читает Максим Александрович Бабенко, заместитель директора отделения computer science, ассистент кафедры математической логики и теории алгоритмов механико-математического факультета МГУ им. М. В. Ломоносова, кандидат физико-математических наук.
Содержание курса, тезисы лекций и ссылки на видео

Алгоритм нечёткой кластеризации fuzzy c-means на PHP

Reading time5 min
Reach and readers24K
Доброго времени суток.

Пост и код приведённый ниже, предназначен не столько для использования алгоритма в рабочих целях, сколько для того, чтобы понять, как алгоритм fuzzy c-means работает и возможно, дать толчок к реализации этого алгоритма на других языках либо для усовершенствования приведённого кода и его дальнейшего использования в рабочих целях.


Читать дальше →

Восстановление логической функции

Reading time19 min
Reach and readers12K
image


В данной статье Вы сможете найти готовую реализацию и описание алгоритма предназначенного для реконструкции логических функций методом чёрного ящика. Под логической функцией я подразумеваю такую функцию, которая принимает в качестве аргументов множество булевых значений и соответственно возвращает одно. Пример:
def customlogic(params):
    return params[0] and params[1] and not params[5] and params[11] or params[2] and not params[3] or params[0] and params[5] and not params[6] or params[7] and not params[8]

В конце статьи алгоритм проверяется на данных полученных из реального мира.
Читать дальше →

Распознавание образов. Метод потенциальных функций

Reading time3 min
Reach and readers33K
Здравствуйте, я давно читаю Хабрахабр и часто мне попадались статьи про нейронные сети, в частности про однослойный перцептрон. Но пока еще мне не встретилась статья про другие виды распознающих функций перцептронного вида. Как следует из названия статьи данный вид распознающих функций называется методом потенциальных функций.

Сразу оговорюсь, целью данной статьи является не предоставить работающую программу на основе данного метода, а рассказать собственно про сам алгоритм, на чем он основан и в чем его преимущества.

Для начала я опишу основные понятия теории распознавания образов, применяющиеся в данной статьей, затем дам краткое пояснение метода и потом уже распишу его подробно.

Основные понятия
Изображение — отображение объекта на воспринимающие органы. То есть, описание объекта, как множество признаков. Часто объект представляется в виде вектора. Если множество признаков постоянное, то объект отождествляется с его изображением.
Образ (класс) — подмножество множества объектов или изображений.
Решающая функция — функция, на вход которой подается изображение, определяющая принадлежность объекта некоторому классу.

Краткое описание
Суть данного метода, а впрочем, любого алгоритма, применяемого для распознавания образов состоит в том, чтобы составить такую решающую функцию, которая будет для каждого объекта определять принадлежность его к нужному классу.
В данном случае, решающая функция составляется итеративно, по маркированной обучающей выборке (для каждого объекта из ОВ известен его класс).
Читать дальше →

Лекции от Яндекса для тех, кто хочет провести каникулы с пользой. Дискретный анализ и теория вероятностей

Reading time3 min
Reach and readers145K
Для тех, кому одного курса на праздники мало и кто хочет больше, продолжаем нашу серию курсов от Школы анализа данных Яндекса. Сегодня подошла очередь курса «Дискретный анализ и теория вероятностей» – даже более фундаментального, чем предыдущий. Но без него нельзя представить ещё большую часть современной обработки данных.

В рамках курса рассматриваются основные понятия и методы комбинаторного, дискретного и асимптотического анализа, теории вероятностей, статистики и на примере решения классических задач демонстрируется их применение.


Читает курс Андрей Райгородский. Доктор физико-математических наук. Профессор кафедры математической статистики и случайных процессов механико-математического факультета МГУ им. М. В. Ломоносова. Заведующий кафедрой Дискретной математики ФИВТ МФТИ. Профессор и научный руководитель бакалавриата кафедры «Анализ данных» факультета инноваций и высоких технологий МФТИ. Руководитель отдела теоретических и прикладных исследований компании «Яндекс». (Ещё больше можно узнать в статье о нём на Википедии).

Содержание курса и тезисы лекций

Machine Learning. Курс от Яндекса для тех, кто хочет провести новогодние каникулы с пользой

Reading time8 min
Reach and readers269K
Новогодние каникулы – хорошее время не только для отдыха, но и для самообразования. Можно отвлечься от повседневных задач и посвятить несколько дней тому, чтобы научиться чему-нибудь новому, что будет помогать вам весь год (а может и не один). Поэтому мы решили в эти выходные опубликовать серию постов с лекциями курсов первого семестра Школы анализа данных.

Сегодня — о самом важном. Современный анализ данных без него представить невозможно. В рамках курса рассматриваются основные задачи обучения по прецедентам: классификация, кластеризация, регрессия, понижение размерности. Изучаются методы их решения, как классические, так и новые, созданные за последние 10–15 лет. Упор делается на глубокое понимание математических основ, взаимосвязей, достоинств и ограничений рассматриваемых методов. Отдельные теоремы приводятся с доказательствами.


Читает курс лекций Константин Вячеславович Воронцов, старший научный сотрудник Вычислительного центра РАН. Заместитель директора по науке ЗАО «Форексис». Заместитель заведующего кафедрой «Интеллектуальные системы» ФУПМ МФТИ. Доцент кафедры «Математические методы прогнозирования» ВМиК МГУ. Эксперт компании «Яндекс». Доктор физико-математических наук.
Содержание и видео всех лекций курса

Машинное обучение и анализ данных. Лекция для Малого ШАДа Яндекса

Reading time3 min
Reach and readers65K
Все чаще и чаще мы сталкиваемся с необходимостью выявлять внутренние закономерности больших объёмов данных. Например, для распознавания спама необходимо уметь находить закономерности в содержании электронных писем, а для прогнозирования стоимости акций — закономерности в финансовых данных. К сожалению, выявить их «вручную» часто невозможно, и тогда на помощь приходят методы машинного обучения. Они позволяют строить алгоритмы, которые помогают находить новые, ещё не описанные закономерности. Мы поговорим о том, что такое машинное обучение, где его стоит применять и какие сложности могут при этом возникнуть. Принципы работы нескольких популярных методов машинного обучения будут рассмотрены на реальных примерах.

Лекция предназначена для старшеклассников — студентов Малого ШАДа, но и взрослые с ее помощью смогут составить представление об основах машинного обучения.

image

Основная идея машинного обучения заключается в том, что имея обучающуюся программу и примеры данных с закономерностями, мы можем построить некоторую модель закономерности и находить закономерности в новых данных.
Видеозапись и конспект лекции

Математический фокус для MP3, JPEG и Гомера Симпсона

Reading time6 min
Reach and readers111K
Девять лет назад я посещал курс физики в колледже, и мой профессор рассказал одну вещь, которая поразила меня. Я думаю, не будет преувеличением сказать, что это одно из наиболее широко используемых математических открытий — от оптики до квантовой физики, радиоастрономии, сжатия MP3 и JPEG, рентгеновской кристаллографии, распознавания голоса и МРТ. Этот математический инструмент называется преобразование Фурье, в честь французского физика и математика 18-го века Жозефа Фурье. Им пользовались даже Джеймс Уотсон и Фрэнсис Крик, чтобы декодировать структуру двойной спирали ДНК из рентгенограмм, произведенных Розалиндой Франклин. (Крик был экспертом по преобразованиям Фурье, он в шутку назвал свою книгу «Преобразования Фурье для орнитологов», чтобы объяснить суть Уотсону, заядлому любителю птиц).
Читать дальше →

Пишу игрушечную ОС (о планировщике)

Reading time4 min
Reach and readers22K

Продолжаю вести блог о разработке игрушечной ОС.

В прошлом посте я писал о том, как добиться возможности реализовывать на C обработчики прерываний. Теперь, пользуясь написанными ранее макросами, можно реализовать простой SMP-планировщик. Он будет предоставлять минимально возможный функционал, на базе которого в будущем нужно будет возводить различные надстройки, в частности, примитивы синхронизации (например, мьютекс). Опять же, красивая модульная структура не способствует высокой производительности, но красота, как известно, спасёт мир, так что отдадим ей предпочтение.

Итак, попробуем сформулировать требования к нашему планировщику. Нам нужна возможность создать поток, указать для него стек, маску разрешённых логических процессоров (affinity), базовый приоритет и функцию выполнения. Далее, поток можно запустить, приостановить, продолжить его выполнение и, наконец, завершить.

Кроме того, было бы здорово, если бы планировщик не занимался выделением памяти, а мог принимать и возвращать память, выделенную под поток кем-то другим. С одной стороны, это бы обеспечило гибкость произвольного резервирования памяти потоков. С другой – дало бы уникальную возможность сохранять поток во внешней памяти (например, на жёстком диске) с последующей его загрузкой и запуском с прерванного места.
Читать дальше →

Доступен для скачивания ReSharper 8 EAP

Reading time5 min
Reach and readers16K
В мире новых технологий ни одна компания не может себе позволить стоять на месте. По мере того как выходят новые фреймворки и языки программирования, ReSharper старается успевать их поддерживать. Собственно, поэтому мы рады объявить об открытии EAP-программы ReSharper 8 и, в связи с предстоящим релизом, представить вашему вниманию обзор тех возможностей, которые появятся в ReSharper 8.
Что новенького?..

Information

Rating
Does not participate
Location
Москва и Московская обл., Россия
Registered
Activity