Pull to refresh
25

User

18
Subscribers
Send message

Разбираем условия Каруша–Куна–Таккера. Решаем сложно простую задачу

Level of difficultyMedium
Reading time6 min
Reach and readers18K

Если Вы когда‑то учились в вузе на технической специальности или учитесь сейчас (иначе, зачем бы Вам эта статья), у Вас наверняка есть предмет, который назывался примерно так — «Методы оптимизации» / «Введение в оптимизацию» или что‑то похожее. Задачки там примерно такие: «завод производит продукцию k типов, как бы произвести n_1 деталей первого типа,..., n_k деталей k‑го и как можно дешевле». Потом рассказывалось про симплекс‑метод для задач линейного программирования и про метод Лагранжа для задач нелинейного. Про указанные выше условия где‑то упоминается, но без примеров, где‑то сразу абстрактные примеры с матрицами, а может быть Ваш препод и вовсе написал в своей методичке, мол, это выходит за рамки курса. В этой статье предлагаю аккуратно разжевать на простом примере, что такое условия ККТ.

Что нам позволяют найти условия Каруша‑Куна‑Таккера (ККТ)

Проверка условий ККТ позволяет решить условную задачу оптимизации, как линейную так и нелинейную, с ограничениями типа равенств и неравенств. Можно сказать, что ККТ это почти универсальный метод, позволяющий решить большинство «адекватных» задач.

Читать далее

Лучшие алгоритмы 20 века по версии SIAM

Level of difficultyMedium
Reading time19 min
Reach and readers15K

На рубеже веков SIAM опубликовали список из 10 алгоритмов, оказавших наибольшее влияние на науку и индустрию в 20 веке (по мнению редакции), четверть века спустя по меньшей половина из этого списка до сих пор используется повсеместно. В статье вспомним что это за алгоритмы и за что они получили такое признание. Обсудим и алгоритмы, которые в этот список не вошли, но вполне могли бы, о чем читатели хабра написали в комментариях к статье "10 лучших алгоритмов 20 века". В конце статьи опрос, пожалуйста, не проходите мимо и отметьте или напишите в комментариях, какие алгоритмы на ваш взгляд должны были оказаться в этом списке!

Читать далее

Выходные не прошли зря. В пьяном дурмане (это наркоз от попоболи) я продолжал разработку своего AI-трейдера,...

Reading time1 min
Reach and readers12K

Выходные не прошли зря.

В пьяном дурмане (это наркоз от попоболи) я продолжал разработку своего AI-трейдера, воспользовался вашими предложениями в телеграм (огромное спасибо за подсказку), и кое-что получилось:

Читать дальше →

Создание умных AI-агентов: полный курс по LangGraph от А до Я. Часть 1. Архитектура: графы, узлы и состояния

Reading time23 min
Reach and readers96K

В первой части курса по созданию ИИ-агентов разбираем фундаментальные основы LangGraph: что такое графы состояний, как работают узлы и рёбра, зачем нужны условные переходы и циклы.

Учимся строить архитектуру будущих AI-агентов без единой строчки ML-кода — только чистая логика и понятные примеры. От простого калькулятора возраста до сложных циклических процессов с визуализацией графов. Готовим фундамент для интеграции с нейросетями в следующих частях.

Читать далее

Когда ИИ может в оптимизацию…

Level of difficultyEasy
Reading time10 min
Reach and readers5.6K

Способны ли имеющиеся архитекутры нейронных сетей составить конкуренцию классическим методам оптимизации в решении хорошо изученных задач таких как проблема коммивояжера? Я решил попробовать ответить на этот вопрос и опубликовать свои наработки.

Читать далее

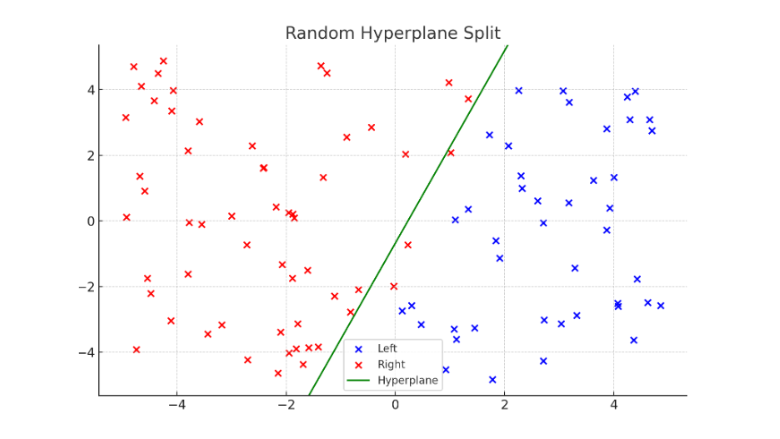
Случайные разрезы данных в задаче кластеризации: коротко

Level of difficultyEasy
Reading time4 min
Reach and readers2.2K

Кластеризация — штука сложная. Вроде все просто: сгруппировать похожее с похожим. Но когда данных вагон, а структура запутаннее клубка проводов за столом, стандартные методы вроде k-means или DBSCAN начинают сдавать позиции. Особенно больно, если данные нелинейные, а пространство хоть на глобус натягивай.

И вот тут хорошо зайдет Random Cuts — подход, который берет все это хаосное пространство и начинает резать его случайными гиперплоскостями.

Читать далее

Physics-based и data-driven моделирование

Level of difficultyEasy
Reading time4 min
Reach and readers4K

В этом посту поговорим про различия в двух подходах моделирования, а именно, чем отличаются физически обоснованные модели от моделей, основанных на данных. На самом деле между этими двумя понятиями есть и кое-что среднее, что становится актуальнее в решение научных задач. Но об этом позже. 

Итак, начнем с моделей, основанных на данных. Такого рода модели встречаются почти на каждом шагу. Любая задача машинного обучения, будь то регрессия (например, предсказание цен на товары), классификация (определение маркера болезни по данным об анализах пациента), рекомендация (определение более подходящего видео в вашей ленте), сегментация (определение объектов на фото или видео) и т. д. Задач машинного обучения достаточно много, но все они требуют одного - данных.

В этом классе моделей требуется собрать подходящий набор данных, обработать его (например, убрать различные аномалии или трансформировать переменные), определиться с типом задачи, выбрать модель для этого типа задачи и подать данные на вход. И, наконец, обучить модель, подбирая оптимальным образом весовые коэффициенты. 

Модели, основанные на данных, по факту являются статистическими моделями, которые наилучшим образом аппроксимируют неизвестную зависимость. Во многих задачах неизвестны закономерности между независимыми переменными и результирующим признаком или признаками. Они либо сложны для описания, либо у нас нет четкой формулы для получения ответа. Именно здесь такие статистические модели приходят на помощь.

Читать далее

Байесовские сети при помощи Питона — что и зачем?

Reading time8 min
Reach and readers20K
Дисклеймер: данная статья является адаптированным переводом. Оригинал можно прочесть здесь.

Байесовские сети при помощи Питона — объяснение с примерами


Из-за ограниченности информации (особенно на родном русском) и ресурсов работы, байесовские сети окружены рядом проблем. И можно было бы спать спокойно, если бы их реализация не осуществлялась в большинстве передовых технологий эры, таких как искусственный интеллект и машинное обучение.

Основываясь на данном факте, эта статья полностью посвящена работе Байесовских сетей и тому, как они сами могут не формировать проблемы, а применяться в их решении, даже если решаемые проблемы крайне запутаны.
Читать дальше →

Предиктивная аналитика политических кризисов с помощью machine learning (на исторических данных)

Level of difficultyEasy
Reading time13 min
Reach and readers5.4K

Допустим, вы инвестор-финансист, покупающий государственные облигации банановой республики или акции компании по выращиванию и поставке бананов или даже правитель бананового рая – всегда необходимо учитывать не только финансовые, но и политические риски в развитии страны. Представим, что наша основная задача - оценить риски. Просто, цинично, в стиле real politic без всякой душеспасительности и ... котиков.

Читать далее

Метрологический дефицит в бигдате: что это такое и как с ним бороться

Reading time6 min
Reach and readers6K

Добрый день. Сегодня я хотел бы поговорить о том, что вроде бы очевидно и должно быть везде, но когда я читаю статьи презентации, рекламные статьи, научные статьи, выступления на отраслевых конференциях и тексты «войди в айти и стань датасатанистом», я этого не вижу.

Речь о том, что данные, попадающие в машинное обучение, ИИ, цифровых двойников и т. п., не являются тем чем кажутся. Потому что между их изначальным физическим смыслом и числовым выражением внутри модели, стоит череда преобразований.

Но в этот раз речь пойдёт не о цифровом износе и моих многолетних наблюдениях за цифровыми объектами, а об измерительных приборах и ваших многолетних наблюдениях за производственными процессами.

Читать далее

Как извлечь квадратный корень из перестановки чисел?

Level of difficultyMedium
Reading time4 min
Reach and readers13K

В этой статье мы исследуем проблему извлечения квадратного корня из перестановки p, иными словами задачу нахождения всех таких перестановок x, что x \cdot x = p. Будет сформулирован критерий возможности извлечения квадратного корня, алгоритм нахождения корней и формула их подсчёта в общем виде.

Читать далее

Как выигрывать Kaggle соревнования: LLM-анализ выигрышных решений

Reading time5 min
Reach and readers8.1K

Примерно год назад энтузиаст с Kaggle по имени Дарек Клечек провел интересный эксперимент: он собрал все доступные описания (writeups) побеждавших на Kaggle за последние годы решений, пропустил их через LLM и свел по ним общую статистику о том, какие механики и алгоритмы оказываются "наиболее победными". Отчет у парня получился достаточно объемный, интересный, а местами и непредсказуемый. Эта статья – свободный авторский пересказ его эссе. И пусть прологом к ней послужит цитата Дарека:

Читать далее

На GitHub опубликован скрипт ReplicateUI для копирования любого веб-сайта со всем кодом и картинками

Reading time1 min
Reach and readers98K

На GitHub опубликован скрипт ReplicateUI для копирования любого веб-сайта со всем кодом и картинками (файл gistfile1.txt). Ранее это решение в виде расширения для браузера продавалось за $10 (https://uireplicator.com/), но теперь код проекта доступен бесплатно.

Читать далее

Применение искусственного интеллекта в синтетической химии

Reading time19 min
Reach and readers22K


Интервью с профессором Игорем Баскиным, доктором физико-математических наук, ведущим научный сотрудник физического факультета МГУ.

В чем самая большая сложность для нейронных сетей, чтобы научиться устанавливать взаимосвязь между структурой вещества и его физическими и химическими свойствами?

Самая большая сложность и ключевая особенность применения нейронных сетей, как и любого другого метода машинного обучения, для поиска соотношений между структурой и свойствами химических веществ заключается в том, что в этом случае они должны моделировать реальную природу с ее чрезвычайно сложной и порой неизвестной организацией, управляемую строгими, но не всегда применимыми на практике законами.

В этом состоит фундаментальное отличие от стандартных задач, решаемых при помощи нейронных сетей, например, распознавания изображений. Действительно, то, что цифра 8 изображается в виде двух соприкасающихся окружностей, не является следствием каких-либо законов природы – это просто предмет соглашений между людьми. А вот римляне в свое время решили, что для них лучше изображать это же число как VIII. Поскольку такие соглашения делаются ради удобства, их форма выбирается такой, чтобы естественные нейронные сети в голове у человека очень легко на подсознательном уровне их распознавали.

Читать дальше →

С новым годом: GPT в 500 строках на SQL

Reading time42 min
Reach and readers44K

В минувшем году все только и говорили об ИИ и о том, как он может всё за вас сделать.

Мне нравится, когда кто-то или что-то работает за меня. Поэтому решил: попрошу-ка ChatGPT написать за меня новогодний пост:

«Эй, ChatGPT. А ты можешь реализовать большую языковую модель на SQL?»
«Нет, SQL не подходит для реализации больших языковых моделей. Язык SQL предназначен для выполнения запросов к данным, хранящимся в РСУБД и для управления этими запросами. Для реализации большой языковой модели требуются сложные алгоритмы, обширные датасеты, а зачастую — и фреймворки для глубокого обучения. SQL всеми этими возможностями не обладает.»

Что ж, лишний раз убеждаешься, что, если хочешь что‑то сделать хорошо – сделай это сам.

Давайте же воодушевимся этим оптимистическим планом и реализуем большую языковую модель на языке SQL.

Читать далее

Главные отличия PCA от UMAP и t-SNE

Level of difficultyMedium
Reading time10 min
Reach and readers13K

Здесь будет рассказано о главных отличиях самого старого и базового алгоритма снижения размерности - PCA от его популярных современных коллег - UMAP и t-SNE. Предполагается, что читатель уже предварительно что-то слышал про эти алгоритмы, поэтому подробного объяснения каждого из них в отдельности приведено не будет. Вместо этого будут объяснены самые важные для практики свойства этих алгоритмов и то, на какие связанные с ними подводные камни можно налететь при неосторожности. Все особенности будут описаны на примерах, с минимумом теории; те пытливые умы, что почувствуют в процессе чтения жажду математической строгости, смогут удовлетворить её в литературе, ссылки на которую будут даны по ходу дела и в конце статьи.

Читать далее

Открытые данные. Как сматчить несматчиваемое или Нейросеть вам в помощь

Reading time9 min
Reach and readers7.2K

Привет, Точка на связи! Аналитик Никитин Александр и Head of ML Андрей Румянцев разобрались как с помощью машинного обучения смерджить несколько наборов данных из открытых источников и не сойти с ума. Open data, TF-IDF, faiss, pgvector, трансформеры и удивительное завершение нашего приключения — всё это под катом.

Читать далее

Эй, компьютер, создай-ка мне шрифт

Level of difficultyMedium
Reading time6 min
Reach and readers12K

Это история о том, как я с нуля осваивал создание генеративных моделей МО, попутно обучая компьютер создавать шрифты. Да, настоящие типографские шрифты, состоящие из набора заглавных глифов. Созданная мной модель получает на входе описание шрифта и создаёт на выходе файл с их готовым набором. Назвал я свой проект FontoGen.

Выше вы видите несколько примеров шрифтов, сгенерированных моделью FontoGen.

Ну а дальше я подробно опишу всю историю.
Читать дальше →

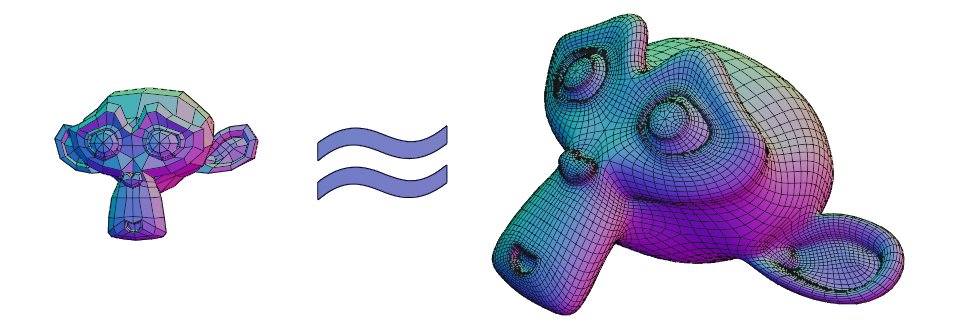
Ray Cast Visual Search (RCVS). Fast and simple algorithm for searching 3D objects with similar shapes

Reading time8 min
Reach and readers3.4K
image
For me, these two models are quite similar, but in fact they don’t have obvious characteristics to measure this similarity. These models have different numbers of vertices, edges and polygons. They are of different sizes, rotated differently and both have the same transforms (Location = [0,0,0], Rotation in radians = [0,0,0], Scale = [1,1,1]). So how to determine their similarity?

Как поделить торт и не поссориться: математические протоколы справедливого деления

Level of difficultyEasy
Reading time10 min
Reach and readers5.5K

В контексте экономики и теории игр отсутствие зависти является критерием справедливого раздела, при котором каждый человек считает, что при разделе какого-либо ресурса его доля по крайней мере так же хороша, как доля любого другого человека — таким образом, он не испытывает зависти. Для n = 2 человек протокол состоит из так называемой процедуры "разделяй и выбирай":

Процедура разрезания торта без зависти гласит, что если два человека должны разделить торт таким образом, чтобы каждый считал, что его доля ничуть не хуже, чем у любого другого человека, один человек ("режущий") разрезает торт на две части; другой человек ("выбирающий") выбирает одну из частей; режущий получает оставшийся кусок.

В случаях, когда количество людей, разделяющих пирог, превышает два, n > 2, сложность протокола значительно возрастает. Эта процедура имеет множество применений, в том числе (совершенно очевидно) в распределении ресурсов, а также в разрешении конфликтов и искусственном интеллекте, среди других областей.

Читать далее
1
23 ...

Information

Rating
Does not participate
Registered
Activity