Pull to refresh
1
Send message

О производительности именованных каналов в многопроцессных приложениях

Reading time4 min
Reach and readers7.7K
В статье об особенностях новой версии Visual Studio одним из главных нововведений (с моей точки зрения) оказалось разделение ранее монолитного процесса среды разработки (devenv.exe) на компоненты, которые будут работать в отдельных процессах. Это уже сделано для системы контроля версий (переезд с libgit на git.exe) и некоторых плагинов, а в будущем и другие части VS будут вынесены в подпроцессы. В связи с этим в комментариях возник вопрос: «А не замедлит ли это работу, ведь обмен данными между процессами требует использования IPC (Inter Process Communications)?»

Нет, не замедлит. И вот почему.
Читать дальше →

Как оптимизировать запоминание иностранных слов

Reading time8 min
Reach and readers34K


Прежде чем взяться за разработку мобильного приложения для заучивания лексики, мы в школе Skyeng потратили массу времени на изучение алгоритмов работы памяти и запоминания слов. В результате разработка Aword заняла чуть больше времени, но мы более уверены в результате — использование определенных алгоритмов в показе слов помогает эффективнее пополнять словарный запас.
Читать дальше →

Оптимизация кода: память

Level of difficultyHard
Reading time12 min
Reach and readers98K
Большинство программистов представляют вычислительную систему как процессор, который выполняет инструкции, и память, которая хранит инструкции и данные для процессора. В этой простой модели память представляется линейным массивом байтов и процессор может обратиться к любому месту в памяти за константное время. Хотя это эффективная модель для большинства ситуаций, она не отражает того, как в действительности работают современные системы.

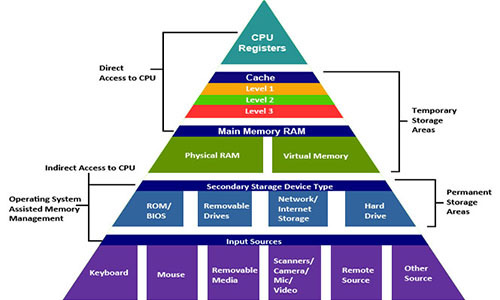
В действительности система памяти образует иерархию устройств хранения с разными ёмкостями, стоимостью и временем доступа. Регистры процессора хранят наиболее часто используемые данные. Маленькие быстрые кэш-памяти, расположенные близко к процессору, служат буферными зонами, которые хранят маленькую часть данных, расположеных в относительно медленной оперативной памяти. Оперативная память служит буфером для медленных локальных дисков. А локальные диски служат буфером для данных с удалённых машин, связанных сетью.

image

Иерархия памяти работает, потому что хорошо написанные программы имеют тенденцию обращаться к хранилищу на каком-то конкретном уровне более часто, чем к хранилищу на более низком уровне. Так что хранилище на более низком уровне может быть медленнее, больше и дешевле. В итоге мы получаем большой объём памяти, который имеет стоимость хранилища в самом низу иерархии, но доставляет данные программе со скоростью быстрого хранилища в самом верху иерархии.
Читать дальше →

Высшая математика командной строки — GNU Octave

Reading time6 min
Reach and readers51K

Как я и обещал, перехожу от обзора программ замены калькулятора к более серьезным инструментам. Если помните схему из предыдущего поста, то во второй категории находились табличные: OpenOffice / LibreOffice сотоварищи. Эту партию мы можем смело пропустить, так как к командной строке она не относится, к тому же, среди читателей Хабра трудно найти человека, который бы в них не разбирался. Поэтому перехожу сразу к третьей категории.


Специализированные математические программы, уровень студент+


  1. GNU Octave.
  2. Scilab.
  3. Maxima.
  4. R.
  5. Sage.

На первом месте в этом списке находится Octave, и это не случайность. Исследователи из Университета Мэриленда в США провели сравнительный анализ математических вычислений, используя MATLAB, Octave, SciLab и FreeMat в простом сценарии и в сложном. В первом случае решали систему линейных уравнений а в втором — конечно-разностную дискретизацию уравнения Пуассона в двухмерном пространстве. Основной вывод — GNU Octave справляется с задачами лучше остальных открытых математических пакетов, демонстрируя результат (страницы 23 и 25) сопоставимый с матлабовским.

Читать дальше →

Matreshka.js 2 — самый простой фреймворк во Вселенной

Reading time8 min
Reach and readers18K
Matreshka.js заполняет образовавшуюся за последние годы пропасть между джуном и сеньором

Вышла beta второй версии фреймворка Matreshka.js. Релиз выйдет через неделю (плюс пара дней) после последнего патча, отчет начинается с выходом этого поста. Версию можно считать стабильной, а статус beta — чистой формальностю, так как проект достаточно долго и без серьезных изменений пребывал в статусе prealpha/alpha и проверялся в реальных проектах.


» Репозиторий
» Сайт


Позиционирование фреймворка


Вместо наивного "JavaScript фреймворк для всех", Matreshka.js теперь позиционируется, как "Простой фреймворк для джунов". Позвольте мне, вместо дублирования текста с сайта, разместить ссылку на текст, объясняющий этот момент более детально.


Общие изменения


  • Фреймворк был переписан с нуля, с использованием ECMAScript 2015 и некоторых элементов синтаксиса, еще не вошедших в финальную спецификацию.
  • Все примеры так же переписаны на новый JavaScript.
  • Устранены все потенциальные утечки памяти.
  • Добавлена возможность импортировать только необходимые функции и классы. В документации к каждому статичному методу и классу указан и адрес модуля.

const bindNode = require('matreshka/bindnode');
bindNode(object, key, node);

  • Все сопроводительные материалы так же обновились: статьи, роутер, и пр.
  • Документация собирается с помощью Webpack и самописного плагина, который очень быстро генерирует HTML файлы из JSDoc и GFM.

Читать дальше →

Это маленькое чудо — алгоритм Кнута-Морриса-Пратта (КМП)

Reading time9 min
Reach and readers213K
Алгоритм Кнута-Морриса-Пратта используется для поиска подстроки (образца) в строке. Кажется, что может быть проще: двигаемся по строке и сравниваем последовательно символы с образцом. Не совпало, перемещаем начало сравнения на один шаг и снова сравниваем. И так до тех пор, пока не найдем образец или не достигнем конца строки.
Читать дальше →

Сколько нужно нейронов, чтобы узнать, разведён ли мост Александра Невского?

Reading time6 min
Reach and readers26K

image


Введение.


На той неделе darkk описал свой подход к проблеме распознавания состояния моста(сведён/разведён).


Алгоритм, описанный в статье, использовал методы компьютерного зрения для извлечения признаков из картинок и скармливал их логистической регрессии для получения оценки вероятности того, что мост сведён.


В комментариях я попросил выложить картинки, чтобы можно было и самому поиграться. darkk на просьбу откликнулся, за что ему большое спасибо.


В последние несколько лет сильную популярность обрели нейронные сети, как алгоритм, который умудряется в автоматическом режиме извлекать признаки из данных и обрабатывать их, причём делается это настолько просто с точки зрения того, кто пишет код и достигается такая высокая точность, что во многих задачах (~5% от всех задач в машинном обучении) они рвут конкурентов на британский флаг с таким отрывом, что другие алгоритмы уже даже и не рассматриваются. Одно из этих успешных для нейронных сетей направлений — работа с изображениями. После убедительной победы свёрточных нейронных сетей на соревновании ImageNet в 2012 году публика в академических и не очень кругах возбудилась настолько, что научные результаты, а также програмные продукты в этом направлении появляются чуть ли не каждый день. И, как результат, использовать нейронные сети во многих случаях стало очень просто и они превратились из "модно и молодёжно" в обыкновенный инструмент, которым пользуются специалисты по машинному обучению, да и просто все желающие.


Читать дальше →

Const и оптимизации в C

Reading time3 min
Reach and readers20K

Сегодня на /r/C_Programming задали вопрос о влиянии const в C на оптимизацию. Я много раз слышал варианты этого вопроса в течении последних двадцати лет. Лично я обвиняю во всём именование const.

Читать дальше →

Супермедленный и супербыстрый бенчмарк

Reading time5 min
Reach and readers24K

В недавней статье про производительность Java разгорелась дискуссия на тему измерения производительности. Глядя на неё, с грустью приходится сознавать, что многие люди до сих пор не понимают, насколько сложно правильно измерить время выполнения того или иного кода. Кроме того, люди вообще не привыкли, что один и тот же код в разных условиях может выполняться существенно разное время. К примеру, вот одно из мнений:


Если мне надо узнать, "какой язык быстрее для меня на моей задаче", то я прогоню самый примитивный бенчмарк в мире. Если разница будет существенной (скажем, на порядок) — то скорее всего и на пользовательской машине все будет примерно также.

К сожалению, самый примитивный бенчмарк в мире — это как правило неправильно написанный бенчмарк. И не следует надеяться, что неправильный бенчмарк измерит результат хотя бы с точностью до порядка. Он может измерить что-нибудь абсолютно другое, что будет совершенно отличаться от реальной производительности программы с аналогичным кодом. Давайте рассмотрим пример.

Читать дальше →

Новые возможности поддержки JavaScript в ReSharper 8.1

Reading time4 min
Reach and readers6.9K

В связи с постоянным ростом популярности языка JavaScript мы продолжаем улучшать его поддержку в ReSharper’е. Ниже хотелось бы продемонстрировать некоторые механизмы, с помощью которых ReSharper 8.1 делает разработку на JavaScript быстрее и безопасней.


Подробности тут...

Атом — реализация на TypeScript

Reading time13 min
Reach and readers20K
Здравствуйте, меня зовут Дмитрий Карловский и я… профессиональный велосипедист. За свою жизнь я перепробовал множество железных коней, но в конечном счёте остановился на самодельном. Не то чтобы мне очень нравилось работать напильником, тратя кучу свободного времени на изобретение колеса, но конечный результат, где каждая кочка не отдаётся болью в нижней половине туловища, того стоит. А теперь, когда вы знаете, что я затеял всё это не просто так, а чтобы сделать мир лучше, позвольте представить вам TypeScript/JavaScript модуль $jin.atom.

Краткое содержание предыдущей серии: простейшее приложение достигло критического уровня сложности, и, чтобы совладать с оной, была введена абстракция «атом», которая вобрала в себя всю рутину, позволив разработчику сконцентрироваться на описании инвариантов в функциональном стиле, не теряя связи с объектно ориентированной платформой. Вся теория и картинки там. Тут же будет куча практики, примеров кода и дампов консоли.
Читать дальше →

Как оптимизировать игру с помощью полигональных атласов

Reading time5 min
Reach and readers32K
Как всем известно, жизнь разработчика мобильных игр непроста. Он должен найти свой путь на очень узкой дорожке. С одной ее стороны — требования гейм-дизайнеров, уверенно устремляющиеся к бесконечности. Больше функционала, больше красивой графики, больше эффектов, больше анимаций, больше звуков. А с другой стороны — ограниченные ресурсы мобильного устройства. И раньше всего, как правило, заканчивается оперативная память.

Например, iPad 2 — всего в нем 512 Мб RAM. Однако приложению доступно только примерно 275 Мб. Когда занимаемая приложением память будет приближаться к этой границе, операционная система пришлет так называемое «Memory warning» — мягко, но настойчиво предложит освободить память. И если лимит все же будет превышен, операционная система остановит приложение. Пользователь будет думать, что ваша игра упала и побежит писать гневное письмо в саппорт.


Главный потребитель памяти — это, конечно, графика. В этой статье мы попробуем рассказать о пусть немного сложном, но эффективном способе, который используется для уменьшения занимаемой текстурами памяти, а также для повышения скорости отрисовки.
Читать дальше →

Эффективное кеширование. От теории к практике

Reading time13 min
Reach and readers78K
image

Как правило, статьи о кешировании начинаются за здравие, а заканчиваются LRU кешем. Попробуем переломить эту тенденцию? Начнем с того, чем LRU плох, а закончим за здравие. Я надеюсь.

Вне зависимости от того, строите ли вы хайлоад сервис для миллионов посетителей или проектируете мобильное приложение, пишите операционную систему или СУБД — ключевое звено, влияющее на конечную стоимость системы и на отзывчивость интерфейса/сервиса — это кеш.
Читать дальше →

Маслобойка

Reading time4 min
Reach and readers48K

Ты слышал про парня, который попрощался с OOП?


О нет. Ещё один? Что же он сказал?

Он описал все обещания OOП, и как ни одно из них на самом деле не было исполнено, и что все возможности ООП обходятся дороже, чем они реально стоят, и функциональное программирование лучше, и ...


Ох. Да, я слышал всё это раньше...

Таким образом, OOП окончательно умерло, и мы можем двигаться дальше.


Двигаться дальше к чему?

Ты чего? К следующему технологическому прорыву, конечно!


А, к этому… И что там у нас на очереди?

Читать дальше →

Обзор физики в играх Sonic. Части 7 и 8: пружины и штуковины, суперскорости

Reading time6 min
Reach and readers15K


Продолжение цикла статей о физике в играх про Соника. В этом посте рассматриваются отталкивания персонажей от различных игровых объектов и их суперспособности.
Читать дальше →

5 наиболее перспективных JavaScript фреймворков в 2016-м году

Reading time5 min
Reach and readers25K
В этой публикации сделаем обзор пяти наиболее интересных и перспективных JavaScript фреймворков первой половины 2016 года. В обзоре собраны вместе различные типы библиотек, которые предоставляют различный функционал — от создания UI компонентов к изоморфному JavaScript. Это не будет глубокий и детальный технический анализ, скорее это краткое введение в ключевые особенности.

Ниже список наших фреймворков:

Теперь, пришло время взглянуть на них поближе.
Читать дальше →

Чат на Go (часть 1)

Reading time4 min
Reach and readers44K

Начинаем разработку чата на Go. Со стеком технологий пока не определились, но для начала сделаем каркас на Go. Берем за основу стандартный пример и пробуем разобраться, что здесь к чему:


https://github.com/golang-samples/websocket/tree/master/websocket-chat


Структура


Вводим 3 структуры Message, Client, Server, которые определяют сервер, клиента со стороны сервера и сообщение.


Message


Сообщение определено структурой:


type Message struct {
    Author string `json:"author"`
    Body   string `json:"body"`
}

func (self *Message) String() string {
    return self.Author + " says " + self.Body
}

С сообщением все совсем просто… Так, что перейдем сразу к клиенту.

Читать дальше →

Переход от монолита к микросервисам

Reading time5 min
Reach and readers38K

Каждый более-менее успешный продукт приходит к состоянию, когда добавлять новые возможности в существующую кодовую базу становится тяжело настолько, что стоимость новой функциональности превосходит все возможные выгоды от ее использования. Конечно же, хороший и внимательный архитектор позаботится о приложении заранее и направит разработку в правильное русло. Самый популярный на данный момент подход подразумевает распиливание одного большого куска кода на много мелких проектиков, каждый из которых отвечает за свои определенные возможности. При проектировании такой системы нависает огромная ответственность. Нужно продумать и разработать такой тип взаимодействия между этими отдельно лежащими кусочками, чтобы будущие внесения изменений не требовали переписать все к чертям.


Понятное дело, в сети существует огромное количество экспертных статей, которые показывают нам важность такой архитектуры и рассказывают о том какую архитектуру можно назвать хорошей, а какую не очень. Существует огромное количество методов взаимодействия между отдельными програмками большого приложения со своими протоколами, версионированием протокола и документации, написания документации на программные интерфейсы, способа развертывания и синхронизации всего этого добра вместе. Безусловно, каждая такая статья или метод логичен и последователен и особенно, если описанный метод подтвержден практикой. Но беда не в том, что проектировщики не знают какую систему они хотят в итоге получить. Беда в том, как перейти к такой вот правильной архитектуре и когда же можно прекратить писать монолитное приложение и начать уже писать взрослые микросервисы, чтобы перед пацанами не было стыдно.

Читать дальше →

ДНК, новые технологии и геном человека: Биоинформатика в Университете ИТМО

Reading time7 min
Reach and readers11K


Биоинформатика – перспективная сфера науки и стремительно развивающаяся индустрия. Применение информационных технологий в биологических исследованиях сегодня позволяет тестировать лекарственные препараты в виртуальной среде и расшифровывать последовательности ДНК за считанные часы. В этом материале мы расскажем о биоинформатике и о том, какие разработки ведутся в этой сфере в Университете ИТМО.
Читать дальше →

Сколько нужно нейронов, чтобы распознать сводку моста?

Reading time4 min
Reach and readers40K

История началась, когда я переехал жить на остров Декабристов в Санкт-Петербурге. Ночью, когда мосты развели, этот остров вместе с Васильевским полностью изолирован от большой земли. Мосты при этом нередко сводят досрочно, иногда на час раньше опубликованного расписания, но оперативной информации об этом нигде нет.


После второго "опоздания" на мосты, я задумался об источниках информации о досрочной сводке мостов. Одним из пришедших в голову вариантов была информация с публичных веб-камер. Вооружившись этими данными и остаточными знаниями со специализации по ML от МФТИ и Яндекса, я решил попробовать решить задачу "в лоб".


0, Дворцовый
Картинки и кишочки под катом
1
23 ...

Information

Rating
Does not participate
Registered
Activity