Pull to refresh
44
Александр Пономарев@lamerman

User

7
Subscribers
Send message

Фильтр Калмана

Reading time10 min
Reach and readers503K


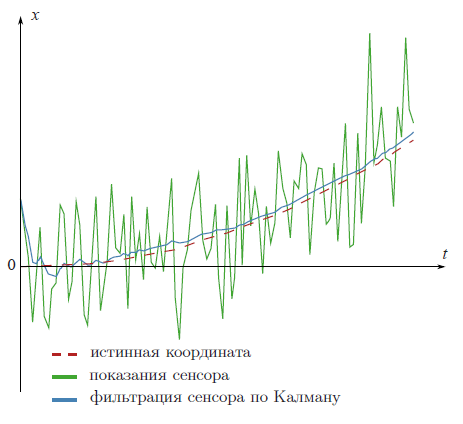
В интернете, в том числе и на хабре, можно найти много информации про фильтр Калмана. Но тяжело найти легкоперевариваемый вывод самих формул. Без вывода вся эта наука воспринимается как некое шаманство, формулы выглядят как безликий набор символов, а главное, многие простые утверждения, лежащие на поверхности теории, оказываются за пределами понимания. Целью этой статьи будет рассказать об этом фильтре на как можно более доступном языке.
Фильтр Калмана — это мощнейший инструмент фильтрации данных. Основной его принцип состоит в том, что при фильтрации используется информация о физике самого явления. Скажем, если вы фильтруете данные со спидометра машины, то инерционность машины дает вам право воспринимать слишком быстрые скачки скорости как ошибку измерения. Фильтр Калмана интересен тем, что в каком-то смысле, это самый лучший фильтр. Подробнее обсудим ниже, что конкретно означают слова «самый лучший». В конце статьи я покажу, что во многих случаях формулы можно до такой степени упростить, что от них почти ничего и не останется.
Читать дальше →

Список ресурсов по машинному обучению. Часть 2

Reading time11 min
Reach and readers49K


Продолжим (1, 2) рассматривать тему машинного обучения. Вашему вниманию вторая часть (первая тут) адаптированной подборки полезных материалов.
Читать дальше →

Краткая шпаргалка по tmux (менеджеру терминалов)

Reading time1 min
Reach and readers464K
tmux — это менеджер терминалов, к которому удобно подключаться и отключаться, не теряя при этом процессы и историю. Как screen, только лучше (в первую очередь потому, что использует модель клиент—сервер).

image

Вашему вниманию предлагается минималистическая шпаргалка, позволяющая быстро начать использовать tmux, а уж тонкую настройку, продвинутые команды и бесконечные хот-кеи желающие найдут, набрав man tmux.

Читать дальше →

Фильтр Маджвика

Reading time38 min
Reach and readers152K

Предисловие от переводчика


Здесь представлен один из новейших методов расчёта ориентации в пространстве по показаниям датчиков акселерометра, гироскопа и компаса — фильтр Маджвика, который, по словам автора, даёт результат лучший, чем применение фильтра на основе метода Калмана в результатах и производительности. Автор — Себастьян Маджвик (его интернет-магазин). Метод описан в статье на английском. Данная работа защищена в Университете г. Бристоля Перевода я не нашёл. Переводчик из меня так себе, особенно таких сложных текстов. Но нам же интересно, что за метод?

Кое-где буду от себя добавлять — там текст выделен курсивом. Мною найдено более 10 опечаток в оригинальном тексте. Вообще было довольно трудно, поэтому помощь приветствуется — пишите в комментариях, где перефразировать нужно, в общем, где что не так.


Читать дальше →

Внезапный диван леопардовой расцветки

Reading time8 min
Reach and readers84K
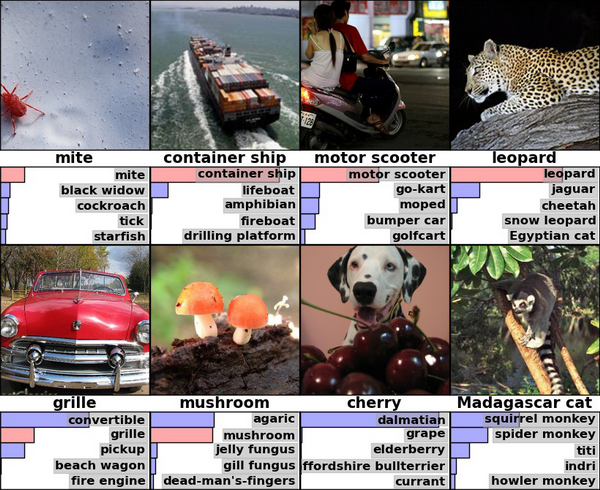
Если вы интересуетесь искусственным интеллектом и прочим распознаванием, то наверняка уже видели эту картинку:


А если не видели, то это результаты Хинтона и Крижевского по классификации ImageNet-2010 глубокой сверточной сетью

Давайте взглянем на ее правый угол, где алгоритм опознал леопарда с достаточной уверенностью, разместив с большим отрывом на втором и третьем месте ягуара и гепарда.

Это вообще довольно любопытный результат, если задуматься. Потому что… скажем, вы знаете, как отличить одного большого пятнистого котика от другого большого пятнистого котика? Я, например, нет. Наверняка есть какие-то зоологические, достаточно тонкие различия, типа общей стройности/массивности и пропорций тела, но мы же все-таки говорим о компьютерном алгоритме, которые до сих пор допускают какие-то вот такие достаточно глупые с человеческой точки зрения ошибки. Как он это делает, черт возьми? Может, тут что-то связанное с контекстом и фоном (леопарда вероятнее обнаружить на дереве или в кустах, а гепарда в саванне)? В общем, когда я впервые задумался над конкретно этим результатом, мне показалось, что это очень круто и мощно, разумные машины где-то за углом и поджидают нас, да здравствует deep learning и все такое.

Так вот, на самом деле все совершенно не так.
под катом пятна

Сравнение библиотек глубокого обучения на примере задачи классификации рукописных цифр

Reading time21 min
Reach and readers54K
Кручинин Дмитрий, Долотов Евгений, Кустикова Валентина, Дружков Павел, Корняков Кирилл

Введение


В настоящее время машинное обучение является активно развивающейся областью научных исследований. Это связано как с возможностью быстрее, выше, сильнее, проще и дешевле собирать и обрабатывать данные, так и с развитием методов выявления из этих данных законов, по которым протекают физические, биологические, экономические и другие процессы. В некоторых задачах, когда такой закон определить достаточно сложно, используют глубокое обучение.

Глубокое обучение (deep learning) рассматривает методы моделирования высокоуровневых абстракций в данных с помощью множества последовательных нелинейных трансформаций, которые, как правило, представляются в виде искусственных нейронных сетей. На сегодняшний день нейросети успешно используются для решения таких задач, как прогнозирование, распознавание образов, сжатие данных и ряда других.
Читать дальше →

Google Play — работаем легально!

Reading time4 min
Reach and readers180K
Привет, Хабр!


Сегодня, я хочу рассказать о том как сделать свое хобби по разработке Android-приложений пусть небольшим, но официальным бизнесом. О том, как легально получать деньги, заработанные на Google Play, о «страшном» валютном контроле и «таинственном» паспорте сделки.
Читать дальше →

Модель Random Forest для классификации, реализация на c#

Reading time18 min
Reach and readers52K
Доброго времени суток, читатель. Random Forest сегодня является одним из популярнейших и крайне эффективных методов решения задач машинного обучения, таких как классификация и регрессия. По эффективности он конкурирует с машинами опорных векторов, нейронными сетями и бустингом, хотя конечно не лишен своих недостатков. С виду алгоритм обучения крайне прост (в сравнении скажем с алгоритмом обучения машины опорных векторов, кому мало острых ощущений в жизни, крайне советую заняться этим на досуге). Мы же попробуем в доступной форме разобраться в основных идеях, заложенных в Random Forest (бинарное дерево решений, бутстреп аггрегирование или бэггинг, метод случайных подпространств и декорреляция) и понять почему все это вместе работает. Модель относительно своих конкурентов довольно таки молодая: началось все со статьи 1997 года в которой авторы предлагали способ построения одного дерева решений, используя метод случайных подпространств признаков при создании новых узлов дерева; затем был ряд статей, который завершился публикацией каноничной версии алгоритма в 2001 году, в котором строится ансамбль решающих деревьев на основе бутстреп агрегирования, или бэггинга. В конце будет приведен простой, совсем не шустрый, но крайне наглядный способ реализации этой модели на c#, а так же проведен ряд тестов. Кстати на фотке справа вы можете наблюдать настоящий случайный лес который произрастает у нас тут в Калининградской области на Куршской косе.

Читать дальше →

Энтропия и деревья принятия решений

Reading time8 min
Reach and readers125K
Деревья принятия решений являются удобным инструментом в тех случаях, когда требуется не просто классифицировать данные, но ещё и объяснить почему тот или иной объект отнесён к какому-либо классу.

Давайте сначала, для полноты картины, рассмотрим природу энтропии и некоторые её свойства. Затем, на простом примере, увидим каким образом использование энтропии помогает при создании классификаторов. После чего, в общих чертах сформулируем алгоритм построения дерева принятия решений и его особенности.
Читать дальше →

Information

Rating
Does not participate
Works in
Registered
Activity