Pull to refresh
-6

Пользователь

Send message

Я спарсил 62 000 Python-вакансий с hh.ru и узнал страшное

Reading time11 min
Reach and readers56K

Привет, Хабр! (И тебе, HR, который ставит в вакансию «Python, SQL, Linux, Docker, K8s, Spark, Airflow, английский C1, опыт 1-3 года, зарплата 40-60К». Особенно тебе.)

Сегодня будем препарировать рынок Python-разработки в России. По-настоящему. С графиками, цифрами и верой в светлое будущее.

Здесь будет всё, зарплаты, актуальные стеки и то что уже никому не нужно, прогнозы, тренды, и многое другое, будет интересно...

Поехали.

Читать далее

Андрей Карпаты: искусственный интеллект отнимает у людей способность выбирать

Reading time1 min
Reach and readers9.8K

Один из самых влиятельных инженеров мира AI, Андрей Карпаты, в новом интервью высказал тревожную мысль: мы живём в эпоху, когда технологии постепенно лишают человечество самой способности принимать решения. По его словам, современные языковые модели не учатся как люди. Они не думают, а лишь копируют поведение, подстраиваясь под ожидания.

Карпаты скептически оценивает обучение с подкреплением (reinforcement learning), на котором построено большинство крупных моделей.

Читать далее

Big Data от A до Я. Часть 5.1: Hive — SQL-движок над MapReduce

Reading time9 min
Reach and readers108K
Привет, Хабр! Мы продолжаем наш цикл статьей, посвященный инструментам и методам анализа данных. Следующие 2 статьи нашего цикла будут посвящены Hive — инструменту для любителей SQL. В предыдущих статьях мы рассматривали парадигму MapReduce, и приемы и стратегии работы с ней. Возможно многим читателям некоторые решения задач при помощи MapReduce показались несколько громоздкими. Действительно, спустя почти 50 лет после изобретения SQL,  кажется довольно странным писать больше одной строчки кода для решения задач вроде «посчитай мне сумму транзакций в разбивке по регионам».

С другой стороны, классические СУБД, такие как Postgres, MySQL или Oracle не имеют такой гибкости в масштабировании при обработке больших массивов данных и при достижении объема большего дальнейшая поддержка становится большой головоной болью.


Собственно, Apache Hive был придуман для того чтобы объединить два этих достоинства:

  • Масштабируемость MapReduce
  • Удобство использования SQL для выборок из данных.

Под катом мы расскажем каким образом это достигается, каким образом начать работать с Hive, и какие есть ограничения на его применения.
Читать дальше →

Трекеры от Google встроены в ряд официальных российских электронных ресурсов

Reading time6 min
Reach and readers19K

image


Google не то, чем кажется
Дж. Ассанж


Предваряю текст цитатой небезызвестного товарища Дж.Ассанжа, издавшего в свое время книгу «When Google Met WikiLeaks» в которой описываются некоторые факты и особенности тесного взаимодействия этой компании с правительством/спецслужбами США.


В статье проведен экспресс-анализ ряда официальных российских ресурсов на наличие сторонних зарубежных трекеров, с учетом того, что в современном мире некоторым ресурсам негоже пользоваться программным обеспечением, способным «выуживать» информацию о россиянах-пользователях и особенностях их поведения и априори передавать их на «заграничные» сервера.

Читать дальше →

Мониторинг и Kubernetes (обзор и видео доклада)

Reading time10 min
Reach and readers35K
28 мая на проходившей в рамках фестиваля РИТ++ 2018 конференции RootConf 2018, в секции «Логирование и мониторинг», прозвучал доклад «Мониторинг и Kubernetes». В нём рассказывается об опыте настройки мониторинга с Prometheus, который был получен компанией «Флант» в результате эксплуатации десятков проектов на Kubernetes в production.


По традиции рады представить видео с докладом (около часа, гораздо информативнее статьи) и основную выжимку в текстовом виде. Поехали!

Эффективное изменение размера картинок при помощи ImageMagick

Reading time12 min
Reach and readers93K
В наше время всё чаще сайты сталкиваются с необходимостью введения отзывчивого дизайна и отзывчивых картинок – а в связи с этим есть необходимость эффективного изменения размера всех картинок. Система должна работать так, чтобы каждому пользователю по запросу отправлялась картинка нужного размера – маленькие для пользователей с небольшими экранами, большие – для больших экранов.

Веб таким образом работает отлично, но для доставки картинок разных размеров разным пользователям необходимо все эти картинки сначала создать.

Множество инструментов занимается изменением размера, но слишком часто они выдают большие файлы, аннулирующие выигрыш в быстродействии, который должен приходить вместе с отзывчивыми картинками. Давайте рассмотрим, как при помощи ImageMagick, инструмента командной строки, быстренько изменять размеры картинок, сохраняя превосходное качество и получая файлы небольших объёмов.

Большие картинки == большие проблемы


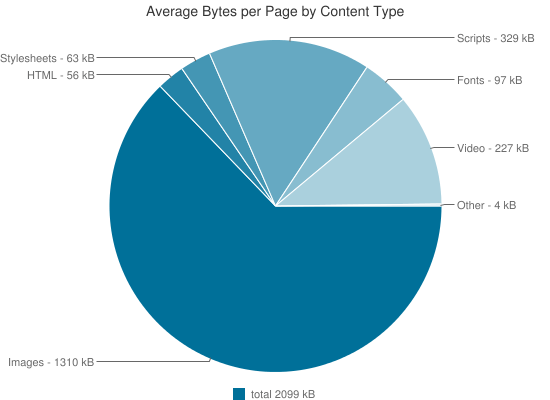
Средняя веб-страница весит 2 Мб, из них 2/3 – картинки. Миллионы людей ходят в интернет через 3G, или ещё хуже. 2Мб-сайты в этих случаях работают ужасно. Даже на быстром соединении такие сайты могут израсходовать лимиты трафика. Работа веб-дизайнеров и разработчиков – упростить и улучшить жизнь пользователя.
image

Очень маленькие сайты могут просто сохранить несколько вариантов всех картинок. Но что, если у вас их дофига? Например, в магазине может быть сотня тысяч картинок – не делать же их варианты вручную.

ImageMagick


Утилита командной строки с 25-летним стажем в то же время является редактором картинок с полным набором функций. В ней огромная куча функций, и среди них – быстрое и автоматическое изменение размера картинок. Но с настройками по умолчанию файлы часто получаются излишне большими – иногда по объёму больше оригинала, хотя в них и меньше пикселей. Сейчас я объясню, в чём проблема, и покажу, какие настройки необходимы для её решения.
Читать дальше →

Изучаем многопоточное программирование в Go по картинкам

Reading time8 min
Reach and readers86K

Скорее всего, вы уже слышали о языке программирования Go, популярность его постоянно растет, что вполне обоснованно. Этот язык простой, быстрый и опирается на прекрасное сообщество. Один из самых любопытных аспектов языка — это модель многопоточного программирования. Примитивы, положенные в ее основу, позволяют создавать многопоточные программы легко и просто. Эта статья предназначена для тех, кто хочет изучить эти примитивы: горутины и каналы. И, через иллюстрации, я покажу, как с ними работать. Надеюсь, это будет для вас хорошим подспорьем в дальнейшем изучении.
Читать дальше →

Как собрать бинарный deb пакет: подробное HowTo

Reading time15 min
Reach and readers248K
Сегодня я расскажу на абстрактном примере как правильно создать *.deb пакет для Ubuntu/Debian. Пакет мы будем делать бинарный. Пакеты, компилирующие бинарники из исходников здесь не рассматриваются: осилив изложенные ниже знания, в дальнейшем по готовым примерам можно понять суть и действовать по аналогии :)

В статье не будет никакой лишней возни «вручную»: формат пакета эволюционировал в достаточно простую, а главное — логичную структуру, и всё делается буквально на коленке, с применением пары специализированных утилит.

В качестве бонуса в конце статьи будет пример быстрого создания собственного локального репозитория: установка пакетов из репозитория позволяет автоматически отслеживать зависимости, и конечно же! — устанавливать всё одной консольной командой на нескольких машинах :)

Для тех, кто не хочет вдаваться в мощную систему установки софта в Linux, рекомендую посетить сайт проги CheckInstall: она автоматически создаёт deb-пакет из команды «make install» ;) А мы вместе с любопытными —
поехали дальше!

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Date of birth
Registered
Activity

Specialization

Бэкенд разработчик
Python
Linux
Golang