Pull to refresh
9
Сергей@yoda_code

Fullstack разработчик

2
Subscribers
Send message

Как работает DNS в Linux. Часть 3:  Разбираемся с resolv.conf, systemd-resolved, NetworkManager и другими

Level of difficultyMedium
Reading time15 min
Reach and readers66K

Теоретическую основу кэширования DNS в Linux мы разбирали в первой части, где говорили про работу процесса разрешения имен — от вызова getaddrinfo() до получения IP-адреса. Вторая часть была посвящена различным уровням кэшей самой системы, приложений и языков программирования, контейнеров, прокси - а также их мониторингу и сбросу. Теперь самое время перейти к практике.

Если вы когда-либо запускали подряд команды ping, curl, dig и получали разные IP-адреса, вы не одиноки. Поведение DNS в Linux — не просто вызов getaddrinfo(). Это взаимодействие множества слоёв: от glibc и NSS до NetworkManager, systemd-resolved, dnsmasq и облачных конфигураций. В этой части разберем практические аспекты DNS:

почему одинаковые запросы дают разные IP

как реально контролируется разрешение имен: что вызывает кого и зачем

как проводить диагностику: strace, resolvectl, tcpdump

Читать далее

Генерация кода валидации из спецификации OpenAPI: как мы синхронизировали валидаторы данных между бэкендом и фронтендом

Level of difficultyMedium
Reading time8 min
Reach and readers5K

Представьте ситуацию: ваша команда закончила интеграцию с API, все протестировала и подготовила релиз. А тут внезапно серверная команда меняет формат ответа. Фронтенд падает, QA злится, пользователи недовольны. Приходится вручную переписывать валидации, искать баги и терять дни, чтобы всё починить. 

Как автоматически синхронизировать работу между бэкэндом и фронтендом? А между дизайном и фронтендом? Использовать генератор кода валидации! Написание своего решения поможет понять бизнес-логику проекта и создать валидаторы, которые максимально отвечают вашим требованиям. А реализация проще, чем кажется на первый взгляд – покажу это в статье на примере создания кастомного генератора на нашем проекте. 

В первую очередь статья будет полезна фронтенд-разработчикам и командам, работающим над сложными веб-приложениями, особенно тем, кто активно взаимодействует с API, описанными через OpenAPI. 

Читать далее

Проект Natasha. Набор качественных открытых инструментов для обработки естественного русского языка (NLP)

Reading time34 min
Reach and readers128K
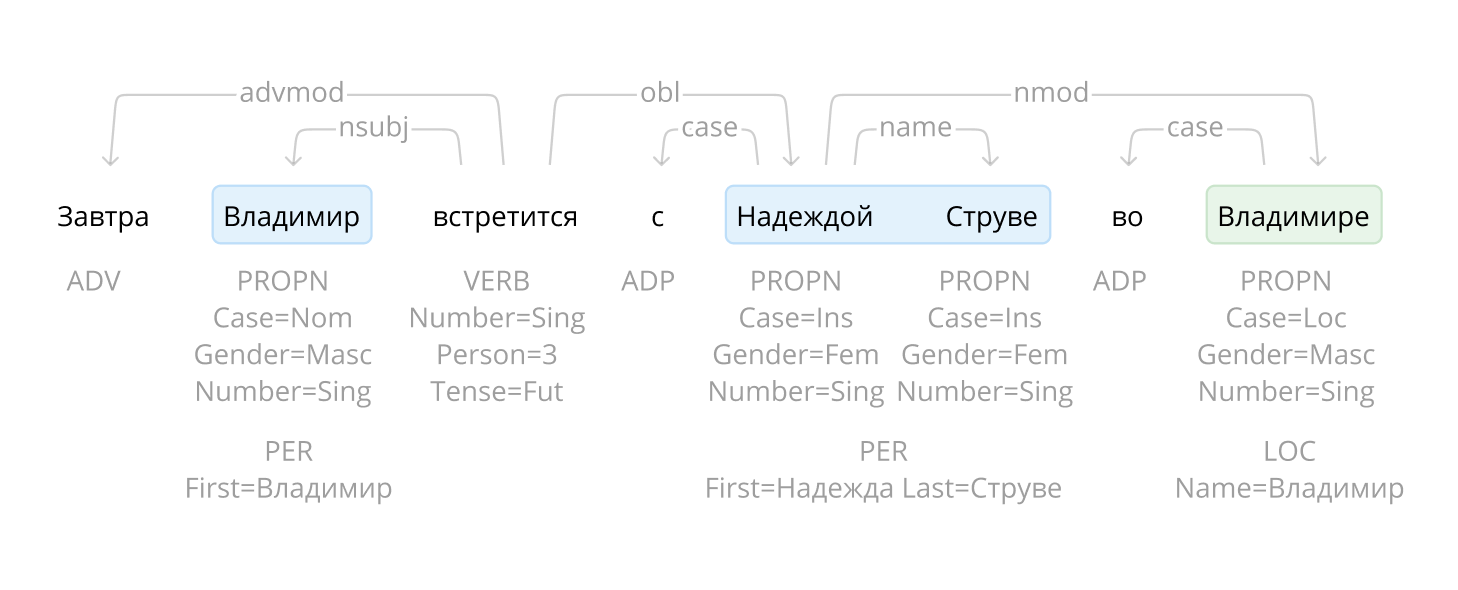
Два года назад я писал на Хабр статью про Yargy-парсер и библиотеку Natasha, рассказывал про решение задачи NER для русского языка, построенное на правилах. Проект хорошо приняли. Yargy-парсер заменил яндексовый Томита-парсер в крупных проектах внутри Сбера, Интерфакса и РИА Новостей. Библиотека Natasha сейчас встроена в образовательные программы ВШЭ, МФТИ и МГУ.

Проект подрос, библиотека теперь решает все базовые задачи обработки естественного русского языка: сегментация на токены и предложения, морфологический и синтаксический анализ, лемматизация, извлечение именованных сущностей.

Для новостных статей качество на всех задачах сравнимо или превосходит существующие решения. Например с задачей NER Natasha справляется на 1 процентный пункт хуже, чем Deeppavlov BERT NER (F1 PER 0.97, LOC 0.91, ORG 0.85), модель весит в 75 раз меньше (27МБ), работает на CPU в 2 раза быстрее (25 статей/сек), чем BERT NER на GPU.

В проекте 9 репозиториев, библиотека Natasha объединяет их под одним интерфейсом. В статье поговорим про новые инструменты, сравним их с существующими решениями: Deeppavlov, SpaCy, UDPipe.

Как AMD выкрутилась и научилась воспроизводить операции ядер CUDA на своих видеокартах. История ROCm

Level of difficultyMedium
Reading time8 min
Reach and readers92K

Как AMD смогла обойти монополию NVIDIA в мире ИИ? История о том, как команда AMD создала ROCm — технологию, позволяющую запускать CUDA-приложения на своих видеокартах. Как компании удалось совершить этот технологический прорыв? Разберём путь от первых экспериментов с HSA до современных версий ROCm, поддерживающих самые популярные фреймворки для машинного обучения. А главное — в конце расскажу, как установить ROCm на Windows и Linux, избежав всех подводных камней.
Читать дальше →

Laravel: электронная подпись на сервере с PDF визуализацией

Level of difficultyEasy
Reading time8 min
Reach and readers8.1K

Сегодня я хочу поделиться с вами решением, которое позволит вам реализовать подписание PDF-документов электронной подписью и их визуализацию прямо на вашем Laravel сервере.

Читать далее

CryptoProBuilder — fluent-интерфейс для КриптоПро на PHP: подпись, шифрование и работа с контейнерами

Level of difficultyEasy
Reading time7 min
Reach and readers4.1K

КриптоПро предоставляет мощные, но неудобные для автоматизации утилиты. CryptoProBuilder — это fluent-интерфейс на PHP, который упрощает подписание, шифрование и работу с сертификатами, без необходимости использовать сложный SDK.

Читать далее

Fluent CLI в PHP: Создаём консольные команды с __call и никаких танцев с бубном

Level of difficultyMedium
Reading time5 min
Reach and readers2.6K

PhpFluentConsole — библиотека для лаконичного выполнения системных команд в PHP, с поддержкой кодировок, обработкой вывода и гибкой архитектурой. В статье — примеры, код и реальные кейсы.

Читать далее

Использование ECMAScript-модулей в Node.js

Reading time6 min
Reach and readers30K
ECMAScript-модули (кратко их называют ES-модулями) — это модули, формат которых описан в стандарте ECMAScript, при работе с которыми используются инструкции import и export:

// ECMAScript-модуль

// инструкция import
import myFunc from './my-func';

//инструкция export
export myOtherFunc(param) {
  const result = myFunc(param);
  // ....
  return otherResult;
}

В Node.js, начиная с версии 13.2.0, имеется стабильная поддержка ES-модулей.


Этот материал посвящён особенностям работы с ES-модулями в Node.js.
Читать дальше →

Способы синхронизации вкладок браузера

Reading time5 min
Reach and readers41K


Давным-давно в далёкой галактике появилась задача по синхронизации вкладок браузера для веб-плеера, наподобие VK: нужно было организовать обмен данными между вкладками, отслеживать их количество и назначать задачи некоторым из них. Всю реализацию нужно было выполнить на клиенте. Информации собрано много, и набралось на целую статью.

Ниже опишу различные способы решения подобных задач.
Читать дальше →

EditorConfig — Одни Настройки для всех Редакторов/IDE

Reading time7 min
Reach and readers114K
EditorConfig это конфигурационный файл и набор расширений, к большому количеству редакторов кода и IDE (Далее просто IDE).

Его задача — создать единый формат настроек, и, раз и навсегда, решить вопросы вроде “табы или пробелы” для всех IDE и всех языков программирования. Такой файл может храниться в системе контроля версий проекта, что позволит всем его разработчикам использовать одну и ту же конфигурацию.

Файлы .editorconfig можно найти в таких проектах, как jQuery, Ruby, WordPress, и многих других.

Плагины доступны для большого количество IDE


Давайте разберемся, как это работает.
Читать дальше →

Перестаньте использовать DateTime

Reading time4 min
Reach and readers32K
Специально для студентов курса «Backend разработчик на PHP» подготовили перевод интересной статьи о сайд-эффекте популярного инструмента.


Работа с датами и временем в PHP порой раздражает, поскольку приводит к неожиданным багам в коде:

$startedAt = new DateTime('2019-06-30 10:00:00');

$finishedAt = $startedAt->add(new DateInterval('PT3M')); 

var_dump($startedAt->format('Y-m-d H:i:s')); //2019-06-30 10:03:00 
var_dump($finishedAt->format('Y-m-d H:i:s')); //2019-06-30 10:03:00 

Обе функции $startdate и $finishdate спешат на три минуты, потому как такие методы, как add (), sub() или modify() также изменяют объект DateTime, для которого они вызываются, прежде чем вернуть его. В приведенном выше примере, конечно же, показано нежелательное поведение.

Мы можем исправить эту ошибку, скопировав объект, на который происходит ссылка, прежде чем взаимодействовать с ним, например:
Читать дальше →

Форки движка MySQL: MariaDB, Percona. who is who?

Reading time3 min
Reach and readers92K
MySQL стал собственностью Oracle, есть ли альтернативы и как быстро движение вперед?.. Вроде как обобщающего обзорчика «who is who?» еще не было. Итак, обзорчик для тех кто «не в теме»
Читать дальше →

Кулинарный гид по Vue.js: всё о props

Level of difficultyMedium
Reading time21 min
Reach and readers31K

Привет, Хабр! В этой статье разберемся, как frontend-разработчику готовить на «кухне» props. Выбирайте подходящий уровень сложности: джуны-поварята смогут лучше разобраться в работе и применении props на фреймворке Vue.js, а еще мы затронем тему валидации. Для мидлов и более опытных специалистов — настоящих шеф-поваров мы приготовили продвинутые кулинарные техники props, где можно освежить в памяти некоторые детали или решить проектную проблему, если замылился глаз. 

Props – от слова «properties» (здесь и дальше будем использовать слово «props») – это специальные атрибуты, используемые в экосистеме Vue для передачи данных в компоненты. Они являются частью системы реактивности, позволяют определять типы данных и проводить с ними валидацию.

По большей части мы будем покрывать основы передачи props. Поэтому статья будет актуальна как для Vue 2, так и для Vue 3, поскольку по части объявления props отличий мало. Но так как в Composition API и TypeScript все же они есть, то мы рассмотрим их тоже.

Если вы подходите под все эти условия, то добро пожаловать, мы начинаем наш кулинарный гайд! Bon appétit!

Читать далее

Партиционирование таблиц в mySQL

Reading time4 min
Reach and readers197K
Начиная с версии 5.1 mySQL поддерживает горизонтальное партицирование таблиц. Что это такое? Партиционирование (partitioning) — это разбиение больших таблиц на логические части по выбранным критериям.. На нижнем уровне для myISAM таблиц, это физически разные файлы, по 3 на каждую партицию (описание таблицы, файл индексов, файл данных). Для innoDB таблиц в конфигурации по умолчанию – разные пространства таблиц в файлах innoDB (не забываем, что innoDB позволяет настраивать индивидуальные хранилища на уровне баз данных или даже конкретных таблиц).

Как это выглядит?

Читать дальше →

Читаем EXPLAIN на максималках

Reading time19 min
Reach and readers100K

Многим, кто работает с MySQL, известно, что команда EXPLAIN используется для оптимизации запросов, получения информации об использованных и возможных индексах. Большинство разработчиков и администраторов СУБД этой информацией и ограничивается. Я же предлагаю изучить команду EXPLAIN максимально подробно.

Читать далее

Волшебный кэширующий декоратор

Reading time3 min
Reach and readers5K
Сейчас работаю над доработкой/переписыванием проекта, который был написан, ну скажем так, «не совсем грамотно». По ходу есть задача оптимизировать работу, т.к. код изначально был написан крайне неоптимально. Среди работ по оптимизации прикручивается кэш.

В проекте есть несколько разных источников данных, результаты работы которых хорошо было бы кэшировать, основной — конечно БД. Хотелось решения прозрачного, с минимальной кровью. В один прекрасный момент надоедает писать конструкции вида

$query = "Select something";
$result = $cache->get($query, $tag);
if (!$result) {
    $result = $db->queryAll($query);
    $cache->set($query, $tag);
}

И хочется чего-то другого. Конечно, код можно вынести в отдельную функцию или метод, но это как-то скучно и к тому же, для каждого разного вызова (а там есть не только $db->queryAll, а несколько разных вариантов) нужен будет свой код и своя функция/метод.

С другой стороны, добавлять код кэширования непосредственно в источники данных тоже не очень правильно — в конце концов, они этим не должны заниматься (именно поэтому Трейты тоже не подходят). Создавать отдельный класс кэша тоже не очень удобно.

В общем, хотелось единого, универсального решения, которое бы подошло для разных источников данных, с разными интерфейсами, но в то же время было единообразным. Было решено сделать «волшебный» декоратор.

Читать дальше →

Когда код становится legacy и как с ним жить

Reading time17 min
Reach and readers21K
Много лет назад, я пришел в один legacy-проект, который разрабатывал Владимир Филонов (pyhoster). Так я и познакомился с одним из организаторов MoscowPython, любителем копаться во внутренностях библиотек, а потом рассказывать об этом. Иронично, что теперь он собирается рассказывать, как выжить, если вам достался legacy. Это еще раз доказывает, что legacy порождают даже те, кто потом учит, как с этим жить. Мне очень хочется расспросить Владимира о том, что такое legacy, как им поменьше зарастать, как бороться, когда уже по уши в legacy, а когда всё бросать и писать заново (спойлер: никогда).

Но сперва посмотрите ролик, чтобы прочувствовать всю боль погружения в legacy…

Docker — это игрушка или нет? Или всё-таки да?

Reading time7 min
Reach and readers54K

Всем привет!


Ооочень хочется прям сразу приступить к теме, но правильнее будет немного рассказать про мою историю:


Вступление


Я программист с опытом разработки frontend одностраничных приложений, scala/java и nodejs на сервере.


Довольно долго (уже точно пару — тройку лет), я придерживался мнения, что docker это манна небесная и вообще очень крутой инструмент и абсолютно каждый разработчик должен уметь пользоваться им. А отсюда вытекает, что и у каждого разработчика должен стоять docker на локальной машине. Да что там про моё мнение, вы полистайте вакансии, которые размещаются на том же hh. В каждой второй есть упоминание про docker и если вы им владеете — это будет вашим конкурентным преимуществом ;)


На своем пути я встечался с многими людьми, с их разным отношением к docker и к его экосистеме. Одни говорили, что это удобная вещь, гарантирующая кроссплатформенность. Вторые не понимали зачем им запускаться в контейнерах и какой профит от этого, третьим было вообще пофиг и они не парились (просто писали код и уходили домой — завидую, кстати, им :) )

Читать дальше →

Правильная работа с датой и временем

Reading time12 min
Reach and readers166K
Практически все проекты сталкиваются с проблемами, вызванными неправильной обработкой и хранением даты и времени. Даже если проект используется в одном часовом поясе, все равно после перехода на зимнее/летнее время можно получить неприятные неожиданности. При этом мало кто озадачивается реализацией правильного механизма со старта, потому что кажется, что с этим проблем быть не может, так как все тривиально. К сожалению, в последствии реальность показывает, что это не так.
Читать дальше →

Шифрование личных заметок

Reading time8 min
Reach and readers18K


Персональная информация, в том числе пароли и кошельки — это главные секреты каждого человека. Эта информация должна быть максимально зашифрована и надёжно храниться. Раньше проблему решал текстовый файл, где хранились и пароли, и заметки, и который легко было зашифровать. Теперь с появлением кучи устройств проблема усложнилась. Но если с паролями проблема решена благодаря парольным менеджерам, то вот с шифрованием заметок не всё так гладко.

Какой вариант выбрать для безопасного и надёжного шифрования личных заметок, с синхронизацией между устройствами и резервным хранением?
Читать дальше →

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Date of birth
Registered
Activity

Specialization

Бэкенд разработчик, Фулстек разработчик
From 200,000 ₽