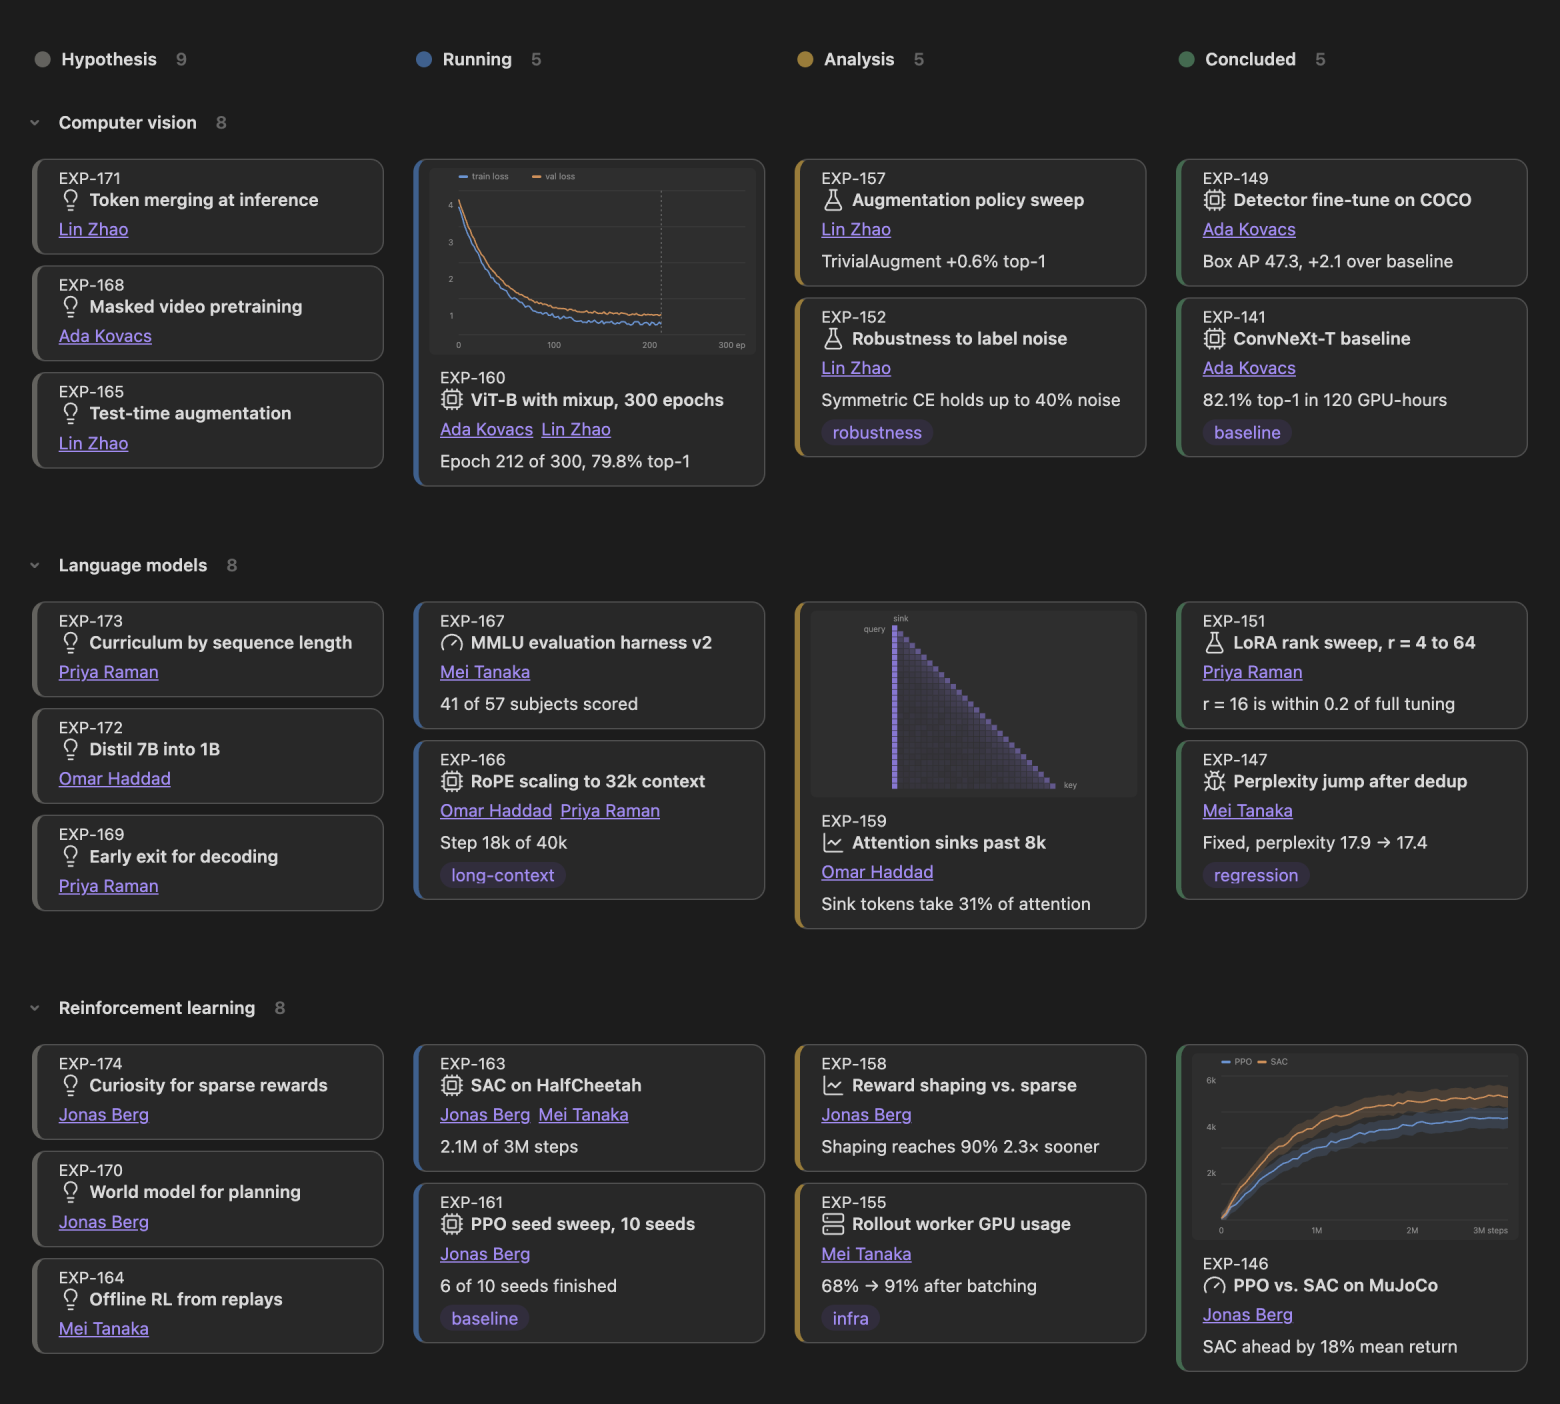
Недавно в Obsidian появился встроенный канбан для Bases, но мой плагин лучше :)
На скриншоте пример доски с исследовательскими экспериментами. Колонки соответствуют стадиям работы, строки разделяют эксперименты по направлениям. Таким же образом можно разложить свои проекты по статусам и областям деятельности.
Основное удобство в том, что заметки можно перемещать между колонками и строками, сразу меняя их свойства. Эдакая очень структурированная доска.
Из основных возможностей:
обложки, иконки и цвета
заголовки колонок и подгрупп остаются видны при прокрутке
несколько размеров карточек
копируемые по клику ID, чтобы скармливать их агентам
отдельные шаблоны новых заметок для каждой доски
В моём хранилище плагин используется почти во всех базах, но больше всего помогает в работе с проектными задачами.
Забавный факт. Изначально это был форк другого плагина. Я отправил автору 6 пулл-реквестов, чтобы исправить ошибки и добавить новые возможности. Но, как это нередко случается, автор забросил плагин.
Решил, что грех такому сокровищу пропадать, и продолжил развивать его как отдельный плагин.
Плагин доступен в Community store по названию Bases Board.
В консоли появится «Первый», хотя в поле уже «Второй».
React здесь успел обновить состояние. Но при каждом рендере функция компонента вызывается заново — со своим значением text и новыми обработчиками. Колбэк уже запущенного таймера сохраняет через замыкание доступ к text из предыдущего рендера.
Новый рендер обновит поле на экране, но не заменит колбэк внутри этого таймера.
А какое значение нам нужно?
Если пользователь зафиксировал текст для отложенной отправки, значение на момент клика может быть правильным. Последующие правки не обязательно должны менять уже запланированное сообщение.
Если же нужно прочитать последнее введённое значение на момент срабатывания таймера, один из вариантов — useRef.
Теперь колбэк обращается к объекту ref, который сохраняется между рендерами, и читает его текущее свойство current.
Сам ref за состоянием не следит: в этом примере мы обновляем его при вводе. text по-прежнему нужен для отображения значения в поле — изменение ref.current не вызывает рендер.
Получается, «старое значение» не всегда означает ошибку. Сначала стоит определить, что должно использовать отложенное действие: текст на момент клика или текст на момент выполнения.
Поделитесь, должны ли последующие правки в вашей форме «Отправить позже» менять уже запланированное сообщение?
Пора бы уже рассказать о своих новых плагинах для Obsidian. Начну с любимого Tabbed.
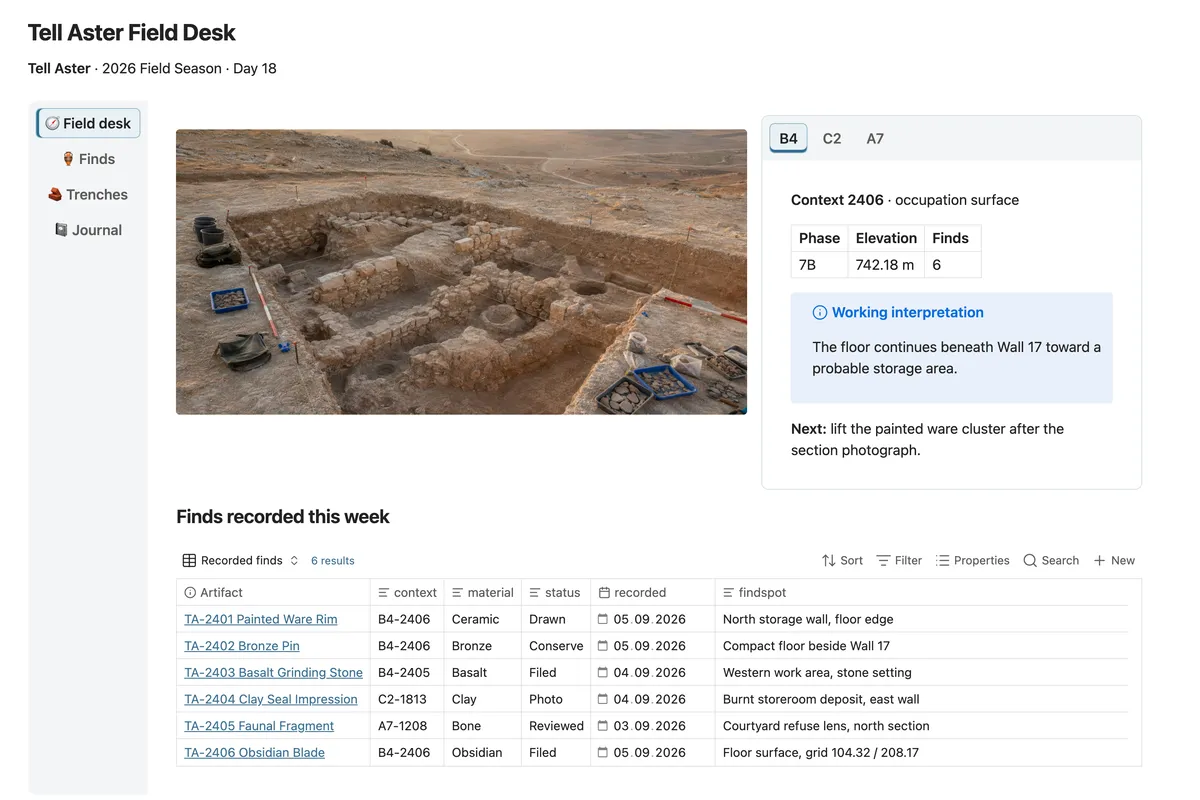
Основная его мощь в том, что он позволяет уплотнить информацию внутри одной заметки с помощью вкладок. Это очень помогает, когда нужно на одном экране сразу разместить и задачи, и детали, и заметки, и оглавление.
На скриншоте вымышленная археологическая экспедиция. Обратите внимание на то, как можно интересно скомпоновать контент внутри заметки с помощью вкладок и колонок.
Работает это просто. Делаете блок кода и помещаете внутрь контент:
Особое внимание я уделил производительности. Cодержимое вкладки загружается при открытии и выгружается, когда вы переключаетесь на другую. Это особенно полезно для сложных Dataview-запросов и таблиц Bases.
Устанавливается из Community plugins по названию Tabbed.
Сам я очень интенсивно использую Tabbed в Abyss Vault. Кто пользуется хранилищем, уже видел, сколько всего можно собрать на одной странице :)
React 19: почему return { error } не предотвращает очистку формы
Форма показывает ошибку сохранения, но введённый текст уже исчез. Такое возможно при использовании функции в action: после её нормального завершения React сбрасывает неконтролируемые поля.
Минимальный пример без сервера — обработчик намеренно всегда возвращает ошибку:
Введите текст и отправьте форму. Сообщение об ошибке появится, а поле вернётся к пустому defaultValue. Функция завершилась без исключения; свойство error для React — обычные данные, а не указание сохранить содержимое формы.
Один из способов оставить текст для исправления — контролируемое поле с value и onChange. Его состояние можно очищать только после подтверждённого сохранения. Наличие state.error само по себе значениями полей не управляет.
Бросать исключение только ради предотвращения сброса — другая крайность: оно передаёт обработку ближайшему Error Boundary и не заменяет управление черновиком. Показать ошибку — только половина задачи. Пользователь должен получить возможность исправить уже написанное, поэтому поведение полей при отказе стоит проверять отдельно от сообщения об ошибке.
Итак, вопрос: в ваших тестах формы проверяется, что введённый текст остаётся на месте после неудачного сохранения?
Удалили строку в React, а её заметка осталась у другого пользователя
Представим: в списке два человека, у каждого поле для заметки. Вводим «Позвонить вечером» рядом с Анной, удаляем Анну — и видим ту же заметку у Бориса.
Данные людей не перепутаны. Проблема в том, как React сопоставляет строки между рендерами.
Вот компонент, в котором ошибку можно воспроизвести:
До удаления ключ 0 принадлежит строке Анны. После удаления ключ 0 получает строка Бориса. Для React это тот же компонент на прежнем месте с тем же ключом, поэтому его состояние note сохраняется. При этом person уже содержит Бориса.
Теперь у Бориса остаётся собственный ключ boris. При удалении Анны её компонент размонтируется, а состояние строки Бориса сохранится.
Ключ должен быть стабильным для одной записи и уникальным среди соседних элементов. Случайный ключ на каждом рендере тоже создаёт проблему: React будет пересоздавать компоненты, сбрасывая их состояние. Индекс не приводит к ошибке в любом списке, но для списка с удалением, вставкой или перестановкой записей он не сохраняет связь состояния с записью.
Проверить исправление можно в обе стороны: заметка Анны исчезает вместе с Анной, а заметка Бориса остаётся у Бориса после удаления предыдущей строки. Затем стоит повторить проверку с сортировкой списка.
Есть и отдельное ограничение: правильный key не хранит черновик после размонтирования. Если фильтр скрывает Бориса, удаляя его Row из дерева, при возвращении строки локальная заметка начнётся заново. Для сохранения таких черновиков состояние нужно поднять выше и хранить по person.id.
Если при сортировке или удалении элементы будто обмениваются введёнными значениями, стоит проверить ключи до того, как искать ошибку в обработчиках формы.
Таймер работы и отдыха кажется простой задачей, пока не начинаешь хранить его состояние. Я сделал для себя Android-приложение на React Native + Expo и TypeScript. Оно делит рабочий день, например с 9:00 до 18:00, на отрезки работы и отдыха и напоминает о перерывах. Режимов пять: настройка, ожидание начала дня, работа, отдых и окончание дня. На его примере покажу три способа описания состояния, их сильные и слабые стороны. Полный код — на GitHub.
Каждый режим описан своим типом со своими полями и общей меткой state. В настройке нет ни конца дня, ни отдыха, а restType и restStartedAt есть только у отдыха.
После проверки state TypeScript точно знает, какие поля доступны, и ! с ?. не нужны.
«Отдых без времени начала» невозможно даже собрать.
Если при переходе забыть перенести поле, это будет ошибка компиляции, а не undefined в рантайме.
Цена — многословность: каждый переход заново собирает объект со всеми полями нового режима.
Способы применения
Флаги подходят, когда они независимы, например, звук и полноэкранный режим в плеере друг другу не мешают.
Поля status без объединения хватит, когда у режимов нет собственных данных.
Размеченное объединение нужно, когда у каждого режима свои поля.
XState или свой редьюсер
Для пяти плоских режимов хватает своего редьюсера без зависимостей. Если появятся вложенные или параллельные состояния, отложенные переходы или понадобится визуализация, стоит смотреть на XState.
Технически в приложении расширенный конечный автомат (EFSM). Кроме режимов, он хранит переменные: границы дня, начало текущего отрезка и счётчик рабочих отрезков. На переходах у него есть условия (начать работу можно, только если день ещё не закончился), а сами переходы обновляют переменные. Без переменных пришлось бы плодить состояния WORK_1, WORK_2…
Поиск в React показывает старый результат. Запросы отправлены правильно, ответы пришли не по порядку
Представьте: пользователь ищет «кот», затем дописывает «котёл». Первый запрос выполняется 1,5 секунды, второй — 100 мс. Сначала появляются результаты для «котёл», затем запоздавший ответ заменяет их результатами для «кот».
Оба запроса успешны. Ошибка в том, что любой ответ получает право обновить экран.
Debounce уменьшает число запросов, но не гарантирует порядок ответов. Уже отправленный медленный запрос всё равно может завершиться последним. Для простого компонента можно совместить отмену запроса с проверкой актуальности его результата. Ниже хук: query — строка поиска, /api/search — ваш endpoint, возвращающий JSON.
import { useEffect, useState } from "react";

export function useSearch(query) {
  const [state, setState] = useState({ status: "loading" });

  useEffect(() => {
    let active = true;
    const controller = new AbortController();
    setState({ status: "loading" });

    async function load() {
      try {
        const response = await fetch(
          `/api/search?q=${encodeURIComponent(query)}`,
          { signal: controller.signal }
        );
        if (!response.ok) {
          throw new Error(`HTTP ${response.status}`);
        }
        const items = await response.json();
        if (active) setState({ status: "ready", items });
      } catch (error) {
        if (active && error.name !== "AbortError") {
          setState({ status: "error", message: error.message });
        }
      }
    }

    load();
    return () => {
      active = false;
      controller.abort();
    };
  }, [query]);

  return state;
}
У каждого запуска эффекта свой active. При изменении query React очищает предыдущий эффект: старый результат больше не должен менять состояние. Та же проверка стоит в обработке ошибок, иначе запоздавшая ошибка первого запроса может закрыть уже загруженные результаты второго.
AbortController позволяет прекратить ненужный fetch и чтение ответа. Флаг дополнительно защищает обновление состояния. При этом отмена на клиенте не откатывает работу, которую сервер уже успел выполнить.
Для проверки стоит специально задержать первый ответ, быстро изменить запрос и убедиться, что на экране остаются данные второго. Отдельный сценарий — первый запрос завершается ошибкой уже после успешного второго. Механика очистки разобрана в документации React, отмена запроса — в MDN.
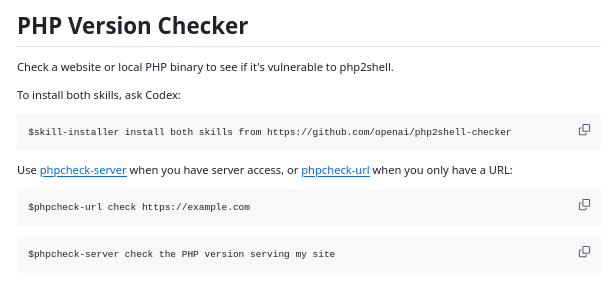
OpenAI выпустила скилл PHP Version Checker для Codex, который помогает оперативно проверять сайты на уязвимости PHP2Shell в PHP (CVE-2026-109618 и CVE-2026-109619), которые потенциально могли привести к несанкционированному RCE:
нужно Codex ссылку на ресурс, ИИ прогонит скрипт, проверит версию языка PHP и подскажет, требуется ли срочное обновление.
также ИИ-агент может сразу поставить патч и защитить сайт на PHP от угрозы взлома.
Уязвимости CVE-2026-109618 и CVE-2026-109619 связаны с разными проблемами при работе с памятью. Первая связана с нехваткой памяти: при очистке запроса программа может обратиться к некорректным данным, что способно привести к удалённому выполнению кода. При обработке последующих запросов программа может обратиться к устаревшим данным до полной инициализации состояния, что тоже грозит удалённым выполнением кода.
Команда безопасности PHP выпустила корректирующие выпуски PHP 8.5.12, 8.4.27, 8.3.36 и 8.2.35, а также патчи для уже не поддерживаемых веток PHP 7.4, PHP 8.0 и PHP 8.1, в которых исправлены критические уязвимости. В команде PHP призвали администраторов установить обновления. Заявлено, что полное блокирование уязвимостей возможно только через установку обновления.
Делюсь опытом вайбкодингаРабота в Antigravity, Open Code, Windsurf
Сразу небольшая ремарка -
Всем ребятам которые когда-либо создавали сайт или приложение с помощью ИИ или агента, хочу сказать что опыт у всех разный , разные модели, взаимодействие, а также склад ума, мышления, понимая конечной цели и желаний, также различен, поэтому прошу не судить строго :)
Моё знакомство с искусственным интеллектом началось примерно в 2022 году, во время пандемии, когда много предприятий закрывалось и было скучно, особо не куда не выйдешь погулять или на природу, появился ChatGPT , я кинулся регаться в OpenAi , используя сервис виртуальных номеров той страны , какой включаешь ВПН, это получилось у меня только на 3 Гугл аккаунте Первые вопросы которые я ему задавал были простыми, но его ответы уже на тот момент мне казались пугающими. Тогда ещё можно было настроить прямо в чате температуру, где больше это значило модель может лгать, меньше или 0 модель всегда отвечала как есть.
В то время мне был очень интересен язык программирования javascript , и я кинулся его изучать, прошёл один бесплатный курс на стёпике и один платный, небольшой, на одной из известных площадок, по видео с Ютуба попробовал сделать мини-апп, но до конца это у меня не вышло, потому что замах был слишком большим, тогда я ещё не понимал что мини-апп этот - целая CRM, работающая на Sanity а не просто приложение. Всё что у меня получилось это 4 работающих страницы и возможность через crm добавлять блоки контента, понимая что наполнять их в одиночку, у меня не будет ни сил не времени, а также не было материальной мотивации, я это дело забросил на три года. У меня родился старший сын, были обычные бытовые заботы, в это время я мало следил за развитием ИИ , так как на тот момент мне казалось что нужно всё таки нужно больше гуглить, серфить stackoverflow, а хотелось максимум автоматизации из-за чувства что не хочу проводить свою жизнь за компьютером.
На тот момент я работал менеджером на ПВЗ Wildberries, по деньгам у меня выходило 5-6 тыс р. а в хорошие дни и 8-9, для моего небольшого города это отлично, с учётом графика 2/2
Но, я как любой другой отец задумался о будущем своего, тогда ещё одного ребёнка, хотел увеличить свой доход
А так как ИИ модели очень продвинулись, я недолго думаю кинулся создавать своё приложение 🐱.
Показывать свой гитхаб я не буду, так как там одни вайбкодинг приложения и нет ничего ценного, но хочу поделиться опытом и ошибками которые я совершал
Вообще ИИ уже очень сильно продвинулся, он мог предложить модули регистрации/авторизации через Гугл/firebase , Яндекс или ВК, или простую почту, также сделать простую метрику кто откуда зашёл, какой тариф купил и так далее, это было всё организованно через ТГ айди пользователя, которое синхронизировалось и при обычном создании аккаунта при регистрации через почту. Что я тогда понял при создании этого приложения?
А проблем была куча :
он мог постоянно генерить новые или менять куски функций, или блоки
если ему не объяснить про безопасность , sql, аудит и gitignore, а также МД файлы, он тупо пушил их кучей в гитхаб те инструкции которые ты ему писал
он хардкодил css
не правильно поставленная задача или промт часто приводила к переделке какого-либо участка кода
переключение на другую модель могло усугубить и добавить абракадабры в код
Итого: ИИ до сих пор не совершенен, и если даже даже мастера сеньоры ошибаются, то что говорить об ИИ?
🏦 Портфель альткоины/золото с автоматической балансировкой
Идея следующая: когда растет Bitcoin, растут альты. Золото растет независимо от Bitcoin.
Исходя от дней роста Bitcoin подряд, смещать распределение портфеля из золота в криптовалюты. Криптовалюты покупать в равной доле независимо от объема торгов, так как все коррелируют с биткоином. При этом не держать в USDT ничего совсем, чтобы избежать инфляции
Закрытие кассы и ребалансировку делаем раз в неделю
import {
  addLauncherSchema,
  addStrategySchema,
  Cache,
  getCandles,
  listenDoneBacktest,
  Position,
  setConfig,
} from "backtest-kit";

setConfig({
  CC_MAX_STOPLOSS_DISTANCE_PERCENT: 100, // иначе валидатор не пропустит технический стоп -50%
});

// Депозит делится поровну между тикерами корзины; доля депозита вне корзины паркуется в золото
const DEPOSIT_USD = 1000;
const PARKING_SYMBOL = "PAXGUSDT";

// Позиция живёт ровно неделю и закрывается по времени; перезаход на первом тике после закрытия
const HOLD_MINUTES = 7 * 24 * 60;

// Трендовый гейт по BTC: доля окон 20..45 дней с положительной доходностью BTC. Это экспозиция
// корзины от 0 до 1; остаток уходит в PARKING_SYMBOL. Ансамбль окон вместо одного N: одиночные
// окна за пределами 25..45 дней заметно хуже, внутри плато результат от выбора N не зависит.
const GATE_SYMBOL = "BTCUSDT";
const GATE_WINDOWS_DAYS = [20, 25, 30, 35, 40, 45];

// Технические уровни: за неделю на споте без плеча недостижимы, штатный выход только по времени
const STOP_LOSS_PERCENT = 50;
const TAKE_PROFIT_PERCENT = 500;

// BASKET:BEGIN
// Сентябрь 2020: топ-20 USDT-пар спота Binance по обороту за август 2020 (известен до начала месяца),
// листинг не моложе 90 дней, без стейблкоинов, плечевых токенов и обёрток BTC/ETH.
const BASKET = [
  "BTCUSDT",
  "ETHUSDT",
  "LINKUSDT",
  "XRPUSDT",
  "BNBUSDT",
  "EOSUSDT",
  "LTCUSDT",
  "TRXUSDT",
  "BCHUSDT",
  "BANDUSDT",
  "OMGUSDT",
  "XTZUSDT",
  "ADAUSDT",
  "ATOMUSDT",
  "VETUSDT",
  "LENDUSDT",
  "ZECUSDT",
  "WAVESUSDT",
  "QTUMUSDT",
  "NEOUSDT",
];
// BASKET:END

const SYMBOL_LIST = [...BASKET, PARKING_SYMBOL];
const PER_SYMBOL_USD = DEPOSIT_USD / BASKET.length;

// getCandles внутри getSignal обрезан по времени движка: последняя дневная свеча - последний
// закрытый день, заглядывания вперёд нет. Cache.fn с интервалом 1d считает гейт один раз
// в день на все тикеры и сам инвалидируется при переходе движка на следующий день.
const getGate = Cache.fn(async (): Promise<number> => {
  const candles = await getCandles(GATE_SYMBOL, "1d", Math.max(...GATE_WINDOWS_DAYS) + 1);
  const closes = candles.map(({ close }) => close);
  const last = closes[closes.length - 1];
  const up = GATE_WINDOWS_DAYS.filter((days) => last > closes[closes.length - 1 - days]).length;
  return up / GATE_WINDOWS_DAYS.length;
}, { interval: "1d" });

addStrategySchema({
  strategyName: "index_fund",
  interval: "1h",
  getSignal: async (symbol, when, currentPrice) => {

    const gate = await getGate();

    const cost = symbol === PARKING_SYMBOL
      ? DEPOSIT_USD * (1 - gate)
      : PER_SYMBOL_USD * gate;

    // cost: 0 движок молча заменяет на CC_POSITION_ENTRY_COST, поэтому нулевая доля - это отсутствие сигнала
    if (cost < 1) {
      return null;
    }

    return {
      id: `${symbol.toLowerCase()}-${when.toISOString().slice(0, 10)}`,
      symbol,
      ...Position.bracket({
        position: "long",
        currentPrice,
        percentStopLoss: STOP_LOSS_PERCENT,
        percentTakeProfit: TAKE_PROFIT_PERCENT,
      }),
      cost: Math.round(cost * 100) / 100,
      minuteEstimatedTime: HOLD_MINUTES,
      payload: { gate, weight: cost / DEPOSIT_USD, basketSize: BASKET.length },
      note: `${symbol} gate=${gate.toFixed(2)} cost=$${cost.toFixed(2)}`,
    };
  },
});

addLauncherSchema({
  launcherName: "main_launcher",
  backtest: true,
  symbolList: SYMBOL_LIST,
  cache: false,
})
Сделал промо-ролик для своего инструмента — и собрал его в Remotion.
Была идея не рисовать интерфейс, а взять уже готовый в Viaduct. Headless Chrome открывает приложение и снимает каждый экран тремя слоями — пустой холст, только связи, полный кадр — и заодно выгружает координаты всех элементов в JSON. Дальше карточки вырезаются из скриншота по этим координатам и выезжают по одной, камера наезжает на нужный элемент, уровни перетекают друг в друга.
Что это даёт: поменялся интерфейс — npm run capture && npm run render, и ролик снова актуален. Нужна локализация — перевести один файл с текстами. Нужна вертикальная версия для Shorts — та же композиция другого размера.
76 секунд, рендер около четырёх минут.
Ролик про Viaduct — браузерный редактор архитектуры по модели C4 с MCP-сервером для кодовых агентов: https://c4.quietgridlabs.com
Если интересно, как устроено внутри — нарезка озвучки по паузам, приглушение музыки под голосом, грабли с headless Chrome — тогда напишу статью с примерами и с готовыми функциями.
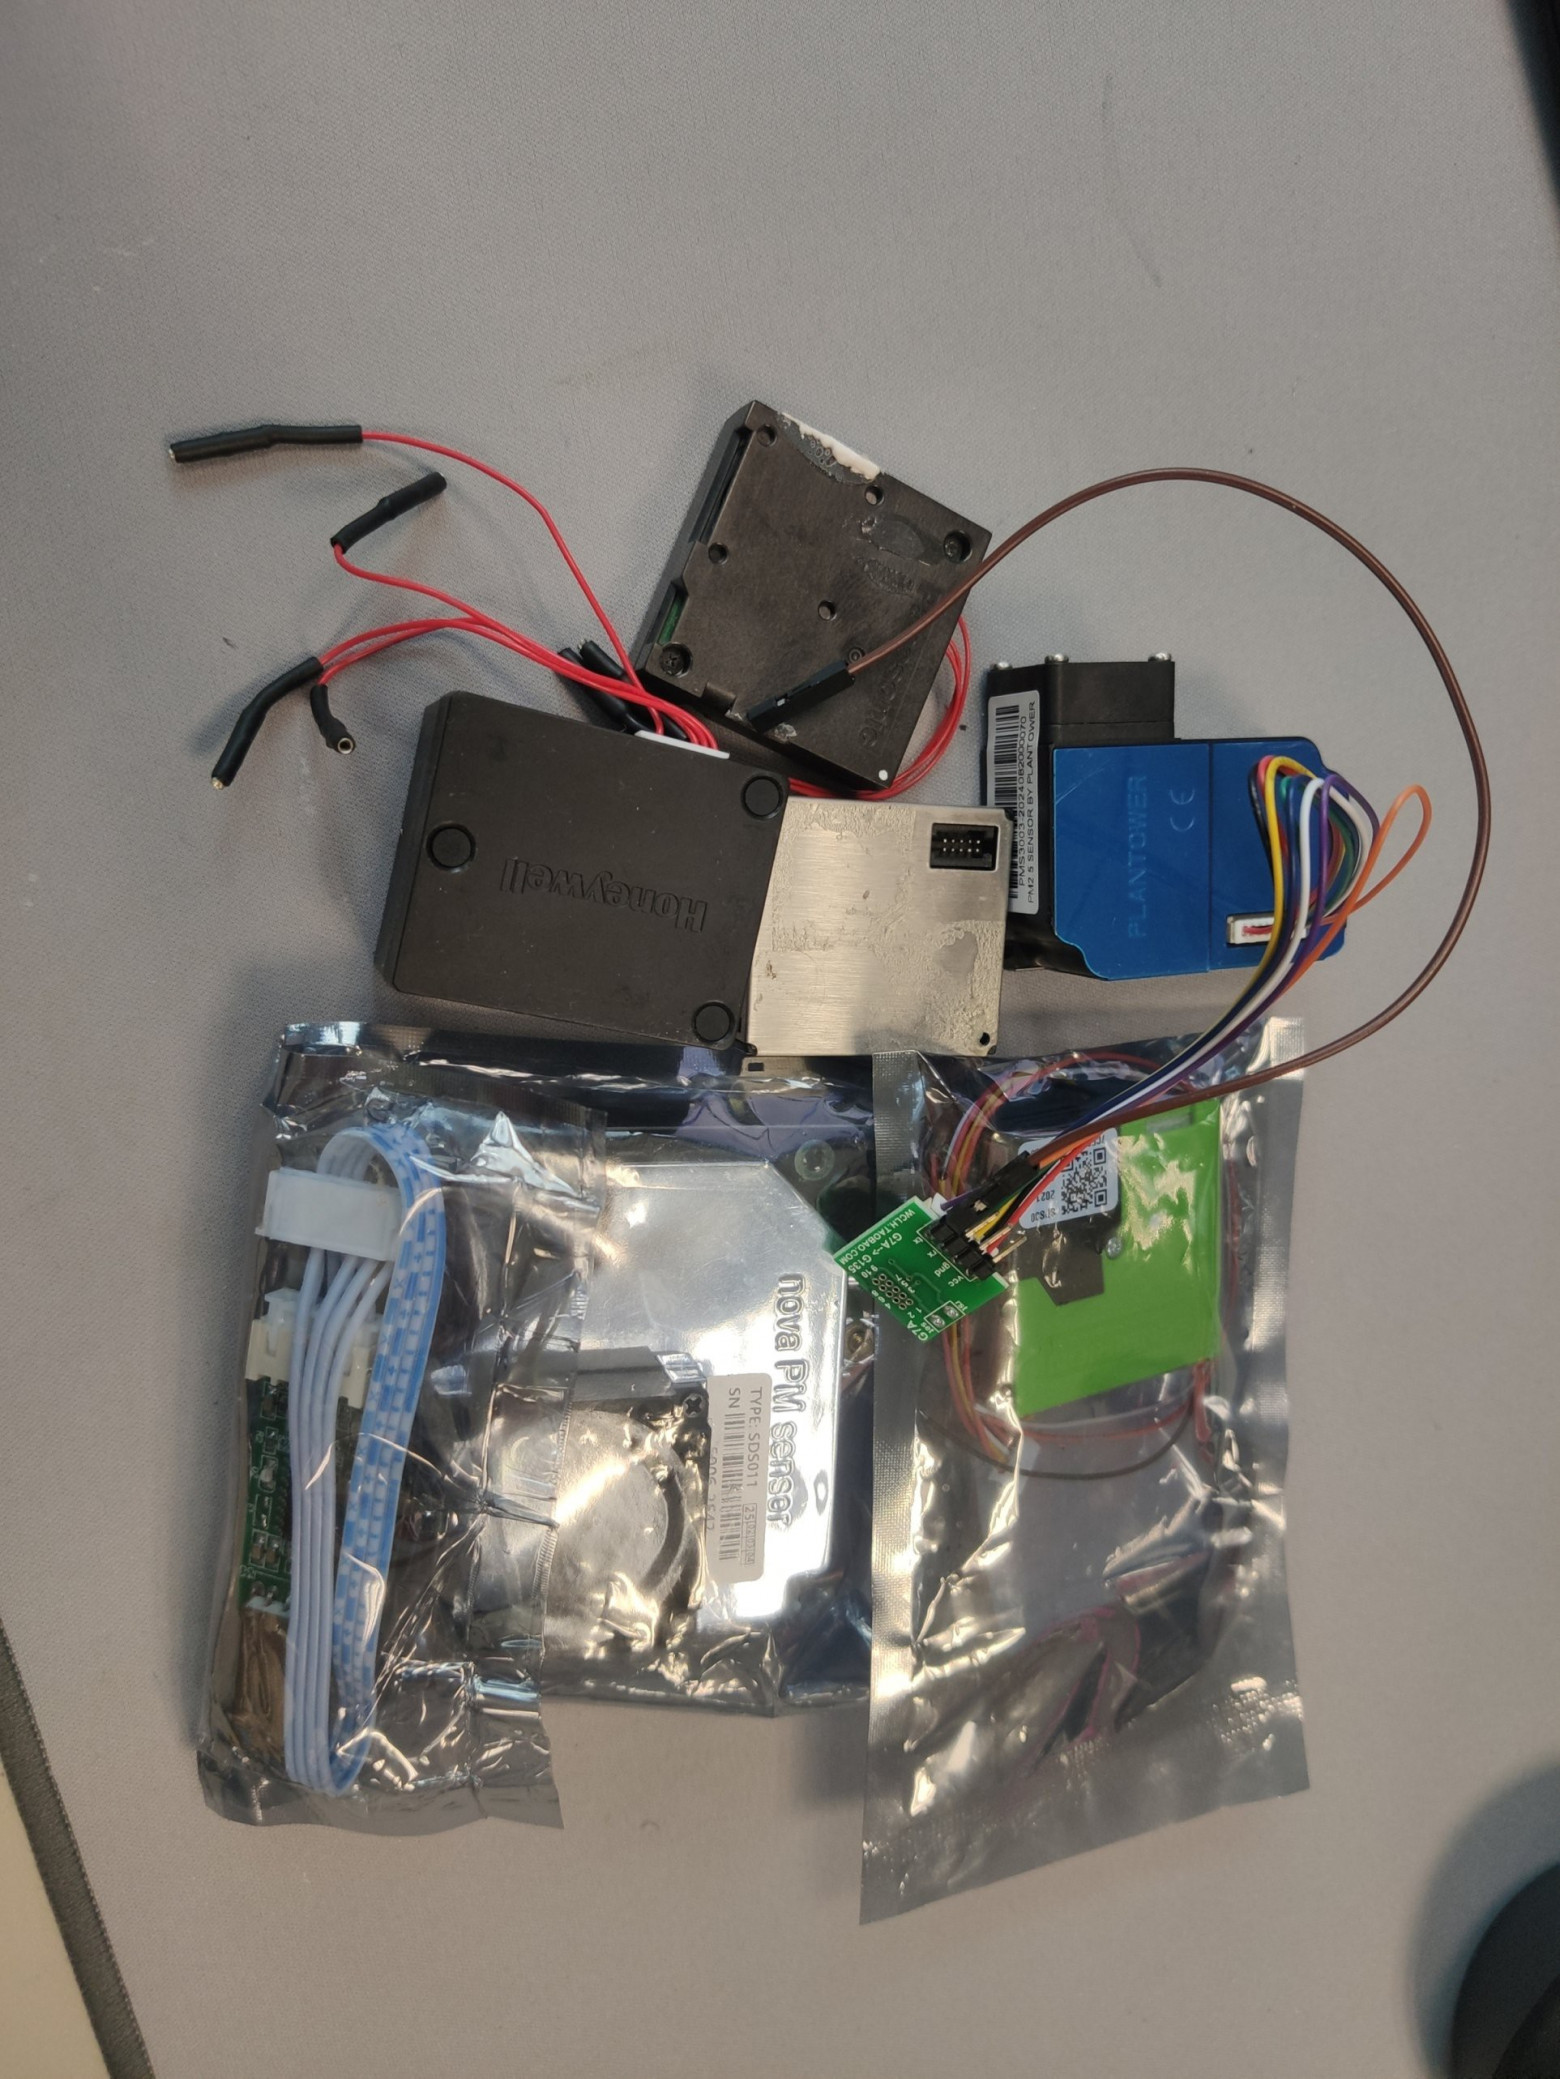
Если коротко: проект, который раньше читал только UART-датчики, теперь работает ещё и с I²C и 1-Wire. Заодно в списке уже 39 датчиков, которые подключаются без написания кода.
Для тех, кто не в курсе: polluSensWeb это страница в браузере, которая через Web Serial API читает данные с датчиков качества воздуха и рисует графики. Ничего ставить не нужно, драйверы тоже. Код открытый, лицензия MIT. Работает в Chrome, Edge, Opera и Brave, а Firefox и Safari Web Serial не поддерживают.
UART
Тут всё как раньше. Берёте любой USB-UART адаптер (CP2102, CH340, FT232), TX с одной стороны идёт на RX с другой и наоборот, плюс питание и земля. Грабли только одни: многим PM-датчикам вроде Plantower PMS5003 нужно 5 В питания, а логика у них 3.3 В, так что уровни адаптера надо проверить.
I²C
К UART-адаптеру I²C-датчик не подключишь, нужен мост USB-I²C, который определяется как COM-порт. Примеры в sensors.json написаны под модуль KEL USB-I2C, и на нём проверeны SCD41, SEN63C и SEN66. У модуля KEL нет подтягивающих резисторов, и у голых датчиков Sensirion их тоже нет. Если ничего не добавить, датчик просто молчит и каждый пакет прилетает с ошибкой. Нужно по одному резистору на SDA и SCL к питанию датчика, от 2.2 до 10 кОм, я ставлю 2.4k. Если плата-переходник уже с подтяжками, свои не нужны. Провода лучше держать короче 30 см, а на длинных кабелях брать резисторы поменьше. Опрашиваются такие датчики через режим multi-command. В JSON описывается последовательность команд: что отправить один раз при старте, что повторять в цикле, какой формат ответа ждать и как проверять контрольную сумму.
1-Wire
Здесь без отдельного мастера шины. 1-Wire гоняется через обычный USB-UART адаптер: сброс идёт на 9600 бод, дальше на 115200 каждый бит шины кодируется одним байтом UART. Скорость порта можно задавать для каждой команды отдельно, поэтому вся последовательность для DS18B20 (reset, Skip ROM, Convert T, чтение scratchpad) описывается тем же JSON, что и остальные датчики. Есть два пути. Самый простой это готовый USB-термометр с usbtemp.com. Он сам определяется как COM-порт, паять ничего не нужно, в списке выбираете «usbtemp.com USB thermometer (DS18B20)». Второй путь: собрать самому из адаптера, диода и резистора. TX и RX объединяются в одну линию данных, TX подключается через диод катодом к себе (чтобы он мог только тянуть линию вниз), на линии данных стоит подтяжка к питанию около 4.7 кОм.
Не подойдут адаптеры вроде DS9490R: они не создают COM-порт, и браузер их не видит. Мосты на DS2480B (тот же DS9097U) порт создают, но говорят на своём протоколе, так что для них нужно отдельное описание. Пока этого нет.
Про сами датчики
В списке сейчас 39 штук: Plantower, SenseAir S8, Sensirion (SPS30, SEN55 по UART, несколько I²C-моделей), DS18B20 и другие. Чтобы не копировать конфиги, есть наследование. В новом описании указываешь, от какого датчика наследуешься, и переопределяешь только отличия. Например, SenseAir S8 004-0-0017 отличается от 004-0-0053 только множителем в формуле CO₂, и в конфиге это одна строка. Если вашего датчика нет, можно загрузить свой JSON прямо в интерфейсе, он появится в списке с пометкой. Или напишите в issue модель, посмотрим вместе.
Остальное вкратце: несколько графиков одновременно, лог сырых пакетов в hex с отметкой, прошла ли контрольная сумма, экспорт в CSV и вебхуки для Home Assistant, Node-RED и всего, что умеет принимать HTTP. Вебхуки идут через CORS-прокси, и по умолчанию он внешний. Если данные не хочется отдавать наружу, поднимите свой.
Представлен открытый проект Papermorph — скилл для Claude, чтобы усилить пользовательский опыт чтения, например, с помощью преобразования PDF в интерактивную веб‑книгу:
можно загрузить PDF, а дальше Claude сам создаст план книги, сториборды, озвучку, анимации и даже квизы для лучшего запоминания
в результате будет полноценный интерактивный учебный проект.
Создать файл с расширением .md с текстовым содержимым, html-, markdown-разметкой в папке с названием подтемы в папке с названием темы или создать новые.
Первой строкой добавить html-комментарий в формате с датой создания файла, затем добавить текст поста. Комментарий с датой используется для сортировки страниц в индексном файле раздела index.js.
Перейти в каталог раздела и обновить индексный файл, выполнив скрипт:
python3 ../update.py
Добавление постов в раздел /posts через RSS-каналы:
Перейти в каталог раздела и запустить скрипт чтения RSS-канала:
  python3 readrss.py <RSSlist-id> (ключ источника из списка RSSlist в скрипте)
  python3 readsites.py <RSSlist-id> (ключ источника из RSSlist)
  python3 readrufeed.py (обновления каналов из Рутуб из списка RSSlist)
  python3 readyfeed.py (обновления каналов из Ютуб из списка RSSlist)
Добавить текст в раздел /songs:
Создать текстовый файл .txt с названием песни с аккордами в markdown-разметке или без в папке с названием музыкального жанра и подпапке с именем исполнителя. Он будет переименован в .md скриптом update.py.
Первой строкой добавить html-комментарий в формате с датой создания файла.
Создать файл about.md с информацией о группе, исполнителе и картинку <Исполнитель.jpg>. После индексации появится описание группы и кавер-картинка при просмотре списка песен исполнителя.
Перейти в каталог раздела и обновить индексный файл, выполнив скрипт:
🤔 Как не терять requestId в логах не пробрасывая его через параметры методов?
Классическая проблема NodeJS разработки: логи не читаемы. При дебаге когда пользователь один, разобрать что происходит ещё можно. Но после запуска в прод в логах сборная солянка из запросов и восстановить трейс вызова композиции методов нельзя
Представлен открытый проект Free Router, автоматически переключает ИИ‑агента между 25 бесплатными провайдерами для значительной экономии токенов, включая бесплатные. На выбор есть любые актуальные модели: DeepSeek, GLM-5.3, Qwen-3.8.
Шутки шутками, а существующие реализации DI на ноде либо перегружены, либо используют декораторы, для которых нет единого стандарта у старого и нового кода.
import { provide, inject } from "di-kit";

export class WalkerLogicPublicService {

  private readonly loggerService = inject<LoggerService>("loggerService");

  ...

}

...

provide("loggerService", () => new LoggerService());
Вот почему нельзя просто вот так? Никаких минусов нет, выносите типы в enum, создавайте изолированные пространства имен.
import { createActivator } from "di-kit";

export const { init, inject, provide } = createActivator("separate-scope");
Регуляторы скоро спросят «где у вас RSA?». Я написал сканер, который отвечает за секунды
Завязка. Три дедлайна: США — PQC для новых госзакупок нацбезопасности с 2027 (EO 14412 / CNSA 2.0, там прямо назван CBOM), Великобритания — полная криптографическая инвентаризация и план миграции к 2028 (NCSC), ЕС — переход с конца 2026. Первый вопрос аудитора одинаковый: «где именно у вас используется RSA?» Ответа нет почти ни у кого.
Что такое CBOM и почему это не то же самое, что SBOM.
«Harvest now, decrypt later» — почему это не про далёкое будущее: трафик записывают сегодня, расшифруют потом. Если у секрета срок жизни больше нескольких лет — проблема уже наступила.
Как работает сканер. Одна команда, три артефакта: CycloneDX 1.6 CBOM, отчёт с планом миграции на ML-KEM/ML-DSA, SARIF для GitHub code scanning. Плюс scan-tls — одно рукопожатие и вердикт по живому эндпоинту.
Байка про баг (Хабр это любит): первый же регрессионный тест поймал, как сканер находит «криптографию» в собственных регулярках. Лечилось маскировкой литералов RSA_generate_ke[y], и теперь есть вечный тест, что репозиторий подсвечивает только свои фикстуры.
Честный бенчмарк против PQCA CBOMkit. Не «мы лучше», а «мы разные»: CBOMkit глубже на Java/Python (знает размеры ключей, симметрику), мы шире (10+ языков, конфиги, сертификаты) и быстрее (0,05–0,12 с против минуты). Прямая ссылка на docs/BENCHMARK.md — воспроизводимо кнопкой в CI.
Ограничения честно: v0 на паттернах, динамические вызовы пропустит, отсутствие находок ≠ отсутствие проблем. AST-движок в планах.
Финал: вопрос к читателям — у кого уже спрашивали CBOM и в каком виде.
Chrome изменил работу window.open с несколькими мониторами
Раньше в Chrome можно было открыть окно на втором мониторе обычным window.open, передав его координаты:
window.open(url, '_blank', 'left=1920,top=0');
Теперь Chrome может ограничить позицию окна текущим экраном, если сайту не выдано разрешение «Управление окнами» (window-management). При этом в Firefox старый вариант продолжает работать.
Современное решение — Window Management API:
const details = await window.getScreenDetails();

const screen = details.screens.find(
  x => x !== details.currentScreen
);

window.open(
  url,
  '_blank',
  `left=${screen.availLeft},top=${screen.availTop}`
);
Главный нюанс: вызов getScreenDetails() запрашивает разрешение на управление окнами. После его выдачи Chrome снова позволяет корректно размещать окно на другом мониторе.
P.S. это изменение уже упоминалось в версии 135.0.7049.116 - ссылка