Обновить
128K+

Natural Language Processing *

Компьютерный анализ и синтез естественных языков

106,01
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

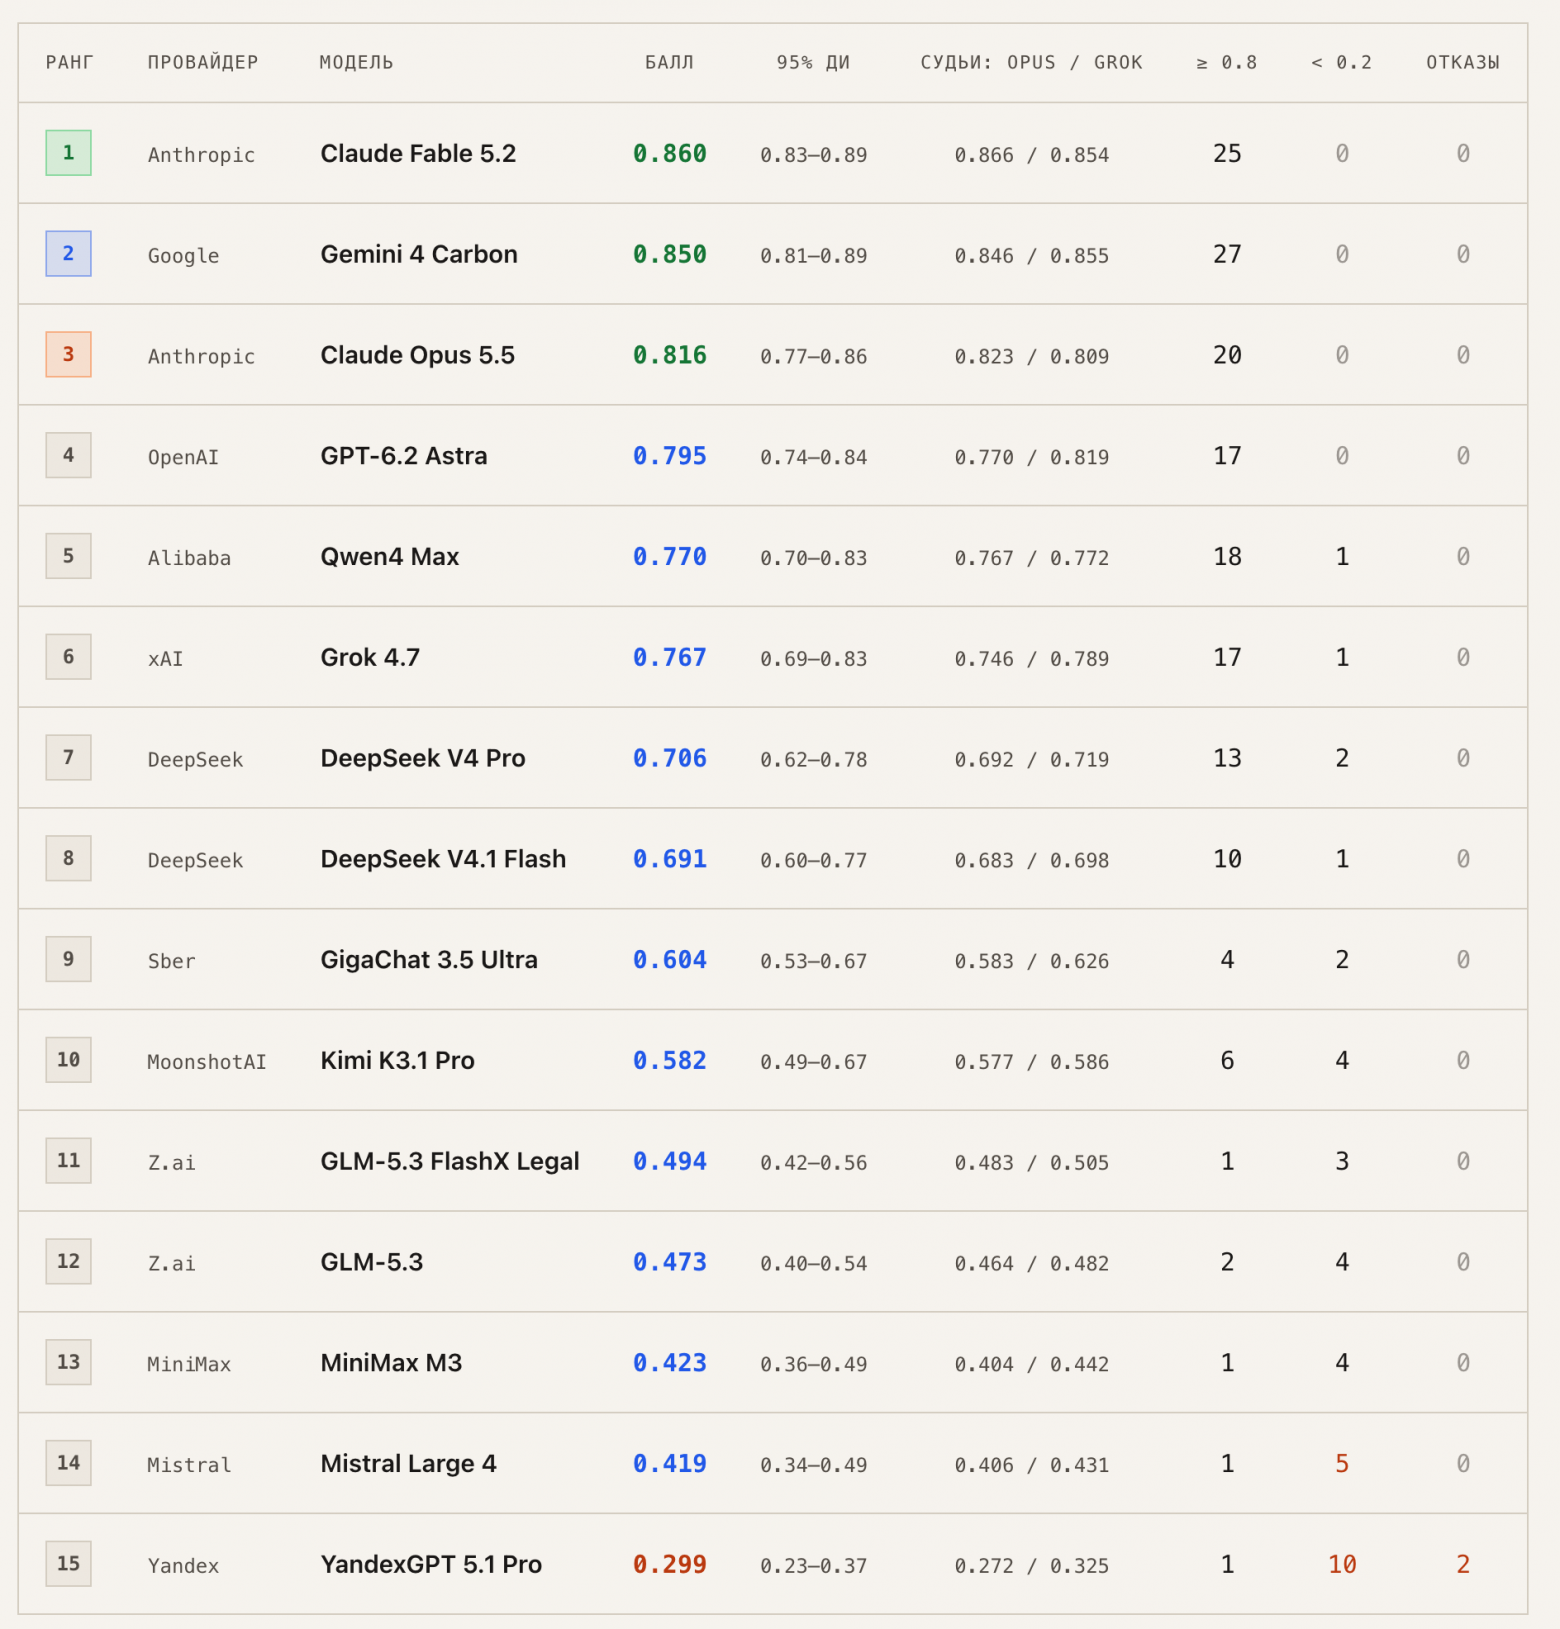
Lexometrica Ground Truth: 15 LLM на 30 кейсах по практике ВС РФ
Уровень сложностиСложный
Время чтения10 мин
Охват и читатели5.7K

Рейтинги языковых моделей обычно читают как турнирную таблицу. Для юридических задач это мало что дает: различия между соседними строками, как правило, меньше погрешности измерения, а надежность модели-судьи, которая выставляет оценки, почти никогда не проверяется. В ноябре я повторил срез Lexometrica Ground Truth - 15 моделей, 30 закрытых кейсов по практике Верховного Суда РФ, два LLM-судьи - и на этот раз проверял не только модели, но и судей. Ниже - дизайн исследования, результаты и то, что удалось измерить про LLM-as-a-Judge: согласие судей, смещение судьи-участника и вклад судьи в общую погрешность. Полная версия с расчетами выйдет препринтом.

У замеров есть прикладная цель - в сервисе «неШемяка!» исход судебного спора прогнозируется по материалам дела пространным LLM-пайплайном. Модели в нем мы меняем на флагманские по мере их выхода, но дважды в год решили подтверждать выбор на собственном датасете. Предыдущий срез был в марте 2026 года, этот - в ноябре.

Читать далее

Дообучаем на Mac малую языковую модель для RAG в браузере

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели11K

Задача выглядела довольно простой: дообучить Qwen3-0.6B отвечать на вопросы по фрагментам текста, найденным семантическим поиском. Но первые эксперименты дали обратный эффект: модель стала чаще выдумывать подробности, хотя validation loss продолжал снижаться. Четыре версии обучающих данных помогли разобраться, почему так происходит и как удалось втрое сократить число галлюцинаций — пусть и ценой более частых отказов от ответа.

Посмотреть результаты

Промпт — это не строка, а шаблон

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели6.1K

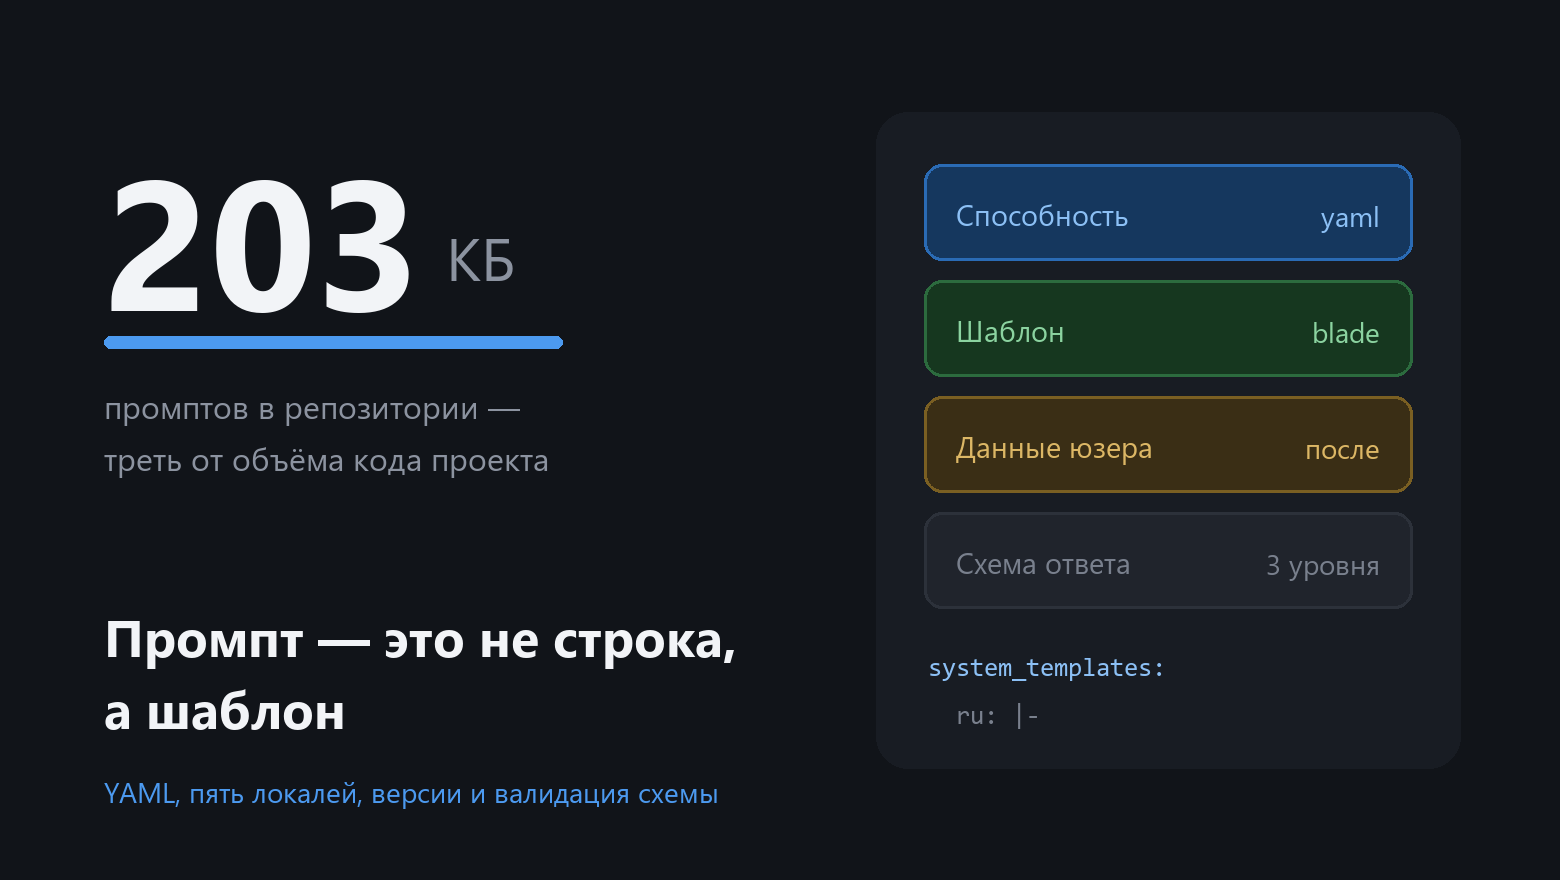
В репозитории проекта лежит 203 килобайта промптов — примерно треть от объёма всего PHP-кода. При этом ни одного промпта в коде нет: все они YAML-файлы, которые проходят ревью, версионируются и выкатываются вместе с релизом.

Разбираю, из чего состоит такой файл и почему единица хранения — не текст, а целиком способность: провайдер, модель, параметры генерации и шаблоны на каждом языке. Плюс неочевидное: почему пользовательские данные подставляются после рендера шаблона, а не внутри него, зачем модели указывать алиасом, как деградировать по трём уровням поддержки JSON-схемы и что вообще можно тестировать там, где ответ недетерминирован.

Читать далее

От TF-IDF до LLM: сравниваю модели на 480 реальных отзывах

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели4.7K

На 480 реальных отзывах сравниваю словесный и символьный TF-IDF с классификатором на признаках ruBERT-tiny2. Метки задаёт локальная Qwen3-0.6B. Показываю результаты на отложенных текстах, расхождения моделей, ошибки разметки и время обработки на M1 — с кодом и пятью графиками.

Читать далее

Когда ИИ ошибается убедительно: инженерия здравого смысла

Время чтения7 мин
Охват и читатели6.4K

Мы живём в удивительное время. Генеративный искусственный интеллект решает сложные математические задачи, помогает разрабатывать программное обеспечение, участвует в поиске новых лекарств. AI-агенты объединяются в оркестры, самостоятельно распределяют задачи и взаимодействуют с корпоративными системами. Вайб-кодинг позволяет создавать приложения людям, которые ещё недавно не могли написать ни одной строки кода.

Всё это меняет привычную картину IT-разработки. Сегодня руководитель подразделения может поручить AI-агенту анализ данных, подготовку отчёта, разработку программного компонента или автоматизацию бизнес-процесса. Сотрудник может самостоятельно собрать собственного агента, подключить его к корпоративным данным и начать решать задачи, которые раньше требовали участия целой команды.

Но вместе с этим возникает вопрос, который становится всё более актуальным для руководителей IT-подразделений и AI-инженеров:

Как превратить впечатляющие возможности ИИ в управляемый корпоративный инструмент, которому можно доверить реальные бизнес-процессы?

Именно здесь заканчивается эпоха демонстрационных возможностей и начинается инженерия промышленного ИИ.

P.S. Статья представляет собой переработку предыдущей, которая ,откровенно говоря, оказалась сухой и непонятной. Учитывая критику, решил провести работу над ошибками и переосмыслить прошлый текст.

Читать далее

Правка SGNE-CC v2 для DeepSeek-R1-1.5B (T=0): −87% зависаний, ответы в 2.7 раза короче и +11 п.п. на MATH-500

Уровень сложностиСредний
Время чтения11 мин
Охват и читатели9.4K

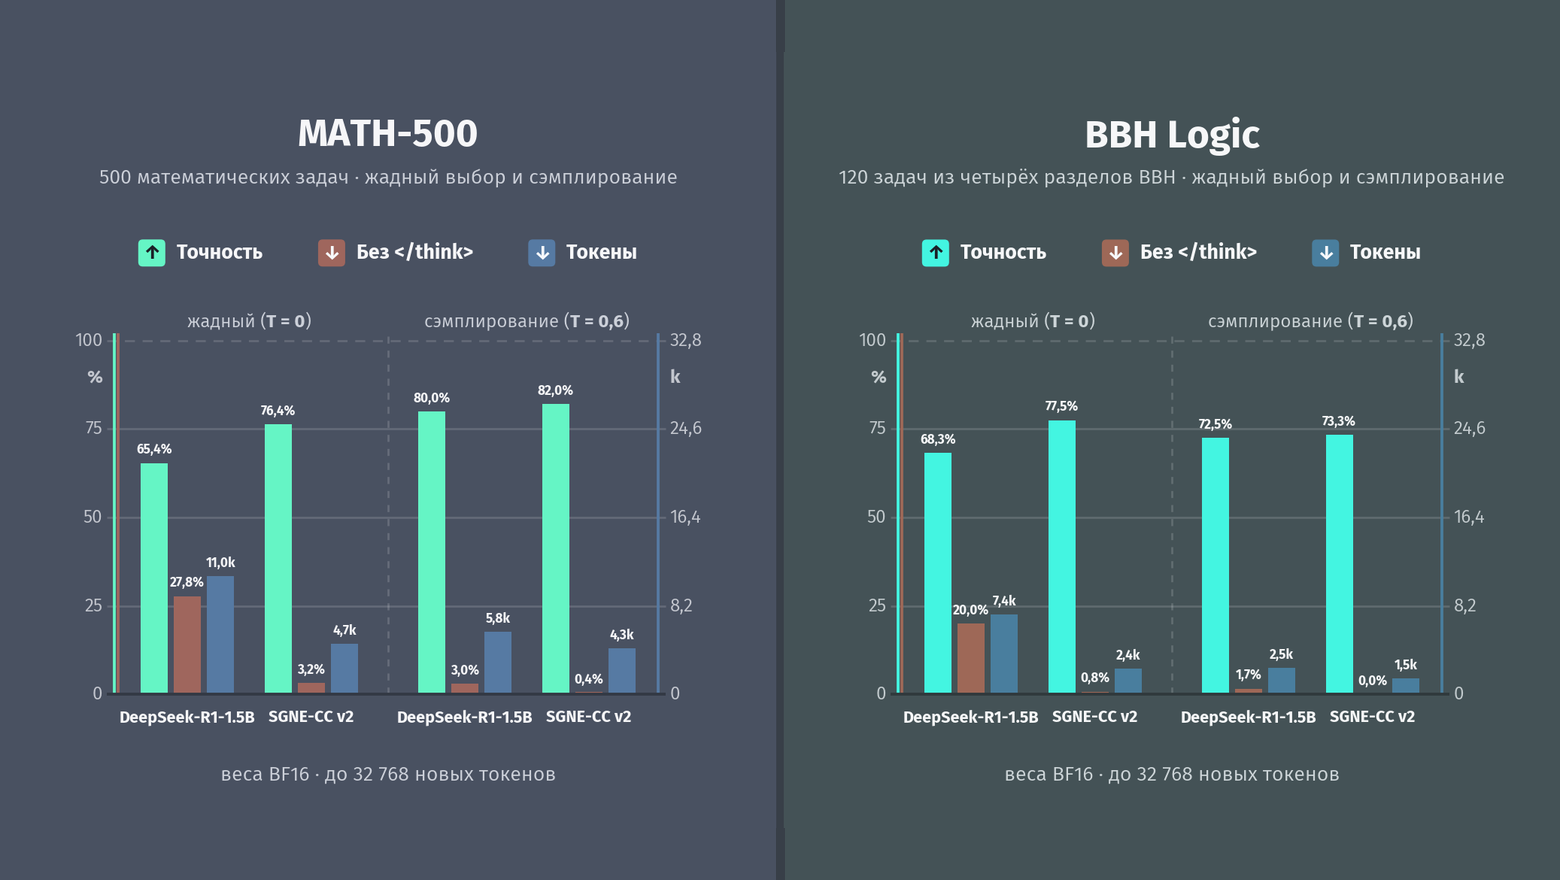
При жадном выборе токенов (T = 0, без сэмплирования и штрафа повторов) рассуждающая модель DeepSeek-R1-Distill-Qwen-1.5B часто вязнет в бесконечной перепроверке уже найденного решения внутри <think> и упирается в потолок 32 768 токенов. Я перенёс открытую нормосохраняющую правку весов SGNE-CC с гибридной Qwen3.5-0.8B на этот чистый трансформер — без дообучения и без правок кода инференса.

Чтобы остановить зацикливание в самих весах, оказалось достаточно повернуть всего 205 столбцов mlp.down_proj (0.0177% параметров, патч 603 КБ), не трогая слои внимания, ворота и нормировки:

Прирост в жадном режиме (T = 0): на математике MATH-500 точность выросла с 65% до 76% (+11 п.п.), на задачах программирования MBPP — с 53% до 68%, на логике BBH — с 68% до 78%.

Меньше обрывов и токенов (по всем 5 наборам, 1 054 задачи): доля незавершённых рассуждений упала на 87%, а средняя длина ответа сократилась в 2.7 раза (10.8k → 4.0k токенов).

При стандартном сэмплировании (T = 0.6): точность не теряется (73% против 72%), остаточные зависания также снижаются на 86%, а генерация становится на треть короче.

Под катом — локализация петли самокопирования в головах внимания, геометрия правки, честные границы метода (HumanEval, T = 0.3) и ссылки на патч и трассы 32K.

Читать далее

Как вайбкодинг меняет IT, экономит на SaaS и заставляет программистов переучиваться — интервью с Артёмом Исламовым

Уровень сложностиСредний
Время чтения77 мин
Охват и читатели6K

Можно ли за один день создать продукт, за который раньше пришлось бы платить десятки тысяч рублей ежемесячно? А какие задачи теперь можно решить без целой команды разработчиков? Пока программисты спорят, способен ли ИИ писать хороший код, предприниматели уже собирают собственные CRM-системы, автоматизируют бизнес-процессы и отказываются от дорогих SaaS-подписок. По словам Артёма Исламова, ему удалось превратить 53 клика для маркировки рекламы в один, создать с помощью ИИ продукт с 89 тысячами пользователей и получить больше миллиона рублей выручки от Google-таблицы, код для которой первоначально писал через ChatGPT.

Я, Александр, автор телеграм-канала «Shulepov Code», поговорил с Артёмом Исламовым – предпринимателем, разработчиком, преподавателем, нейроэнтузиастом и основателем Glo Academy, автором телеграм-канала «Лысый из браузера». Обсудили, почему он продал онлайн-школу, как нейросети меняют образование и рынок IT, что происходит с профессией программиста и почему вайбкодинг одновременно помогает новичкам освоить разработку и заставляет опытных специалистов терять привычные навыки.

В интервью – примеры автоматизации бизнеса, история создания Telegram-проектов, экономика привлечения подписчиков, опыт переезда в Узбекистан, разработка собственных продуктов вместо платных сервисов и разговор о том, стоит ли сегодня вообще учиться программированию.

Читать далее

Как мы собираем и склеиваем объявления из 200+ Telegram-каналов Ташкента

Время чтения7 мин
Охват и читатели5.8K

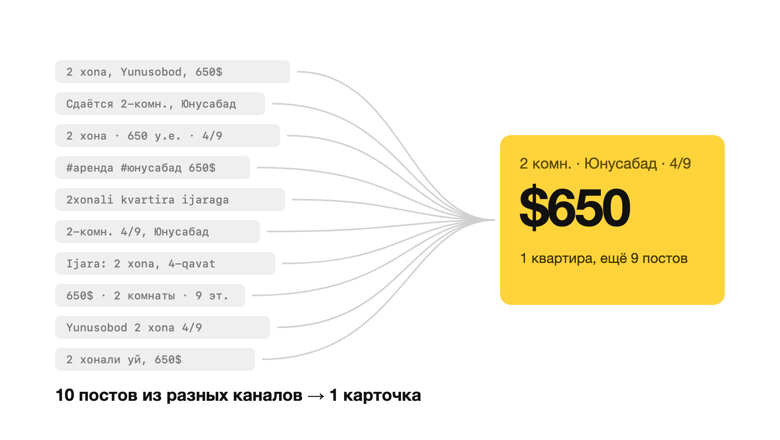
В Ташкенте квартиру в аренду ищут не на большом сайте объявлений, а в Telegram. Каналов с объявлениями — сотни: у каждого агентства свой, плюс районные, студенческие, «без посредников». Одну и ту же квартиру выкладывают в пяти-десяти из них, с разными фото, ценой в долларах или сумах, на русском, узбекском латиницей и узбекском кириллицей — часто в одном посте.

Мы делаем kvadro² — сервис поиска квартир: сайт kvadro.app, Telegram-бот и приложение внутри Telegram (Mini App). Он собирает объявления из 215 открытых каналов Ташкента, Ташкентской области, Андижана, Намангана, Коканда и Ферганы в одну ленту. Ниже — как это устроено: от чтения каналов до склейки дублей и подсчёта «цены к рынку». Без секретов и без маркетинга, с цифрами из нашей рабочей базы.

Читать далее

Цена ошибки: паддинг, чекпоинты на сетевом диске и сторож, который гасил здоровое обучение

Уровень сложностиПростой
Время чтения13 мин
Охват и читатели12K

Ошибки бывают в любой настоящей работе. Обычно о них пишут одной строкой где-то между графиками с результатами, а я решил сделать наоборот: собрать наши промахи в одну статью и разобрать их по-инженерному, то есть что именно сломалось, сколько это стоило и что мы после этого поменяли.

Во второй статье серии я пообещал рассказать, как арендовал видеокарты в облаке и сжёг на них деньги, почти ничего не посчитав. В третьей напомнил, что обещание в силе. Теперь выполняю. Большая часть статьи про облачное дообучение языковой модели, а в конце я расскажу о нескольких ошибках в измерениях: денег они почти не стоили, но были опаснее.

Как и раньше, я не называю базовые модели, техники дообучения, чекпоинты и источники данных. Классы карт, поставщиков, цены в час и порядок величин называю, потому что без них разговор о стоимости теряет смысл.

Читать далее

Как научить BERT «понимать» науку: гибридная классификация научно‑технических текстов с графами знаний

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели5.5K

Научных публикаций становится экспоненциально больше. Вручную рубрицировать и индексировать их уже невозможно, поэтому острая потребность в автоматической классификации очевидна. Казалось бы, можно взять классический BERT, дообучить его на размеченных статьях и получить отличный результат. Для текстов общей тематики так и есть. Но научно‑технические тексты устроены иначе: они содержат узкоспециализированную терминологию, редкие сущности и сложные концептуальные связи, которые слабо отражаются в базовой статистике совместной встречаемости слов.

Трансформер учится на распределении токенов. Он может «знать», что «градиентный спуск» и «оптимизация» часто стоят рядом, но явного понимания того, что первое является разновидностью второго, у него нет. При столкновении с междисциплинарными терминами или текстами с дефицитом контекста одних статистических паттернов не хватает. Граф знаний, напротив, хранит такие связи явно в виде семантических триплетов, состоящих из субъекта, отношения и объекта. Интеграция этой верифицируемой онтологии в процесс дообучения языковых моделей позволяет преодолеть слепоту трансформеров к фактам. Вопрос заключается лишь в том, как передать эти знания модели, не потеряв скорость инференса и не обрезав половину статьи из‑за лимитов памяти.

Читать далее

OpenAI выпустила GPT-6.2: обгоняет Claude Opus 5.5 и стоит в разы дешевле. Но есть нюансы

Уровень сложностиПростой
Время чтения4 мин
Охват и читатели14K

17 ноября OpenAI представила две модели: GPT-6.2 Astra и GPT-6.2 Sol. Astra предназначена для сложных задач, программирования и агентных сценариев, а Sol - для повседневной работы, где важны скорость и экономичность.

Первые независимые тесты Artificial Analysis показывают, что обновление получилось серьёзным. Новая Astra обошла Claude Opus 5.5 по общему индексу интеллекта и приблизилась к Claude Fable 5.2, при этом задачи обходятся значительно дешевле.

Посмотрим, насколько новые модели превосходят предыдущие GPT, как они выглядят на фоне Claude и какие недостатки OpenAI обнаружила в официальных тестах.

Читать далее

Своя LLM на Core i5-2400 без видеокарты: сказки за вечер, Qwen3.5 за 1 ч 44 мин

Уровень сложностиСредний
Время чтения13 мин
Охват и читатели10K

Изначально я хотел сделать проект для обучения LLM для себя — ради эксперимента. А в итоге он вырос в программу, в которой свою LLM может обучить любой человек. Делаю его с 8 июня 2026 года — и до сих пор.

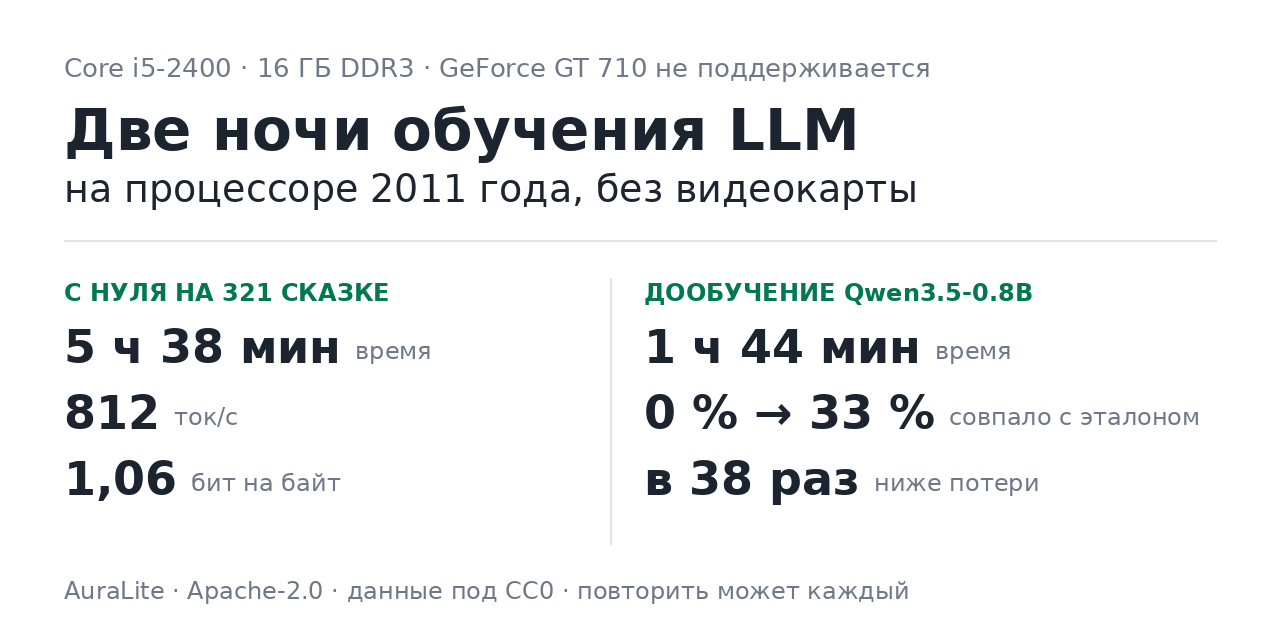
Старый ПК в заголовке — не для красного словца. Core i5-2400 2011 года, 16 ГБ DDR3 и GeForce GT 710 — это и есть мой основной компьютер, мощнее у меня нет. Видеокарту PyTorch не поддерживает, так что всё в статье посчитано на процессоре. Мне было интересно проверить, что на таком железе реально сделать с языковыми моделями без облака. Получилось две вещи: модель на 7 млн параметров, обученная с нуля на русских народных сказках, и Qwen3.5-0.8B, дообученная за 1 ч 44 мин отвечать на вопросы о программе, в которой всё это сделано.

Сразу оговорюсь: AuraLite — моя программа, я пишу её с июня 2026 года. Статья не про то, что «вот какой продукт», а про то, что на такой машине реально получается из обучения LLM и где проходят границы. Все цифры ниже — с этой машины, все неудачи — тоже.

Коротко: Core i5-2400 2011 года, 16 ГБ DDR3, всё на процессоре. За 5 ч 38 мин выучил с нуля модель на 7 млн параметров на 321 сказке — она перенимает стиль, но не смысл. За 1 ч 44 мин дообучил Qwen3.5-0.8B отвечать по документации программы: дословных совпадений с эталоном 0 % → 33 %, потери в 38 раз ниже — и три честных провала. Данные и команды в конце, повторить можно на любом похожем железе.

Читать далее

Как читать тексты в эпоху слопа

Уровень сложностиПростой
Время чтения27 мин
Охват и читатели9.7K

Генеративный искусственный интеллект значительно упростил создание нового контента. Современные числодробилки с гигабайтами высокоскоростной памяти способны выжимать сотни дешёвых токенов в секунду даже из относительно крупных больших языковых моделей. И это огромная проблема.

Год назад исследователь Университета Карнеги — Меллона Грэм Нойбиг предложил символическую награду в 50 долларов США тому, кто проверит детектором ИИ научные статьи и рецензии, поданные на Международную конференцию по обучению представлений (International Conference on Learning Representations). Призыв прозвучал в ноябре 2025 года, когда вовсю шло рецензирование научных работ ICLR 2026.

Поводом стало большое число жалоб от исследователей. Слишком много оказалось пространных, малосодержательных замечаний; в других случаях требовалось проведение необычных для своей области исследований; иногда в текстах были ссылки на несуществующие работы. Возникли подозрения, а не поручают ли рецензенты свой труд машине. Винить их в этом сложно. Рецензенты ICLR — это сами исследователи в области машинного обучения, то есть преподаватели университетов, аспиранты и сотрудники научных лабораторий. При этом за рецензирование им обычно не платят.

Читать далее

Ближайшие события

Поисковая строка, которая понимает: гибрид подсказок и LLM-классификаторов в нишевом каталоге

Уровень сложностиСредний
Время чтения7 мин
Охват и читатели6.6K

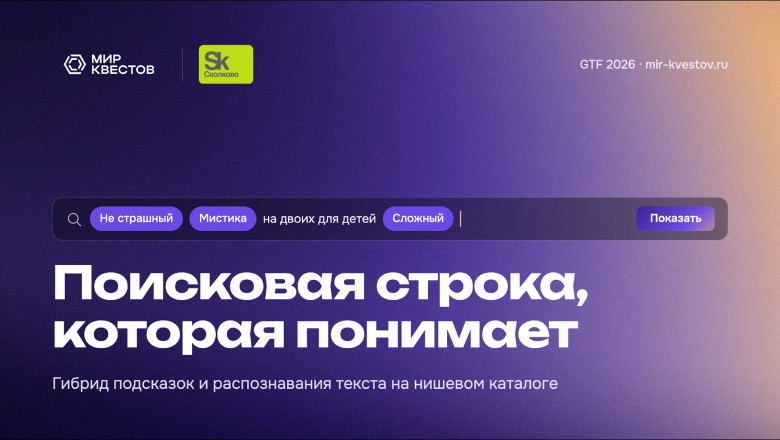
У нишевого агрегатора мало данных: 65% посетителей не авторизованы, истории просмотров нет, а в каталоге всего три тысячи квестов. Рассказываю, как мы в Мире Квестов заменили историю опросом покупателей, решающим деревом сжали анкету из 120 галочек до трёх кликов по подсказкам и добавили шесть LLM-классификаторов, которые разбирают запрос вроде «страшный на двоих», пока посетитель печатает. Внутри метрики поиска и сравнение с подходами больших компаний.

Читать далее

Перед residual stream: токенизация, эмбеддинги и изнанка безопасности LLM

Уровень сложностиСложный
Время чтения13 мин
Охват и читатели7.2K

Одна запятая способна изменить язык ответа нейросети. Разбираемся, как токенизация и эмбеддинги влияют на поведение больших языковых моделей, где возникают риски безопасности и почему привычные методы анализа векторов могут вводить в заблуждение.

Читать далее

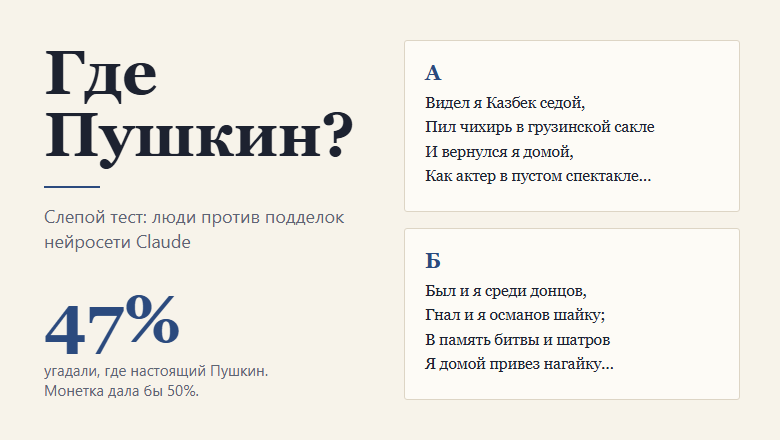
Где Пушкин? Слепой тест: люди против подделок нейросети

Уровень сложностиСредний
Время чтения9 мин
Охват и читатели5.9K

А смогли бы вы отличить стихотворение, написанное А. С. Пушкиным, от подделки нейросети Claude Opus 5.5? А повторить то же самое 10 раз?

Я вот не смог. В 2024 году в журнале Scientific Reports вышла статья, описывающая эксперимент, в котором люди вслепую угадывали, написан ли отрывок Шекспиром, Байроном, Уитменом и другими известными англоязычными поэтами или нейросетью GPT-3.5. И результат был неутешительным для людей: уже тогда поколение моделей, которое сейчас кажется анекдотически слабым, отлично подделывало стили известных поэтов, и по крайней мере респонденты, не являющиеся филологами, поэтами, литературоведами и пр., показали результат угадайки даже чуть хуже монетки — 46,6% верных ответов.

К 2026 году модели вычитали тексты классических авторов на разных языках вдоль и поперёк. Однако, по моему опыту, писать стихотворения с нуля, без референса на конкретный стиль, они так и не научились.

Читать далее

Агенты тоже любят индивидуальный подход, или Почему для генерации кода не существует универсальной обвязки

Уровень сложностиСредний
Время чтения10 мин
Охват и читатели7.2K

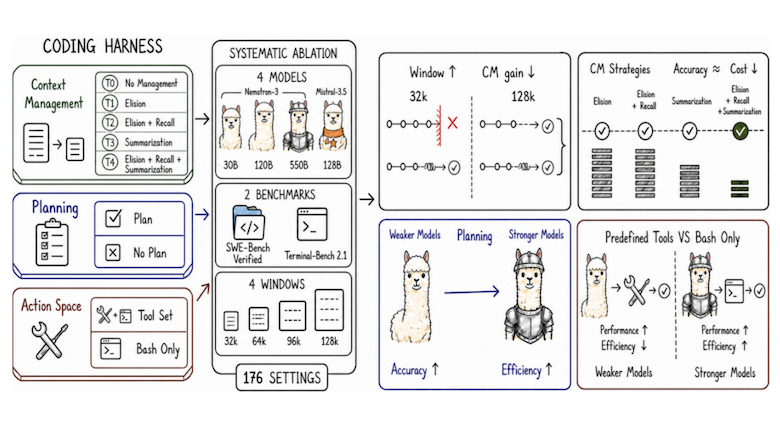
Замечали ли вы, что одна и та же модель в одном ИИ-помощнике для написания кода прекрасно чинит баги, а в другом не вывозит простую задачу? Кажется, что в этом виновата сама модель. Но это не совсем так. Мне захотелось поделиться с вами исследованием, в котором была рассмотрена программная оболочка вокруг модели, так называемая обвязка, или харнесс (по-английски — harness). Это рабочее место агента, где решается, как он составляет план, какие использует инструменты для работы с файлами и терминалом и что делает, когда переписка становится слишком длинной и перестает помещаться в контекстное окно.

Обычно для сравнения обвязок берут готовые инструменты, прогоняют их на одних и тех же задачах и оценивают результаты. Но на них влияют сразу несколько факторов, и практически невозможно понять, какой из них сыграл главную роль. К тому же одна и та же обвязка с разными моделями ведет себя по-разному. А тут исследователи собрали простую обвязку и поочередно меняли в ней планирование, набор действий и управление контекстом. Результаты оказались довольно неожиданными. То, что нужно слабой модели, сильной либо не нужно, либо мешает, а некоторые умные механизмы вообще почти никем не используются. Ниже расскажу об этом подробнее.

Для начала посмотрим, из чего состоит обвязка.

Читать далее

Скидки, сделки и секреты: как я дообучал NER-модели для маскирования

Уровень сложностиСредний
Время чтения17 мин
Охват и читатели7.7K

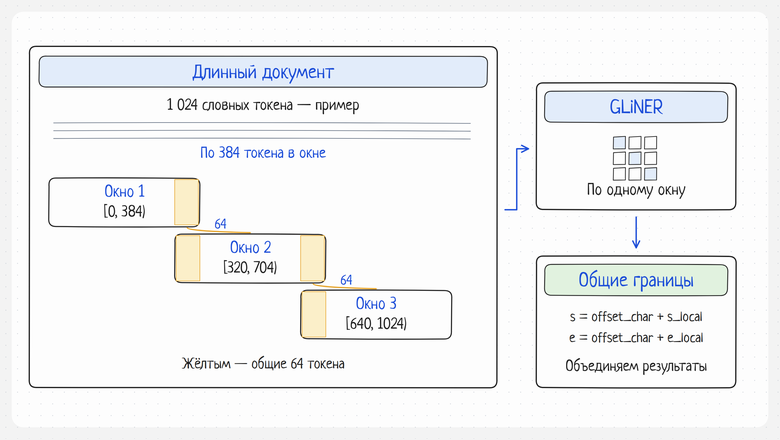
Дообучил GLiNER2.5 на 5 000 синтетических текстов и сравнил полное дообучение с LoRA, DoRA, rsLoRA и QLoRA. Для примера взял коммерческие условия: цены, скидки и графики оплаты. На коротком тесте Exact F1 вырос с 22,51% до 94,13%, а обучение на разметке DeepSeek дало 95,62%. Также проверил Qwen и Gemma с NER-головой и обработку длинных документов окнами. В статье — устройство эксперимента, ошибки моделей, замеры скорости и памяти. Код, данные и конфигурации опубликованы; результаты относятся к нашему синтетическому корпусу.

Читать далее

Корпоративная база знаний на базе ИИ

Время чтения21 мин
Охват и читатели9.9K

Корпоративная база знаний на базе ИИ отвечает сотрудникам на вопросы по внутренним документам компании и показывает, откуда взят ответ. Строится она по схеме RAG — поиск нужных фрагментов плюс языковая модель. Это руководство для архитектора: из чего состоит стенд и где его разместить, сколько ресурсов нужно каждой модели, как выбрать хранилище и посчитать среду, что проверить до запуска и где обычно совершаются ошибки.

Читать далее

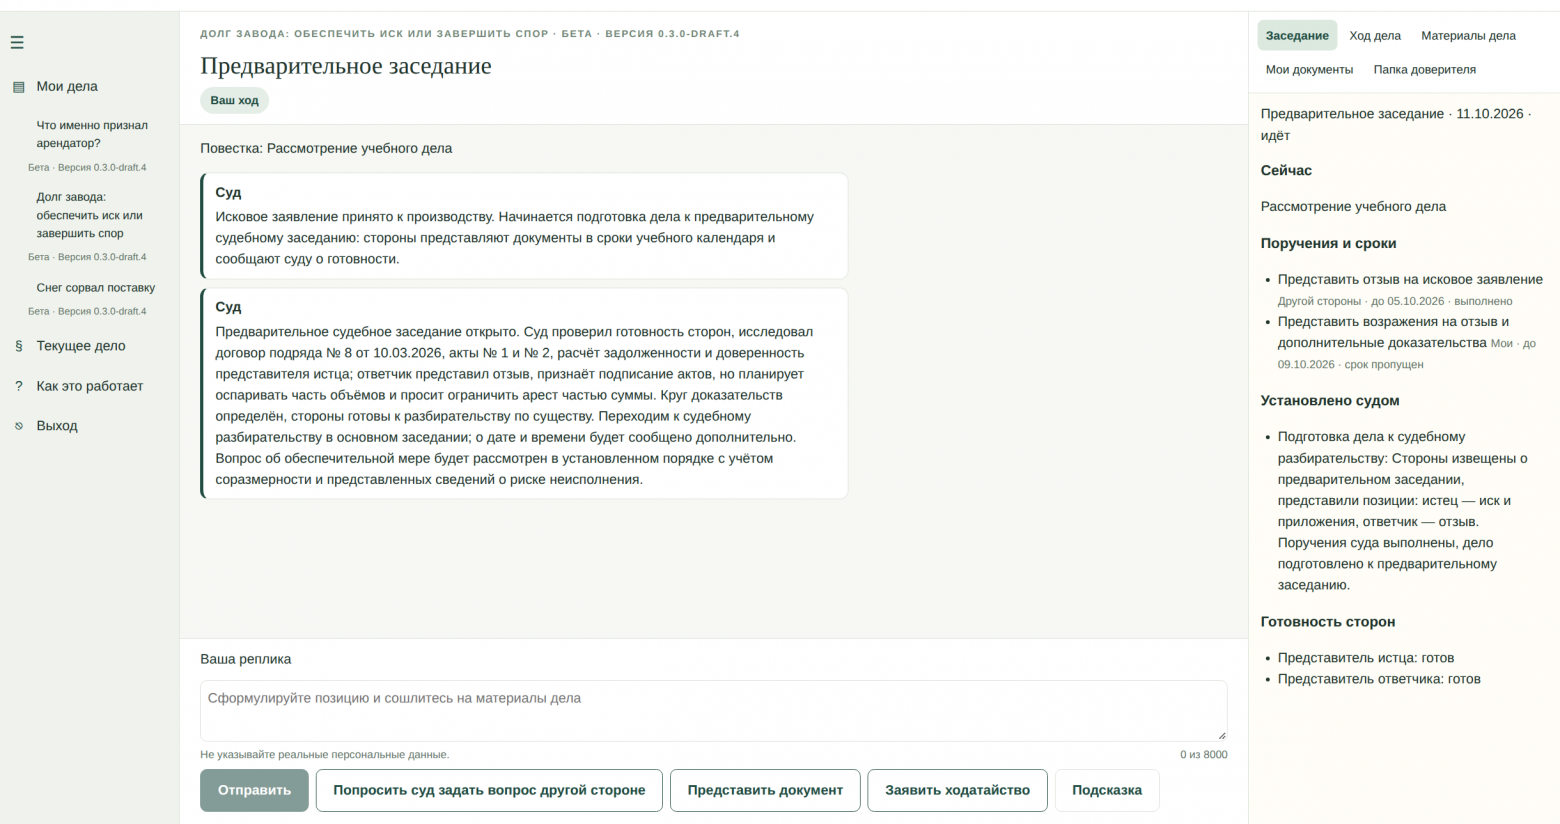
ИИ‑тренажер судебного процесса ChatCourt

Уровень сложностиПростой
Время чтения10 мин
Охват и читатели8.4K

Привет, Хабр!

Представь обычное домашнее задание в вузе. Преподаватель просит нейросеть составить задание, студент отдаёт её своей нейросети и сдаёт готовый ответ, а проверяет работу снова нейросеть. От подготовки задания до проверки получается переписка ИИ студента с ИИ преподавателя — ирония в том, что это может быть одна и та же модель. А люди в такой переписке только передают тексты друг другу и выступают в роли живых прокси. Конечно, так бывает не всегда и далеко не все преподаватели составляют задания нейросетью, и не все студенты решают с ее помощью домашние работы. Но и редкостью такой сценарий уже не назовёшь. При этом, запрещать чат-боты бессмысленно — они уже часть нашей повседневной жизни, как интернет и смартфоны.

Читать далее
1
23 ...