Комментарии 510

Предвижу бурю...

Смотрел тут на просторах небольшие обзоры, некоторые даже видео закончили со словами "чёто-как то" на 3 минуте.
Пока возможно буря отменяется. Что будет дальше буду смотреть, но предвижу, что в проф работе и в тяжёлых проектах пока рановато.
Кстати в указанных проектах немного забыли про то, что это всё экосистема со сквозным пайплайном.

Вы попробуйте запустить, это как бы СИЛЬНО не аналог

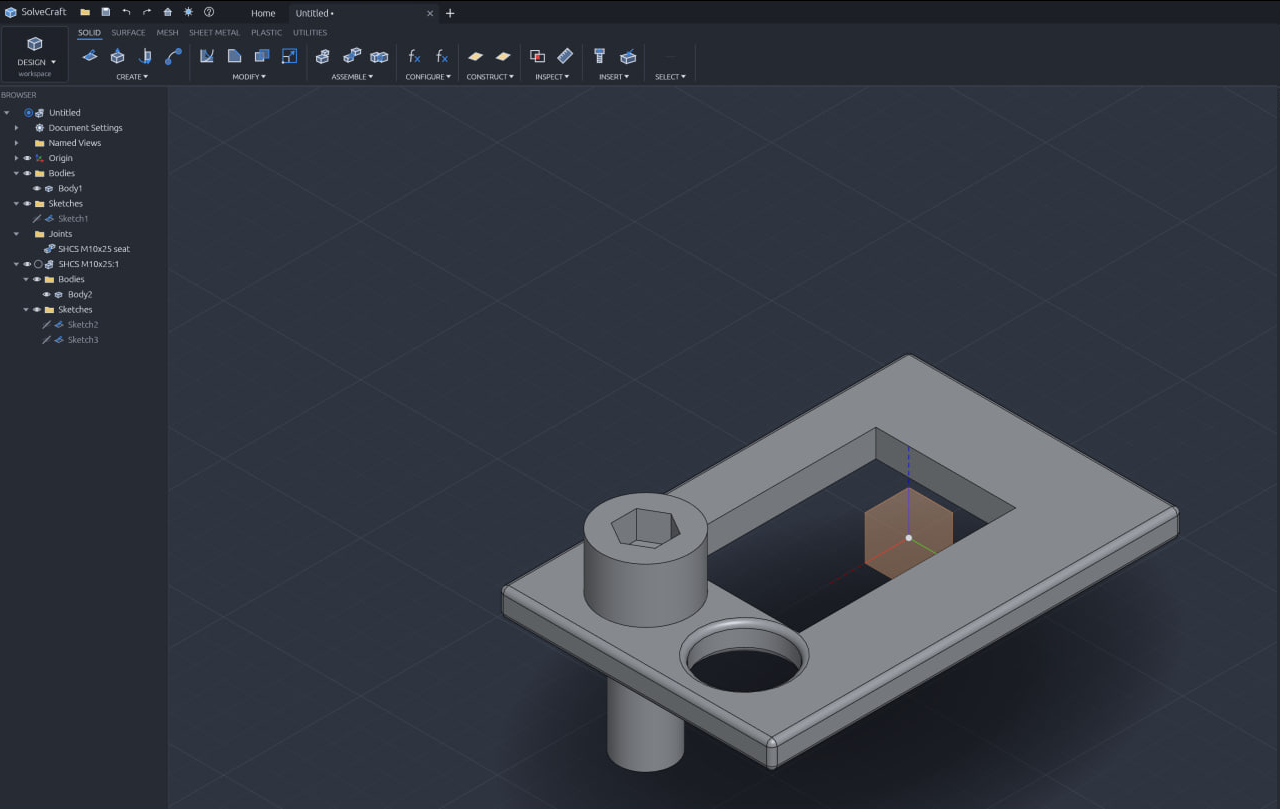
Я попробовал аналог Fusion360 (solvecraft). Оно вообще не оригинал.
В чертеже нельзя выставить расстояние от круга до линии. Да и в целом с проставлением размеров проблемы. Нельзя создать чертеж на плоскостях модели. Констракшен линия (штрих) есть и ее можно провести от точки до точки, но Midpoint (находит центр этой констракшен линии и по нему двигает всю конструкцию к выставленной точке) не работает, просто не видит центр линии. Ну ладно, с горем пополам что то построил, выдавил даже. Чамфер/филет, ну или фаска по русски, не работает на торцах! в этом софте просто нельзя выбрать торцы как таковые... Можно на всю стенку наложить фаску и оно само все обработает, но только там где стенка простая. Если на стенке есть отверстия то оно не работает. Тут же выбрав больше одной поверхности начинаются лаги, выбирать другие тяжело + перестает работать их подсветка.
Но хорошее тоже есть! Оно работает, оно на 70% Fusion 360, работает ужасно плавно, фьюжен с пустой сценой на 16 ядрах и 32 потоках с частотой 5,4ггц не так быстро работает как эта поделка. Что то совсем простое и базовое сделать можно.
Если это чудо доработают, то я не думая перейду с фьюжена который с каждой обновой все более тормозной и проблемный.

Хаха, вы сейчас только что FreeCad. Он мне безумно нравится, но хоть он и не написан нейронкой, багов там вагон и маленькая тележка.

Не хотелось бы оскорблять замечательных людей разрабатывающих FreeCad (глубочайшее уважение этим джентльменам). Но FreeCad против Fusion это трехколесный велик (у которого на ходу отваливается то руль то педали то сидение) против Lamborghini. При всем уважении, но я считаю что инструментом нужно пользоваться , а не бороться с ним. Искренне надеюсь, что однажды у них выйдет отличный продукт, но пока для меня он уд больно сырой

чет разнесло с такого сравнения
Полностью со всем согласен. Но для несложных задач "для дома и семьи" у него есть важное преимущество: не нужно кряков, ставится почти на любую систему и как-то работает. Можно допиливать скриптами. Меня в одно время просто очень сильно стал напрягать тот факт, что полноценные пакеты мало того что не на любой комп поставишь, так еще и кряк если неправильно поставился - систему проще снести и все заново. Для cam можно завести отдельный powermill на специально выделенном компе, настроить его и только там использовать хоть по удаленке, а вот "попроектировать" иногда хочется на любом компе без особых плясок с бубнами.
Седло отваливается, руль отваливается, но едет? Едет)) А "на выход в свет" конечно лучше ламборгини раз в месяц из гаража выкатить.

Такое же мнение сложилось от него. Ни Fusion360 ни Solidworks ни даже Компасс3д такого ощущения постоянной борьбы с ПО не вызывали.

По моим ощущениям он сильно изменился с версии 1.x
Стал гораздо лучше и по стабильнотси, и по удобству.
Возможно, использование нейросетей помогло.
FreeCAD v <=0.9 и FreeCAD v >1 - существенно разные программы. Но, наверное, проблемы с ранними версиями в памяти останутся надолго.
Не. С версии 1 вылез такой багище, что я побежал его сносить сразу. 0.2 версии работали хотя бы. А это инструмент "тонкая оболочка". Ну безумно же удобный инструмент, рисуешь кубик, делаешь ему оболочку и вот тебе готовый корпус со стенками, только крепления пририсовать. Просто сыпет кучей ошибок и иногда крашит весь кад. Я пошел в профильные форумы - там предлагали копировать обьект, копию масштабировать в более мелкую а затем применить булево вычитание. Так оно конечно можно, да. Но это уже насилие над здравым смыслом. да и не все корпуса прямоугольные и если геометрический центр обьекта не совпадет с центром координат появляются стенки разной ширины, вплоть до отрицательной и все падает. Починили или нет, мне неизвестно. Вот такие ужасы обновлений =) Сейчас у меня 0.20.2 и она стабильная черт возьми, по меньшей мере в ней все работает как заявлено, и шестеренки и сборка через a2plus...
Хм, только что проверил. Версия FreeCAD 1.1.4, просто последний релиз, я обычно такими пользуюсь.
Чтобы сделать "тонкую оболочку"
1) нажал на иконку Additive Box
2) на кубике выбрал одну поверхность, которая будет открытой
3) нажал иконку Thickness
получилась коробочка.
Вроде бы секунд 20 на это ушло. Нечасто коробочки из кубиков делаю, можно было бы и быстрее.
Верстак Gear у меня работает нормально. По крайней мере с эвольвентными шестерёнками и рейками проблем у меня точно не было.
a2plus - про это не скажу.
Ubuntu 26

Теперь он solidcraft называется. Похоже не только правится функционал, но и название

так переписывают ИИ осенью 2026 если особо ничего не делать. мой опыт переписывания - после получения первой версии, силами мясного прокси за пару часов находятся куча несоответствий, нейронка это все превращает в тесты (gates) и за несколько таких итераций получается что-то похожее на рабочую версию. ну т.е. главный и по сути практически единственный вопрос когда хочется что-то переписать это придумать сценарии тестов.
чтобы минимизировать человеческую работу, неплохой способ для этого - если есть документация/учебные материалы/лабы/прочее - это все можно превратить в тесты самой ИИ и тогда дело пойдет бодро и меньше будет ломаться с каждой доработкой

Да вроде нет тут бури, буря будет когда люди с предметными знаниями начнут пилить аналоги, условный проджеклид, который работал над фотошопом/вордом и пр, лет 10-20, начинал еще с простого девелопера, и вот он с ИИ может быстро навайкодить "аналог"

Люда, нам...

И это он может...

А альтиум дизайнер можно?
А может, лучше ну его? Закопать? За такой юи руки надо отжигать плазменной горелкой.
Причем я только про юи, даже не касаясь того, как оно тормозит с самого запуска на вроде нормальных компах.

Про ui расскажите пользователям которые ещё не перешли с pcad)
Какие есть альтернативы?

KiCAD

Сadence allegro, например

Мне DipTrace понравился, но я не профессионал, так, для себя что-то пробовал :)

У Ментор График Экспедишн UI вообще жесть, Альтиум сказка с ним в сравнении

угу, а потом искать, почему у меня связи между падами перепутались из-за краевого случая сортировки каких-нибудь объектов
Нет, спасибо :D То, что проверено годами, кучей пользователей, профи заменить сложно

kicad существует. Альтиум имеет недостаточно функционала по сравнению с каким нибудь ментором, но при этом сложнее и не дает больших преимуществ по сравнению с открытым kicad. А копировать ментор... Крайне сложная и вероятнее всего бессмысленая задача, кому он нужен, за лицензию готовы платить.

Вот только KiCad жрёт память как не в себя. 2...3 ГБ ОЗУ на пустом проекте - для него норма. В итоге браузер с сотней вкладок, STM Cube, пара мессенджеров, PDF Reader с кучей документов и 3...5 одновременно открытых плат кладут компьютер на лопатки.
на пустом проекте KiCAD 2...3 ГБ?
Я открыл проект - 680 МБ ОЗУ
открыл схему, открыл двухслойную плату 180x125 мм - 780 МБ.
Version: 9.0.7, установлен пакетом snap
ОС - Ubuntu 26
Тоже приходится запускать KiCAD, FreeCAD, VS Code, Qt Creator, браузер. И порой выбирать, что из этого держать открытым, а что уже закрывать.
И желательно solid works и vivado. И человеческий порт на линукс.

солид с кряком на рутреке есть за 2025 год ОК. и на линуксе стабильно все работает.
я сомневаюсь что даже с нейронками что то открытое появится скоро или когда-либо, все же солид это не просто рисовалка (хотя нормального стабильного открытого простого CAD до сих пор нет, это да)
Для большинства достаточно базовых 2D и 3D функций, которые не так что бы сложно реализовать. Если кто-то выпустил нейрослопную версию Autodesk Inventor или солида, я лучше это попробую, чем кривущий FreeCAD
веб-версий я только на хабре три разные помню
с 3Д проблема в том что там не катит "вайб" а гораздо важнее точная математика и потому все попытки родить ежа упираются в уровень компетенции кожаного в первую очередь.
А потом уже имея корневые проблемы на уровне архитектуры дальше развивать все сложнее и сложнее и проекты подвисают
Да это понятно. В любом случае 95% задач по типу смоделировать корпус, сломавшуюся деталь, заглушку и прочую мелочевку закроет и простейшая float точность. Очевидно, что компании, которые и так платят за лицензию не перейдут на бесплатный "аналог", ибо важнее качество работы, чем поддержка linux или открытый код.
я годами использую tinkercad для простых вещей
хотя сейчас благодаря AI я наконец-то без проблем имею доступ к солиду на линуксе и это очень просто для всяких мелочей, даже проще чем tinkercad благодаря широким возможностям

я полгода назад перешёл на линукс, и как-то средненько работает SOLIDWORKS через VMку, ибо нет графического hardware acceleration-а - так что как это - "без проблем доступ к солиду на линуксе"? у меня графика рисуется процом, так что всё страшно тормозит

хотя нормального стабильного открытого простого CAD до сих пор нет
Открытый не открытый, но бесплатный Fusion 360 покрывает большинство задач 3D моделирования.

А где аналог Adobe Flash ?

А ты хорош

Так был же Silverlight, который MS позиционировала как убийку Adobe Flash. Правда и он сейчас там же где и Adobe Flash...


Я тоже хочу Adobe Flash. Только не Adobe Flash а еще Macromedia Flash.

Silverlight?
Опередили ) Тогда Moonlight.
Что-то на ночь глядя повеяло кладбищенскими историями, если вежливо сформулировать.

Ruffle


Также в более ранней стадии разработки находятся WordCraft, GridCraft, DeckCraft (аналоги Word, Excel и PowerPoint)
Немыслимое кощунство, даже на преподобный Микрософт покусились, ну ничего святого у этого ИИ.


Ворд кстати сносный, не хуже “отечественных аналогов”.

Ну хуже отечественных аналогов только ворд для Линукс.
Кстати, пните, если навайбкодят нормальный офис для Линукс

Ну для невызыскательных - OnlyOffice может сгодиться. По крайней мере там хоть интерфейс не так страшен как у либры.
И, к слову сказать, один и тот же файл 1.5Мб, 400+ страниц в MS под виндой практически не ворочается (конкретно - надо было в режиме рецензирования быстро пробежаться по правкам), а в OnlyOffice под линукс да же на более слабом компе с ним удалось более-менее работать.

Меня когда-то давно Р7 офис удивил, но я тогда не был особо требовательным. По крайней мере, визуально он мимикрирует достаточно сильно
Не пробовал. Мне от офиса не сильно много надо. Сам не пишу, надо только в ТЗ работать. А там нужно чтобы было удобное оглавление и режим прохода по правкам. В либре все это крайне ублюдочно реализовано, в Only меня устроило, остальное не стал перебирать уже.
Наши документы он отображает адекватно, работать тоже ним вполне нормально. Интерфейс отторжения не вызывает. Так что оставил его на линуксовой машине.

R7 это и есть Only, а с 23 года - независимый (наверное) форк.

Продолжительное время сидел на ЛибреОфис, потом перешёл на гуглдокс, которого для моих потребностей за глаза и за уши хватает, плюс командная работа.

>Ворд кстати сносный
Так неповторимый оригинал и сам сносным не назовёшь. Если делать хоть что-то посложнее простыней текста, то уши у окружающих сворачиваются.

Пользоваться этим поделками невозможно. Что такое контекстное меню эти программы не знают, но, главное, постоянно падают минут через 10 работы с несложным проектом. Хотя внешне выглядят хорошо.
Утечки накапливают, вероятно
Пару недель назад смотрел видео, где чувак игру навайбкодил.
Запустил, понравилось даже. Был в восторге - до чего дошла технология ии, но через две минуты браузер закрылся со словами память кончилась, милорд

Вы ему об этом сказали, чтобы он пофиксил?

А он сам свою поделку не запускает?
Ой, вы с такими аргументами осторожно, а то так ведь про любой софт можно сказать... Ну и "у меня все работает" это как бы была классика задолго до вайбкодинга.

Может у разработчика 128 Гб оперативы?

Как геймдев разработчик (в прошлом профессиональный, а сейчас время от времени сам для себя что-то пилю) могу с 99% уверенностью сказать что нет, не запускает.
Когда делаешь игру, за время ее разработки она успевает осточертеть. Потому что ты начинаешь с мечтой "о вот ща сделаю игру в которую сам хочу сыграть". Но потом после стотысячного перепрохождения одной и той же сцены для отладки ты уже играть в нее не хочешь вообще. Ты там все изучил вдоль и поперек, наигрался, никаких интересностей или неожиданных находок для тебя там нет. И тебе кажется что все уже привычно и перестаешь обращать внимания на мелочи или пробовать каждый возможный вариант.
А в них баги и прячутся.
В итоге нормально тестировать собственное поделие разработчик неспособен. Ничто не заменит тестирования с живыми пользователями, которые видят игру в первый раз.

Поддерживаю. Ещё лучше - давать проверить продукт детям/подросткам. Просто потому что они могут залезть в такие дебри и наворотить такого, что ни один взрослый даже не подумает. Я так в 10 лет нашёл в Deus Ex очень серьёзную штуку, практически чит. Просто потому что мне было интересно потыкать и посмотреть что получится XD

И это хваленый Rust, а не ногопрострельный Си...
Вероятно. Давным давно один мой знакомый из Adode подарил мне свеженький диск с Illustrator. Начал в нем работать... Такая же история - через 10 минут падает. Написал ему. Он поблагодарил и сказал, что передал дальше для исправления бага, описал баг похожими словами типа "утечка".

У меня иногда бывало нечто в этом роде с LibreOffice. :) Открываешь какой-нибудь Word’овский или Excel’евский файлик - а не открывается, тупо виснет. :(
Либра вообще творение каких-то укурков. Во всех отношениях.
Забавно, что давным-давно OpenOffice.org (офисный пакет, не сайт) в плане стабильности работы был несколько лучше.

Может и так, но плюсы есть. На больших файлах, когда надо постоянно копировать-вставить, либровский Writer гораздо отзывчивее Wordа (как минимум старых версий, про 2021 и 2024 не знаю).

У людей, которые делают все эти Open/Libre офисы, как будто нулевая мотивация ими заниматься или нет финансирования вообще, они сами своими продуктами, кажется, вообще не пользуются, там dogfooding просто отсутствует. Иначе я не могу объяснить выбешивающие баги, которые годами (десятилетиями) не исправляют. Невозможно просто пользоваться своим продуктом и терпеть всё это.
Вот агентов им в помощь, этим ребятам точно уже нечего терять.
Ну это же по сути проба пера и совсем грубый способ, а теперь представьте что люди с пониманием предметной области и опыта разработки того же фотошопа возьмутся за дело, например какая то бывшая команда или бывшие сотрудники, эффект будет совсем другой.


Ага. Нюанс лишь в том, что год назад (даже полгода назад !) о чем-то подобном и помыслить было невозможно, а сейчас мы обсуждаем их юзабилити. Что будет лет через 5, даже представить себе не могу.

Нюанс лишь в том, что год назад (даже полгода назад !) о чем-то подобном и помыслить было невозможно
Правильней было бы сказать, что нюанс лишь в том, что год назад (ну, почти) выпустили Opus 4.5, с которого и стартовала вся это мода с написанием клонов всего подряд. Уровень слопности таких проектов, впрочем, снизился незначительно за это время.
через 5 лет эти офисы нахрен никому не будут нужны. Компьютеры сделали для людей чтобы избавиться от рутины и ускорить процессы. Появилась другая "рутина" - документы, программирование. Сейчас активно хоронят программирование, однако при этом забывают что и цель написания программ - различный прикладной софт, тоже активно сокращается, но уже с другого конца. В итоге вы нагенерируете уйму альтернатив для ворда, экселя, адоба, только вот пользоваться ими никто уже не будет - процессы где они были востребованы (где были задействованы пользователи) уже возьмут на себя нейросети.

ну и винду до кучи запилили бы

Начало анекдота придумалось:
Звонит Линус Биллу ...
И говорит - Билл, у меня твои утекшие исходники винды не собираются
Билл - Да они у меня тоже не собираются!
Линус - ИИ писало?
Билл - Угу.
Линус - попробую переписать линукс через ИИ.
Прошла неделя
Билл - у меня теперь твой линукс не собирается. Тоже ИИ?
Линус - Угу.
(По мотивам известного анекдота “Допилить напильником”)
И говорит:
Линус - Собираю твои утёкшие исходники винды, MacOS получается. Как так?
Билл - Да не внимательно читаешь Readme.md. Попробуй ещё раз, но чётко по инструкции!
Через некоторое время Линус опять звонит и говорит:
Линус - Перечитал, собираю по инструкции, теперь Убунта получается. Скажи уж наконец, что делаю не так?
Билл - Да говорю же, не внимательно читаешь. Видишь, на 701 странице написано: “Пропатчить блобами”

Скоро софт будет выпускаться без документации, а обучение будет идти в защищенных от прослушки помещениях со строгим досмотром и изъятием всех мобильных устройств.

Не будет. Время платного софта для масс ушло навсегда. А специализированный софт, который будет генерироваться под конкретную бизнес-задачу, никуда не денется. Более того, наконец-то перестанут подгонять бизнес под возможности софта, и начнут подгонять софт под возможности бизнеса...

А возможности бизнеса по генерации решений с высокой долей энтропии практически безграничны...

У нас никогда его и не было, либо пиратский, либо покупали для работы, кому нужно было.

Время платного софта для масс ушло навсегда. А
...токены типа бесплатные, ога.

Пока жив SAP - не перестанут подгонять бизнес :))

Нда, такое впечтление, что бизнес на разработке софта становится высокорискованным и низкомаржинальным.
1. Если у вас в софте нет глубокой экспертизы, то ваш софт могут повторить.
2. Если у вас в софте есть глубокие экспертные знания, то ваш софт могут декомпилировать до исходников или взломать.
Скептикам советую повспоминать, что был год назад, и подумать, куда это все катится.
Не могут повторить. Это примерно 2% от заявленного софта. Хотелось бы увидеть остальные 98%, но не увидим. Реально ускорилось только прототипирование.

Миллиард лет анекдоту "Ищем пхп программиста написать гугл, 2 странички, на первой инпут поиска, на второй результаты, 1000 руб".

Сейчас криво косо, но получаются копии сложнейших программных продуктов, которые разрабатывались десятилетиями и вряд ли на это тратится сотни тысяч долларов. Если такой софт переписывается уже сейчас, то сделать клон более простых програмных продуктов вопрос желания и пары сотен/тысяч баксов. И то, через пару лет уже будет сотни/десятки. Да, очевидно это все ещё демки, но и год назад нейронки даже и близко так не могли.

У Гугл АИ оценка теперешней стоимости вайб-кодинга проекта уровня Adobe Suit - 45 млн. $
Т.е. всё что сильно дешевле - это либо сильно урезано, либо АИ декомпиляция.

Это работает при условии, что у технологии нет пределов в развитии. Раньше и про космические полёты аналогично фантазировали: "сегодня на Луну слетали, а через два года - на Марс полетим".

Ну, формально, на Марс можно хоть завтра лететь — вопрос только зачем
Как это зачем? Яблони садить.

Так формально можно и под каждую слоп-поделку выделить мегаваттный датацентр. Вопрос будет тот же.

Вроде нет - технологически слетать на Марс человеками и вернутся обратно пока не можем. Теоретически для химический ракетных двигателей Марс вроде бы возможная цель, но где-то на пределе. Дальше на спутники Сатурна или Юпитера нужны двигатели другого типа.

Вопрос количества топлива, количества ступеней и длительности полёта. Дорого просто очень.

Там не просто дорого. Достигнутого нашими технологиями дельта-вэ, чтоб туда слетать и вернуться - не хватит. Т.е. на Марсе обязательно должна быть дозаправка. А как это организовать - есть только в самые общие идеи.
Можно заранее ракеты с топливом предварителньо заслать,
Да хватает всего. Ещё СССР Н1 изначально для пилотируемых полетов к Марсу разрабатывал. При чем посадка/взлет с Марса по сложности не сильно превышает луну.
Первая космическая луны - 1,68 км/с
Марса - 3,55 км/с, вроде бы в 2 раза больше, но и топливо на торможение почти не требуется - атмосфера сделает большую часть работы
Радиация? Если задача слетать туда-обратно, то не критично.
Продовольствие? Пару тонн не особо много в масштабах космического корабля.
Просто никому это нахрен не нужно. Слишком много усилий ради флаговтыка.
Максимальная delta-V Н1 с натяжкой и в теории была 15 км/с. И это в принципе максимальная характеристическая скорость ракеты достижимая на современных технологиях (может Маск выдаст больше - но опять-таки пока в теории).
А чтобы слетать до Марса надо:
выйти на орбиту Земли - это уже 10 км/с минимум (атмосфера, потери на “гравитационный манёвр”).
Долететь до Марса - 3,5 км/с, итого остаётся полтора.
Посадка на Марс - порядка киломктра в секунду (это с учётом ароторможения!) - остаётся пловинака
Старт с Марса -порядка 2 км/с- уже полтора не хватат. Всё приплыли.
Так что Н1 до Марса ещё как-то долетала, а вот обратно - точно нет. Есть идеи по сборке и заправке кораблей на орбите (Старшип, кстати - туда же). Но это пока идеи, т.к. речь идёт о таких объемах топлива, которые на орбиту ещё никогда не возили и в условиях невесомости не перекачивали.
Да, сборка корабля на орбите. Сложно, дорого, но космические станции строят же. Для покидания низкой орбиты и соответственно торможения у Марса не требуется огромной тяги, виток за витком с ускорением 0.5 м/с2 вполне себе можно, то есть огромная жёсткость не требуется. Единственная сложность - да, перекачка топлива. Но это все равно больше инженерная задача, а не научная. Все технологии уже существуют.
Дельта вэ в первом приближении зависит от характеристик топлива и количества ступеней (Вернее отношения массы нагрузки к стартовой массе). По второй составляющей никакого теоретического потолка нет.
Дельта вэ большая не нужна, но нужно подобрать гравитационные манёвры, это может удлинить экспедицию. Пристегнуть на орбите разгонные блоки особого труда не составит. Те же разгонные блоки можно доставлять на орбиту марса в автоматическом режиме. Часть необходимая для обратного полёта как и на луне на поверхность не спускается.
По второй составляющей никакого теоретического потолка нет.
Кроме прочности материалов.
В каком месте, поясните? Между орбитами никаких сколько нибудь значимых нагрузок нет. Остальное решается сборкой на орбите. Да и в остальных местах предел не достигнут.
Вам сюда.
Там где автор того опуса учился я преподавал. Там вся портянка сводится к тому, что ракеты это концептуально дорого измываясь над совой с помощью глобуса. Тезис спорный, однако я его даже не пытался опровергать.
Чо сказать то хотели?
Чо сказать то хотели?
«Физика, бессердечная ты щука!»
Какой закон физики запрещает выводить корабль на орбиту по частям и собирать его там?
Хотя потолок размера ракеты и массы выводимого на орбиту груза тоже явно не достигнут. Да рост выводимого груза не факт что будет прямо пропорциональный, но он явно будет. А может даже будет больше линейного.
@ksbes Наилучшее отношение топлива к сухой массе как раз и определяется “пружинным пределом”
А кто говорит про наилучшее соотношение? я говорю что предел массы вывода на орбиту вряд ли достигнут. т.е. условно - можно сделать ракету в 10 раз больше, а полезная нагрузка увеличится в 2 раза. К любой существующей крупной ракете скорее всего можно пристегнуть дополнительных твердотопливных ускорителей ценой незначительной модификации.
Но куда проще запустить несколько ракет и собрать всё на орбите. Тут практически идеальное линейное масштабирование гарантировано.
Т.е. это всё решается при наличии достаточного количества бабла. Бабла существующего в природе. Например на деньги вбуханные в ИИ можно запустить 10 000 (десять тысяч) старшипов в одноразовом варианте. И еще останется на разработку и допиливание.
Давайте для начала определимся, о чём мы спорим‑то. Возможно ли поднять бандуру из гравитационного колодца? В принципе — возможно. Будет ли это доступно? Нууууууу.... It depends!
Возможно ли поднять бандуру
Это какой-то особый вид слепоты? По какой причине проигнорирован первый абзац моего предыдущего коммента?
Будет ли это доступно?
Космос сильно подешевел в технической реализации. И свойства материалов тут не при чем. Материалы теже (хотя тоже некоторый прогресс есть). Там где во времена аполлона нужно было нанимать тысячу пильщиков напильником стопицотого разряда, которые с горем пополам делали одну деталь с сотой попытки, сейчас пара станков чпу делает гораздо точнее сразу партию с гарантированным качеством. И вместо одной ракеты сегодня за теже деньги можно произвести десяти или сотни. Сопроматовские расчеты тоже радикально подешевели.
Цены держатся на коррупции и архаичном руководстве. Но к физике это никакого отношения не имеет. И частники уже поджимают.
Другое дело, что на полётах человека что на луну, что на марс денег особо не сделаешь. Для понтов одновременно дорого и беспонтово. Для туризма дорого, Для науки дорого. Для промышленности и всего остального абсолютно бесполезно. Вообще полезных применений космоса можно пересчитать по пальцам. И практически все они держатся по сути на коррупции препятствующей развитию более эффективных наземных альтернатив.
В общем, я уже перестал понимать, о чём мы вообще спорим. Я говорю о том, что свойствами нашей Вселенной в космическую технику заложен предел, превзойти который принципиально невозможно — и это то самоё максимально возможное delta-V. Да, на нынешнем уровне технологий до предела ещё далеко — но он есть, как приснопамятный суслик.
В общем, я уже перестал понимать, о чём мы вообще спорим.
и эти люди критикуют ИИшки.
речь шла о технологической возможности слетат на марс.
а я отвечаю, что это исключительно вопрос желания это мероприятие оплачивать.
потолок дельтави актуален для межзвёздных перелётов. марс от луны отличается даже не на порядок.
и то потолка как такового нет. просто из-за экспоненциального роста поднять скорость на порядок еще можно, а на 3-4 порядка уже превысит все ресурсы человечества.
Что не надо путать фантазии, пусть и инженерные и реальность.
Дельта вэ в первом приближении зависит от характеристик топлива и количества ступеней (Вернее отношения массы нагрузки к стартовой массе). По второй составляющей никакого теоретического потолка нет.
Нет. Просто нет. Вы не можете сделать массу пустой ракеты произвольно маленькой. Наилучшее отношение топлива к сухой массе как раз и определяется “пружинным пределом” - ракета должна не ломаться при ускорении и просто от давления топлива. Для идеальной ракеты - это даёт при текщих топливах теоритический предел дельта ве порядка 25 км/с.
Когда я прочитал и грокнул этот цикл статей, у меня вот прямо руки опустились. Это ж ещё один фундаментальный предел, записанный прямо в структуре нашего мира, который невозможно обойти никакими ухищрениями, к нему можно только бесконечно приближаться — второй такой же предел, примерно как скорость света. Кстати, у меня есть подозрение, что он ей равен с точностью до коэффициента.
Кстати, у меня есть подозрение, что он ей равен с точностью до коэффициента.
Это не подозрение это так и есть - по сути это с определённым коофициентом максимальная энергия электромагнитной связи двух тел (атомов). Т.е. чтобы его превзойти, надо научится делать детали из нейтрониума - материала нейтронных звёзд! (слабое взаимодействие … слишком слабое)
…ну или принести жертву богам Хаоса …
Тут возникает второй вопрос: можно, но за чей счёт банкет?

Знаете, если почитать какое-нибудь Пикабу, то можно найти кучу статей типа "некто из жигулей, монтажной пены и пенопласта сделал феррари". Проводя аналогию - этот кто-то должен легко изготавливать хотя бы базовые жигули с нуля?
Вы не забывайте, что сначала этим нейронкам скормили исходники всего, до чего дотянулись, с подробным описанием. Сделать очередной унылый клон того, что уже есть - не то же самое, что сделать новый программный продукт.

Стесняюсь спросить, зачем мне тратить пару сотен баксов чтобы сделать копию софта, который либо стоит копейки, либо можно найти на зелёных сайтах? Тем более что у почти любого софта есть опенсорс аналог, не лучше ли потратить токены на его совместное развитие?
у почти любого софта есть опенсорс аналог, не лучше ли потратить токены на его совместное развитие?
No genAI contributions! We have a strict no-genAI rule (be it for code, images, text…). We do not control what you do elsewhere, but please do not bring these tools in GIMP. And do not use your commit rights to stealthily add LLM-generated code or other similarly generated data, once you are able to push yourself. We trust you. Do not make us regret it.

Забавно. Гимп сам не страдает эталоном качественного софта. А так, могли бы и подтянуться.
Кто-то запретил сделать форк гимпа и развивать его своими силами?
База там так себе, если слизывать, то уж с оригинала, а не с поделки на коленке. Плюс лицензия может создать лишние проблемы на ровном месте.
Но тем не менее, он работает. А если слизывать с оригинала, проблем может быть не меньше - как минимум будет несовместим формат, потому что psd защищён авторским правом. В чём проблема с лицензией gimp у которого gpl я не знаю. А стричь денежки на очередной поделке когда "каждый сам себе программист", ну такая себе затея - опенсорс клон фотошопа или ии-форк гимпа хотя бы таких же фанатиков может привлечь.
Но тем не менее, он работает.
Шняга из статьи тоже работает, это не показатель.
Работает было сказано к тому, что пользователь уже привык им пользоваться. Собственно поэтому поделие из статьи и копирует внешний вид фотошопа и умеет открывать psd. Кстати странно, мне почему-то казалось что формат проприетарный, ан нет, он открыт для чтения. А вот насколько стороннее по хорошо его обрабатывает - вопрос открытый. Как и прочие приколы самого фотошопа вроде набора кастомных кисточек, плагинов и так далее. Хотя один фиг сейчас и Adobe вайбкодит как не в себя, остаётся только надеяться что там процесс нормально, как в условном гугле, налажен.
разрабатывались десятилетиями
Кмк разрабатывались они несколько первых лет. Потом - пилились.
Тот же МС офис. Для редактирования документов версия 97 года уже достаточно хороша. Но не закрываться же по этому поводу?
Ну блин, я наблюдаю все это сам на примере моей маленькой области.
То, что ранее требовало моей высокой квалификации в реверс-инжиниринге, теперь делает чуть ли не каждая обезъяна с ChatGPT, но быстрее и местами даже лучше.
Еще откуда-то декомпилировали и выложили в опенсорс ценнейшие исходники, которые скоро перевернут рынок с ног на голову.
Теперь каждый сам себе программист и как на всем этом много зарабатывать - не ясно.
Не вижу, почему бы те же самые механизмы не сработали в любой другой области разработки ПО.

Бесполезно. Люди инерционны. У некоторых еще стадия отрицания.
Теперь каждый сам себе программист и как на всем этом много зарабатывать - не ясно.
Тут недавно Delphi 1.0 вышла. Теперь каждый сам себе программист (ц)

То, что ранее требовало моей высокой квалификации в реверс-инжиниринге, теперь делает чуть ли не каждая обезъяна с ChatGPT,
Альтернативные прошивки синтезаторов? А то в августе началось.
Это при том что реверс-инжениринг во много был больше про “внимательность и трудолюбие” и тут AI просто вне конкуренции по сравнению с человеком, но ив целом на мой взгляд еще пара лет и привычная ИТ поменяется кардинально, я не уверен, что теперь у профессии программист есть будущее в привычном плане как это было еще лет 10 назад, за исключением тех областей где нужно много еще работать руками, типа embbeded/FPGA и пр.
Будут всё те же программисты. Просто одни будут программировать программы; а другие будут программировать агентов, что бы те программировали программы.
Почему нельзя использовать ИИ в областях embbeded/FPGA ? Мало данных для обучения?
Потому что осциллограф нужно руками к плате подключать, генераторы сигналов вручную включать, что то подпаивать и пр.

Да как бы уже антропик и openai работают с разработчиками тулзов для синтеза.
Инженеры себе делают тулзы для ИИ-шки, который диаграммы разбирают и показывают в исходниках баги. Wavepeek, например.

Можно.

Позавчера наш вечный двигатель крутился минуту, потом останавливался. Вчера он крутился уже пять минут. Сегодня десять. Скептикам советую повспоминать, что было позавчера и вчера, и подумать, куда это всё катится.
Как иллюстрация:
Important
Status: PhotoCraft is in early alpha, and we want to be straight about where it stands: much of Photoshop’s feature surface exists in some form, but it is not yet a Photoshop replacement for daily professional work. The biggest gaps are AI/generative features, 15 missing tools, depth in typography and pro workflows, and plug-in compatibility. Every Photoshop menu item is wired to a command (docs/parity-checklist.md), but that measures wiring, not behaviour. The honest, dimension-by-dimension picture and where we’re going next are in the roadmap and parity assessment. Expect rough edges, and please file issues (include your OS, document size, layer count and a screenshot). You can also tell us what broke on Discord.
У программистов это называется «Мы сделали первые 95% работы, теперь осталось сделать вторые 95% работы». Как человек, много работающий в PS CS6, могу сказать, что Фотошоп без моей библиотеки кистей, шейпов, градиентов и стилей мне не нужен. Я гляжу на скриншот со вкладкой Outer Glow и не вижу параметров фотошоповского Outer Glow. Т.е., как в советском анекдоте, «в некоторых параметрах Outer Glow сегодня потребности нет». Но это говорит, к сожалению, о несовместимости, так что пробовать ставить эту альфа-демку и грузить библиотеки бочками (в данном случае, .asl) смысла просто нет. А тем ещё и джаваскрипты, у тех кто работает в нём реально много и всё автоматизирует. Всякие однотипные операции.
Совершенно очевидный обман кроется за фразой, выделенной болдом. Если я и другие лемминги пойдём файлить тикеты со всеми расхождениями, то реплика в результате будет написана нашим человеческим интеллектом. А позиционируется это как «Мы сказали: сделай копию Фотошопа, и оно сделало!!!11».
Менее очевидный обман в том, что даже с кучей тикетов хрен что выйдет. Тикетами Фотошоп специфицировать (написать ТЗ) невозможно, для этого надо описывать алгоритмы. А тикеты будут вида «скачал с ДевиантАрта такую-то кисть или такой-то стиль для кнопки, и он не соответствует отрендеренной картинке автора».
Видимо, кто-то просто очень хочет успешное IPO.
Позавчера наш вечный двигатель крутился минуту, потом останавливался. Вчера он крутился уже пять минут. Сегодня десять. Скептикам советую повспоминать, что было позавчера и вчера, и подумать, куда это всё катится.
Это пять! Утащил в шкатулочку.

И что, термоядерный реактор вполне себе пилят, хотя каждый год все так же обещают ещё 30 лет и все будет. Бюджеты миллиардами успешно на него тратят, чем AI в этом плане плох... Точно так же можно десятилетиями бюджеты на него выделять.
С квантовым компьютером кстати примерно так же.
Разница в том что, на термояд или квантовые компьютеры тратится несколько миллиардов в год. А эти ребята требуют (не просят) несколько триллионов. И в этом на мой взгляд ключевая разница.

С квантовым компьютером кстати примерно так же.
Не вижу ничего общего. За квантовым компьютером стоит хорошо проработанная теория. Она объясняет, как параллелить вычисления с чудовищной эффективностью. А теории мышления нет.

Сильно не очевидно что ваш менееочевидный обман действительно обман, уж простите за тавтологию. Но у вероятностных методов всё-таки есть сходимость. Без сомнения вы не сможете загнать на каждую кисть миллион тесьировщиков, которые попробуют её и скажут где она расходится, после чего будет внесён фикс и опять сверка. Но вот миллион агентов можете. Тоесть я согласен, что это всё ещё скорее гипотетитечкая штука, но кажется что вопрос только цены, и цена стремительно падает.
Цена стремительно падает, пока платят инвесторы. Но как показывают последние события инвесторы, начали интересоваться: "А где деньги?" и просто так под фантазии деньги давать перестают. Их сейчас начали заваливать сообщениями о якобы "конце света", эпических взломах и вон как здесь написанных на коленке сложнейших программах. И у меня есть очень большие сомнения, что "большие дядьки" на это купятся.
Большие дядьки инвестируют не в замену кодерам, большие дядьки инвестируют в надежде первыми запрыгнуть в AGI, а там кто первый - тот победил.
Если что, уже можно крутить что-то что будет выдавать приемлемый результат со скоростью 200т/сек локально, тысяч так за 6-8, и думается мне, что цена будет падать раза в 2 каждый год-два.
А кто будет от четырёх до семи - восьми триллионов (если IPO случится) отдавать? Если пузырь взорвётся все останутся со своими маленькими локальными модельками, на которых только в крестики-нолики играть.
Ну взорвутся он и взорвутся, доткомы тоже лопнули, однако технологии никуда не делись, инференс явно будет дешевеет со временем, плюс киатйские модели стоят “копейки” а выдают качество не сильно хуже.
На мой взгляд еще пару лет на понимание/привыкание и все ИТ изменится, разве что эмбедед девелоперы не сильно пострадают, из-за того, что все-таки там нужно много руками работать, с платами сидеть.
Без громадных и очень дорогих дата-центров это всё это по сути не имеет смысла. Написания виндоуса на домашней RTX 5060 быстро станет отдельной формой мазохизма.
А что до технологии, уже давным-давно есть куча технологий которые вполне эффективны, но слишком дороги для практического использования.
Допустим так и будет все и ИИ пузырь лопнет, и технология останется дорогой, то будет еще хуже, это значит доступ к ИИ будет доступен крупному бизнесу, который будет выигрывать по эффективности у ручного труда и обычная разработка будет совсем нишевой.
На данный момент никто не доказал что ИИ разработка действительно эффективнее, даже при этих сверхдешёвых ценах. У большего бизнеса за свои деньги ИИ будет очень дорог и его использование в связи с этим будет очень ограниченно.
А зачем кто то будет кому то доказывать, индустрия просто меняется.
Доказывать никто никому ничего не должен, а вот прибыль приносить должны. И если что-то прибыли не приносит, то вкладываться в это не будут. И это "будущее" сдохнет, как и десяток до него. На данный момент никто из больших никаких финансовых успехов не продемонстрировал (кроме торговца лопат), если нет разницы то зачем?
Насчет прибыли я не готов спорить просто не знаю, спекуляций на этот счет полно, а читать реальные финансовые документы лично мне лень, но помню ровно такие же спекуляции были и про СпасеХ, Старлинк и пр, но получается что ваша линия зашиты это финансовая не техническая, если завтра будет прорыв и даже текущий ИИ станет дешевым (или останется цена для потребителя текущей) то индустрия ИТ меняется кардинально. С технической стороны нынешний ИИ при даже не особо грамотном использовании (когда его грубо просят повтори фотошоп) уже показывает результат.
Плюс повторюсь у нас есть китайские модели, которые показывают чуть хуже результат, но стоят дешевле. Я к тому, что выстраивать защиту за лишь финансовой стороной я бы не стал, вот если бы найти техническую (математически) причину, где бы мы точно сказали, что все здесь нейронки упираются в потолок тогда бы да можно было бы быть спокойными. Но походу UAT (Universal Approximation Theorem) не дает нам такой уверенности.
но помню ровно такие же спекуляции были и про СпасеХ, Старлинк
Разница в том, что все вышеозначенные, по сути своей были копеечные проекты (по сравнению с) и финансировались по большей части Маском и ещё несколькими заинтересованными лицами. И их провал вообще не имел бы никаких последствий ни технологическим, ни материальных. Здесь же мы говорим о суммах в пределе (если IPO случится) восемь триллионов долларов. Население земли около восьми миллиардов.
То есть, чтобы отбить эти деньги (даже без процентов) нужно чтобы всё население земли, включая стариков и младенцев, потратило на использование ИИ тысячу долларов. Я себе этого представить не могу, и это та самая математика. К тому же даже эти вложения не сделали весь тот бизнес рентабельным, то есть реальная цена токена, видимо в сотни раз дороже. К слову, что там у китайцев с рентабельностью их "дешёвых" моделей, вроде как никто не знает.
Я выше уже писал, возможно это пузырь и он лопается, построенные дата центы при этом не взрываются , обученные модели они уже с нами, просто кто то по дешевке выкупит наработки и железо, тоже самое что с доткомами.
остроенные дата центы при этом не взрываются
Не взрываются, просто их никто не обслуживает, за электричество не платит и новые не строит.
обученные модели они уже с нами, просто кто то по дешевке выкупит наработки и железо,
Купит и что будет со всем этим делать это всё может работать только в этих циклопических масштабах. Есть серьёзное подозрение, что если последнюю модель запустить, не на десяткe тысяч B200 , а например на ста, результат будет так себе.
построенные дата центы при этом не взрываются
30 лет назад построенные заводы тоже не взрывались. Однако фоточки из их цехов сейчас только в фильмы про сталкеров годятся.
Здесь же мы говорим о суммах в пределе (если IPO случится) восемь триллионов долларов. Население земли около восьми миллиардов.
Я не специалист в этом поэтому просто спрашиваю, разве это корректная оценка, в том плане что 1 трлн.. это же разговоры о рыночной капитализации или спекулятивной оценке рынка, ну типа как оценка имущества (рыночная капитализация) Илона Маска летом была 1.6 трлн. долларов.
, разве это корректная оценка, в том плане что 1 трлн.. это же разговоры о рыночной капитализации
То что я видел вся отрасль должна примерно от двух до четырёх триллионов долларов, именно должна разным кредиторам. То есть те деньги которые надо так или иначе вернуть, причём как минимум часть из них вернуть с процентами. Что касается IPO то это акции и участие в будущей прибыли (так по идеи должно быть). И здесь подводный камень размеров с Эверест. А именно как только компания становится публичной она обязана публиковать свою отчётность. И тут учитывая всё ситуацию, возможны нюансы.
если завтра будет прорыв и даже текущий ИИ станет дешевым (или останется цена для потребителя текущей) то индустрия ИТ меняется кардинально
Если. То несомненно, но пока его совершенно не видно.
С технической стороны нынешний ИИ при даже не особо грамотном использовании (когда его грубо просят повтори фотошоп) уже показывает результат.
Результат который, кроме пары гиков, никому не нужен. Хайпу уже пару лет и за это время никто не продемонстрировал хоть сколько-то успешного продукта. Даже блок-чейн при всех своих проблемах за первые пару лет показывал хоть какие-то успешные решения и продукты.
Не совсем понимаю что Вы имеете ввиду под успешным продуктом, продукты Майкрософт успешны? Вот в одном которым пользуются миллионы, уже процентов 90% кода пишется ИИ-тулами, а в целом по компании согласно заявлению Майкрософта такого когда уже 30%
Или недавно Линус расказывал как он с помошью AI дебажил баг в GPU
Не совсем понимаю что Вы имеете ввиду под успешным продуктом,
Для блок-чайна успешным продуктом можно считать биткоин, для электромобилей теслу. Здесь нет ничего подобного, всё свелось к ворду или IDE переростку который, чтобы заставить нормально работать нужно преложить усилия сопоставимые с просто написанием кода. Выхлоп мягко говоря никакой. Что до "больших" которые хвастаются, что у них всё на ИИ, так никаких новых шикарных продуктов, которые должны были политься как из водопада почему-то нет.
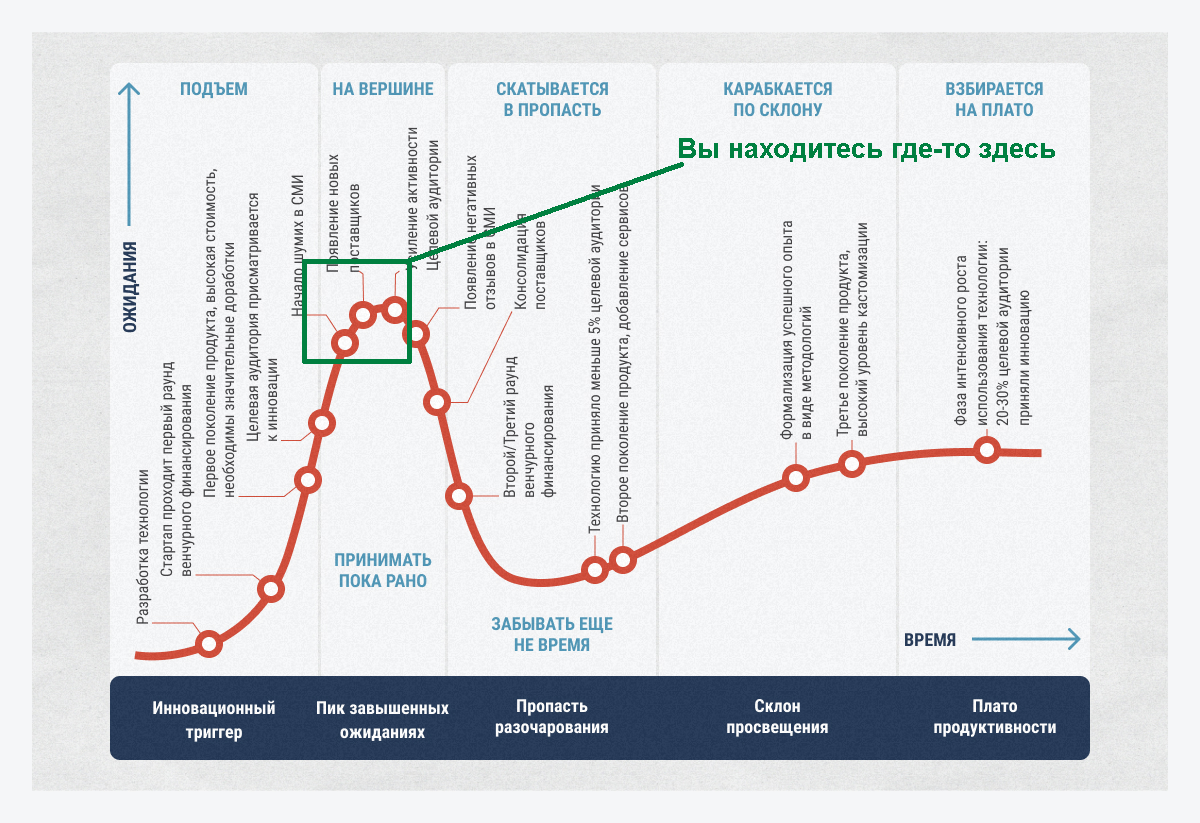
Ну смотрите тут напрашивается классическая “вы находитесь здесь” и в целом как много в принципе то новых продуктов выходит на рынок, хоть с ИИ хоть без него?
Еще пару лет назад говорили что ИИ даже катч тесты не умеют генерить, не умеют решать выпускные задачи по математике даже средней школы и пр. Второе повторюсь я не делаю и современного ИИ какую то волшебную палочку, более того я считаю что и-за UAT (universal approximation theorem) нынешний ИИ ограничен в рамках обучающих данных, но в рамках этих же данных он и всесилен, большая часть разработки программного обеспечения это решение уже решенных задач или чего то что можно решить с помощью имеющиеся решений, а тут мы загнали весь наш вербальный опыт в LLM.
Возвращаясь к софту, нынешний ИИ закрывает большинство задач разработки в том плане что ему ставят задачу он выдает результат (вынося за скобки размер промпта и выходного качества), это можно использовать в разработке существенно повышая свою производительность, многие рутинные задачи, написание тестов, форм ГУИ и пр, AI закрывает полностью. Смех смехом, но тут в статье пишут про аналог фотошопа, а не так давно Adobe заявляли что они активно используют AI для разработки и написания кода.
Ну смотрите тут напрашивается классическая “вы находитесь здесь”
Про "здесь" уже даже не смешно. Два года назад здесь на хабре были статьи, что через год программистов всех уволят, а через пять всех заменят человекоподобные роботы. И тоже рассказывали про "здесь".
в целом как много в принципе то новых продуктов выходит на рынок, хоть с ИИ хоть без него?
В мире висит в воздухе громадное количество идей для сложных проектов которые вполне прибыльно можно сделать. Если всё стало так легко и просто. Где например мобильная операционка от майкрософт с их то опытом по созданию операционных систем. Или от ред хат. Где конкурент спотифай от любого из брендов. Любой из "больших" (да и не больших всё же "просто") теперь легко может залезть на чужую поляну и отгрызть кусок. Тем не менее никто не лезет, очень странно.
вынося за скобки размер промпта и выходного качества
Дальше на самом деле можно не читать, потому, что именно этот момент убивает всю так называемую "эффективность". И видимо именно этот момент рушит всё экономическую целесообразность всей идеи.
Два года назад здесь на хабре были статьи, что через год программистов всех уволят, а через пять всех заменят человекоподобные роботы. И тоже рассказывали про "здесь"
Это игра в обе стороны так же говорили что ИИ ни когда не сможет даже решать зщадачи школьного уровня.
Где например мобильная операционка от майкрософт с их то опытом по созданию операционных систем.
А чем тут ИИ поможет если рынок уже за Андройдом и IOS? Какой смысл в новой мобильной операционке? Эти операционки и без ИИ пытались делать Самсунг, Интел, Блакберии и пр.
Дальше на самом деле можно не читать, потому, что именно этот момент убивает всю так называемую "эффективность". И видимо именно этот момент рушит всё экономическую целесообразность всей идеи.
Вы снова цепляетесь за экономку, если дело только в ней, то это вопрос времени, ну насчет эффективности, я вижу этот инструмент очень эффективным если с ним работать правильно и не ожидать от него магии.
А чем тут ИИ поможет если рынок уже за Андройдом и IOS?
Что рынок поделен это такое откровение свыше и предки так повелели.
Какой смысл в новой мобильной операционке?
Самсунг и прочие делали по сути форки от андойда (или линукса в широком смысле). Виндоус это отдельная среда с кучей неплохих идей и интересных патентов. Место для неё есть, и аппликаций в магазин тоже якобы можно легко написать.
Вы снова цепляетесь за экономку, если дело только в ней, то это вопрос времени,
Экономика является основой и то что противоречит экономике, не жизнеспособно. И если вопрос времени, когда по вашему мнению экономика ИИ сойдётся.
Это игра в обе стороны так же говорили что ИИ ни когда не сможет даже решать зщадачи школьного уровня.
Так решать он ведь и не может — он может тольцо цитировать, как люди решали эти задачи до него.
Согласен с формулировко, и софт он точно так же пишет как бы писали люди на основе обучающих данных.
Не просто "люди", а средневзвешенный человек. Ну то есть такой, который больше всех написал ответов на stackoverflow.
А гении там обычно не зависают.

А нерешённые до этого задачи он откуда цитирует?
А нерешённые до этого задачи он откуда цитирует?
Мне реально всё-всё надо обяснять?
В английском языке есть такая идиома — throw things at the wall and see what sticks, то есть «бросайте всякую хрень об стену и следите, какая из них прилипнет». Ну так здесь просто скомпоновали пулемёт Гатлинга, способный бросать гипотезы в стену с нечеловеческой скоростью, и детектор, который записывает, какая из них «прилипла».
А гипотезы из какого набора берутся, и как так получается, что там оказывается верное решение?
если данные не похожи на те что были в обучающей выборке то вместо аппроксимации у нас происходит экстраполяция
как так получается, что там оказывается верное решение?
В бесконечном наборе из случайных букв слов по определению окажется верное решение. Вопрос исключительно в том, как отличить его от неверных.
И вот в этом-то и заключается смысл «тренировки нейросети».
LLM — это эмулятор валящегося студента на экзамене: он «выдумывает» всегда — просто иногда «выдуманное» им совпадает с правильным ответом — и мы «ставим ему пятёрку»; а иногда является чушью различных степеней полноты — и тогда мы говорим: «это он галлюцинирует».
Все «настройки» и «тренировки» LLM сводятся к тому, чтобы тем или иным способом увеличить количество первых случаев и уменьшить — последних.
Так ведь нейронки не перебирают этот бесконечный набор случайных слов. Если они для задачи за разумное время выдают рабочее решение, уже нельзя говорить, что оно случайное — ну по крайней мере, не больше, чем у человека (который также и перебирает гипотезы в поисках той, которая «прилипнет», и ошибается-галлюцинирует вполне себе). И заявлять, что «ихние решения не решения» — махровый кожаный шовинизм. С тем успехом можно сказать, что вы бросаете на хабр тыщи случайных комментариев, некоторые случайно оказываются в тему ;)
Даже если это так (хотя это не совсем так, все таки число решений бесконечно), пользователю то какая разница был там чистый рандомный перебор по бесконечному множеству или экстраполяция сработала, если он получил результата которые его устраивает
пользователю то какая разница был там чистый рандомный перебор по бесконечному множеству или экстраполяция сработала, если он получил результата которые его устраивает
Ну вот пользователь и получил результат, который его устраивает: «Вам не надо платить НДС».
Правда, потом оказалось, что этот результат неверный.

Это, видимо, не все про генетическое программирование знают. ЛЛМ КМК после часов чтегия размышлений Квена примерно так же “решает” проблемы, только с фильтром, который отбрасывает 99.999% заведомо шлаковых вариантов.
Где например мобильная операционка от майкрософт
Windows Mobile ?
с их то опытом по созданию операционных систем
Ну, как опыт.. 1 (одна) ОС ;)
залезть на чужую поляну и отгрызть кусок
Spotify - там ценость не в коде. Там не за код деньги платят.
тут напрашивается классическая “вы находитесь здесь”
Ну да...
зачем кто то будет кому то доказывать
Чтобы продать.

Если я и другие лемминги пойдём файлить тикеты со всеми расхождениями, то реплика в результате будет написана нашим человеческим интеллектом
Оно и раньше так делалось в open source.
Кстати, посмотрел аналог word. Такие же мысли: они побежали клеить танчики в паритет по фичам. А надо было бежать в совместимость. Нет совместимости - нет использования. Нужна библиотека примеров, десятки тысяч тестов
А надо было бежать в совместимость. Нет совместимости - нет использования.
Есть подозрение, что настоящая совместимость, заблокирована, всякими интересными патентами. И поэтому лезут ни куда надо, а куда можно.

Настоящая совместимось заблокирована тем, что помимо стандарта есть реализация Microsoft Word, которую нужно воспроизвести 1-в-1, чтобы текст не поехал из-за того же рендеринга.
https://en.wikipedia.org/wiki/Office_Open_XML а публично описан "стандарт" только из-за того, что Microsoft лет 20 назад хорошо так прижали на пике войн форматов вокруг OpenOffice.org
Насчёт успешного IPO скорее всего Вы правы... Но с другой стороны кодекс самурая "не знаешь что делать - делай шаг вперёд" вероятно до сих пор единственный доступный человечеству путь в познании... Идея вкачивать петабаксы в процессоры и видеокарты в надежде что он сам себя доработает - смахивает на бред
Но с другой стороны кодекс самурая "не знаешь что делать - делай шаг вперёд" вероятно до сих пор единственный доступный человечеству путь в познании..
И с хорошей вероятностью провалиться в пропасть. С точки зрения человека как вида, это замечательно, остальные туда не пойдут, как минимум сразу.
Идея вкачивать петабаксы в процессоры и видеокарты в надежде что он сам себя доработает - смахивает на бред
Есть подозрение, что у них выхода нет. Весь бизнес крутится по сути вокруг одной компании, которой свои очень дорогие железки некому продавать. В реальной физической жизни никому не нужна видео карта за 30 тысяч долларов. Сейчас они пытаются создать новый рынок . Но уже есть очень серьёзное подозрение, что такого размера рынок никому не нужен, а остановится они не могут ибо будет крах.
Но с другой стороны кодекс самурая "не знаешь что делать - делай шаг вперёд"
Осталась самая мелочь: понять, где перёд.
Не нужно.
Для каждого отдельного самурая перед это то куда он в данный момент смотрит.
Миллион самураев сделает (каждый свой) шаг.
Если подняться повыше над этой толпой, можно увидеть куда (чуть-чуть, в среднем) сдвинулась вся толпа.
Миллион самураев сделает (каждый свой) шаг.
Но 500,000 из них не выживут. Я знал, что Вы предложите такой вариант, Адольф.
Ошыбочко! Я не Адик и не гоню самураев плёткой. Я просто гляжу со стороны. И я не обременён идеологией, просто наблюдаю самураев в естественной среде. Да, кто-то из них споткнётся и расшибёт лоб. Кто-то наступит на грабли. Кто-то рухнет в пропасть. Беда в том что никто не знает что принесёт следующий шаг. Вообще никто. Вряд ли существует система планирования для обсуждаемой темы.
кодекс самурая “не знаешь что делать - делай шаг вперёд”
Так ведь ЕСТЬ самураи, которые ЗНАЮТ. Это учёные. Учёные говорят, что с задачей «сделай реплику Фотошопа» может справиться либо статистический автомат, если человек позаботился вложить в его базу огромное число реплик Фотошопа, и он может строить дерево реплик и идти по нему в соответствии с ключевыми словами озвучиваемых требований, либо человеческое мышление, которое разберётся с нуля. Что делать реплики Фотошопа из большого числа реплик Фотошопа это варить кашу из топора. Что не зная, как устроено человеческое мышление, повторить его устройство невозможно. Что разобравшись однажды и повторив человеческое мышление, мы получим не автомат с тремя законами РАБОтехники, а нового человека, обладающего правами. Не читали великого русского провидца Михаила Булгакова? Вы ему: «Сделай реплику Фотошопа», а он вас по матери. Ведь все эти верующие: «Взвейтесь-развейтесь! Технологическая сингулярность!» — дикари, вы к ним в душу загляните, вы ахнете, когда увидите махрового рабовладельца.
Петабаксы же — вопрос не научный. Нет науки, которая бы говорила, отобьются вложения или нет. Лично я думаю, что экономика у них не сойдётся. Искать, конечно, удобно. Я постоянно что-то ищу в базе чатботов. Они, в отличие от поисковых сервисов, пока что не изгажены SEO и рекламой и могут забивать на копирайт и приватность. Гугл не может показать вам ссылку на документ, не находящийся в открытом доступе, а чатбот может процитировать документ, не указав автора и происхождение. Но рано или поздно цифровой коммунизм задолбает и начнётся жёсткая регуляция. Вдобавок, как мы видим, продают-то они не удобный поиск с элементами пиратства, а волшебную палочку, которая делает Фотошопы.

Просто нужно делать свободное.
1. Нет смысла повторять софтину, если уже есть и так доступная всем.
2. Нет смысла декомпилировать до исходников, так как исходники и так доступны всем.
Однако, возникает дополнительная потребность в рабочих бизнес-моделях для опенсорса.
Кто и как будет зарабатывать на разработке ПО, если все свободное?
По факту, к тому все и идет.
На поддержке. На SaaS, где софт - только часть сервиса.

владельцы датацентров, производители железа и оборудования для его производства. Не зря именно туда сейчас сотни ярдов умные люди закачивают.
Это железо.
У меня речь шла про софт.
Напрашивается логичная мысль, что чисто на софте зарабатывать уже не выйдет.
Нужен бизнес, привязанный к какому-то физическому продукту.
Да почему не выйдет, все так же будет, конкурентная борьба даже среди "вайбкода", плюс например не будут банки ставить СУБД или СРМ системы от вайбкодеров с гитхаба
Да почему не выйдет, все так же будет, конкурентная борьба даже среди "вайбкода"
Да, только порог входа в "вайбкод" на три-четыре порядка ниже, чем в традиционное софтостроение. Низкий порог => больше конкуренция. А сильная конкуренция, как известно, абсолютно всегда переход в плоскость цен. Потом неизбежно и очень быстро приходят "условно-бесплатные" софтостроители, товаром становится пользователь и рынок превращается в говно.
На написании того, что нужно именно этому клиенту. Чтобы успешно вайбкодить, нужно иметь прорву навыков, условный бухгалтер не сможет качественно навайбкодить себе рассчетный софт - все равно нужен будет специалист, который шарит в софтостроении. Это и основной вектор заработка.

1. Нет смысла повторять софтину, если уже есть и так доступная всем.
А если волшебная палочка умеет только заклинание повторения?
1. Нет смысла повторять софтину, если уже есть и так доступная всем.
2. Нет смысла декомпилировать до исходников, так как исходники и так доступны всем.
Ученик берёт сборник задач по математике/физике/химии и спрашивает: "Какой смысл решать все эти задачки, если в конце книги есть ответы?"
Думается мне, что смысл в повторении доступных программ и в декомпиляции заключается в обучении ИИ выполнять эти операции.
декомпилировать до исходников обычно невозможно, т.к. при компиляции большая часть информации теряется.
Можно лишь получить, что-то пригодное для анализа работы программы.
Откуда такая информация? Как раз наобррот. Все самое важное для работы программы остается. Люди руками много чего декомпилировать могут, а уж с такой автоматизацией и подавно. Я молчу про попросить ИИ просто тупо написать такой же софт используя скомпиленый бинарник как оракула. Как уже несколько месяцев назад сделали с gcc.
уже несколько месяцев назад сделали с gcc.
«Правда, такая фигня получилась...» ©

А ИИ текущий точно таким образом обучают? Или вы об обучении тех, кто пользуется?
А ИИ текущий точно таким образом обучают? Или вы об обучении тех, кто пользуется?
Задайте Гуглу вопрос: "как ИИ обучают декомпилировать программы?" Вы получите обзор по этому вопросу со ссылками на статьи. В этих статьях достаточно много информации об обучении ИИ.
Разве программисты уже знают всё про ИИ? Очевидно, что обучаются как ИИ, так и программисты.
Я же Вас спросил. Ваше мнение хотел узнать. А Вы в гугл меня шлете. В гугле Вашего мнения не найти.
Я же Вас спросил. Ваше мнение хотел узнать.
Я подумал, что Вам нужна точная информация. Я не специалист по ИИ, поэтому знаю, что ИИ обучают писать программы, а декомпиляция готовых программ часть такого обучения. Как это точно делают лучше всё же прочитать в интернете.
Я сам, когда начинал работать с компьютерами, это делал. Надо было ещё в DOS написать драйвер русификации для одного компьютера. Пришлось дизассемблировать готовый драйвер, понять как он работает и написать сильно похожий, но всё же свой драйвер. Это самая настоящая учёба.
Ученик берёт сборник задач по математике/физике/химии и спрашивает: "Какой смысл решать все эти задачки, если в конце книги есть ответы?"
В том-то и проблема (у ученика):
Некоторые ученики считают, что домашние задания им дают не для того, чтобы у них в мозгу нейронные связи образовывались, а потому, что учителя — это такая злая секта, которая каждый вечер приносит своему особому, злому богу в жертву тетрадки, исписанные
кровьюпочерком учеников, и поэтому обмануть их — святой долг каждого.
Если у вас в софте есть глубокие экспертные знания, то ваш софт могут декомпилировать до исходников или взломать.
Будто раньше так не пробовали. Декомпилируют уже софт конкурента, найдут повторение и засудят.
В СССР тоже увлекались декомпиляцией.
По одной из версий взрыва на трубопроводе «Западная Сибирь — Урал — Поволжье», который произошёл в ночь на 4 июня 1989 года была логическая бомба от копирования западных технологий. Впрочем, там много теорий заговора, как и в 9.11
Будто раньше так не пробовали. Декомпилируют уже софт конкурента, найдут повторение и засудят.
С помощью ИИ "отмывать" код от лицензий придумали гиганты как раз чтобы решить эту проблему с "найдут повторения" - ИИ просто переписывает "своими словами". Теперь придется либо проводить в законах "нам можно, вам нельзя", либо терпеть.
Возможно мы так придем к патентам на идеи ). Если реализация идеи ничего не стоит, то... о, дивный новый мир.
Отмывать код от лицензии (а потом сопровождать) легко?
Ну скажите это авторам uutils
Разработку проекта uutils (также известного как Rust Coreutils) начали в 2014 году
Через 12 лет ещё бета, принята в прод ограниченным числом версий Линукс.
По одной из версий взрыва на трубопроводе «Западная Сибирь — Урал — Поволжье»,
На мой взгляд эта версия может существовать, только для тех кто никогда не видел как выглядели промышленные компьютеры (тем более в СССР) в начале, середине восьмидесятых и как для них писались программы.

Нууу... Я, конечно, не сторонник нейрослопо-софта, но wordcraft вроде так ничего... Глубоко не погружался, но все основное работает довольно сносно.


Неплохо было бы чтобы теперь в эти программы для примера добавили новые функции. Насколько там кодовая база изменится

Нельзя просто так взять и написать убийцу фотошопа. Это работает совсем не так. Все кто привык к норм софту - даже по приколу не будет качать тестить (быть бесплатным тестировщиком) нейрослопа. Фотошоп (и вообще старый софт который работает и выполняет свои задачи) - это база знаний, служба поддержки, комьюнити и то что работает - то работает как задумано. Вайбкодерам нужны годы, чтоб заслужить доверие, вложить кучу бабла и времени в раскрутку. но сначала естественно в отладку. 99.999% такие вайбкодных убийц чего либо сами умрут максимум через пол года, а скорее всего и раньше о них все забудут и сам разраб тоже.

Вайбкодерам (при условии безлимитных токенов), при владении предметной областью и активном участии в тестировании продукта потребуется от 2 недель до 1 месяца чтобы не только закрыть весь продукт, но и наполнить его новыми фичами.

китайцы постоянно добавляли в свои навайбкоденные айфоны телевизионные антенны, но рынок это почему-то так и не переломило

Натренировавшись на тех поделках несколько лет, в итоге теперь у них очень крупные и сильные производители современных смартов, откусивших очень значимую долю мирового рынка.
Современный ИИ очень молод. Да я знаю, что основы были заложены пол века назад, но то была теория - ни данные для обучения ни доступное на тот момент железо не позволяло делать реально сильные вещи.
В том и прикол, китайцы это делали САМИ, те кто занимаются разработкой и производством как раз изначально и занимались такой "тренировкой" на чайнафонах. А натягивать это на использование нейронок, это как говорить что у нас есть своё производство, занимаясь переклеиванием шильдиков. Вы не разобрались, не прокачали свою экспертизу, вы просто отдали это на ауторс. Это не плохо, просто не надо себя обманывать, прикол телефонов того же Huawei не в том что он уникален, а EMUI и стандартное (и потому дешёвое) железо с oem фабрики. Причём oem сборка хотя бы защищена контрактами и взаимными обязательствами, а нейронки вам ничем не обязаны. Да и чтобы выхлоп нейронки перестал для вас быть чёрным ящиком, вам надо сначала разобраться, но это уже не вайбкодинг.
китайцы постоянно добавляли в свои навайбкоденные айфоны телевизионные антенны, но рынок это почему-то так и не переломило
Это вполне себе переломило рынок: аналоговое телевидение благополучно умерло.
А ксиоми и Хуавей? Очень даже неплохие игроки .
Потому что у Аpple модель бизнеса защищена от копирования не технологиями. Большинство покупающих тот же айфон, покупают в первую очередь фальшивый "статус в обществе", понт, обозначение себя как богатого, который может выкинуть $2000 за мобильник, самоутверждение, "прикосновение к миру роскоши". Они пришли не за техническим функционалом, они пришли за социальной игрой... Никакой китаец это не склонирует, даже если сделает телефон лучше в техническом плане.
Большинство покупающих тот же айфон, покупают в первую очередь фальшивый "статус в обществе", понт, обозначение себя как богатого, который может выкинуть $2000 за мобильник, самоутверждение, "прикосновение к миру роскоши"
То же самое когда автомобиль не Жигули а Тесла. Одни понты.

Большинство покупающих тот же айфон, покупают в первую очередь фальшивый "статус в обществе", понт
Это где так? В бангладеше каком-н? Всем вокруг давно плевать у кого какие телефоны. Большинство покупающих тот же айфон покупают прежде всего смартфон который просто включил и он просто предсказуемо работает без приседаний и плясок с бубном, и не развалится через год. Да и цены на него начинаются с 900$ вроде б, это даже в странах со средней покупательной способностью не сказать что неподъемные деньги за закрытие потребности в гаджете на 5+ лет.
В любой стране, где есть официальные продажи продукции Apple.
Или вы считаете что люди, которые 23 октября выстроятся в очереди за iPhone Duo будут стоять там (а также покупать места в очереди и брать у перекупщиков за две-три цены) ради того, чтобы "просто включил и он просто предсказуемо работает"?
Также, было бы интересно сравнить сколько из них будут при этом иметь в кармане условный 17 Pro Max по сравнению с 12-м или ниже (те самые 5+ лет).
Конечно, их не большинство, но это достаточно значимая (не по количеству, а по заметности) часть аудитории, что и позволяет делать выводы, подобные тому, на который вы отвечали.
В любой стране, где есть официальные продажи продукции Apple.
Например?
люди, которые 23 октября выстроятся в очереди за iPhone Duo будут стоять там
Во-первых сколько их среди общей массы пользователей смартфонов apple? Во-вторых, с чего вы решили что они ради самоутверждения то там стоят? Где и перед кем вы айфоном самоутвердитесь то, если в тех же США 54% смартфонов это iphone?
но это достаточно значимая (не по количеству, а по заметности) часть аудитории, что и позволяет делать выводы, подобные тому, на который вы отвечали.
Даже безотносительно того, что данное утверждение лишено всяческой логики, изначально было сказано "Большинство покупающих тот же айфон, покупают в первую очередь фальшивый "статус в обществе"".

не ифоновод, но маковод, покупаю не за понты, а потому что его взял и он работает в отличии от 100500 поделок для винды а тем более для линукса.
да дороже, правдя если равнять с массмаркетом, а так хорошая сопоставимая железка под винду или линукс стоит хорошо если не больше.
Хммм, крайне странное утверждение. Маки буквально всегда на 20-50% дороже сопоставимого вин железа. По многолетнему опыту эксплуатации вин железа с некоторыми вкраплениями Маков. В целом кроме цены к Макам я претензий не имею. Если бы стоили примерно одинаково то можно было бы их вполне и брать, но увы нет.
Маки буквально всегда на 20-50% дороже сопоставимого вин железа.
Это очень давно уже не так, во всяком случае если речь о ноутбуках. Если искать что то сопоставимое macbook pro, то там в основном дороже выходит
Ну тут хз, я когда брал свои личный первы макбук, выбирал между разер блейдом и макбуком, разер получался дороже. Сейчас глянул, он не сильно подешевел, правда макбуки сильно подорожали (
на мой взгляд это очень ограниченная позиция - в 2026 году думать, что люди покупают айфон ради понта. Люди хотят просто стабильно работающее хорошо фотографирующее устройство. Фирм, готовых предоставить это, не так много, и как раз таки они успешно делят рынок между собой. И да, айфон уже давно не считается дорогим устройством. Посмотрите сколько стоят флагманы тех же китайцев. Там цены сопоставимы, а то и выше.

Какой еще статус в обществе? Айфон просто лучший комплекс железо+софт, говорю это как человек, что пользовал Android, Windows Phone, iOS.
Для серьезного софта только на перечисление фич и опций уйдут месяцы.
Как они вообще определяют алгоритмы? Методом тыка это невозможно теоретически, количество комбинаций тыков может превышать количество атомов в видимой вселенной даже у не очень сложного софта.
Реверс с дизасемблированием? Этож сколько токенов надо? Тут небольшой фреймворк 100к выедает не дойдя до середины. И это с готовыми исходниками на сях.

Реверс тоже не даст нормального кода, особенно если там защищённый бинарь
В теории можно с нуля написать алгоритмы или посмотреть реализацию где-то. Или спросить ИИ как-бы он это реализовал.
Конкретная функциональность может быть реализована кучей разных способов и прямое копирование использованного алгоритма не факт, что оптимально.

Есть куча софта с открыми исходниками, которые подобные алгоритмы используют. Вот их нейронки и берут. Плюс научные статьи и патенты, где тоже что-нибудь может быть описано.
Вот кто минус тиснул? Мне не жалко. Но учти(те), что вот прямо сейчас, сию секунду, методика разработки ПО уже другая. Агент - исполнитель. Программист (именно, Программист с большой буквы) не печатная машинка для кода, который агент всё равно наберёт лучше, а Архитектор. И сейчас в специальности останутся исключительно люди с системным мышлением и опытом в предметных областях. Именно они смогут чётко контролировать/координировать работу нейросетей по написанию кода. Живые "печатные машинки", основанные на паттернах и минимальных знаниях языка, на котором они пишут - уже не нужны.
И сейчас в специальности останутся исключительно люди с системным мышлением и опытом в предметных областях. Именно они смогут чётко контролировать/координировать работу нейросетей по написанию кода.
Скажем так, и до ИИ, написание кода (печатанье по клавиатуре) после позиции Mid не было самой затратной частью по времени, а больше времени занимало понимание задачи, проработка архитектуры, согласования и пр.
Ни в одном проекте (последние наверное лет двадцать) именно печатание кода не было сколько-то значимой по ресурсам операцией. Понять как убыстрение этой операции, за счёт увеличение времени на аналитику и на управление (в широком смысле), может сделать весь проект дешевле не возможно.
На нижнем уровне разработки куча задач по созданию форм, шаблонов, простейших обработчиков событий, обмен JSON и прочей рутины. Код там простой и однотипный, но его очень много. И как раз такой код хорошо автоматизируется ИИ и позволит экономить.
Обмен JSON это достаточно верхний уровень. Нижний - это JSON распарсить, вытащить данные и обработать их в соответствии с заданной бизнес-логикой. Которая может быть весьма и весьма нетривиальной.
И вот тут начинаются проблемы - чтобы описать всю эту логику так, чтобы ее ИИ адекватно понял, уходит не меньше времени чем сразу написать код самому. А потом еще надо проверить что он там нагенерил, в том числе, насколько все это эффективно реализовано.
В итоге все это растягивается очень надолго.
И сейчас в специальности останутся исключительно люди с системным мышлением и опытом в предметных областях
А надолго они там останутся? Системное мышление и опыт точно так же оцифровываются и ложатся в веса новых моделей.
Мне всё ещё интересно, как вы собираетесь взращивать таких вот архитекторов и людей с системным мышлением. Допустим, как вы можете координировать нейросети по написанию кода если этот самый код вы никогда не писали? Как я тут видел, "Предложи изменения", "Ок", "Дальше"? Да и не имея опыта в разработке, каким образом вы сможете оценить и проверить результат работы нейросети? Вот допустим гугл, те кто работают над ИИ, и у себя же его используют, 75% кода генерируется, но код проходит через довольно длинную цепочку валидаторов, и потом всё ещё попадает на ревью к человеку.
Ну окей, допустим ваша модель работает, что такого сакрального тогда есть в предметной области что не поддаётся оцифровке? Вот с позиции бизнесмена, зачем нужен предметник-архитектор, если он может поставить нейросетевых: предметника, архитектора, 5 создателей, 7 валидаторов и 5 тестировщиков?
Про живых печатных машинок даже смешно, это описание вчерашнего выпускника на низшей позиции бигтеха.
Я понимаю что отхвачу минусов (привыкайте, это норма для любого острого обсуждения), но как мне мой батя всегда говорил: "***деть - не мешки ворочать, много вас таких по весне оттаяло"
Ну окей, допустим ваша модель работает, что такого сакрального тогда есть в предметной области что не поддаётся оцифровке? Вот с позиции бизнесмена, зачем нужен предметник-архитектор, если он может поставить нейросетевых: предметника, архитектора, 5 создателей, 7 валидаторов и 5 тестировщиков?
Это же в обе стороны работает, архитектор скажет зачем мне бизнесмен, если я могу сделать тоже самое и выдать продукт.
Можете, который не принесёт дохода, потому что нет опыта ведения бизнеса и понимания потребностей рынка. За исключением если вы тот самый предметник, из которых обычно и получаются бизнесмены в технических отраслях, и при этом обладаете жилкой продавца и связями. Вы почти уловили суть.
Вы выше задали вопрос
Ну окей, допустим ваша модель работает, что такого сакрального тогда есть в предметной области что не поддаётся оцифровке?
Почему тогда "опыта ведения бизнеса и понимания потребностей рынка " нельзя оцифровать? Ну так же поставит десяток агентов, которые ему промоделируют продукт/идею, покажут возможные результаты выхода на рынок и пр, пр.
В итоге остается одна пока не поддающаяся цифровизации штука умение видеть проблемы у людей, потому что предлагать решение уже можно с помощью ИИ
Я же говорю, вы уже уловили посыл того, о чём я говорил и почему предложенная выше модель если и будет работать, то с очень большими оговорками. А решение мало предложить, его надо ещё и продать.
Ну так же поставит десяток агентов, которые ему промоделируют продукт/идею, покажут возможные результаты выхода на рынок и пр, пр.
Которые будут убеждать в том, какая идея крутая и революционная, и точно перевернёт представление человечества о *вставить название*, потому что модели склонны поддерживать пользователя в определённых вещах. "Вы не правы" модель скажет только если вы объективно неправы, но на рынке для начинающего бизнесмена слишком много тонких материй не поддающихся анализу и оцифровке. Как вы оцифруете например связи, и речь в том числе о зондировании конкурентов? Предпринимательскую чуйку, тренды, и ещё много мелочей которые надо учитывать когда речь идёт о техническом бизнесе? Не говоря уже о том, что доверять свои деньги вероятностной машине я бы не стал, вероятности на рынке и так слишком условные.
Как говорит один мой коллега:
-- А я паровоз поднимал
-- Правда? Поднял?
-- Я не сказал поднял, я сказал поднимал.
Тут как-то на пробу кинул ИИшке тривиальную задачку. Буквально на 10 строк кода максимум. Он выдал решение. Но очень громоздкое, плохо читаемое и крайне неэффективное.
Когда предложил ему свой вариант, он сразу согласился что да, так компактнее, лучше читается и будет быстрее работать и потреблять меньше ресурсов.

Мне всё ещё интересно, как вы собираетесь взращивать таких вот архитекторов и людей с системным мышлением. Допустим, как вы можете координировать нейросети по написанию кода если этот самый код вы никогда не писали?
Забавно, раньше работодатели искали только молодых программистов, а 40+ уже считались некондиционными стариками. Но скоро, похоже, всё будет наоборот)
И оно уже началось. Бывший коллега в западной конторе несколько месяцев не может найти толкового миддла в проект. Кандидатов приходит немало, но без ChatGPT все абсолютно беспомощны.
у фотошопа десятки лет есть бесплатный аналог максимально подогнанный и совместимый - гимп, мс офис имеет тоже кучу бесплатных относительно совместимых аналогов, у остального софта думаю тоже такие есть. Только они не убили платный оригинал и все новые пользователи все равно выбирают платный (или ломанный платный). Это уже был повод задуматься перед созданием “убийц”.
"при владении предметной областью и активном участии в тестировании продукта" - это уже не вайбкодинг, а парное программирование с ИИ, но при такой подходе скорость итогового выхода качественного готового продукта а не "mvp заглушки" получается много месяцев, а если "убивать" фотошоп, то не один год.

у фотошопа десятки лет есть бесплатный аналог максимально подогнанный и совместимый - гимп,
Так может сказать только человек который не работает в ФШ. Гимп это не максимально подогнанный и совместимый аналог. Это пока что поделка вызывающая боль при загруженной работе.
Фичами заполнить - да. Работающими как надо - нет.
Там уже прайсинг с подписками прикрутили
Все кто привык
С этими понятно. Но время идет, старые люди уходят, приходят новые.
это база знаний, служба поддержки, комьюнити и то что работает - то работает как задумано. Вайбкодерам нужны годы, чтоб заслужить доверие, вложить кучу бабла и времени в раскрутку.
Это концепция тоже не вечна.

Ребята, проект только начался в февраля, а многим программам нету и месяца. Лучше дать ребятам время. Уже классно, что они взялись за это и заставили гигантов вспотеть.

заставили гигантов вспотеть
А гиганты в курсе? У либры больше шансов заставить их потеть.

Уже классно, что они взялись за это и заставили гигантов вспотеть.
Написал B2B Продакт менеджер в полной уверенности, что уж его-то бизнес-ту-бизнес точно не при каких условиях не заставят вспотеть. Нимёллера цитировать или сами справитесь?
А когда навайбкодят WarCraft, аналог WarCraft-а ?


Кровавый энтерпрайз все равно проигнорирет, потому что главное -- правовая стабильность ну и где-то там на энном месте безопасность и поддержка интеграторов.
Принципиальные или бедные частники давно имели бесплатные опен-либр офисы, ВСДС и прочие фрикады, но никто на этот счёт даже не чесался. Потому что эти альтернативы в работе просто нервный тик вызывают.
А вот если добрые AAA++++ вендоры осознают, что их великие без шуток продукты можно не по мелочам иишечкой портить, а целиком вайбануть -- будет ой.
Так что не удивлюсь, что это такой разминочный подход к снаряду в режиме инкогнито. В конце концов, токенов там не на одну тысячу доллров уже потрачено, и даже не на десять тысяч, а потребуется ещё экспоненциально больше.
Об этом и речь. Клоны приложений проприетарного софта, основанные не на исходном коде, который, скорее всего, закрыт, а на функциях/результатах, которые открыты. И претензии предъявить некому.

Так будут дизассемблировать и скармливать нейросетям, со всеми вытекающими.
Осталось только обучить нейронки ассемблерам.
Ну вообще китайские модели не плохо реверсят, давая доступ к гидре и ставя задачу они вские кракме решают быстро
Кто кого решает?
Ну вообще китайские модели не плохо реверсят
В смысле декомпилируют? На какой язык? И "не плохо" - это как?
Кто кого решает?
Crackme
В смысле декомпилируют? На какой язык? И "не плохо" - это как?
В том смысле, что разбирают что делает ассемблеровкий код или кусок кода и могут заимплементить на любом языке. Из того что я знаю, коллеги таким образом разобрались в закрытом формате одной тулы которая используется на фабрике TSMC, вот прям именно таким грубым способом, есть тула, есть выходные файлы, дали доступ к гидре и за полчаса (плюс минус), они получили полную спецификацию формата.

Повторяю свой коммент недельной давности - я за две недели по вечерам, пользуясь подпиской на один из всем известных AI агентов ПОЛНОСТЬЮ расковырял близзардовский античит к WoW, которому уже 20 лет.
Я знаю ЧТО он делает, КАК он делает, и КОГДА он делает.
Там порядка 10 кастомных алгоритмов шифрования, все в CFF, вся связь через RVA арены, все сисколлы обфусцированы, все строки разбиты, int3 пойзонинг везде, cff диспетчеры работают по 10к раз в секунду, все хуки на все сисколлы отслеживаются, своя память сканируется постоянно, модули полиморфные, и еще десятки тактик, про всякие мелочи типа "разобьем стек чтобы ida не осилила" и "следим за хардварными бряками, если видим - падаем" я даже говорить не буду.
AI агент написал мне тулинг для хукинга в пару с PT трейсингом, все на кернел/гипервизор левеле, пишет эмуляторы, дефлаттенеры, сам ковыряет IDA, сам смотрит переходы и сворачивает MBA, и еще бесконечное количество вещей. Сам понимает когда статика исчерпана и что ему нужно отхукнуть/оттрейсить. Единственная его проблема - иногда он триггерится на что-то, и говорит - все, баста, дальше ковырять отказываюсь, вы тут хакер. Чинится сменой промтпа/модели.
Еще раз - две недели, чтобы такое расковырять, хотя мои познания в реверсе до этого это "ну щас dll заинжектим, jne кинем в наш код, чет там посмотрим".
Я вообще не понимаю удивление что AIагенты умеют хорошо в реверс-инжениринг, задача реверс инжиниринга скомпилированного файла в целом "простая", бери анализируй ассмеблеровский код, смотри какие API функции вызываются, смотри диаграммы вызовов и пр, для человека основная сложность именно в таком анализе, надо реально много смотреть, читать код, делать гипотезы, дебажит и пр,, а для AI-агента это вообще не проблема, он не устает, глаза у него красными не становятся.
Именно! Это для нас оффсет 0x235EA9 имеет примерно нулевую значимость, мы должны сначала его переименовать как-то в IDB, а потом возможно еще десяток раз, потому что были не правы этот десяток раз, для агента 0x235EA9 и "ntdll_RVA" это буквально одно и то же. У агента значительно большая "насмотренность", для него метод (char* a1, uint a2, unit a3) это сразу подозрение на какой-то xor/шифр, он сразу пробежится по цепочкам вызовов, опровергнет теорию или подтвердит.
У меня то это удивление не вызывает. Мне интересно способны ли эти агенты декомпилировать прикладной софт, восстановить всю бизнес-логику.
Да, все так. Что-то защитить становится очень сложно.
, надо будет попробовать. У меня есть бинарники для БК-0010, и отдельно — их исходники. Надо будет попросить ChatGPT их реверснуть и посмотреть на результат.
Дадите тоже посмотреть на результат? :)
Я намедни пытался заставить расшифровать протокол обмена ups с егойным пультом. На каждой итерации чатик выдавал скрипт на numpy, который точно все расшифрует. Хвалил меня - мы уже все расшифровали! Ты же видишь - вот повторяющаяся последвательность! (Нет) да, ты прав, это uart на 2500 бод (нет).. Как и обещали - если в обучающей выборке такого нет - кидаем всякое в стену и смотрим что прилипнет.
Короче, отложил. Решил что не настолько мне оно интересно.
Можно, конечно, с другой стороны зайти, прочитать прошивку пульта..
PdfCraft (Acrobat)

Когда ии станет ещё лучше и залезет в карман крупных корпораций софта и не только, Начнется волна ограничений и запрещений. ИИ будет доступен в полной мере только тем же корпорациям . Скриньте )))
Всё равно найдут, как преодолеть. Я думаю наоборот - нас ждёт эпоха кастомного ПО.
Так уже. Есть модели "не для всех".
Тимс, Тимс перепишите!

Я боюсь себе представить, сколько так сказать бизнес логики (вплоть до кнопки вставить только текст) было утраченно из-за того, что агент забыл, а вабкодер не написал

Мы, конечно, сравниваем с релизами матёрого софта от огромных корпораций, но тут совсем другое явление из новой эпохи, пока первое в своем роде.
За весь софт не скажу, изучал только LightCraft. Вчером в пятницу я завел 9 тиктов. Когда я дописал девятый, первые три уже были со своими МРми, а один в мастере. Сейчас из 20 не закрыто только 8. В общем потоке за день запиливают около сотни МРов.
От момента, когда я поставил 0.2.1 до сегодняшнего 0.6.0 прошел огромный прогресс от "невозможно пользоваться" до "ну в принципе большинство повеседневных фич есть и работает стабильно". И это всего за три дня. Уже сейчас, в принципе, оно работает не хуже DarkTable и RawTherapee. Не было пока ещё такого крупного проекта с таким же прогрессом.
Можно возмущаться, что это вайбкоженое говно, но у Адоба-то теперь тоже, и у Майкрософта. Только тот же Лайтрум за 20 лет превратился в глючное тормозное говно по подписке ещё до вайбкода, а с вайбкодом он лучше не стал.

Что такого нового в идее сделать свой продукт силами бесплатных энтузиастов и потом монетизировать в свою пользу? Разница только в том что раньше энтузиасты сами исправления писали, а теперь ИИ кормят задачами и проверяют результаты.
Хотелось бы конечно верить что всё делается исключительно во славу open source-а, но множество примеров последних лет делают более вероятным что после допиливания до целевого уровня исходная репа будет заброшена, а клон начнут продавать в том или ином виде.

Если один смог сделать это при помощи ии, то и другие это будут делить так же. Ценности с каждым разом у этого всего будет становиться всё меньше и меньше. Миллионы уже не заработать.
Типа как MySQL - MariaDB, OpenOffice - Libre Office? Форкнут и продолжат.
Как я писал, проект растёт коммитами сотен волонтеров, с MIT лицензией
Кстати, если убедят сообщество, что могут закрывать issues очень быстро, то это большой плюс. Сообщество заинтересуется и пойдёт развивать продукт
Вайбкод обязан прогревать пользователей на написание issue. Потому что поиск багов - это самая сложная часть вайбкодинга, распараллелить ее на кучу пользователей - мечта. А найти и пофиксить баг современная нейронка может без особых усилий, надо ее только пнуть в нужную сторону.

Сдается мне когда толпа вайбкодеров начнет фиксить нейронками баги без полного понимания предметной области количество багов в какой-то момент начнет не убывать а расти. А эта чудо-сковородка приобретет функционал забагованной мультиварки
Пока практика показывает, что количество багов все же убывает.
это пока кодовая база помещается в область внимания
Они пока на 434628 LOC, т.е. даже без subagents все лезет. К тому моменту, как перевалят за миллион, думаю уже либо миллионе подрастет до двух, либо просто еще более эффективные harness выпустят. Хотя ИМХО вполне достаточно того, что сейчас есть, пытаться все впихнуть в один контекст - моветон.
Идеальный вариант - это как раз вся кодовая база, все примеры, все доки, все, что связанно хоть как-то с проектом. Тогда сразу легче с долгосроным планированием. Всяки эти спеки, интерфейсы, md, чтения по кускам, grep - это костыли и палки придуманные для человеков, а и последующем для ллм из-за ограниченности ресурсов памяти и внимания
А найти и пофиксить баг современная нейронка может без особых усилий
10 багов из кровавого энтерпрайза этому господину (ломать текущее поведение нельзя)
К счастью речь в статье не о кровавом энтерпрайзе, те пущай в своем легаси, написанном дедами, сами возятся :)
Word вполне кровавый enterprise
Фотошопы всякие - не знаю
Так ведь не их код переписывают, а вайбкодят "с нуля".
Word и в эксплуатации кровавый энтерпрайз
А уж Excel так и подавно!
Вайбкодят скорее по уже готовым сырцам того же оперсурца, на чем собственно нейронка и училась. Плюс куча книг и документации по функционалу текущего софта который пародируют. Так что ноль там скорее всего весьма условный. Чтобы сделать такую махину и ничего не забыть, надо ТЗ не один месяц писать. Это как говорят что сегодня с нуля невозможно написать браузер со своим движком, никто просто не потянет написать ТЗ. Ну окей, его сама нейросетка напишет, но ключевой момент в том что ничего не забыть. В противном случае это получается такое же легаси к которому можно бесконечно править баги, но заниматься этим никто не будет, потому что таких поделок наклепают сотни и тысячи и такие баги даже искать никто не будет. А автору банально надоест всем этим заниматься. Это как в свое время народ с криптой развлекался создавая тысячами всяких скам-койнов придумывая им великое назначение и успешное будущее.
Не стоит вскрывать эту тему. Вы тут молодые, шутливые, вам все легко. Систему там переустановить, пакет из нпм поставить. Это не то. Это надпись no service по утру на телефоне и сообщение "операция отклонена" при проведении платежа в магазине. Серьезно, любой из вас будет жалеть.
Очень интересно.
Меня интересует вот такой вопрос, а как в промпте перечислить ВСЕ функции-возможности программы, причем так, что б это было понятно ИИшечке? Я вот пользуюсь очень ограниченным набором функций того же Wordа и понятия не имею, что он там умеет в глубине. Или можно взять учебники, типа "Word для самых маленьких" и "Word для профессионалов", дать агенту доступ к настоящему Wordу, и - сказать читай, проверяй и копируй функционал.

"Ну ты же знаешь, как выглядит фотошоп, сделай такой же, но на расте и пожалуйста без багов". Думаю стартовый промпт примерно такой
ИИшка может читать документации и мануалы с официального сайта.
Мне как то надо было подружить софт с API одного веб сервиса. Документацию там нельзя было скачать в виде одного файла, она была разбросана по страницам. Дал агенту только адрес сайта. Он сам порылся по сайту, нашел документацию, изучил, протестировал API, по своей инициативе нашел несколько недокументированных методов.
Заставить агента искать и изучать все доступные доки и видосы?
Для этого есть спецификация с подробным описанием функциональности программы. Есть ли она для Photoshop - не знаю.

было бы интересно если бы они целились в производство именно клонов, вплоть до расположения кнопок
Даже сам адоб не очень уважает свое расположение кнопок, я обновил фотошоп с 22 до 26 и за голову схватился, куда все пункты в контекстных меню сползли.
А зачем? Навайбкоживание клона стоит денег. Кто его купит? За деньги есть оригинал, за бесплатно - open source аналог.

Это все здорово, но всего лишь промежуточная проба сил, КМК.
Однажды должна родиться одна Программа. Мультитул. КОторый будет работать со всеми видами файлов на одном борту.
Хоть .doc, хоть .dwg, хоть богопротивный .djvu.
Подстраивать интерфейс, подгружать модули для экзотики (или рожать их на ходу). Не обременяя юзера ненужными наворотами, которыми забиты нынешние приложения (облака, совместная работа, публикации и прочая чушь.
Глючить будет конечно такая химера, так и официальное ПО нынче не образец безглючности.
Hицшеанство.Программы глючат потому, что они - всего лишь программы и достойны презрения.Только сверхпрограмма будет безглючной.
Критики ницшеанства.
У сверхпрограммы будут сверхглюки, ха-ха!
Всё новое - хорошо забытое старое.
The core idea of OpenDoc is to create small, reusable components which are responsible for a specific task, such as text editing, bitmap editing, or browsing an FTP server.
...
OpenDoc frameworks can substitute suitable components for each part, even if they are from different vendors.[3] In this way, users can “build up” their documents from parts.
https://en.wikipedia.org/wiki/OpenDoc (ни за что не догадаетесь, какая Корпорация Добра за ним стояла)

Не без багов, конечно, (эти рывки по центру сама прога делает, у меня тремора нет) но в принципе появление таких клонов вполне ожидаемо:
Я давно подумываю о клоне Fiji-ImageJ на Расте, кой - какие запчасти оттуда можно позаимствовать, хотя и не просто ввиду ИИ-шности происхождения и обилия "если на Виндовс, то так, а если Линукс или Мак, то сяк", я код глянул. Притом там egui/wgpu его и в wasm можно собрать, в веб тоже будет жить. Хотя баги чинить или расширять там вручную задолбаешься, как впрочем и со многими другими таким образом сгенерёнными исходниками. Но собирается влёт без единого предупреждения на среднем ноуте минут за десять и стартует мгновенно, в общем не так плохо для начала, как по мне.
Интересный феномен. Ведь эти господа могли пойти контрибьютить в опенсорсные аналоги. Бэклог там бесконечный. Но пошли путём мелких понтов разлива питерской подворотни. Мол смотри, как можем: содрали фотошоп в ноль. А у аудитории просыпается это сладкое забытое желание носить непременно Armani - но желательно за 3 копейки из перехода. Короче сплошь вайбы 90х у меня от этой новости.
Там скорее всего сидят ребята, которые в лучшем случае воротят нос от вайбкода, а в худшем - запрещают его. Оно физически неспособны закрыть такое количество PR, о которых написали выше, да и интереса у них никакого - скорее только срачи будут.
Не могли. Мешает уже имеющаяся "человеческая" кодовая база, которую ИИ правит намного хуже, чем пишет свое с нуля. Плюс там сообщество, наверняка полное луддитов, которым набирать код нужно руками в vim, а не энтими вашими модными нейросетями.
А если из подворотни за 3 копейки по качеству ничем не отличается от Armani? Существует только цена/качество, остальное выпендреж людей с комплексом неполноценности.
https://github.com/storytold/photocraft/issues
Всего лишь 770 issues.
Эти программы уже созданы и прекрасно работают. Их создатели уже заработали свои миллионв и миллиарды зелёных, вам этого не повторить 100%. Зачем создавать их аналоги? (К тому же они всегда существовали) Лучше создавать то, чего не существует. Далее, при наличии ИИ вообще не понятно, зачем нужна половина этих программ. Ну фотошот точно не нужен большенству
Зачем создавать их аналоги? (К тому же они всегда существовали) Лучше создавать то, чего не существует.
Прежде чем создавать новое надо обучить ИИ. На аналогах ИИ и обучают работать.
Лучше создавать то, чего не существует.
Так для этого головой думать надо, ИИ не поможет
Ну фотошот точно не нужен большенству
Интересен такой феномен: по PhotoCraft'у больше всего открытых (и закрытых) ишесов и пулл-реквестов. Причем разница с другими продуктами почти порядок.

А почему Адобе не делают этого сами? У них явно больше и документации и исходников, так что странно, почему они не перегенериили себе весь софт за недельку. Или чудо вайбкодинга так не работает...
Пока вайбкодинг либо выдает имитацию программ, либо ухудшает то, что было (судя по апдейтам от МС).
А почему Адобе не делают этого сами?
Они заняты придумыванием очередных способов отьема бабла у пользователей.
Потому что провести какое-то изменение в большой жирной корпорации - это многолетняя война с бюрократами и коробочками на местах. Они не могут взять и допилить фичи вот просто так, всё надо считать в деньгах и рисках, а это реально месяцы согласований по каждой мелочи...
Ждем, когда с помощью ИИ будут копировать целые бизнес-модели и компании целиком, а не просто какой-то софт.
Начинание хорошее, проблема в одном. Кто мне мешает встроить в этот клон фотошопа хитрую уязвимость, которая, например, при открытии определенного файла будет запускать шелл-код из него? Да никто. Дальше, когда все скачали софт, идем на дарк-маркет и продаем за миллиончики 0-day, которых заложили сотни... Проверить нейрослоп невозможно, он развивается слишком быстро, чтобы как-то его верифицировать.

Мы в нашей компании разрабатываем аналог Visual Components и RoboDK - программ для моделирования и симуляции промышленных роботов. Активно используем ИИ. За три месяца покрыто примерно 80% функционала конкурентов. Но я не могу сказать, что это легко и непринуждённо - сказал ИИ "сделай мне клона", и он сделал. Это не менее упорная и сложная работа, чем если писать вручную, просто быстрее. У нас в команде программисты с опытом более 20 лет в проектах, связанных с САПР и робототехникой, и консультируют нас не менее сильные специалисты в области интеграции промышленных роботов. Если вы и так способны своей командой написать Word и Excel, то ИИ поможет это ускорить, а если у вас нет опыта работы с такими проектами, то ИИ не станет волшебной палочкой. С определённого объёма кодовой базы правки ИИ начинают ломать уже работающий код, и нужна невероятная дисциплина и грамотно построенная система разнообразных проверок и валидаций, чтобы ИИ продолжал помогать, а не лишь увеличивать энтропию.

А если не секрет с клодом пишите? Скилы пректируете и описываете? Получается такая мысль, что раньше появился ООП как уровень абстракции и в каком-то смысле мышление стало объектным. А сейчас на уровне скилов, еще верхнеуровнее, только уже на порядок и даже несколько.
Да, Opus и Fable. Дополнительные инструкции есть, но их не так чтобы много. Большую часть занимают факты о проекте, либо правила, по которым принимается то или иное решение. Например, ИИ любит добавлять проверки и тесты на всевозможные случаи, но на часть кода у нас правило "garbage in -> garbage out", чтобы не плодить никому не нужные тесты.

Странно, почему бы не допилить существующие опенсорсные продукты до вменяемого состояния ?
Раньше, когда рассказывал кому то про опенсорс , говоря «любой может взять и поменять как хочет» приходилось добавлять что все таки не у каждого любого найдутся силы на такие подвиги.
Теперь это стало гораздо проще.
Иногда проще с нуля написать, чем исправлять что то старое с легаси
Только в случае с тяжелым софтом и вайбкодингом на выходе получится такое же легаси, только еще и никому нафиг ненужное и не интересное кроме как его автору
Тут палка о двух концах. С другой стороны , там нет многих граблей на которые наступишь пока пишешь с нуля
Для настоящего программиста всегда с нуля проще! Но не всегда получается. Не ищем легких путей.
Почему оно не может просто взять и отрефакторить легаси?
Потому что попенсорс активно воюет с LLM.
И в чём не прав? Напулять PR мозгов и затрат нужно куда меньше, чем всё это валидировать. Кто ж виноват, что макаки с клодом побежали бомбить кодом репозитории?
И в чём не прав?
В некоторых проектах и до эры нейрослопа предлагали “контрибьюторов расстреливать”. Во многих проектах жуткая и бессмысленная бюрократия, выгоревшие мейнтейнеры, но при этом не желающие принимать вклад.
Вот выше там про LibreOffice есть дискуссия. Оно же годами не развивается толком, просто в каком-то режиме зомби существует, а тысячам пользователей приходится мириться с багами и корявостью продукта, что никто исправлять не собирается. А если кто-то извне соберётся, то упрётся в стену “исправить баг в нашем проекте - большая честь”.
Какова мораль?
Мораль такова.
почему бы не допилить существующие опенсорсные продукты до вменяемого состояния
Потому что мейнтейнеры проектов или сложившийся порядок вещей в сообществе/экосистеме этому препятствуют.
Я против нейрослопа и вайбкодинга в коммерческой и open source разработке, но LLM-ки с харнесом в виде агентов можно сделать полезным инструментом для помощи в разработке и сопровождении проектов. Было бы желание не быть луддитом.
LLM-ки с харнесом в виде агентов можно сделать полезным инструментом для помощи в разработке и сопровождении проектов
И что мешает это делать? Если LLM использовать именно как инструмент, каким образом ревьюер сможет понять, что LLM вообще использованы? Это становится понятно, когда один автор вываливает PR на тысячи LOC в количестве нескольких штук за раз или пихает код, едва глянув на него, оставляя кучу ненужных комментариев от агента или идиотские конструкции, которые явно выдают руку LLM, но это невозможно при использовании агентов и нейронок как инструмента.
Если я что-то упускаю, буду рад узнать, что именно.
И тот софт, о котором речь в публикации идёт, явно не про "LLM — это просто инструмент для разработки". Так что авторы действительно не смогут контрибьютить, но уж точно не потому, что весь опенсорс — это луддиты.
Ну, кстати, LibreOffice боль-мень работает. И багов я встречал меньше, чем в аналогичном продукте Microsoft последних выпусков. Хотя баги есть, да.
Да пусть что хотят делают, могут на своих багах хоть еще 20 лет просидеть в ожидании идеального PR - вопрос был почему не помогают попенсорсу - вот поэтому. Потому что половина попенсорса это филиал почившего ныне SO (земля ему и его модерам стекловатой).
могут на своих багах хоть еще 20 лет просидеть в ожидании идеального PR
Я понимаю, что фанатам вайбкодинга кажется, что они на острие прогресса, однако несколько об ином речь шла.
Я не знаю, о чем вы думаете шла речь, я напомню:
Странно, почему бы не допилить существующие опенсорсные продукты до вменяемого состояния ?
Ответ - потому что попенсорс не принимает код из под LLM. А дальше пошли какие-то пространные рассуждения "а в чем они не правы" и прочие попытки смешно пошутить. Ну шутите-шутите, поэтому традиционный попенсорс и находится там, где находится.
Я помню, о чём речь шла. Это не ответ на исходный вопрос, и мои комментарии объясняют, почему: срать слопом не то же самое, что делать продукт хоть с какой-то ответственностью. Ровно потому и мейнтейнеры не горят желанием видеть тонну этого слопа у себя. Желание причаститься к опенсорсу не требует пулять по 100500 невалидированных PR в репу. Это, внезапно, не единственный способ разработки. И нет никаких оснований утверждать, что навайбкоженный аналог будет лучше. Так что мне не совсем понятно, с чего бы нежелание мейнтейнера видеть у себя гору мусора, которую именно ему разгребать за спасибо, было бы достаточным оправданием для невозможности контрибьютить. Отсюда и мой вывод, что с подобной позицией выступает тот, кто вайбкодинг считает достаточно качественным подходом.
В ближайшее время, кстати, узнаем, насколько далеко проект с таким подходом сможет зайти.
В ближайшее время, кстати, узнаем, насколько далеко проект с таким подходом сможет зайти.
Истинно так.
Мне вот буквально на днях прислали PR с примерно такой посылкой — «вот это место в коде занимает слишком много времени — давайте его выкинем». То, что в результате этого «выкинем» переменные останутся неинициализированными, никто не заметил.
А причину, почему это место тормозило, никто даже и не заметил.

Ну звоночки ожидаемые, вендорский софт будет девальвироваться
аналог Premier
Позанудствую: видеомонтажка от Adobe называется Premiere (французское слово).

Что-то большие сомнения, что будет что-то юзабельное. ИИшки делают вроде всё красиво пока не вникаешь в детали, и на более простых проектах куча багов. Причем зачастую, так сказать на ровном месте.
Помнится делал клиента для Binance Futures, так все ИИ-шки нужно было несколько раз "мордой тыкать" в доку, чтобы они сделали 5 пунктов, как в документации (при том что эта часть доков не менялась лет 5). Они постоянно, что-то "улучшали и оптимизировали", в итоге работало неправильно.
А тут такие вещи, как Word, это ж не просто текст жирным выделить или шрифт поменять.

Товарищи - добро пожаловать в цифровой коммунизм!

Круто. А если что-то не работает, то пул агентов допилит минут за 20. Прощай, Adobe, короче.


В левом углу ринга у нас традиционные корпорации, десятилетиями превращающие свой софт в тяжелое глючное неюзабельное кхм... (если почитать камменты к роликам про новые функции того же Solidworks - там лейтмотивом будет "нам не надо новых функций, нам нужна стабильная работа старых")
В правом углу ринга - молодая гвардия, пытающаяся сделать лёгкие бесплатные аналоги сложного софта вайбкодом. Аналоги пока (пока) получаются тоже "как минимум не идеальными" с точки зрения стабильности.
Со временем посмотрим кто кого.

Здесь та же самая история, что с Serif Affinity Photo, а ещё раньше с Paint.Net и ещё несколькими проектами.
Стоит появиться какому-то клону интерфейса фотошопа, как тут же десятки тысяч хомячков (удивительным образом среди них очень много индийцев) начинают повсеместно флудить в комментах: «вай-вай, всё, адобе канэц!» или «ахалай-махалай, вот карощий альтернатиф».
Э, дорогой, отвечаю я этим срикумарам ш. пателям, я фотошопом пользуюсь с 1993 года — со своих двенадцати лет и версии 2.5LE. Никакой пейнт.нет, никакой аффинити и даже Corel PhotoPaint (которому лет немногим меньше, чем собственно фотошопу и который со времён царя гороха поддерживает фотошопные кисти, плагины и много чего ещё), а уж фотокрафт альфа-версии тем более, рядом не валялись.
Знаю ли я фотошоп так, как Дэн Маргулис или Умеш Динда (PixImperfect)? Нет, потому что мне как фоторепортёру (и то отставному) и допечатнику знать ВЕСЬ фотошоп не нужно. ВЕСЬ фотошоп нужно знать тем, кто продаёт по нему курсы — то есть Маргулису, Динде и иже с ними. Я знаю его процентов на 35 и пользуюсь примерно 20% его штатных возможностей. Но то, чем я пользуюсь в фотошопе, как правило заменить чем-то ещё нельзя. А вообще возможности фотошопа безграничны почти так же, как Вселенная и человеческая глупость, потому что плагины (а теперь ещё и специальная иишница).
Наконец, не фотошопом единым. Есть иллюстратор и индизайн, которые вообще-то отраслевые стандарты. Несколько бесплатных российских скриптов для индизайна, которыми я пользуюсь больше десяти лет, экономят даже не часы, а дни на корректуре, хотя её никоим образом не отменяют. Сила индизайна — не в умении таскать текстовые блоки с точностью 0,01 мм (это и QuarkXPress может и даже Scribus несчастный, и даже покойный MS Publisher, да и ворд при желании). Сила индизайна — в скриптах и в интеграции. Я одиночка, не пользуюсь InCopy. А издательства, в том числе российские, пользуются ещё как.
Acrobat — тут сложнее. Инструментов для работы с PDF куча, многие из них удобнее акробата (хотя PDF придумала адоба, как и постскрипт). Но Distiller, когда нужно выдать файл по стандарту, потому что RIP в типографии понимает только так — не заменить.
Наконец, Premiere Pro и AfterEffects. Видеоредакторов уйма, они совершенствуются, плюс ИИ. Но почему-то, несмотря на популярность DaVinci Resolve и стремительный рост CapCut, никуда премьер не девается. Потому что точность и эргономика, заточенные ПОД МОНТАЖЁРА И ЭФФЕКТЕРА.
Главное не интерфейс слизать и не код отреверсить. Главное то, что не слизать и не отреверсить. А именно — что среди разработчиков профессионального софта программистов (ну или там промпт-инженеров уже может) существенно меньше, чем профессиональных пользователей. Тут хороший пример — 1С. Я помню какую-то старую итерацию их сайта, когда они ещё не были таким спрутом, хотя уже крепко держали всю российскую бухгалтерию за чувствительные места: Нуралиев, десяток программистов — и сорок две бухгалтерши.
Ну это для вас главное. А для меня например иметь инструмент более ли менее полноценный, в котором можно без проблем что то накидать - главное. А еще MCP из коробки.
Потеряют ли Adobe с такого? Конечно потеряют. Но останутся те, кто слезть с него не сможет.
И это только начало. Дальше будет только хуже. Нейросети на самом деле дают дикую автономию для обычных людей. И пока есть дефицит железа - это можно сильно замедлить. Но прогресс не остановить, чем дальше люди будут этим заниматься - тем лучше будут инструменты и качество.
Сегодня вы что то делаете скриптами. Завтра за вас это будет делать нейросеть, по вашему прошлому шаблону.
Вы просто еще не понимаете насколько сильно меняется мир. И динамика изменений в ближайшие 1-3 года будет только нарастать в прогрессии.
А люди которые будут отрицать это, рано или поздно столкнутся с реальностью, которая им сильно не понравится. По большей степени потому что они внезапно станут профнепригодными.
Делайте правильные выводы.
Видите ли, поник... Вам надо «накидать», а мне надо «сделать». Я зарабатываю вообще не тем, что нейросети могут как-то задушить что в первом приближении, что во втором. Меня много лет стращают, что виртуальные аватары будут излагать синтезированным голосом сгенерированные доклады вместо того, чтобы человек сам приехал выступать или даже ВКС включил.
Нет.
Люди тщеславны, они хотят видеть себя на экране и слышать свой голос в колонках, а ещё они хотят пить кофе и жрать обеды за чужой счёт. И желательно получать за всё это зарплату.
До тех пор, пока они путаются в двух кнопках кликера для презентаций, мне не грозит решительно ничего. Кроме того, нельзя нейросетью заменить режиссёра и операторов на живом концерте живых людей, на спортивном состязании людей и при трансляции операций на людях. Не «пока» нельзя, а «совсем» нельзя.
Я сейчас перевожу книжку (антиутопический антикорпоративный боевик) о том будущем, которое как бы рисуете вы. Книжка написана в 2020–2021 году, во время ковида, когда до начала бума LLM был ещё год. Там тоже всё произошло очень стремительно и всё стало в основном очень плохо. Но так — не будет. А если и будет, то отверженные там тоже вполне выживают и даже в итоге ломают систему. Но, кстати сказать, люди творческих профессий, спортсмены, топ-менеджеры и юристы даже в том мире «уцелели» — как и AV-техники.
Перевожу я её руками. Во-первых, потому что мне нравится процесс, а кое-кому нравится результат (хотя я вообще-то больше по ранней истории гражданской авиации, дальше на очереди чуть более ранний авиатор, а может и вне очереди — у него книжка маленькая), а во-вторых, потому, что нейросеть этого сделать не может. То есть, конечно, может, но при наличии хотя бы минимального чувства языка читать это невозможно. И написать примечания для определённой аудитории, но так, чтобы они были интересны всем остальным, нейронка тоже не может.
Наслопать машина может давно. Помнится, ещё в конце девяностых и начале нулевых «промтом» переводили бульварно-будуарные подтирки, ну и историю «Корчевателя», думаю, помнят многие (а тогда ни о каком машинном обучении и ни о каких ИИ-агентах даже и речи не было, это всё было совершенно эфемерной фантастикой). А вот чтобы приятно было — не может. Да, деловую документацию иишница переводит (но горе тому, кто не отдаст результат на проверку понимающему человеку). Да, даже переводы нон-фикшена уже там одна нейронка под руководством другой лепит (importknig). Я попробовал эти переводы почитать — проблевался.
Так вот, о чём можно говорить, если большие языковые модели не могут нормально работать с текстом? А ведь прошли уже те четыре года, за которые должны были исчезнуть копирайтеры, журналисты, часть писателей, две трети юристов, половина бухгалтеров и почти все аудиторы. Исчезать пока начали только программисты, да и то скорее переквалифицироваться.
Пока не сменится несколько поколений людей— можно не беспокоиться, да и там всё будет не совсем так. Сколько бы мне ни было ещё отпущено, до полной дисквалификации и абсолютной бесполезности я вряд ли доживу, да и вы, скорее всего, тоже, даже если вы вдвое меня моложе (судя по всему моложе, но отнюдь не вдвое). Потому что прогресс прогрессом, но есть всякие «чёрные лебеди», «идеальные штормы», а ещё личные шкурные интересы и просто банальные дураки. Иногда шкурный интерес банального дурака становится чёрным лебедем в идеальный шторм и происходит такое нечто и труляля, на которое не хватает ни человеческой фантазии, ни мрачных прогнозов всевозможных аналитиков. Аналитиков хватает на ситуацию, в которой ещё один пожилой руководитель крупного государства полезет на маленький остров и хлопнет ракетой по одной фабрике на этом острове. Даже такое, весьма возможное вроде бы, событие уже грозит если не остановкой прогресса, то его замедлением. Ну или там землетрясение какое, или вулкан опять взорвётся очередной, или ещё какая незадача, помноженная на не самые лучше личностные и мыслительные качества лиц, принимающих решения.
Ваша аргументация строится на ошибке выжившего и экстраполяции частного опыта на общие рыночные процессы.
Вы оцениваете будущее по текущим ограничениям ИИ игнорируя экспоненциальный рост технологий. Рынок же принимает уровень "достаточно хорошо" но за существенно меньшую стоимость. Это будет постепенно размывать даже узкие профессиональные ниши.
Ваша конкретная ниша может сохраниться, но трансформация смежных процессов и экосистемы неизбежно изменит условия работы.
Вы не учитываете трансформацию инструментов. Хороший тому пример - IDE для программирования. Такие компании как jetbreans теряют клиентов с огромной скоростью. Я не знаю ни одного человека кто в этом году продлил подписку на их продукты, хотя еще 2 года назад такое невозможно было представить.
Пересечение технологией порога "достаточно хорошо, удобно, дешево" вызывает лавинообразную миграцию.
И как только подобные инструменты достигнуть определенного порога юзабилити, произойдет естественный приток пользователей. Что определенно скажется на таких компаниях как Adobe. С текущим трендом это уже просто неизбежно.
экспоненциальный рост технологий
Кстати, как там экспоненциальный рост технологий поживает? На Марс уже на выходные летаем? Термоядерный реактор в подвале жужжит?
Нету «экспоненциального роста» — есть S‑кривая.
Так вы точно так же смотрите со своей колокольни разработчика, причём ещё и в порядочной панике, с трудом скрываемой. Я могу сказать, что моя ниша и смежные УЖЕ трансформировались так, что никакое клодирование разработки и сравнительно узкоспециального софта тут рядом не валялись! И я свою нишу занимаю ИСКЛЮЧИТЕЛЬНО благодаря этой трансформации.
Штука вот в чём: пока в процессе заняты люди с эмоциями, рассеянием внимания, пределами компетентности, «критическими днями» в конце концов, никакая нейронка не сработает.
Думаете, не существует «достаточно хороших» решений, которые позволяют неспециалисту вести многокамерную трансляцию с кучей наворотов? Существуют. Особенно в Китае, там вообще в этом смысле свой мир, который не всякая фантастика описывает (при том, что с собственно научной фантастикой, не считая Лю Цысиня и ещё буквально нескольких человек, всё весьма нехорошо). Существуют. Проблема в том, что они, во-первых, непредсказуемы сами, а во-вторых, не в состоянии реагировать на нештатные ситуации так, как это делают опытные видеоинженеры, звукорежиссёры и осветители. А в силу фундаментальных различий природы человека и ИИ нескоро этому научатся.
Есть и ещё одна причина, которая добавляет мне спокойствия: я занят в разработке видеомикшеров (китайских), основная аудитория которых (в жарких странах), во-первых, не может себе позволить ИИ, а во-вторых, крайне редко может похвастаться кругозором и грамотностью как технической, так и букварной, которых требует полноценное использование ИИ-инструментов в их виде как нынешнем, так и обозримом на ближайшие лет как минимум пять, а скорее куда дольше.
Да, можно подсадить Африку и Индию на чатботов и вайбкодинг. Но много вы знаете африканских программистов? То-то же. Из сотен известных мне африканских и индийских видеоинженеров грамотных — единицы. Один из них, тоголезец, в Москве бывший бы, скажем так, середнячком в трансляциях средней руки и с весьма средним ценником, мотается по всей Западной Африке от Камеруна до Гамбии, поднимает телеканал с цифрой 1 в названии в Буркина-Фасо и много чего ещё делает. Это при том, что спрос на простейшие онлайн-трансляции в Чёрной Африке сумасшедший (и причиной тому... религия).
Звук и концертный свет за последние лет 7 (спасибо тем же китайцам во многом) поменялись так, что я туда даже не пытаюсь лезть.
Да, казалось бы падает спрос на озвучку, перевод текстов, рынок видеорекламы (и связанные с ним, в частности, производство осветительных приборов) сильно просели и продолжают. Но вот парадокс: одновременно растёт спрос на нишевые продукты, которые в состоянии сделать только люди. Ну кто в 2006 году поверил бы нынешней статистике продаж винила, спроса на уникальные печатные издания, аналоговую фотографию, авторскую мебель, безделушки и прочее такое, при том, что средства и методы их производства стали доступны как никогда почти всем. А вот поди ж ты.
Ну и не надо сбрасывать со счетов регуляторику. Испуганный бюрократ среднего звена при должном стечении обстоятельств одним росчерком пера в состоянии отбросить даже не одну страну, а несколько десятков стран на десятки лет назад. А уж что можно сделать со всем этим цифровым благоденствием несколькими десятками килограммов взрывчатки, этот год показал весьма наглядно, причём не только в окрестностях Москвы на прошлой неделе, а куда раньше и куда южнее. Если же в паре мест ещё и планета покажет зубки, ударив снизу магнитудой не 8 и не 9, а 11 — будет совсем занятно.
Короче, революции не будет. Будет стремительная эволюция, причём скорость её будет совершенно различной в разных частях света. А то, что пара корпораций посыпается — так ничего страшного. И не такое сыпалось. И ничего, свет пока не кончился.
игнорируя экспоненциальный рост
экспоненциальным ростом не пахнет даже и близко.
четыре года, десятки миллиардов долларов на R&D, лучшие умы человечества...
а ChatGPT как ловил дикие галюны, так и ловит.
Вы просто еще не понимаете насколько сильно меняется мир.
Один Вы в белом пальто стоите и усердно понимаете...

Пользуюсь PaintNet, закрывает 100% моих задач, бесплатный, быстрый, не занимает места. Никогда не было еще ситуации типа "ну все, надо качать фотошопик с рутрекера пэйнт.нет тут не справится". Здесь важно разделять профессиональные задачи и бытовые, и фотошоп часто бывает излишним для обычной рутины типа (вырезать, обрезать, поправить уровни и т.д).
Пользуюсь Photoshop 7 Portable. Не знанимает места (что такое сейчас 52 Мб?), закрывает все мои задачи.
В этом-то и дело! Здесь в комментах почти исключительно те, у кого только те самые простые бытовые задачи! Для них и Paint.Net не нужен, хватит и FastStone, а красноглазые когда-то и вовсе imagemagick придумали. Консольный редактор растровых изображений, надо ж до такого дотумкать!
А у меня и ещё нескольких человек здесь задачи за рамки бытовых как бы немножко выходят. Издательская цветокоррекция там, ретушь (и не уровня фотоателье у метро, а ручная, точная, по пикселю, без ущерба исторической достоверности снимка). Тут и монитор не абы какой нужен (и любой, кто попробует угадать, будет неправ), и некоторое чутьё.

Мы пробовали делать аналог нашего софта, платформы Loginom. Есть даже статья на Хабре - https://habr.com/ru/articles/1085382/.
Вопросов много... очень много. Выглядит хорошо, но стоит потыкать и тут же всё начинает падать. Причем если ты не в теме, то даже не поймешь в чем ошибка, насколько правдоподобно всё выглядит. Ну, не всё ли равно коэффициент 2.12 или 2.46? В том то и дело, что не все равно. Цифры не сходятся.
А как только начинается что-то достаточно глубокое, типа параллелизма, больших данных и прочее, то приколы нарастают. Самое же непривычное в том, что пока не потыкаешься проблем не видно вообще.
Люди как оценивают? Посмотрели ролик или скришноты, если похоже, значит работает. Выполнили парочку элементарных действий и не упало - значит всё отлично. Но в том и прикол, что на уровне "презентаций" проблем не видно вообще. Это реально ломает мозг. Специалист говорит, вот, мол, тут не так подсчитано, а для человека не в теме это выглядит как придирка.
Выглядит хорошо, но стоит потыкать и тут же всё начинает падать.
Что в очередной раз подтверждает истинность
@Hemml : Да, всё, в чем ты не разбираешься, нейронка делает хорошо. Но вот то, в чем ты что-нибудь понимаешь, она всегда делает плохо

Эти штуки ещё мягко говоря сыроваты, но сам факт - что ИИшка уже посягает на святых монополистов рынка, которые дерут космические цены, уже достоин внимания)
Интересно, как нейронке ставят задачу в случае таких сложных проектов. Вряд ли это: "напиши аналог Автокада".
А как?
Ну если котортко: “Изучи, отдокументируй, выдели главные фичи, запрограмируй их, напиши тесты и дежурные молитвы омнисии”.
К сожалению, ясности пока не добавилось. Я хотел бы научиться трансформировать своё понимание предметной области в ТЗ к программному продукту (для себя или нейронки - не так важно). Но пока не понимаю как к этой задаче подступиться.
А вы еще не создали ни одного продукта для себя с помощью нейронки? Я вот например год назад создавал бесплатную копию quizlet, только более гибкую и функциональную(точнее заточенную под свои задачи). Конечно это не AutoCAD, но все же (35$ сэкономил и на практике эффективно пользовался когда нужно было). Все начинается с трансформации хотелок в техзадание в чате, а дальше бросается агенту в IDE и поэтапно реализовывается. Хотя это наверное для меня гуманитария все кажется так просто, я ведь не обременен всякими знаниями о паттернах проектирования. Меня не интересует код, только производительность и конечный результат относительно задуманного. Так сказать "не важно какой код внутри кота, главное чтобы он ловил мышей".
Попробуйте поизучать отдельно или совместно с ИИшницей подход Spec-driven development. Некоторые ораторы искренне верят что эта штука очень хороша в выковыривании требований из головы пользователя.
Я сам пользуюсь для того чтобы дыры в логике закрыть и для того чтобы она корнер-кейсов накидала побольше. Иногда получается отлично, иногда - отлично от ожидаемого результата.
А как?
Через спецификации (spec-driven development). Сначала итеративно через review-раунды пишется подробная спецификация с применением той же нейронки. На этом этапе ей скармливается максимум информации о предметной области и том, что и как надо сделать, документация, определяются инварианты, ограничения, краевые случаи, методология тестирования и т. д. Затем нейронка пишет подробный поэтапный план реализации. План тоже проходит несколько раундов review. Затем запускается выполнение плана, часто с оркестрацией нескольких агентов. Каждый этап плана тоже проходит несколько раундов независимого review агентами и/или человеком. Над всем этим обычно насыпано куча rules, skills, tools, MCP. Как-то так.
Во всём этом дивном новом процессе разработки самое выматывающее - это review. Если не делать человеческое review и не контролировать каждый этап плана, агенты могут пойти вразнос, а тесты написанные этими же агентами не гарантируют ничего.
Можете для интереса почитать как переписывали Bun на Rust.
Я пробовал использовать нейронки. Правда, пока ограниченно - в режиме чата. Это даёт ощутимый прирост скорости - такой "умный справочник". Но есть проблема: они обучены на массиве популярных репозиториев, которым уже несколько лет, соответственно, часто дают устаревший код. К примеру, они меня уверяли что не бывает Spring Boot 4, хотя он существовал уже с пол-года :) Приходилось сгружать им ссылки на доку и убеждать что я не вру. Но всё равно часто косячат и всё равно приходится вычитывать доку и пилить руками.
Насчёт архитектуры тоже пробовал советоваться. Причём брал максимально простой и типовой (как мне казалось) случай, "про который все знают". Нейронка уверенно выдавала мне варианты реализации. Начинал делать (руками пока) и быстро упирался в проблемы. Пытался решать их с нейронкой, она очень быстро начинала "бегать по кругу" - давать одни и те же нерабочие советы.
В общем, я пока не знаю как "стать прогрессивным". М.б. всё делов том что я пока тренируюсь на бесплатных модельках. Но главная-то проблема, КМК, в том, о чём я написал в начале: не понимаю как описать моё видение предметной области в терминах ТЗ (пока даже неважно: человеку или энтой нежити).


Написали. Допустим, даже допилят по более-менее нормального состояния, при самом оптимистичном сценарии.
И дальше? Так и будут просто поддерживать и развивать как открытое ПО в своё свободное время? А живут эти разработчики на что?
а) Либо у них уже есть работа, на которой они наёмные работники, и в которой как-то продаётся платное ПО - ровно такое, против которого они и борятся.
б) Либо они должны будет добавлять в эти прожки что-то платное. Тогда, чем это будет отличаться от уже существующих платных, закрытых аналогов? Разве что только тем, что это будет open source. Ну, да, и что? Где гарантия, что в их платной версии нет без трояна?
в) Либо, будут запускать какое-нибудь IPO. Тогда, это будет называться "мы делаем бесплатно. Но, и много денег тоже хотим". А что будет с этими прожками после? Так как, инвесторам же надо свои деньги и отбивать, и ещё и прибыль, желательно, получить.
платное ПО - ровно такое, против которого они и борются
По-моему, никто особо не борется против платного ПО. Видимая цель - перехватить инициативу (и денежные потоки) у зажравшихся и малоподвижных кабанчиков. Как перехватила Microsoft у IBM, разработчики браузеров у Microsoft, и т.д., и т.п.
Ну, "а не догонят - так хоть согреются" - выработают на практике новые подходы к разработке.
"а не догонят - так хоть согреются"
(С бесконечной грустью:) Вот вы тут ржОте, а если задуматься, насколько вы правы.
В том смысле, что сколько энергии бесполезно переходит в тепло при ворочании LLMок...
В чём будет заключаться "перехват инициативы"?
И "денежные потоки", говоришь. Значит, они должны будут ввести платные версии. Чем тогда их прожки будут привлекательнее для конечного пользователя?
Там веб версии имеют платные подписки. Там где подключение LLM в их продукт
В чём будет заключаться "перехват инициативы"?
В том же, в чём и раньше. Раньше IBM выпускала компьютеры и программы к ним. Потом пришёл Билл и вклинился в этот процесс. Потом отказался быть на вторых ролях и занял первые :)
Чем тогда их прожки будут привлекательнее для конечного пользователя?
Это уже их задача: сделать привлекательнее и суметь заработать :)
Claudobe PhotoSlop
Так, они и до "желтых" доберутся, и их перепишут... :)

А есть где-то разбор или пример того как именно пишут запросы и правила для таких проектов? Включая и последующие баг фиксы? Мне действительно интересно как такое делают.
Я выше задал аналогичный вопрос. Мне там кое-что ответили, не знаю насколько будет полезно.
Выше написали про spec driven development. Я в своих проектах примерно так и делаю, правда до этого как то сам дошел - просто каких то 20 лет разработки ПО ))
0 лет опыта разработки. спросил у Астры что это "Spec-driven development — это разработка по спецификации: сначала описываешь, что программа должна делать и как должно выглядеть правильное поведение, а затем по этому описанию пишется код. Spec — сокращение от specification, то есть спецификация, или техническое задание.
Твои подробные промпты близки к этому подходу. Особенно ТЗ для Chronoscape: карточки событий, периоды, параллельные исторические полосы, импорт и экспорт, масштабирование. Ты описываешь будущий продукт и его возможности — это уже основа спецификации"
Я что-то такое и делаю на одном проекте, но он гораздо меньше чем такие приложения инна сам план (высокоуровневый) у меня ушло оклад двух недель. Больше мегабайта плана...
План большой т.к. я вижу что иначе будет написано не так и поддерживать будет очень трудно.

Как минимум craft аналоги делал чел с умением в разработку, а не Вайбкодер голый
Необходимость в программистах падает всë сильнее. А кто-то ещё верит, что ИИ не заменит большинство
Необходимость в программистах падает
У Вас в слове «овнокодерах» полно опечаток.
О, опять эта песня. Ну как расскажи мне, где же эта грань между программистом и гoвнoкодером?
Писали ли Вы в своей жизни что‑нибудь сложнее перекладывания JSON‑ов?
Приходилось ли Вам в своей жизни когда‑нибудь впихивать невпихнуемое? Ну, скажем, код, занимающий 134 байта, в последние свободные 128?
Короче, приходилось Вам ну хоть когда нибудь применять креативность, или всё больше «раз два три четыре»?
Так ИИ-шка меньше склонна к говнокоду при более менее нормальном промте , потому что какая причина говнокода, лень и недостаток времени, когда просят что то добавить и люди берут внутренность класса/корной библиотеки вытаскивают наружу, делают копипасты, делают гадклассы, потому что лень, нет времени, нет желания, неохота прогонять тесты, нет понимания в целом, у ИИ нет проблем, он и интерфейс добавит и тесты добавит и запустит.
Я начинал еще в далёкие годы с ассемблера и Си и встраиваемого софта в области DSP, систем управления и пр, по сути процентов 80% качества зависело просто от того как люди читают документацию на контроллер, процессор, API, тут снова у ИИ нет проблем прочитать 1000 страниц документации.
Там же был проект нужно было сделать софт под Виндовс который настраивает некоторые железяки и еще драйвер для PCI, это было время когда на плюсах еще писали UI и мы делали по сути свою WTL то есть обвертка С++ над WinAPI и опять что самое сложное, это читать MSDN, как использовать функции, например задача на WinAPI реализовать TreeVIew контрол с картинами, разными шрифтами, drag and drop и пр, это реально 90% просто чтение документации как использовать API и какие параметры заполнять, какие сообщения куда отправлять.
С драйвером то же самое, читай документацию делай правильно вызовы, не торопись.
Вы сами упоминали Стековерфлой, так там же куча вопросов именно как мне такую то функцию использовать, или что вызвать в C# что бы что то получить, как там сделать неблокирующею очередь, и т.д., по сути все ответы есть в документации (или большинство).
Осталось только опенсорсную VibeOs запилить, с кроссплатформенной поддержкой win,mac,linux приложений.

Имхо, следующий этап - провайдеры моделей/инференса сами уйдут в saas. Будут условные антропики продавать подписку за 10 баксов в месяц на полный пакет софта для абсолютно всего начиная от фотошопа и заканчивая каким-нибудь специфичным софтом для финансистов. А писать и поддерживать это все будет рой агентов, которые у них же в датацентрах крутятся.
Как бы ни было грустно и противно от этой мысли, но профессия программиста (и вайбкодера в том числе) доживает последние года
Хорошая попытка, но нет©
Очень надеюсь, что появятся более легкие бесплатные версии Adobe Premiere Pro и Solid Works.
Конечно сейчас не без проблем с багами и полнотой функциональности, но надеюсь через полгодика все наладится
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
С помощью ИИ были созданы клоны всех программ Adobe, Microsoft Office и AutoCAD