Comments 196

А вариант через KodaCode не рассматривали совсем?

У меня опыта использования нет. У вас есть опыт и чем можно поделиться?
Опыт пока небольшой, но положительный. Он доступен в VS Code, JetBrains IDE и терминале (CLI). Можно пользоваться их моделями KODA-BASE и KODA-PRO, но KODA-BASE галлюцинирует безбожно. KODA-PRO вполне узабельна. Можно использовать большой спектр внешних моделей, можно подключить свои локальные.
Оплата в рублях, подключение без всяких трехбуквенных посредников.

Модели их особо не тестировал, но вот автокомплит у них очень плохой, до того же Windsurf ему далеко, практически никогда не ставит закрывающие скобки и иногда теряет контекст уже написанного кода в файле. Хуже него, пожалуй, только автокомплит Gigacode, тот вообще контекст не видит, тупо фигачит отсебятину.

хитро

А почему никто не упоминает GitHub Copilot в VS Code?
Один из самых удобных вариантов для взаимодействия с нейронками для разработки, по моему опыту.
Хочешь - платишь подписку гитхаба. Не хочешь, подключаешь облачные или локальные модели.

Использую Qwen Code, обычно в паре Deepseek-4.1-Flash. Qwen Code зрелый CLI-агент, существует и разрабатывается уже какое-то время (в отличие от тех же Deepseek Harness, MiniMax Code), работает без нареканий. Deepseek-4.1-Flash подключен напрямую через API Deepseek, качество модели устраивает.
Классное сочетание, про qwen code я совсем забыл, расширю про него тоже

я работаю с deepseek flash + opencode
ещё до блокировки клоды приходилось это поднимать для задач по взлому всякого, потому что клода беззубая в этих задачах
сейчас только на дипсик, но жалко бывает токены тратить на какие-то побочные задачи, поэтому планирую попробовать создать ещё один аккаунт на клоде, с зарубежным паспортом и так далее

а как оплатить DeepSeek API?
Платимаркет. Недавно была статья со способом оплаты через Alipay, сам пока не пробовал.

Подскажите, как Вы распределяете задачи между агентами?

Меня Минимакс Код порадовал своим десктопным клиентом из коробки. Не нужно ковыряться с плагинами и отдельным апи-ключом, все в одной подписке висит
Дипсик Харнесс выглядит прикольно с его плагинной архитектурой, но пока он в превью, я бы в прод его не тащил. Слишком велик шанс, что при следующем обновлении что-то отвалится по совместимости
Вообще и смешно и грустно, что в итоге большая часть экономии на дешевых моделях тупо сжигается твоим же временем на ручные правки их галлюцинаций)

Только что проверил Kimi. Нормально работает оплата через Мир. Более того на странице оплаты две секции где можно было перейти к оплате - верхняя с описанием содержания каждого плана и нижняя с техническими характеристиками (количество конкурирующих задач, объем диска и т.п). Раньше оплата через Мир работала только в нижней секции а сейчас и в верхней тоже.

Да, вчера тоже оплачивал через Мир (не хватало Pro - переходил на Max). Причём вернули за неиспользованный период (а это 2300р, при 87% использованного лимита, в первый день выхода k3.1 оплатил). Но нужен РФ-ip'шник, иначе будет как на скрине в статье (и тут проблема бывает из-за блокировок cloudflare, за которым работает у них аутентификация -- я в итоге аутентификацию kimi пустил через прокси).

Кими дорого. Нет дёшевой модели за пивом бегать.
2.х тупой совсем
opencode go за 10$ в помощь (там можно deepseek v4.1-flash почти без ограничений (эквивалент 100$ по api) гонять)

Он там квантованный. Лучше не надо. Качество заметно хуже.

Капец он в их харнесе умный, но быстро улетели пробные тонны из-за кучи агентов, а оплатить никак


Месяц сидел на этой подписке, ну, скажем так, юзабельно. Обычный корпоративный веб бэкенд/фронтэнд (php/js) вполне мне закрывал.

Не вижу там варианта оплатить через мир, кидает в stripe.


Попробовал пользоваться. Лимит расходуется с пугающей скоростью. Обсудил пяток несложных вопросов. 6% месячной квоты ушло. Пользоваться этим нереально. Ушел на GLM5.3. На нем лимиты расходуются, по ощущениям, чуть быстрее чем было с Клодом. Но приемлемо.

Мне зашел Яндексовский sourcecraft code assistant для VSC. Оплата в рублях, Яндекс вполне справлялся с 1с, питоном и другими. До недавних событий. Когда Яндекс поломали, прикрутил Buthub и пользуюсь всеми его доступными моделями, но в основном deepseek flash.
Разница в цене с прямыми API вполне себе окупается отсутствием геморроя с доступом к этим прямым API.
В меньшей мере использую Opencode с Bothub, vsc привычней и позволяет больше участвовать в процессе. в Opencode запускаю задачи выполнение которых можно не контролировать, то есть запустил, через какое то время посмотрел результат.

Sourcecraft это просто допиленный форк Roo Code и Cline, учитывая насколько последние дырявые и кривые и полузаброшены, я работать с sourcecraft не стал, для небольших задач наверно пойдет

Тоже решил попробовать поделку Яндекса. Поставил жирную задачу - перепилить старый проект JSF на Spring Boot + React. Агент трудится третий день, окно около 500к, выжрал уже примерно 20к ихних нейрокредитов (включая грант). Самому любопытно, что получится)

По факту они сейчас продают китайские модели и под этим соусом втюхивают тебе свою экосистему. Я просил у них нормальный API ключ чтобы добавить их подписку в свой, уже настроенный, OpenCode, но нет.. ты можешь пользоваться только тем что встроено в их CLI (Который SourceCraft).
В общем в итоге я отказался, у меня еще впечатление от вирусной установки яндекс панели и яндекс браузера в голове живо, чтобы я очередное их поделие себе на рабочий ноутбук тащил..

Использовал сурскрафт чуть больше месяца (сентябрь-октябрь '26) - работает медленно, жрет кучу токенов. На работе несколько проектов на .net, в общем где то 250к+ строк кодовая база. Бывает даже на простых задачах как будто сам себе ставит палки в колеса. Пару раз крутился по часу, просто не мог довести новый код до билда без ошибок.
Я израсходовал 4к бесплатных токенов по гранту, купил подписку. Когда лимиты кончились сначала на Start, а потом и на Go за 2600 - начал смотреть альтернативы, ибо платить за GoX5 5600р уже жаба душит, тем более учитывая полученный опыт использования. Токены кончались очень быстро, я даже не уверен, что мне было бы комфортно на GoX5. Всех токенов с подписок и гранта хватило с 22.09 по 16.10.
При этом я не то чтобы использую ИИ повсеместно в рабочих задачах, обычно это готовый промпт в стиле "сделай вот это, как было сделано вот в этом коммите". Полноценной автоматизации из разряда "возьми таск в джире и доведи до МР и ответь на комменты МР" - нет
Прайсинг при этом непонятный - пока что мне пришел инвойс на 190 рублей (ну как сказать, пришел, Яндекс просто взял и списал его автоматически как будто я в такси проехал или оплатил Я.Плюс). В биллинге висит информация, что общий счет 2190р, из которых 2000 - это тоже какой то грант, ну а 190 из моего кармана. При этом где то я видел, что нейрокредиты = рубли, получается, это не так.
В общем, сменил подписку на бесплатную по быстрому, и поставил аккаунт на деактивацию.
Пока далеко до cursor или opencode, на который я в итоге сейчас перешел. На opencode 10$ подписка тоже ушла быстро, но я и использовал его активнее.
Вероятно, для автодополнений еще можно использовать, для Rider например это через плагин поддерживается и бесплатно. Либо для совсем мелких вещей. Но покупать я бы не стал точно, чисто на Free

А Codex или Grok как ?
Codex и Grok очень хороши и близки к claude как по качеству так и сложностям с покупкой и, кажется, что вопрос когда они начнут просить паспорта - вопрос времени. В статье хотелось посмотреть и обсудить, что происходит за пределами этой четверки

>Codex и Grok очень хороши и близки к claude как по качеству
смешно. codex + astra рвут opus-а как тузика (да, несколько месяцев назад было наоборот). причём астра работает на подписке.
Как там, open AI банит часто?

Не слышал чтобы банили в принципе. Работает даже на VPS с российскими ASN.

Скажу за себя (то есть свои наблюдения), работаю каждый день, мой акк, зарегистрированный ещё в начале 2023, жив до сих пор. У клауди было 3 бана (ещё до ввода паспортов), у знакомых кого лично знаю, банов не было, баны клауди были

Астра разве не сильно дороже? У меня на корпоративном тарифе нет Astra и Fable, поэтому сравнить могу только Sol vs Opus, и с последним сейчас приятнее работать, хотя во времена Opus 5.0 совершенно однозначно Sol был лучше.
астра ест больше (но по подписке работает, в отличие от fable), но просишь сделать review на опусы opus-а и всё становится ясно.
кого-то и багованый код qwen3.8 устраивает ) главное тесты пройти и х-х дальше. мне хочется чтобы код без косяков был.
Fable по подписке тоже есть, только не в самой дешёвой. Неужели астры хватает на хоть что-то вменяемое по двадцатидолларовой подписке?
но просишь сделать review на опусы opus-а и всё становится ясно
Это и в обратную сторону работает. И по бенчмаркам, и по реальным задачам Опус ничем не уступает Астре.

(внешний) аудит, проверка, ревью — всегда проще, чем генерация. Правило же. Я Клодом например мочу регулярно Алису и наоборот. Почти паритет. Алиса огрызается часто и бурно (с доказательствами) и часто по делу. Клод менее эмоциональный (меньше генерит оправданий, скромно "OK, согласен" ))
А разве нельзя составлять план астрой, писать багованный код квеном и править его астрой? По идее должно выходить почти бесплатно, по сравнению с полноценным написанием астрой
просишь сделать review на опусы opus-а и всё становится ясно.
Обычно это всегда так на сколь-нибудь сложном коде и логике, независимо от модели)
Можно и саму модель просить провести ревью её собственного кода, всегда находят ошибки. У меня обычно стабильно несколько итераций ревью и исправлений после них, и каждый раз нужно отвечать на вопросы и принимать решения по ключевым моментам реализации.

В этом и смысл. У каждой модели свои косяки и слепые зоны. Друг за другом находят баги. У меня в тучные месяцы даже скилл был подключен внутри Claude Code, чтобы оно ревьюило изменения и искало баги перед коммитом.
qwen 3.8 отлично пишет код. все правда по 10 раз перепроверит. но уэ точно по качеству вопросов нет

Подскажи плиз в личку как ты подтверждал телефон для Codex.
Я пока не рискую через всякие стоковые смс или WhatsApp номера которых в инете полно.

Живу теперь на Sol (ultra), с лимитами всё хорошо, плюс нет 5-часовых, только недельные.
https://artificialanalysis.ai/evaluations/artificial-analysis-intelligence-index

У меня работает оплата Kimi картой сбера Мир. В hosts нужно вписать правильные ip, если через cloudflare резолвится kimi.ai не было ярлычка мир при выборе карт. Первая оплата прошла 31 октября когда поменял ip.

А поподробнее? Что за "правильные ip"?
видимо любой CDN который не cloudflare, хотя может это совпадение, не знаю как объяснить. с другой стороны объясняет почему у одних все работает у других нет.
у меня в hosts
23.53.32.13 www.kimi.ai
23.53.32.39 www.kimi.ai
whois говорит что это Akamai Technologies, Inc. (AKAMAI)

А как у них с лимитами? На reddit пишут, что они очень-очень низкие и недельный лимит вылетает за пару дней работы.
Не видел такого понятия как недельный лимит. есть месячные подписки и api. по месячным подпискам общий лимит установлен в зависимости от уровня подписки. Внутри лимита на чат нет ограничений, а на код есть ограниченный объем который каждые 5 часов обнуляется (у меня тариф Plus самый дешевый на попробовать). Размер этого ограничения не могу оценить. я пробовал два вида задач: на ревью и переделку около 8 тыс строк кода (cline + vs code) уходит 5 часовой лимит 2 раза. И работа с mcp (также в cline + vs code) два файла ворд и excel (около 10 мб) проверка, сопоставление и т.п. расходуют лимит кода на 5 часов. В подписке Pro написано в 2 раза больше лимиты. Объем токенов пока не пробовал оценить.

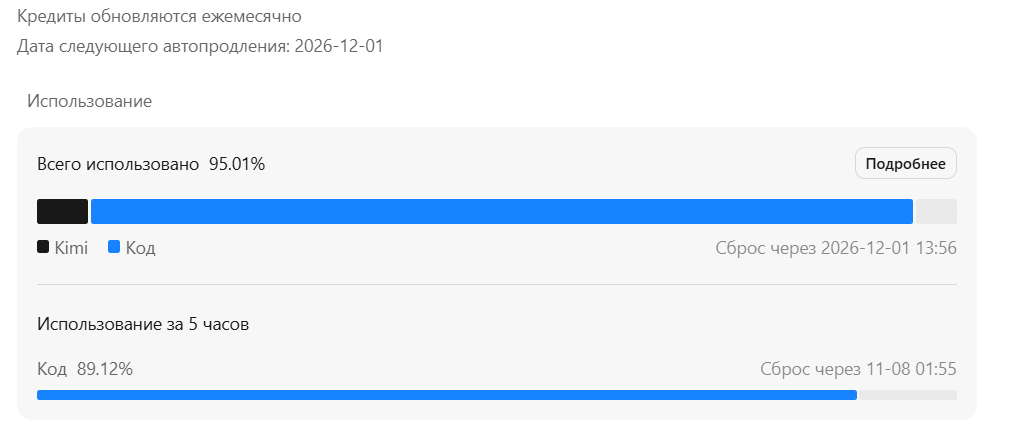

Плохо с лимитами. Точнее как, у chatgpt и claude лимиты субсидированные, если вы такое же количество токенов будете через api покупать - там по деньгам выйдет раз в 10 дороже, если не больше. А у Кими похоже на то, что в подписке токенов выдается столько же, сколько и через апи. Лично мой опыт - в первый день использования подписки plus выжег 50% месячного лимита. Правда, у меня в проекте были довольно криво настроены скиллы и документация для агентов, в клоде это не так заметно было, а в кими пришлось разобраться, куда так резво лимиты улетают. Сейчас стало получше, но все равно для постоянного использования слишком мало.

Они были у них нормальные, когда была модель 2.7 активная, после K3, стало говнище полное, на 20ке баксов за 5 минут 5часовой лимит выжирает, до этого можно было работать, до слез - всасывает контекст и в пару минут набирает лимит - задачу не закончил) ощущение что вас поимели) эти китайцы явно зазвездились..

VSCode + ZooCode + отдельный комп с Qwen3.8 next. Подписками вообще не пользуюсь (зачем? если дома есть мощный комп купленный еще до повышения цен - хотел продавать, а тут как раз локальные сетки подъехали - продажа отменилась :) ). Хотя для интереса попробовал бесплатный режим с neuraldeep (у них есть бесплатный qwen версии 3.6 + ограничения по запросам, но для всякой мелкоты хватает).
поделитесь, пожалуйста, опытом, по вашему мнению этого хватает для полноценной работы с кодом уровня опуса/сонета? и насколько у вас мощное железо?

Сразу оговорюсь, я не профессиональный программист, пишу код для себя. Раньше, за “особые заслуги” был доступ к “большим” моделям уровня GPT-5. Сейчас “халява” закончилась и я работаю на локальной LLM, а именно Qwen3.8-Flash-Next-UD-Q4_K_XL.gguf . И эта модель меня полностью устраивает, уровень не хуже чем GPT-5 и даже по моим ощущениям - лучше (ошибок в коде намного меньше). Качество кода, по сравнению с кодом уровня опуса/сонета, оценить не могу, но пример кода который написан этой моделью можете посмотреть в моем репозитории: https://github.com/SkalaSkalolaz/llama-runner . Компьютер на котором работаю: Intel Core i9-9900K , NVIDIA GeForce GTX 1080 Ti , 64 Gb. Скорость которую обеспечивает эта конфигурация в тесте llama-bench - pp512 - 79.31 ± 14.24 , tg128 - 4.76 ± 0.05 . Моя связка для работы с моделью: ClaudeCode + llama-server + Qwen3.8-Flash … , запускаю с помощью llama-runner . Да, медленно, но если Вы никуда не спешите, то качество приемлемое, главное написать хороший промпт …

если поменять видеокарту на хотябы 20х серию то можно поставить Strata. на вашем железе будет 30-40tps
С такими скоростями deepseek v4.1 flash по API выйдет дешевле, чем счет за электричество, а там более амортизация оборудования. Серьезно, если хочется крутить локально, стоит обновить карточку хотя бы до уровня 3060 12 gb.
По скорости - кому как, для хобби я предпочитаю короткие, но продуктивные заходы, поэтому меньше 200 ток/сек даже не рассматриваю, на работе да, можно и 50 т/с, все равно спешить некуда.

Просто скорость — это ни о чём. Какой был размер заполненного контекста в момент теста? какой был time to first token (первый раз и второй с префикс кэшом)?
Вполне хватает. Кодирует она сильно. Немного косноязычно по русски пишет так что для литературных текстов не очень, но в кодинге даже лучше sonnet 5.5.

Gemini — не Claude, он прекрасно работает даже через расширение в браузере.
Создать аккаунт в Gemini задача не простая, так как потребуется телефон иностранный, карта и средство обхода. Также на прошлой неделе в нескольких источниках были новости про блокировки, но, судья по всему, ситуация не массовая

У меня gemini часто отлетает, потому что по каким-то там своим алгоритмам узнает, что я из России несмотря на ВПН. Правда не сразу, а через несколько недель. Уже несколько локаций сменил.
У Гугла вообще своя какая-то тема по определению страны. Сидел через финку - показывал UK. Сидел через Швейцарию - показывал Зурих.
Полностью пока не блокировали. Подписка правда только про, та самая индийская за 600 рублей/18 месяцов

geohide?
Вероятно расхождения ряда параметров (geo, time и др) через фингерпринты / User agent браузера, где светиться и системная локаль (?)
Про это есть много разных fix расширений для браузеров

Я тупо Google по GeoSite и GeoIP пустил на WARP / фришный Proton со стороны своего VPS, вполне себе работает

Подписку уже по 180р эту продают ) но там только 3.8 Flash и остался. Гугл опреляет страну по трафику, если он идёт из РФ и в РФ, то сервер через некоторое время перекрашивается в РФ, не зависимо от того какой у него IP. Надо менять сервер, старый постепенно остынет и потом можно вернутся. У меня под гугл 3 VDS чередуются на автомате + авто-WARP на них если не успел ни один остыть.

Телефон российский, селфхостед прокси с евросоюзной AS, оплачиваю подарочными картами Google Play, регион сменили по запросу на страну прокси без единого вопроса. Не скрываюсь (незаблокированными сервисами пользуюсь без прокси), Gemini, Antigravity, AI Studio требуют прокси. Подписка Pro за все деньги, уже полгода как полёт нормальный.

Это весьма странно, поскольку я зарегался год назад, имея лишь логин в Google, и совершенно точно там не привязан ни один зарубежный номер. Даже сомнительно, что там вообще привязан телефон.

У Cline есть ещё своя подписка 10 баксов в месяц в которую включены все основные модели, но с лимитами день, неделя месяц. На задачах с автоматизированным Code Review (5-8 задач в день) этих лимитов хватает на 2/3 месяца.


Можно просто купить готовый акк ChatGPT на торговых площадках (plati, gg). Смотрите где есть верификация номера для подтверждения аккаунта.
Да, это дороже чем cline, но проприетарные модели пока хорошо оторвались от открытых.
Подписку берите Pro, а не Go чтобы можно было подключать к vscode.
Агент для vscode использую kilo, т.к. в нём можно хорошо контролировать каждое действие которое хочет совершить агент. Либо не заморачиваться и поставить codex
Да ну нахер этих перекупов. Головной боли больше, чем пользы. В прошлый раз оплачивал подписку на пол года, все было отлично, у того же продавца оплатил на год, ожидая, что будет все то же самое, подключал очень долго, а спустя месяц решил, что пора закрывать бизнес и перестал продлевать подписку. А оплачивать каждый месяц самостоятельно ещё больший геморрой.
Поэтому полностью перешел на z.ai , ибо спокойно регистрируется и работает из РФ, только виртуальную карту выпустить долларовую + иногда современные дешевые модельки на openrouter потыкать.

Дипсик на родном харнессе очень хорош для своей цены и скорости, и главное - он, черт возьми, стабилен. У OpenAI какая-то лотерея, то астра ваншотит сложную большую задачу даже не почесавшись, а в следующей простой задаче наваливает такого говнокода, что разбирать его приходится дольше, чем писать руками. У дипсика прослеживается довольно четкий предел возможностей, и этим он хорош, потому что понимаешь, что от него ожидать. В большинстве случаев, конечно. Некоторая доля хаоса присутствует у всех, никуда от этого не деться.

Может кому интересно для исследования: использую OmniRoute (+подписки CommandCode(x2)), hermes agent, hindsight, oh-my-pi. Все на VPS за пределами. Подписки - через ПлатиПоМиру.
не реклама.


Замену тяжело найти, Claude до истины доходит за меньшие траты токенов и шагов 😭

Да, на определенных задачах вообще я не вижу замену Opus-5.5. Даже Sol-6.1 что-то вроде делает, но тратит огромное количество просто токенов и времени

Это правда, я для себя единственной альтернативой, если блокнут, вижу только платить за клод по API, но чтобы он составлял план и оркестрировал sol 6.1. Тоже дорого, но пока время дороже.

Согласен. Claude после курсора на компорсере просто прорыв в проекте сделал. Причем за день, буквально.

Вы только в контексте вайбкодинга рассматриваете? Потому что для диалогов меня больше всех Gemini порадовал.

Гемини, на мой вкус, просто постоянно галлюцинирует и уверенно пишет выдумки. Причём если обвязать ограничениями, упирается в другую крайность - не видит в упор очевидного.
Ну так они все галлюцинируют в той или иной мере. Видимо, всё зависит от специфики задач. Поэтому я обычно каждый тип задач на разных моделях проверяю. Плюс сами модели же кардинально могут отличаться выдачей в зависимости даже от минорной версии (и не всегда в лучшую сторону).
У Клода я глюков не заметил, скорее наоборот - он остальных на этом ловил
У Клода я глюков не заметил
Ну бывает, чё)) Они по определению неизбежны - поскольку модели имеют ограниченный объём семантики. Чуть глубже в какую матчасть копните... С геометрией, например, у всех серьёзные проблемы.
Вот, первое попавшееся в истории диалогов ткнул:
Скрытый текст
Да сколько угодно. И у Опуса и у Астры. Код-то они генерят рабочий по хеппипас, но это небольшая заслуга. Иногда они такой говнокод выдают что ужас. И чинить по простым промптам не хотят, приходится явно говорить что как надо написать.
Буквально на этой неделе Опус мне нормально написал 50 строк вроде несложногого (на мой вкус) кода с четвертого раза. И посадил там баг. Прямо явный корнер кейс забыл. Корнеркейс абсолютно реальный, а не что-то придуманное мной.
О, скажите, а Астрой можно заменить Клод? Мне для простых задач, чаще с аналитикой и работой с документами. Сложный код не пишу, так простые модели машинного обучения для предсказания характеристик. Мы не айтишники, скорее юристы - надо рутину на него перенести
Нет, нельзя. После бана клода спросил у гпт, что использовать после opus 5.5 high. Он ответил astra high. Первая же задача (заменить пару полей в форме и написать миграцию) упёрлась в 5ч лимит, не доделав до конца. Миграцию сделал абсолютно неправильно, будто потерял контекст. И, конечно, тратил на это по 20 минут времени. Опусом я бы за пару минут все сделал, потратив не больше 10% 5ч лимита.
А, и контекст 200к после 1кк в клоде выглядит смешным
В вашем кейсе можно конечно. Проблема когда нужен качественный сложный код. Там Клод все еще вне конкуренции.
Если есть кто не технари, а кто в гуманитарных целях использует, подскажите альтернативную модель с очень хорошим reasoning и умением в прозу.
А то я новеллу пишу и мне нужен "партнёр" с которым я смогу спорить по сюжетным моментам

говорят glm все ещё может прозу, но рекомендую потестировать хотя бы на опенроутере
Прозу не пробовал, но стих ChatGPT пишет очень хорошо. Раньше, с год назад, было много ошибок в рифме, сейчас такого нет…

Альтернативу чему? Опусу? Хз, чатгпт пишет неплохо, но очень сухо, после Клода вообще не то. Самому интересно.
В художественном плане лучше всех Gemini работал. Возможно, это субъективно, но скажем так - он в юмор умеет лучше чем весь современный стендап ;)
У Gemini есть одна маленькая проблема. Нет системы проектов в ai studio и памяти по проекту. Только app.
Ну и ещё с reasoning у него какая-то беда. Я делал бенчмарк по манускрипту - слишком очумительные выводы делал, не смотря на четкие инструкции не выдумывать чепуху не ссылаясь на манускрипт.
Мне умение в прозу нужно для редактирования того, что я сам написал, а не для того, чтобы он сам весь текст написал.
В целом когда я общался с chatgpr и gemini, мне они сказали, что им гораздо проще написать все самим чем разбирать со мной сюжет и редактировать мою прозу (которая хромает ещё пока).
Claude лучше всех с моими запросами справлялся. Пока не забанили, но готовиться надо =\

Deepseek как-раз хорош в "креативности", даже когда его не просят))

Я пишу фанфик на бесплатных чатботах, одновременно даю задания на творческое расширение и улучшение текста трем - deepseek, gemini и qwen; дальше выбираю лучшее буквально по фразам и свожу/довожу до ума результаты в deepseek (при этом реально конкуренция в основном между deepseek и gemini; qwen похуже). А начинал с grok, но он сейчас совсем испортился. chatgpt тоже не очень, claude средненько, но давно им не пользовался, да и больше трех выдач уже просто напрягает вычитывать:)
Попытаю счастья с DeepSeek наверное.
А так Opus на самом деле больше всего мне подходил. Хоть на сторонние API переезжай, которые сами небось закроются в какой-то момент...
Вот сейчас возобновил работу с бесплатным claude - пожалуй он вполне на уровне deepseek и gemini, но там другая засада - очень маленький лимит токенов бесплатно; в моем случае получается по одному-два фрагмента в день (фрагмент примерно 10К). Но мне хватит - я никуда не тороплюсь, а основная работа с правками все равно в deepseek.

Спасибо!

Мне кажется, что зависимость от моделей Антропика... психологическая. Потому, что модель работает добросовестно, а не просто выдаёт ответ с минимумом собственных усилий. Оно план по пунктам напишет, и в интернете последние спецификации поищет, и стаю агентов запустит, и код напишет и как минимум smoke тесты; очень хорошо объяснит, что было сделано и как именно, а потом ещё задаст разумные вопросы по дальнейшей работе. То есть, тебе не нужно быть погонщиком стада, не нужно слишком сильно детализировать и проверять, где странные костыли разбросаны. Это очень чувствуется при смене на более "дубовые" модели, например на китайские.
Но "китайцы" постепенно перенимают эти манеры...


Лично мне понравился вариант VSCode + расширение Kilocode + API дипсика напрямую, удобно, быстро, дешево, качество устраивает.


Два месяца использовал MiniMax, и крайне в нём разочарован. Кроме огромного количества токенов за немного денег, других плюсов не нашёл. Перешёл на Qwen - небо и земля. Но всё субъективно, конечно.

Я с недавних пор использую посредника polza ai. Дипсик, Клод, гпт работают как агенты в vs code + Zoo. Раньше опенрутер использовал, но проблемно оплачивать постоянно через посредников.


Чем заменить Claude или Gemini после блокировки
Как насчёт мозгами? А, ну да...
Как насчёт вообще отказаться от компьютеров и пользоваться только мозгами?
Ох уж мне эта молодьож. Ничего без компьюторов не умеет: ни программировать, ни даже в быструю приближённую арифметику в уме.

увы, вы им ничего не объясните и не докажете. я вот помню сам, как слышал сотни раз в школе вопрос "зачем считать, если есть калькулятор". а потом человек, уже взрослый, чтобы поделить 1000 на 8, запускает тот самый калькулятор на телефоне и вообще не видит в этом проблемы, у него всё в порядке. вот и здесь так, ну не донесёте вы, что программировать увлекательно, а думать - полезно. им не надо, просто не надо) и найдётся огромное количество аргументов, чтобы не предпринимать хоть какие-то усилия. зачем?
А это, увы, уже вопрос воспитания, и техническими средствами он не решаем. Ребёнку ещё в самом детстве не показали, что что-то делать — это интересно и увлекательно. А дальше — по накатанной...
То есть вы калькуляторами принципиально не пользуетесь и операции над многозначными числами выполняете исключительно в уме или на листочке? Если кто-то не может поделить 1000 на 8 без калькулятора, то проблема, очевидно, не в калькуляторе. LLM такой же инструмент, который можно использовать по-разному. Просто не надо впадать в крайности.
Если кто-то не может поделить 1000 на 8 без калькулятора, то проблема, очевидно,
в том, что человек не способен понять, что
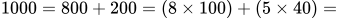
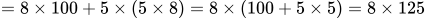
Кажется цепочка 1000-500-250-125 быстрее и нагляднее. Старым добрым “русским” способом на степени двойки делить проще всего ИМХО.
Кажется цепочка 1000-500-250-125 быстрее и нагляднее
Так до этой цепочки ещё надо дойти... А если задача на 9 поделить?
Ну и 1000/8 я лично просто по памяти помню.
У каждого в мозгу свои мнемоники. Я, например, начинаю с «какое максимальное число можно получить, если делитель домножить на степень десяти», потому что на следующем шаге очень просто будет вычитать.

Есть мысли почему тебя везде минусуют? Ну если мозгами подумать

Судя по тому,
как автора коммента заминусовали,
использование своих мозгов не в почете.

DeepSeek в родном harness по api + локальная qwen 3.8:27b в codex. В разных связках разные проекты. Косячат обе (по крайней мере по данным внешних аудитов от Claude и Sol) DeepSeek лучше и быстрее, но у меня не сильно сложные проекты и время разработки не критично.

Меня одного удивляет, что в эпоху когда ИИ должен заменить программистов, оказалось что написать нормальный харнесс нет так то просто даже для создателей ИИ, причем ведь исходный код Клода утек. Получается, все-таки, нас пока рано заменять?
Так речь вряд ли о полной замене. Ускорение процессов, удешевление, замена джунов. Рынок сократится, но полностью не исчезнет. Просто нейросети нивелируют навык написания кода.
Просто большинство харнесов это наспех слепленная вайбкод масса, подсмотренная у конкурентов на которую в гонки за пользовательским вниманием наслаивается тонна нового функционала а также плагинов, mcp, скилов, вытекающая в потерю контроля и проблем с производительностью. Возможно у антропиков сейчас благодаря налаженному процессу и их реально лучшим моделям удалось как-то всё это скомпоновать в очень хороший продукт, но вот на текущий Codex для винды без слёз не взглянешь.

Удивлен, что никто не упомянул OpenCode. Как CLI мне нравится. В качестве "мозга" можно использовать очень много чего, хоть локально развернуть в LM Studio, хоть API токен от какого-нибудь посредника

Я OpenChamber поставил, это надстройка над OpenCode, рекомендую. В принципе ради одной цели ставил - чтоб можно было с телефона управлять (крутится опенкод все равно на компе, но вставать с дивана чтобы нажать там ентер это же не по-вайбкодерски, а родной вебсервер опенкода какой-то убогий). Но постепенно втянулся и там и другие интересные функции тоже есть - посмотреть лимиты, создать worktree, встроенные инструменты для работы с браузером и снимков экрана.
Для локальных моделей, где сильно ограничен контекст, это не лучший выбор, он занимает десятки тысяч токенов еще перед первым запросом. Лучше Pi и его форки.
Когда мне заблокировали подряд 2 аккаунта Claude на весенних блокировках, то я создал новый и улучшил сетевую инфраструктуру, чтобы все ip с роутера чётко совпадали с картой и даже городом указанным в документах оплаты (KZ). Все запросы геопозиции на устройствах с клиентами запрещены. Пока норм, использую Ultra.
Для Gemini использую за 200р подарочную подписку AI Pro на 1,5 года. Но там только Gemini Flash 3.8. За пивом ходить и общие настройки, верстку без TS, скелеты архитектуры или планы сделать годится, глубокий код ни в коем случае. Но цена вопроса решает. Капризный к Geo, определяет не по IP а по трафику, перекрашивает сервер в RU, тогда надо менять выход на другой, старый со временем опять становится не RU и трафик на него можно вернуть.
Что я пробовал на замену:
SourceCraft от яндекс. Хорошо как по мне. Если выбирать между ним и qwen или deepseak без учета цены, то я бы выбрал его. Но дорого, цену на 2 делить и тогда можно думать.
Codex - хуже claude в больших контекстах (да и контекст в 2 раза меньше). Если проект не большой или можно изолировать агента без разрастания контекста, то не хуже claude на бэке. На фронте отличный.
Kimi - та же проблема - начинает упускать обязательные инструкции на больших контекстах. Дорого.
Gigacode - мок для нейронки ))
Qwen, deepseek - сырое, уровень генерируемого кода меня не устроил.
Локальные модели - ещё хуже, чем 5.
Это моё IMHO, все у вас может быть иначе и это нормально для нейронок. Все зависит от вашего проекта, его архитектуры и правил кода/ревью для агентов.
Я использую для: Symfony, Bitrix (вот тут и надо контекст), kotlin под андроид, Vuе как фронт, Go для роутеров, администрирование серверов.

Я использую openCode и мультитул с api таймвеба. Цены в принципе нормальные, и там можно выбрать локальный контур для чувствительных данных и 152 ФЗ. Как бы не сказать что дешево но пойдет, в мультитуле есть бесплатные лимиты. Харнес тоже когда использовал подключал api таймвеба.

блокирнули русским клод
прифигел слегка народ
ищут все альтернативу
чем писать хороший код
скажут, странные ребята
кто в момент ИТ войны
продолжал вливать монету
в зарубежные ИИ
ну а выходов не много
и людей я не виню
суверенные модели
предоставили херню
нет, работают не плохо
пишут даже сносный код
только цены на токены
нахерблэтебанарот!!!

Автор, а как же использование Strata?)) вместо плотной модели на 27B+ можно запустить мутанта MoE

Использую OpenCode с локальной GLM 5.3 через Project Muse (форк strata). На удивление хорошо работает, 15 ток/с стабильно. Поднял контекст до 256К через конфиг, на производительность вообще не повлияло. Не такой "метеор" как qwen, но и переделывать по 10 раз не надо. Но 90Гб ОЗУ отъедает с лёгкостью.
На каком железе у вас это крутится? На 5090 + 128ГБ RAM запустится?
“Канешна” … а если без юмора, то много зависит от VRAM, чем больше - тем больше слоёв будет использоваться на GPU, а RAM на таком ПК достаточно для запуска, к примеру: unsloth/Qwen3.8-Flash-Next-UD-Q4_K_XL. Можно использовать и послабее “машины”, вот как у меня Intel Core i9-9900K , NVIDIA GeForce GTX 1080 Ti , 64 Gb. Тоже работает, но медленно. Только свои “тонкие” настройки требует, поэтому для упрощения работы с LLM написал свой скрипт на Go, можете глянуть в репозиторий https://github.com/SkalaSkalolaz/llama-runner. Можно как провести сборку из исходного кода, так и установить с помощью curl -fsSL https://raw.githubusercontent.com/SkalaSkalolaz/llama-runner/master/install.sh | sh . Вообще в интернете много различных руннеров для запуска локальных LLM, со многими звездами на GitHub, которые упрощают работу пользователя с LLM .
к примеру: unsloth/Qwen3.8-Flash-Next-UD-Q4_K_XL. Можно использовать и послабее “машины”, вот как у меня Intel Core i9-9900K , NVIDIA GeForce GTX 1080 Ti , 64 Gb. Тоже работает, но медленно.
А какая скорость у вас получается на этой машине? Как я понял, Qwen3.8-Flash-Next-UD-Q4_K_XL упирается в скорость RAM, а VRAM не так уж сильно ускоряет (коль модель целиком в VRAM не умещается).
Я недавно собрал еще одну дешевую сборку: на авито взял старрую материнку asus с двумя полноценными портами (pcie4x8 - при одновременной работе) и две видюхи 5060ti и 64ГБ RAM. Модель unsloth/Qwen3.8-Flash-Next-UD-Q4_K_XL дает всего 20 т/с. Но я не оптимизировал, просто запускал с настройками по умолчанию в unsloth desktop.
Видел, что народ активно использует решения типа strata и пр. для ускорения в разы, но боюсь, это ускорение дается ценой некоторой лоботомии (видел некоторые утверждения на этот счет).
Скорость которую обеспечивает эта конфигурация в тесте llama-bench - pp512 - 79.31 ± 14.24 , tg128 - 4.76 ± 0.05 . Моя связка для работы с моделью: ClaudeCode + llama-server + Qwen3.8-Flash … , запускаю с помощью llama-runner. На счет всяких скоростных моделей, скорость возрастает, но Вы правы, качество кода падает и соответсвенно, за счет “серии” правок по времени получается, что ~ одинаково. По этой причине, сейчас и работаю на проверенной мною unsloth/Qwen3.8-Flash-Next-UD-Q4_K_XL. В моих задачах, ошибок почти нет. Как работаю: сперва пишу промпт, прошу LLM “разобрать” его как профессионал и предоставить ее формулировку промпта (что бы было понятно, что мы рассуждает об одном и том же). На втором этапе, что в результате правки кода должно быть получено. Потом что бы LLM написала план работ … Соглашаюсь с ее планом или прошу его поправить и даю команду на выполнение. После каждого пункта плана, LLM проверяет код go test и т.д , а в конце цикла полноценная проверка. “Вычитку” кода не провожу, в продакшен мой код не идет, проверяю по функционалу. На одну задачу уходит от 3 до 5 часов времени, поставил на ночь, утром посмотрел …
На втором этапе, что в результате правки кода должно быть получено. Потом что бы LLM написала план работ … Соглашаюсь с ее планом или прошу его поправить и даю команду на выполнение.
Да, логично. Я сейчас использую редактор zed, подключил его через openai api к локальной модели Qwen3.8-27B (llama.cpp через llama-swap). zed уже заточен под работу с LLM, мне понравилось, но надо еще будет глубже разобраться. Мне понравилось, что zed автоматически делает проверки синтаксиса с основой на pyright (он подсветкой ошибок и предупреждений занимается), а также сам "на лету" временные тесты создает, даже тестовые БД. Хочу глубже разобраться с этим. Но мне такая работа нравится. И он также выдает описание, что сделано, и предлагает применить или отменить.
Для кодинга использую Qwen3.8-27B_Q6_K, т.к. на 5090 она целиком влезает в VRAM и скорость 100+ т/с.
ЗЫ
На следующей неделе обещают Qwen4-27B и Qwen4-flash и еще какой-то. Ждёмс...
У… На моем компьютере с Qwen3.8-27B все очень медленно … Но я прогонял через бенчмарки и плотную и MOE модели, то получается что Qwen3.8-27B чуть “тупее” чем Flash. Вот результаты тестирования wikitext:
llama-perplexity -m ~/GGUF/Qwen3.8-27B-UD-Q4_K_M.gguf -ngl 40 -c 512 -f wikitext-2-raw/wiki.test.raw -> 29.33.724.140 I Final estimate: PPL = 6.9642 +/- 0.04499 . llama-perplexity -m ~/GGUF/Qwen3.8-Flash-Next-UD-Q4_K_XL-merged.gguf -ngl 6 -f wikitext-2-raw/wiki.test.raw -> 81.15.628.270 I Final estimate: PPL = 4.6254 +/- 0.02816. На знание Go: llama-perplexity -m ~/GGUF/Qwen3.8-27B-UD-Q4_K_M.gguf -ngl 40 -c 512 -f go_corpus.txt -> 236.31.659.145 I Final estimate: PPL = 1.5943 +/- 0.00205 . llama-perplexity -m ~/GGUF/Qwen3.8-Flash-Next-UD-Q4_K_XL-merged.gguf -ngl 6 -f go_corpus.txt --chunks 500 -> 77.12.215.054 I Final estimate: PPL = 1.4037 +/- 0.00506
7900XTX 24Гб и 128Гб DDR4 - на удивление AMD не в пролёте

Попробовал кими на месяц, потом на год взял второй тариф, а потом грейданулся до третьего, тоже на год. Сравнивать, кроме как с бесплатными моделями, не с чем, но мне его и для работы и для личных проектов хватает. А теперь и вовсе можно из России купить выгодно.

Пару дней уже использую deepseek 4.1 flash на opencode go подписке. В целом по уровню моделей конца 2025 года, но за эти 10 баксов лимиты выжечь будто бы нереально.

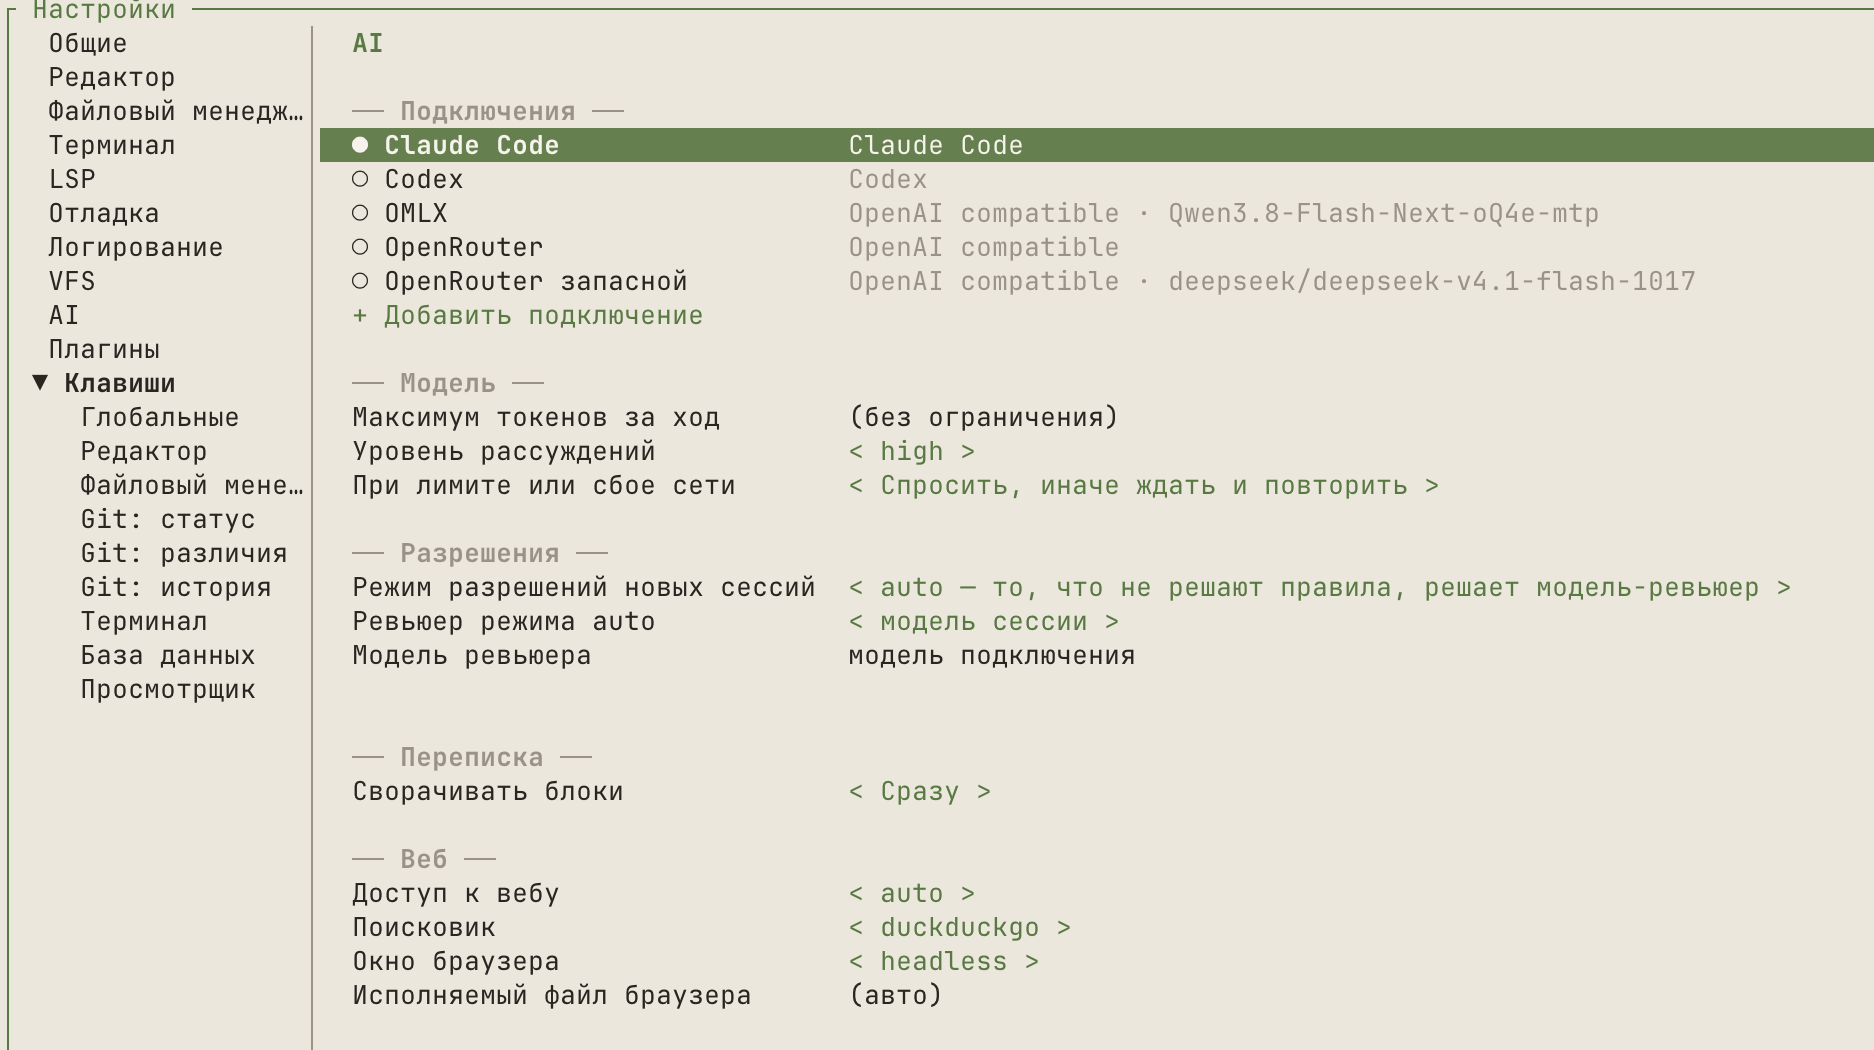
Поделюсь своим вариантом который пилю уже почти год - termide.
В работе использую список подключений из подписок и апишных инференсов, например сейчас это: Claude Code, Codex, локальная OMLX (Qwen3.8-Flash-Next, Qwen3.8-27B), OpenRouter (deepseek-v4.1-flash). Если упираюсь в лимит переключаюсь на подходящую.
Красиво, но пока устанавливать не стал… В свое время тоже пытался написать своего агента для кода на Go, но уперся в “нестабильность” ответов от LLM и забросил это дело. Проще оказалось “прикрутить” к ClaudeCode локальную LLM через llama-server … Поставил Вам “звездочку” :>)
Спасибо за "звёздочку" :) Конечно это больше монолитный воркспэйс на разные случаи жизни нежели просто харнес вокруг ии инференса. Когда делал харнес, то основными принципами ставил - не наворотить непрозрачных эвристик, сделать полностью прозрачный и настраиваемый системный промпт. Для слабых моделей которые часто циклятся есть автодетект на зацикливание. В целом скажу что Qwen3.8-Flash-Next, Qwen3.8-27B в локальном инференсе очень даже ничего даже на продуктовых задачах, по уму гдето между соннетом и опусом, только размышляют больше раза в 3.
Если есть возможность для OpenAI с Codex - вообще непонятно о чем речь тогда, кроме Опуса никто с ними не сравнится для кода. Никакие китайские модели и рядом не стояли (простите Kimi и GLM-5.3). А если нет - то лучше уже облачный Qwen в QwenCode или любом другом харнессе. Уж точно лучше глючного Deepseek и прочих.
Локальные модели использовать для кода - только если скрипты "для себя". Для других - лучше не надо.
Последний Deepseek пробовали юзать? Напрямую через его API, а не через агрегаторы моделей - те, кто используют через них, обычно и жалуются на качество. Пишут что в агрегаторах используются квантованные версии https://habr.com/ru/articles/1104258/comments/#comment_30610842

Я задолго до текущей ситуации понимал что будут сложности, поэтому начал делать свою IDE куда можно любую модель зацепить. В личке есть ссылка. Там уже можно автономно программировать и править баги.
Давайте честно: chatgpt и claude - лидеры. chatgpt проще всего купить и продлевать, будучи в РФ (я нахожусь в РБ, но проблемы у нас в этом плане общие). Claude на сегодняшний момент можно только продлевать, с продлением новых аккаунтов (открытых после 15 сентября) сейчас проблемы на "сером рынке". DeepSeek до их функциональности не дотягивает. Gemini - вроде мощная штука, но я пока не работал с ней, поэтому ничего толкового сказать не могу.

Cline раньше использовал, но он сильно уж простоват, зато у них появилось десктопное приложение - подключаешь локальную модель и можно спокойно выполнять задачи аналитика и обработки данных, документов. Для не программистом самое то.
Я же для себя открыл и пользуюсь активно уже второй месяц - oh-my-pi. Чего только не умеет из коробки, до сих пор иногда открываю в нем что-то новое и полезное. А как добавил ему ponytail - код стал сильно лаконичнее, и задачи быстрее доводит до конца.
Можно подкрутить еще скиллами под языки программирования, но какой-то прям вау-разницы я не ощутил, хотя и вижу что регулярно часть из них используется в процессе.
Есть у меня случаи, когда агент нужен на удаленной машине или в контейнере - в таких случаях я обычно использую VSCode+Kilo. То есть не надо ставить в терминале отдельно (а иногда и не получится), только VSCode сам запускается внутри себя и позволяет активировать расширение Kilo. Он в последнее время тоже ощутимо прокачался, вполне удобно пользоваться, хотя по возможностям все таки уступает omp.
А модели я беру у агрегаторов. Например Opencode Go, или что-то подобное. В последнее время основная модель это Deepseek V4.1 Flash 1017, прям для всего можно. Но на длинных или сложных задачах упахиваюсь следить сам, ставлю над ним надсмотрщика. Последним пробовал надсмотрщиком Qwen 3.8 Max, по ощущениям прям неплохо дополняют друг друга и лимиты не так сильно выжирают. Как вариант, GLM 5.3 неплох тоже, и GLM 5.3 Flash иногда как запасную после дипсика использую - они дешевле, но и слабее в рассуждениях.

У меня в VS стоит Cline и Claude Code, в Cline для планирования используется deepseek/deepseek-v4-pro-0813, для действий moonshotai/kimi-k2.7-code. Но вот чем мне понравился Claude - я его попросил, подключись через USB к моему полетному контроллеру, считай из него конфиг Betaflight. Он через Powershell сам подрубился, все прочитал.
А Cline сразу в отказ - я к USB подключаться не могу... Почему такая разница - модели умнее или просто скилы в Claude прописаны лучше?
никто не упомянул, что у VS Code есть свой Copilot, который постоянно обновляется, имеет бесплатные 200 кредитов в месяц, и там можно по API любую свою модель ставить.
главный его плюс, это нативная поддержка VS Code.

Тоже на днях заблокировали клод. Очень неприятное отношенеи к пользователям. Сейчас подключил и тестирую Кими К3.1, автор пишет что оплату заблокировали, это не так, пару дней назад оплатил без проблем картой мир. По первым впечатлениям неплохо, плюс хорошо заточнеа под 3д моделирование, это прям то что мне нужно. По ощущения действительно очень медленно работает по сравнению с клодом, и лимиты сброс раз в месяц, это конечно фэйл, хз как будут тратится, 50% уже ушло за подписку 20$, хотя я еше ничего не делал только переносил проекты. Ну посмотрим на рсход в будущем. Автору спасибо за статбю, было интересно)

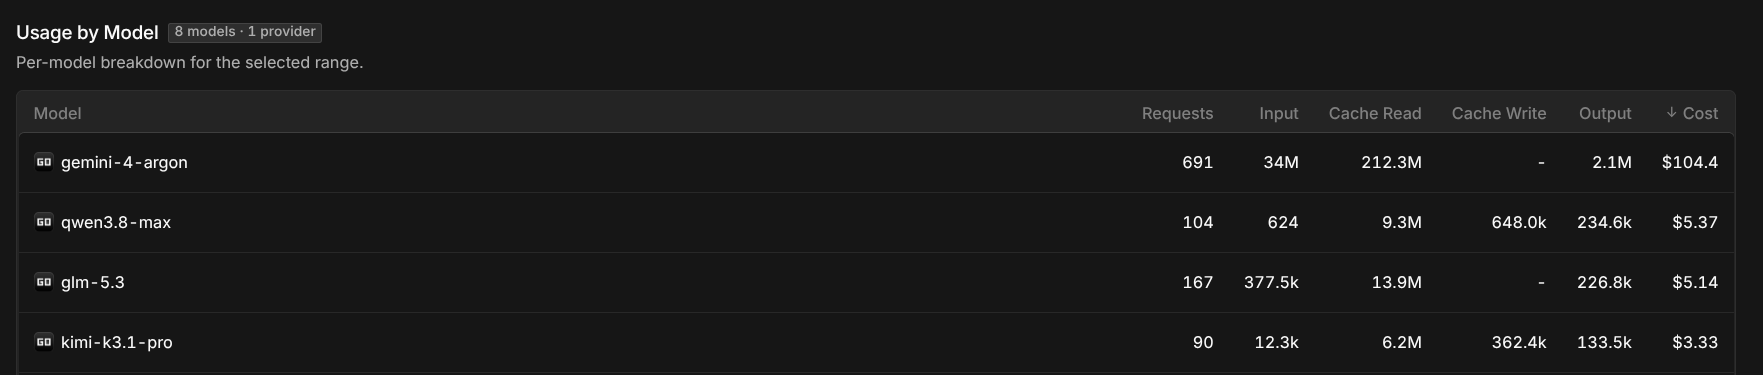
Использую такой стек: opencode, Gemini Argon для планирования и ревью, GLM 5.3 в роли основного исполнителя и Kimi 3.1 Pro для сложных задач. Пока полет нормальный. Сильно дороже, чем Opus на все роли, но результат радует.

Конкретно моя обвязка Qwen code (кстати нормальный терминал, достаточно взрослый уже, я его застал еще ребенком без сжатия контекста:)) + Qwen3.8-27B Q4_K_M для локальной работы и Codex для облака.
Пробовал также paperclip - но не понял смысла, по мне так ересь получилась.

Пересел с клода (забанили 2 аккаунта макс подписка) на локальный qwen3.8-flash-next-iq3_s. По конфигу: 5080 + 128gb ram. Память xmp профиль 5600. Работает все в связке strata + deepseek harness. Удалось выжать 262k контекста, 4к префилл и порядка 150 т/с генерация. Для моих задач хватает вполне (в основном код на dart/flutter, kotlin, так же e2e тесты на устройствах).

Opencode + подписка Opencode Go $40. Все агенты работают на Argon High - месячный лимит улетел за 7 активных дней. Для сравнения на клодовсвкой нищенской $20 подписке эти же задачи бы выполнил за 30% его недельного лимита на opus5.5 high.
Поэтому, как уже выше отписались, нужно комбинировать argon / glm5.3 / deepseek flash.
На работе пока удается перебиваться codex ($20) + opencode go ($40). Сейчас смотрю в сторону оптимизации воркфлоу на opencode go в сторону Argon medium + glm5.3. В качестве альтернативы еще можно рассмотреть codex ($100) и z.ai подписки.
Чем заменить Claude или Gemini после блокировки