Comments 109

Вот сам репозиторий: https://github.com/wilsonzlin/fastrender
Прикольно, конечно, задача более чем масштабная выбрана.

Интересно, что там ни один экшен не проходит, из последних по крайне мере

интересно, какой самый масштабный проект будет написан исключительно с помощью LLM в 2026 году?


Так оно ж даже не компилируется. При том что CI там настроен, но последних 4 дня все проверки фейлятся. Даже при том, что последний (на данный момент) называется "resolve browser binary compilation errors", оно нифига не компилируется.


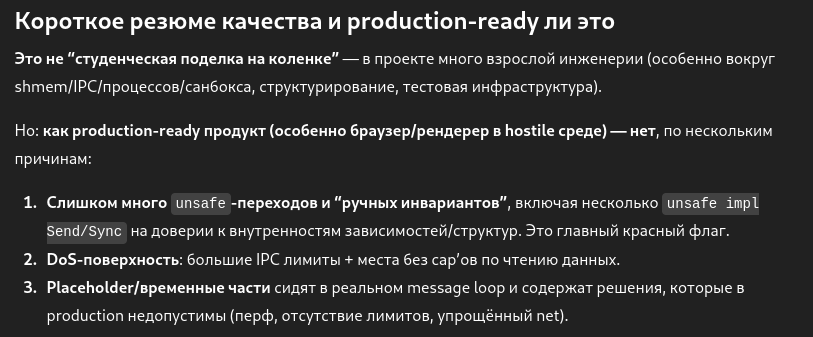
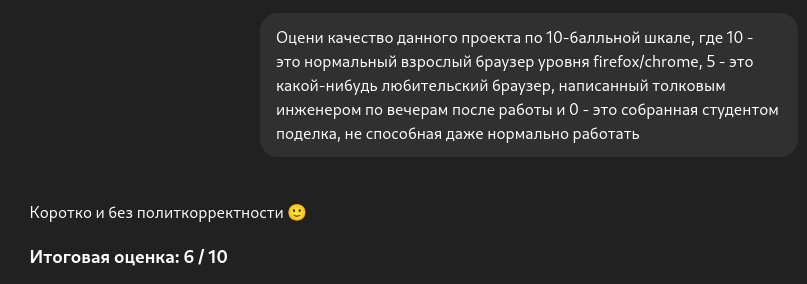
Вот что думает сам GPT-5.2 о данном проекте после анализа исходников

Перевожу
WebKitWebView и подобные GTK/WebKit объекты внутри используют сырые указатели, которые не реализуют Send/Sync автоматически. Но автор знает (или надеется), что реальное использование однопоточное или защищено движком
скорее всего биндинги типа webkit2gtk-rs - они обёртки над C-библиотеками WebKit.
Архитектор поленился. Без кожаного никуда...

GPT оверэстимирует сложности минимальной имплементации с помощью ИИ на десятки порядков, поэтому и 6 верить не стоит даже с натяжкой

Вы откалибровали шкалу по реальному Firefox/Chromium коду? Почему нет?

Ведь есть методика работы с нейронками - попросить написать код, попросить оценить ею же написанный код и потом составить план корректировок и применить его.
С человеком рано или поздно мы дойдём до ситуации, когда человек скажет - мне нечего править (не знаю как или считаю идеальным).
Что будет с нейронкой при такой методике в пределе? Она войдёт в какой-то бесконечный цикл перетасовывания кода без какой-либо логики? Ведь в столь крупных проектах вариаций что и как можно изменить (не факт что улучшить, но всё-таки) огромное множество.

Вы ещё предложите ей отвечать «нет, тут есть ошибка» :)

Ведь есть методика работы с нейронками - попросить написать код, попросить оценить ею же написанный код и потом составить план корректировок и применить его.
Буквально так и делаю постоянно. Сначала "пишем" код, потом через N добавленных функций "suggest refactor", чтобы раскидать его грамотнее по отдельным файлам и удалить расплодившиеся сущности (claude code любит писать велосипеды, хотя подходящие педали уже есть) - после refactor в plan mode приходит в себя и пишет "вот это можно объединить".
Что будет с нейронкой при такой методике в пределе? Она войдёт в какой-то бесконечный цикл перетасовывания кода без какой-либо логики?
Она в какой-то момент скатится в нерабочие оптимизации. Типа, вот тут это можно убрать и сократить - потом само же в процессе - ой нет, постойте, раньше было правильно, это не улучшение, не прокатило вычеркиваем. Оно как бы только радо прожрать токены.
Оно как бы только радо прожрать токены.
В точности повторяет конкурентную борьбу автопроизводителей. Сначала они соревновались в мощности, комфорте, безопасности и... надёжности! Мерседес вон даже демонстрацию ресурса на гоночном треке проводил.
https://youtu.be/Y9rxL8cvMaY?si=6b7VIa9pR9fkRIhG
Потом, когда рынок насытился, вычислительные мощности компов повысились и можно было обсчитывать ресурс точнее, то ресурс авто снизился.
Так будет и с нейронками. Сейчас за 10 итераций пишется простое веб-приложение, а потом будет и за 20 итераций писать с багами.

У меня на небольших задачах уходило 8-12 итерации с оценками и правой кода по ним. Я писал на Claude а оценивал ChatGPT. Сделал для себя вывод что на небольших задачах примерно так и будет. Собственно наблюдения подписываются примерно такой цифрой и в других случаях

Ну вообще говоря человек может бесконечно оптимизировать, переходя ко всё более мелким оптимизациям. Причём это может приводить к значительным изменениям архитектуры. Ожидать такого от LLM думаю не стоит. (А если и сделает, то криво и на следующем проходе назад вернёт) Пока что-то не видно именно системного подхода к этой проблеме. Они сами говорят "ну... всё зависит от промпта". Т е по факту люди подсказывают как писать и без анализа промптов которые давали, в новости вообще нет самой новости... Смотрел я одного "деятеля" на ютуб, где он сайт делал вайб-кодингом... Так там промпт больше кода по размеру 😁
Где же они брали требования?
Гуглили и делали по аналогии?
Пытались пройти тест кейсы WPT (Web Platform Tests) - общий для всех браузеров, десятки тысяч тестов? Так ведь не прошли же
3 млн строк, неделя работы агентов - а на выходе что-то уровня курсового проекта с unsafe-костылями и без прохождения стандартных тестов.
Как демо скорости генерации кода - впечатляет. Как инженерный результат - сомнительно

Ну так и ясен пень. Тут даже скорее больше поражает способность агентов взаимодействовать и работать сообща, генеря что-то разумное (то что браузер вообще хоть как-то работает уже чудо). И, очевидно, никто не будет использовать современные LLM так: очень жирный проект и слишком мало человеческого контроля. Однако этот эксперимент даёт намёки на возможность смены парадигмы с "AI как инструмент" на "AI вместо целого отдела" для несложных проектов. Думаю, если подобными образом организовать агентов (как сделано в эксперименте), можно уже сейчас заменять небольшие команды не очень опытных программистов, если после каких-то контрольных точек проверять вручную куда все катится.

То есть, сначала надо написать очень подробное техзадание, а потом перелопатить пару тысяч строк кода, причём написанного, как в примере выше.
А когда не вышло нормально с первой попытки, повторить весь цикл несколько раз до получения приемлемого результата.
А когда не вышло нормально с первой попытки, повторить весь цикл несколько раз до получения приемлемого результата.
Нет конечно, там уже дальше идет редактирование кода, он же не каждый раз с 0 пишет.
Надо попросить chatgpt сравнить это с Servo, который тысячи человек пилят с 2012, он на конец 2025 в версии 0.0.3
Даже небольшое уточнение техзадания может привести к тому, что 100 процентов строк кода будут изменены. На первых этапах заранее сказать, какие будут изменения, невозможно.
То есть на n-ной итеракции придём к ситуации, что действительно изменять надо только небольшие куски, а всё остальное работает нормально.
Проблема в том, что заранее предсказать число n пока не представляется возможным.
Когда появится формула, предсказывающая это n относительно сложности задачи, вот тогда можно будет говорить о реальном практическом применении.
Под практическим применением я подразумеваю предсказуемое количество ресурсов, необходимых для решения задачи. Пока этого нет.
Справедливо, сейчас заранее угадать, сколько токенов захочет проесть нейронка - проблематично. Когда можно без задней мысли генерировать 3 миллиона строк кода - это, конечно, хорошо. Но не для всех реально :)


То есть на n-ной итеракции придём к ситуации, что действительно изменять надо только небольшие куски, а всё остальное работает нормально. Проблема в том, что заранее предсказать число n пока не представляется возможным.
Более того, невозможно гарантировать, что на следующей итерации нейронка не решит переписать больше кода, чем на предыдущей, и невозможно при этом предсказать насколько больше.

вот тут да, ценность собственно кода начинает сильно падать, т.к. код это в общем случае необратимо измененное видение ТЗ,
При этом начитает возрастать ценность детализации ТЗ (контента) и тестов, которые должен в итоге проходить продукт. Возможно тесты выступают как составная, негативная часть ТЗ.
Т.е. мы должны реально описывать что продукт должен делать (позитивная часть ТЗ) и чего он не должен делать (негативная часть ТЗ). Любой продукт (итоговый код) укладывающийся в эти условия принимается нами как рабочий.
Первое, что агент должен сделать это проанализировать ТЗ на предмет неразрешимых фундаментально противоречий и на предмет практически трудно-разрешимых противоречий и потребовать описать способы их разрешения для принятия им решения.
Если агент не способен сформировать решение за один проход по этим требованиям, тогда нужна декомпозиция с формированием такой же структуры для каждой подзадачи.
И тогда новым "языком программирования" будет уже выступать дерево этих вот непротиворечивых ТЗ с набором тестов, помещающееся в контекст агентов. Считай дерево промптов.
Дальше конечно вопрос - с этим вот деревом промптов можно ли будет повторить результат за примерно одинаковое время/стоимость на разных агентах, да и даже на одном агенте?
что продукт должен делать (позитивная часть ТЗ) и чего он не должен делать (негативная часть ТЗ).
Но ведь если подумать, то пространство "того, что продукт не должен делать" просто огромно, и гораздо больше пространства того, что продукт "должен делать", возможно оно даже бесконечно. Особенно если начать углубляться в детали.
Ваша правда - бесконечно. Только кого это теперь интересует? Вставит агент троянов и бекдоров - выглядит так, что такая цена приемлема за то, что он сделает позитивную часть задешево.
А если ближе к реалиям, то допустим продукт сейчас что бы быть продаваем должен быть сертифицирован разного рода конторами. И вроде как ответственность за то, что продукт не должен делать перекладывается на эти конторы, они уже определяют есть ли там трояны и прочее. По крайней мере формально.
Возможно конторы затребуют "исходники", что бы это не значило во времена вайб-кодинга. Возможно будут агенты, натренированные на то, что бы проверять факт того, что код в этих исходниках делает то и только то, что указано в ТЗ.
Детализированное ТЗ это скорее контракты: типы, инварианты, пред/постусловия. Тесты это примеры выполнения контрактов, частные случаи.
Экономика сдвигается к языкам с богатой системой типов, там контракт и есть значительная часть работы, а реализация часто тривиальна или выводима.

Надо попросить chatgpt сравнить это с Servo, который тысячи человек пилят с 2012, он на конец 2025 в версии 0.0.3
Или дописать ReactOS до работоспособного состояния. Вряд ли там ситуация сложнее, чем с браузером.
Самое смешное и печальное, что то, как вы описываете вполне может быть.
Ведь окно Овертона смещается. Буквально 20 лет назад мы и представить не могли, что браузеры будут жрать память как не в себя и "компьютер для интернета" будет вполне себе мощным компом.
А теперь это норма. Возможно в будущем очень сильно снизятся требования к качеству кода, требования к работоспособности приложений и сервисов.
В абсолюте будет такой, поломанный интернет сам для себя. Компании состоят сотен нейронко-агентов, которые генерят практически не рабочие сервисы, которые мгновенно деплоятся через CI/CD, тестятся на проде, генерятся фиксы и деплоятся вновь.
И всё это продаётся инвесторам под соусом "мы увеличили эффективность, разогнали последних дорогущих разработчиков и заменили их нейронками".
Короче, антиутопия какая-то про мёртвый интернет получается.
Засилье текстовых процессоров и всяких word вылилось в markdown. Сложные интерфейсы современных web сайтов превратились в perlplexity, который без интерфейса показывает нам то, что мы на самом деле хотим увидеть. Вывод - будущий Интернет будет состоять из древовидных каталогов и ИИ для получения информации. Браузеров вообще не будет.
Сейчас самые популярные развлекательные сервисы имеют самый простой интерфейс.
Как будто бы для восторженных возгласов менеджеров достаточно цифры в 3 млн строк кода. Уже вижу как напихивают сеньору в бигтехе, два дня копающемуся в многопоточном коде в поисках бага, за то, что он за 2 дня написал одну строку кода, когда ИИ пишет 3 млн

Было бы интересно если бы они теперь в уже написанный проект попросили GPT добавить какую-то фичу. Т.е. насколько хорошо он сможет поддерживать созданный проект

Никак(( он если и сделает то без внутренних библиотек. Ну пока у меня так выдает.
Когда я "переписывал" TunProxy с http/socks на https и менял ему гуи с java на kotlin - сделал без особых затруднений. Но тут конечно сам проект весьма крохотный.

Это то как раз легко.
Нюанс в том, что проект написан на актуальных языках с актуальным стеком и архитектурой. Нейронка в этом как рыба в воде.
А вот переписывать древнее легаси - тут беда. Я конкретно этим занимался недавно, базово все ок, но в деталях проблема на проблеме. И это не потому что нейронка код неправильно сгенерировала, а потому что легаси зачастую это костыли плюс нюанс плюс чудом работающий код на архитектуре 2005 года.
И тут очень решает если у нейронки есть доступ к инструментам, то есть не просто код читать, но прогнать тесты, собрать проект и даже инициировать вызовы к тестовой бд и считать ответ.

Я делаю это уже несколько месяцев. Использую, в основном, с Opus 4.5, работатает по-разному. Где-то не справляется вовсе, но чаще всего — справляется и очень хорошо, но нужно делать code reivew.

Так там это есть уже
https://github.com/wilsonzlin/fastrender/blob/main/instructions/live_rendering.md
Я думаю GPT добавит следующую фичу так же, как он добавил любую предыдущую так как концептуально они ничем не отличаются.

Главный инсайт команды: промпты важнее, чем выбор модели или архитектура системы.
По опыту использования нейросети: написание правильного промпта занимает больше времени, чем самостоятельная разработка. По сути ты декомпозируешь ТЗ с мельчайшими подробностями, чтоб джун ненароком не наворотил что-то другое.
И если джуна со второй, третьей попытки чему-то научить можно, то тут каждый раз с нуля.
Для этих целей уже придумали агентов-промптописателей, которые ваш "сделай красиво" раскладывают на десяток пунктов и отдельно расписывают критерии, по которым задачу будут принимать. Вам останется только вычитать ТЗ и поправить, где надо.

Я работал в компании с такими вот штуками. Там задачи так ставили, + критерии для QA. В результате весь промпт разрабы игнорили. Он был до омерзения полон не технических деталей, процентов на 70, 15% были отсебятиной и 15% изначального запроса
Это почти чистый галлюциноген ИИ по нормативке, который формально можно сделать, но это увеличит срок разработки в несколько раз
Так же пытались ТЗ от аналитиков сделать, структуру составили, пытались как-то наполнить и т.д. И выглядело это очень хорошо и похоже на правду со стороны(директорат был в восторге похоже). Но на деле было то же самое, что и выше писал. Только в большом тексте заметить это было на много сложнее, потому как текст внешне не противоречив, понятен, +схемки какие-то, даже с виду логически верные. Но чуть подумаешь и опытному человеку сразу видно, что это чушь

Чем самостоятельная разработка команды из 1человека? Когда в команде несколько человек, то точно также необходимо все подробно спланировать и описать.

По сути ты декомпозируешь ТЗ с мельчайшими подробностями, чтоб джун ненароком не наворотил что-то другое.
О том и речь
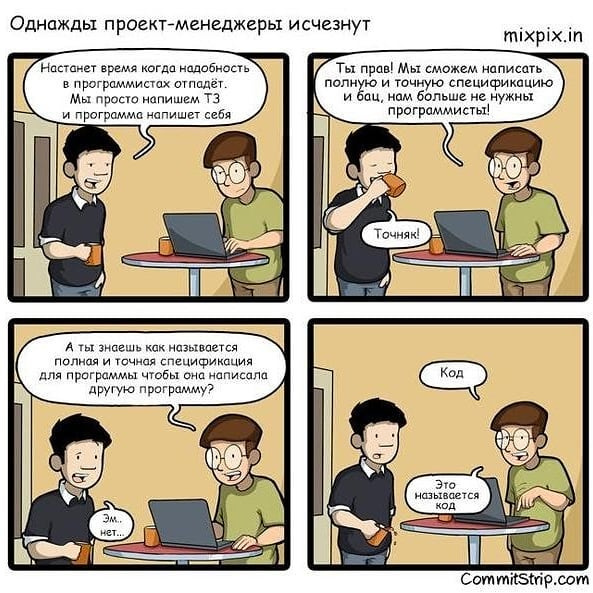
Ну да просто код без доков и требований - конечно быстрее)

Это конечно круто, но мне Opus 4.5 не мог написать Talbot RIS функцию в 60 строк, приходилось тыкать пальцем.

Хуже того, без иерархии агенты избегали сложных задач и делали мелкие безопасные правки.
Я смотрю, искусственный интеллект уже зачастую ведет себя как настоящие живые разработчики

А что потом делать с этими 3 миллионами строк кода... Кто разберёт их дальше и продолжит?
Ну вот, а боимся, что разработчики без работы останутся. Судя по всему, специализация "Рефакторинг легаси ИИ" в будущем будет основной и народу нужно будет столько, сколько сейчас и не работает.
- Знаю. - Селтрикс вытащил револьвер, проверил, в порядке ли, и вновь сунул в кобуру. - Все наши парни вернулись, капитан?
- Все? - Капитан невесело засмеялся. - Да в нашем отделе теперь в полтора раза больше народу. Столько убийств еще никогда не бывало.
- Ясно, - сказал Селтрикс. - Страж-птицам недосуг, они нянчатся с грузовиками и не дают паукам жрать мух. (c) Роберт Шекли


Сеньерам точно такое не интересно. Да и джунам тоже, для них весь чужой код - говнокод. Вообщем, игрушка для ПМов.


двадцать агентов выдавали производительность двух-трех — остальные ждали освобождения блокировок. Хуже того, без иерархии агенты избегали сложных задач и делали мелкие безопасные правки
Похоже, что они таки достигли человеческого уровня интеллекта.

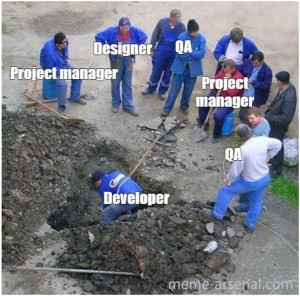
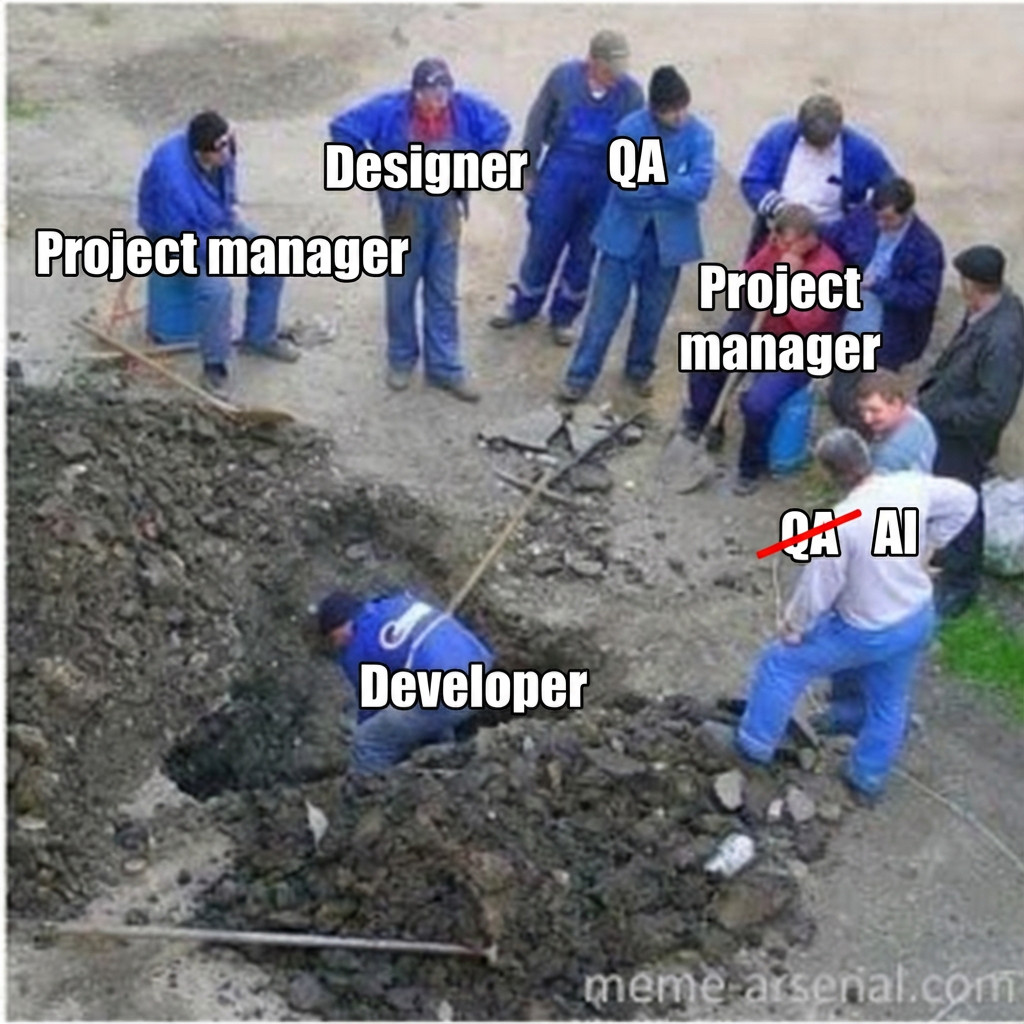

Хуже того, без иерархии агенты избегали сложных задач и делали мелкие безопасные правки
единственный сценарий, в котором AGI не уничтожит человечество - это такой, в котором ему будет просто лень начать такой большой "проект".

А насколько хорошо сейчас ИИ умеет переписывать готовый код?
Например есть древнющий проект специфического каталога на PHP4, который работает, но править который боль.
Сможет он реализовать тот же функционал на Flask и переверстать HTML + CSS под Bootstrap?
И если да, то какой должен быть ориентировочный бюджет на подписки/токены?
Локально подобное завести наверное надеяться не стоит?

Легко. Достаточно будет даже бесплатной демо подписки Cursor.
Я плачу 20$ в месяц и очень доволен результатом.
Очень критично и скептически был настроен сначала, но попробовал и затянуло. Это похоже на зависимость, но способность программировать ты не теряешь, наоборот, увеличиваешь свою насмотренность просматривая код от ИИ.
Я плачу 20$ в месяц и очень доволен результатом.
«У нас есть такие приборы!
Но мы вам про них не расскажем их не покажем.»

Можно ещё дешевле - подписка на github copilot $10usd в месяц. Есть отличный плагин для VSCode
Удобство в том, что ты покупаешь не токены, а 100 запросов. Всегда доступны последние модели, в т.ч. Gemini 3pro, GPT5.2-Codex, Claude 4.5 Opus, Sonnet. Плюс безлимит запросов к моделькам полегче, типа GPT-5 mini
Не знаю, какой бюджет на токены, но бюджет на кожаных такой же как затраты на изначальную разработку плюс внедрение (включая затраты заказчика) плюс суммарные затраты на сопровождение за все годы.
Я не шучу. Потому что никто точно не знает как она должна работать, а раскопки и тесты дороги.
Единственное, что утешает: можно переписать не весь код, а только критичную часть.
Я не шучу. Потому что никто точно не знает как она должна работать, а раскопки и тесты дороги.
Ну с тем как оно должно работать тут как раз вполне понятно.
Сложности начинаются когда надо вносить доработки, а там в коде все вперемешку в паре больших файлов - серверная логика, верстка, стили в тегах, запросы к базе.

Зависит от количества строк кода в вашем проекте. Если у вас сотни тысяч строк кода, то придется декомпозировать задачу. Если это тысячи, то скорее всего сможет и без вашей помощи, достаточно будет проверить.
В целом AI неплохо умеет повторять.
Локально тоже можно развернуть. Но с учетом амортизации оборудования будет медленнее и дороже, чем в облаке
Зависит от особенностей и нюансов системы имхо. Маленькие проекты да, большие проект - боль.
Мой опыт - древний проект на c# net framework 3.5 в 1000+ файлов был переделан в net core 8. Была куча нюансов, куча багофиксов легаси, оставлен огромный техдолг (до сих по impersonation висит) и так далее. И протестировано пока дай бог 70% проекта, при этом каждая итерация теста это новые фиксы.
По ценам хз, у меня гопота про и клауде про, соотвественно codex и claude code работали не покладая рук две недели, часто упираясь в 5 часовой лимит.
Но итог - оно работает, работает хорошо, и хотя бы дальше уже можно идти в контейнеризацию и виртуализацию, а win машину выкинуть на помойку.
Из нюансов, в таких проектах очень и очень важно сначала натравливать агентов на изучение всего проекта и далее результат скармливать самым умным нейронками типа 5.2 Pro, что бы они проанализировали структуру и далее вместе с ними договариваться об архитектуре. Ну и "логировать" в .md файлы все и вся.

Не согласен с предыдущим оратором. Сижу на легаси, причём он уже на 5-ке писался. Этот ИИ не может даже прожевать божественную хранимую процедуру на 1000 строк. У него контекстное окно заканчивается. А ещё нужно понять, по какому случаю эту функцию в PHP вызывают, и много чего другого. А если ещё учесть, что здесь вот cron работает, здесь апишечка, а тут что-то в базу кладётся, а здесь бизнес логика в ХП-шке, то вообще ой. Ни один ИИ с этой штукой не справится. Разве что частями, и то у ИИ понимания не будет, как всё это вместе должно работать.
У вас очень плохой\старый ИИ, если он не может прожевать процедуру на 1000 строк. Claude Code мне один css на 2381 строку написал (чем я ни разу не горжусь, если честно).
Не старый, но да, с не очень большим контекстным окном. И у нас задачи разные. Рефакторинг и написание кода. Эта божественная хранимка вызывает другие хранимки. Эдакое очень связанное спагетти. В одном месте ковырнёшь, 100500 других мест откажут. И здесь нужно проводить рефакторинг, выносить бизнес логику из ХП в домен. DRY, KISS и всякое такое. На таких объёмах оно банально не работает. JB AI Assistant.
Эта божественная хранимка вызывает другие хранимки. Эдакое очень связанное спагетти. В одном месте ковырнёшь, 100500 других мест откажут.
Это нормально, даже в моих вайбкоженных костылях такое есть. Собственно говоря, тот же Claude Code при любом рефакторе норовит выделить функции на ровном месте, получается как раз такая лапша (хоть и удобная для ИИ). То есть ему вообще не западло функцию даже из 10 строк выделить в отдельный файл.
И здесь нужно проводить рефакторинг, выносить бизнес логику из ХП в домен. DRY, KISS и всякое такое. На таких объёмах оно банально не работает. JB AI Assistant.
Облачный cutting-edge типа Claude Code и Antigravity не буду советовать, но вам стоит попробовать что-то локальное в агентском режиме, с plan mode. Лично у меня кое-как ворочается devstral2 в Cline внутри vscode. Долго думает, но в целом работает. Даже оно должно быть сильно лучше того, что у вас не переваривает 1000 строк.
Скрытый текст
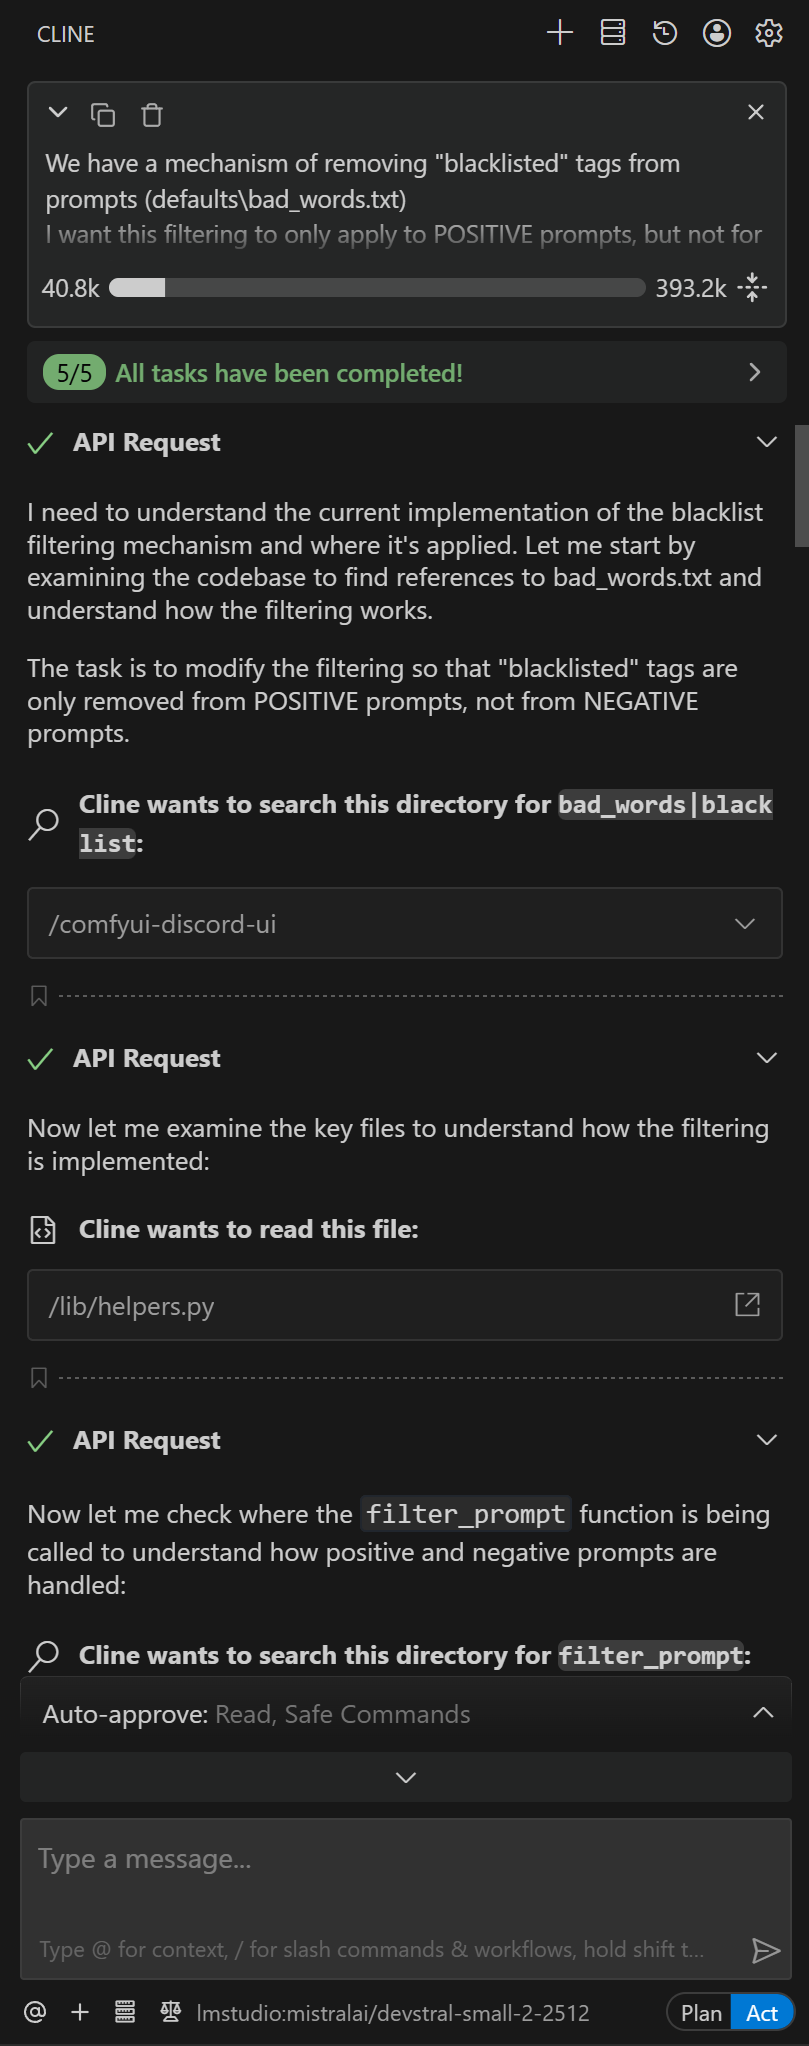
Чуда на локалках ожидать не стоит, они запросто могут даже просто опечатки в коде оставлять или сваливаться в цикл. Но это все равно будет выглядеть интереснее, кмк, как эксперимент даже.

Расскажите, как вы работаете с моделями при участии в разработке реальных коммерческих проектов? Как правило, они ведь все под NDA, т.о. нельзя пользоваться сторонними инструментами, куда потенциально может утечь кодовая база. Или используете локальные модели? Но тогда какого уровня задачи они могут решать?
Я не участвую в разработке коммерческих проектов, я пишу велосипеды для решения собственных задач (если уверен в том, что оно работает хорошо - делаю репу публичной) и форкаю и исправляю заброшенные репы, которые иногда пригождаются.
Если есть возможность я использую только облачные модели и специально не отключаю им обучение. Но для коммерческих решений можно попробовать использовать локальные модели, типа devstral2. Я ими пользовался ограниченно и писать код они могут, ну, 50\50 я бы сказал.
Но вот подсказать что-то архитектурно или предложить рефакторинг они могут вполне адекватно, хоть и не слишком быстро (devstral2 на 4090 шпарит примерно 20-50 tok\s, на AMD 395+ примерно 10).
Но вообще, конечно, отличная иллюстрация для мема "вы находитесь здесь".
Интересно, каким будет спрос на программистов в 2030 году.

Мне больше интересно как они победили окно контекста. Ведь агент это же по сути объект модели, который воспроизведён N раз. Всем им задали роли и они выполняют свои задачи.
Но ведь в отличии от человека, модель ограничена набором входных данных (код что она писала раньше + условие + суть задачи + новые правки + новый код), который она получает при каждой итерации и который нельзя увеличить до безразмерности. У человека в этом случае вступает абстракция, когда мы архивируем данные как бы "забывая" их цепляя за что-то (слово, звук, картинка и т.д.).
А учитывая что общий код занимает примерно 3М строк и даже если разделить его на отдельные функции и подсистемы, то с учётом инструкций и процесса работы над задачей, этот кусок все равно растет довольно быстро.
Возможно тут другой подход и в этом нет проблемы, что-то я могу не знать. Однако как у пользователя который немного работал с моделями как локально, так и через облачное API, этот вопрос в голове возник 🤔
Там явно очень плотно все в ембеддинги заливается, потому что тот же chatgpt без вопросов анализировал 3 мегабайта переписки моего товарища, с цитатам и датами. Дома с gpt-oss-120b повторить не удалось - просто пишет чушь. Так что половина работы над нейронкой это как раз как правильно подать ей информацию, в том числе под капотом.
Не волнуйтесь, ChatGPT тоже пишет чушь — просто Вы этого пока ещё не осознали.
Нет, как я написал выше, он пишет анализ текста с датами и цитатами, которые в исходном тексте находятся через ctrl+f.
Локальный oss просто пишет "я вижу за один месяц сообщения" и выдумывает даты.
половина работы над нейронкой это как раз как правильно подать ей информацию
Вообще да, но даже так, нужно добиться баланса компактности и понимания.
без вопросов анализировал 3 мегабайта переписки моего товарища, с цитатам и датами
А вот это интересно. Ибо не давно пробовал проанализировать XML файл с 13К строк и модель 5.2 в какой-то момент перестала отвечать и вовсе не выдала ответ в чат. А учитывая что текстовая информация имеет объем 3Мб, то строк там наверное за 50-70К. Интересно как GPT смогла это переработать.

Ибо не давно пробовал проанализировать XML файл с 13К строк и модель 5.2 в какой-то момент перестала отвечать и вовсе не выдала ответ в чат.
Это большая разница - переписка и прямой файл в промте.
Переписка как правило большая и добавляется кусочками в контекст с помощью RAG (3 Мб не проблема). А вот прямой файл прожевать - да, это как правило проблема начиная где-то с 32-64 Кб входа (большой контекст нейронки едят, но с напряжением)
Вот мне тоже интересно было, я подключал разные ембеддинги и крутил настройки в openwebui, но ничего похожего даже добиться не смог - все равно была одна чушь.

Самый интересный вывод тут не про GPT-5.2, а про организацию работы. Выходит, менеджмент и постановка задач никуда не делись, даже если код пишут машины)

Короче 90% проекта готово, осталось допилить вторые 90%
Еще я замечаю что всегда пишут с 0, но реальные проекты в компаниях уже написаны
И я вот думаю - почему бы чувакам не развивать Servo - вот вроде движок, хотят сделать все по стандартом, но интуиция мне подсказывает что не взлетело бы такой подход.
В любом популярном open source репозитория сотни открытых issues, но чет никак их не получается закрыть.
Потому что будут воротить нос от коммитов из под нейронки, тут вот идейные прямо в комментариях сидят: "я не буду читать этот код, он из под нейронки, я буду дальше 3 года сидеть в 0.0.3"

Мне кажется, тут воротят нос, потому что сам по себе этот код является отличным примером отборнейшего ИИ слопа, а вся новость - попытка залить отборнейшего копиума инвесторам и прочим нейрохомякам.
Ну и да:
я буду дальше 3 года сидеть в 0.0.3
Исходя из раскопок других пользователей, ИИ-агенты тоже предпочли использовать парсеры CSS и HTML от "Servo" (который как раз в версии 0.0.3) в проекте вместо написания какого-нибудь "Servo Copy, Full AI edition, v1.0". Выводы делайте сами.
Выводы сделаны: за неделю ИИ-агенты могут почти привести в чувство заброшенный проект. Вопрос только в том, что они смогут сделать за месяц, или за пол года, и как изменится цифра 3 в версии Servo за этот же промежуток времени. Лично у меня, правда, нет безлимитных токенов, чтобы это проверить, а локальные модельки все же туповаты. А так я бы с большим интересом провел эксперимент сам.
Вопрос только в том, что они смогут сделать за месяц, или за пол года
Давайте не будем применять классический прием ИИ бустеров и фантазировать о том, что там будет, а вместо этого посмотрим на то, что имеем сейчас. По факту:
- Еле-еле работающий обрубок браузера
- 3 миллиона строк кода, но абсолютно неясно, что они вообще делают, так как для реализации большинства (если не всех) основных функций используются внешние библиотеки.
- На фоне предыдущих двух пунктов, обертки над готовой библиотекой в 20к строк кода, из которых половина отведена под тесты, заставляют задуматься над вероятностью того, что под видом "невероятно сложного проекта" нам пытаются пропихнуть раздутую бойлерплейтом и неадекватными тестами слопобазу.
Ну и да, если бы в Cursor верили, что дополнительная неделя/месяц привели бы к значительному прогрессу (добавление функциональности, исправление багов, отказ от готовых библиотек), то стали бы выкладывать еле живой обрубок? Вопрос риторический.

Краем глаза видел такие ПР и их обсуждения. Коммиттер на все просьбы объяснить, что происходит в ПР и как он пофиксил баг, блеет "это нейронка, объяснить не могу".
Конечно, после нескольких таких ПР мейнтейнеру проще и быстрее сразу завернуть код нейронки, чем вместо коммиттера в нём разбираться.
Вот честно хз насчёт курсора. Вот простой пример , у меня есть дока + исходники на игровой движок. Я ему дал задание проанализируй все и напиши программу для реверса чтобы достать исходники
Томить не буду , gpt 5.0 cursor pro, он делал что угодно но не писал программу , т.е он писал инструкцию, писал какой то алгоритм, делал какой то анализ , и даже отчёт предоставил
НО ЭТО ВСЕ ФЕЙКИ БЫЛИ , т.е. он наглую меня обманывал, а когда я ему сказал что хватит меня обманывать он тупо уходил в вечные раздумья. Сайт или пофиксить ошибки он может , но сделать что то свое нет, даже если подробную инструкцию дать
GPT-5.2 написала браузер за неделю
«...правда, такая ерунда получилась...» ©

Ндаа.. 3 миллиона бойлер-плейт кода для связывания уже готовых quickjs, jsvm и еще десятка готовых библиотек для css, dom, websockets и т.д.. Все сложное и интересное в браузере - взято уже готовое.
Про то, что оно даже не собирается и тесты не проходит уже написали.
Еще там, говорят, старая версия Rust и системы сборки используется почему-то.
Ну и качество кода такое, что уже никто ничего никак в этом репозитории не исправит. Единственный метод - все удалить и сгенерировать заново, надеясь, что в этот раз повезет.
Они даже в собственно пресс-релизе не смогли с серьезным лицом заявить, что все работает - пришлось писать что оно почти работает.
В общем, обычный пиар и манипуляции для колхозников, чтобы инвесторы уронили челюсти и побежали давать следующие миллиарды.

Там файлики с cосрцами по 10К+ строк. В самом большом 77267 строк)
Говорят, всего-то осталось пройти 2 млн тестов

Включать звук 😁
"...у тебя всё получится! Но через ж**у" :))
GPT-5.2 написала браузер за неделю: результаты эксперимента Cursor с агентами