Pull to refresh
0
Send message

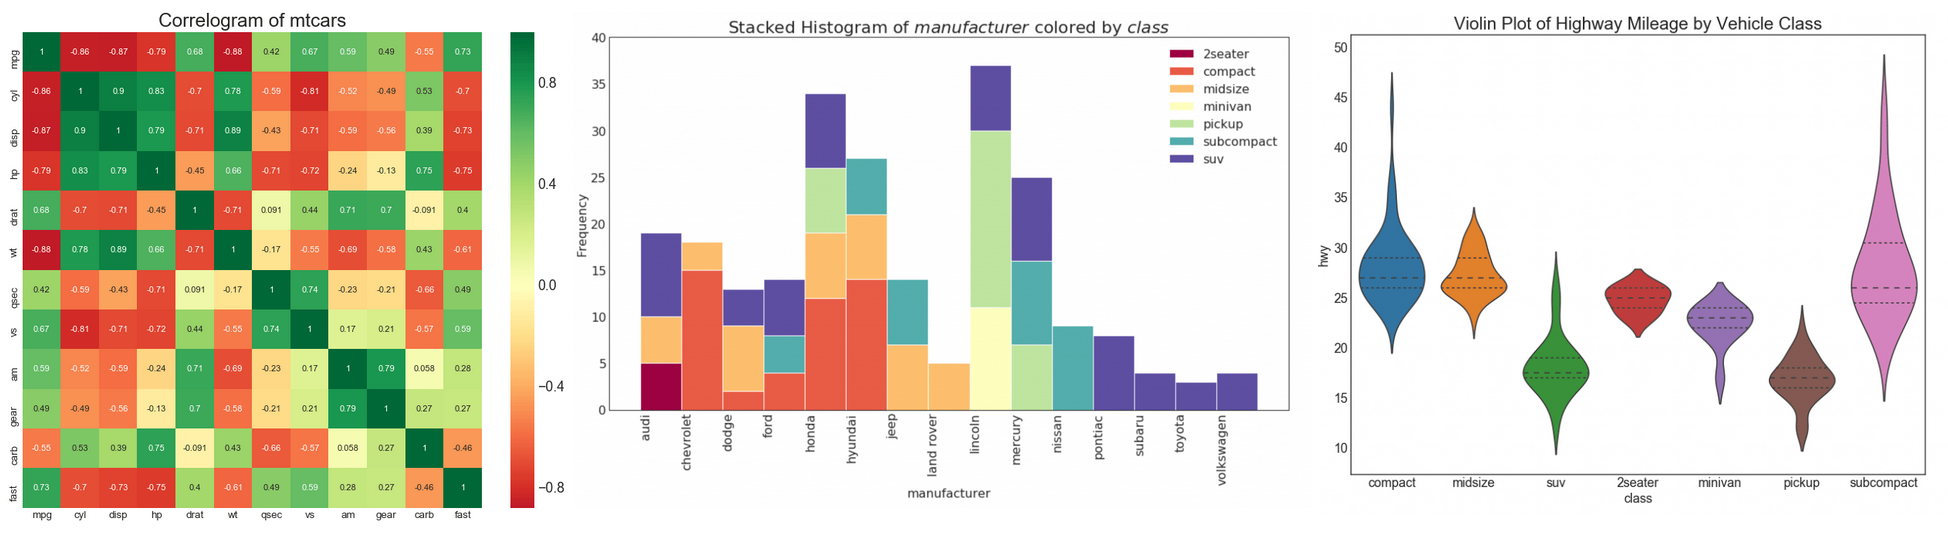
50 оттенков matplotlib — The Master Plots (с полным кодом на Python)

Reading time39 min
Reach and readers489K
Те, кто работает с данными, отлично знают, что не в нейросетке счастье — а в том, как правильно обработать данные. Но чтобы их обработать, необходимо сначала проанализировать корреляции, выбрать нужные данные, выкинуть ненужные и так далее. Для подобных целей часто используется визуализация с помощью библиотеки matplotlib.


Встретимся «внутри»!
Читать дальше →

Учим нейросети в Google Таблицах

Reading time5 min
Reach and readers13K

Хочу с вами зачелленджить одну интересную штуку: попробовать обучить нейросеть в Google Таблицах. Безо всяких макросов и прочих хаков, на чистых формулах.


Читать дальше →

Моя шпаргалка по pandas

Reading time8 min
Reach and readers920K
Один преподаватель как-то сказал мне, что если поискать аналог программиста в мире книг, то окажется, что программисты похожи не на учебники, а на оглавления учебников: они не помнят всего, но знают, как быстро найти то, что им нужно.

Возможность быстро находить описания функций позволяет программистам продуктивно работать, не теряя состояния потока. Поэтому я и создал представленную здесь шпаргалку по pandas и включил в неё то, чем пользуюсь каждый день, создавая веб-приложения и модели машинного обучения.


Нельзя сказать, что это — исчерпывающий список возможностей pandas, но сюда входят функции, которыми я пользуюсь чаще всего, примеры и мои пояснения по поводу ситуаций, в которых эти функции особенно полезны.
Читать дальше →

Туториал по uplift моделированию. Часть 1

Reading time9 min
Reach and readers129K

Команда Big Data МТС активно извлекает знания из имеющихся данных и решает большое количество задач для бизнеса. Один из типов задач машинного обучения, с которыми мы сталкиваемся – это задачи моделирования uplift. С помощью этого подхода оценивается эффект от коммуникации с клиентами и выбирается группа, которая наиболее подвержена влиянию.

Такой класс задач прост в реализации, но не получил большого распространения в литературе про машинное обучение. Небольшой цикл статей, подготовленный Ириной Елисовой (iraelisova) и Максимом Шевченко (maks-sh), можно рассматривать как руководство к решению таких задач. В рамках него мы познакомимся с uplift моделями, рассмотрим, чем они отличаются от других подходов, и разберем их реализации.
Читать дальше →

Быстрый старт в изучении анализа данных и машинного обучения от МФТИ и Яндекса

Reading time5 min
Reach and readers41K

Почему анализ данных


Потребность в анализе данных вышла далеко за пределы технологических и интернет-компаний. Методы машинного обучения все активнее используются в совершенно различных областях, вплоть до оптимизации маршрутов транспорта. С их помощью создаются новые лекарства и автомобили без водителя, подбирается музыка под настроение, находятся потенциальные спутники жизни.

Специалист по анализу данных или data scientist – одна из самых востребованных профессий сегодняшнего дня. За реальных практиков, умеющих получать значимые результаты в сжатые сроки, идет настоящая борьба, и стоимость таких специалистов взлетает до небес.

Также интерес подогревают государственные и коммерческие структуры, которые не только говорят об этих специальностях, но и уже готовятся к проведению первых олимпиад по ним.

Что же скрывается за этими словами, все ли понимают их значение? К сожалению, нередко к ним относятся как к некому волшебному ингредиенту, который решит все проблемы. Не осознаются ни границы его применения, ни порядок действий, чтобы использовать их «здесь и сейчас».

Пришла пора внести ясность в этот вопрос.

image

Читать дальше →

Открытый курс машинного обучения. Тема 10. Градиентный бустинг

Reading time18 min
Reach and readers338K

Всем привет! Настало время пополнить наш с вами алгоритмический арсенал.


Сегодня мы основательно разберем один из наиболее популярных и применяемых на практике алгоритмов машинного обучения — градиентный бустинг. О том, откуда у бустинга растут корни и что на самом деле творится под капотом алгоритма — в нашем красочном путешествии в мир бустинга под катом.


UPD 01.2022: С февраля 2022 г. ML-курс ODS на русском возрождается под руководством Петра Ермакова couatl. Для русскоязычной аудитории это предпочтительный вариант (c этими статьями на Хабре – в подкрепление), англоговорящим рекомендуется mlcourse.ai в режиме самостоятельного прохождения.


Видеозапись лекции по мотивам этой статьи в рамках второго запуска открытого курса (сентябрь-ноябрь 2017).

Читать дальше →

Градиентный спуск по косточкам

Reading time37 min
Reach and readers71K

В интернете есть много статей с описанием алгоритма градиентного спуска. Здесь будет еще одна.


8 июля 1958 года The New York Times писала: «Психолог показывает эмбрион компьютера, разработанного, чтобы читать и становиться мудрее. Разработанный ВМФ… стоивший 2 миллиона долларов компьютер "704", обучился различать левое и правое после пятидесяти попыток… По утверждению ВМФ, они используют этот принцип, чтобы построить первую мыслящую машину класса "Перцептрон", которая сможет читать и писать; разработку планируется завершить через год, с общей стоимостью $100 000… Ученые предсказывают, что позже Перцептроны смогут распознавать людей и называть их по имени, мгновенно переводить устную и письменную речь с одного языка на другой. Мистер Розенблатт сказал, что в принципе возможно построить "мозги", которые смогут воспроизводить самих себя на конвейере и которые будут осознавать свое собственное существование» (цитата и перевод из книги С. Николенко, «Глубокое обучение, погружение в мир нейронный сетей»).


Ах уж эти журналисты, умеют заинтриговать. Очень интересно разобраться, что на самом деле представляет из себя мыслящая машина класса «Перцептрон».

Читать дальше →

Базовые принципы машинного обучения на примере линейной регрессии

Reading time20 min
Reach and readers210K
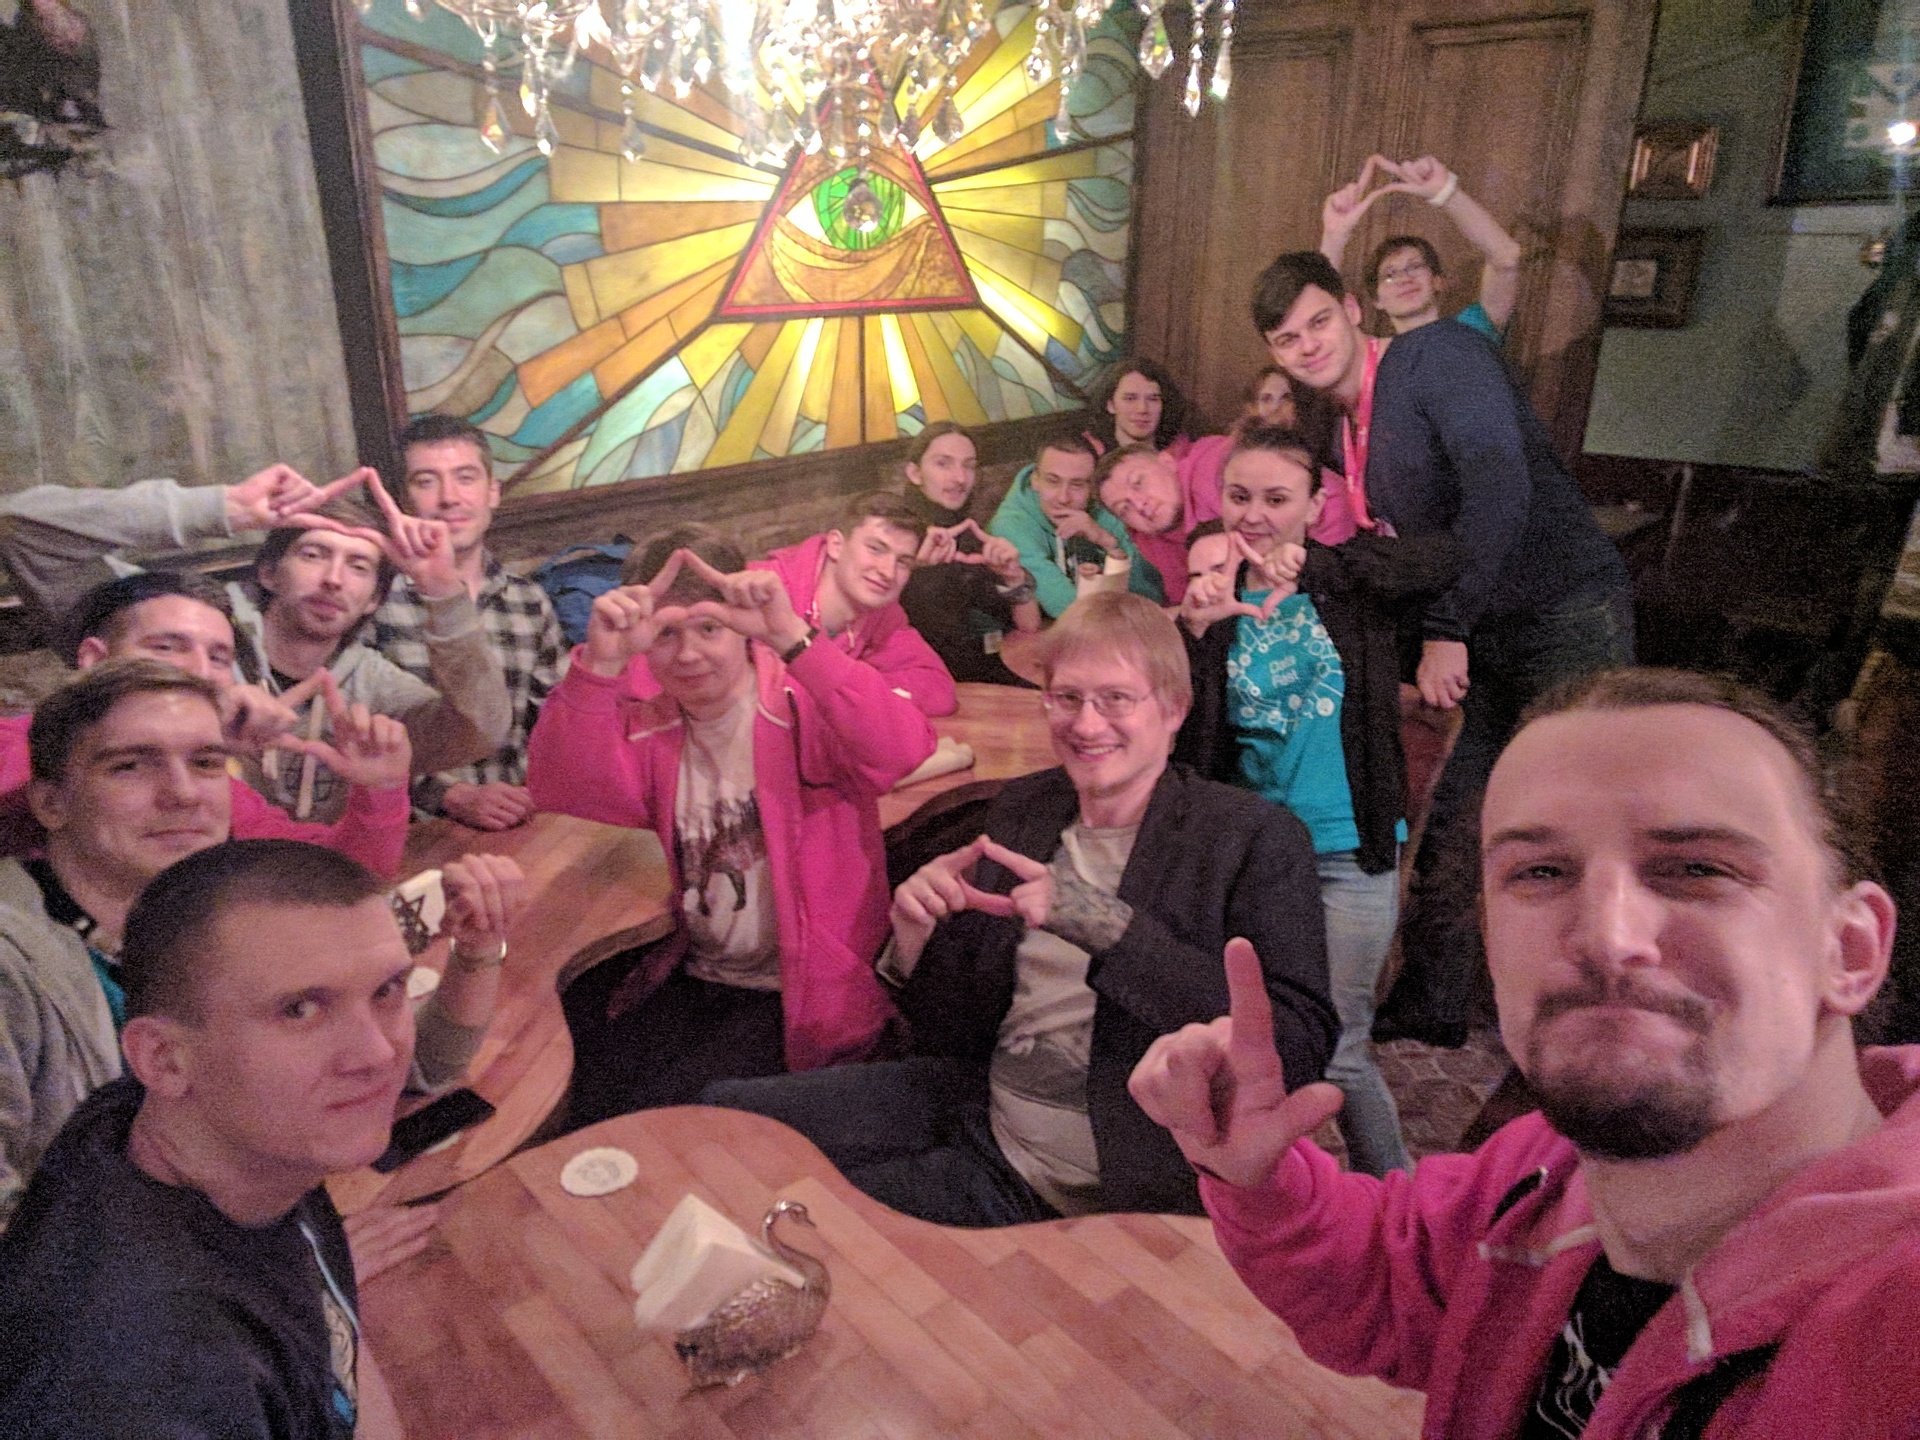
Здравствуйте, коллеги! Это блог открытой русскоговорящей дата саентологической ложи. Нас уже легион, точнее 2500+ человек в слаке. За полтора года мы нагенерили 800к+ сообщений (ради этого слак выделил нам корпоративный аккаунт). Наши люди есть везде и, может, даже в вашей организации. Если вы интересуетесь машинным обучением, но по каким-то причинам не знаете про Open Data Science, то возможно вы в курсе мероприятий, которые организовывает сообщество. Самым масштабным из них является DataFest, который проходил недавно в офисе Mail.Ru Group, за два дня его посетило 1700 человек. Мы растем, наши ложи открываются в городах России, а также в Нью-Йорке, Дубае и даже во Львове, да, мы не воюем, а иногда даже и употребляем горячительные напитки вместе. И да, мы некоммерческая организация, наша цель — просвещение. Мы делаем все ради искусства. (пс: на фотографии вы можете наблюдать заседание ложи в одном из тайных храмов в Москве).

Мне выпала честь сделать первый пост, и я, пожалуй, отклонюсь от своей привычной нейросетевой тематики и сделаю пост о базовых понятиях машинного обучения на примере одной из самых простых и самых полезных моделей — линейной регрессии. Я буду использовать язык питон для демонстрации экспериментов и отрисовки графиков, все это вы с легкостью сможете повторить на своем компьютере. Поехали.
Читать дальше →

Information

Rating
Does not participate
Registered
Activity