Pull to refresh
28
Дмитрий Пашуткин@dm_p2016

Пользователь

4
Subscribers
Send message

Ускорение разведочного анализа данных с использованием библиотеки pandas-profiling

Reading time6 min
Reach and readers28K
Первым делом, приступая к работе с новым набором данных, нужно понять его. Для того чтобы это сделать, нужно, например, выяснить диапазоны значений, принимаемых переменными, их типы, а также узнать о количестве пропущенных значений.

Библиотека pandas предоставляет нам множество полезных инструментов для выполнения разведочного анализа данных (Exploratory Data Analysis, EDA). Но, прежде чем воспользоваться ими, обычно нужно начать с функций более общего плана, таких как df.describe(). Правда, надо отметить, что возможности, предоставляемые подобными функциями, ограничены, а начальные этапы работы с любыми наборами данных при выполнении EDA очень часто сильно похожи друг на друга.


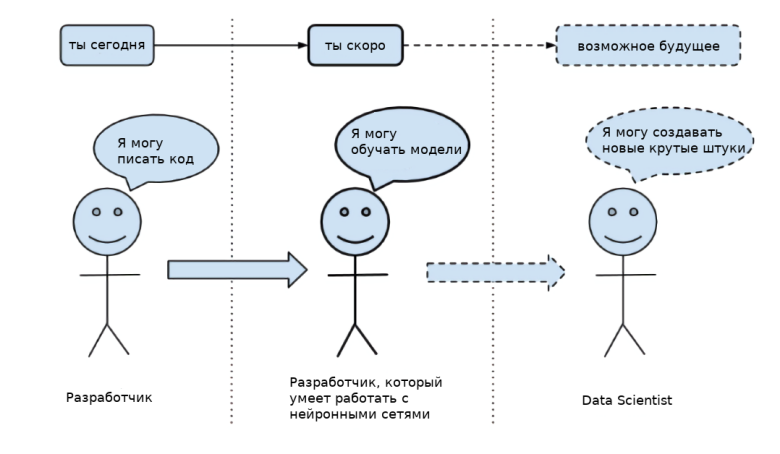
Автор материала, который мы сегодня публикуем, говорит, что он — не любитель выполнения повторяющихся действий. В результате он, в поисках средств, позволяющих быстро и эффективно выполнять разведочный анализ данных, нашёл библиотеку pandas-profiling. Результаты её работы выражаются не в виде неких отдельных показателей, а в форме довольно подробного HTML-отчёта, содержащего большую часть тех сведений об анализируемых данных, которые может понадобиться знать перед тем, как приступать к более плотной работе с ними.
Читать дальше →

Фильтр Калмана

Reading time10 min
Reach and readers503K


В интернете, в том числе и на хабре, можно найти много информации про фильтр Калмана. Но тяжело найти легкоперевариваемый вывод самих формул. Без вывода вся эта наука воспринимается как некое шаманство, формулы выглядят как безликий набор символов, а главное, многие простые утверждения, лежащие на поверхности теории, оказываются за пределами понимания. Целью этой статьи будет рассказать об этом фильтре на как можно более доступном языке.
Фильтр Калмана — это мощнейший инструмент фильтрации данных. Основной его принцип состоит в том, что при фильтрации используется информация о физике самого явления. Скажем, если вы фильтруете данные со спидометра машины, то инерционность машины дает вам право воспринимать слишком быстрые скачки скорости как ошибку измерения. Фильтр Калмана интересен тем, что в каком-то смысле, это самый лучший фильтр. Подробнее обсудим ниже, что конкретно означают слова «самый лучший». В конце статьи я покажу, что во многих случаях формулы можно до такой степени упростить, что от них почти ничего и не останется.
Читать дальше →

Фильтр Калмана — Введение

Reading time5 min
Reach and readers280K
Фильтр Калмана — это, наверное, самый популярный алгоритм фильтрации, используемый во многих областях науки и техники. Благодаря своей простоте и эффективности его можно встретить в GPS-приемниках, обработчиках показаний датчиков, при реализации систем управления и т.д.

Про фильтр Калмана в интернете есть очень много статей и книг (в основном на английском), но у этих статей довольно большой порог вхождения, остается много туманных мест, хотя на самом деле это очень ясный и прозрачный алгоритм. Я попробую рассказать о нем простым языком, с постепенным нарастанием сложности.
Читать дальше →

22 сайта для программиста, которые помогут заговорить на английском

Reading time3 min
Reach and readers140K
Хабр, привет!

Сделал подборку из 22-х сайтов для изучения английского языка.
Подборка поможет изучить английский легко, без зубрежки и учебников.

Приступим!

Учить лексику


Плагины, мобильные приложения и сайты, которые помогут перевести и запомнить незнакомые термины с русского на английский и обратно.

ЛеоПереводчик

С этим плагином удобно переписываться с коллегами. Он автоматически переводит непонятные слова и выражения. Незаменимый инструмент, когда нет времени на доскональные переводы и нужен срочный ответ.
Читать дальше →

Лучшие дистрибутивы Linux для старых компьютеров

Reading time8 min
Reach and readers661K
Привет!

Меня зовут Рушан, и я автор Telegram‑канала Нейрон. Не забудьте поделиться с коллегами или просто с теми, кому интересны такие статьи.

Вкратце: пока не бросайте свой старый компьютер — используйте легкий дистрибутив Linux, чтобы возродить его!

Что вы делаете со своим старым компьютером? Тот, который когда-то имел хорошую аппаратную конфигурацию, но теперь считается устаревшим. Почему бы не восстановить его вместе с Linux? Я собираюсь перечислить лучшие легкие дистрибутивы Linux, которые вы можете использовать на своем старом ПК.

Лучшие легкие дистрибутивы Linux для старых ноутбуков и десктопов


Я постараюсь упорядочить список в порядке убывания требований к оборудованию. Это означает, что легкому дистрибутиву Linux, занимающему первое место, потребуется минимальное аппаратное обеспечение.

10. Peppermint


image

Peppermint  —  это облачно-ориентированный дистрибутив Linux, не требующий мощного железа для запуска. Он основан на Lubuntu и использует окружение рабочего стола LXDE для более плавной работы.
Читать дальше →

Низковольтный ламповый сверхрегенеративный FM-приемник без выходного трансформатора

Reading time6 min
Reach and readers61K
image

Здравствуйте.

Примечание
В конце статьи есть два видеоролика, которые примерно дублируют содержимое статьи и демонстрируют работу устройства.

Могу предположить, что многих здешних обитателей привлекают электронные устройства, основанные на электронных лампах (лично меня радует теплота, приятный свет и монументальность ламповых конструкций), но при этом желание сконструировать что-то теплое и ламповое своими руками часто ломается о боязнь связываться с высокими напряжениями или проблемы с поиском специфических трансформаторов. И этой статьей я хочу попытаться помочь страждущим, т.е. описать ламповую конструкцию с низким анодным напряжением, очень простой схемой, распространенными элементами и отсутствуем потребности в выходном трансформаторе. При этом это не очередной усилитель для наушников или какой-нибудь овердрайв для гитары, а намного более интересное устройство.
Читать дальше →

Яндекс открывает датасеты Толоки для исследователей

Reading time6 min
Reach and readers35K
Толока — крупнейший источник размеченных людьми данных для задач машинного обучения. Каждый день в Толоке десятки тысяч исполнителей производят более 5 миллионов оценок. Для любых исследований и экспериментов, связанных с машинным обучением, необходимы большие объёмы качественных данных. Поэтому мы начинаем публиковать открытые датасеты для академических исследований в разных предметных областях.

Сегодня мы поделимся ссылками на первые публичные датасеты и расскажем о том, как они собирались. А ещё подскажем, где же правильно ставить ударение в названии нашей платформы.
Читать дальше →

Введение в разработку CatBoost. Доклад Яндекса

Reading time10 min
Reach and readers19K
Меня зовут Стас Кириллов, я ведущий разработчик в группе ML-платформ в Яндексе. Мы занимаемся разработкой инструментов машинного обучения, поддержкой и развитием инфраструктуры для них. Ниже — мой недавний доклад о том, как устроена библиотека CatBoost. В докладе я рассказал о входных точках и особенностях кода для тех, кто хочет его понять или стать нашим контрибьютором.


— CatBoost у нас живет на GitHub под лицензией Apache 2.0, то есть открыт и бесплатен для всех. Проект активно развивается, сейчас у нашего репозитория больше четырех тысяч звездочек. CatBoost написан на C++, это библиотека для градиентного бустинга на деревьях решений. В ней поддержано несколько видов деревьев, в том числе так называемые «симметричные» деревья, которые используются в библиотеке по умолчанию.

Python потребляет много памяти или как уменьшить размер объектов?

Reading time7 min
Reach and readers34K

Проблема памяти может возникнуть, когда в процессе выполнения программы нужно иметь большое количество объектов, особенно если есть ограничения на общий размер доступной оперативной памяти.


Ниже приводится обзор некоторых методов уменьшения размера объектов, которые позволяют существенно сократить объем оперативной памяти, необходимой для программ на чистом Python.

Читать дальше →

Пишем XGBoost с нуля — часть 2: градиентный бустинг

Reading time13 min
Reach and readers32K

Всем привет!

В прошлой статье мы разбирались, как устроены решающие деревья, и с нуля реализовали
алгоритм построения, попутно оптимизируя и улучшая его. В этой статье мы реализуем алгоритм градиентного бустинга и в конце создадим свой собственный XGBoost. Повествование будет идти по той же схеме: пишем алгоритм, описываем его, в заверешение подводим итоги, сравнивая результаты работы с аналогами из Sklearn'а.

В этой статье упор тоже будет сделан на реализацию в коде, поэтому всю теорию лучше почитать в другом вместе (например, в курсе ODS), и уже со знанием теории можно переходить к этой статье, так как тема достаточно сложная.


Итак, поехали!

Советские мечты о будущем

Reading time9 min
Reach and readers96K


Помните очаровательного котика, которые чихал в заставке советского мультфильма? Мы помним, и нашли его — вместе с ворохом другой рисованной фантастики. В детстве она пугала и обескураживала, поскольку поднимала серьезные, взрослые темы. Настала пора пересмотреть старые мультфильмы, чтобы узнать, о каком будущем мечтали в той стране.

Доступное объяснение гипотезы Римана

Reading time20 min
Reach and readers199K
image

Посвящается памяти Джона Форбса Нэша-младшего

Вы ведь помните, что такое «простые числа»? Эти числа не делятся ни на какие другие, кроме самих себя и 1. А теперь я задам вопрос, которому уже 3000 лет:

  • 2, 3, 5, 7, 11, 13, 17, 19, 23, 29, p. Чему равно p? 31. Каким будет следующее p? 37. А следующее p ? 41. А следующее? 43. Да, но… как нам узнать, каким будет следующее значение?

Придумайте суждение или формулу, которые (хотя бы с грехом пополам) прогнозируют, каким будет следующее простое число, (в любом заданном ряду чисел), и ваше имя навечно будет связано с одним из величайших достижений человеческого мозга. Вы встанете в один ряд с Ньютоном, Эйнштейном и Гёделем. Разберитесь в поведении простых чисел, и можете потом всю жизнь почивать на лаврах.

Введение


Свойства простых чисел изучались многими великими людьми в истории математики. С первого доказательства бесконечности простых чисел Евклида до формулы произведения Эйлера, связавшей простые числа с дзета-функцией. От формулировки теоремы о простых числах Гаусса и Лежандра до её доказательства, придуманного Адамаром и Валле-Пуссеном. Тем не менее, Бернхард Риман до сих пор считается математиком, сделавшим единственное крупнейшее открытие в теории простых чисел. В его опубликованной в 1859 году статье, состоявшей всего из восьми страниц, были сделаны новые, ранее неизвестные открытия о распределении простых чисел. Эта статья по сей день считается одной из самых важных в теории чисел.

После публикации статья Римана оставалась главным трудом в теории простых чисел и на самом деле стала основной причиной доказательства в 1896 году теоремы о распределении простых чисел. С тех пор было найдено несколько новых доказательств, в том числе элементарные доказательства Сельберга и Эрдёша. Однако до сих пор остаётся загадкой гипотеза Римана о корнях дзета-функции.
Читать дальше →

ML-Блиц: разбор задач первого квалификационного раунда

Reading time10 min
Reach and readers35K

23 июня 2018 года состоялся финал ML-Блица, конкурса по машинному обучению, организованного Яндексом. Ранее мы анонсировали его на Хабре и рассказывали, какие примерно задачи могут встретиться на реальном соревновании.


Теперь мы хотим поделиться с вами разборами задач одного из квалификационных раундов — самого первого. Двое участников сумели решить все задачи этого соревнования; 57 участников решили хотя бы одну задачу, а 110 совершили хотя бы по одной попытке сдать задание.


Хотя автор этих строк принимал участие в составлении задач конкурса, именно в первой квалификации его задачи не принимали участие. Так что я пишу этот разбор с позиции участника конкурса, который впервые увидел условия и хотел как можно быстрее получить как можно больше баллов.


Самым популярным языком программирования среди участников соревнования ожидаемо оказался python, поэтому я также использовал именно этот язык во всех случаях, когда требовалось написать код.


Все мои решения доступны на GitHub


image

Читать дальше →

Яндекс.Блиц: машинное обучение

Reading time5 min
Reach and readers20K

Не так давно мы проводили Яндекс.Блиц – соревнование по алгоритмическому программированию. Соревнование удалось: в финал пробилось более трёхсот участников, из которых двое сумели решить все предложенные задачи! Двадцать финалистов приехали в офис Яндекса, познакомились с руководителями различных сервисов и больше узнали об устройстве современных поисковых систем.


Однако в Яндексе разработчики решают самые разные задачи: от разработки высоконагруженных систем обработки данных до построения сложных моделей релевантности и смешивания поисковых источников. Поэтому нам показалось вполне логичным продолжить цикл соревнований от Яндекса соревнованием по машинному обучению и анализу данных.


Так же, как и в прошлый раз, мы заранее рассказываем на Хабре о том, какие задачи могут встретиться в контесте, и как их можно было бы решать, чтобы у потенциальных участников было представление о том, что их ждёт.


Квалификацию ML-блица можно будет пройти с 11 по 17 июня, а 23 июня состоится финал. Итоги соревнования будут подведены 25 июня. Для участия необходимо вовремя зарегистрироваться!


image

Читать дальше →

О разложении многоканального отклика системы по «псевдособственным» формам колебаний

Reading time7 min
Reach and readers3K
Обклеенный десятками датчиков «объект исследований» при натурных динамических испытаниях (например, при исследовании виброактивности транспортного средства) легко обеспечивает нас большим объемом полученных данных, но вот что с ними делать, зачастую не очень-то ясно. То же самое — при симуляционом моделировании динамических процессов систем с большим количеством степеней свободы.

Это может быть не совсем понятно тем, кто не сталкивается с проблемой регулярно, но — отсматривать соответствующую анимацию процесса, стохастического во времени и пространстве, как правило, почти бессмысленно. Где сломается или почему так трясет — обычно «не видно». Что придумывали кроме анимации, ниже расскажу, а порекомендую вот что.

Путем элементарнешей процедуры можно получить и сами пространственные «формы» колебаний, причем именно реально проявляющиеся в данных условиях нагружения, и интенсивности их проявления (дисперсии; при желании — и сами процессы).

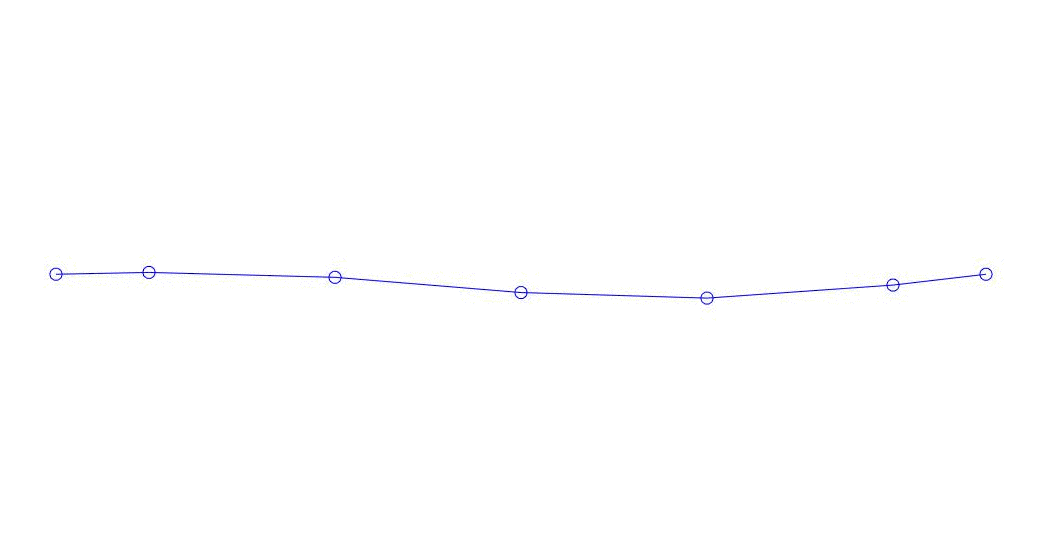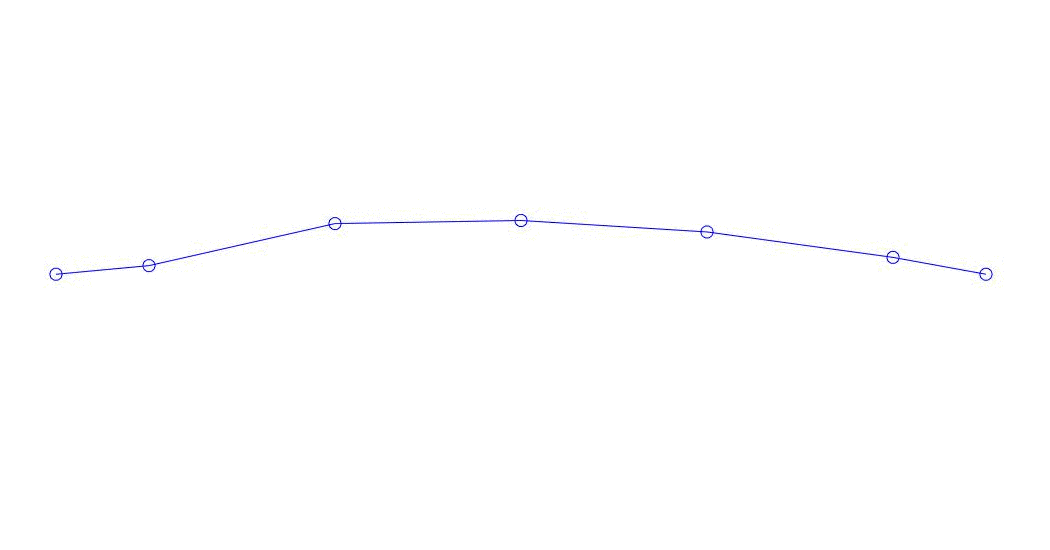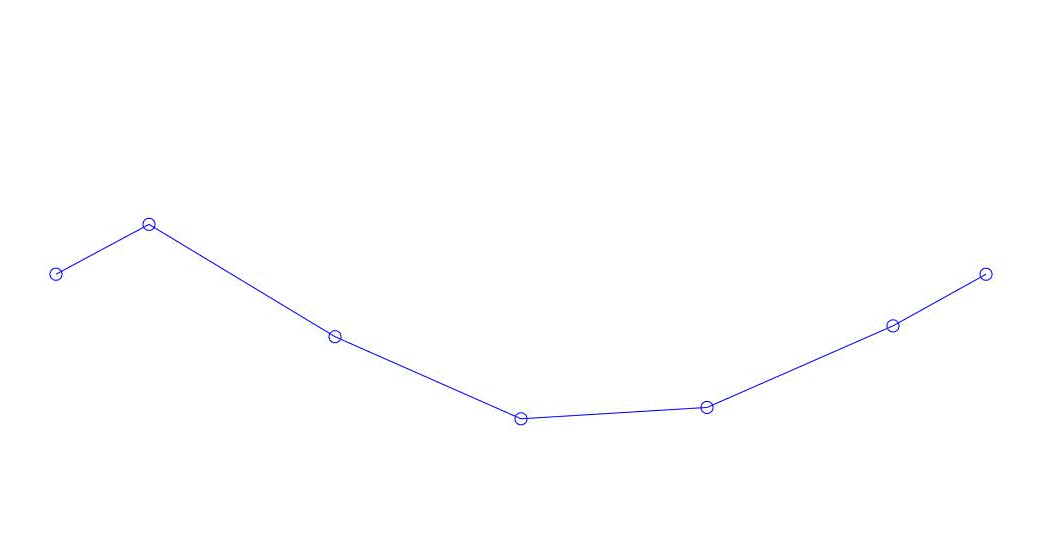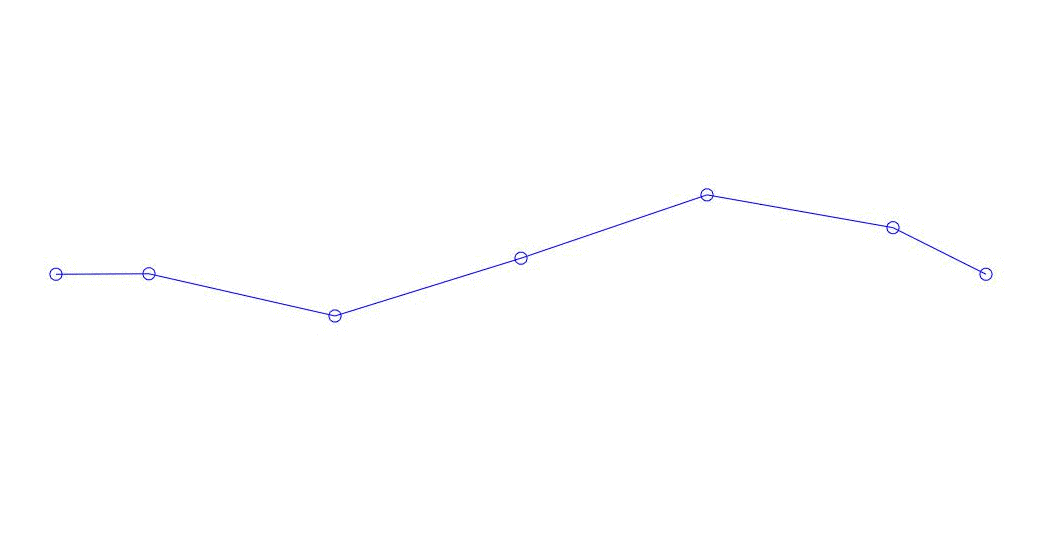
Исходный
многоканальный
процесс

image
Разложение
image
image
image


Рис.1 Разложение многоканального отклика по псевдоформам. «Струна в вязкой среде»(см.рис.2)

Читать дальше →

Эмулятор Радио-86РК на JavaScript / Перезагрузка

Reading time2 min
Reach and readers14K


В 2009 я написал первую версию эмулятора Радио-86РК на JavaScript. Тогда мне очень хотелось проверить саму идею подобного эмулятора, поэтому непосредственно реализация вышла несколько сумбурной, хотя и работала в итоге. Тогда я тестировал эмуляцию процессора Intel 8080 в основном визуально, на играх. Поэтому какой-либо рефакторинг кода был мучителен, так как было элементарно что-то сломать.

Недавно я запустил эмулятор РК на микрокомпьютере Maximite. В процессе работы эмуляция ядра Intel 8080 выделилась в отдельный проект i8080-core, в котором также появилась система тестирования. Тесты, особенно, 8080 CPU Execercier, позволяют весьма тщательно проверить качество эмуляции, особенно на предмет недокументированного поведения.

И тут пришла идея вернуться к эмулятору на JavaScript и перетестировать его. В итоге я фактически переписал эмулятор с нуля, разделив его на ядро процессора i8080-js, и, собственно, эмулятор РК.
Читать дальше →

Почему дорожное движение внезапно превращается в пробку

Reading time5 min
Reach and readers32K

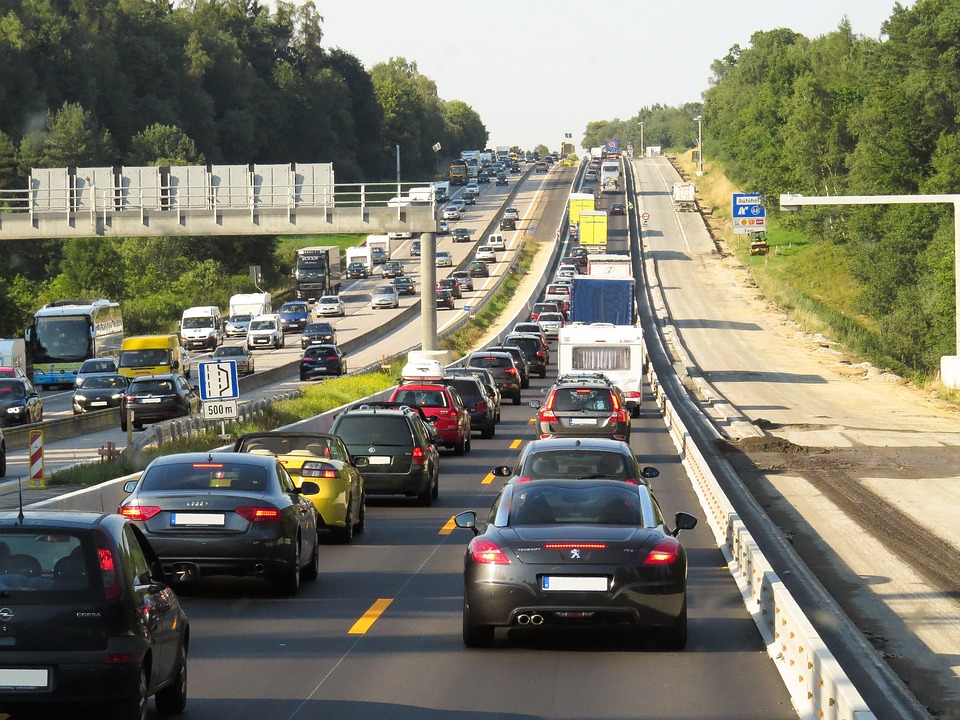
Одним из самых непонятных явлений в автомобильной поездке становятся внезапно возникающие фантомные пробки. Большинство из нас с этим сталкивалось: машина перед вами внезапно тормозит, заставляя тормозить вас, что заставляет тормозить водителя за вами. Но вскоре вы и окружающие вас машины снова ускоряются до исходной скорости, и становится очевидно, что на дороге нет ни видимых препятствий, ни заметных причин для замедления.

Так как движение быстро восстанавливает исходную скорость, фантомные пробки обычно не вызывают серьёзных задержек. Но не являются они и просто малозначительными досадными помехами. Это очаги аварий, потому что они заставляют неожиданно тормозить. А дёрганое движение, к которому они приводят, вредит автомобилю, снижает ресурс и повышает потребление топлива.

Так что же происходит? Для ответа на этот вопрос математики, физики и инженеры-транспортники разработали множество различных видов моделей трафика. Например, микроскопические модели вычисляют пути отдельных автомобилей и хорошо подходят для описания взаимодействия единичных машин. Макроскопические модели описывают трафик в виде жидкости, а машины в ней интерпретируются как частицы жидкости. Они эффективны при изучении крупномасштабных явлений с участием множества автомобилей. Наконец, клеточные модели разделяют дорогу на сегменты и предписывают правила, по которым машины движутся из клетки в клетку, создавая структуру для описания неопределённости, присущей реальному дорожному движению.

Вейвлет – анализ. Основы

Reading time8 min
Reach and readers92K

Введение


Английское слово wavelet (от французского «ondelette») дословно переводится как «короткая (маленькая) волна». В различных переводах зарубежных статей на русский язык встречаются еще термины: «всплеск», «всплесковая функция», «маловолновая функция», «волночка» и др.

Вейвлет-преобразование (ВП) широко используется для анализа сигналов. Помимо этого, оно находит большое применение в области сжатия данных. ВП одномерного сигнала – это его представление ввиде обобщенного ряда или интеграла Фурье по системе базисных функций.

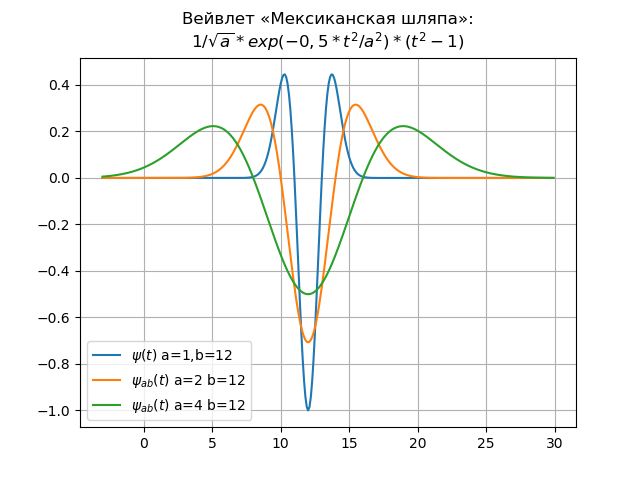
$\psi _{ab}(t)=\frac{1}{\sqrt{a}}\psi \left ( \frac{t-b}{a} \right ) $, (1)

сконструированных из материнского (исходного) вейвлета $\psi(t)$, обладающего определенными свойствами за счет операций сдвига во времени ( b ) и изменения временного масштаба (a).

Множитель $1/\sqrt{a}$ обеспечивает независимость нормы функций (1) от масштабирующего числа (a). Для заданных значений параметров a и b функция $\psi_{ab}(t)$ и есть вейвлет, порождаемый материнским вейвлетом $\psi(t)$.

В качестве примера приведём вейвлет «мексиканская шляпа» во временной и частотной областях:

Листинг вейвлета для временной области
from numpy import*
import matplotlib.pyplot as plt
x= arange(-4,30,0.01)
def w(a,b,t):    
    f =(1/a**0.5)*exp(-0.5*((t-b)/a)**2)* (((t-b)/a)**2-1)
    return f
plt.title("Вейвлет «Мексиканская шляпа»:\n$1/\sqrt{a}*exp(-0,5*t^{2}/a^{2})*(t^{2}-1)$")
y=[w(1,12,t) for t in x]
plt.plot(x,y,label="$\psi(t)$ a=1,b=12") 
y=[w(2,12,t) for t in x]
plt.plot(x,y,label="$\psi_{ab}(t)$ a=2 b=12")   
y=[w(4,12,t) for t in x]
plt.plot(x,y,label="$\psi_{ab}(t)$ a=4 b=12")   
plt.legend(loc='best')
plt.grid(True)
plt.show()


Читать дальше →

Мета-кластеризация с минимизацией ошибки, и почему я думаю, что так работает мозг

Reading time8 min
Reach and readers7.8K
Привет всем! Хочу поделиться с Вами своей идеей машинного обучения.

Большие достижения в области машинного обучения, впечатляют. Сверточные сети и LSTM это круто. Но почти все современные технологии основаны на обратном распространении ошибки. На основе этого метода вряд ли получится построить думающую машину. Нейронные сети получаются чем-то вроде замороженного мозга, обученного раз и навсегда, неспособным меняться размышлять.

Я подумал, почему бы не попробовать создать что-то похожее на живой мозг. Этакий реинжиниринг. Поскольку у всех животных, несмотря на различия в интеллекте, мозг состоит из примерно одинаковых нейронов, в основе его работы должен лежать какой-то базовый принцип.
Читать дальше →

Нейронные сети с нуля. Обзор курсов и статей на русском языке, бесплатно и без регистрации

Reading time5 min
Reach and readers226K
На Хабре периодически появляются обзоры курсов по машинному обучению. Но такие статьи чаще добавляют в закладки, чем проходят сами курсы. Причины для этого разные: курсы на английском языке, требуют уверенного знания матана или специфичных фреймворков (либо наоборот не описаны начальные знания, необходимые для прохождения курса), находятся на других сайтах и требуют регистрации, имеют расписание, домашнюю работу и тяжело сочетаются с трудовыми буднями. Всё это мешает уже сейчас с нуля начать погружаться в мир машинного обучения со своей собственной скоростью, ровно до того уровня, который интересен и пропускать при этом неинтересные разделы.

В этом обзоре в основном присутствуют только ссылки на статьи на хабре, а ссылки на другие ресурсы в качестве дополнения (информация на них на русском языке и не нужно регистрироваться). Все рекомендованные мною статьи и материалы я прочитал лично. Я попробовал каждый видеокурс, чтобы выбрать что понравится мне и помочь с выбором остальным. Большинство статей мною были прочитаны ранее, но есть и те на которые я наткнулся во время написания этого обзора.

Обзор состоит из нескольких разделов, чтобы каждый мог выбрать уровень с которого можно начать.
Для крупных разделов и видео-курсов указаны приблизительные временные затраты, необходимые знания, ожидаемые результаты и задания для самопроверки.


Читать дальше →

Information

Rating
Does not participate
Registered
Activity