Pull to refresh
28
Дмитрий Пашуткин@dm_p2016

Пользователь

4
Subscribers
Send message

Памятка пользователям ssh

Reading time13 min
Reach and readers1.6M
abstract: В статье описаны продвинутые функций OpenSSH, которые позволяют сильно упростить жизнь системным администраторам и программистам, которые не боятся шелла. В отличие от большинства руководств, которые кроме ключей и -L/D/R опций ничего не описывают, я попытался собрать все интересные фичи и удобства, которые с собой несёт ssh.

Предупреждение: пост очень объёмный, но для удобства использования я решил не резать его на части.

Оглавление:
  • управление ключами
  • копирование файлов через ssh
  • Проброс потоков ввода/вывода
  • Монтирование удалённой FS через ssh
  • Удалённое исполнение кода
  • Алиасы и опции для подключений в .ssh/config
  • Опции по-умолчанию
  • Проброс X-сервера
  • ssh в качестве socks-proxy
  • Проброс портов — прямой и обратный
  • Реверс-сокс-прокси
  • туннелирование L2/L3 трафика
  • Проброс агента авторизации
  • Туннелирование ssh через ssh сквозь недоверенный сервер (с большой вероятностью вы этого не знаете)
Читать дальше →

Метрики в задачах машинного обучения

Reading time9 min
Reach and readers808K

Привет, Хабр!


В задачах машинного обучения для оценки качества моделей и сравнения различных алгоритмов используются метрики, а их выбор и анализ — непременная часть работы датасатаниста.


В этой статье мы рассмотрим некоторые критерии качества в задачах классификации, обсудим, что является важным при выборе метрики и что может пойти не так.


Читать дальше →

8 ошибок, из-за которых ты проиграешь в соревновательном Data Science

Reading time8 min
Reach and readers17K

Привет, чемпион!

Если ты читаешь этот пост, значит, тебе стало интересно, не допускаешь ли этих ошибок ты?! Почти уверен, что ты допускал эти ошибки хотя бы раз в жизни. Мы не застрахованы от совершения ошибок, такова наша человеческая натура — ошибаться для нас естественно. Однако, я постараюсь уберечь тебя от тех ошибок, которые совершал сам или замечал у других.

Так вышло, что за время участия в чемпионатах по соревновательному анализу данных я достаточно часто бывал в призовых местах. Однако, бывали случаи, когда я лишался призовых по глупости или неосторожности. Рассказываю по порядку.
Читать дальше →

Парадокс, положивший начало научным вычислениям

Reading time21 min
Reach and readers49K


В 1953 году научные сотрудники Лос-Аламосской национальной лаборатории подбирали задачу для одного из первых электронных компьютеров. Выбор пал на простейшую одномерную систему — цепочку грузиков соединённых пружинами с нелинейной упругостью. Результаты моделирования вполне соответствовали ожиданиям: после возбуждения основного колебательного режима систему предоставляли самой себе, после чего энергия равномерно распределялась по остальным колебательным модам, и движения цепочки обретали характер белого шума.

Но однажды, из-за затянувшегося обеденного перерыва, машину оставили работать дольше обычного. Спохватившись, учёные вернулись в компьютерный зал и заметили, что расчётная система, пробыв некоторое время в состоянии теплового равновесия, вышла из него, а энергия в процессе эволюции периодично кочевала между наиболее длиноволновыми модами, практически не передаваясь на коротковолновые колебания. И в конце концов, система возвращалась из хаоса в исходное состояние! Этот парадокс ознаменовал собой рождение компьютерного моделирования, теории детерминированного хаоса и солитоники.
Читать дальше →

Коллаборативная фильтрация

Reading time6 min
Reach and readers79K
В современном мире часто приходится сталкиваться с проблемой рекомендации товаров или услуг пользователям какой-либо информационной системы. В старые времена для формирования рекомендаций обходились сводкой наиболее популярных продуктов: это можно наблюдать и сейчас, открыв тот же Google Play. Но со временем такие рекомендации стали вытесняться таргетированными (целевыми) предложениями: пользователям рекомендуются не просто популярные продукты, а те продукты, которые наверняка понравятся именно им. Не так давно компания Netflix проводила конкурс с призовым фондом в 1 миллион долларов, задачей которого стояло улучшение алгоритма рекомендации фильмов (подробнее). Как же работают подобные алгоритмы?

В данной статье рассматривается алгоритм коллаборативной фильтрации по схожести пользователей, определяемой с использованием косинусной меры, а также его реализация на python.


Читать дальше →

Программирование квантовых компьютеров: джентльменский набор издательства «Питер»

Reading time7 min
Reach and readers14K

Мы очень стараемся отслеживать тренды ещё на этапе их формирования и готовить для русскоязычных читателей наиболее актуальные книги. Сегодня я покажу, как это происходит. Для примера возьму довольно необычную тему – программирование квантовых компьютеров.

Эта история началась 4 года назад и теперь, в конце 2020, у нас уже сформирован небольшой, но весьма доступный и актуальный портфель.

Вот как это было

Как заменить регулярные выражения нейронной сетью

Reading time4 min
Reach and readers7.8K

Наиболее часто используемый инструмент для поиска подстроки определенного вида в тексте – это регулярные выражения. Но можно ли вместо регулярного выражения использовать нейронную сеть, которая бы выполняла ту же самую задачу?

Задача: найти в тексте описание стоимости недвижимости, то есть численное обозначение и стоимость, записанную прописью. Например, 2 050 000 (два миллиона пятьдесят тысяч) руб., 00 коп. Задача усложняется тем, что «рубли» и «копейки» могут быть в любом месте (перед скобками или после) и могут быть сокращены.

Чтобы решить данную задачу, будем использовать NLP (Natural Language Processing), морфологический анализатор и нейронную сеть. Подключаем соответствующие библиотеки:

Читать далее

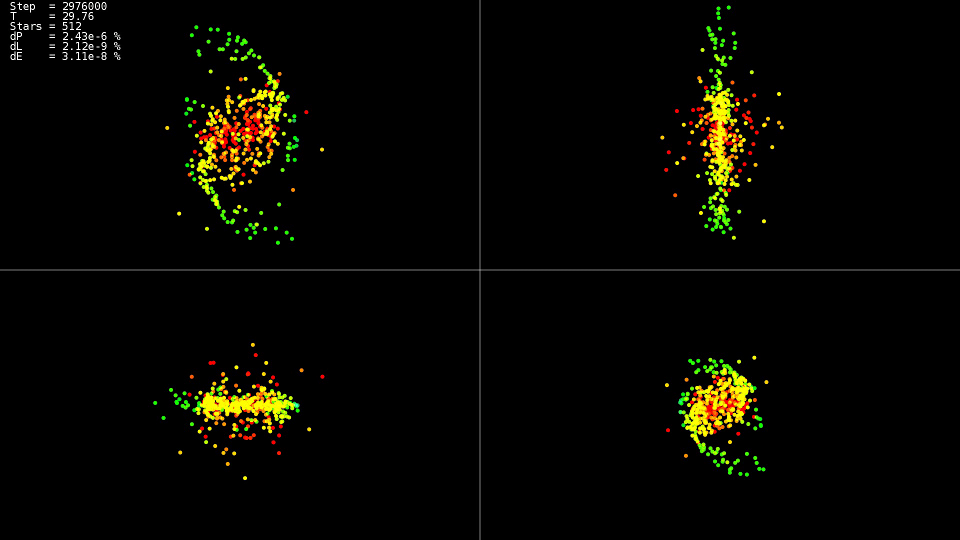
Задача N тел или как взорвать галактику не выходя из кухни

Reading time32 min
Reach and readers51K


Не так давно я прочёл фантастический роман «Задача трёх тел» Лю Цысиня. В нём у одних инопланетян была проблема — они не умели, с достаточной для них точностью, вычислять траекторию своей родной планеты. В отличии от нас, они жили в системе из трёх звёзд, и от их взаимного расположения сильно зависела «погода» на планете — от испепеляющей жары до леденящего мороза. И я решил проверить, можем ли мы решать подобные задачи.
Читать дальше →

Нефтяные ряды в R

Reading time6 min
Reach and readers43K
«Графики цен великолепны, чтобы предсказывать прошлое»
Питер Линч


С временными рядами мне как-то не доводилось иметь дело на практике. Я, конечно, читал о них и имел некоторое представление в рамках учебного курса о том, как в общих чертах проводится анализ, но хорошо известно, что то, о чем рассказывают в учебниках по статистике и машинному обучению, не всегда отражает реальное положение дел.
Читать дальше →

Открытый курс машинного обучения. Тема 9. Анализ временных рядов с помощью Python

Reading time27 min
Reach and readers405K

Доброго дня! Мы продолжаем наш цикл статей открытого курса по машинному обучению и сегодня поговорим о временных рядах.


Посмотрим на то, как с ними работать в Python, какие возможные методы и модели можно использовать для прогнозирования; что такое двойное и тройное экспоненциальное взвешивание; что делать, если стационарность — это не про вас; как построить SARIMA и не умереть; и как прогнозировать xgboost-ом. И всё это будем применять к примеру из суровой реальности.

UPD 01.2022: С февраля 2022 г. ML-курс ODS на русском возрождается под руководством Петра Ермакова couatl. Для русскоязычной аудитории это предпочтительный вариант (c этими статьями на Хабре – в подкрепление), англоговорящим рекомендуется mlcourse.ai в режиме самостоятельного прохождения.


Видеозапись лекции по мотивам этой статьи в рамках второго запуска открытого курса (сентябрь-ноябрь 2017).

Читать дальше →

Руководство по Docker Compose для начинающих

Reading time9 min
Reach and readers1.2M
Автор статьи, перевод которой мы сегодня публикуем, говорит, что она предназначена для тех разработчиков, которые хотят изучить Docker Compose и идут к тому, чтобы создать своё первое клиент-серверное приложение с использованием Docker. Предполагается, что читатель этого материала знаком с основами Docker. Если это не так — можете взглянуть на эту серию материалов, на эту публикацию, где основы Docker рассмотрены вместе с основами Kubernetes, и на эту статью для начинающих.

image
Читать дальше →

Регулярные выражения в Python от простого к сложному. Подробности, примеры, картинки, упражнения

Reading time25 min
Reach and readers1.9M

Регулярные выражения в Python от простого к сложному


Решил я давеча моим школьникам дать задачек на регулярные выражения для изучения. А к задачкам нужна какая-нибудь теория. И стал я искать хорошие тексты на русском. Пяток сносных нашёл, но всё не то. Что-то смято, что-то упущено. У этих текстов был не только фатальный недостаток. Мало картинок, мало примеров. И почти нет разумных задач. Ну неужели поиск IP-адреса — это самая частая задача для регулярных выражений? Вот и я думаю, что нет.
Про разницу (?:...) / (...) фиг найдёшь, а без этого знания в некоторых случаях можно только страдать.

Плюс в питоне есть немало регулярных плюшек. Например, re.split может добавлять тот кусок текста, по которому был разрез, в список частей. А в re.sub можно вместо шаблона для замены передать функцию. Это — реальные вещи, которые прямо очень нужны, но никто про это не пишет.
Так и родился этот достаточно многобуквенный материал с подробностями, тонкостями, картинками и задачами.

Надеюсь, вам удастся из него извлечь что-нибудь новое и полезное, даже если вы уже в ладах с регулярками.
Читать дальше →

Знакомство с Neural ODE

Reading time20 min
Reach and readers43K

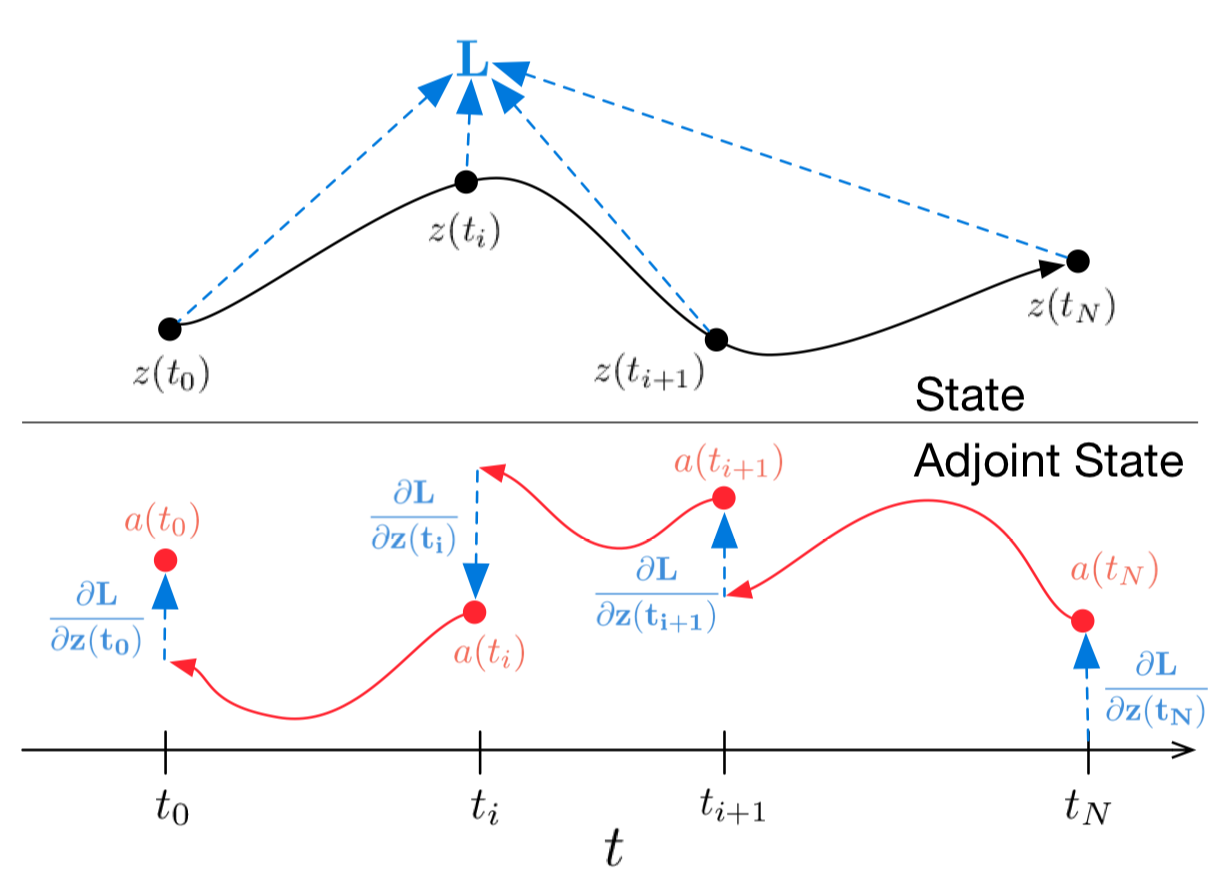
Neural Ordinary Differential Equations


Значительная доля процессов описывается дифференциальными уравнениями, это могут быть эволюция физической системы во времени, медицинское состояние пациента, фундаментальные характеристики фондового рынка и т.д. Данные о таких процессах последовательны и непрерывны по своей природе, в том смысле, что наблюдения — это просто проявления какого-то непрерывно изменяющегося состояния.

Есть также и другой тип последовательных данных, это дискретные данные, например, данные NLP задач. Состояния в таких данных меняется дискретно: от одного символа или слова к другому.

Сейчас оба типа таких последовательных данных обычно обрабатываются рекуррентными сетями, несмотря на то, что они отличны по своей природе, и похоже, требуют различных подходов.

На последней NIPS-конференции была представлена одна очень интересная статья, которая может помочь решить эту проблему. Авторы предлагают подход, который они назвали Нейронные Обыкновенные Дифференциальные Уравнения (Neural ODE).

Здесь я постарался воспроизвести и кратко изложить результаты этой статьи, чтобы сделать знакомство с ее идеей чуть более простым. Мне кажется, что эта новая архитектура вполне может найти место в стандартном инструментарии дата-сайентиста наряду со сверточными и рекуррентными сетями.


Читать дальше →

Участвуем в соревновании по Data Science. Первый опыт

Reading time37 min
Reach and readers5.6K
Привет, Хабр!

Давно я не писал никаких статей и, вот думаю, пришло время написать о там, как мне пригодились знания по data science, полученные по ходу обучения небезывестной специализации от Яндекса и МФТИ «Машинное обучение и анализ данных». Правда, справедливости ради надо отметить, что знания до конца не получены — специализация не завершена :) Однако, решать простенькие реальные бизнесовые задачи уже можно. Или нужно? На этот вопрос будет ответ, буквально через пару абзацев.

Итак, сегодня в этой статье я расскажу уважаемому читателю о своем первом опыте участия в открытом соревновании. Хотелось бы сразу отметить, что моей целью соревнования было не получение каких-либо призовых мест. Единственное желание было попробовать свои силы в реальном мире :) Да, в добавок так вышло, что тематика соревнования практически никак не пересекалась с материалом из пройденных курсов. Это добавило некоторые сложности, но с этим соревнование стало еще интереснее и ценнее опыт вынесенный оттуда.

По сложившейся традиции, обозначу кому может быть интересна статья. Во-первых, если Вы уже прошли первые два курса указанной выше специализации, и хотите попробовать свои силы на практических задачах, но стесняетесь и переживаете, что может не получиться и Вас засмеют и т.д. После прочтения статьи, такие опасения, надеюсь, развеятся. Во-вторых, возможно, Вы решаете схожую задачу и совсем не знаете с чего зайти. А здесь готовенький простенький, как говорят настоящие датасайнтисты, бэйзлайн :)
Читать дальше →

База данных штрихкодов скачать бесплатно без регистрации (и прочей хурмы)

Reading time5 min
Reach and readers94K
Добрый день. В открытом доступе наконец-то появился огромный справочник штрихкодов с наименованиями товаров, категориями и брендами.

Мы работаем над ним лет 8 и теперь в нем около 3 миллионов штрихкодов в стандартах EAN (EAN-13, EAN-8) и UPC (UPC-A, UPC-E).
Читать дальше →

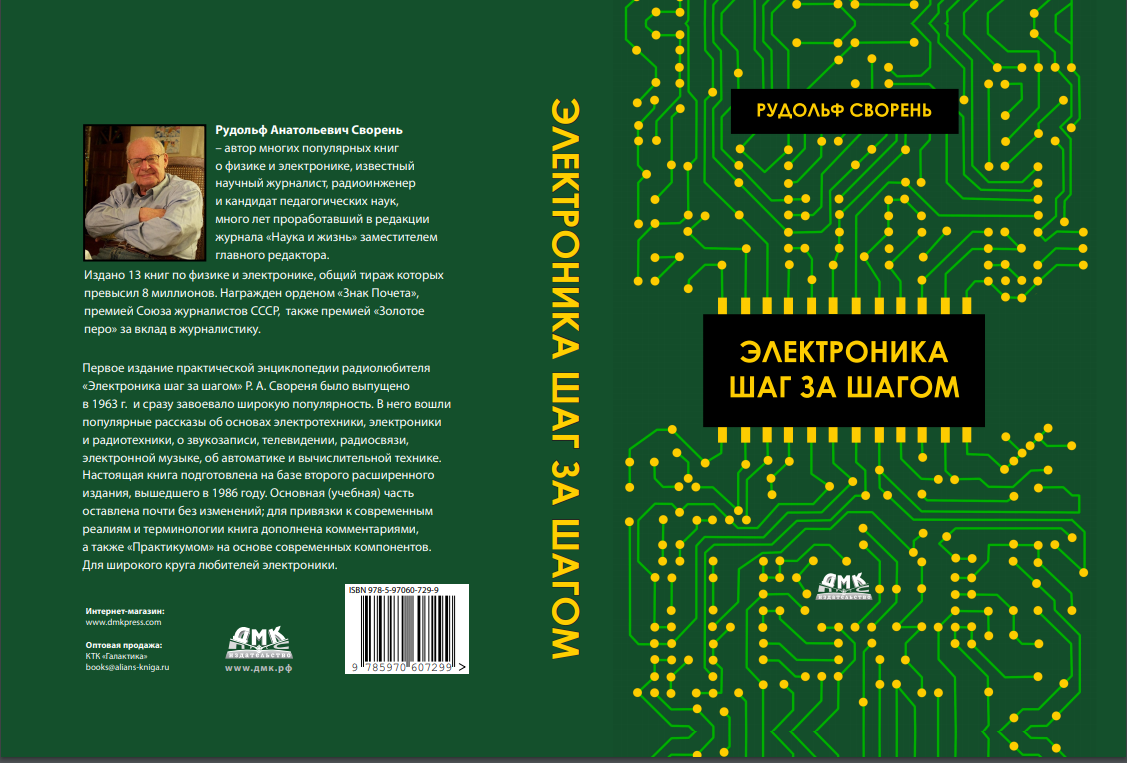
Как книга «Электроника шаг за шагом» обрела новую жизнь

Reading time7 min
Reach and readers100K


Привет, Хабр!

Хорошие новости для тех, кто следил за историей переиздания книги Рудольфа Свореня «Электроника шаг за шагом» — книга вот-вот, на днях, покинет типографию и попадёт в руки читателей. Почему так долго пришлось ждать новое издание книги? Что изменилось в тексте? А иллюстрации всё те же? Что со схемами  — по-прежнему, на МП39, с плюсовой «землей»? Будет ли электронная версия книги? На эти и другие вопросы, я попытаюсь ответить ниже.
Читать дальше →

Сборка тонкого клиента RDP на базе Raspberry Pi

Reading time18 min
Reach and readers89K
С ростом популярности мини-ПК типа Raspberry Pi, и подобных ему клонов, возникла масса кейсов по их использованию в ИТ-инфраструктуре предприятия, умном доме / даче / гараже, и в других применениях.

Одним из удобных и желаемых кейсов является использование RPi как тонкого клиента, подключаемого по протоколу RDP к Windows-системам.

Если Вам интересно, как настроить такое место на базе Raspberry Pi, причем так, чтобы «настроить и забыть» — добро пожаловать под кат. Для совсем ленивых есть готовый образ (см. раздел 6.Б).

Картинка для привлечения внимания

Читать дальше →

Подготовка к собеседованиям в IT-гиганты: как я преодолела проклятье алгоритмического собеседования

Reading time12 min
Reach and readers211K

Дисклеймер:


Я не программирую с трёх лет, не знаю наизусть Кнута, не являюсь призёром олимпиад по информатике и чемпионатов по спортивному программированию, не училась в MIT. У меня за плечами образование по информатике и 6 лет опыта в коммерческой разработке. И до недавнего времени я не могла пройти дальше первого технического скрининга в IT-гиганты из FAANG (Facebook, Amazon, Apple, Netflix, Google и подобные), хотя предпринимала несколько попыток. 

Но теперь всё изменилось, я получила несколько офферов и хочу поделиться опытом, как можно к этому прийти. Речь пойдёт о позиции Software Engineer в европейских офисах перечисленных компаний.
Читать дальше →

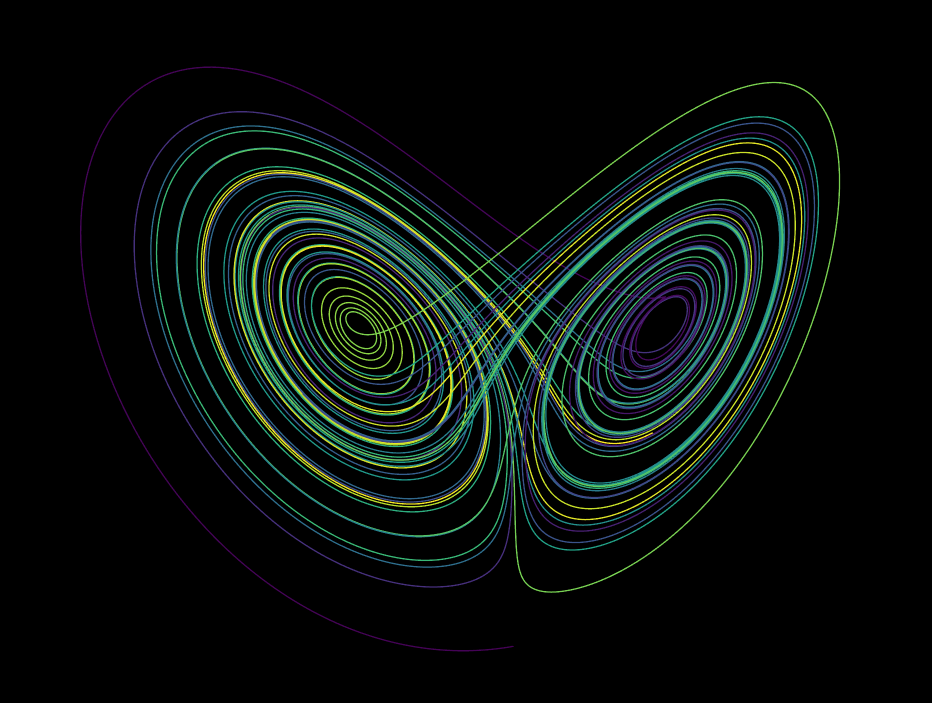
Визуализация странных аттракторов в Plotly — это шедеврально

Reading time10 min
Reach and readers18K
Поэзия — это очень красивый, зачастую глубокомысленный слог, которым мы не пользуемся в обыденной жизни, но так им любим наслаждаться. То же самое можно сказать и о математике. В фильме «Пи» главный герой называет математику «языком природы», а в фильме «Игры разума» главный герой говорит о ней, как об «особом виде искусства». Мы же, в обыденной жизни, можем напрочь забыть об этом.

Облик странных аттракторов необычен и притягателен даже в двумерном измерении. Plotly позволяет строить их в трех измерениях, причем он дает возможность очень легко получить именно 3D-модель, которую можно «вертеть» и сквозь которую можно «пролетать» — ощущение «прикосновения».

image

Читать дальше →

Титаник на Kaggle: вы не дочитаете этот пост до конца

Reading time31 min
Reach and readers86K
Привет, хабр!

#{Data Science для новичков}

Меня зовут Глеб Морозов, мы с Вами уже знакомы по предыдущим статьям. По многочисленным просьбам продолжаю описывать опыт своего участия в образовательных проектах MLClass.ru (кстати, кто еще не успел — до конца еще можно получить материалы прошедших курсов — это, наверное, самый краткий и максимально практичный курс по анализу данных, который можно себе представить).

Данная работа описывает мою попытку создать модель для предсказания выживших пассажиров «Титаника». Основная задача — тренировка в использовании инструментов применяемых в Data Science для анализа данных и презентации результатов исследования, поэтому данная статья будет очень и очень длинной. Основное внимание уделено исследовательскому анализу (exploratory research) и работе по созданию и выбору предикторов (feature engineering). Модель создаётся в рамках соревнования Titanic: Machine Learning from Disaster проходящего на сайте Kaggle. В своей работе я буду использовать язык «R».
Читать дальше →

Information

Rating
Does not participate
Registered
Activity