Pull to refresh
-6
Алексей@java3000

Администратор windows умеющий в программирование

Send message

СМИ: «Студенты используют ИИ в 15% своих работ»

Reading time2 min
Reach and readers5.2K

Компания «Антиплагиат» проанализировала студенческие работы и выяснила, как часто в них используется искусственный интеллект. В 2025 году система проверила 8 млн студенческих работ. Каждая седьмая работа содержала признаки использования ИИ. Об этом изданию «РИА Новости» сообщил исполнительный директор компании «Антиплагиат» Евгений Лукьянчиков.

Общий процент работ с признаками использования ИИ составил 15,3%. Средний процент плагиата и заимствований из открытых источников превысил 20%. Евгений Лукьянчиков отметил, что студенты всё чаще обращаются к нейросетям для редактирования своих работ.

Читать далее

Когда AI сможет работать месяц автономно? По данным METR — к 2027 году

Reading time1 min
Reach and readers5.8K

Организация METR опубликовала свежие замеры бенчмарка Time Horizon, который измеряет, задачи какой длины AI-агенты выполняют автономно. Gemini 3 Pro показал результат около 4 часов — это время, за которое человек-эксперт выполнил бы задачу, с которой модель справляется с 50% вероятностью успеха. Лидирует Claude Opus 4.5 с показателем 5,3 часа. Правда, если смотреть на 80%-й горизонт — задачи, которые модель решает надежно, — цифры скромнее: 42 минуты у Claude Opus 4.5 и 43 минуты у Gemini 3 Pro.

Читать далее

Почему большие языковые модели застряли в пещере Платона (и что будет дальше)

Level of difficultyEasy
Reading time4 min
Reach and readers11K

Большие языковые модели кажутся умными, потому что говорят бегло, уверенно и в огромных масштабах. Но беглость - это не понимание, а уверенность - это не восприятие. Чтобы ухватить реальное ограничение сегодняшних ИИ-систем, полезно вернуться к идее возрастом более двух тысяч лет.

В "Государстве" Платон описывает аллегорию пещеры: узники, закованные в цепи внутри пещеры, могут видеть только тени, проецируемые на стену. Никогда не видев реальных объектов, отбрасывающих эти тени, они принимают видимость за реальность и лишены возможности испытать настоящий мир.

Большие языковые модели живут в очень похожей пещере.

Читать далее

OpenClaw/MoltBot/Clawdbot: разбираемся в AI-ассистенте, который взорвал GitHub за неделю

Level of difficultyEasy
Reading time9 min
Reach and readers61K

Январь 2026 года. Ты листаешь ленту за утренним кофе и видишь, как люди массово скупают Mac Mini или арендуют VPS сервера. Не для разработки. Не для монтажа видео. Для бота. AI-бота, которому нужен целый компьютер, чтобы работать 24/7.

За две недели проект набирает почти 100 000 звёзд на GitHub. Сто. Тысяч. Для сравнения: у React 234K за 11 лет. А тут за месяц чуть ли не половина этого. TechCrunch, VentureBeat, IBM, Cisco- все пишут. Cloudflare запускает специальный сервис под него, и их акции подскакивают на 20%. Anthropic присылает автору письмо: "Братан, переименуй, слишком похоже на Claude". Он переименовывает. Дважды (для контекста: сначала это Clawdbot, потом становится MoltBot и вот наконец января 2026 это OpenClaw, надолго ли?).

Читать далее

Видео-ИИ научился монтировать: Kling 3.0 сам выбирает ракурсы и переходы

Reading time1 min
Reach and readers5.8K

Китайская Kuaishou выпустила Kling 3.0 — видеогенератор, который не просто создает клипы, а самостоятельно режиссирует их. Модель умеет расставлять до шести камер в одной сцене, переключаться между ракурсами и добавлять переходы без участия пользователя. Ранний доступ для подписчиков Ultra открылся 4 февраля, API заработает на следующий день.

Читать далее

ИИ научили писать исследования длиннее его памяти

Reading time2 min
Reach and readers7.1K

Главная проблема современных ИИ-агентов — лимит контекстного окна. Даже 200К токенов мало для серьезной научной работы на десятки тысяч слов. Исследователи из Китая представили FS-Researcher — систему, которая использует обычную файловую систему как внешнюю память.

Читать далее

Разбираю статью про FS-Researcher: как учёные научили ИИ вести конспекты

Level of difficultyEasy
Reading time5 min
Reach and readers9.3K

ChatGPT и другие LLM "забывают" начало диалога при серьезном ресерче. Обычная проблема. Новые факты вытесняют старые из-за ограниченного контекстного окна, и отчет получается поверхностным. Недавнее исследование предлагает простое решение — дать ИИ-агенту "блокнот". Разбираемся как такой подход обходит ограничения контекста.

Читать далее

Roblox запустил открытый бета-тест 4D-генерации объектов

Reading time2 min
Reach and readers7.5K

Платформа Roblox запустила открытый бета-тест долгожданной функции 4D-создания. Если ранее ИИ компании помогал генерировать статичные 3D-объекты, то теперь он научился оживлять их внутри игровых миров.

Читать далее

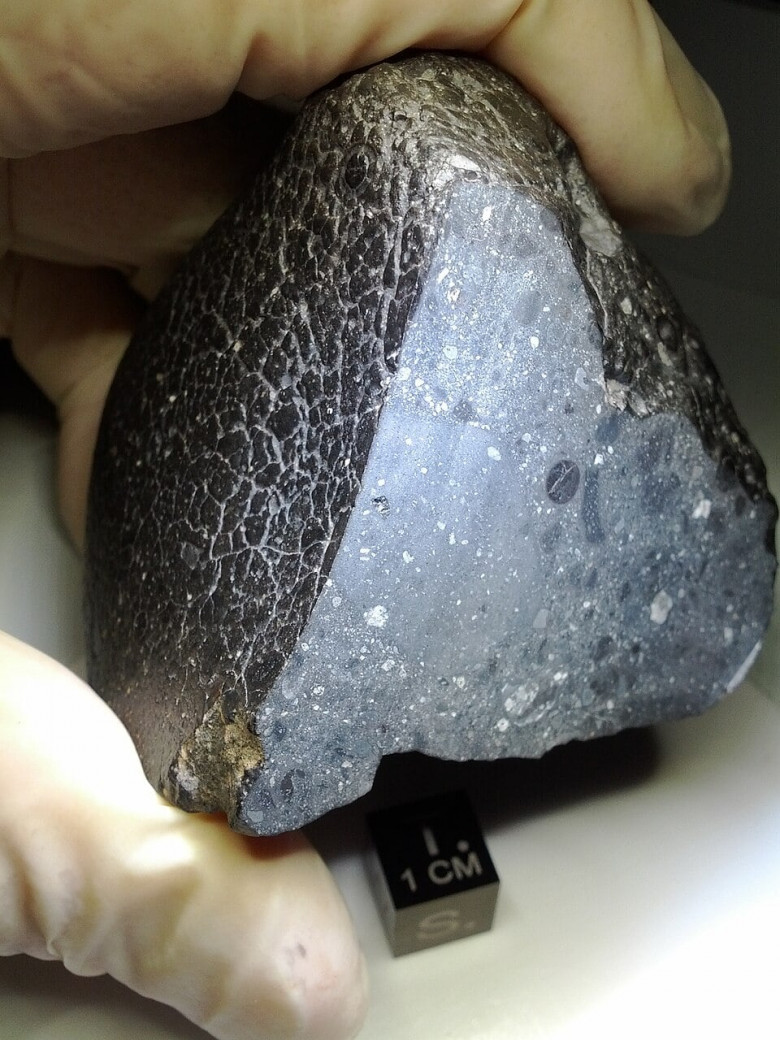
Учёные обнаружили скрытые запасы воды внутри «Чёрной Красавицы»

Reading time2 min
Reach and readers9.7K

В новой статье, доступной в препринте на arXiv, Эстрид Навер из Технического университета Дании и её соавторы описывают использование двух новых инструментов на одном из самых известных метеоритов в мире — NWA 7034, также известном как «Чёрная красавица».

Часть славы метеорита связана с его происхождением. Это кусок Марса, который упал на Землю, скорее всего, после мощного удара по Красной планете. Он состоит из материала, возраст которого составляет около 4,48 миллиарда лет, что делает его одним из старейших известных марсианских материалов в Солнечной системе.

К сожалению, в предыдущих исследованиях учёным приходилось отрезать части этой «красавицы», чтобы изучить их. Затем эти части измельчали или растворяли, чтобы извлечь материалы, из которых состоит камень. Но теперь у нас есть аппараты для компьютерной томографии.

Читать далее

LLM модель qwen3-coder-next быстрый тест на локальном сервере

Level of difficultyEasy
Reading time3 min
Reach and readers25K

Сегодня зашел на сайт ollama, а там представили новую LLM модель qwen3-coder-next. Но при попытке ее установить вышло предупреждение что моя текущая версия 0.15.4 не будет работать с ней, нужно установить 0.15.5 которая еще только в бета тестировании. А стандартная установка ставила только 0.15.4, сначала я плюнул на это.

Но немного разобравшись, оказалось что установить бета версию не так и сложно, стандартная установка для линукс выглядит так

curl -fsSL https://ollama.com/install.sh | sh

а установка бета варсии (сейчас она 0.15.5-rs2) выглядит так

curl -fsSL https://ollama.com/install.sh | OLLAMA_VERSION=0.15.5-rc2 sh

Представлено 2 версии qwen3-coder-next

Читать далее

Карта российских ИИ-платформ для аналитика

Level of difficultyEasy
Reading time7 min
Reach and readers9.4K

GigaCode vs SourceCraft Code Assistant: что выбрать аналитику в 2025?

Сравнил две российские AI-IDE по критериям, важным не разработчику, а аналитику: работа с документами, контекстное окно, агентный режим, бесплатные квоты. Плюс пошаговые инструкции — от регистрации до первого запроса в чате.

SourceCraft: 3000 предложений + 1000 чат-запросов в неделю бесплатно, лимиты прозрачны.
GigaCode: бесплатен для пользователей GitVerse, квоты не публикуются.

Бонус: таблица соответствия концепций Roo Code → российские платформы. Для тех, кто читал мои предыдущие статьи и хочет применить подходы на одобренном стеке.

Читать далее

Посимвольная нейросетевая модель для автоматической акцентуации русского языка

Reading time4 min
Reach and readers9.6K

Привет Хабр, решил поделиться небольшой моделью для расстановки ударений, которую обучил на открытом датасете из более чем 400 книг художественной прозы в открытом источнике.

Читать далее

Разработка приложения на Spring Boot, Java, База данных, профиль пользователя. Часть 2

Level of difficultyHard
Reading time7 min
Reach and readers9.1K


Всех приветствую!

В прошлый раз я не указал важный аспект: на данном этапе проект - это монолит. Однако архитектура закладывается с учетом того, что в будущем систему можно будет разнести на разные серверы.

Хочу поблагодарить пользователей за конструктивную критику в комментариях. В частности, @aleksandy верно подметил использование LocalDateTime вместо Instant. Повторюсь: на этапе прототипирования это осознанный выбор для удобства отладки и прямого контроля данных в БД "глазами", без конвертации часовых поясов в уме. Переход на Instant - это стандарт для продакшена, и он заложен в план развития.

Также коснулись темы equals() и hashCode(). В текущей реализации я использую getClass(). Знаю, что это не учитывает работу Hibernate Proxy (когда вместо реального объекта мы получаем его обертку‑пустышку для ленивой загрузки). На текущей «плоской» структуре данных это не критично, но как только мы перейдем к сложным связям, будет рефакторинг этих методов через instanceof, чтобы избежать ошибок сравнения.

Читать далее

Алгоритмическая энциклопедия: как навести порядок в мире программных библиотек

Reading time6 min
Reach and readers9.4K

Современный разработчик сталкивается с парадоксальной ситуацией: с одной стороны — колоссальный выбор готовых решений, с другой — невероятная сложность их отбора.

По данным GitHub, количество открытых библиотек растёт экспоненциально. Только в экосистеме npm (JavaScript) насчитывается более 2 миллионов пакетов. При этом:

Читать далее

Как ИИ-стартап задумал отсканировать и утилизировать миллионы книг

Level of difficultyEasy
Reading time10 min
Reach and readers38K

Судебные материалы раскрывают, как компании наперегонки добывали всё больше книг, чтобы скормить чат-ботам: в числе прочего, покупали, сканировали и уничтожали миллионы экземпляров

В начале 2024 года руководители Anthropic, стартапа по разработке искусственного интеллекта, взялись за амбициозный проект, одновременно пытаясь держать его в тайне. «Project Panama — это наша попытка провести деструктивное сканирование всех книг мира, — говорилось во внутреннем плане, рассекреченном в судебных материалах на прошлой неделе. — Мы не хотим, чтобы факт нашей деятельности стал известен».

Как следует из документов, примерно через год на эту цель был освоен бюджет в десятки миллионов долларов. Эти деньги потратили, чтобы приобрести книги и сре́зать корешки, а затем отсканировать страницы и вкачать больше знаний в ИИ-модели, лежащие в основе продуктов по типу популярного чат-бота Claude.

Читать далее

Обработка 100 000 запросов с помощью виртуальных потоков Java и сравнение производительности с обычными потоками

Level of difficultyEasy
Reading time8 min
Reach and readers7.5K

Всем привет!

Сегодня хочу затронуть тему виртуальных потоков и выяснить на сколько они лучше (быстрее) и в каких случаях, чем обычные потоки операционной системы (или как еще их называют платформенные потоки).

Долгое время java полагалась только на потоки операционной системы для обработки параллельных операций. Это выглядело следующим образом, когда веб-сервер получал запрос, он обычно выделял один поток операционной системы для его обработки. Эта модель называется «поток на запрос». Она очень проста — мы просто пишем блокирующий код так, как если бы он был синхронный, а операционная система обрабатывает переключение контекста между потоками в рамках какого-то процесса.

Несмотря на свою простоту, эта модель имеет существенный недостаток: потоки операционной системы обходятся дорого. Каждый поток потребляет от 1 до 2 МБ памяти только на свой стек, а переключение между ними включает в себя переключение контекста на уровне операционной системы, что также является ресурсоемкой операцией.

Представьте, что есть задача по обработке 100 000 одновременных запросов с помощью этой модели. Это приведёт к потреблению десятков гигабайт памяти только под стеки потоков и, скорее всего, к аварийному завершению JVM задолго до достижения такого количества потоков, также будет тратиться время на переключение контекста между потоками. Пропускная способность системы резко упадет из-за накладных расходов.

Для решения этой проблемы разработчики прибегают к сложным асинхронным моделям программирования, к реактивному программированию, к управлению событиями. Хотя эти подходы и являются мощным инструментом, но они вносят значительную сложность, затрудняя чтение, отладку и сопровождение кода. Мы меняем простоту блокирующего кода на сложности, связанные с неблокирующими коллбэками и реактивными потоками.

Читать далее

MCPHero: MCP tools как native tools в openai

Level of difficultyEasy
Reading time5 min
Reach and readers7.1K

MCPHero - новая библиотека/проект для Python для использования MCP tools как native tools в ИИ библиотеках типа openai, которые не поддерживают MCP сами по себе.

Читать далее

От «яблока» до «королевы»: как нейросети учатся понимать смысл слов через эмбеддинги

Reading time4 min
Reach and readers8K

Представьте, что вы объясняете ребёнку, что такое «яблоко». Вы покажете картинку, дадите попробовать, расскажете, что оно круглое, сладкое, растёт на дереве, а теперь попробуйте объяснить это нейросети. Она не видит, не пробует, но она понимает только числа.

Как же тогда заставить машину понять, что «яблоко» ближе к «груше», чем к «трактору»? Ответ на самом деле кроется в элегантном приёме, который произвёл революцию в NLP- векторных представлениях слов, или эмбеддингах.

Проблема «слепого» кодирования: почему one-hot не работает

Самый наивный подход- это пронумеровать все слова в словаре и закодировать каждое вектором из нулей и одной единицы:

Читать далее

Как мы пытались научить ML считать трудоёмкость в промышленности — и что из этого вышло

Level of difficultyHard
Reading time18 min
Reach and readers5.9K

Современное машиностроительное производство требует высокой точности планирования технологических процессов и оценки трудоёмкости операций. Эти оценки напрямую влияют на формирование себестоимости, планирование загрузки оборудования и назначение цен на продукцию и услуги.

В последние годы руководители IT-подразделений всё чаще рассматривают методы анализа данных и машинного обучения как универсальный инструмент, способный «автоматически» решить задачу расчёта норм времени. Иногда — с избыточным оптимизмом. Часто при этом забывается простая, но важная мысль: если существующий процесс расчёта неточен и данные в нём некачественные, то автоматизация такого процесса лишь ускоряет распространение ошибок. Особенно если применять вероятностные модели к накопленным за годы «грязным» данным.

Именно с такой реальностью нам (мне и коллегам) и пришлось столкнуться.

Читать далее

Сравнение методов решения систем линейных алгебраических уравнений

Reading time26 min
Reach and readers7.4K

Цель данной статьи - предоставить сравнение методов решения СЛАУ и их эффективности в разрезе времени решения и нормы невязки, характеризующей точность решения. В статье приводятся результаты решения для числа уравнений от 50 до 3000. Приводится сравнение результатов решения для методов: Гаусса, LU декомпозиции, компактной схемы исключения, QR декомпозиции, LL^T декомпозиции, методов вращений, релаксации и градиентного спуска.

Читать далее

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Date of birth
Registered
Activity

Specialization

Десктоп разработчик, Администратор серверов
Младший
From 110,000 ₽
Java
Java Spring Framework
RESTful WebServices.
PostgreSQL
SQL
Hibernate
Linux
Базы данных
Microsoft SQL Server
Разработка программного обеспечения