Pull to refresh
33
Игорь Хмельков@khmelkoff

Data Scientist

29
Subscribers
Send message

Лекции по биоинформатике

Reading time7 min
Reach and readers17K
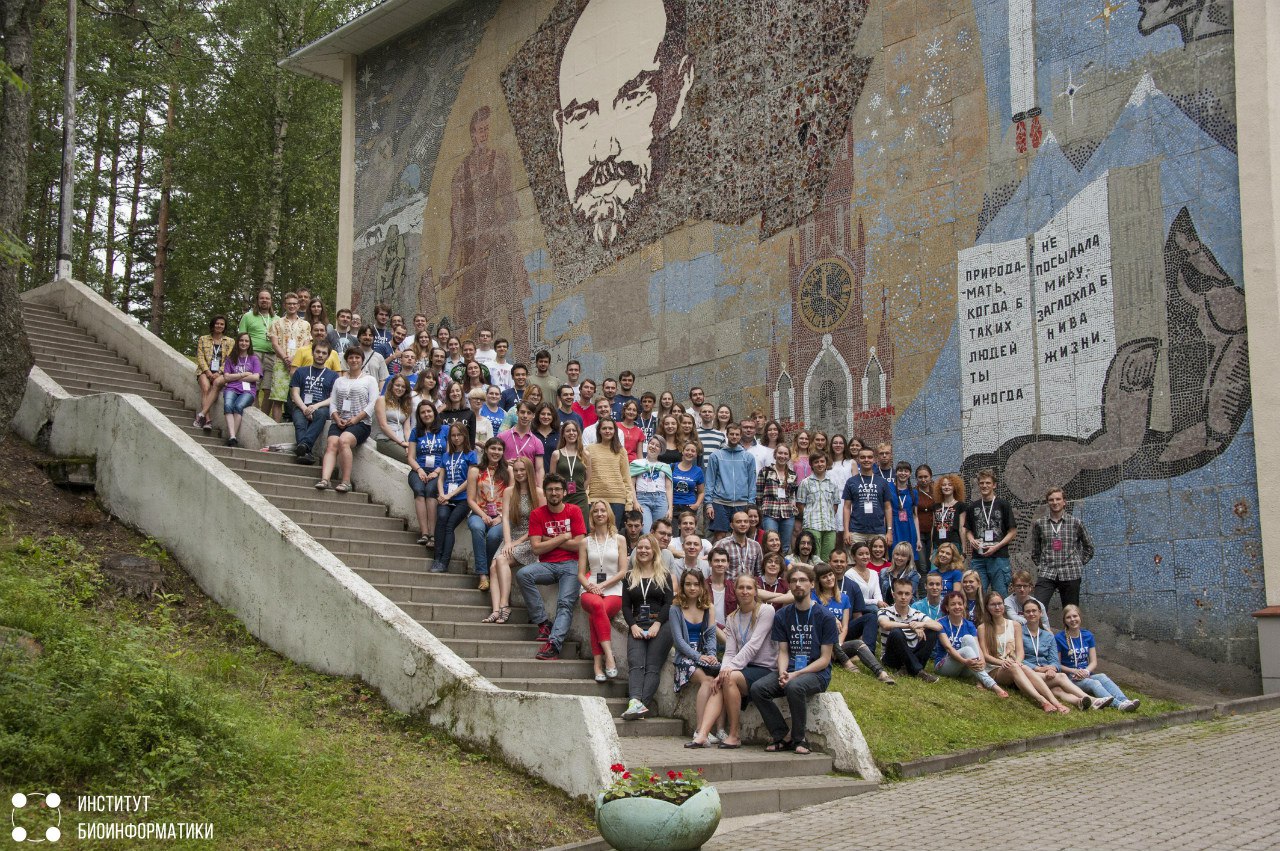
Каждый год в конце июля Институт биоинформатики совместно с СПбАУ РАН проводит летнюю школу по биоинформатике. В этой небольшой статье собраны лекции (видео и слайды) за два последних года проведения летних школ.
image

Вводные слова о школе


Каждый год на школу приезжает 100 студентов и аспирантов со всей России, СНГ и других стран. В основном это биологи, медики, программисты, математики и физики. В течение недели участники погружаются в мир биоинформатики: просыпают посещают лекции и семинары, много общаются друг с другом и работают над научными проектами.

Читать дальше →

Анонимность в современном мегаполисе

Reading time11 min
Reach and readers35K


Современный мегаполис — это гигантский и сложный организм, пронизанный насквозь информационными потоками. Информация делает более эффективной его работу, но при этом создает потенциальные проблемы с приватностью его обитателей, которые зачастую даже не подозревают о слежке.


Эта статья о том, какие данные собираются, какими способами и как от этого защититься.

Читать дальше →

Второй мозг и LLM‑Wiki: Теория и практический гайд по созданию и поддержке личной базы знаний

Level of difficultyEasy
Reading time9 min
Reach and readers30K

В этой статье поговорим про концепцию «второго мозга»: что это такое, где хранить информацию и как ее использовать. Разберу, как собрать минимальную систему знаний в Obsidian, чем подход LLM‑Wiki от Andrej Karpathy отличается от классического RAG, и покажу практический пример реализации «второго мозга».

Читать далее

RAG для тех, кто разочаровался: почему retrieval ломается и как это починить

Level of difficultyMedium
Reading time7 min
Reach and readers13K

Вы собрали RAG-пайплайн: загрузили документы, нарезали на чанки, сгенерировали эмбеддинги, подключили векторную базу. Задаёте вопрос — модель отвечает уверенно и подробно. Показываете заказчику, тот в восторге. Потом начинается тестирование на реальных вопросах, и оказывается, что на половину из них система отвечает мимо: то находит не тот документ, то находит правильный, но не тот кусок, то вообще ничего релевантного не достаёт и модель уверенно галлюцинирует.

Каждый раз проблема не в модели (GPT-4 и Claude отвечают хорошо, если им дать правильный контекст), а в retrieval — в том, как мы ищем релевантные куски документов. Модель отвечает ровно настолько хорошо, насколько хорош контекст, который ей подсунули.

Рассмотрим три основные причины.

Разобрать RAG

Вам не нужен OpenClaw — напишите свой

Level of difficultyEasy
Reading time14 min
Reach and readers70K

Привет, Хабр! Меня зовут Никита Пастухов — автор FastStream, Principal Engineer и мейнтейнер AG2 (фреймворк для разработки агентов). Я уже 8 лет в разработке, последний год - по уши в агентах.

И я хочу доказать вам, что написать своего агента не сложнее, чем написать CRUD

Почему это вообще нужно доказывать? Потому что есть заметный разрыв между тем, что происходит с AI в мире, и тем, что происходит в среднестатистической российской компании. В мире — в каждой компании подписка на OpenAI, миллиард стартапов с AI-продуктами, агенты глубоко интегрированы в бэкофис. В России — «опасно, хостим свои модели», «непонятно» и чат-боты поддержки. В мире инженеры уже умеют разрабатывать агентов. В России — «что это вообще такое?»

Поэтому давайте разберём устройство агентов на примере OpenClaw — самого хайпового “личного AI-агента” прямо сейчас. Он живёт в вашем мессенджере, разбирает почту, ведёт соцсети, пишет код, деплоит сервисы. Его популярность — свидетельство того, насколько мало люди пока используют агентов в быту. Для тех, кто в теме, OpenClaw не привнёс ничего нового.

Давайте разбираться

Локальные LLM в реальной работе: Gemma 4, Qwen 3.6 и Qwen Coder

Level of difficultyEasy
Reading time17 min
Reach and readers82K

Привет, меня зовут Вячеслав. Я интересуюсь локальными LLM и тем, как они ведут себя в реальных задачах — не на синтетических бенчмарках, а когда нужно написать работающий код, отрефакторить файл с багами или вытащить данные из HTML.

Вокруг локальных моделей сложилась странная ситуация. С одной стороны, их постоянно принижают: если это не последняя версия Opus с максимальным режимом размышления, то и пробовать не стоит. С другой — мало кто действительно разбирается, что стоит за запуском локальной модели. Поднять API через llama.cpp — это полдела. А вот как ты её запускаешь, в какой среде, с какими параметрами — эти вещи порой переворачивают результат с ног на голову. Получить плохой результат с локальной моделью на удивление легко. Получить хороший — надо попотеть.

При этом локальные модели нужны. Особенно когда начинаются истории про чувствительные данные, закрытые контуры и ситуации, когда облачный API просто не вариант.

Я посмотрел множество тестов на YouTube — ни один меня не устроил. Общая канва одинаковая: берут модель побольше, запускают без оглядки на оптимальность и дают задание уровня «напиши сортировку пузырьком». Серьёзно?

Я не разработчик и не кодер по профессии, но решил пойти другим путём. Тесты с подковыркой, реальная агентская среда, подбор параметров. И модели я выбрал не «чем больше, тем лучше», а те, которые реально влезают в 16 ГБ видеопамяти домашней видеокарты. Что из этого вышло — дальше по тексту.

Читать далее

Claude Code — полный гайд и обучение для новичков с нуля

Level of difficultyEasy
Reading time40 min
Reach and readers284K

В этой статье ты получишь полный гайд по Claude Code.. В одной этой статье вся информация, которая тебе нужна.

Привет. Начнем с того, что компания Anthropic в последнее время обновляет продукты с совершенно безумной скоростью, настолько, что даже многие глубоко вовлечённые пользователи с трудом успевают следить. Практически каждый день выходят новые версии, а с января этого года крупные обновления стабильно выпускаются примерно раз в две недели.

Новые модели, новые инструменты, новые интеграции и даже целые новые категории продуктов появляются непрерывно. Стоит отвлечься или отдохнуть пару недель и вы, скорее всего, уже пропустили немало ключевых изменений. И да, Claude действительно меняет ваш способ работы, это не подлежит сомнению.

Все что было запущено на Claude по состоянию на 23 марта 2026 года, здесь будет охвачено: как настроить каждую функцию, в каких сценариях её использовать и какие лучшие практики реально работают. Понимание этих различий, это именно то, что отделяет «вау, прикольно» от «реально перестроил рабочий процесс».

Читать далее

Использование графов знаний при разработке RAG-систем

Level of difficultyMedium
Reading time8 min
Reach and readers14K

Привет, Habr! На связи Александр Сулейкин, Роман Бабенко и Даниил Бутнев. Подготовили совместную статью по теме использования графов знаний при разработке RAG-систем. В рамках статьи рассказываем про основные проблемы традиционных RAG-систем, даем обзор основных открытых проектов графов знаний GraphRAG, показываем и даем краткое описание архитектуры таких систем, а также рассказываем про практическое использование графов знаний на примере трех областей - медицины, метрологии и стандартизации.

Читать далее

Как общаться с базой знаний на естественном языке с помощью LLM и объективно оценить работу полученной системы

Level of difficultyEasy
Reading time11 min
Reach and readers11K

Привет, Хабр! Меня зовут Даниил, работаю в ML-отделе Doubletapp. В статье расскажу про особенности применения больших языковых моделей для оптимизации бизнес-процессов.

Большая языковая модель (LLM) — это тип языковой модели, который способен распознавать и генерировать осмысленные тексты, а также другие сложные типы данных (например, код). Такого рода модели обучаются на огромных массивах данных, чаще всего собранных из открытых источников.

Тем не менее LLM все еще имеют ряд проблем, одной из которых является галлюцинирование (придумывание фактов). Сложно винить модель за то, что она не знает, как устроен тот или иной процесс/продукт в вашей компании, и пытается придумать вразумительный ответ. Поэтому нужно подсказать LLM фактическую информацию, а она уже даст нам понятную человеку персонализированную реплику.

Такая система ответов на вопросы с использованием фактической информации называется RAG (Retrieval Augmented Generation).

Данная статья состоит из двух частей:

• мы рассмотрим построение RAG-системы на основе библиотеки langchain;

• объективно оценим работоспособность созданной системы, используя синтетические данные на русском языке с помощью фреймворка RAGAs.

Читать далее

Как сделать чат-бота лучше, нужен всего лишь простой советский… RAGAS

Reading time8 min
Reach and readers12K

В вводной части обзора мы познакомились с концепцией Retrieval Augmented Generation (RAG) и её расширением через методологию RAGAS (Retrieval Augmented Generation Automated Scoring). Мы разобрались, как RAGAS подходит к процессу оценки эффективности и точности RAG-систем.

В этой части мы более подробно рассмотрим техническую сторону RAGAS. Как обычно, начнем с более простых и интуитивно понятных примеров, потом перейдем к более сложным сценариям.

Читать далее

Руководство для начинающих по оценке конвейеров RAG с использованием RAGAS

Reading time7 min
Reach and readers4.1K

В постоянно развивающемся мире машинного обучения и искусственного интеллекта разработка приложений языковых моделей, в частности систем генерации дополненного извлечения (RAG), становится все более сложной. Однако настоящая проблема возникает не во время первоначального создания, а при постоянном обслуживании и улучшении этих приложений. Именно здесь в игру вступает RAGAS — оценочная библиотека, предназначенная для предоставления метрик для конвейеров RAG. В этой статье мы рассмотрим библиотеку RAGAS и научим вас использовать ее для оценки конвейеров RAG.

Читать далее

Список слов русского языка из Wiktionary и сравнение с pymorphy3 на примере Пушкина и Noize MC *

Level of difficultyEasy
Reading time10 min
Reach and readers9.6K

В задачах обработки естественного языка (NLP) часто требуется список слов русского языка. Такой список может использоваться как базовый фильтр для выявления неизвестных и потенциально некорректных слов.

Одним из распространённых инструментов для работы с русским текстом является библиотека pymorphy (pymorphy2 / pymorphy3), основанная на корпусе русского языка OpenCorpora. Она предназначена для морфологического анализа текстов и, в том числе, позволяет проверять, известно ли слово встроенному словарю библиотеки.

Однако словарь pymorphy ориентирован на нормативную лексику и морфологию. В нём отсутствует значительная часть имён собственных, топонимов, заимствований, разговорной и современной лексики. Поэтому при использовании pymorphy для фильтрации текста возникают ложные срабатывания, много редких и нестандартных слов определяются как неизвестные (что мы увидим ниже в разделе сравнения словарей).

Для повышения полноты выявления неизвестных слов я решил собрать свой максимально широкий список слов русского языка для задач NLP.

Такой список слов можно получить на основе данных сайта Wiktionary (Викисловарь). Wiktionary — это открытый многоязычный словарь, в котором каждая словарная единица представлена в виде отдельной статьи. Викисловарь содержит информацию о словах различных языков, включая русский, а также сведения об их морфологических и синтаксических свойствах.

* Признан минюстом РФ иностранным агентом.

Читать далее

Hybrid RAG для бизнеса: умный поиск по документам без облака и утечки данных

Level of difficultyMedium
Reading time5 min
Reach and readers8.1K

Крупная логистическая компания. Многолетний архив — договоры с перевозчиками, регламенты, переписка по инцидентам. Менеджер хочет узнать: были ли у нас претензии к этому контрагенту и на каких условиях мы с ним работали два года назад? Открывает почту, потом SharePoint, потом звонит в архив. Через час у него есть частичный ответ.

Та же ситуация повторяется в таможне, банках и юридических фирмах. Данные накоплены — в PDF, Word, сканах, таблицах. Но корпоративная база знаний не отвечает на вопросы: нет инструмента, который понимал бы смысл запроса, а не просто искал по ключевым словам. Автоматизация документооборота упёрлась в потолок классических СЭД.

Читать далее

Создание умных AI-агентов: полный курс по LangGraph от А до Я. Часть 2. Диалоговые агенты: память, сообщения и контекст

Reading time48 min
Reach and readers58K

Во второй части курса по созданию ИИ-агентов превращаем безжизненные схемы в настоящих цифровых собеседников: подключаем нейросети к LangGraph, учим их запоминать контекст на сотни сообщений и гарантированно получать валидный JSON вместо творческой "болтовни".

Создаем умные системы, которые сами определяют тип сообщения — отзыв это или вопрос — и автоматически направляют в нужную ветку обработки.

Покажу, как объединить несколько нейросетей в одном графе, где каждая модель работает там, где сильнее всего. От простых диалогов до мультимодельных архитектур с интеллектуальной маршрутизацией.

Читать далее

Создаем свой RAG: введение в LangGraph

Level of difficultyMedium
Reading time7 min
Reach and readers16K

Привет, Хабр! В этой статье мы рассмотрим LangGraph — инструмент для построения сложных RAG-систем. Разберём его ключевые концепции и архитектурные принципы. В следующей части перейдём к практической реализации: изучим компоненты RAG-систем и способы их интеграции
Читать далее

ruMTEB: новый бенчмарк для русскоязычных эмбеддеров

Level of difficultyMedium
Reading time11 min
Reach and readers19K

Салют, Хабр! На связи команды AGI NLP и нейронных сетей Виртуального ассистента Салют. В SberDevices наши команды занимаются созданием бенчмарков, а также обучением моделей для векторных представлений текстов или эмбеддеров. В этой статье расскажем про наш новый русскоязычный бенчмарк для эмбеддеров текста — ruMTEB.

Читать далее

Прокачиваем RAG: тестируем техники и считаем их эффективность. Часть 1

Level of difficultyEasy
Reading time15 min
Reach and readers25K

При про­ектировании RAG-системы инженер каждый раз сталкивается со множеством вопросов: какую базу данных использовать, как организовать получение релевантной информации, да даже выбор эмбеддера может занять приличное время, а это лишь вершина айсберга. Что хорошо работает в одной сфере, например в техподдержке, может полностью провалиться в другой — например, при анализе юридических документов. Поэтому задачей инженера является выявление особенностей предметной области и адаптации RAG системы к ним. Однако, чтобы это сделать, необходимо не только понимать, какие приёмы можно использовать, но и знать насколько они эффективны.

В данной статье мы разберём основные RAG техники, посмотрим их сильные и слабые стороны, сферы применения, а также немного поэкспериментируем. В следующей части статьи мы проведём тестирование этих техник на реальных пользовательских запросах из датасета Natural Questions и оценим качество работы с помощью RAGAS и BertScore, посмотрим на графики и разойдёмся, чтобы обдумать всё написанное. Поэтому предлагаю начать!

Читать далее

Chonkie: революция в RAG-чанкинге — скорость, лёгкость, удобство

Level of difficultyEasy
Reading time11 min
Reach and readers17K

В эпоху, когда большие языковые модели (LLM) становятся всё более мощными и применяются во многих задачах, одна из ключевых проблем остаётся прежней — как эффективно снабжать их релевантным контекстом. Одним из популярных решений является подход RAG, где качество итогового ответа зависит от целого ряда факторов, одним из которых является качественное чанкирование исходных текстов. Сегодня мы рассмотрим одно из новых и интересных решений.

Всем привет! Меня зовут Вадим, я Data Scientist в компании Raft. В этой статье я расскажу о Chonkie — библиотеке для простого и быстрого чанкирования документов, а также на практике применю её и сравню с другими популярными решениями: LangChain и LlamaIndex.

Читать далее

Семантический поиск: от простого сходства Жаккара к сложному SBERT

Reading time9 min
Reach and readers43K

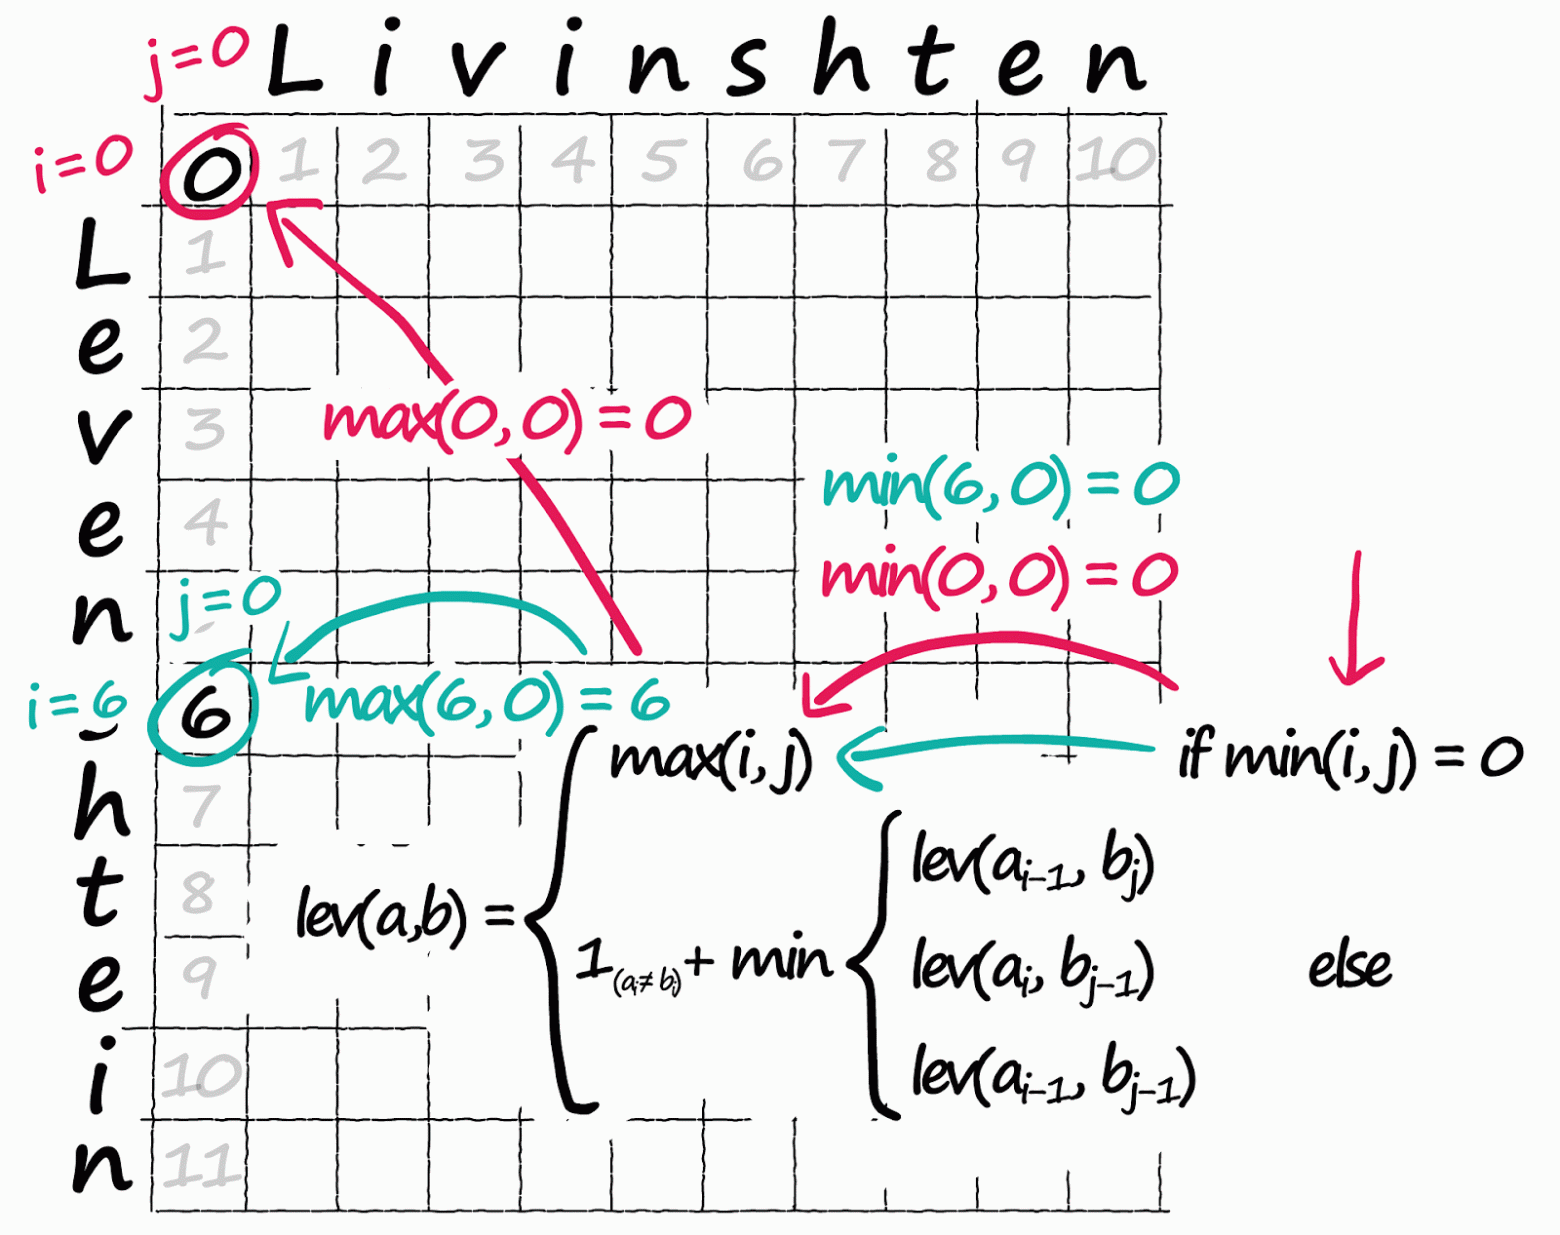
В материале, переводом которого мы решили поделиться к старту курса о машинном и глубоком обучении, простым языком рассказывается о семантическом поиске, статья охватывает шесть его методов; начиная с простых сходства по Жаккару, алгоритма шинглов и расстояния Левенштейна, автор переходит к поиску с разреженными векторами — TF-IDF и BM25 и заканчивает современными представлениями плотных векторов и Sentence-BERT. Простые примеры сопровождаются кодом и иллюстрациями, а в конце вы найдёте ссылки на соответствующие блокноты Jupyter.

Читать далее

Нейросетевой синтез речи своими руками

Reading time12 min
Reach and readers106K
Синтез речи на сегодняшний день применяется в самых разных областях. Это и голосовые ассистенты, и IVR-системы, и умные дома, и еще много чего. Сама по себе задача, на мой вкус, очень наглядная и понятная: написанный текст должен произноситься так, как это бы сделал человек.

Некоторое время назад в область синтеза речи, как и во многие другие области, пришло машинное обучение. Выяснилось, что целый ряд компонентов всей системы можно заменить на нейронные сети, что позволит не просто приблизиться по качеству к существующим алгоритмам, а даже значительно их превзойти.


Я решил попробовать сделать полностью нейросетевой синтез своими руками, а заодно и поделиться с сообществом своим опытом. Что из этого получилось, можно узнать, заглянув под кат.

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Registered
Activity