Обновить
32K+

Apache *

Свободный веб-сервер

4,07
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

The history of Kubernetes

Уровень сложностиСложный
Время на прочтение9 мин
Охват и читатели8.9K

В современной ИТ-инфраструктуре невозможно переоценить роль Kubernetes — платформы с открытым исходным кодом для оркестрации контейнеров, которая автоматизирует развертывание, управление и масштабирование контейнеризированных программных приложений и сервисов. Согласно отчету организации Cloud Native Computing Foundation (CNCF), Kubernetes является вторым по величине проектом с открытым исходным кодом в мире (уступая лишь Linux®) и основным инструментом оркестрации контейнеров для 71% компаний из списка Fortune 100. Чтобы понять, как Kubernetes удалось занять доминирующее положение на рынке облачных вычислений и микросервисов, необходимо обратиться к истории его создания.

Эволюция Kubernetes

Читать далее

Установка Apache Superset в Docker (Windows + WSL2): пошагово, с разбором типичных ошибок

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели6.1K

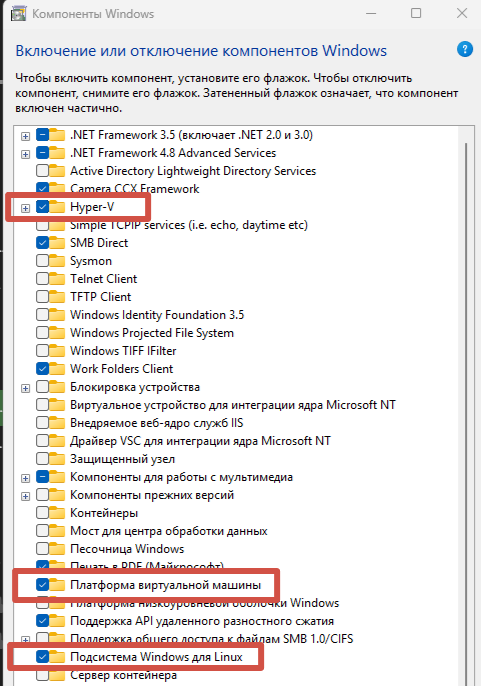
TL;DR: ставим WSL2 и Docker Desktop, клонируем Superset, генерируем SECRET_KEY, поднимаем стек через docker compose и не наступаем на грабли с down -v, неприменяемым конфигом и занятым портом 8088.

Apache Superset — открытая BI-платформа от Apache: дашборды, SQL Lab, десятки коннекторов к базам. Если вы под Windows и не хотите портить систему пачкой зависимостей Python — самый спокойный путь это WSL2 + Docker. Ниже — рабочий рецепт от первого включения виртуализации до открытого в браузере логина, плюс ошибки, на которые я наткнулся сам.

Читать далее

1040 Too many connections: как один JavaScript-цикл положил прод и почему Laravel-приложение не могло восстановиться

Уровень сложностиСредний
Время на прочтение17 мин
Охват и читатели4.8K

В середине обычного рабочего дня B2B-приложение, с которым работают наши партнёры, перестало обслуживать запросы. MariaDB исчерпала лимит подключений, пользователи получали HTTP 500, а за четыре минуты в журнал приложения упало около 20 тысяч ошибок.

Сначала всё выглядело как типичная проблема производительности базы. Расследование показало другое: толчком стал зациклившийся JavaScript в одной вкладке браузера. Но этот всплеск объясняет только начало аварии. Четыре минуты простоя обеспечило само приложение: обработчик ошибок записывал ошибки в уже недоступную базу, страница ошибки снова обращалась к той же базе, а Auth::check() при каждой неудаче пытался подключиться заново.

Ниже - как мы восстанавливали картину по логам Apache, Laravel и счётчикам MariaDB, какие версии не подтвердились, где мы сами ошибались по ходу анализа и что в итоге поменяли.

Читать далее

CyberOffice.pro 4.1.17 — корректирующий выпуск

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели5.8K

В статье краткое описание и ссылка на корректирующий выпуск CyberOffice.pro 4.1.17.

CyberOffice.pro – лёгкий офисный пакет для ценящих стабильность, интероперабельность и совместимость при работе со сложными документами; для практикующих цифровую гигиену без фанатизма.

Читать далее

Единое окно инженера данных: как мы построили веб-среду разработки для 12 000 потоков данных

Время на прочтение5 мин
Охват и читатели5.3K

Привет, Хабр! Меня зовут Никита Калганов, я ведущий системный инженер данных в X5 Tech. Мы с командой проектируем и развиваем высоконагруженную систему потоков данных и поддерживаем её в условиях постоянного роста, как по числу потоков, так и по количеству команд, которые с ней работают.

В нашей системе обработки данных живёт больше двенадцати тысяч потоков данных, и их число растёт в среднем на несколько десятков в день. Всё нормально работает, но мы решили сделать её ещё лучше. В этой статье расскажу, как мы построили единое окно инженера данных, сделали собственный DDL-мигратор с поддержкой зависимостей и при этом сохранили то, что уже работает.

Читать далее

Beget лежит четвёртый день, теперь упал и AdminVPS. Хостинги Рунета штормит. Панель управления AdminVPS отдаёт 502 Bad...

Охват и читатели9.8K

Beget лежит четвёртый день, теперь упал и AdminVPS. Хостинги Рунета штормит. Панель управления AdminVPS отдаёт 502 Bad Gateway. Личный кабинет недоступен, доступа к серверам нет. У меня копии сайтов лежат в двух местах, одно из которых хостер не контролирует вообще.

А у вас как? Кто пострадал от сбоев и куда переносите проекты?

Читать дальше →

Потерянные ключи шифрования, или изучение атомарности в Cassandra

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели5.9K

Привет, Хабр! На связи системный аналитик Илья Глазунов и разработчик Кирилл Дунаев. Мы работаем с платформой аналитического карточного хранилища Т-Банка. Попутно открываем все новые грани одного из главных компонентов нашего детища — Apache Cassandra. 

Мы уже изучили тонну материалов, сами стали носителями знаний, делимся ими в команде и на Хабре. Но не перестаем натыкаться на интересные механики и особенности Cassandra, которые приходится разбирать по принципу «с миру по нитке». 

Та механика, о которой пойдет речь, могла проявиться только в системе со специфическим дизайном, предназначенной для очень конкретных задач, при значительной нагрузке на запись и высоком коэффициенте параллельности.

В статье разберем, почему утверждение «Cassandra — колоночная БД» частично верное. Приоткроем занавес, как база данных работает с мета-данными и объединением неизменяемых файлов при высокой пишущей нагрузке. А еще подискутируем на тему понятия атомарности операций во вселенной Apache Cassandra и разберемся, причем же тут UDT и frozen UDT. 

Читать далее

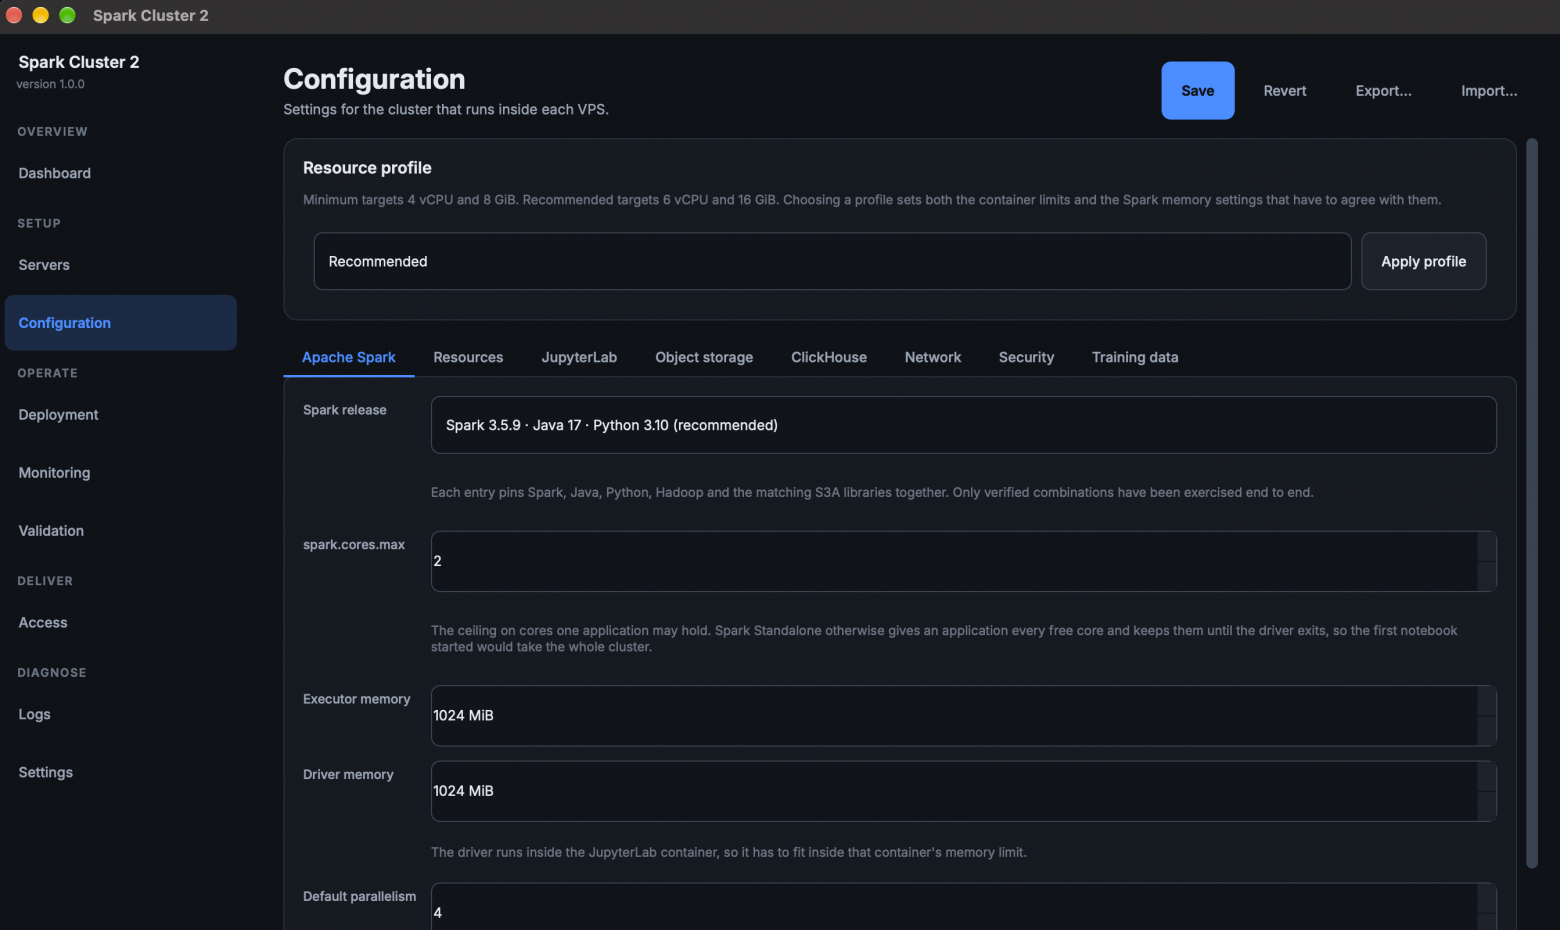
Spark Cluster 2: как я создал приложение для автоматического развёртывания Apache Spark

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели5.6K

Привет, Хабр!

В процессе преподавания дисциплин, связанных с анализом больших данных и распределёнными вычислениями, я регулярно сталкиваюсь с необходимостью организовывать практическую работу студентов с Apache Spark. На первый взгляд задача достаточно простая: подготовить серверы, установить необходимые компоненты, настроить взаимодействие между ними и предоставить студентам доступ к работающему кластеру.

Но когда речь идёт не об одном стенде, а о целой учебной группе, подготовка инфраструктуры превращается в отдельную задачу. Особенно если каждому студенту необходимо предоставить собственный кластер для выполнения лабораторных работ. Некоторое время назад я решил автоматизировать этот процесс и разработал небольшое настольное приложение для развёртывания Apache Spark на виртуальных серверах.

Читать далее

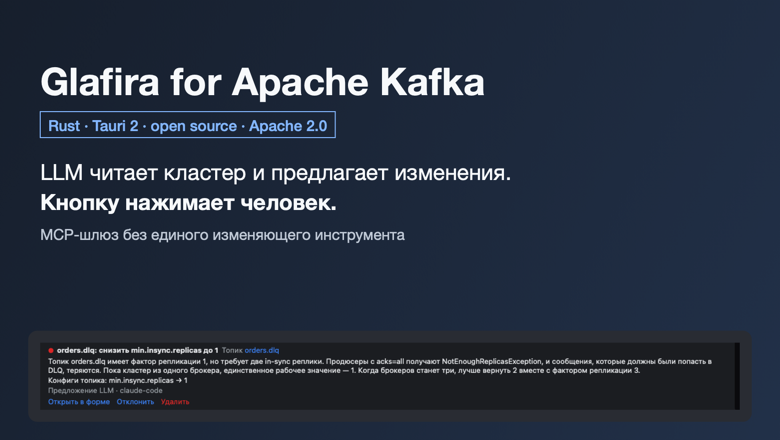
Glafira for Apache Kafka: открытый desktop-клиент на Rust, который даёт LLM читать кластер, но не трогать его

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели10K

Glafira for Apache Kafka — бесплатный desktop-клиент для Kafka под macOS, Windows и Linux: Tauri 2, Rust, librdkafka, код открыт под Apache 2.0. Просмотр сообщений с фильтрами и JSONPath, Producer с шаблонами, consumer-сессии, топики, группы, сброс оффсетов и встроенная проверка кластера.

Самое интересное — MCP-шлюз для LLM. Claude, GigaCode, Cursor или любой другой клиент с поддержкой MCP подключается к Glafira, читает метаданные кластера, находит проблемы, оставляет замечания и предлагает изменения. Применить что-либо модель не может: у неё физически нет ни одного изменяющего инструмента, а предложение открывается заполненной формой, где кнопку нажимает человек. В статье — как это устроено, почему это гарантия, а не обещание, и два настоящих диалога с Claude Code.

Читать далее

Возможности сводных таблиц в Superset

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели5.2K

С версии Superset 6.0 в метрики сводных таблиц можно подставлять произвольный HTML. Это открывает возможности, которые раньше казались недоступными — например, карточки KPI прямо в ячейках Pivot Table.

Я уже описывала различные фишки, которые можно реализовывать в сводных таблицах: здесь, здесь и здесь.

В данной статье продолжу раскрывать потенциал сводных таблиц.

Читать далее

Дельты, Jinja и HTML в сводных таблицах SuperSet

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели6.6K

В шестой версии SuperSet появилась возможность прописывать HTML код в метриках  и измерениях сводных таблиц, что значительно расширило  приемы для BI-разработчиков по форматированию  таблиц.  Покажу как в SuperSet можно реализовать сводную таблицу со сменой периодов и выводом красивой дельты.

Читать далее

Компактация лога в Apache Kafka повреждала данные. Вот как мы это исправили

Время на прочтение11 мин
Охват и читатели7.9K

Компактация лога в Kafka может привести к ситуации, когда разные реплики одного топика начинают хранить разную версию данных — и расхождение сохраняется даже после восстановления брокера. Проблема возникает из-за гонки между компактацией и репликацией и затрагивает Kafka 3.9–4.2. Разбираемся, как воспроизвести баг и почему координированная компактация решает проблему.

Изучить решение

Ближайшие события

Подытоги и итоги сводных таблиц в Apache Superset: многоуровневая агрегация на ClickHouse (часть 2)

Время на прочтение4 мин
Охват и читатели5.7K

В  первой статье были разобраны причины поиска решения  по выводу корректных  подытогов и итогов в сводных таблицах SuperSet, а также подробный разбор первого способа решения с помощью UNION. В данной статья я разберу второй способ, который мне больше нравится, – это использование массивов.  

Читать далее

Подытоги и итоги сводных таблиц в Apache SuperSet: многоуровневая агрегация на ClickHouse (часть 1)

Время на прочтение6 мин
Охват и читатели4.4K

Superset умеет строить сводные таблицы,  но при выводе подытогов и итогов (subtotals/total)  в сводных таблицах с иерархически структурированной метрикой сталкиваешься с ограничением: из коробки можно строить только простые метрики. А если нужна процентная метрика с корректными подытогами и итогами — приходится искать обходные решения.

 В этой статье разберём, как обойти это ограничение на уровне обращения к БД (ClickHouse).

Я  нашла два подхода: UNION и массивы. И начну с первого, детально разобрав именно через UNION.

Читать далее

Со Spark на Apache Doris: как Kwai ускорила расчёт метрик A/B-экспериментов в 145 раз

Уровень сложностиСредний
Время на прочтение16 мин
Охват и читатели5.8K

Kwai перенесла расчёт метрик A/B-экспериментов со Spark на Apache Doris: до 145 раз быстрее при снижении потребления ресурсов на 72%. В переводе разбираем, как команда переработала размещение данных, Local Distinct, UDF, планирование и метаданные FE на кластере из 2000 BE-узлов. С примечаниями о границах сравнения и доступности оптимизаций в открытом Doris.

Читать далее

Интеграция Apache NiFi с корпоративной системой управления секретами

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели8.8K

Привет, Хабр. Я Игорь Юрченко, backend-разработчик Сбера. В предыдущей статье я описал автоматизацию развёртывания потоков NiFi, а сейчас расскажу о дальнейшем развитии этого подхода для интеграции с корпоративной системой управления секретами — SecMan. Буду использовать терминологию предыдущей статьи.

Читать далее

Очередь без серверов и головной боли: как устроен Serverless Queue в MWS Cloud Platform

Уровень сложностиСредний
Время на прочтение18 мин
Охват и читатели11K

Если вы хоть раз эксплуатировали Kafka, то знаете, сколько нервных клеток способен съесть её кластер. Поднять Kafka для PoC несложно, а вот дальше начинается планирование ёмкости, диски, replication factor, перераспределение партиций и восстановление после отказа брокера. 

В MWS Cloud Platform мы решили, что так дальше жить нельзя, и запустили Serverless Queue — бессерверный Kafka-совместимый брокер. Читайте статью, чтобы узнать, как с его помощью быстро и просто можно запустить сценарии обработки сообщений по Kafka-протоколу.

Читать далее

Delta Lake 4.3: Выборочная замена данных и API‑интерфейсы каталога Unity Delta

Уровень сложностиСложный
Время на прочтение10 мин
Охват и читатели9.7K

Методы replaceUsing и replaceOn обеспечивают более удобный способ перезаписи, а каталог теперь проверяет каждую операцию, а не только фиксацию.

Выпуск Delta Lake 4.3 состоялся в июне 2026 года, и он основан на Apache Spark 4.1.0 и 4.0.1. Если прочитать примечания к выпуску от начала до конца, вы увидите длинный список изменений, охватывающих Delta Spark, ядро, UniForm, Sharing и Flink, который легко принять за релиз с исправлениями, дополненный описанием каталога обновлений.

Два момента заслуживают вашего внимания, и они находятся на противоположных концах стека. Первый — небольшой и сразу полезный: replaceUsingнаконец replaceOn-то API DataFrame получает возможность выборочной перезаписи, которая не является replaceWhere. Второй — структурный: теперь каждая операция с таблицей, управляемой каталогом, проходит через API Unity Catalog Delta , а не только фиксация изменений. В Delta 4.2 фиксации изменений были скоординированы с каталогом. В Delta 4.3 остальная часть интерфейса, загрузка таблиц, CREATE, CTAS, REPLACE, и запись метаданных, объединены в один проверенный путь.

В этой статье рассматривается версия 4.3 с точки зрения разработчика конвейера: какие изменения в коде вы вносите, какие изменения происходят под вашим контролем и что следует проверить перед обновлением. Приводятся примеры testing.defaultдля каталога и схемы, а также пример компании CH Enterprise. Ссылки на исходный код находятся внизу.

Читать далее

Обработка сделок в реальном времени: как мы переехали с batch-обработки на Kafka Streams

Время на прочтение6 мин
Охват и читатели9.3K

Привет, Хабр! Я Артём Борисов, Java-разработчик, в основном занимаюсь развитием микросервисов в команде РСХБ «Свои инвестиции». Представьте ситуацию: вы работаете с инвестиционными сделками, обрабатываете миллионы сделок в день, но все они обрабатываются один раз только ночью. А бизнес требует реального времени. Это была наша рутина, пока мы не внедрили Kafka Streams. В этой статье я расскажу о том, как мы трансформировали систему обработки сделок на фондовом рынке (SOFR) с batch-обработки на полноценную real-time систему, способную обрабатывать миллионы сделок в сутки.

Читать далее
1
23 ...