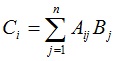Обновить
8K+

Параллельное программирование *

Распараллеливаем вычисления

6,08
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Пример оптимизации вычислений на CUDA

Время на прочтение5 мин
Охват и читатели23K

Введение


Я описываю результаты применения способов оптимизации вычислений на CUDA при моделировании плазмы. Вычисления производятся с использованием Java-привязки к CUDA (JCUDA) [1] на GT630 (Kepler). Моделирование происходит как решение задачи Коши — задание значений параметров в начальный момент времени, затем приращение времени и перерасчет всех уравнений, и т.д. многократно. Вычисления происходят в двойной точности (double). Правильность полученных результатов подтверждена вычислениями на CPU без JCUDA.
Читать дальше →

Будущее программирования аппаратных ускорителей

Время на прочтение10 мин
Охват и читатели20K
Многие из новейших суперкомпьютеров основаны на аппаратных ускорителях вычислений (accelerator). включая две самые быстрые системы согласно TOP500 от 11/2013. Ускорители распространяются так же и на обычных PC и даже появляются в портативных устройствах, что ещё больше способствовует росту интереса к программированию ускорителей.

Такое широкое применение ускорителей является результатом их высокой производительности, энергоэффективности и низкой стоимости. Например, если сравнить Xeon E5-2687W и GTX 680, выпущенные в марте 2012, мы увидим, что GTX 680 в четыре раза дешевле, имеет в 8 раз большую производительность операций одинарной точности и в 4 раза большую пропускную способность памяти, а так же обеспечивает более 30 раз большую производительность в пересчёте на доллар и в 6 раз большую производительность на ватт. Исходя из таких сравнительных результатов, ускорители должны бы использоваться везде и всегда. Почему же этого не происходит?
Читать дальше →

Вышел Rust 0.9

Время на прочтение2 мин
Охват и читатели19K

Mozilla выпустила новую версию компилятора Rust 0.9 и соответствующих инструментов.

Rust — это компилируемый и мультипарадигмальный язык для системного программирования, который позиционируется как альтернатива С/С++. Визуально он похож на C, но отличается в деталях синтаксиса и семантики. Идеально подходит для параллельных вычислений.

Разработчики говорят о существенном улучшении рантайма и подсистемы ввода-вывода. Так, в компиляторе появились статические ссылки и поддерживается оптимизация во время линковки (link-time). В языке уменьшено количество разных видов замыканий, чтобы упростить и сделать более логичным синтаксис.
Читать дальше →

Введение в параллельные вычисления в R

Время на прочтение5 мин
Охват и читатели17K
   Эта статья посвящена языку R. Он не так широко распространен на территории ex-USSR, как Matlab и тем более Python, но, безусловно, заслуживает внимания. Нельзя не отметить, что R — фактически стандарт для Data Science (хотя тут хорошо написано, что не R единым живут data scientists). Богатый синтаксис, совместимость с legacy кодом (что весьма важно в научных приложениях), удобная среда разработки RStudio и наличие огромного числа библиотек в CRAN делают R таковым.
Читать дальше →

«Задачка-то сошлась с ответом!»

Время на прочтение4 мин
Охват и читатели34K


Я очень часто по работе слышу вопрос, задаваемый из, большей частью, академической среды, ввиду огромного количества выполняемых вычислений именно там: «Почему наши результаты разные от запуска к запуску одного и того же приложения? Мы же ничего не меняем в нем». Стоит отметить, разговор про это уже был, но лишь частично отвечающий на вопрос. Попробую рассказать про эту проблему ещё чуть-чуть.
Читать дальше →

Модели акторов 40 лет

Время на прочтение9 мин
Охват и читатели23K
Высоконагруженные системы, построенные по модели акторов – это тренд сегодняшнего времени. Вот далеко неполный перечень статей на хабре, в которых, в той или иной степени, упоминается данная модель или одна из ее реализаций, например,1, 2, 3, 3, 4, 5, 6, 7. Есть хорошая статья в википедии, рассказывающая про акторы. К сожалению, после ее прочтения, у меня осталось много вопросов, ответы на которые я смог найти только в первоисточниках. Результаты этого обзора я и хочу представить Вашему вниманию.
Читать дальше →

Разработчик на распутье: как векторизовать?!

Время на прочтение5 мин
Охват и читатели18K

На тему векторизации написано немало интересного. Вот скажем, отличный пост, который много полезного объясняет по работе автовекторизации, очень рекомендовал бы его к прочтению. Мне интересен другой вопрос. Сейчас в руках у разработчиков большое количество способов, чтобы создать «векторный» код – от чистого ассемблера до того же автовекторизатора. На каком же способе остановиться? Как найти баланс между необходимым и достаточным? Об этом и поговорим.
Читать дальше →

Поговорим про Intel® Cilk™ Plus

Время на прочтение4 мин
Охват и читатели14K
Мой недавний пост про OpenMP 4.0 натолкнул меня на мысль, что было бы неплохо написать и про Intel Cilk Plus, потому что модель программирования весьма интересная и уж точно заслуживает отдельного внимания. Ну и раз её часть стала фактически новым стандартом OpenMP, то, вероятно, были на то веские причины.
Читать дальше →

Мультипроцессовый Firefox

Время на прочтение3 мин
Охват и читатели44K
C января этого года Билл Макклоски вместе с Дэвидом Андерсоном работали над тем, чтобы сделать «Файерфокс» мультипроцессовым, в этом им помогали Том Шустер (evilpie), Фелипе Гомез и Марк Хаммонд. И теперь настал момент, когда они хотели бы узнать мнение сообщества о проделанной работе.

В «Файерфоксе» всегда использовалась однопроцессовая модель построения. Интерес к изменениям в области распараллеливания подстегнул выход браузера «Хром», в нём использовались один процесс для интерфейса и отдельные процессы для работы с контентом веб-страниц. (Тем не менее за шесть месяцев до «Хрома» несколько процессов начал использовать «Интернет эксплорер 8».) Вскоре, примеру «Хрома» последовали и некоторые другие браузеры, «Мозилла» начала проект Electrolysis для адаптации движка «Гекко» к использованию нескольких процессов.

Что вынуждает «Мозиллу» переключаться на подобную модель построения своего браузера? В первую очередь это производительность и отзывчивость. Основной целью является уменьшение подвисания (jank), проявляющегося при стандартных операциях — загрузке особенно крупной страницы, наборе текста в веб-форме или прокрутке перегруженной элементами страницы.
Читать дальше →

Обработка событий в реальном масштабе времени с помощью SynapseGrid

Время на прочтение15 мин
Охват и читатели4.5K
Занимались мы как-то обработкой аудио на Java с помощью сложных алгоритмов. Каждый кусочек аудио должен был пройти длинную цепочку обработки (20-50 алгоритмов разной степени сложности). Потоки аудио поступали параллельно, алгоритмы работали параллельно, и завершались в разные моменты. Некоторые алгоритмы нуждались в разной степени буферизации. Из кусочков аудио извлекалась информация повышающегося уровня абстракции, то есть начиная с какого-то уровня уже шло не аудио, а извлечённая информация об этом аудио.

Всё хозяйство должно было работать в рамках одного экземпляра приложения, но при этом должно было быть несколько вложенных почти независимых очень похожих контейнеров для клиентского кода (типа Bean'ов).

С самого начала мы не ставили задачу всеобщей унификации, и решали в каждой части системы по своему. Где-то использовали потоки для длительных задач, где-то создавали цепочки вызовов, где-то — модель подписки. Так как система была довольно большой, то практически все известные способы декомпозиции и обработки были задействованы в той или иной степени. Потом мы обнаруживали общность и реализовывали похожие решения в разных частях системы. А потом изобрели первую версию того, что сейчас мы называем система контактов или SynapseGrid.
Как мы изобрели систему контактов SynapseGrid

Оптимизация приложений под Android x86: проверенные способы

Время на прочтение7 мин
Охват и читатели18K

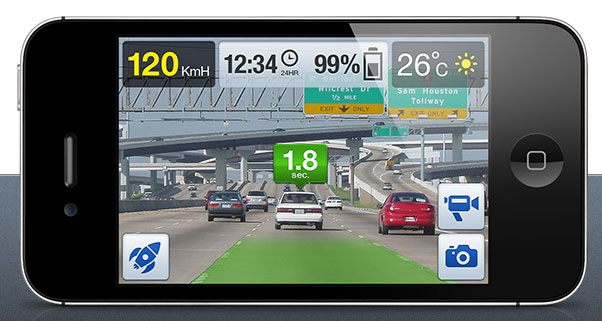
Любое приложение для Android, даже написанное только на скриптовых и ненативных языках (таких как Java или HTML5), в конечном счёте использует базисные компоненты среды исполнения, которые должны быть оптимизированы. Хорошими примерами для иллюстрации оптимизационных подходов и потребностей являются приложения, использующие технологии мультимедиа и дополненной реальности, описанные ниже. Для платформы Android (смартфоны и планшеты) Intel использует различные виды процессоров Atom, имеющих SSSE3 уровень векторизации и обычно 2 ядра с гипертредингом – считайте это намеком :) Для тех, кто намек понял, под катом – история оптимизации и распараллеливания одного конкретного приложения израильской компании iOnRoad — iOnRoad.
Читать дальше →

Ждали, ждали и дождались! OpenMP 4.0

Время на прочтение5 мин
Охват и читатели23K


Каждая новая спецификация OpenMP вводит очень полезные и необходимые дополнения к уже существующему функционалу. Например, в версии 3.0 были добавлены так ожидаемые задачи (tasks), позволившие решать ещё больший спектр задач по распараллеливанию приложений. В 3.1 целый ряд улучшений по работе с задачами и редукциями.

Но по сравнению с тем, что нам теперь даёт стандарт 4.0, предыдущие нововведения кажутся какими-то мелкими. Последняя версия расширила типы поддерживаемого параллелизма, чего раньше никогда не замечалось.
Поясню, что я хочу сказать.

Microsoft Robotics. Параллельная обработка данных

Время на прочтение7 мин
Охват и читатели7.2K
Один из продуктов Microsoft — Microsoft Robotics включает библиотеку Concurrent and Coordination Runtime. Библиотека очень нужна роботам для организации параллельных вычислений при обработке звука и изображений (да и не только их). В посте я расскажу как с помощью данной библиотеки создать параллельный алгоритм умножения матрицы A (m × n элементов) на вектор B (1 × n элементов) по следующей формуле: . Алгоритм вычисления вектора C (m × 1 элементов) легко распараллеливается, так как значение i-го элемента вектора не зависит от значений других его элементов. Перед запуском примера из исходников рекомендуется установить Microsoft Robotics.
Подробности

Ближайшие события

Профилировка производительности OpenMP приложений

Время на прочтение7 мин
Охват и читатели7.3K


OpenMP – пожалуй, самая распространённая модель параллельного программирования на потоках, на системах с общей памятью. Ценят её за высокоуровневые параллельные конструкции (в сравнении с программированием системных потоков) и поддержку разными производителями компиляторов. Но этот пост не про сам стандарт OpenMP, про него есть много материалов в сети.

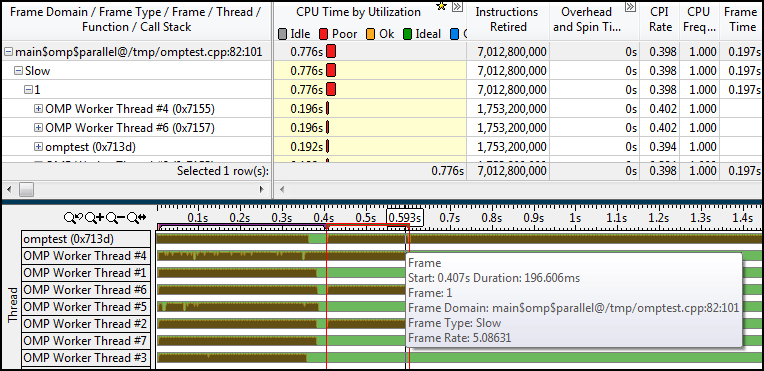
Распараллеливают вычисления на OpenMP ради производительности, о чём, собственно, и статья. Точнее, об измерении производительности с помощью Intel VTune Amplifier XE. А именно, как получить информацию о:
  • Получении профиля всего OpenMP приложения
  • Профиле отдельных параллельных регионов OpenMP (время CPU, горячие функции и т.д.)
  • Балансе работы внутри отдельного параллельного региона OpenMP
  • Балансе параллельного/последовательного кода
  • Уровне гранулярности параллельных задач
  • Объектах синхронизации, времени ожидания и передачах управления между потоками
Узнать больше о профилировке OpenMP

Как мы ускорили поиск на hh.ru

Время на прочтение5 мин
Охват и читатели16K
image
Некоторое время назад наш поиск стал работать быстрее. Особенно это заметно на сложных для движка запросах, в которых используется минимум фильтров и высокочастотные слова, что требует построить фасеты по результатам и отсортировать максимальные объёмы документов. Но и запросы средней сложности, где в выдаче немного документов, стали обрабатываться заметно быстрее. Почему возникла необходимость что-то ускорять и как мы это делали?
Читать дальше →

Resumable функции

Время на прочтение11 мин
Охват и читатели26K
На прошлой неделе в мире С++ произошло интересное событие. Компания Microsoft объявила о выходе обновления к компилятору С++ в Visual Studio 2013. Само по себе обновление компилятора отдельно от Visual Studio или её сервис-пака — уже нетривиальное для Microsoft событие. Но ещё интереснее то, что вошло в это обновление. Полный список можно почитать по ссылке выше, а я остановлюсь только на одном моменте — resumable функции. Для полного понимания ситуации: Microsoft изрядно протроллила и комитет по стандартизации С++ и разработчиков gcc\clang, выпустив (тут надо внимательно) реализацию экспериментальной и не утверждённой ещё возможности будущего стандарта C++17, основанной на экспериментальных и не утверждённых ещё возможностях будущего стандарта C++14, которые в свою очередь являются исправлениями не сильно ещё вошедших в повседневное программирование возможностей С++11.

Достаточно гиковский ход, не находите?

А ниже будет перевод статьи с meetingcpp.com, рассказывающей о том, что это за фича и как её использовать.
Читать дальше →

Конференция PACT (Parallel Architectures and Compilation Techniques) 2013. Отчет о посещении

Время на прочтение6 мин
Охват и читатели2.8K

С 7 по 11 сентября в Эдинбурге, Шотландия проходила 22-я международная конференция по параллельным архитектурам и методам компиляции (PACT). Конференция состояла из двух частей: Workshops/Tutorials и основной части. Мне удалось посетить основную часть, о которой хотелось бы рассказать.

Конференция PACT является одной из крупных и значимых в своей области. Список тем конференции весьма обширен:

  • Параллельные архитектуры и вычислительные модели
  • Инструментарий (компиляторы и прочее) для параллельных компьютерных систем
  • Архитектуры: многоядерные, многопоточные, суперскалярные и VLIW
  • Языки и алгоритмы для параллельного программирования
  • И прочее, прочее, прочее, что связано с параллелизмом в software и в hardware

Читать дальше →

Squeak: Моделирование систем массового обслуживания

Время на прочтение4 мин
Охват и читатели19K
На Хабре крайне мало информации о таком языке программирования как Squeak. Я попытаюсь рассказать о нем в контексте моделирования систем массового обслуживания. Покажу как написать простой класс, расскажу его структуру и использую его в программе, которая будет обслуживать заявки посредством нескольких каналов.

Пару слов о Squeak


Squeak это открытая, кросс-платформенная реализация языка программирования Smalltalk-80 c динамической типизацией и сборщиком мусора. Интерфейс довольно специфический, но вполне удобный для отладки и анализа. Squeak полностью отвечает концепции ООП. Все состоит из объектов, даже конструкции if-then-else, for, while реализованы с их помощью. Весь синтаксис сводится к посылке объекту сообщения в виде:
<объект> <сообщение>
Любой метод всегда возвращает объект и ему можно направить новое сообщение.
Squeak часто используется для моделирования процессов, но может использоваться и как средство для создания мультимедийных приложений и разнообразных образовательных платформ.
Читать дальше

Эдвард руки — С++

Время на прочтение10 мин
Охват и читатели55K
Я искал, с чем бы сравнить программирование на С++ и я вспомнил фильм 1990 года режиссера Тима Бертона — «Эдвард руки-ножницы»
Читать далее

Нагружаем Node под завязку (2-я из 12 статей о Node.js от команды Mozilla Identity)

Время на прочтение7 мин
Охват и читатели19K
От переводчика: Это вторая статья из цикла о Node.js от команды Mozilla Identity, которая занимается проектом Persona. Эта статья написана по мотивам выступления Ллойда Хилайеля на конференции Node Philly 2012 в Филадельфии.


Процесс Node.js выполняется на единственном ядре процессора, так что построение масштабируемого сервера на Node требует особой заботы. Благодаря возможности писать нативные расширения и продуманному набору API для управления процессами, есть несколько разных способов заставить Node выполнять код параллельно. Мы рассмотрим их в этой статье.

Кроме того, мы представим модуль compute-cluster — маленькую библиотеку, которая облегчает управление коллекцией процессов для выполнения распределённых вычислений.

Постановка задачи


Для Persona нам было необходимо создать сервер, который справился бы с обработкой множества запросов со смешанными характеристиками. Мы выбрали для этой цели Node.js. Нам надо было обрабатывать два основных типа запросов: «интерактивные», которые не требовали сложных вычислений и должны были выполняться быстро, чтобы интерфейс приложения был отзывчивым, и «пакетные», которые отнимали примерно пол-секунды процессорного времени и могли быть ненадолго отложены без ущерба для удобства пользователя.

В поисках наилучшей архитектуры приложения мы долго и тщательно обдумывали способы обработки этих типов запросов с учётом юзабилити и стоимости масштабирования и в конце концов сформулировали четыре основных требования:

  • Насыщение. Наше решение должно было использовать все доступные ядра процессора.
  • Отзывчивость. Пользовательский интерфейс должен оставаться отзывчивым. Всегда.
  • Отказоустойчивость. Когда нагрузка зашкаливает, мы должны нормально обслужить столько клиентов, сколько сможем, а остальным показать сообщение об ошибке.
  • Простота. Решение должно легко и постепенно интегрироваться в уже работающий сервер.


Вооружившись этими требованиями, мы можем осмысленно сравнивать разные подходы.
Читать дальше →