Обновить
128K+

Серверная оптимизация *

Разгружаем сервер

64,12
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

NetApp HCI ─ гиперконвергентная система нового поколения для работы с данными

Время на прочтение9 мин
Охват и читатели7.1K
Развитие систем хранения данных и управления ими прошли долгий путь развития, будучи критичными для любого корпоративного IT решения. Сегодня наиболее совершенными являются гиперконвергентные системы, которые имеют целый ряд преимуществ перед используемыми сегодня и устаревшими наследуемыми системами. Они дешевле, проще в управлении, легко масштабируются и обеспечивают точное соответствие своих ресурсов потребностям предприятия.


Читать дальше →

Intel Vpro или IP-KVM для десктопов

Время на прочтение3 мин
Охват и читатели8.9K

Прежде всего, давайте договоримся: те, кому технология Intel vPro не в новинку, могут не тратить времени на всю вступительную часть статьи, сразу заказать Intel Core I7 7700 c 16 GB DDR4 240 SSD c защитой от DDOS за 3800руб в мес, без установочного платежа (ссылка в конце статьи). Но нам кажется, что пока не все оценили преимущества удалённого доступа при помощи Intel vPro – который в нашем дата-центре предоставляется ко всем выделенным серверам без серверных платформ. А значит, нужно разобраться: что это за технология такая, какая она реализовывается, и какие проблемы решает.


Что такое Intel vPro?


Эта технология – настоящий аппаратно-программный комплекс, направленный на продвинутое решение проблем удалённого доступа: с учётом высоких требований к информационной безопасности, и необходимости предоставлять самые широкие возможности управления (о чём подробнее – ниже).

Читать дальше →

Тюнинг сетевого стека Linux для ленивых

Время на прочтение5 мин
Охват и читатели100K

Сетевой стек Linux по умолчанию замечательно работает на десктопах. На серверах с нагрузкой чуть выше средней уже приходится разбираться как всё нужно правильно настраивать. На моей текущей работе этим приходится заниматься едва ли не в промышленных масштабах, так что без автоматизации никуда – объяснять каждому коллеге что и как устроено долго, а заставлять людей читать ≈300 страниц английского текста, перемешанного с кодом на C… Можно и нужно, но результаты будут не через час и не через день. Поэтому я попробовал накидать набор утилит для тюнинга сетевого стека и руководство по их использованию, не уходящее в специфические детали определённых задач, которое при этом остаётся достаточно компактным для того, чтобы его можно было прочитать меньше чем за час и вынести из него хоть какую-то пользу.

Читать дальше →

Сжатие фотографий без видимой потери качества: опыт Yelp

Время на прочтение11 мин
Охват и читатели25K
На Yelp хранится более 100 миллионов пользовательских фотографий, от картинок ужинов и причёсок до одной из наших последних фич, #yelfies. Эти изображения составляют основную часть трафика для пользователей приложения и веб-сайта, а их хранение и передача обходятся недёшево. Стараясь предоставить людям наилучший сервис, мы усиленно работали над оптимизацией всех фотографий и добились среднего уменьшения размера на 30%. Это экономит людям время и трафик, а также сокращает наши расходы на обслуживание этих изображений. Ах да, и мы сделали это без ухудшения качества фотографий!

Исходные данные


Yelp хранит пользовательские фотографии уже 12 лет. Мы сохраняем lossless-форматы (PNG, GIF) как PNG, а все остальные форматы в JPEG. Для сохранения файлов используются Python и Pillow, а загрузки фотографий начинаются примерно с такого сниппета:

# do a typical thumbnail, preserving aspect ratio
new_photo = photo.copy()
new_photo.thumbnail(
    (width, height),
    resample=PIL.Image.ANTIALIAS,
)
thumbfile = cStringIO.StringIO()
save_args = {'format': format}
if format == 'JPEG':
    save_args['quality'] = 85
new_photo.save(thumbfile, **save_args)

Читать дальше →

Организация коммутационного поля СКС высокой плотности

Время на прочтение4 мин
Охват и читатели29K
Объм и плотность коммутационного поля СКС прямо пропорциональны хаосу на нем и обратно пропорциональны возможности его устранения. Проблематика проектирования и построения новой СКС сводится к расстановке рабочих мест, кабельных трасс и коммутационных узлов. Никто не задумывается о технических решениях, призванных обеспечить эффективное эксплуатирование системы после ее сдачи.


Читать дальше →

Как пропатчить K̶D̶E̶ TCP-стек под FreeBSD

Время на прочтение10 мин
Охват и читатели15K
Когда стоит вопрос выбора между проприетарным и открытым программным обеспечением, часто в пользу последнего приводят следующий аргумент: при необходимости можно изменить исходники под нужды своего проекта, или исправить ошибку прямо сейчас, а не дожидаясь месяцами реакции вендора. Зачастую это соображение является оторванным от практики — куда проще исправить SQL запрос, чем оптимизировать SQL-планировщик, или поменять проблемное оборудование вместо того, чтобы искать и исправлять ошибку в драйвере. Тем не менее, иногда именно открытость кода позволяет избежать потенциальных убытков и перерасхода вычислительных ресурсов. Хочу рассказать об одном из таких кейсов, случившемся за время моей работы в Advanced Hosting
Читать дальше →

Сохранить данные и веру в человечество: большая миграция кластера ElasticSearch

Время на прочтение10 мин
Охват и читатели14K


В этом материале я продолжаю делиться полевым опытом работы с системой сбора логов на базе Heka и ElasticSearch.


На этот раз рассказ пойдет про миграцию данных между двумя кластерами ElasticSearch 2.2 и 5.2.2, которая стоила немалых нервов лично мне. Как-никак, предстояло перевезти 24 миллиарда записей, не сломав уже работающую систему.


Прошлая статья закончилась на том, что система работает, логи поступают и складываются в кластер ElasticSearch, доступен их просмотр в реальном времени через Kibana. Но кластер изначально был собран со значительным запасом по памяти как раз на вырост.

Приступим к освоению всех 512 ГБ

HP DL120 G7 — вторая жизнь сервера

Время на прочтение4 мин
Охват и читатели43K


Привет Хабр! За бортом 2017 год и на рынке доступны новые сервера поколения HP G9, а скоро думаю появятся и HP G10.

Но «денег нет», и вы приняли решение купить БУ сервер или провести оптимизацию существующего парка серверов. И в этом случае я хочу обратить ваше внимание на пару моментов связанных с дисковой подсистемой сервера HP DL120 G7.
Читать дальше →

Основные возможности Dell EMC Cloud для Microsoft Azure

Время на прочтение2 мин
Охват и читатели2.1K
Около месяца назад компания Dell EMC представила Dell EMC Cloud для Microsoft Azure Stack — платформу, которая позволит оптимизировать внедрение гибридных облачных решений на базе Microsoft Azure Stack. И пока она еще не доступна для заказа, мы вкратце расскажем о ее основных преимуществах и о том, что она даст клиентам.

Читать дальше →

Старые технологии на новый лад. FreeBSD Jails + CBSD Project

Время на прочтение7 мин
Охват и читатели11K

Предисловие


Примерно 9 лет назад, когда в моем городе появились первые безлимитные тарифы (что-то вроде 128 кбит/сек за 500 руб.), я принял решение держать в квартире собственный «сервер» для решения различных задач. Одной из первых идей было поднятие зеркала для проекта FreeBSD.org. Проработало оно где-то 2 года. Далее в этом уже не было смысла, ввиду расширения каналов и других причин.

Помимо этого, сервер принимал на себя в разные периоды времени и другие задачи:

  • Хранение резервный копий данных, документов и дистрибутивов;
  • Закачка торрентов;
  • Раздача торрентов по DLNA и SMB на различные устройства;
  • VPN-клиент к провайдеру (был даже период, когда сервер держал два PPTP соединения через MPD – для работы локального трафика и медленного безлимита);
  • VPN-сервер и подключение до офисного шлюза (канал до работы);
  • Asterisk сервер для IP-телефонии (в дальнейшем в доме появились всякие SPA-3112, радио-трубки и т.д.);
  • FTP-служба для получения данных с IP-камеры, для сброса бекапов с Mikrotik-ов скриптами;
  • И т.д. и т.п.

Общая мысль – в руках был конструктор с кучей разноцветных деталей и большое желание прикрутить еще что-нибудь эдакое. В общем то обычная ситуация для большинства системных администраторов, знающих и любящих *nix-системы.
Читать дальше →

HCIBench — нагрузочное тестирование хранилищ под vSphere

Время на прочтение14 мин
Охват и читатели14K

Введение


Вопрос хранения данных является одним из самых важных, сложных и дорогих для любой виртуальной инфраструктуры, в т.ч. для всеми уважаемой VMware vSphere.

Для оценки производительности хранилища, дабы понимать его возможности для выполнения реальных задач, необходимо проведение нагрузочного тестирования. Самыми простыми в реализации являются синтетические тесты, выполняемые, например, с помощью таких популярных утилит как Iometer и Fio. Классическое применение: тестирование локального хранилища узла либо внешней СХД с одного или нескольких узлов.

С виртуальной инфраструктурой дела обстоят несколько сложнее, она состоит из множества хостов, на которых крутятся десятки ВМ. Даже небольшая инсталляция из двух-четырех хостов может легко держать около 100 ВМ, не говоря о средних и больших инфраструктурах из десятков и сотен хостов.

Тестировать общее хранилище для такой инфраструктуры путем запуска Iometer/Fio на одной или нескольких ВМ либо с выделенного узла на голом железе будет некорректным. Такое тестирование должно быть распределенным и обеспечивать параллельную генерацию ввода/вывода и централизованный учет результатов с множества ВМ со всех хостов кластера vSphere. Только такой подход позволит сэмулировать нагрузку реального высоконагруженного виртуального кластера.

Лично я пробовал на своем тестовом кластере vSphere vSAN 6 update 3 из 4х хостов ручками развернуть 4 ВМ на Винде с Iometer, через командную строку подключить Dynamo на 3х ВМ к консоли Iometer на четвертой ВМ, с которой и проводил распределенное тестирование. Даже для 4х ВМ дело это скучное и неблагодарное, разворачивать по несколько ВМ на хост вручную вообще не вариант.

Конечно можно воспользоваться скриптами, средствами автоматизации и сделать всё красиво, но я не умею. Поэтому для таких как я небольшая группа разработчиков VMware выпустила и развивает бесплатную утилиту HCIBench, о ней мы и будем говорить в данной статье.
Читать дальше →

Bitdefender Hypervisor Introspection: новое средство борьбы со скрытыми киберугрозами

Время на прочтение5 мин
Охват и читатели3.4K
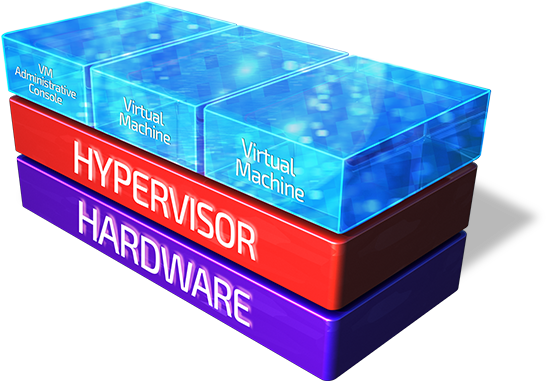
Некоторое вредоносное ПО, заражая систему, может начать выполнять свои функции спустя месяцы после самого заражения. Находясь на виртуальной машине, подобные зловреды при подключении к серверу могут распространиться по всему центру обработки данных и корпоративной сети. Именно для отражения подобных угроз Сitrix и Bitdefender разработали средство безопасности, которое запускается внутри гипервизора для обнаружения вредоносного ПО, запущенного в гостевых виртуальных машинах. В данном случае речь идет о сервере компании Citrix под названием XenServer, а сам защитный продукт называется Bitdefender Hypervisor Introspection (HVI).

Читать дальше →

Дайджест: работа IaaS-провайдера, SSL-сертификаты, ЦОД и наш «пятничный формат»

Время на прочтение4 мин
Охват и читатели1.9K
В этой подборке мы приводим материалы, которые помогут разобраться с тем, что происходит в сфере IaaS, новых технологиях для ЦОД, устройстве SSL-сертификатов и познакомиться другими нюансами и тонкостями работы виртуальной инфраструктуры.

В прошлых выпусках:


Читать дальше →

Ближайшие события

Работа с потоком логов в реальном времени с помощью Heka. Опыт Яндекс.Денег

Время на прочтение9 мин
Охват и читатели33K

image alt text


В этом материале я расскажу о том, как в Яндекс.Деньгах организована система сбора и доставки серверных логов платежных сервисов. Доставкой логов я занимаюсь весь последний год, и за это время накопилось достаточно нюансов, чтобы поделиться опытом с общественностью.


Система построена на базе стека EHK (Elasticsearch/Heka/Kibana), с прицелом на работу практически в реальном времени. Особый упор сделаю на тонкие места и нюансы обработки миллиардов строк текста в сутки.

Приступим к суровому hands-on

IaaS-дайджест: «vCloud и его друзья»

Время на прочтение4 мин
Охват и читатели2.5K
Сегодня мы подготовили для вас тематическую подборку материалов по теме vCloud и начала работы с IaaS (арендованной облачной инфраструктурой). Всех заинтересовавшихся приглашаем под кат.

Ускоряем восстановление бэкапов в Postgres. Часть вторая (потому что сокращения времени вдвое недостаточно)

Время на прочтение3 мин
Охват и читатели17K


В первой части статьи «Ускоряем восстановление бэкапов в Postgres» я рассказал о предпринятых шагах по уменьшению времени восстановления в локальном окружении. Мы начали с простого: pg_dump-пили (а есть ли такое слово?), паковали gzip-ом, распаковывали и направляли вывод в psql < file.sql. На восстановление уходило около 30 минут. В итоге мы остановились на настраиваемом (custom) формате Postgres и применили аргумент -j, добившись уменьшения времени до 16 минут.


В этой статье я описал, как нам удалось уменьшить размер файла резервной копии, что дополнительно ускорило процедуру восстановления.

Читать дальше →

Контейнеры Docker немного увеличивают энергопотребление сервера

Время на прочтение3 мин
Охват и читатели12K

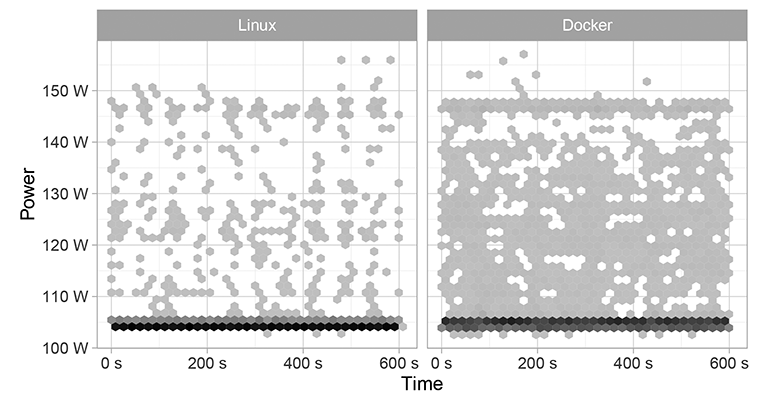
Энергопотребление компьютера с ОС Linux и сервисом Docker без всякой нагрузки (без загрузки контейнера)

Виртуализация даёт множество преимуществ — особенно для изоляции процессов и контроля за ресурсами. Развёртывание программ стало как никогда простым благодаря образам полной и сконфигурированной системы. Работа гипервизора для виртуальных машин означала одновременную работу двух ядер операционной системы. Поэтому появились легковесная альтернатива виртуальным машинам — контейнеры, которые сейчас быстро вытесняют виртуальные машины как наиболее оптимальный способ виртуализации.

Поскольку в контейнерах не работают одновременно два ядра операционной системы, как в виртуальных машинах, то казалось бы, что энергопотребление у них должно быть такое же, как при работе обычной операционной системы. Но это не так. Cравнительное тестирование Linux и Docker показало, что энергопотребление контейнеров Docker чуть выше.
Читать дальше →

Ускоряем восстановление бэкапов в PostgreSQL

Время на прочтение4 мин
Охват и читатели76K

Мои ощущения от процесса работы


Недавно я решил заняться ускорением восстановления нашей базы данных в dev-окружении. Как и во многих других проектах, база вначале была небольшой, но со временем значительно выросла. Когда мы начинали, ее размер было всего несколько мегабайт. Теперь упакованная база занимает почти 2 ГБ (несжатая — 30 ГБ ). Мы восстанавливаем dev-окружение в среднем раз в неделю. Старый способ проведения операции перестал нас устраивать, а вовремя подвернувшаяся в Slack-канале картинка “DB restore foos?” побудила меня к действию.


Ниже описано, как я ускорял операцию восстановления базы данных.

Читать дальше →

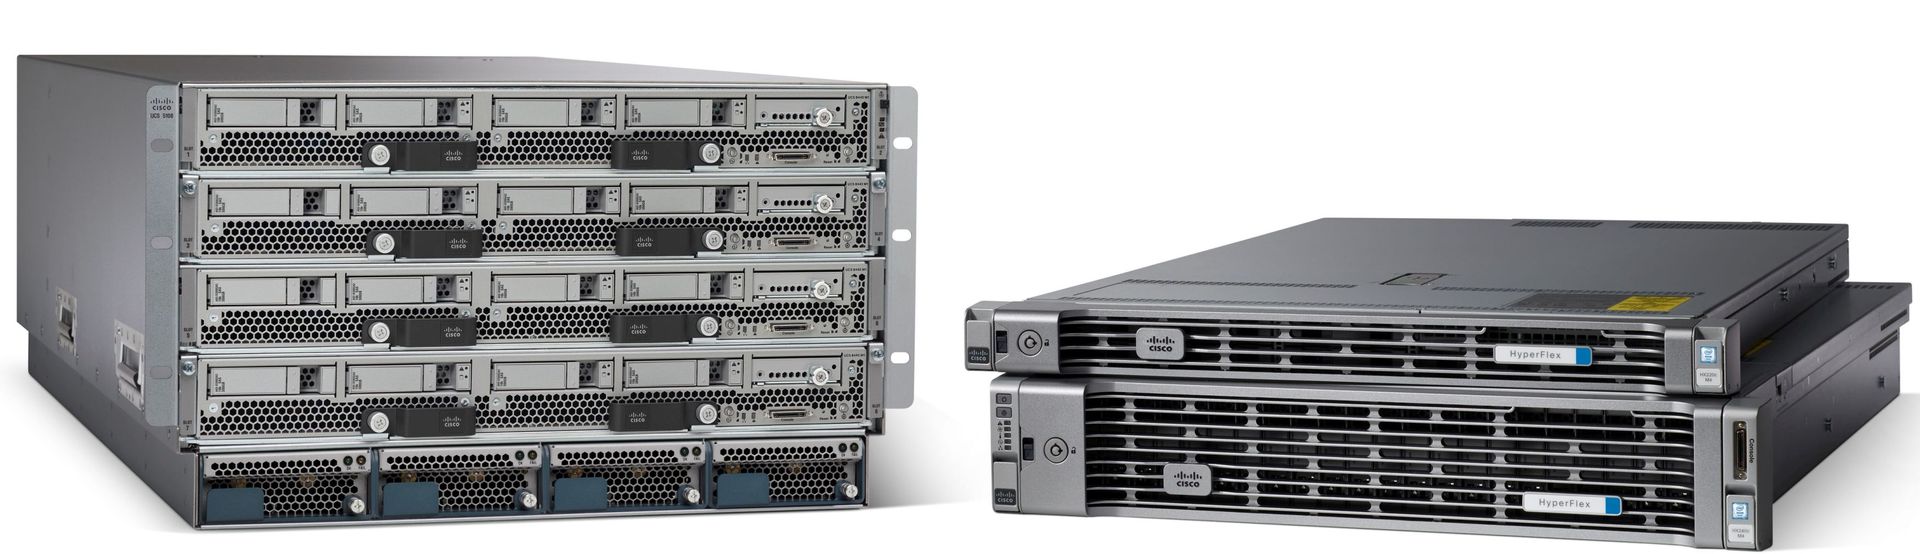
Гиперконвергентность в тренде: Cisco HyperFlex

Время на прочтение5 мин
Охват и читатели4.9K
Современные предприятия все чаще сталкиваются с задачами, для которых традиционные серверы и СХД уже не могут служить идеальным решением. Объединить вычислительную платформу, виртуальные машины и систему хранения данных в единую распределенную инфраструктуру позволяет гиперконвергентная инфраструктура Cisco HyperFlex.
image
Читать дальше →

Nvidia опубликовала отчет о разработке и оптимизации актуальных GPU и сравнила их с TPU Google

Время на прочтение4 мин
Охват и читатели8.1K
Недавний отчет Google об устройстве и назначении TPU позволяет сделать однозначный вывод — без ускоренных вычислений серьезное развертывание системы ИИ просто нецелесообразно.
Большинство необходимых экономических вычислений во всем мире сегодня производится в мировых центрах обработки данных, а они с каждым годом все сильнее изменяются. Не так давно они обслуживали веб-страницы, распространяли рекламу и видеоконтент, а теперь распознают голос, идентифицируют изображение в видеопотоках и предоставляют нужную информацию именно в тот момент, когда она нам нужна.

Все чаще эти возможности активируются с помощью одной из форм искусственного интеллекта, т.н. «глубокого обучения». Это алгоритм, который учится на огромных объемах данных для создания систем, решающих такие задачи, как перевод с разных языков, диагностирование рака и обучение беспилотных автомобилей. Перемены, привносимые искусственным интеллектом в нашу жизнь, ускоряются невиданными в отрасли темпами.

Один из исследователей глубокого обучения, Джеффри Хинтон, недавно сказал в интервью «The New Yorker»: «Возьмите любую старую классификационную проблему, в которой у вас много данных, и она будет решена путем «глубокого обучения». У нас на подходе тысячи разных приложений на базе «глубокого обучения».
Читать дальше →