Обновить
3
Евгений Аблесов@Codebaker

Пользователь

Отправить сообщение

Сериализация объектов Qt

Время чтения8 мин
Охват и читатели21K
Здесь меня будет интересовать как сериализовать объект Qt, передать его по сети и поддерживать между оригиналом и копией связь синхронизирующую состояние копии. Использовался Qt 4.8.
Читать дальше →

Увидеть незримое

Время чтения8 мин
Охват и читатели93K
Пару лет назад на Хабре проскакивало две статьи, в которых упоминался интересный алгоритм. Статьи, правда, были написаны нечитабильно. В стилистике «новости»(1, 2), но ссылка на сайт присутствовала, подробно можно было разобраться на месте (алгоритм за авторством MIT). А там была магия. Абсолютно волшебный алгоритм, позволяющий увидеть незримое. Оба автора на Хабре этого не заметили и сфокусировались на том, что алгоритм позволял увидеть пульс. Пропустив самое главное.


Алгоритм позволял усиливать движения, невидные глазу, показать вещи, которые никто никогда не видел живьём. Видео чуть выше – презентация c сайта MIT второй части алгоритма. Микросаккады, которые приведены начиная с 29ой секунды, раньше наблюдались только как отражения установленных на зрачках зеркалах. А тут они видны глазами.
Пару недель назад я опять натолкнулся на те статьи. Мне сразу стало любопытно: а что народ сделал за эти два года готового? Но… Пустота. Это определило развлечение на следующие полторы недели. Хочу сделать такой же алгоритм и разобраться, что с ним можно сделать и почему его до сих пор нет в каждом смартфоне, как минимум для измерения пульса.

В статье будет много матана, видео, картинок, немного кода и ответы на поставленные вопросы.
Читать дальше →

Пишем простой интерпретатор на C++ с помощью TDD, часть 1

Время чтения17 мин
Охват и читатели51K

Введение


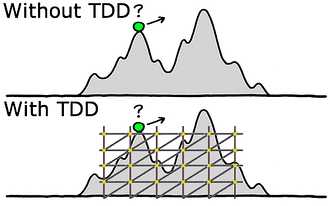
Многие C++ программисты слышали про разработку через тестирование. Но почти все материалы по данной теме касаются более высокоуровневых языков и сосредоточены больше на общей теории, чем на практике. Итак, в данной статье я попробую привести пример пошаговой разработки через тестирование небольшого проекта на C++. А именно, как можно предположить из названия, простого интерпретатора математических выражений. Такой проект также является неплохой code kata, так как на его выполнение затрачивается не более часа (если не писать параллельно статью об этом).

Архитектура


Несмотря на то, что при использовании TDD архитектура приложения постепенно проявляется сама собой, начальная её проработка всё же необходима. Благодаря этому может значительно снизиться общее время, затраченное на реализацию. Это особенно эффективно в тех случаях, когда существуют готовые примеры подобных систем, которые можно взять за образец. В данном случае, существует вполне устоявшееся мнение о том, как должны быть устроены компиляторы и интерпретаторы, чем и можно воспользоваться.

Существует множество библиотек и инструментов, которые могут облегчить разработку интерпретаторов и компиляторов. Начиная от Boost.Spirit и заканчивая ANTLR и Bison. Можно даже запустить канал интерпретатора командной строки через popen и вычислить выражение через него. Целью данной статье является пошаговая разработка достаточно сложной системы с помощью TDD, поэтому будет использоваться только стандартная библиотека C++ и встроенный в IDE тестовый фреймворк.
Читать дальше →

Анимации на лямбдах в C++11

Время чтения3 мин
Охват и читатели20K


Компании-разработчики, как правило, не особо спешат переходить на новый Си++. Главным образом из-за поддержки его компиляторами, а точнее ее полного или частичного отсутствия. Недавно я решил узнать, что же есть новенького в плане поддержки C++11 компилятором GCC, и понял, что пора начинать. Благо, у нас в Ivideon лояльно относятся к новым технологиям и дают пробовать что-то новое.
Начал, конечно же, с самого вкусного — с лямбда-выражений! И с потоков.
Читать дальше →

Как улучшить свой стиль программирования?

Время чтения6 мин
Охват и читатели140K

Исповедь 1


Я — разработчик. От своих работодателей я постоянно слышу, что работаю медленно и часто всё усложняю без веской причины. И что мне пора бы что-то с этим сделать. Во избежание.

Весь мой опыт программирования складывается из университетских работ и пары лет пребывания в различных компаниях. Критикующие меня люди неоднократно говорили мне, что в целом я разбираюсь в теме, так что я далеко не клинический случай, как можно было подумать. Однако, очевидно, я выработал совсем не те программистские привычки (как минимум, на взгляд работодателя) и мне нужно срочно изменить их. Везде, где бы я ни работал, мои решения, использующие иерархии мелких классов с делегированием поведения, признавались плохими. Говорят, будто так и надо писать, но это не так. Потому что всё это «как надо» может стоить мне работы.
Читать дальше →

Лучшие грабли российских IT-стартапов

Время чтения7 мин
Охват и читатели70K


1. Упарываться по хардкору
Это не ошибка, но очень характерная ситуация для IT-сферы. Пока другие стартаперы не имеют продукта, зато рассылают релизы со скриншотами, пьют смузи, выступают на конференциях и выставках, айтишники пишут код. Когда прототип собран и дело доходит до поиска инвестора, становится понятно, что пиар тоже был нужен. Вот только начинать его надо было месяца так два назад.

2. «Сам дурак»
Большая проблема — нежелание слушать мнение окружающих. Когда половина проекта готова и внезапно становится понятно, что проект нежизнеспособен, есть два варианта: резко меняться или сворачиваться. Знаете, что часто делают руководители IT-стартапов? Перестают слушать людей снаружи, превращают команду в секту и упорно допиливают продукт. Потому что полработы уже сделано.

3. Не знать конкурентов
Офигенный подход аутистов — взять и сделать прототип без изучения рынка. Незнание прямого конкурента, косвенного конкурента и западных аналогов продукта — это не самая хорошая идея. Нужно смотреть, кто уже работал в этом направлении и, главное, с какими проблемами сталкивался. Потому что эти проблемы придут к вам. Ещё полезно замерять показатели конкурентов и сравнивать со своими. Если конкурентов нет — это повод насторожиться. Возможно, ваш продукт никому не нужен.
Читать дальше →

О бедном C++ API замолвите словцо!

Время чтения15 мин
Охват и читатели44K
Желание написать об C++ API у меня возникло давно, и вот наконец выдался спокойный вечер. По роду деятельности я и мои ребята пишем код на C++ для программистов на C++ и Python, общее ядро функционала, который используется во всех продуктах нашей компании. Разумеется это подразумевает, что код должен иметь интуитивно понятный API, с общей логикой как для низкоуровневого C++, так и для высокоуровневого Python, вне зависимости от разночтения в языках некоторых базовых конструкций. Об объединении C++ и Python я много писал ранее в статьях про Boost.Python, сейчас я очень благодарен архитектуре и логике языка Python, я многое понял и перенял в С++ именно благодаря опыту построения общего API для этих двух таких разных языков, но сейчас речь пойдёт только и исключительно о C++, про API и про то, что такой зверский гибкий язык позволяет сделать с интерфейсом вашей замечательной библиотеки, если не учитывать ряд важных особенностей языка C++.
Читать дальше →

Variadic templates. Tuples, unpacking and more

Время чтения7 мин
Охват и читатели109K
В этом посте я поговорю о шаблонах с переменным числом параметров. В качестве примера будет приведена простейшая реализация класса tuple. Также я расскажу о распаковке tuple'а и подстановки, хранимых там значений в качестве аргументов функции. И напоследок приведу пример использования вышеописанных техник для реализации отложенного выполнения функции, которое может быть использовано, например, в качестве аналога finally блоков в других языках.
Читать дальше →

Опыт кастомного анализа c# кода

Время чтения6 мин
Охват и читатели10K
Довольно давно я делился проблемой тестирования кода в финализаторе и недавно жаловался на падение теста (Как тестировать код финализатора (c#) и Как тестировать код финализатора (c#). Послесловие: тест все-таки упал).
В ходе обсуждения комрадом withkittens была высказана идея:
Финализатор (при правильной реализации IDisposable pattern) должен (should) вызывать Dispose(false). Этот факт можно тестировать статическим анализом. Соответственно, если Dispose(false) вызывает удаление файла (вы же написали тест?), то можно быть уверенным, что и финализатор тоже вызовет удаление файла, unit-тест излишен.

Мне эта идея показалась очень здравой, кроме того, иногда хочется контролировать исходный код более кастомно, чем дает встроенный анализ кода или решарпер.
Опыт реализации кастомных правил анализа кода под катом + «как ozcode помог в процессе исследования внешней библиотеки»
Читать дальше →

Вероятностные модели: сэмплирование

Время чтения10 мин
Охват и читатели38K
И снова здравствуйте! Сегодня я продолжаю серию статей в блоге Surfingbird, посвящённую разным методам рекомендаций, а также иногда и просто разного рода вероятностным моделям. Давным-давно, кажется, в прошлую пятницу летом прошлого года, я написал небольшой цикл о графических вероятностных моделях: первая часть вводила основы графических вероятностных моделей, во второй части было несколько примеров, часть 3 рассказывала об алгоритме передачи сообщений, а в четвёртой части мы кратко поговорили о вариационных приближениях. Цикл заканчивался обещанием поговорить о сэмплировании — ну что ж, не прошло и года. Вообще говоря, в этом мини-цикле я поведу речь более предметно о модели LDA и о том, как она помогает нам делать рекомендации текстового контента. Но сегодня начну с того, что выполню давнее обещание и расскажу о сэмплировании в вероятностных моделях — одном из основных методов приближённого вывода.

Читать дальше →

Решение задачи линейной регрессии с помощью быстрого преобразования Хафа

Время чтения7 мин
Охват и читатели17K

Введение


Друзья, рассмотрим нынче же задачу линейной регрессии в присутствии выбросового (некоррелированного с сигналом) шума. Эта задача часто возникает при обработке изображений (напр., при цветовой сегментации [1]), в том числе — акустических [2]. В случаях, когда координаты случайных величин можно грубо дискретизовать, а размерность задачи низка (2-3), кроме стандартных методов робастной регрессии можно воспользоваться быстрым преобразованием Хафа (БПХ) [3]. Попробуем сравнить этот последний метод по точности и устойчивости с «классическими».

Использование БПХ для линейной регрессии


Задача линейной регрессии на плоскости состоит в восстановлении линейной зависимости между двумя переменными, заданными в виде множества пар (x, y). Задавшись некоторым уровнем дискретизации координат, можно отобразить это множество на однобитном или целочисленном изображении (в первом случае мы отмечаем только факт наличия в исходных данных точки с примерно такими координатами, во втором — еще и их число). Фактически, речь идет о двумерной гистограмме исходных данных. Таким образом, неформально задача может быть сведена к поиску на изображении прямой, которая наилучшим образом описывает изображенное распределение точек.В обработке изображений в подобных случаях используется преобразование Хафа.

Преобразование Хафа является дискретным аналогом преобразования Радона и ставит в соответствие каждой прямой на изображении сумму яркостей пикселей вдоль нее (то есть одновременно вычисляет всевозможные суммы вдоль дискретных прямых). Можно ввести разумную дискретизацию прямых по сдвигам и наклонам так, чтобы параллельные дискретные прямые плотно упаковывали плоскость, а выходящие из одной точки на одном крае изображения прямые расходились по наклону на противоположном крае на целое число пикселей. Тогда таких дискретных прямых на квадрате n2 будет примерно 4 * n2. Для этой дискретизации существует алгоритм быстрого вычисления преобразования Хафа с ассимптотикой O(n2 * log n). Этот алгоритм является близким аналогом алгоритма быстрого преобразования Фурье, хорошо параллелизуется и не требует никаких операций, кроме сложения. В работе [3] можно прочитать об этом чуть больше, кроме того, там объясняется, почему преобразование Хафа от сглаженного гауссовским фильтром изображения вообще можно применять в задаче линейной регресии. Здесь же мы продемонстрируем устойчивость этого метода.
Читать дальше →

Классы и фабрики. Как разобрать и собрать объект с наследованием на прототипах

Время чтения6 мин
Охват и читатели21K
Привет, Хабра!
При разработке игр на JavaScript часто возникает необходимость создавать множество объектов. О том, как правильно это сделать и не утонуть в коде, я рассказывал, примерно — месяц назад на Frontend Dev Conf в Минске. Возможно, доклад будет интересен тем, кто не был на конференции и сталкивался с проблемой создания множества объектов, либо является разработчиком HTML5 игр.


Под катом текст с картинками.
Читать дальше →

Шпаргалка по HTTP-библиотекам для С++

Время чтения12 мин
Охват и читатели118K
К сожалению, в стандартной библиотеке языка С++ нет никаких средств для работы с протоколом HTTP. Возможно, в будущем появятся, но на данный момент каждый раз при необходимости дёрнуть какой-нибудь REST-сервис, пропарсить веб-страничку, написать простенького бота или краулера приходится задаваться вопросами «А какую же библиотеку взять, так чтобы побыстрее и попроще?». Иногда проект уже использует какой-то фреймворк (а иногда даже несколько) и тогда приходится вспоминать «А как же сделать HTTP-запрос имеющимися средствами?». Чтобы не путаться я решил написать для себя шпаргалку с примерами HTTP-запросов на С++ с применением разных библиотек. А самое удобное место для хранения подобных шпаргалок — Хабр: и сам не потеряешь, и другим может пригодиться.

Будут рассмотрены:
  • WinInet
  • WinHttp
  • Casablanca
  • Qt
  • POCO
  • wxWidgets
  • Boost.Asio
  • libcurl
  • neon
  • .NET (С++/CLI)
  • IXMLHTTPRequest
  • HappyHttp
  • cpp-netlib


Читать дальше →

Снижение компонентной связности кода С++

Время чтения15 мин
Охват и читатели15K

Избавляемся от недостатков классического ООП и пишем на С++ в модульном стиле.
Читать дальше →

Maxmertkit. Идеальный css-фреймворк

Время чтения29 мин
Охват и читатели48K


Всю документацию на английском языке вы сможете прочесть на maxmert.com.

Требования и задачи


При создании версии 1.0 мне пришлось пересмотреть основные требования к фреймворку:

  • Возможность легко добавить/удалить размер или тему. Json-файл с прописанными темами и размерами для каждого виджета. Таким образом можно конфигурировать фреймворк исправляя json-файл.
  • Модульность. При отключении или добавлении любого виджета фреймворк должен стабильно работать (привет bootstrap).
  • Особое именование классов для избежания переопределения пользовательских классов.
  • Javascript компоненты без jQuery (но с возможностью его использования, если он подключен).


Конечно это не единственные требования, а приоритетные. Их, поверьте, было очень-очень много. В итоге у меня получился фреймворк, которым я сам с большим наслаждением пользуюсь. Так каковы же его основные отличия от уже существующих?

Осторожно! Трафик.
Читать дальше →

Как запилить свой дешборд на все случаи жизни?

Время чтения9 мин
Охват и читатели83K
В работе почти каждого человека непременно есть цифры, от которых зависит всё. Посещаемость сайта, время отклика или количество коммитов — что угодно! И если поместить эти цифры на самое видное место, они сразу становятся либо отличным способом оперативно принимать решения, либо просто наглядным инструментом мотивации. А самый лучший способ сделать это — это собственный дешборд, информационное табло, которое можно повесить на самом видном месте в офисе.


Читать дальше →

Как я делал виджет управления мощностью для своего браузерного симулятора космических полетов

Время чтения6 мин
Охват и читатели7.9K
Сегодня я сделал небольшой сниппет кода для себя и решил поделиться с сообществом его содержимым и историей его создания.

Я довольно долго рылся в интернетах для того чтобы найти хоть что-то похожее на то, что мне нужно, но интернет до сих пор с такой задачей не сталкивался видимо или никто не решился создавать подобный виджет. Наверное никому не надо было.

Для начала озвучу чего мне так хотелось:
Мне нужен слайдер — аналог регулятора громкости, совмещенный с прогресс-баром. Эдакий компонент управления мощностью чего-либо, совмещенный с одновременной индикацией этой мощности. Иногда мощность может превышать установленный предел в 100% — необходимо отображать этот уровень и правильно высчитывать процент. Иногда мощность может заходить ниже нуля ( не знаю может ли — но я на всякий случай предусмотрел такую возможность) и этот уровень тоже надо отображать. Более того, то устройство, которое мы регулируем может быть инертным и разгоняться не с той скоростью, с которой мы выставляем значение. Если вы нажали кнопку форсажа на самолете — то двигатели выйдут на форсажный режим через некоторое время. То есть надо отдельно задавать значение прогрессбара и также отдельно получать-устанавливать текущее значение ползунка слайдера.

Может быть я и фиговый искатель, но в итоге психанул — решил сделать свой:
Здесь ссылка на результат, а под катом описание процесса
Читать дальше →

Как писать парсеры на JavaScript

Время чтения10 мин
Охват и читатели114K
… а именно как писать LL парсеры для не очень сложных структур при помощи конструирования сложного парсера из более простых. Изредка возникает необходимость распарсить что то несложное, скажем некую XML-подобную структуру или какой нибудь data URL, и тогда обычно возникает либо простыня хитрого трудно читаемого кода либо зависимость от какой то ещё более сложной и хитрой библиотеки для парсинга. Здесь я собираюсь совместить несколько известных идей (какие то из них попадались на Хабре) и показать как можно просто и лаконично написать довольно сложные парсеры уложившись при этом в совсем немного строчек кода. Для примера я буду писать парсер XML-подобной структуры. И да, я не буду вставлять сюда картинку для привлечения внимания. В статье вообще картинок нет, поэтому читать будет трудно.

Читать дальше →

Вызов функции, соответствующей заданной строке

Время чтения14 мин
Охват и читатели15K
Привет!
Не знал, как поточнее назвать статью, но хотелось бы разобрать одну маленькую задачку, которая звучит следующим образом:
На вход подаётся отформатированная некоторым образом строка, в которой указаны имя функции, её аргументы и типы аргументов. Нужно иметь возможность вызвать соответствующий обработчик функции, корректно передав все аргументы.

Например, так ActionScript пытается вызвать функцию test с тремя аргументами str, false, 1.0(соответственно типы аргументов: String, Boolean, Number):
<invoke name="test" returntype="xml"><arguments><string>str</string><false/><number>1.0</number></arguments></invoke>

Хотелось бы, чтобы со стороны C++ была вызвана соответствующая функция:
void test_handler(const std::wstring& str, bool flag, double n);


Под катом — реализация с использованием нового стандарта и, для сравнения, реализация с использованием старого стандарта(и капельки boost-а).
Читать дальше →

Ещё один Pattern Matching на C#

Время чтения4 мин
Охват и читатели18K
Последнее время в процессе работы с языком C# я стал всё острее и острее нуждаться в механизме сопоставления с образцом, который присутствует во многих современных мультипарадигмальных языках (F#, Scala и т.д.), но отсутвует в C#. Найденые благодаря получасу гугления реализации (Пример) предлагали конструировать match-выражения посредством fluent-интерфейсов, что, на мой взгляд, довольно громоздко синтаксически. Вторым, уже более существенным для реального использования, недостатком является overhead на перебор предикатов в цикле, происходящий «под капотом» в таких мэтчерах. В общем, я задался целью написать собственную реализацию сопоставления с образцом, руководствуюсь двумя основными принципами:
  • Синтаксически приблизится к «нормальным» конструкциям как в F#/Scala
  • Приблизиться по производительности к коду с if/else if/else насколько это возможно


За тем, что получилось — прошу под кат
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Москва, Москва и Московская обл., Россия
Работает в
Дата рождения
Зарегистрирован
Активность