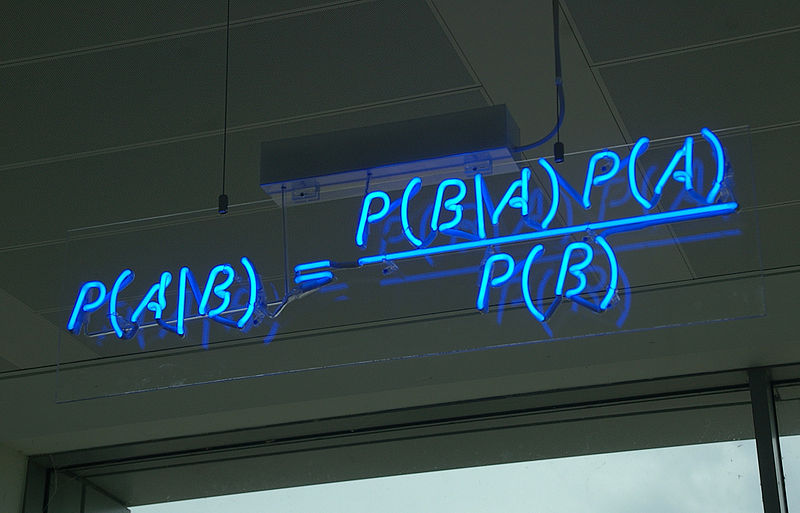
Обновить
3
Евгений Аблесов@Codebaker

Пользователь

Отправить сообщение

Дуальные числа в бизнесе или как оценить чувствительность решения к изменению начальных условий

Время чтения4 мин
Охват и читатели13K
За применение в бизнесе мнимых величин уже дали премию. Теперь интересно что-нибудь поиметь с дуальных.
Дуальное число — это расширение поля действительных чисел (или любого другого, например комплексных) вида a + εb, где a и b — числа из исходного поля. При этом полагается, что ε ε = 0.
Оказывается, у таких странных чисел есть практическое приложение.

Основным полезным свойством дуальных чисел является
f(a + εb) = f(a) + εf'(a)b.
Когда у нас есть формула для f(x), получить производную f'(x) труда не составит. Но часто f(x) доступно только в виде алгоритма — например как решение специальным образом составленной системы линейных уравнений. Запустив алгоритм с исходными данными, в которые добавлена ε мы получим результат и значение производной по одному из параметров.
Немного матана с примерами на Haskell

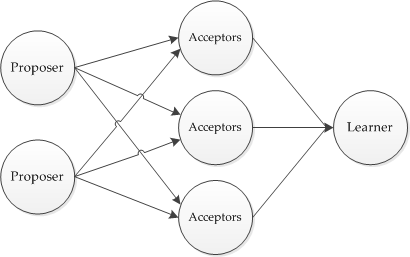
Консенсус в распределенных системах. Paxos

Время чтения7 мин
Охват и читатели44K
В последнее время в научных публикациях всё чаще упоминается алгоритм достижения консенсуса в распределенных системах под названием Paxos. Среди таких публикаций ряд работ сотрудников Google (Chubby, Megastore, Spanner) ранее уже частично освещенных на хабре, архитектуры систем WANdisco, Ceph и пр. В то же время, сам алгоритм Paxos считается сложным для понимания, хоть и основывается он на элементарных принципах.

В этой статье я постараюсь исправить эту ситуацию и рассказать об этом алгоритме понятным языком, как когда-то это попытался сделать автор алгоритма Лесли Лэмпорт.
читать далее

Выжать все соки или используем Raspberry pi на всю катушку

Время чтения11 мин
Охват и читатели266K
Всем привет!

Долой унылые речи о том, что это мой первый пост и все такое. Пожалуй лучше я расскажу о том, как выжать все соки из маленькой малютки под названием Raspberry PI (далее RPI), ценой $ 35. Я уверен на 146,6% что здесь уже были посты подобного рода, и этот пост не претендует на твердую пять. Скорее это просто вступительное слово о том: «Как я занял себя делом на пару унылых вечеров». Собственно мы получим в итоге Raspberry PI который можно использовать:
  1. как домашний web-сервер (если ты какой-нибудь PHP-разработчик, и тебе не чуждо веселье);
  2. как мультимедийную приставку с популярным XBMC Media Center (или супер-пупер-крутую-шняжку к телевизору за скромные 1800$);
  3. и как ночную торрент качалку, с web-интерфейсом (для ленивых);

Для тех кому стало интересно прошу под кат (Внимание! Трафик).
Читать дальше →

Алгоритм решения задачи о рюкзаке ( версия 2, исправленная)

Время чтения5 мин
Охват и читатели141K
Ниже приведен алгоритм точного решения целочисленной задачи о рюкзаке. Предлагаемый алгоритм требует меньше вычислительных ресурсов и возможно несколько проще алгоритма динамического программирования (ДП).

Причина побудившая автора к публикации


Первая версия описания алгоритма было послана мною в институт математики им. С. Л. Соболева Сибирского отделения РАН, откуда был прислан ответ что указанный алгоритм известен давно. Цитирую:
Одно из его первых упоминаний в книге Кереллера Nemhauser, Ullman, Discrete dynamic programming and capital allocation, Management Science, 15 p. 494-505, 1969.
Тем не менее я решил ознакомить сообщество с алгоритмом, т.к. в известных мне учебниках по дискретной математике я его не обнаружил (возможно плохо искал). В первой версии алгоритма была ошибка, указанная мне пользователем wataru. За это ему большое спасибо. Я постарался эту ошибку устранить. До алгоритма я дошел самостоятельно, так что надеюсь ничьих прав не нарушаю. Возможно кому нибудь описание будет интересно и пригодится.
Читать дальше →

Перевод учебника по алгоритмам

Время чтения1 мин
Охват и читатели168K


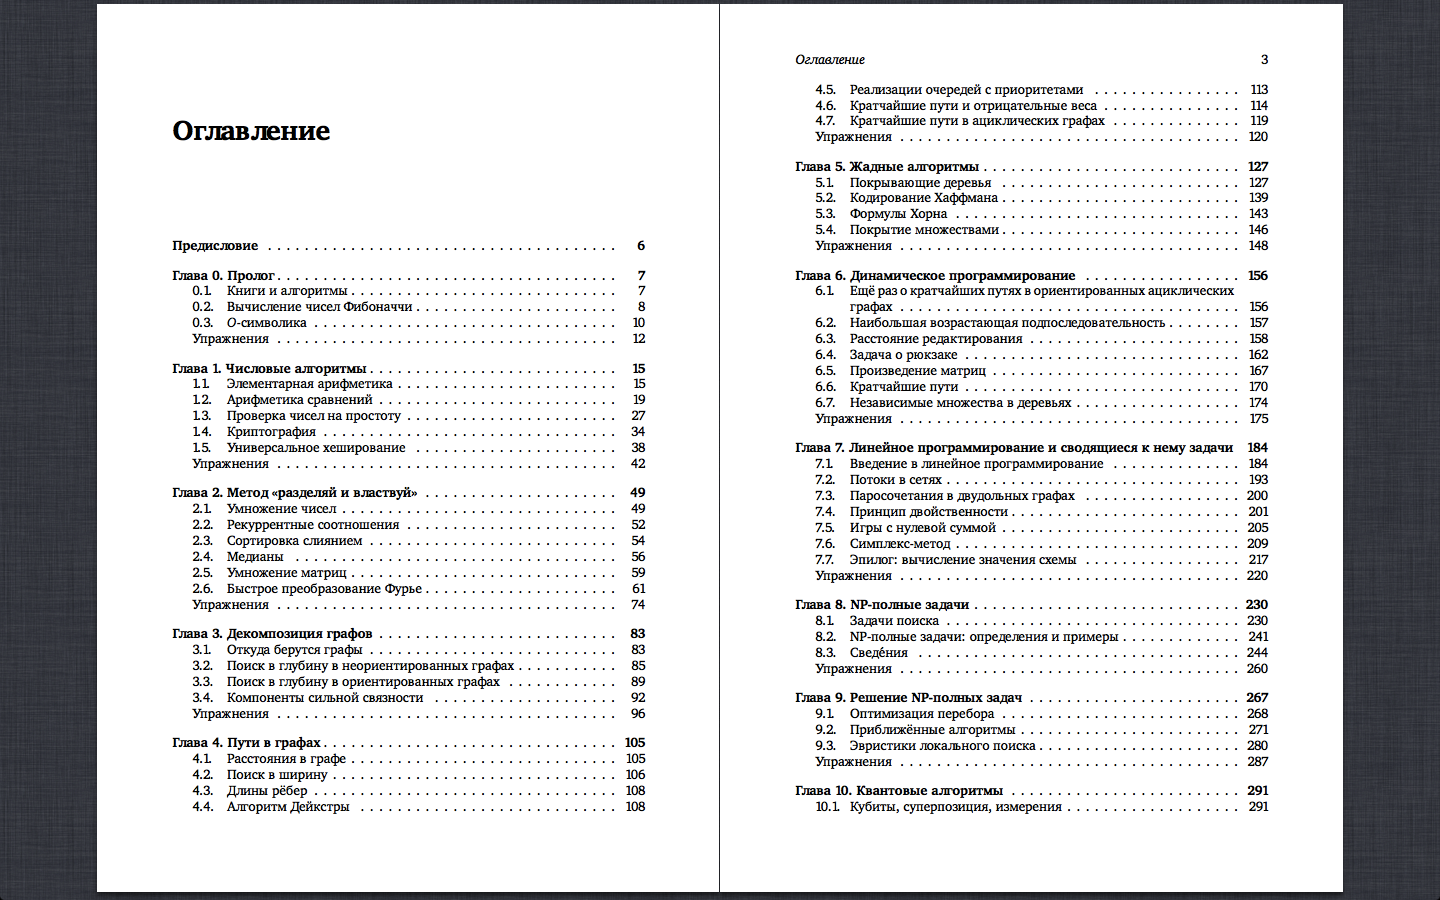
Рад сообщить, что вышел перевод отличнейшего учебника Дасгупты, Пападимитриу, Вазирани «Алгоритмы», над которым я работал последние несколько лет. В книге многие алгоритмы объяснены гораздо короче и проще, чем в других учебниках: с одной стороны, без излишнего формализа, с другой — без потери математической строгости. Откройте книгу на каком-нибудь известном вам алгоритме и убедитесь в этом. =)

В общем, угощайтесь: печатный вариант перевода, электронный вариант перевода (PDF), печатный вариант оригинала, электронный вариант оригинала (PDF).
Читать дальше →

Классификация с использованием муравьиного алгоритма

Время чтения4 мин
Охват и читатели22K
На хабре уже был рассмотрен муравьиный алгоритм, позволяющий используя простые правила решить задачу поиска оптимального маршрута. В данной статье рассмотрено применение этого алгоритма к задаче классификации.
Читать дальше →

Подглядываем за метаниями нейронной сети

Время чтения8 мин
Охват и читатели32K


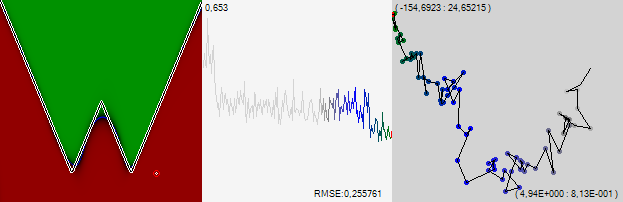
В комментариях к моей предыдущей статье о происходящем в нейронной сети проскользнула фраза, что, к сожалению, визуализация процессов обучения редко бывает возможна на реальных задачах с большими данными. Действительно очень жаль. Давайте же попытаемся это исправить. Под катом я предлагаю простую и, как ни удивительно, информативную визуализацию процесса обучения нейронной сети, не зависящую ни от характера задачи, ни от свойств самой сети, то есть доступную для сколь угодно сложной задачи.
Читать дальше, с картинками

Байес

Время чтения3 мин
Охват и читатели99K
В левой руке Морфеуса лежит 7 синих и 3 красных таблетки, а в правой 5 синих и 8 красных. Вы закрываете глаза и берете таблетку — она оказывается красной, однако вы не знаете из какой руки ее взяли. Какова вероятность, что вы взяли ее из правой руки?


image

17 апреля 1761 — день смерти Томаса Байеса.
Под катом результаты того, что есть в рунете, помимо стандартных вещей типа Теорема Байеса, Байесовская сеть, Наивный байесовский классификатор , Байесовская фильтрация спама
Читать дальше →

Интерпретация во время компиляции, или Альтернативное понимание лямбд в C++11

Время чтения22 мин
Охват и читатели33K
Yo dawg, I heard you like programming. So we put a language in you language, so you can program while you programНа Хабре недавно проскочила ещё одна статья про вычисления на шаблонах C++ от HurrTheDurr. В комментариях к ней лично я увидел вызов:

> С каждым новым релизом количество способов нетривиально вывихнуть себе мозг при помощи С++ продолжает увеличиваться)
> > Особенно, если не менять подход к реализации игрового поля и продолжать пытаться все вычисления выполнять не над константами, а над типами.


А так ли сложно будет написать универсальный вычислитель на типах, более удобный для программирования, чем клеточный автомат? Как оказалось, несложно; я в 30 раз больше времени потратил на эту статью, чем на написание и отладку собственно кода вычислителя.

Чуть раньше AveNat опубликовала введение в лямбда-исчисление в двух частях, так что вдохновение пришло мгновенно. Хотелось, чтобы можно было (образно) писать так:
#include <iostream>

#include <LC/kernel.h>
#include <LC/church_numerals.h>

int main()
{
    // Представление натуральных чисел в виде лямбда-абстракций
    typedef ChurchEncode<2> Two;    // 2 = λfx.f (f x)
    typedef ChurchEncode<3> Three;  // 3 = λfx.f (f (f x))

    // * = λab.λf.a (b f)
    typedef Lambda<'a', Lambda<'b', Lambda<'f',
                Apply<Var<'a'>, Apply<Var<'b'>, Var<'f'> > >
        > > > Multiply;

    // Вычисление (* 2 3)
    typedef Eval<Apply<Apply<Multiply, Two>, Three>> Output;

    // Переход обратно от лямбда-абстракций к натуральным числам
    typedef ChurchDecode<Output> Result;

    std::cout << Result::value;
}

А на выходе получать такое:
ilammy@ferocity ~ $ gcc cpp.cpp
ilammy@ferocity ~ $ ./a.out
6

Статья получилась несколько великоватой, так как мне хотелось рассказать обо всех интересных штуках, которые здесь используются. И ещё она требует базового набора знаний о лямбда-исчислении. Приведённых выше обзоров, среднего знания C++ (с шаблонами), и здравого смысла должно быть достаточно для понимания содержимого.

Под катом находится очередное прокомментированное конструктивное доказательство Тьюринг-полноты шаблонов C++ в виде compile-time интерпретатора бестипового лямбда-исчисления (плюс печеньки в виде макросов и рекурсии).
Читать дальше →

Откуда «мыло» в WPF и как с ним бороться

Время чтения21 мин
Охват и читатели84K


Это руководство для WPF-разработчиков, стремящихся добиться максимально чёткой картинки в своих приложениях. Графическая система WPF до мозга костей векторная, но конечным результатом её работы по-прежнему является растр. Если не уделить этому факту должного внимания, можно столкнуться с различными сортами «мыла» — паразитными артефактами растеризации. В такой ситуации важно не терять присутствия духа, причины их возникновения вполне рациональны, а методы борьбы достаточно просты и эффективны.
Читать дальше →

5 способов сравнить два байтовых массива. Сравнительное тестирование

Время чтения32 мин
Охват и читатели53K
секундомерВ результате профилирования моей софтины я сделал вывод о необходимости оптимизации функции сравнения буферов.
Т.к. CLR не предоставляет стандартного способа сравнить два куска памяти, то функция была написан на скорую руку самостоятельно (лишь бы работало).
Погуглив по фразе «Best Way to Compare Byte Arrays in .Net», я пришёл в замешательство: в абсолютном большинстве случаев люди предлагали использовать либо LINQ, либо Enumerable.SequenceEqual(), что практически одно и тоже. Даже на StackOverflow это был самый популярный ответ. Т.е. катастрофически популярно заблуждение вида:

«Compiler\run-time environment will optimize your loop so you don't need to worry about performance.» Отсюда.

Именно оно впервые навело меня на мысль написать этот пост.
Я провёл сравнительное тестирование пяти способов сравнения буферов, доступных из C#, и на основании результатов тестирования дал рекомендации в выборе способа.
Кроме того, я декомпилировал некоторые функции, и проанализировал код, генерируемый JIT-компилятором для конфигурации x86, а так же сравнил машинный код, генерируемый JIT-компилятором, с машинным кодом функции CRT аналогичного назначения.
Читать дальше →

Быстрая генерация массивов случайных чисел для задач имитационного моделирования, статистического оценивания и создания повторной выборки

Время чтения9 мин
Охват и читатели18K
Имитационное моделирование с использованием методов Монте-Карло в наше время используется практически во всех областях операционной деятельности, где требуется многократное принятие решений по итогам анализа поступающих из внешнего мира данных. При этом важную роль начинает играть качество, производительность и доступность генераторов случайных чисел, использующихся для придания абстрактному методу черт реальной задачи, решаемой специалистом. Как я недавно выяснил, этот вопрос начинает играть решающее значение при переходе к параллельному программированию… Вы тоже столкнулись с этой проблемой, и хотите знать, как в Windows можно быстро получить массивы случайных чисел с нужным распределением?
Читать дальше →

Делегаты и события в .NET

Время чтения26 мин
Охват и читатели244K
От переводчика. Судя по своему опыту, а также по опыту знакомых коллег-программистов, могу сказать, что для начинающего разработчика среди всех базовых функций языка C# и платформы .NET делегаты и события являются одними из наиболее сложных. Возможно, это из-за того, что необходимость делегатов и событий на первый взгляд кажется неочевидной, или же из-за некоторой путаницы в терминах. Поэтому я решил перевести статью Джона Скита, рассказывающую о делегатах и событиях на самом базовом уровне, «на пальцах». Она идеальна для тех, кто знаком с C#/.NET, однако испытывает затруднение в понимании делегатов и событий.

Представленный здесь перевод является вольным. Однако если под «вольным», как правило, понимают сокращённый перевод, с упущениями, упрощениями и пересказами, то здесь всё наоборот. Данный перевод является немного расширенной, уточнённой и обновлённой версией оригинала. Я выражаю огромную благодарность Сергею Теплякову aka SergeyT, который внёс неоценимый вклад в перевод и оформление данной статьи.


Люди часто испытывают затруднения в понимании различий между событиями и делегатами. И C# ещё больше запутывает ситуацию, так как позволяет объявлять field-like события, которые автоматически преобразуются в переменную делегата с таким же самым именем. Эта статья призвана прояснить данный вопрос. Ещё одним моментом является путаница с термином «делегат», который имеет несколько значений. Иногда его используют для обозначения типа делегата (delegate type), а иногда — для обозначения экземпляра делегата (delegate instance). Чтобы избежать путаницы, я буду явно использовать эти термины — тип делегата и экземпляр делегата, а когда буду использовать слово «делегат» — значит, я говорю о них в самом широком смысле.
Читать статью

Просто о make

Время чтения6 мин
Охват и читатели546K
Меня всегда привлекал минимализм. Идея о том, что одна вещь должна выполнять одну функцию, но при этом выполнять ее как можно лучше, вылилась в создание UNIX. И хотя UNIX давно уже нельзя назвать простой системой, да и минимализм в ней узреть не так то просто, ее можно считать наглядным примером количество- качественной трансформации множества простых и понятных вещей в одну весьма непростую и не прозрачную. В своем развитии make прошел примерно такой же путь: простота и ясность, с ростом масштабов, превратилась в жуткого монстра (вспомните свои ощущения, когда впервые открыли мэйкфайл).

Мое упорное игнорирование make в течении долгого времени, было обусловлено удобством используемых IDE, и нежеланием разбираться в этом 'пережитке прошлого' (по сути — ленью). Однако, все эти надоедливые кнопочки, менюшки ит.п. атрибуты всевозможных студий, заставили меня искать альтернативу тому методу работы, который я практиковал до сих пор. Нет, я не стал гуру make, но полученных мною знаний вполне достаточно для моих небольших проектов. Данная статья предназначена для тех, кто так же как и я еще совсем недавно, желают вырваться из уютного оконного рабства в аскетичный, но свободный мир шелла.
Читать дальше →

Применение паттерна CRTP в C#

Время чтения3 мин
Охват и читатели19K
CRTP (Curiously recurring template pattern) — идиома, ведущая свои корни из C++. Суть CRTP заключается в наследовании от шаблонного (generic) класса, шаблонным параметром которого является сам класс-наследник.

В коде это выглядит достаточно просто:
public class Base<T> where T : Base<T>
{ /* ... */ }
public class Derived : Base<Derived>
{ /* ... */ }

Такой подход позволяет оперировать типом класса-наследника (T) в коде базового класса, например, явно приводить this к типу T.

Рассмотрим пару вариантов практического применения.
Читать дальше →

Почему использование юнит тестов это отличная инвестиция в качественную архитектуру

Время чтения7 мин
Охват и читатели21K
На понимание факта, что юнит тесты это не только инструмент борьбы с регрессией в коде, но также и отличная инвестиция в качественную архитектуру меня натолкнул топик, посвященный модульному тестированию в одном англоязычном .net сообществе. Автора топика звали Джонни и он описывал свой первый (и последний) день в компании, занимавшейся разработкой программного обеспечения для предприятий финансового сектора. Джонни претендовал на вакансию разработчика модульных тестов и был расстроен низким качеством кода, который ему вменялось тестировать. Он сравнил увиденный им код со свалкой, набитой объектами, бесконтрольно создающими друг друга в любых непригодных для этого местах. Также он писал, что ему так и не удалось найти в репозитории абстрактные типы данных, код состоял исключительно из туго переплетенных в один клубок реализаций, перекрестно вызывающих друг друга. Джонни, понимая всю бесполезность применения практики модульного тестирования в этой компании, обрисовал ситуацию нанявшему его менеджеру и, отказавшись от дальнейшего сотрудничества, дал напоследок ценный, с его точки зрения, совет. Он посоветовал отправить команду разработчиков на курсы, где бы их смогли научить правильно инстанцировать объекты и пользоваться преимуществами абстрактных типов данных. Я не знаю, последовал ли менеджер совету (думаю, что нет), но если вам интересно, что имел в виду Джонни и как использование практик модульного тестирования может повлиять на качество вашей архитектуры, добро пожаловать под кат, будем разбираться вместе.
Читать дальше →

Объясняем бизнесу, почему у нас такие «фиговые» оценки

Время чтения3 мин
Охват и читатели36K
Далеко не все владельцы бизнеса, менеджеры продуктов и менеджеры по продажам, связанные с разработкой ПО, пришли на свою позицию из программистов. Этот пост в основном для них. Но, возможно, он будет полезен и разработчикам ПО, которым постоянно приходится отвечать им на два стандартных вопроса:

Почему ты не можешь дать точную оценку трудоемкости разработки?
Почему ты не можешь завершить все работы в два раза быстрее?

В одной серьезной компании, в которой я участвовал в создании нового направления бизнеса, заказной разработки ПО, я даже провел небольшой семинар, чтобы ответить на эти вопросы сразу всем людям бизнеса.
image
Вот краткие тезисы

Пробуем Audio API на примере написания визуализатора

Время чтения6 мин
Охват и читатели56K

Web Audio API для меня является одной из тех новинок, которыми сейчас напичканы браузеры и с которой хотелось подружиться поближе и хоть как-то проникнуться тем, что же можно с помощью этого натворить. Что бы проникнуться, я решил написать простенький визуализатор аудио.

Но прежде чем начать разбираться непосредственно с Audio API, нам необходимо набросать заготовку нашего визуализатора и делать мы будем это при помощи canvas.

Подробности

Пространственно-временная обработка изображений на GPU

Время чтения9 мин
Охват и читатели29K
Не так уж и давно стало популярным использовать видеокарты для вычислений. В один прекрасный день, несколько лет назад и я взглянул на новую, тогда, технологию CUDA. В руках была хорошая карточка по тем временам GTX8800, да и задачки для распараллеливания тоже были.
Кто работал с GPU, знает про объединение запросов, конфликт банков и как с этим бороться, а если не работал, то можно найти несколько полезных статей по основам программирования на CUDA[1]. Карта GTX8800, в некотором смысле, была хороша тем, что была одной из первых и поддерживала только первые версии CUDA, поэтому на ней было четко заметно, когда есть конфликты банков или запросы в глобальную память не объединяются, потому что время в этом случае увеличивалось в разы. Все это помогало лучше понять все правила работы с картой и писать нормальный код.
В новые модели добавляют все больше и больше функциональности, что облегчает и ускорят разработку. Появились атомарные операции, кеш, динамический параллелизм и т.д.
В посте я расскажу про пространственно-временную фильтрацию изображений и реализацию для compute capability = 1.0, и как можно ускорить получившийся результат за счет новых возможностей.
Временная фильтрация может пригодиться при наблюдении за спутниками или в прочих ситуациях фильтрации, когда требуется точное подавление фона.

Читать дальше →

Амортизационный анализ

Время чтения6 мин
Охват и читатели35K
Привет, Хабр!

Сегодня мы поговорим об амортизационном анализе. Сначала я расскажу, что это такое, и приведу игрушечный пример. А потом расскажу, как его применить для анализа системы непересекающихся множеств.

Читать дальше...

Информация

В рейтинге
Не участвует
Откуда
Москва, Москва и Московская обл., Россия
Работает в
Дата рождения
Зарегистрирован
Активность