Обновить
5

Пользователь

2
Подписчики
Отправить сообщение

QA на проде. Почему это круто

Время чтения5 мин
Охват и читатели34K
Многие считают тестирование на production окружении вредной практикой: оно не помогает предотвратить попадание проблем к конечным пользователям, а больше констатирует их наличие. Кроме этого, тестировщик отрывается от стандартного рабочего процесса и методик, применяемых на тестовом окружении. Меня зовут Оля Михальчук, я QA-инженер в финтех-компании ID Finance. В этом посте я расскажу почему тестирование на проде может существенно помочь вашему проекту.

image
Читать дальше →

Код живой и мёртвый. Часть первая. Объекты

Время чтения7 мин
Охват и читатели14K

Код — это мысль. Появляется задача, и разработчик думает, как её решить, как выразить требования в функциях и классах, как сдружить их, как добиться строгости и корректности и как подмастить бизнес. Практики, методики, принципы, шаблоны и подходы — всё нужно учесть и всё нужно помнить.


И вместе с этим мы видим повсеместную эпидемию менеджеров, хелперов, сервисов, контроллеров, селекторов, адаптеров, геттеров, сеттеров и другой нечисти: всё это мёртвый код. Он сковывает и загромождает.


Бороться предлагаю вот как: нужно представлять программы как текст на естественном языке и оценивать их соответственно. Как это и что получается — в статье.

Читать дальше →

Открытый урок «Feature Engineering на примере классического датасета Титаника»

Время чтения5 мин
Охват и читатели7.4K
И снова привет!

В декабре у нас стартует обучение очередной группы «Data scientist», поэтому открытых уроков и прочих активностей становится всё больше. Например, буквально на днях прошёл вебинар под длинным названием «Feature Engineering на примере классического датасета Титаника». Его провёл Александр Сизов — опытный разработчик, кандидат технических наук, эксперт по Machine/Deep learning и участник различных коммерческих международных проектов, связанных с искусственным интеллектом и анализом данных.

Открытый урок занял около полутора часов. В ходе вебинара преподаватель рассказал про подбор признаков, преобразование исходных данных (кодирование, масштабирование), настройку параметров, обучение модели и много чего ещё. В процессе проведения урока участникам показывалась тетрадь Jupyter Notebook. Для работы использовались открытые данные с платформы Kaggle (классический датасет про «Титаник», с которого многие начинают знакомство с Data Science). Ниже предлагаем видео и транскрипт прошедшего мероприятия, а тут можно забрать презентацию и коды в юпитеровском ноутбуке.

Гениальный нейробиолог, у которого, возможно, есть ключ к созданию настоящего искусственного интеллекта

Время чтения12 мин
Охват и читатели40K
Принцип свободной энергии Карла Фристона может быть наиболее всеобъемлющей идеей со времён теории естественного отбора Чарльза Дарвина. Но чтобы понять его, необходимо заглянуть в разум самого Фристона.


Когда король Англии Георг III к концу правления начал проявлять признаки острого маниакального поведения, слухи о безумии короля быстро распространились в народе. В одной легенде говорится, что Георг попытался пожать руку дереву, считая, что видит перед собой прусского короля. В другой описывалось, как его тайно перевезли в здание на Квин-сквер лондонского района Блумсбери, чтобы там лечить его вместе с его подданными. Также утверждается, что его супруга, королева Шарлотта Мекленбург-Стрелицкая, арендовала целый подвал в местном пабе, чтобы хранить там припасы для кормления короля, пока он находился под опекой врачей.
Читать дальше →

Как Яндекс.Такси прогнозирует время подачи автомобиля с помощью машинного обучения

Время чтения6 мин
Охват и читатели28K
Представьте, что вам надо вызвать такси. Вы открываете приложение, видите, что машина приедет минут через семь, нажимаете «Заказать» — и… автомобиль в 15 минутах от вас, если вообще найден. Согласитесь, неприятно?

Под катом поговорим о том, как методы машинного обучения помогают Яндекс.Такси более качественно прогнозировать ETA (Estimated Time of Arrival — ожидаемое время прибытия).


Читать дальше →

Как устроен скоринг в индустрии каршеринга. Часть 1. Обзор популярных инструментов на реальных данных

Время чтения5 мин
Охват и читатели11K
Каршеринг, несмотря на свою молодость, — одно из самых активно развивающихся направлений в автобизнесе России. С момента запуска первой компании прошло 5 лет, и сегодня на рынке работают более 25 операторов, специализирующихся на краткосрочной аренде. С развитием каршеринга накапливаются данные о пользователях, и вот уже у каршеринга, как у банков, появляется некая система скоринга клиентов. Она также опирается на возраст, пол, стаж вождения, однако здесь рассматривается не история ваших кредитов, а история поездок. Одной из целей такого скоринга, помимо платежеспособности, валидации водительского удостоверения, штрафов, является предсказание вероятности ДТП для конкретного водителя.


В этой статье мы разберем логику работы алгоритмов скоринга пользователей каршеринга, которые будут опираться только на возраст и стиль вождения. Помимо этих параметров, и для получения более точных результатов, могут быть использованы — социальный статус, поездки с детьми, активность в социальных сетях и информация с камеры в салоне автомобиля. Однако, сегодня остановимся на двух базовых — возраст и стиль вождения.

Отметим, что в статье мы продемонстрируем логику работы скоринга на примере водительской активности 50 000 пользователей и 260 000 поездок. Все данные были анонимизированны. Кроме того, мы использовали данные по 220 ДТП, совершенных с Москве и МО.
Читать дальше →

Архитектуры нейросетей

Время чтения12 мин
Охват и читатели75K
Перевод Neural Network Architectures

Алгоритмы глубоких нейросетей сегодня обрели большую популярность, которая во многом обеспечивается продуманностью архитектур. Давайте рассмотрим историю их развития за последние несколько лет. Если вас интересует более глубокий анализ, обратитесь к этой работе.


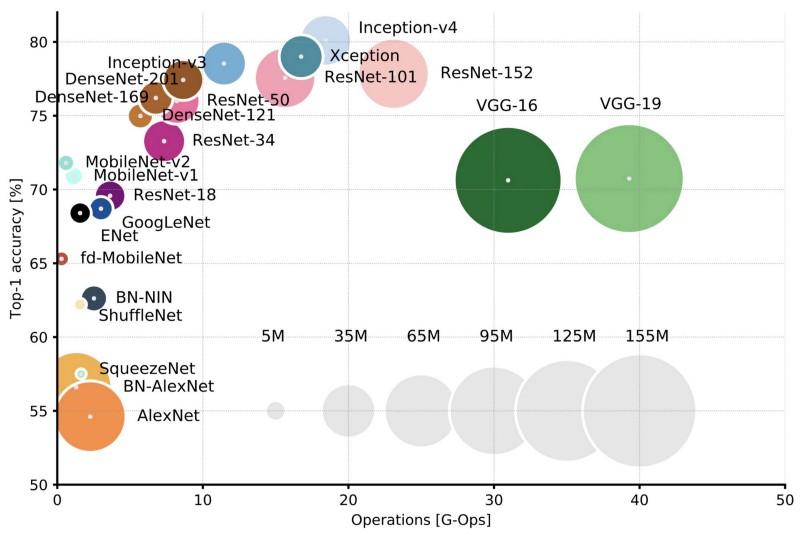
Сравнение популярных архитектур по Top-1 one-crop-точности и количеству операций, необходимых для одного прямого прохода. Подробнее здесь.
Читать дальше →

Принципы SOLID, о которых должен знать каждый разработчик

Время чтения11 мин
Охват и читатели467K
Объектно-ориентированное программирование принесло в разработку ПО новые подходы к проектированию приложений. В частности, ООП позволило программистам комбинировать сущности, объединённые некоей общей целью или функционалом, в отдельных классах, рассчитанных на решение самостоятельных задач и независимых от других частей приложения. Однако само по себе применение ООП не означает, что разработчик застрахован от возможности создания непонятного, запутанного кода, который тяжело поддерживать. Роберт Мартин, для того, чтобы помочь всем желающим разрабатывать качественные ООП-приложения, разработал пять принципов объектно-ориентированного программирования и проектирования, говоря о которых, с подачи Майкла Фэзерса, используют акроним SOLID.


Материал, перевод которого мы сегодня публикуем, посвящён основам SOLID и предназначен для начинающих разработчиков.
Читать дальше →

Нечестная игра, или как нас обманывают организаторы розыгрышей

Время чтения4 мин
Охват и читатели68K

Однажды, солнечным весенним утром, почитывая городской форум, я наткнулся на ссылку с простенькой игрой от известной торговой сети. Игра (акция), посвящённая чемпионату мира по футболу, представляла собой незамысловатое поле три на три, заполненное футбольными мячами. Кликая по мячу, мы открывали картинку с тем или иным товаром. При открытии трёх одинаковых картинок участнику гарантировалось бесплатное получение данного товара в одном из магазинов сети. Также под одним из мячей имелось изображение красной карточки, открытие которой означало конец игры.
Читать дальше →

Искусственный интеллект и нейросети для .NET-разработчиков

Время чтения26 мин
Охват и читатели58K

Искусственный интеллект сейчас является одной из самых обсуждаемых тем и главным двигателем цифровой трансформации бизнеса. Стратегия Microsoft в области ИИ включает в себя демократизацию ИИ для разработчиков, т.е. предоставление простых в использовании фреймворков и сервисов для решения интеллектуальных задач. В этой статье рассказывается, как .NET-разработчики могут использовать возможности ИИ в своих проектах: начиная от готовых когнитивных сервисов, работающих в облаке, заканчивая обучением нейросетей на .NET-языках и запуском сложных нейросетевых моделей на компактных устройствах типа Raspberry Pi.


Прототипом статьи послужил доклад Дмитрия Сошникова на конференции DotNext 2017 Moscow. Дмитрий — технологический евангелист компании Майкрософт, занимается популяризацией современных технологий разработки программного обеспечения среди начинающих разработчиков. Специализируется в области интернета вещей, в разработке универсальных приложений Windows, в области функционального программирования и на платформе .NET (F#, Roslyn). Лично провел несколько десятков хакатонов по всей России, помогал многим студенческим стартапам начать свои проекты в различных областях. Доцент, к.ф.-м.н., ведет занятия в МФТИ и МАИ, член Российской ассоциации искусственного интеллекта, летом — ведущий кафедры компьютерных технологий детского лагеря ЮНИО-Р.


Осторожно, трафик! В этом посте присутствует огромное количество картинок — слайдов и скриншотов с видео в формате 720p.

Читать дальше →

Работа с Anaconda на примере поиска корреляции курсов криптовалют

Время чтения11 мин
Охват и читатели78K


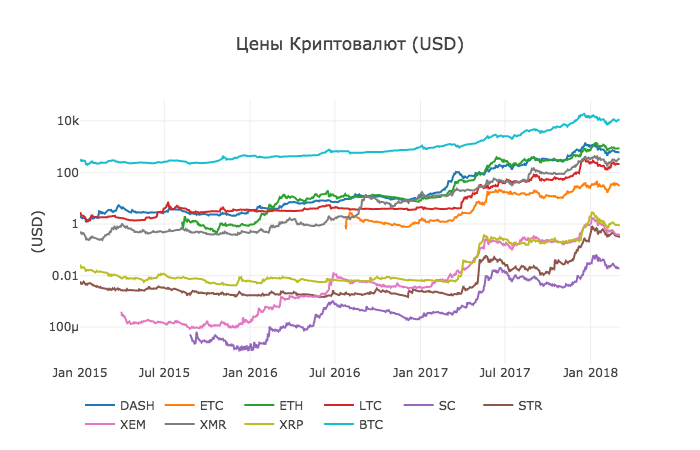
Цель этой статьи — предоставить легкое введение в анализ данных с использованием Anaconda. Мы пройдем через написание простого скрипта Python для извлечения, анализа и визуализации данных по различным криптовалютам.
Читать дальше →

.NET Security — это просто

Время чтения17 мин
Охват и читатели18K

Представляем интервью с ведущими экспертами в области безопасности: Владимиром Кочетковым (руководителем отдела исследований анализа защищенности приложений в Positive Technologies) и Михаилом Щербаковым (независимым разработчиком и консультантом в области информационной безопасности).


О чем эта статья? Процитирую одну из реплик Михаила:


«Разработка защищенного приложения – это частный случай разработки приложения, не содержащего ошибок вообще. Кроме этого, ваше приложение использует сторонние библиотеки, защищенность которых тоже не гарантируется, далее оно выполняется на ОС и железе. Часто мы даже не можем сказать, на какой именно ОС и на каком железе. И все это со временем изменяется!»


Читать дальше →

Краткий курс машинного обучения или как создать нейронную сеть для решения скоринг задачи

Время чтения28 мин
Охват и читатели237K
image

Мы часто слышим такие словесные конструкции, как «машинное обучение», «нейронные сети». Эти выражения уже плотно вошли в общественное сознание и чаще всего ассоциируются с распознаванием образов и речи, с генерацией человекоподобного текста. На самом деле алгоритмы машинного обучения могут решать множество различных типов задач, в том числе помогать малому бизнесу, интернет-изданию, да чему угодно. В этой статье я расскажу как создать нейросеть, которая способна решить реальную бизнес-задачу по созданию скоринговой модели. Мы рассмотрим все этапы: от подготовки данных до создания модели и оценки ее качества.

Если тебе интересно машинное обучение, то приглашаю в «Мишин Лернинг» — мой субъективный телеграм-канал об искусстве глубокого обучения, нейронных сетях и новостях из мира искусственного интеллекта.

Вопросы, которые разобраны в статье:

• Как собрать и подготовить данные для построения модели?
• Что такое нейронная сеть и как она устроена?
• Как написать свою нейронную сеть с нуля?
• Как правильно обучить нейронную сеть на имеющихся данных?
• Как интерпретировать модель и ее результаты?
• Как корректно оценить качество модели?
Поехали!

Что должен знать о поиске каждый разработчик

Время чтения18 мин
Охват и читатели26K

Хотите внедрить или доработать функцию поиска? Вам сюда.


Спросите разработчика: «Как бы вы реализовали функцию поиска в своем продукте?» или «Как создать поисковую систему?». Вероятно, в ответ вы услышите что-нибудь такое: «Ну, мы просто запустим кластер Elasticsearch: с поиском сегодня всё просто».

Но так ли это? Во многих современных продуктах по-прежнему не лучшим образом реализован поиск. Настоящий специалист по поисковым системам скажет вам, что лишь немногие разработчики глубоко понимают, как работает поиск, а ведь это знание часто необходимо для улучшения качества поиска.

Есть множество программных пакетов с открытым исходным кодом, проведено немало исследований, однако лишь немногие избранные понимают, как нужно делать функциональный поиск. Как ни забавно, но если поискать в Интернете связанную с реализацией поиска информацию, вы не найдете актуальных и содержательных обзоров.

Цель статьи


Этот текст можно считать собранием ценных идей и ресурсов, которые могут помочь в создании функции поиска. Статья, безусловно, не претендует на исчерпывающую полноту, однако я надеюсь, что ваши отзывы помогут ее доработать (оставляйте замечания в комментариях или свяжитесь со мной).

Основываясь на опыте работы с универсальными решениями и узкоспециализированными проектами самого разного масштаба (в компаниях Google, Airbnb и нескольких стартапах), я расскажу о некоторых популярных подходах, алгоритмах, методах и инструментах.

Недооценка и непонимание масштабов и сложности задачи поиска могут привести к тому, что у пользователей останутся плохие впечатления, разработчики потратят время впустую, а продукт провалится.

Переведено в Alconost
Читать дальше →

C#: требования и рекомендации по написанию кода

Время чтения5 мин
Охват и читатели156K
Не так давно в комментариях к топику AlexS высказал идею использования соглашения об оформлении на Хабре кода примеров темы .Net написанных на C#.

Я немного поизучал имеющиеся предложения из этих источников:
submain.com/blog/FreeCVBNETCodingGuidelinesEbookDownload.aspx
idesign.net/idesign/DesktopDefault.aspx
и скомпилировал черновик который описывает самые базовые правила оформления кода написанного на C#.

Предлагаю:
— обсудить этот черновик;
— внести в него все необходимые изменения;
— утвердить как стандарт написания C# кода на Хабре.
Более того, предлагаю создать документ, который можно было бы предложить как рекомендации habrahabr comunity для всех других программистов C#.

Под катом вы найдете текст черновика. Предлагаю всем желающим обсудить его и подвергнуть надлежащей правке.

Читать дальше →

Рекомендации по написанию кода на C# от Aviva Solutions

Время чтения40 мин
Охват и читатели85K
Представляю вашему вниманию перевод документа "Coding Guidelines for C# 3.0, 4.0 and 5.0".

Целью создания этого списка правил является попытка установить стандарты написания кода на C#, которые были бы удобными и практичными одновременно. Само собой, мы практикуем то, что создали. Эти правила являются одним из тех стандартов, которые лежат в основе нашей ежедневной работы в AvivaSolutions. Не все эти правила имеют четкое обоснование. Некоторые из них просто приняты у нас в качестве стандартов.

Статический анализатор кода VisualStudio (который также известен как FxComp) и StyleCop могут автоматически применять многие из правил кодирования и оформления путем анализа скомпилированных сборок. Вы можете сконфигурировать их таким образом, чтобы анализ производился во время компиляции или был неотъемлемой частью непрерывной или ежедневной сборки. Этот документ просто добавляет дополнительные правила и рекомендации, но его вспомогательный сайт www.csharpcodingguidelines.com предоставляет список правил анализа кода, необходимых в зависимости от того, с какой базой кода вы работаете.
Читать дальше →

Telegram-bot: моя история. Часть первая

Время чтения6 мин
Охват и читатели61K

Доброго времени суток, Хабрахабр! Целью статьи является рассказать начинающим программистам о возможности не только разработать что-то интересное на основе несложных инструментов, но и разместить проект в общий доступ, а при усердных стараниях увидеть, что не только автор может оценить потраченные усилия.

Ближе к делу — мой первый пет-проект, решающий проблему доступа к расписанию университета на мобильных устройствах через Telegram, с аудиторией более, чем сто пятьдесят уникальных посетителей в сутки. Несмотря на то, что цифра не является заоблачной, это совсем неплохой результат, выступающий последующей долговременной средой настоящей боевой разработки, учитывая все возможные особенности, и сопровождения продукта длительный период, что бесспорно полезно и ценно для каждого разработчика.
Читать дальше →

Анализ взаимосвязи навыков с помощью графов в R

Время чтения6 мин
Охват и читатели8.8K

Интересно, но такая область как профессиональное развитие остается немного в стороне от шума из-за data science. Стартапы в сфере HRtech только начинают наращивать обороты и увеличивать свою долю, замещая традиционный подход в сфере работы с профессионалами или, теми, кто хочет стать профессионалом.


Сфера HRtech очень разнообразна и включает в себя автоматизацию найма сотрудников, развитие и коучинг, автоматизацию внутренних HR процедур, отслеживание рыночных зарплат, трекинг кандидатов, сотрудников и многое другое. Данное исследование помогает с помощью методов анализа данных ответить на вопрос как взаимосвязаны навыки, какие есть специализации, какие навыки более популярны, а какие навыки следует изучить следующим.

Читать дальше →

Получаем информацию о рабочем месте пользователя

Время чтения8 мин
Охват и читатели8.5K

image


0. Предисловие


Все началось с очередного звонка пользователя, который с гордостью сообщил сообщил: — „Всё сломалось“, и с моих „потуг“ удаленно найти PC, на котором работает данный пользователь..


Решение планировало быть простым до безумия и собираться на коленке. Так-как большинство наших сотрудников работают под "виндой" и все рабочие станции входят в домен, был задан вектор поиска решения. Изначально, планировалось написать небольшой скрипт. В его задачу входило собрать базовую информацию о системе и сотруднике, который за этой системой работает. Набор информации минимальный. А именно: логин, название рабочей станции и ее ip. Результат работы сохраняем на сервере, а сам скрипт "вешаем" на пользователя через GPO.


В такой реализации были существенные недостатки в виде:


  • получить информацию можно было бы только зайдя на сервер (его сетевую папку где хранился файл), что не всегда удобно
  • поддерживать файл в актуальном состоянии
  • получать данные в реальном времени

После раздумий пришло решение: использовать бота в Telegram. Прибегнув к небольшой ловкости рук, скрипт был переписан в небольшую программку для отправки информации в чат, за место "скучной" записи в файл на сервере. (+ были добавлены еще некоторые параметры которые оправлялись боту)

Читать дальше →

Создание Web API приложения с использованием .NET Core + MongoDB .NET Driver

Время чтения16 мин
Охват и читатели33K
Как вы уже знаете, MongoDB — это одно из наиболее развитых, open-source NoSQL решений, которое представляет собой документо-ориентированную базу данных, является кросс-платформенным, а также обеспечивает высокую производительность, доступность и простоту масштабирования.

В современных open-source веб-приложениях использование NoSQL решений получило свою популярность в связи с их нереляционным поведением. В данной статье шаг за шагом мы реализуем простое ASP.NET Core Web API приложение «записной книжки», которое будет поддерживать операции CRUD применимо к коллекции в MongoDB.
Читать дальше →

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность

Специализация

Фронтенд разработчик, Веб-разработчик
Ведущий
Git
JavaScript
TypeScript
React
Веб-разработка