Обновить
25
Programmer@Programmer

Пользователь

3
Подписчики
Отправить сообщение

Bind, Call и Apply в JavaScript

Время чтения3 мин
Охват и читатели122K
От переводчика:
Прошу принять во внимание, что приведенный здесь код, возможно, не является хорошими практиками. Тем не менее разбор сниппета из этого поста может оказаться еще одним поводом окунуться в функциональный JavaScript.


Недавно я увидел изящный JS сниппет в этом твите.
var bind = Function.prototype.call.bind(Function.prototype.bind); // #fp

Взглянув на него, я смог догадаться, что он делает. Он превращает x.y(z) в y(x, z). Радуясь как ребенок, я показал его своим коллегам. Они спросили меня, что же тут происходит. Я открыл рот, чтобы объяснить и… не смог сказать ни слова. Я развернулся и ушел.
Читать дальше →

Переключения между провайдерами интернета на Debian 7

Время чтения7 мин
Охват и читатели21K
В последних дистрибутивах Linux довольно много всяких полезных плюшек в папке /etc, однако мало кто ими грамотно пользуется. Здесь я расскажу про часть из них применительно к последней стабильной версии Debian, и приведу пример реализации переключения на резервный канал.
Все попытки найти банальную автопереключалку приводили к связке из 1-2 скриптов, написанным «под себя» и мало поддающимися настройке. К dhcp не был привязан ни один из них, а значит любые манипуляции на стороне провайдера требовали вмешательство в настройки. Сам писал такие в свое время, но вот теперь решил на новой системе оформить это красиво – так, как это задумывали разработчики Debian, а именно – меняем файлы конфигурации, добавляем свои скрипты и не трогаем те, что нам предоставила система.
Подробности

Приручаем конфигурации веб-приложений с помощью node-convict

Время чтения6 мин
Охват и читатели9.9K
От переводчика: Это седьмая статья из цикла о Node.js от команды Mozilla Identity, которая занимается проектом Persona.


В этой статье из цикла о Node.js мы рассмотрим модуль node-convict, который помогает управлять конфигурациями приложений Node.js. Он предоставляет прозрачные настройки по умолчанию и встроенную типизацию, чтобы было легче находить и исправлять ошибки.

Постановка задачи


Есть две основные проблемы, которые создают необходимость в конфигурации приложений:

  • Большинство приложений могут работать в нескольких окружениях, имеющих разные параметры конфигурации.
  • Включение учётных данных и другой конфиденциально информации в код приложения может создавать проблемы.

Эти проблемы можно решить, инициализируя некоторые переменные в зависимости от текущего окружения и используя переменные окружения для хранения конфиденциальных данных. Общепринятый в среде Node.js шаблон для реализации этого подхода состоит в создании модуля, который экспортирует конфигурацию:

var conf = {
  // окружение приложения - 
  // "production", "development", или "test
  env: process.env.NODE_ENV || "development",
 
  // IP адрес
  ip: process.env.IP_ADDRESS || "127.0.0.1",
 
  // Порт
  port: process.env.PORT || 0,
 
  // Настройки БД
  database: {
    host: process.env.DB_HOST || "localhost:8091"
  }
};
 
module.exports = conf;

Это работает неплохо, но есть ещё пара проблем:

  • Что если в конфигурации указаны некорректные данные? Мы можем сберечь время и нервы, обнаруживая ошибки как можно раньше.
  • Насколько легко разобраться в конфигурации администраторам, тестировщикам и другим членам большой команды, когда им надо менять настройки или искать дефекты? Более декларативный и лучше документированный формат сделал бы их жизнь легче.

Читать дальше →

CornerJS, или директивы «как в AngularJS», только лучше

Время чтения4 мин
Охват и читатели13K
image

Постоянно создавая сложные веб-проекты с нуля, начинаешь замечать, что примерно треть — а в некоторых случаях половина и больше — кода в действительности автономна, и привязана только к определенному DOM-элементу.

В рабочих проектах это может сводиться к чему-то вроде

function pageChange(){
    if ($(‘.element-carousel').length>0) {$('.element-carousel').initCarousel()}
    if ($('.element-scrollbox').length>0) {$('.element-scrollbox').initScrollbox()}
…


А может и не сводиться, и в каждом условном контроллере (колбэке на смену определенной страницы) мы вызываем код, связанный с определенными элементами.

Знакомо? Думаю, да. Считаете ли вы этот подход неправильным? Если первый ответ – да, то уверен, что и второй тоже да.

Хотите узнать, как можно сделать правильно, аккуратно и красиво?
Читать дальше →

Дайджест интересных новостей и материалов из мира PHP за последние две недели № 27 (22 сентября — 6 октября 2013)

Время чтения6 мин
Охват и читатели21K


Предлагаем вашему вниманию очередную подборку с ссылками на новости и материалы.

Кстати, вчера исполнился ровно год с момента публикации первого PHP-дайджеста на Хабре. Огромное спасибо всем, кто так или иначе помогал создавать дайджесты, спасибо разработчикам за замечательные инструменты, авторам за их полезные статьи, а главное спасибо вам за то, что до сих пор читаете!
Читать дальше →

ARPU, или Несколько десятых доллара

Время чтения3 мин
Охват и читатели33K
ARPU – average revenue per user, или «средняя выручка с пользователя». Если вы считаете, что этот показатель высчитывается через деление всей выручки на все инсталлы в срок с момента релиза и на сегодняшний день, то эта статья для вас.

Многие из-за нехватки знаний, а может, и из-за желания упростить себе работу, пытаются посчитать один из важнейших параметров игры по вышеприведенной схеме. И это неправильно. Особенно, когда LifeTime (время жизни игрока в проекте) пользователя меньше рассматриваемого периода в 2 раза или менее.
Читать дальше →

Тонкости благополучного git-merge

Время чтения8 мин
Охват и читатели391K

Вступительное слово


Считается, что «киллер фичей» СКВ Git является легковесное ветвление. Я ощутил это преимущество в полной мере, ведь я перешел на Git с SVN, где ветвление было достаточно дорогим процессом: для создания ветки нужно было скопировать весь рабочий каталог. В Git все проще: создание ветки подразумевает лишь создание нового указателя на определенный коммит в папке .git/refs/heads, который является файлом с 40 байтами текста, хешем коммита.

Основными командами пользовательского уровня для ветвления в Git являются git-branch, git-checkout, git-rebase, git-log и, конечно же, git-merge. Для себя я считаю git-merge зоной наибольшей ответственности, точкой огромной магической энергии и больших возможностей. Но это достаточно сложная команда, и даже достаточно длительный опыт работы с Git порой бывает недостаточным для освоение всех ее тонкостей и умения применить ее наиболее эффективно в какой-либо нестандартной ситуации.

Попробуем же разобраться в тонкостях git-merge и приручить эту великую магию.

Здесь я хочу рассмотреть только случай благополучного слияния, под которым я понимаю слияние без конфликтов. Обработка и разрешение конфликтов — отдельная интересная тема, достойная отдельной статьи. Я очень рекомендую так же ознакомиться со статьей Внутреннее устройство Git: хранение данных и merge, содержащей много важной информации, на которую я опираюсь.
Читать дальше →

Нагружаем Node под завязку (2-я из 12 статей о Node.js от команды Mozilla Identity)

Время чтения7 мин
Охват и читатели19K
От переводчика: Это вторая статья из цикла о Node.js от команды Mozilla Identity, которая занимается проектом Persona. Эта статья написана по мотивам выступления Ллойда Хилайеля на конференции Node Philly 2012 в Филадельфии.


Процесс Node.js выполняется на единственном ядре процессора, так что построение масштабируемого сервера на Node требует особой заботы. Благодаря возможности писать нативные расширения и продуманному набору API для управления процессами, есть несколько разных способов заставить Node выполнять код параллельно. Мы рассмотрим их в этой статье.

Кроме того, мы представим модуль compute-cluster — маленькую библиотеку, которая облегчает управление коллекцией процессов для выполнения распределённых вычислений.

Постановка задачи


Для Persona нам было необходимо создать сервер, который справился бы с обработкой множества запросов со смешанными характеристиками. Мы выбрали для этой цели Node.js. Нам надо было обрабатывать два основных типа запросов: «интерактивные», которые не требовали сложных вычислений и должны были выполняться быстро, чтобы интерфейс приложения был отзывчивым, и «пакетные», которые отнимали примерно пол-секунды процессорного времени и могли быть ненадолго отложены без ущерба для удобства пользователя.

В поисках наилучшей архитектуры приложения мы долго и тщательно обдумывали способы обработки этих типов запросов с учётом юзабилити и стоимости масштабирования и в конце концов сформулировали четыре основных требования:

  • Насыщение. Наше решение должно было использовать все доступные ядра процессора.
  • Отзывчивость. Пользовательский интерфейс должен оставаться отзывчивым. Всегда.
  • Отказоустойчивость. Когда нагрузка зашкаливает, мы должны нормально обслужить столько клиентов, сколько сможем, а остальным показать сообщение об ошибке.
  • Простота. Решение должно легко и постепенно интегрироваться в уже работающий сервер.


Вооружившись этими требованиями, мы можем осмысленно сравнивать разные подходы.
Читать дальше →

Охотимся за утечками памяти в Node.js (1-я из 12 статей о Node.js от команды Mozilla Identity)

Время чтения7 мин
Охват и читатели27K
От переводчика: Это первая статья из цикла о Node.js от команды Mozilla Identity, которая занимается проектом Persona. Как клиентская, так и серверная часть Persona написаны на JavaScript. В ходе работы команда проекта создала несколько инструментов на все случаи жизни — от локализации до отладки, управления зависимостями и многого другого. В этой серии статей разработчики Mozilla делятся с сообществом своим опытом и этими инструментами, которые пригодятся любому, кто пишет высоконагруженный сервис на Node.js.

Первая статья цикла посвящена распространённой проблеме Node.js — утечкам памяти, особенностям утечек в высоконагруженных проектах и библиотеке node-memwatch, которая помогает найти и устранить такие утечки в Node.


Зачем заморачиваться?


Вы можете спросить, зачем вообще отслеживать утечки памяти? Неужели нет более важных дел? Почему бы просто не перезапускать процесс время от времени, или просто добавить памяти на сервер? Есть три причины, по которым устранять утечки всё-таки важно:

  1. Возможно, вы не сильно переживаете об утечках памяти, но этого нельзя сказать о V8 (движок JavaScript на котором работает Node). Чем больше памяти занято, тем активнее работает сборщик мусора, замедляя ваше приложение. Так что в Node утечки напрямую вредят производительности.
  2. Утечки могут привести к другим проблемам. Протекающий код может блокировать ограниченные ресурсы. У вас могут закончиться файловые дескрипторы или вы вдруг не сможете открыть ещё одно соединение с БД. Такие проблемы могут возникнуть задолго до того, как кончится память, но обрушат ваше приложение ничуть не хуже.
  3. Рано или поздно ваше приложение упадёт. И это наверняка случится во время наплыва посетителей. Вас все засмеют и будут писать про вас гадости на Hacker News.

Откуда доносится звук падающих капель?

Linux pipes tips & tricks

Время чтения8 мин
Охват и читатели215K

Pipe — что это?


Pipe (конвеер) – это однонаправленный канал межпроцессного взаимодействия. Термин был придуман Дугласом Макилроем для командной оболочки Unix и назван по аналогии с трубопроводом. Конвейеры чаще всего используются в shell-скриптах для связи нескольких команд путем перенаправления вывода одной команды (stdout) на вход (stdin) последующей, используя символ конвеера ‘|’:
cmd1 | cmd2 | .... | cmdN

Например:
$ grep -i “error” ./log | wc -l
43

grep выполняет регистронезависимый поиск строки “error” в файле log, но результат поиска не выводится на экран, а перенаправляется на вход (stdin) команды wc, которая в свою очередь выполняет подсчет количества строк.

Логика


Конвеер обеспечивает асинхронное выполнение команд с использованием буферизации ввода/вывода. Таким образом все команды в конвейере работают параллельно, каждая в своем процессе.

Размер буфера начиная с ядра версии 2.6.11 составляет 65536 байт (64Кб) и равен странице памяти в более старых ядрах. При попытке чтения из пустого буфера процесс чтения блокируется до появления данных. Аналогично при попытке записи в заполненный буфер процесс записи будет заблокирован до освобождения необходимого места.
Важно, что несмотря на то, что конвейер оперирует файловыми дескрипторами потоков ввода/вывода, все операции выполняются в памяти, без нагрузки на диск.
Вся информация, приведенная ниже, касается оболочки bash-4.2 и ядра 3.10.10.

Простой дебаг


Утилита strace позволяет отследить системные вызовы в процессе выполнения программы:
$ strace -f bash -c ‘/bin/echo foo | grep bar’
....
getpid() = 13726                   <– PID основного процесса
...
pipe([3,  4])                       <– системный вызов для создания конвеера
....
clone(....) = 13727                <– подпроцесс для первой команды конвеера (echo)
...
[pid 13727] execve("/bin/echo",  ["/bin/echo",  "foo"],  [/* 61 vars */] 
.....
[pid 13726] clone(....) = 13728    <– подпроцесс для второй команды (grep) создается так же основным процессом
...
[pid 13728] stat("/home/aikikode/bin/grep",   
...
Видно, что для создания конвеера используется системный вызов pipe(), а также, что оба процесса выполняются параллельно в разных потоках.
Читать дальше →

JavaScript обёртка скроллбара в виде jQuery плагина

Время чтения6 мин
Охват и читатели68K
Проблема стилизации скроллбара браузера до сих пор актуальна, несмотря на огромное количество скриптов, предназначенных для решения данной задачи. Рассмотрим реализацию стилизуемого скроллбара, максимально приближенного к родному поведению браузера.

Существует два основных подхода для стилизации скроллбара средствами HTML/CSS, каждый из которых имеет свои плюсы и минусы:

  • Эмуляция скролла средствами JavaScript
  • JavaScript обёртка над родным скроллом

Читать дальше →

Дайджест интересных новостей и материалов из мира PHP за последние две недели №16 (22.04.2013 — 06.05.2013)

Время чтения5 мин
Охват и читатели22K


Предлагаем вашему вниманию очередную подборку с ссылками на новости и материалы.

Приятного чтения!
Читать дальше →

Phalcon 1.1 beta

Время чтения4 мин
Охват и читатели12K

После успешного релиза PHP-фреймворка Phalcon 1.0, команда разработчиков продолжает работать над его развитием. В этой статья я хочу осветить наиболее интересные фичи, представленные в версии 1.1.0 BETA


Читать дальше →

Дайджест интересных новостей и материалов из мира PHP за последние две недели №15 (08.04.2013 — 22.04.2013)

Время чтения6 мин
Охват и читатели23K


Предлагаем вашему вниманию очередную подборку с ссылками на новости и материалы.

Приятного чтения!
Читать дальше →

Сбор расширенной статистики работы апстрима с помощью nginx-sla

Время чтения8 мин
Охват и читатели17K

Введение


Повышение качества обслуживания клиентов неизменно приводит к более высокой их лояльности. Причем не только в смысле приверженности определенному онлайн-продукту, но и в смысле терпимости к его недостаткам, при условии, конечно, что достоинства – скорость, юзабилити, функциональность и т.д. – их перевешивают.

Измерить качество обслуживания напрямую мы, конечно, не можем, однако даже такую эфемерную величину в принципе можно свести к набору количественных характеристик, так или иначе косвенно отражающихся на качестве. Прибыль, число клиентов, процент конвертированных лидов (leads – зарегистрировавшиеся или заинтересованные пользователи) и т.д. – все это вполне объективные показатели. Кроме того, эти величины могут быть включены в систему контроля эффективности работы в качестве KPI – ключевых показателей эффективности.

С нашей, инженерной точки зрения подобными характеристиками являются время ответа и HTTP-код ответа апстрима. Действительно, дизайн, функциональность продукта, маркетинговые усилия и прозвон клиентов находятся вне зоны нашей компетенции. Следовательно, нужно сфокусироваться на том, что находится в нашей власти – ускорение работы инфраструктуры приложения и обработки клиентских запросов.

Анализ отклика и HTTP-кодов удобно проводить на основе некоторой собранной статистической базы, и здесь мы плавно подходим к теме статьи.
Читать дальше →

Особенности логического сравнения в PHP

Время чтения14 мин
Охват и читатели12K
Четвертого апреля на stackoverflow появился вопрос, касающийся работы операторов сравнения в PHP. Почти сразу же на него поступил развернутый ответ. Наверняка для многих это является интересной темой.

Вопрос


PHP славится своим приведением типов. Я потратил много времени в поисках основ логики сравнения в нем.

Например: если $a > $b является истиной и $b > $c является истиной, значит ли это, что $a > $c также является истиной?

Руководствуясь простейшей логикой я могу предположить что это выражение также верно, однако я не очень доверяю PHP в этом в вопросе. Может кто-нибудь привести мне пример, в котором данное утверждение будет ложным?
Читать дальше →

Judy-массивы в PHP

Время чтения4 мин
Охват и читатели27K
В Badoo используется много сервисов на C и C++, большинство из которых работают с огромными объёмами данных. Как правило, сервисы выступают в роли «быстрого кэша» или «быстрой базы данных», т.е. совершают различные операции с массивами однотипных данных. Для быстрого доступа к данным мы давно и успешно используем Judy-массивы (англ. Judy arrays). Но однажды нам захотелось странного: обрабатывать большие массивы целых чисел на PHP, и мы сразу вспомнили про Judy.

Немного истории

Judy-массивы были изобретены Дугласом Баскинсом (англ. Douglas Baskins) в начале 2000-го года. Проект их разработки финансировался компанией HP, но примерно через два года был закрыт. За это время было выпущено четыре версии, причём разработка последней заняла больше года, и в ней разработчики смогли в два раза ускорить Judy, в два раза уменьшить потребление памяти, хоть и далось это нелёгкой ценой: объём кода вырос в 5 раз, а его сложность  ― на порядок.
Читать дальше →

Дайджест интересных новостей и материалов из мира PHP за последние две недели №13 (12.03.2013 — 25.03.2013)

Время чтения5 мин
Охват и читатели27K


Предлагаем вашему вниманию очередную подборку с ссылками на новости и материалы.

Приятного чтения!
Читать дальше →

Использование zRam для увеличения количества доступной памяти под Linux

Время чтения3 мин
Охват и читатели145K
image
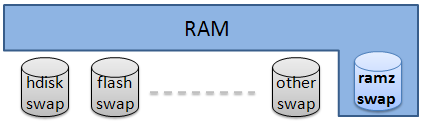
Уже 2 месяца использую на своих компьютерах модуль zRam и хочу поделиться результатами. На практике он позволил мне не используя раздел подкачки, и не получая видимого замедления работы компьютера увеличить размер оперативной памяти в 2.5-3 раза. На сервере виртуалок тот же подход позволил очень ощутимо увеличить отзывчивость при нехватке памяти.
Заинтересовавшихся прошу под кат.
Читать дальше →

Дайджест интересных новостей и материалов из мира PHP за последние две недели №12 (25.02.2013 — 11.03.2013)

Время чтения7 мин
Охват и читатели21K


Предлагаем вашему вниманию очередную подборку с ссылками на новости и материалы.

Приятного чтения!
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Киев, Киевская обл., Украина
Дата рождения
Зарегистрирован
Активность