Обновить
25
Programmer@Programmer

Пользователь

3
Подписчики
Отправить сообщение

Запуск кластера RabbitMQ в Kubernetes

Время на прочтение10 мин
Охват и читатели36K
При микросервисной организации приложения существенная работа ложится на механизмы интеграционной связи микросервисов. Причем эта интеграция должна быть отказоустойчива, с высокой степенью доступности.

В наших решениях мы используем интеграцию и с помощью Kafka, и с помощью gRPC, и с помощью RabbitMQ.

В этой статье мы поделимся нашим опытом кластеризации RabbitMQ, ноды которого размещены в Kubernetes.
image

До RabbitMQ версии 3.7 его кластеризация в K8S была не очень тривиальной задачей, со множеством хаков и не очень красивых решений. В версии 3.6 использовался autocluster плагин из RabbitMQ Community. А в 3.7 появился Kubernetes Peer Discovery Backend. Он встроен плагином в базовую поставку RabbitMQ и не требует отдельной сборки и установки.

Мы опишем итоговую конфигурацию целиком, попутно комментируя происходящее.
Читать дальше →

8-битный компьютер с BASIC и VGA-выходом на Arduino

Время на прочтение3 мин
Охват и читатели51K
C помощью Arduino можно собрать 8-битный ретро-компьютер с Basic (похожий на ZX Spectrum) с выводом цветного изображения на VGA-монитор.

Кроме того, этот проект можно использовать как простой способ вывода текстовых сообщений на монитор.


Сама по себе, идея использовать Arduino для создания компьютера с BASIC не нова, но насколько я знаю, все они не поддерживают вывод цветного изображения. В некоторых проектах использовались LCD-мониторы, а в других — библиотека TVout, которая выводит чёрно-белое изображение. Кроме того, многие из этих проектов требуют дополнительные модули и специальные платы расширения. Тут же нужно всего-то иметь два Arduino, несколько резисторов, плюс разъёмы для PS/2 клавиатуры и VGA-монитора.

Для проекта нужно две платы Arduino: один будет основным (или «мастером»), в нём работает интерпретатор Tiny Basic Plus (это порт Tiny Basic на языке Си, адаптированный для поддержки Arduino). Также этот Arduino управляет PS/2 клавиатурой. Вывод из первого Arduino через последовательный порт отправляется на второй Arduino, который с помощью библиотеки VGAx генерирует VGA-сигнал.

Программу на языке BASIC в собранный нами компьютер можно будет ввести с помощью PS/2 клавиатуры, а результат можно будет посмотреть на VGA-мониторе: разрешение получившегося изображения 24 столбца на 10 строк, размер символов — 5х6 пикселей, доступно 4 цвета.
После введения программы, её можно будет сохранить в энергонезависимой памяти самого Arduino, а также код программы предусматривает управление I/O пинами Arduino.

Если готовы, начнём!

Использование SVG в качестве Placeholder’a

Время на прочтение7 мин
Охват и читатели39K
image

Генерация SVG из изображений может использоваться для Placeholder’ов.

Я занимаюсь оптимизацией изображений и картинок для их быстрой загрузки. Одна из самых интересных областей исследования это Placeholder’ы: что показывать, когда изображение еще не загружено.

В последние дни я сталкивался с некоторыми методами загрузки, которые используют SVG, и я хотел бы описать их в этом посте.

В этом посте мы рассмотрим следующие темы:

  • Обзор различных типов Placeholder’ов
  • Placeholder на основе SVG (контуры, фигуры и силуэты)
  • Автоматизация процесса.

Читать дальше →

Gixy — open source от Яндекса, который сделает конфигурирование Nginx безопасным

Время на прочтение10 мин
Охват и читатели37K
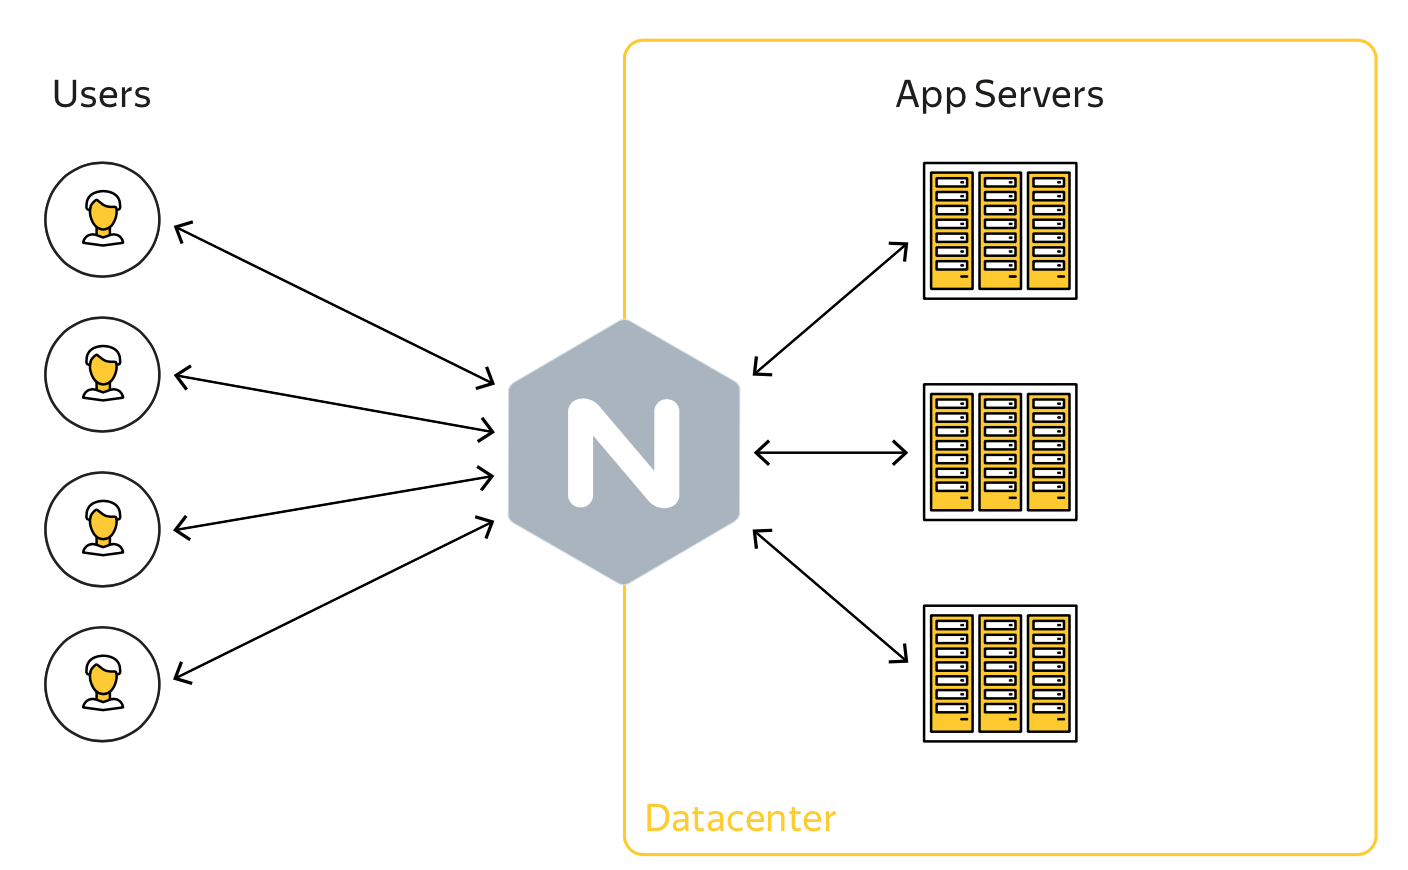
Nginx, однозначно, один из крутейших веб-серверов. Однако, будучи в меру простым, довольно расширяемым и производительным, он требует уважительного отношения к себе. Впрочем, это относится к почти любому ПО, от которого зависит безопасность и работоспособность сервиса. Признаюсь, нам нравится Nginx. В Яндексе он представлен огромным количеством инсталляций с разнообразной конфигурацией: от простых reverse proxy до полноценных приложений. Благодаря такому разнообразию у нас накопился некий опыт его [не]безопасного конфигурирования, которым мы хотим поделиться.


Но обо всем по порядку. Нас давно терзал вопрос безопасного конфигурирования Nginx, ведь он — полноправный кубик веб-приложения, а значит, и его конфигурация требует не меньшего контроля с нашей стороны, чем код самого приложения. В прошлом году нам стало очевидно, что этот процесс требует серьезной автоматизации. Так начался in-house проект Gixy, требования к которому мы обозначили следующим образом:

— быть простым;
— но расширяемым;
— с возможностью удобного встраивания в процессы тестирования;
— неплохо бы уметь резолвить инклюды;
— и работать с переменными;
— и про регулярные выражения не забыть.
Читать дальше →

Видеозаписи докладов конференции AI&BigDataLab за последние три года

Время на прочтение1 мин
Охват и читатели3.7K


Через 2 недели, 13 мая в Одессе, команда FlyElephant будет проводить конференцию Data Science Lab. Это будет наша 4-я конференция, которая посвящена искусственному интеллекту, большим данным и науке о данных.

Сегодня я хочу поделиться видеозаписями всех докладов с прошлых конференций. Смотрите, изучайте и делитесь:

Не доверяйте SUDO, она может вас подвести

Время на прочтение7 мин
Охват и читатели48K

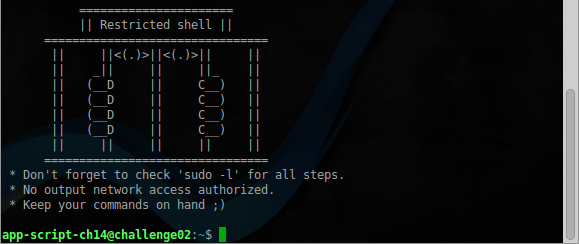
Всем доброго времени суток, в этой статье постараюсь описать некоторые способы обхода ограничений на исполнение команд в ОС Linux, советы по использованию которых можно часто встретить на различных форумах. Демонстрация будет проведена на примере задания Restricted shells с сайта Root-Me. Итак, начнём.
Читать дальше →

Уровни изоляции транзакций с примерами на PostgreSQL

Время на прочтение8 мин
Охват и читатели355K

Вступление


В стандарте SQL описывается четыре уровня изоляции транзакций — Read uncommited (Чтение незафиксированных данных), Read committed (Чтение зафиксированных данных), Repeatable read (Повторяемое чтение) и Serializable (Сериализуемость). В данной статье будет рассмотрен жизненный цикл четырёх параллельно выполняющихся транзакций с уровнями изоляции Read committed и Serializable.


Для уровня изоляции Read committed допустимы следующие особые условия чтения данных:


Неповторяемое чтение — транзакция повторно читает те же данные, что и раньше, и обнаруживает, что они были изменены другой транзакцией (которая завершилась после первого чтения).


Фантомное чтение — транзакция повторно выполняет запрос, возвращающий набор строк для некоторого условия, и обнаруживает, что набор строк, удовлетворяющих условию, изменился из-за транзакции, завершившейся за это время.


Что же касается Serializable, то данный уровень изоляции самый строгий, и не имеет феноменов чтения данных.

Читать дальше →

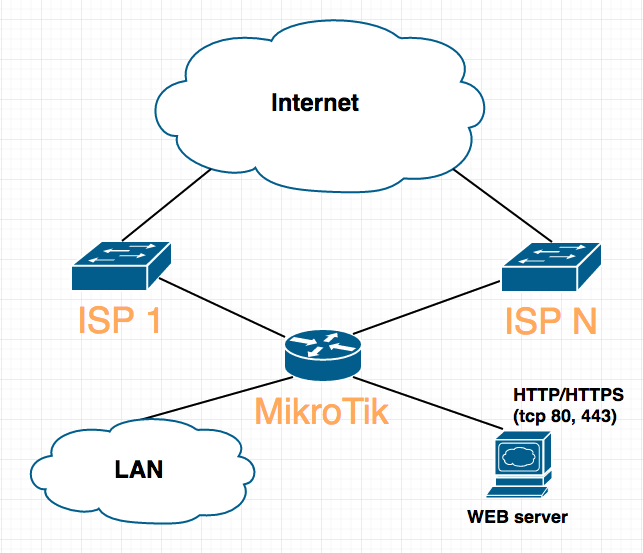
MikroTik. Правильный dst nat при использовании 2-х и более провайдеров

Время на прочтение11 мин
Охват и читатели243K
Приступая к выполнению задачи я рассчитывал на легкую прогулку в тени дубового парка, созерцая природу и предаваясь размышлениям… Однако позже стало понятно, что это будет тернистый и сложный поход сквозь горные реки с подводными камнями, обледеневшими скалами и глубокими пещерами.
Через медитации, борьбу со стихиями и собственной тупостью преодоление себя я, все таки, достиг желанной нирваны.

В этой статье я не только предоставлю готовый набор правил, но и постараюсь максимально доступно объяснить почему и как именно они работают.


Конкретно в моем случае, нужно было настроить роутер так, чтобы web-сервер в локальной сети за ним был доступен по IP любого из 3-х провайдеров.
Читать дальше →

Как дать адекватную оценку времени, когда неопределённость бьёт по башке

Время на прочтение12 мин
Охват и читатели86K
Большинство людей не умеют адекватно оценивать сроки выполнения задач. Ой как это заставляет порой понервничать… Тут и «дэдлайн подкрадывается незаметно». И перестраховка в 500% на всякий случай (все равно не хватает). И отжимание «заведомо раздутых сроков», чтобы исполнитель пообещал чего-то более приемлемого. И невнятные бормотания вместо конкретных цифр.

image

В этой статье собраны и структурированы принципы и методы, с помощью которых можно научить себя и других давать адекватные оценки. В начале — общие принципы и чуть-чуть математики. В конце — конкретика для студий.
Читать дальше →

Мониторинг сети с помощью FlapMyPort

Время на прочтение5 мин
Охват и читатели19K
image

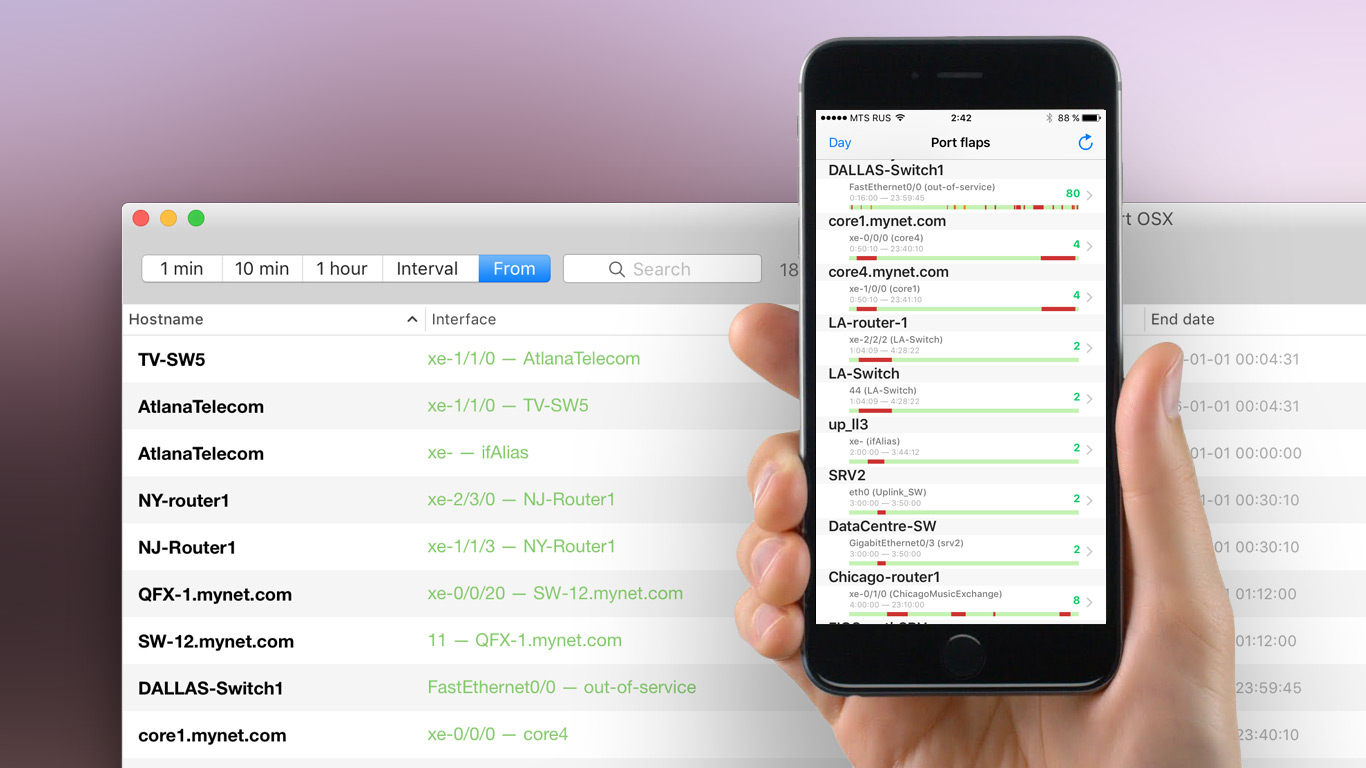
Я создал систему мониторинга сети сугубо под свои нужды, но со временем проект развился до такого состояния, при котором он вполне может быть полезен другим людям. Эта статья адресована прежде всего сетевым инженерам, системным администраторам, и другим специалистам, чья деятельность связана с коммутаторами и маршрутизаторами. Если кто-то из вас захочет внедрить FlapMyPort в своей сети, я готов оказать персональное содействие в ее развертывании, так как хочу, чтобы люди пользовались ею.
Читать дальше →

Как спроектировать супер-быстрый сайт

Время на прочтение5 мин
Охват и читатели15K
Предлагаю вам перевод статьи How to Design Your Site to Make it Super-fast с сайта Awwwards, в которой говорится, как малыми средствами добиться большого результата в деле увеличения скорости работы вашего сайта. Данная статья скорее обращается к тем, кто не забывает про дизайн после утверждением макета, а продолжает работать над проектом вместе с разработчиками или сам является разработчиком.

Супер-быстрый сайт
Читать дальше →

Обзор расширения OPCache для PHP

Время на прочтение33 мин
Охват и читатели141K


PHP — это скриптовый язык, который по умолчанию компилирует те файлы, которые вам нужно запустить. Во время компилирования он извлекает опкоды, исполняет их, а затем немедленно уничтожает. PHP был так разработан: когда он переходит к выполнению запроса R, то «забывает» всё, что было выполнено в ходе запроса R-1.

Очень маловероятно, что на production-серверах PHP-код изменится между выполнением нескольких запросов. Так что можно считать, что при компилированиях всегда считывается один и тот же исходный код, а значит и опкод будет точно таким же. И если извлекать его для каждого скрипта, то получается бесполезная трата времени и ресурсов.
Читать дальше →

Организация кода в Go

Время на прочтение8 мин
Охват и читатели46K

Зависимости. Дженерики. Они часто звучат в списке проблем в Go сообществе, но есть одна проблема, о которой вспоминают довольно редко — организация кода вашего пакета.


Каждое Go приложение, с которым я работал, похоже, имеет свой ответ на вопрос "Как я должен организовать код?". Некоторые приложения засовывают всё в один пакет, в то время, как другие группируют логику по типам или модулям. Без хорошей стратегии, которой придерживаются все члены команды, вы рано или поздно увидите, что код сильно разбросан по многочисленным пакетам. Нам нужен некий стандарт для дизайна кода в Go приложениях.


Я предлагаю подход получше. Следуя набору простых правил, мы можем добиться того, что код будет несвязанным, легко тестируемым и структура проекта будет цельная. Но прежде, чем мы углубимся в детали, давайте посмотрим на наиболее часто используемые подходы к структуризации Go кода.

Читать дальше →

Как устроены каналы в Go

Время на прочтение4 мин
Охват и читатели82K

Перевод познавательной статьи "Golang: channels implementation" о том, как устроены каналы в Go.


Go становится всё популярнее и популярнее, и одна из причин этого — великолепная поддержка конкурентного программирования. Каналы и горутины сильно упрощают разработку конкурентных программ. Есть несколько хороших статей о том, как реализованы различные структуры данных в Go — к примеру, слайсы, карты, интерфейсы — но про внутреннюю реализацию каналов написано довольно мало. В этой статье мы изучим, как работают каналы и как они реализованы изнутри. (Если вы никогда не использовали каналы в Go, рекомендую сначала прочитать эту статью.)


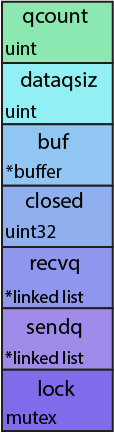
Устройство канала


Давайте начнём с разбора структуры канала:


Читать дальше →

Новая редакция популярного бесплатного учебника электроники, архитектуры компьютера и низкоуровневого программирования

Время на прочтение3 мин
Охват и читатели150K
Господа! Только что на сайте Imagination Technologies вышло исправленное издание бесплатного учебника на русском языке «Цифровая схемотехника и архитектура компьютера» Дэвида Харриса и Сары Харрис (кстати, они не супруги и вообще не родственники – просто так совпало). Предыдущее издание этого учебника вышло год назад, пост о нем собрал 145,000 просмотров на Хабре, количество скачиваний с британского сайта вызвало у его британских админов подозрение, что их атакуют русские хакеры, а впоследствие команду переводчиков лично благодарили за учебник преподаватели МФТИ, МВТУ им. Баумана, харьковского ХНУРЭ и других университетов.

silicon_russia_ad_selected_160730_174932

Книжка содержит «введение во все», доступное способному школьнику или младшему студенту, который после ее прочтения может спроектировать, написать на SystemVerilog или VHDL и реализовать на ПЛИС несложный, но при этом совершенно настоящий конвейерный процессор. Книга написана живым языком и для введения концепций, например конечных автоматов, использует примеры типа:


Читать дальше →

Эффективные структуры данных для PHP 7

Время на прочтение11 мин
Охват и читатели53K
PHP имеет всего одну структуру данных для управления всем. array — сложный, гибкий, гибридный, сочетает в себе поведение list и linked map. Но мы используем его для всего, потому что PHP придерживается прагматичного подхода: иметь предельно правильный, здравый и реалистичный способ решения проблемы, исходящий из практических, а не теоретических рассуждений. array позволяет делать работу, хотя о нем и так много рассказывают на лекциях по информатике. Но, к сожалению, с гибкостью приходит и сложность.

Последний релиз PHP вызвал большое оживление в сообществе. Мы не могли дождаться того, чтобы начать использовать новые возможности и почувствовать вкус ~2х прироста производительности. Одна из причин, почему это случилось — структура array была переработана. Но массивы все также придерживаются принципа «оптимизировано для всего; оптимизировано для ничего», еще не все идеально, есть возможности для совершенствования.

А что насчет структур данных SPL?
К сожалению… они ужасны. Раньше, до PHP7, они предлагали _некоторые_ преимущества, но сейчас мы дошли до точки, когда использование SPL не имеет практического смысла.

Почему мы не можем просто поправить и улучшить их?
Да, мы могли бы, но я считаю, что их дизайн и реализация настолько бедны, что лучше бы найти более современную замену.
«SPL data structures are horribly designed.»
— Anthony Ferrara


Введение: php-ds — расширение для PHP7, добавляющее структуры данных. Этот пост кратко охватывает поведение, производительность и преимущества каждой из них. Также в конце вы найдете список ответов на ожидаемые вопросы.

Github: https://github.com/php-ds
Пространство имен: Ds\
Интерфейсы: Collection, Sequence, Hashable
Классы: Vector, Deque, Stack, Queue, PriorityQueue, Map, Set
Читать дальше →

CodingFuture + Puppet. Часть V: базы данных (cfdb)

Время на прочтение8 мин
Охват и читатели6.5K

cfdb use cases


Вкратце:


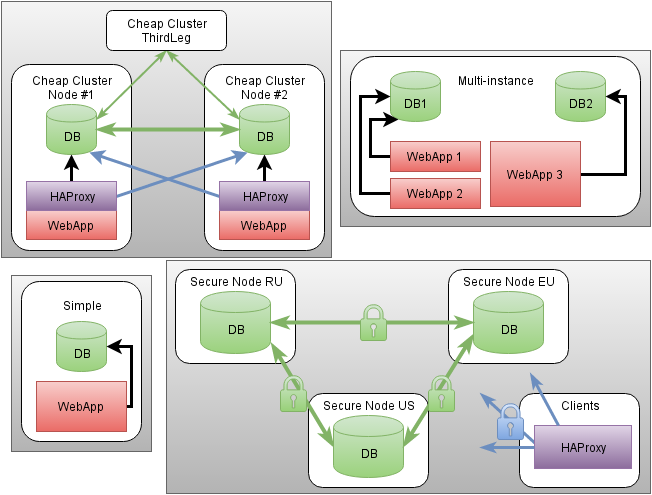
  1. cfdb — модуль развёртывания и автонастройки узлов и кластеров баз данных и доступа к ним с высокой доступностью и защитой от сбоев.
  2. Как proof-of-concept поддерживаются MySQL и PostgreSQL на базе Percona Server/XtraDB Cluster и официальных сборок PostgreSQL+repmgr.
  3. Изоляция ресурсов на базе cgroups, интеграция с настройками сетевого фильтра через модуль cfnetwork и строгий контроль доступа средствами СУБД.
  4. Запись на один узел для минимизации конфликтов и распределение нагрузки для read-only доступа.
  5. Автоматическая проверка здоровья кластера и фактической осуществимости доступа.
  6. Ручное и автоматическое локальное резервное копирование, автоматизированное восстановление данных.
  7. Поддержка автоматической миграции уже существующих баз данных

Читать дальше →

Видео докладов с Docker митапа

Время на прочтение1 мин
Охват и читатели19K

18-го июня мы провели Docker митап, а сегодня публикуем видео докладов.

Познавательного вам просмотра!
Читать дальше →

Поиск по Postgres с использованием ZomboDb и elasticsearch

Время на прочтение3 мин
Охват и читатели21K

В какой-то момент разработки проекта встал вопрос поиска по большому количеству текстов. Причем, тексты имеют различную длину: от твиттов до больших статей. Сначала, основным поисковым движком был выбран встроенный в Postgres _tsvector. Для поиска по простым правилам его было вполне достаточно. Массив текстов рос с большой скоростью, а правила поиска усложнялись, поэтому встроенный движок уже не покрывал требований.


Да, существует sphinx, у него есть отличная интеграция с Postgres, но была цель найти решение для использования elasticsearch с Postgres. Почему? elasticsearch показывал хорошие результаты в некоторых case-ах проекта. Да и уже был сервер с ним для хранения логов logstash-а. Также было желание найти такой инструмент, который полностью возьмет на себя синхронизацию данных.


В результате всего на просторах сети был найден проект ZomboDb, который как раз подходил под требования.

Читать дальше →

2-3-дерево. Наивная реализация

Время на прочтение15 мин
Охват и читатели69K
Недавно мне понадобилось написать 2-3-дерево и я начал искать информацию в русскоязычном интернете. К сожалению, ни на хабре, ни на других ресурсах я не смог найти достаточно полную информацию на русском языке. На всех ресурсах было одно и то же: свойства дерева, как вставляются ключи в дерево, поиск в дереве и иногда простой пример, как удаляется ключ из дерева; не было реализации.

Поэтому, после того, как я сделал то, что мне нужно, решил написать данную статью. Думаю, кому-нибудь будет полезна в образовательных целях, так как на практике обычно реализуют эквивалент 2-3- и 2-3-4-деревьев — красно-черное дерево.
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Киев, Киевская обл., Украина
Дата рождения
Зарегистрирован
Активность