Новый год, новый GitHub: неограниченные бесплатные приватные репозитории


Веб-сервис для хостинга и разработки IT-проектов

Эта новость опубликована на The Next Web, с пометкой:
"Из-за ошибок в планировании, мы опубликовали эту новость на день раньше снятия эмбарго на разглашение. Фича всё ещё не запущена, о ней официально расскажут завтра. Когда это произойдёт, мы обновим пост новым официальным анонсом".
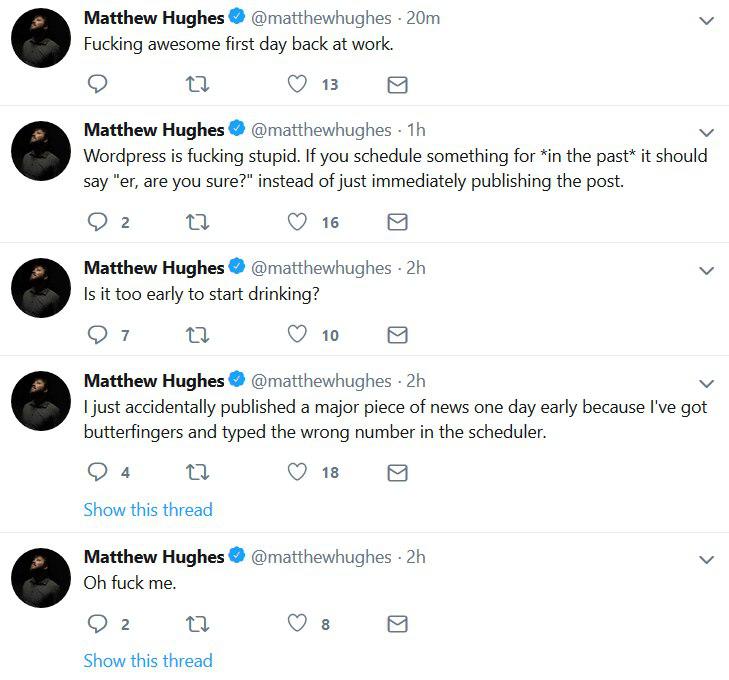
А ещё есть вот такой замечательный тред в Twitter:

Ясно, что человек писал это дрожащими руками — точно так же, как я сейчас пишу дрожащими руками этот перевод.
Фейк ли это? Нет. Есть и официальное подтверждение в твиттере GitHub, так что — назад дороги нет.
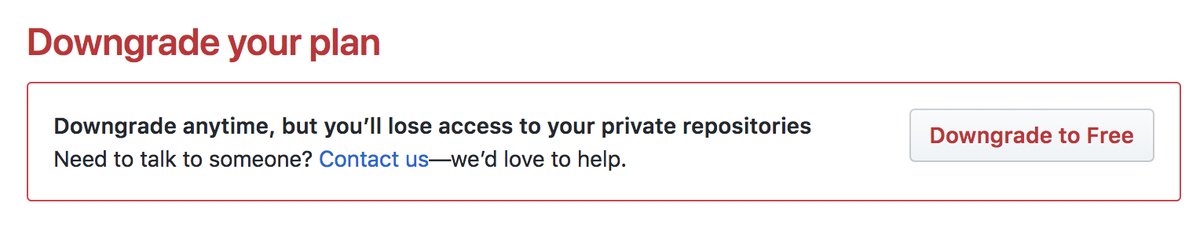
Фичу явно выкатывали на спех, до сих пор на сайте не поправлена часть текстов, касающихся тарифов, а попытка даунгрейднуть план встречает таким вот опасно выглядящим сообщением:

В общем, запасаемся попкорном, скрещиваем пальцы на ногах и ждём годноты!


Последние пару недель были непростыми для нашей команды. Выпускали OpenCV 4, а вместе с ним готовились к Intel's OpenVINO toolkit R4, в состав которого входит OpenCV. Думаешь, отвлекусь на время, посмотрю, как обычно, форумы про OpenCV, да комментарии пользователей, и тут на тебе, модно стало говорить что OpenCV не IoT, что под Raspberry Pi собрать — припоя не хватает, что на ночь make -j2 ставить — утром будет готово, если повезёт.
Поэтому предлагаю дружно взяться за руки и посмотреть, как же можно собирать библиотеку OpenCV для 32-битной операционной системы, исполняемой на ARM процессоре, используя ресурсы машины с 64-битной OS, движимой отличной архитектурой CPU. Колдовство Кросс-компиляция, не иначе!
В последнее время стало много новостей про случайные утечки различных конфиденциальных данных из веб-сервиса для хостинга IT-проектов и их совместной разработки GitHub.

Подчеркну, что речь пойдет именно о случайных утечках, т.е. произошедших по неосторожности и без злого умысла со стороны виновников инцидентов.

Большинство разработчиков знают и любят github pages. На случай, если вы не встречались с ними — этот сервис даёт возможность создать статический сайт из вашего репозитория, который будет доступен на домене smth.github.io. Это безумно удобно для всякой временной статики, документации, небольших простых сайтов и так далее. Не приходится думать о каком-то дополнительном веб сервере.
Так же там есть возможность привязать к репозиторию свой домен — тогда всё будет совсем красиво. Даже поддержка SSL есть.
После этого небольшого введения перейдём к собственно теме статьи. Совсем недавно (9 ноября) у меня приключилась интересная история. Рекомендую не читать её залпом, а периодически останавливаться и прикидывать, что же означают все полученные на текущий момент вводные. Думаю, из этого выйдет интересная тренировка, хотя сюжет моего детектива оказался и не очень длинным и закрученным.
Оптическое распознавание символов (OCR) — это процесс получения печатных текстов в оцифрованном формате. Если вы прочитали классический роман на цифровом устройстве или попросили врача поднять старые медицинские записи через компьютерную систему больницы, вы, вероятно, воспользовались OCR.
OCR делает ранее статический контент доступным для редактирования, доступным для поиска и для обмена. Но многие документы, нуждающиеся в оцифровке, содержат кофейные пятна, страницы с загнутыми уголками и множество морщин сохраняют некоторые печатные документы в не оцифрованном виде.
Всем давно известно, что существуют миллионы старых книг, которые хранятся в хранилищах. Использование этих книг запрещено по причине их ветшалости и дряхлости, и поэтому оцифровка этих книг столь важна.
В работе рассматривается задача очистки текста от зашумленности, распознавание текста на изображении и конвертации его в текстовый формат.
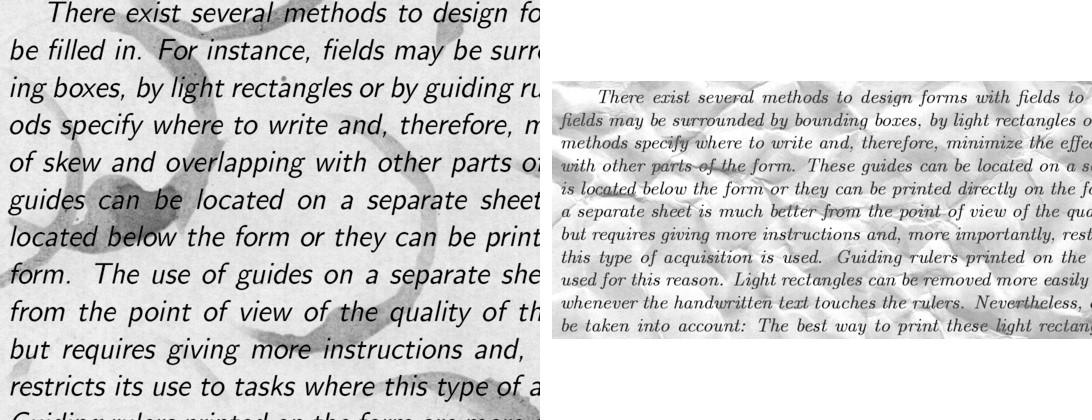
Для обучения использовалось 144 картинки. Размер может быть разным, но желательно должен быть в пределах разумного. Картинки должны иметь формат PNG. После считывании изображения используется бинаризация – процесс преобразования цветного изображения в черно-белое, то есть каждый пиксель нормализуется в диапазон от 0 до 255, где 0 – это черный, 255 – белый.
Чтобы обучить сверточную сеть, нужно больше изображений, чем имеется. Было принято решение разделить изображения на части. Так как обучающая выборка состоит из картинок разного размера, каждое изображение было сжато до 448х448 пикселей. В результате получилось 144 изображения в разрешении 448х448 пикселей. После чего все они были нарезаны на неперекрывающиеся окна размером 112x112 пикселей.

Все мы давным давно хотим нормальную инкапсуляцию в JS, которую можно было бы использовать без лишних телодвижений. А ещё мы хотим удобные конструкции для объявления свойств класса. И, напоследок, мы хотим что бы все эти фичи в языке появились так, что бы не сломать уже существующие приложения.
Казалось бы, вот оно счастье: class-fields-proposal, который спустя долгие годы мучений коммитета tc39 таки добрался до stage 3 и даже получил реализацию в хроме.
Честно говоря, я бы очень хотел написать статью просто о том, почему стоит пользоваться новой фишкой языка и как это сделать, но, к сожалению, статья будет совсем не об этом.


https://t.co/Mxtcxki9Ce
— Gentoo Linux (@gentoo) June 28, 2018
Today 28 June at approximately 20:20 UTC unknown individuals have gained control of the Github Gentoo organization, and modified the content of repositories as well as pages there. More see link.
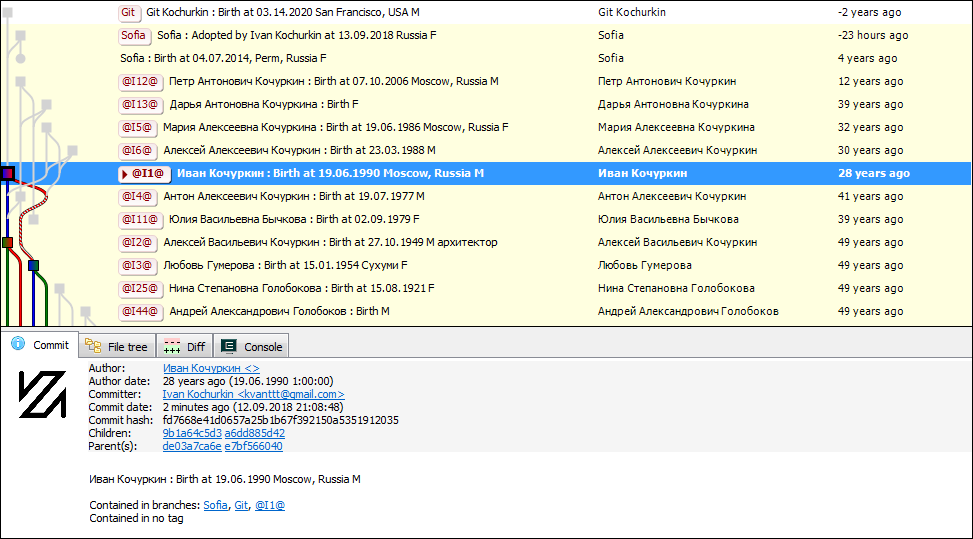
Поздравляю всех с днем программиста! Желаю больше ярких "коммитов", принятых "пулл-реквестов", меньше незапланированных "мержей" и чтобы ваши ветви жизни оставались актуальными как можно дольше. В качестве идейного подарка предлагаю реализацию генеалогического древа средствами системы контроля версий Git. Ну что же… звучит как план!
Для тех, кто сразу все понял, выкладываю исходники генератора: GenealogyTreeInGit и сами генеалогические древа — мое и президентов США.
Кроме того, я реализовал простой социальный граф. Он отображает не только степень родства, но и статус отношений между потомками, отображает такие события как свадьба, развод, рождение ребенка, а также вклады в отношения тех или иных сторон.