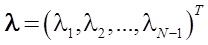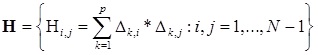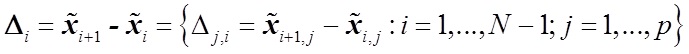Обновить
3
Евгений Аблесов@Codebaker

Пользователь

Отправить сообщение

Пишем фреймворк для разработки игр — Mechanic Framework

Время чтения26 мин
Охват и читатели25K
Добрый день, жители Хабра!
Сегодня мы будем писать фреймворк с названием Mechanic Framework для удобной разработки игр под андроид.

image

Что нам потребуется:


  • Установленные Eclipse и Android SDK
  • Приличное знание Java либо другого С-подобного языка. Лучший пример – C#
  • Терпение


Читать дальше →

Оценка результатов линейной регрессии

Время чтения6 мин
Охват и читатели112K

Введение


Сегодня уже все, кто хоть немного интересуется дата майнингом, наверняка слышали про простую линейную регрессию. Про нее уже писали на хабре, а также подробно рассказывал Эндрю Нг в своем известном курсе машинного обучения. Линейная регрессия является одним из базовых и самых простых методов машинного обучения, однако очень редко упоминаются методы оценки качества построенной модели. В этой статье я постараюсь немного исправить это досадное упущение на примере разбора результатов функции summary.lm() в языке R. При этом я постараюсь предоставить необходимые формулы, таким образом все вычисления можно легко запрограммировать на любом другом языке. Эта статья предназначена для тех, кто слышал о том, что можно строить линейную регрессию, но не сталкивался со статистическими процедурами для оценки ее качества.
Читать дальше →

Как измерить релевантность контента

Время чтения10 мин
Охват и читатели12K
Оценка контента одна из главных составляющих формулы релевантности. Знание текстовых признаков и вклад каждого из них в оценку сайта позволит приблизиться к более профессиональной работе с ресурсом. В данной статье будет рассмотрена модель, позволяющая восстановить формулу ранжирования по каждому конкретному запросу, указана значимость определение тематики сайта при продвижении по определенному запросу, а также проработан вопрос, связанного с определением неестественного текста.

Восстановление формулы ранжирования

Если переводить данную задачу в область математики, то входные данные можно представить набором векторов, где каждый вектор – множество характеристик каждого сайта, а координаты в векторе – параметр, по которым оценивается сайт. В описанном векторном пространстве обязательно должна быть задана функция, определяющая отношение порядка двух объектов между собой. Эта функция позволяет ранжировать объекты между собой по принципу «больше — меньше», однако при этом сказать, насколько именно одно больше или меньше другого – нельзя. Такого вида задачи относятся к задачам оценки порядковой регрессии.
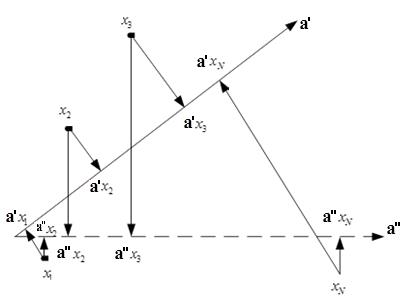
Наши сотрудники разработали алгоритм на основе модели линейной регрессии с регулируемой селективностью, который позволил с определенной долей погрешности восстановить ранги сайтов и спрогнозировать изменение выдачи при соответствующих корректировках параметров сайта. Первым шагом алгоритма является обучение модели. В данном случае обучающая выборка представляет собой результаты ранжирования сайтов в рамках одного поискового запроса. Упорядоченность сайтов в рамках поискового запроса фактически означает, что в признаковом пространстве существует некоторое направление, на которое объекты обучающей выборки должны проектироваться в нужном порядке. Это направление и является искомым в задаче восстановления формулы ранжирования. Однако судя по рис.1, таких направлений может быть много.
image
Рис. 1. Выбор направляющего вектора

Для решения данного вопроса был рассмотрен подход, лежащий в основе метода опорных точек, а именно – выбор такого направления, которое будет обеспечивать максимальное удаление объектов друг от друга.
Следующая задача, которая была решена — выбор стратегии обучения. Рассматривалось два варианта – сокращенная стратегия обучения, при которой учитывается порядок двух соответствующих элементов, и полная стратегия, которая учитывает весь порядок объектов. В результате экспериментов была выбрана сокращенная стратегия, которая заключается в решении следующего уравнения:(1)
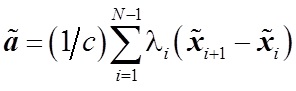
image, где image — решение стандартной задачи квадратичного программирования при линейных ограничениях: image, где
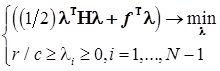
image — симметричная матрица
image — вектор коэффициента
image — разница векторов характеристик

Данный подход на различных выборках (100 признаков и 500 признаков на 20 различных множествах поисковых запросов) показал хорошие результаты (см. табл. 1).

Читать далее

Примитивный игровой дизайн. Пошаговая разработка карточной игры

Время чтения9 мин
Охват и читатели50K


Мотивированный прочтением тематической литературы и нескольких статей на хабре о гейм-дизайне в целом и о том, как наконец-то встать с четверенек и попробовать сделать первые шаги, я решил, что все, что от меня требуется — это сесть и начать работать.
Пусть это будет не ААА проект, подкрепленный миллионными вложениями, а нечто более тривиальное и простое.
Карточная игра. Затягивающая, интересная, не слишком сложная. А там уже посмотрим.

Под катом — вводная, начало процесса и много размышлений на тему.

Заглянуть

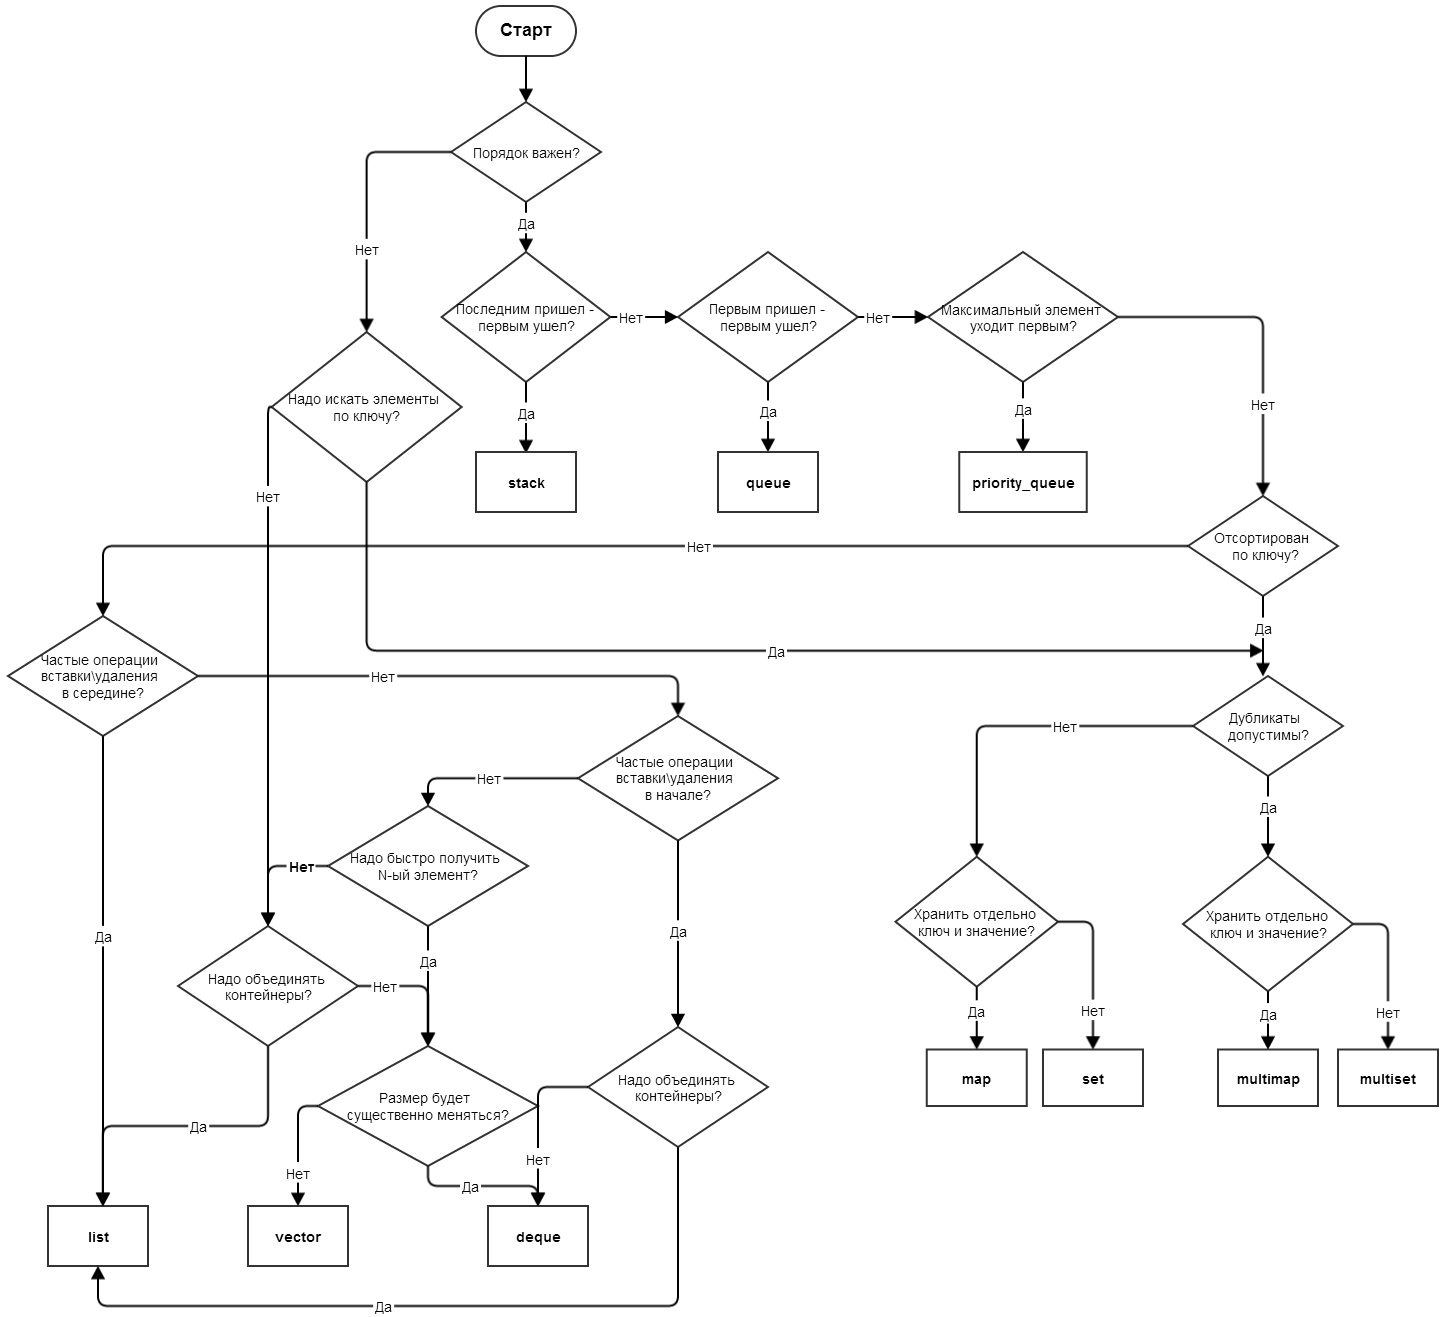
Алгоритм выбора STL-контейнера

Время чтения1 мин
Охват и читатели65K


UPD: схема заменена на вариант с контейнерами из С++11, соавторы — в комментариях ниже

Первый вариант схемы - без контейнеров из С++11

Корректная обработка проблем аутентификации AJAX-запросов для приложений ASP.NET MVC

Время чтения5 мин
Охват и читатели14K
Для современных веб-приложений стало уже нормой использование AJAX при создании пользовательских интерфейсов. Однако, из-за этого, порой, возникают дополнительные сложности. Часто эти сложности связаны с аутентификацией и процессом обработки таких запросов на клиенте.
Читать дальше →

Алгоритм Self-Organizing Incremental Neural Network (SOINN)

Время чтения7 мин
Охват и читатели23K

Введение


Одной из задач обучения без учителя является задача нахождения топологической структуры, которая наиболее точно отражает топологию распределения входных данных. Существует несколько подходов решения этой задачи. Например, алгоритм Самоорганизующихся Карт Кохонена является методом проецирования многомерного пространства в пространство с более низкой размерностью (как правило, двумерное) с предопределенной структурой. В связи с понижением размерности исходной задачи, и предопределенной структурой сети, возникают дефекты проецирование, анализ которых является сложной задачей. В качестве одной из альтернатив данному подходу, сочетание конкурентного обучения Хебба и нейронного газа является более эффективным в построении топологической структуры. Но практическому применению данного подхода препятствует ряд проблем: необходимы априорные знания о необходимом размере сети и сложность применения методов адаптации скорости обучения к данной сети, излишняя адаптация приводит к снижению эффективности при обучении новым данным, а слишком медленная скорость адаптации вызывает высокую чувствительность к зашумленным данным.

Для задач онлайн обучения или длительного обучения, перечисленные выше методы не подходят. Фундаментальная проблема для таких задач — это как система может приспособиться к новой информации без повреждения или уничтожения уже известной.

В данной статье рассматривается алгоритм SOINN, который частично решает озвученные выше проблемы.
Читать дальше →

Вероятностные модели: борьба с циклами и вариационные приближения

Время чтения8 мин
Охват и читатели16K
В четвёртой серии цикла о графических вероятностных моделях (часть 1, часть 2, часть 3) мы продолжим разговор о том, как справляться со сложными фактор-графами. В прошлый раз мы изучили алгоритм передачи сообщений, который, правда, работает только в тех случаях, когда фактор-граф представляет собой дерево, и в каждом узле можно без проблем пересчитать распределения грубой силой. Что делать в по-настоящему интересных случаях, когда в графе есть большие содержательные циклы, мы начнём обсуждать сегодня – поговорим о паре относительно простых методов и обсудим очень мощный, но непростой в использовании инструмент – вариационные приближения.


Читать дальше →

Конвертируем картинку в ANSI

Время чтения4 мин
Охват и читатели23K
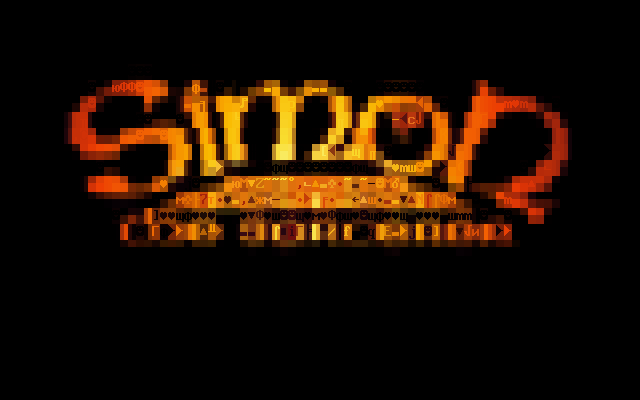
Не знаю, насколько это будет кому-то интересно, но на днях решил поиграться и сделать следующее:

Дано: Картинка (например, BMP) 640 на 400, шрифт 8 на 16

Надо: Перевести ее в ANSI псевдографику в стандартном режиме 80 на 25 символов, символы и фон могут иметь любой цвет (true color).

image

Благодаря очень хорошим комментариям я обновил версию: ссылка
С ней получаются примерно такие картинки: image

Читать дальше →

Определение процента схожести нарисованного 2d-полигона с заданным шаблоном

Время чтения6 мин
Охват и читатели31K
Приветствую, друзья.

Как вы знаете, в последнее время технология разработки игр для мобильных платформ развивается очень бурно. Игры пишутся на самых разных движках и языках, мы не будем в этой статье обсуждать, почему тот или иной язык/движок лучше или хуже (правда ведь?). Разработчики пытаются придумать новые интересные и удобные элементы управления игрой. Мне как игроку очень нравится использовать в игре геометрические элементы. Например такие, как в игре Джаггернаут для мобильных устройств.


Я попробую рассказать вам об алгоритме определения нарисованных 2d фигур. Свою версию движка я написал на языке ActionScript 3.0. При желании(и наличии базовых знаний по геометрии) его можно реализовать на любом другом.

Итак, нам необходимо по нарисованной руками фигуре определить процент схожести с имеющейся:


Читать дальше →

Raytracing render на C

Время чтения12 мин
Охват и читатели77K
Имея опыт разработки на одном из высокоуровневых языков программирования, а также интерес к задачам из различных областей информатики, я наконец нашел возможность овладеть еще одним инструментом — языком программирования С. Исходя из собственного опыта — знания лучше усваиваются, если применять их для решения практических задач. Поэтому, было решено реализовать с нуля Ray tracing рендер (поскольку увлекаюсь компьютерной графикой ещё со школьных времен).

В данной статье хочу поделиться собственным подходом и полученными результатами.


Читать дальше →

Введение в теорию магии

Время чтения8 мин
Охват и читатели58K
Первая статья из цикла «Теория магии» носит обзорный характер. Ее цель — сформулировать основные вопросы рассматриваемой дисциплины преимущественно на качественном уровне, а так же разъяснить, какие принято выделять субдисциплины, и как аспекты, находящиеся в центре их внимания, связаны между собой.
Читать дальше →

C++: Когда время жизни объекта определяется временем жизни ссылки на него

Время чтения3 мин
Охват и читатели14K
В то время пока выходят статьи о сущности и подводных камнях r-value ссылок (пример со ссылками на полезные источники habrahabr.ru/post/157961) подозреваю, что довольно многие не знают особенности обычных l-value ссылок. Суть этой статьи показать пример, когда время жизни объекта определяется временем жизни l-value ссылки на него, и как это можно использовать. Если заинтересовало, то добро пожаловать. Кстати, зная как можно больше особенностей про l-value ссылки, будет проще понять r-value.
Читать дальше →

Не зная брода, не лезь в воду. Часть N4

Время чтения5 мин
Охват и читатели15K
В этот раз я хочу поговорить о виртуальном наследовании в языке Си++, и почему его следует использовать очень осторожно. Предыдущие статьи: часть N1, N2, N3.
Статья написана по мотивам заметки "Грабли 2: Виртуальное наследование". Статья хорошая, но, на мой взгляд, несколько размыта, и новичок может не до конца уловить суть опасностей. Я решил предложить свой вариант описания проблем связанных с виртуальным наследованиям.
Читать дальше →

Доказательное планирование

Время чтения13 мин
Охват и читатели41K
Примечание переводчика: оригинальная статья была написана в 2007-м году, однако, на мой взгляд, полностью сохраняет актуальность и сегодня.

Разработчики программного обеспечения не любят составлять план работ. Обычно пытаются вовсе от него отказаться. «Закончу, когда закончу!», — говорят они, ожидая, что этот смелый и веселый поступок вызовет одобрение у босса, а о планировании будет успешно забыто.

Большая часть расписаний, с которыми вы встретитесь, будет представлять из себя бездушные отписки. Совершенно забытые, они хранятся в каком-нибудь общем каталоге. После выпуска продукта с опозданием на пару лет странный парень, в чьем офисе, говорят, видели картотеку, принесет на обсуждение причин провала старую распечатку, которую все засмеют. «Только гляньте! Мы запланировали две недели, на переписывание системы с нуля на Ruby!»
Читать дальше →

Не бойтесь велосипедов. Или еще один Grand Central Dispatch (GCD) на C++11

Время чтения8 мин
Охват и читатели22K

ИМХО (Имею Мнение Хрен Оспоришь)


С моей точки зрения самое полезное, что может сделать программист для повышения своего профессионального уровня — это написание велосипедов. Велосипедостроение — очень увлекательный процесс. Иногда он увлекает больше, чем задача, ради которой сам велосипед и затевался. При написании велосипеда (под велосипедом я понимаю реализацию уже существующего) происходит более глубокое понимание уже существующих решений и техник.

Читать дальше →

Вероятностные модели: искусство расставлять скобки

Время чтения5 мин
Охват и читатели27K
После большого перерыва продолжаем цикл о графических вероятностных моделях (часть 1, часть 2). Сегодня мы наконец-то от постановок задач перейдём к алгоритмам; поговорим мы о самом простом, но часто полезном алгоритме вывода на фактор-графах – алгоритме передачи сообщений. Или, как его ещё можно назвать, алгоритме правильной расстановки скобок.


by sergey-lesiuk
Читать дальше →

Занимательный C++: Счетчик времени компиляции

Время чтения5 мин
Охват и читатели20K
Предлагается разработать безопасную альтернативу встроенного макроса __COUNTER__. Первое вхождение макроса заменяется на 0, второе на 1, и так далее. Значение __COUNTER__ подставляется на этапе препроцессирования, следовательно его можно использовать в контексте constant expression.

К сожалению, макрос __COUNTER__ опасно использовать в заголовочных файлах — при другом порядке включения заголовочных файлов подставленные значения счетчика поменяются. Это может привести к ситуации, когда например в foo.cpp значение константы AWESOME равно 42, в то время как в bar.cpp AWESOME≡33. Это нарушение принципа one definition rule, что есть страшный криминал во вселенной C++.

Нужна возможность использовать локальные счетчики вместо единого глобального (как минимум, для каждого заголовочного файла свой). При этом возможность использовать значение счетчика в constant expression должна сохраниться.

По мотивам этого вопроса на Stack Overflow.
Читать дальше →

Фильтрация смс спама с помощью наивного байесовского классификатора (код на R)

Время чтения8 мин
Охват и читатели29K
Привет. В этом посте мы рассмотрим простую модель фильтрации спама с помощью наивного байесовского классификатора с размытием по Лапласу, напишем несколько строк кода на R, и, наконец, протестируем на англоязычной базе данных смс спама. Вообще, на хабре я нашел две статьи посвященные данной теме, но ни в одной не было наглядного примера, чтобы можно было скачать код и посмотреть результат. Также не было упоминания про размытие, что существенно увеличивает качество модели, без особых затрат усилий, в отличие, скажем, от сложной предобработки текста. Но вообще, запилить очередной пост про наивного байеса меня побудило то, что я пишу методичку для студентов с примерами кода на R, вот и решил поделиться инфой.

Читать дальше →

Thread concurrency C++11, свой велосипед технологии (Apple) GCD

Время чтения7 мин
Охват и читатели6.7K
Вступление

Добрый вечер хабровчане. В данной статье хочу описать проблемы работы в многопоточной среде, с которыми я встретился и пути их решения. Более пяти лет я занимаюсь разработкой игровых проектов на С++ / Objective C++, в оснвоном под платформу iOS. 2 года назад решил попробовать себя в «нативной» разработке используя только Objective-C. Примерно в тоже время меня заинтересовала технология GCD от Apple (как раз после просмотра очередного WWDC). В первую очередь, в этой технологии меня привлекла гибкая возможность делегирования операций между потоками. Довольно распространненой задачей является загрузка каких-либо игровых ресурсов в низкоприоритетном потоке. Но довольно нетривиальной задачей является смена потока по окончанию операции загрузки на главный поток с целью дальнейшей загрузки в VRAM. Конечно можно было закрыть глаза на эту проблему и использовать Shared Context для графического контекста, но ростущий в то время во мне перфикционизм к собственному коду и решениям проектирования графических систем, не позволил поступить так. В общем было принято решение опробовать GCD на «пет» проекте, которым я как раз в то время занимался. И получилось довольно не плохо. Кроме задач решающих загрузку игровых ресурсов я стал использовать GCD там где это было уместно, ну или мне казалось, что это было уместно.

Прошло много времени и вот появились компиляторы полноценно поддерживающие C++11 стандарт. Так как работаю я в текущий момент в компании, занимающейся разработкой компьютерных игр, то особое требование ставится именно к разработке на С++. Большинству сотрудников чужд Objective-C. Да и сам я не питаю особой любви к этому языку (может быть только кроме его обьектной модели построенной по принципам языка Smalltalk).

Почитав спеки по 11 стандарту, проштудировав множество буржуинских блогов я решился написать свой велосипед схожий с Apple CGD. Конечно я не ставлю себе за цель обьять необьятное и ограничился лишь реализацией паттерна «Пул потоков» и возможностью выйти в любой момент из контекста второстепенного потока на контекст главного потока, и наоборот.

Для этого мне понадобились следующие новшевства С++11 — std::function, variadic templates и конечно работы с std::thread. (std::shared_ptr используется лишь для чувства собственного успокоения). Конечно еще одна цель, которую я поставил перед собой — это кроссплатформенность. И очень был разочарован, когда узнал, что компилятор от Microsoft, укомплектованый в VS 2012, не поддерживал variadic templates. Но, поштудировав немного stackoverflow, я увидел, что и эта проблема решается установкой допольнительного пакета «Visual C++ November 2012 CTP».
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Москва, Москва и Московская обл., Россия
Работает в
Дата рождения
Зарегистрирован
Активность