Обновить
-14
Виктор Швейгерт@anloop

Пользователь

Отправить сообщение

Полезные мелочи Windows администратора, поиск компьютеров пользователей и не только

Время на прочтение18 мин
Охват и читатели34K

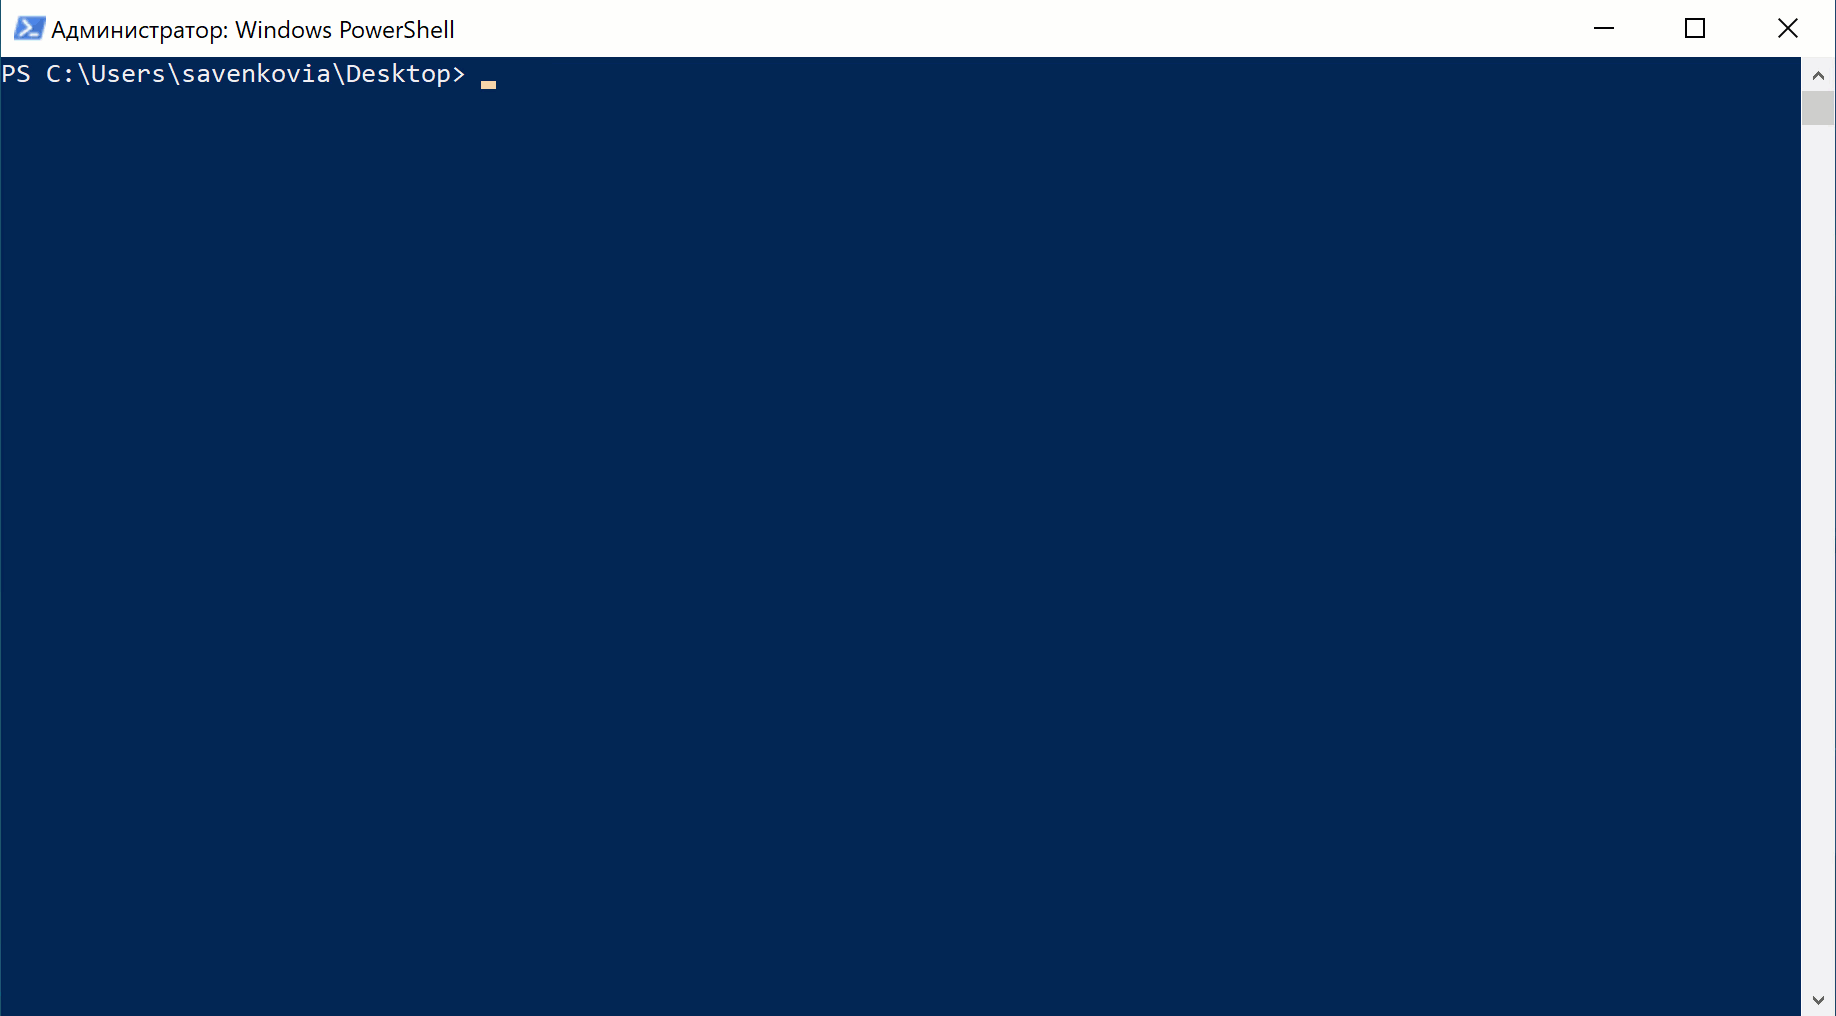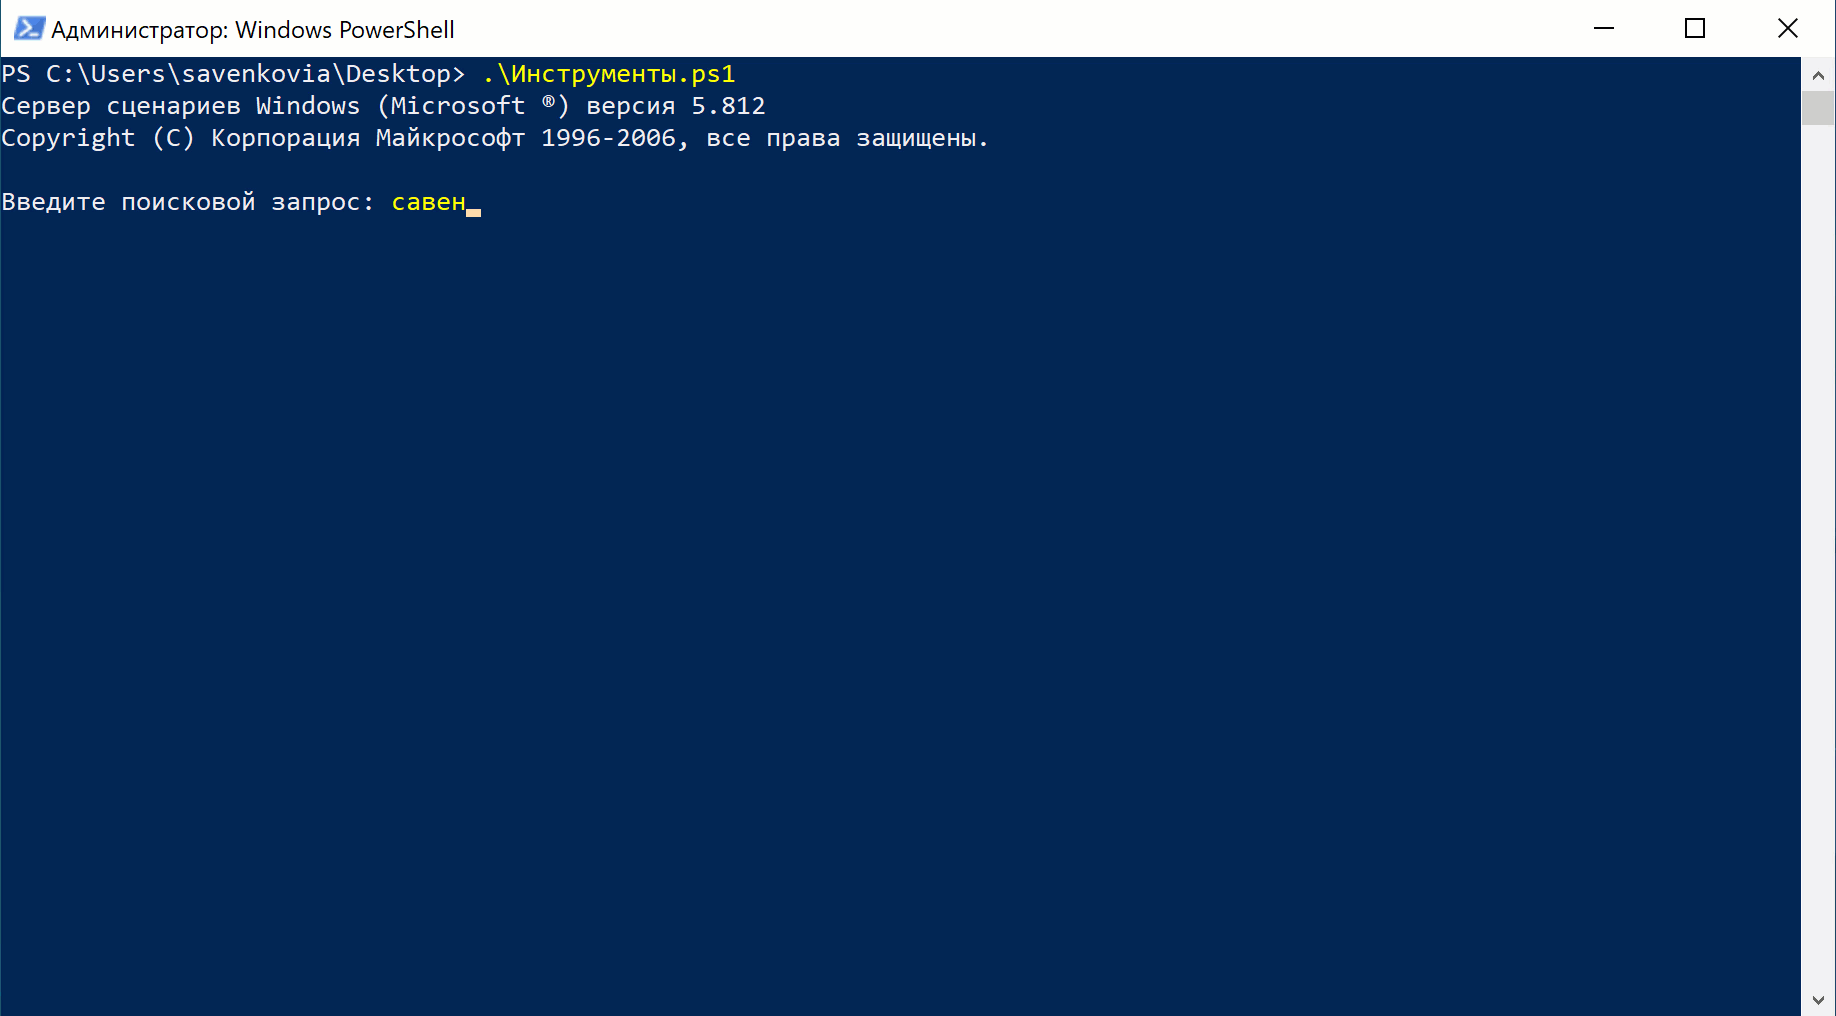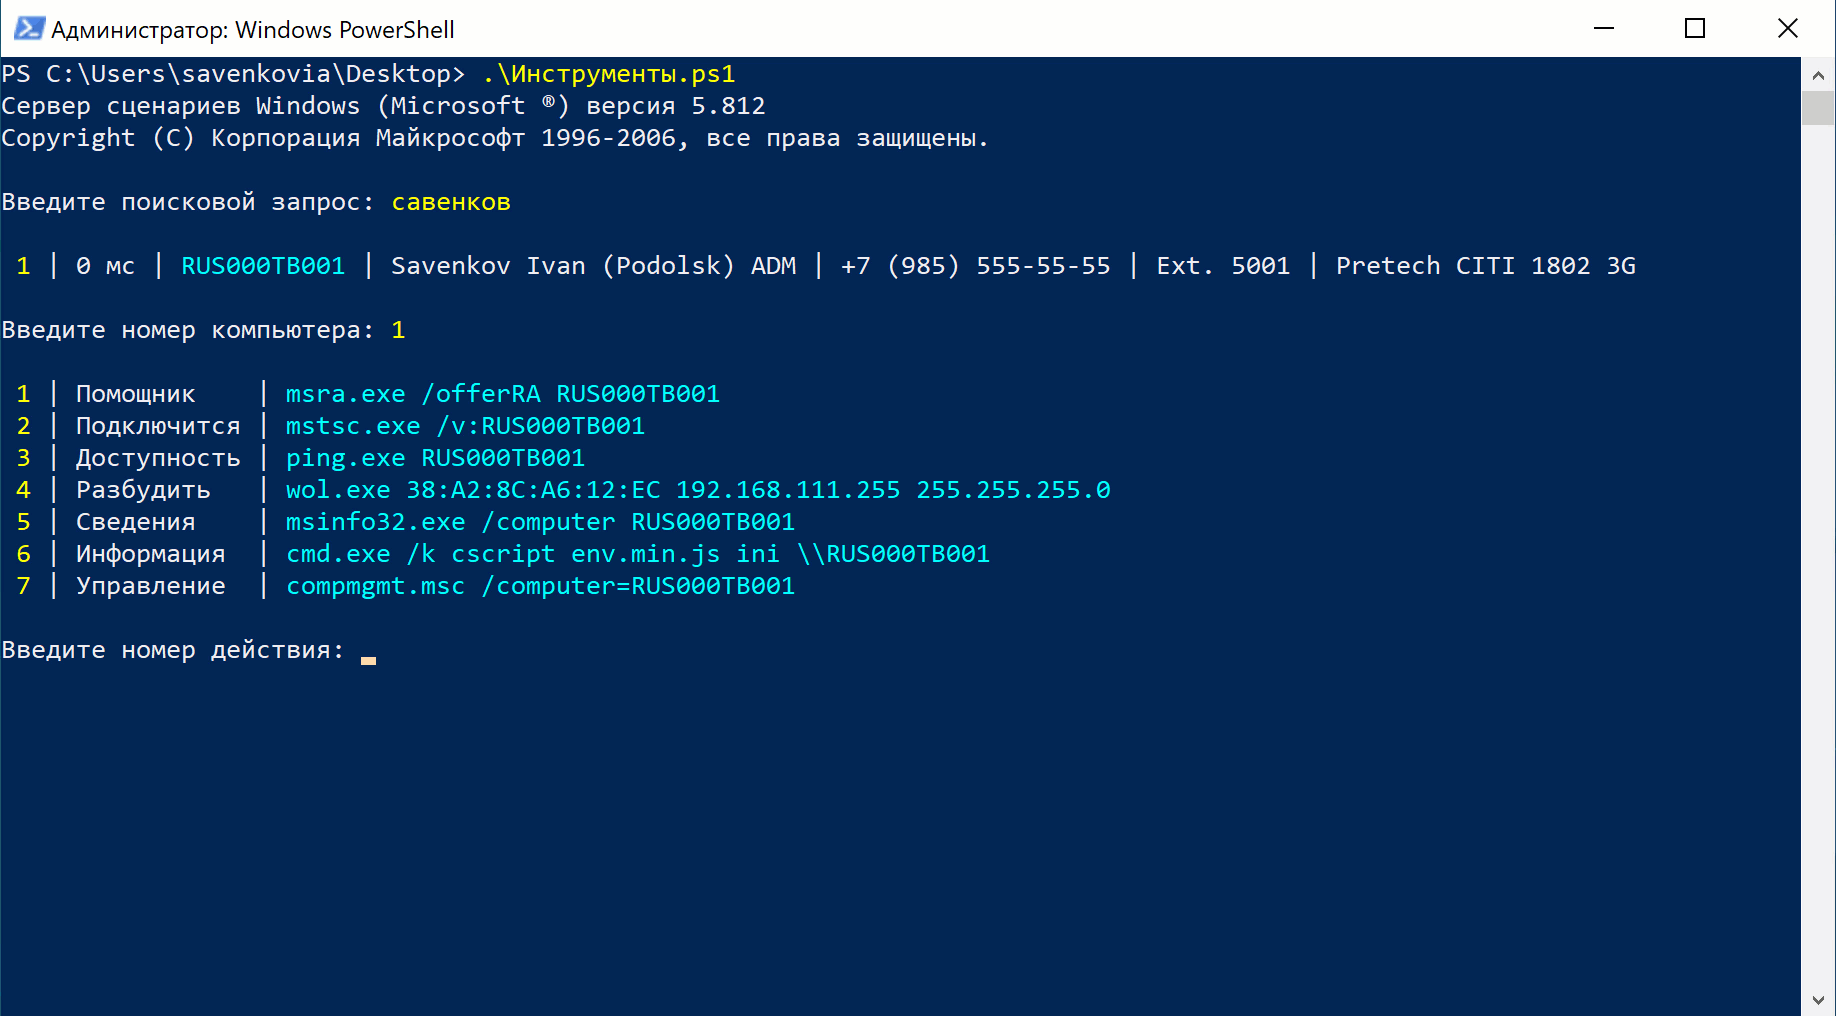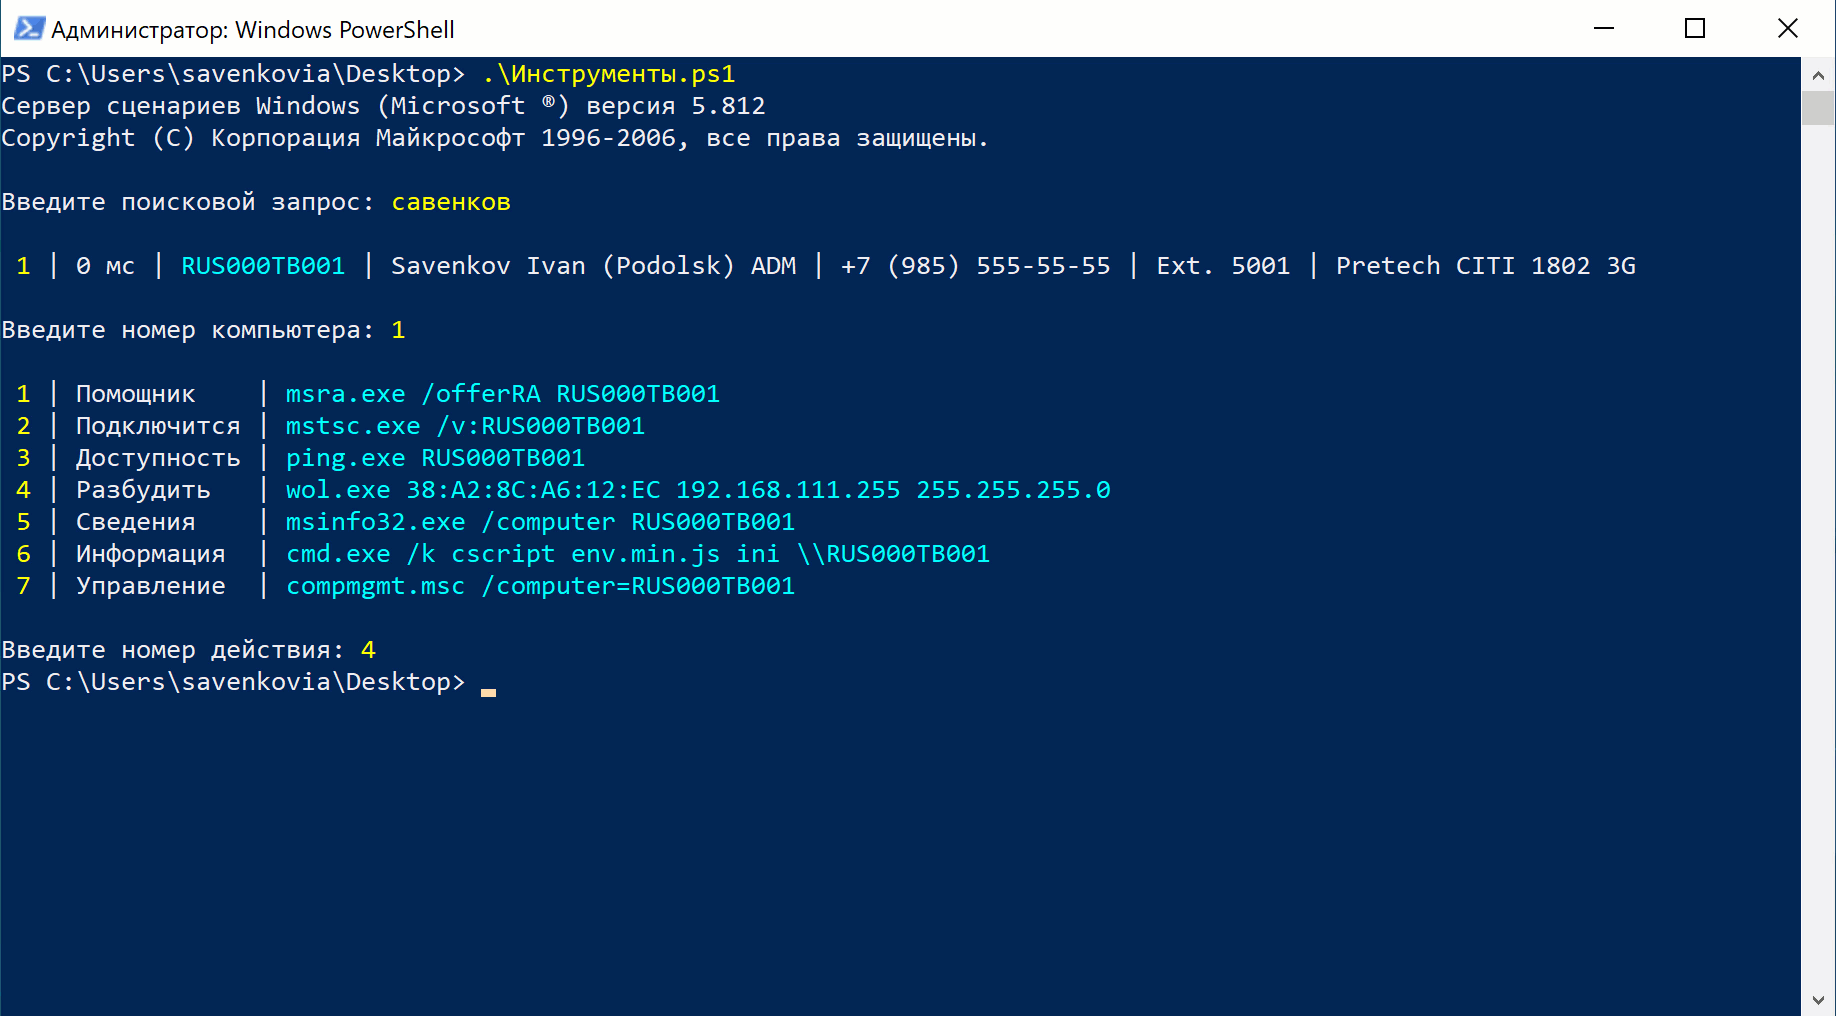
Как-то давно на хабре публиковалась статья Опытные мелочи Windows-админа. В ней рассказывалось как быстро и достаточно эффективно находить компьютеры на которых залогинился тот или иной пользователь.

Мне эта идея понравилась, т.к. всё делается достаточно просто, быстро и без модификации схемы Active Directory. Я постепенно улучшал изложенные в статье подходы и в итоге появились три скрипта, которыми я и хочу поделится с вами.

Читать далее

Ваша новая любимая команда для поиска и устранения неисправностей CISCO IOS

Время на прочтение11 мин
Охват и читатели7.3K

Простите за название блога с кликбейтом, но я говорю серьезно. Одна из самых неприятных вещей при поиске и устранении неисправностей в сети - это проблема с максимальным размером передаваемого блока данных (MTU)

Читать далее

Ventoy. Мультизагрузочная флешка

Время на прочтение3 мин
Охват и читатели273K

Мультизагрузочная флешка, сколько раз она меня выручала, с нее я чистил компы от вирусов, ставил Оси и т.д. В общем объяснять для чего она на хабре не нужно. Я знаю две самых известных утилиты для создания МФ - Easy2Boot и Win Setup From USB. Чем отличается Ventoy от них? Сейчас посмотрим.

Читать далее

Хороший Wi-Fi для предприятия: от А до Я

Время на прочтение11 мин
Охват и читатели34K

В продолжение двух статей про ЛВС, сегодня поговорим о том, как сделать хороший Wi-Fi для предприятия.

1. Разберем общие вопросы (от юридических моментов до выбора технологий);

2. Кратко и емко пройдемся по вопросам моделирования Wi-Fi;

3. Обсудим настройку сети Wi-Fi (мощность, выбор каналов, роуминг, WMM, Beamforming);

4. Разберем основные ошибки при проведении радио замеров;

5. Проведем эксперимент с микроволновкой на кухне.

Читать далее

Сеть контейнеров — это не сложно

Время на прочтение17 мин
Охват и читатели38K

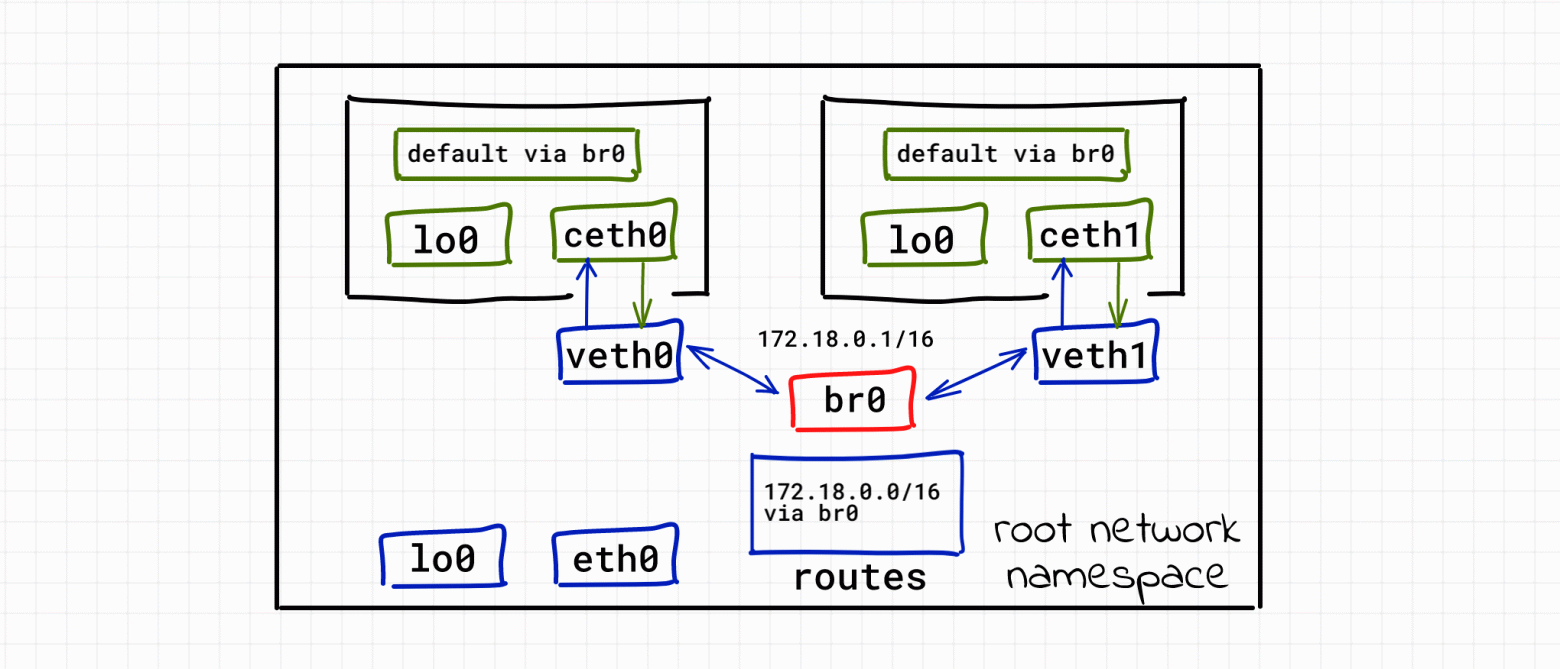
Работа с контейнерами многим кажется волшебством, пришло время разобраться как работает сеть Docker. Мы покажем на примерах, что это совсем не сложно. Нам потребуется немного сетевой магии и никакого кода...

В этой статье мы ответим на следующие вопросы:

• Как виртуализировать сетевые ресурсы, чтобы контейнеры думали, что у каждого из них есть выделенный сетевой стек?

• Как превратить контейнеры в дружелюбных соседей, не дать им мешать друг другу и научить хорошо общаться?

• Как настроить сетевой доступ из контейнера во внешний мир (например, в Интернет)?

• Как получить доступ к контейнерам, работающим на сервере, из внешнего мира (публикация портов)?

Читать далее

«Мистер X» или стоит ли небольшой команде рассмотреть XWiki как возможную замену Confluence?

Время на прочтение5 мин
Охват и читатели33K

В феврале 2021 Atlassian прекращает продажу лицензий на серверные версии Confluence. В этой статье я поделюсь своим виденьем Xwiki в качестве аналога Confluence, закрывающего потребности по документированию для небольшой команды разработчиков.

Читать далее

Обзор функционала Wi-Fi радиомоделирования в Intangi Iris

Время на прочтение3 мин
Охват и читатели3.1K
В последней версии Intangi Iris (5.5) появился новый функционал – Wireless View for Predictive Analysis. Он позволяет проводить моделирование покрытия Wi-Fi. В сравнении с топовыми продуктами для Wi-Fi радиомоделирования (Ekahau, MetaGeek и пр.), которые мы обычно используем у себя в «ЛАНИТ-Интеграции», функционал в Intangi Iris крайне скудный, но при этом достаточный для приблизительной оценки необходимого количества точек доступа Wi-Fi: возможно смоделировать только уровень сигнала в диапазонах 2.4 и 5 ГГц. В этой статье мы подробнее рассмотрим, в чем особенности нового функционала в Intangi Iris.

Источник

Intangi Iris – это бесплатная платформа, позволяющая осуществлять дизайн проектов компьютерных сетей, составлять конфигурации и спецификации оборудования таких вендоров, как APC, Aruba, Cisco, Extreme, Fortinet, HPE, Ruckus. 
Читать дальше →

Давайте обсудим мониторинг

Время на прочтение8 мин
Охват и читатели16K

Вот уже четвертый год я занимаюсь организацией того, что принято называть Observability. Набранный за это время опыт я обличаю в текст, делюсь им с вами в виде размышления-рекомендации и выношу на суд общественности. Здесь практически не будет технических деталей – статья намеренно написана таким образом, дабы изложенное можно было положить на практически любой стек технологий. Дело в том, что инструменты врываются в тренды и покидают их с невероятной скоростью, посему их выбор остается за вами.

Давайте обсудим мониторинг.

Читать далее

Аналитика в SD-WAN – как она выглядит и зачем нужна?

Время на прочтение5 мин
Охват и читатели4.5K
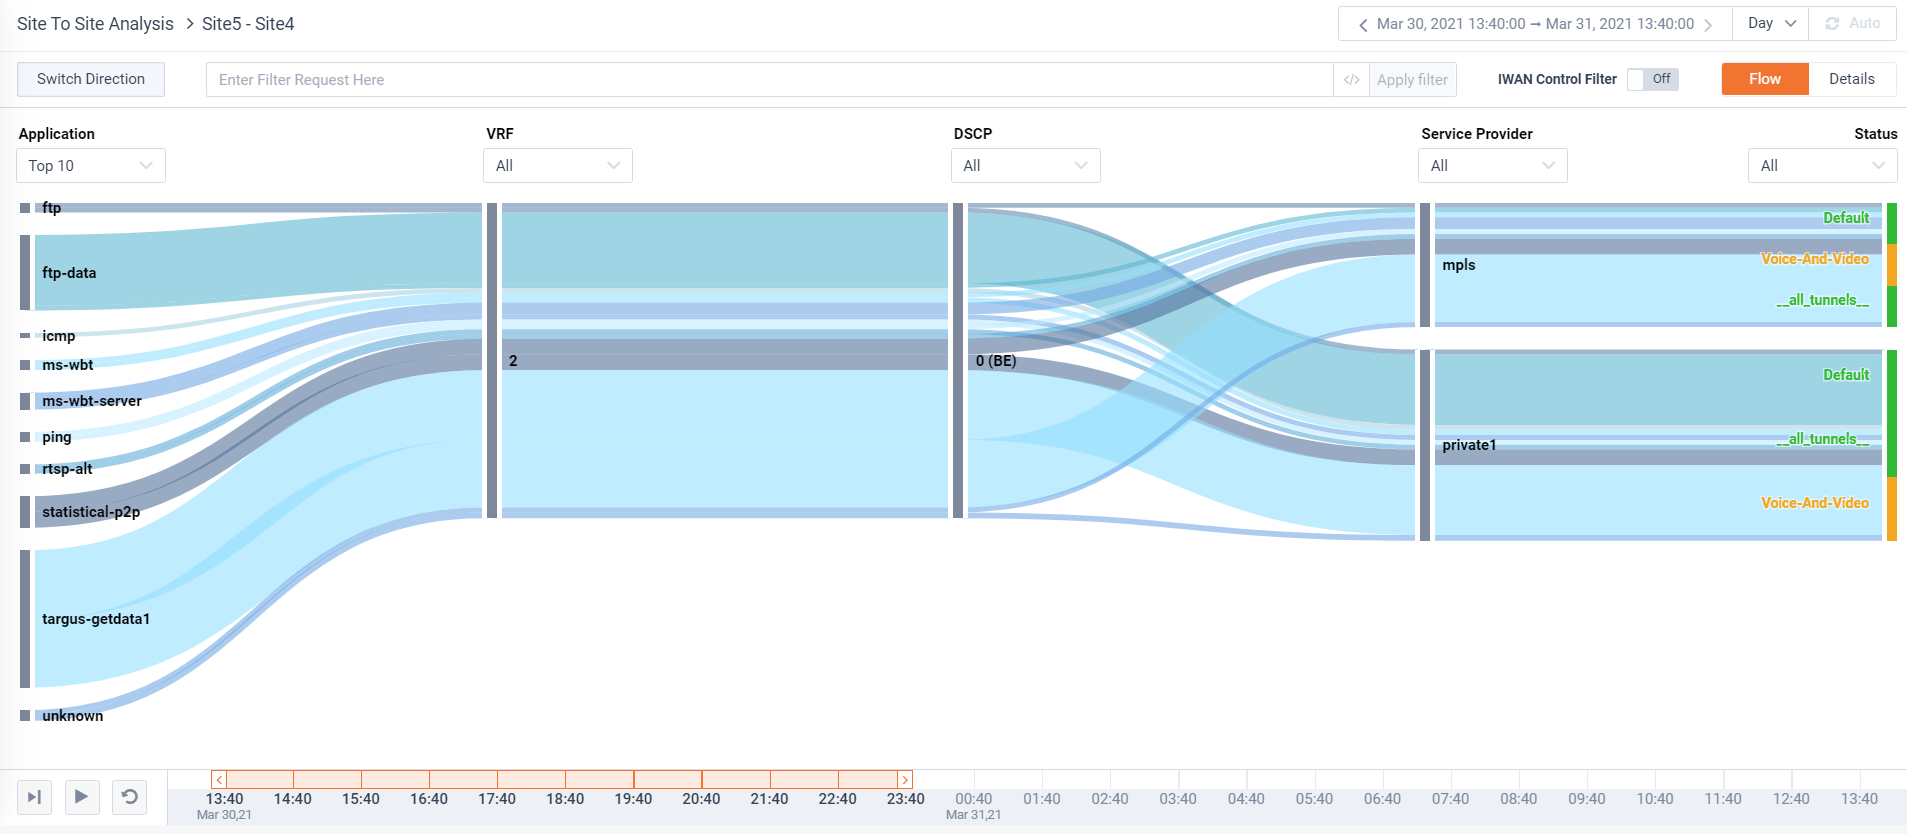
Привет, я работаю инженером в КРОК, где у нас есть своя SD-WAN-лаборатория. И когда заказчик приходит с вопросами вроде «А вот у меня в сети сейчас всё работает так, а как это будет работать, если я захочу перейти на SD-WAN? И будет ли работать вообще?» мы можем быстро собрать нужную схему, оттестировать и показать.

На днях мы добавили в наш стенд Cisco средство аналитики от компании-партнёра LiveAction, которое сейчас вовсю тестируем. Почему для SD-WAN вообще нужно какое-то особое средство аналитики? Во-первых, маршрутизация в такой сети устроена намного сложнее, чем в традиционной сети и администратору важно видеть, что происходит с трафиком с учётом всего многообразия настроек. Во-вторых, SD-WAN-сеть – это про обеспечение качества работы приложений, а значит необходимо иметь средства анализа качества работы этих приложений.

Расскажу, как эти решения работают в паре и как все настроить.


Читать дальше →

О переезде с Redis на Redis-cluster

Время на прочтение11 мин
Охват и читатели39K


Приходя в продукт, который развивается больше десятка лет, совершенно не удивительно встретить в нем устаревшие технологии. Но что если через полгода вы должны держать нагрузку в 10 раз выше, а цена падений увеличится в сотни раз? В этом случае вам необходим крутой Highload Engineer. Но за неимением горничной такового, решать проблему доверили мне. В первой части статьи я расскажу, как мы переезжали с Redis на Redis-cluster, а во второй части дам советы, как начать пользоваться кластером и на что обратить внимание при эксплуатации.

Читать дальше →

Автоматичное отключение пользователей в ISPManager5 lite без BILLmanager

Время на прочтение3 мин
Охват и читатели1.2K
Дано:

  1. VPS Сервер с вечной лицензией ispmanager lite 5
  2. 10-20 пользователей на сервере
  3. Google Calendar с регулярными напоминаниями у кого закончился хостинг
  4. Душащая жаба платить за что-либо еще, тем более на подписке

Цель, избавиться от google календаря и ручных напоминаниях клиенту о том что нужно оплатить хостинг. Избавить себя от «пусть еще немного поработает он скоро оплатит» «как то не удобно отключать», и поручить это решать бездушной машине.
Читать дальше →

Еще раз про живую миграцию: как перенести виртуальные машины Hyper-V, да побыстрее

Время на прочтение10 мин
Охват и читатели72K
     «Любишь Hyper-V – люби и PowerShell»
     Первое правило Сообщества Hyper-V в Телеграм 

     «А если любишь VMware ESXi, то люби PowerShell на пару с ESXi CLI и REST API»
     Дополнено мной

Живая миграция (live migration) – популярная функция в Hyper-V. Она позволяет переносить работающие виртуальные машины без видимого простоя. В сети много инструкций по переносу ВМ, но многие из них устарели. Вдобавок не все заглядывают в расширенные настройки и правильно используют возможности Live Migration. 

Я собрал нюансы и неочевидные параметры для быстрого переноса ВМ внутри кластера и между кластерами. Заодно поделюсь маленькими секретами в настройке и проектировании. Надеюсь, статья будет полезна начинающим админам.  

Дисклеймер: Все описанные шаги желательно сделать ДО ввода сервера Hyper-V в прод. Hyper-V никогда не прощает ошибок проектирования и подведет вас при первом удобном случае. То есть уже на следующий день.
Читать дальше →

Анализ производительности ВМ в VMware vSphere. Часть 3: Storage

Время на прочтение7 мин
Охват и читатели41K


Часть 1. Про CPU
Часть 2. Про Memory

Сегодня разберем метрики дисковой подсистемы в vSphere. Проблема со стораджем – самая частая причина медленной работы виртуальной машины. Если в случаях с CPU и RAM траблшутинг заканчивается на уровне гипервизора, то при проблемах с диском, возможно, придется разбираться с сетью передачи данных и СХД.

Тему буду разбирать на примере блочного доступа к СХД, хотя при файловом доступе счетчики примерно те же.
Читать дальше →

Руководство для начинающих по SELinux

Время на прочтение5 мин
Охват и читатели76K


Перевод статьи подготовлен для студентов курса «Безопасность Linux»


SELinux или Security Enhanced Linux — это улучшенный механизм управления доступом, разработанный Агентством национальной безопасности США (АНБ США) для предотвращения злонамеренных вторжений. Он реализует принудительную (или мандатную) модель управления доступом (англ. Mandatory Access Control, MAC) поверх существующей дискреционной (или избирательной) модели (англ. Discretionary Access Control, DAC), то есть разрешений на чтение, запись, выполнение.

Читать дальше →

Анализ производительности виртуальной машины в VMware vSphere. Часть 1: CPU

Время на прочтение11 мин
Охват и читатели98K


Если вы администрируете виртуальную инфраструктуру на базе VMware vSphere (или любого другого стека технологий), то наверняка часто слышите от пользователей жалобы: «Виртуальная машина работает медленно!». В этом цикле статей разберу метрики производительности и расскажу, что и почему «тормозит» и как сделать так, чтобы не «тормозило».

Буду рассматривать следующие аспекты производительности виртуальных машин:

  • CPU,
  • RAM,
  • DISK,
  • Network.

Начну с CPU.

Для анализа производительности нам понадобятся:

  • vCenter Performance Counters – счетчики производительности, графики которых можно посмотреть через vSphere Client. Информация по данным счетчикам доступна в любой версии клиента (“толстый” клиент на C#, web-клиент на Flex и web-клиент на HTML5). В данных статьях мы будем использовать скриншоты из С#-клиента, только потому, что они лучше смотрятся в миниатюре:)
  • ESXTOP – утилита, которая запускается из командной строки ESXi. С ее помощью можно получить значения счетчиков производительности в реальном времени или выгрузить эти значения за определенный период в .csv файл для дальнейшего анализа. Далее расскажу про этот инструмент подробнее и приведу несколько полезных ссылок на документацию и статьи по теме.

Читать дальше →

Анализ производительности ВМ в VMware vSphere. Часть 2: Memory

Время на прочтение10 мин
Охват и читатели47K


Часть 1. Про CPU
Часть 3. Про Storage

В этой статье поговорим про счетчики производительности оперативной памяти (RAM) в vSphere.
Вроде бы с памятью все более однозначно, чем с процессором: если на ВМ возникают проблемы с производительностью, их сложно не заметить. Зато если они появляются, справиться с ними гораздо сложнее. Но обо всем по порядку.
Читать дальше →

Настройка резервного копирования и восстановления Zimbra OSE целиком и отдельными ящиками, не используя Zextras

Время на прочтение16 мин
Охват и читатели21K
image

1. С чего начать


С чего начинается резервное копирование? Планирование. При резервировании любой системы необходимо составить план резервного копирования: что именно, как часто, как долго хранить, хватит ли свободного пространства? Из ответов на эти вопросы вытекает ответ на главный вопрос – чем бэкапить?

Если свободного пространства много – можно хранить целиком виртуальную машину. Делать бэкапы тем же Veeam по расписанию, и не думать о сложностях. Но как по мне, так это расточительство, я привык делать все максимально сжато и, по возможности, экономично. Veeam у меня, конечно же, развернут, но им я делаю резервные копии лишь тех систем, которые либо невозможно, либо проблематично и очень долго разворачивать из резервных копий.

Про скрипты средств управления виртуальной средой просто многозначительно промолчу.

У Zimbra есть инструмент zmmailbox. И, при ближайшем рассмотрении его функционала, я понял, что его мне будет более, чем достаточно. Он умеет резервировать и восстанавливать ящики даже на живой системе. И мне понравилась возможность делать бэкапы критичных почтовых ящиков отдельно от бэкапа всей системы. Таким образом пространство, занимаемое резервными копиями, будет ограничено размером заархивированных почтовых ящиков, помноженным на количество дней «глубины бэкапа», а не объемом всей системы, помноженной на то же количество дней. К тому же с бэкапа всей системы, в случае с Zimbra, крайне сложно восстановиться. Гораздо проще скопировать виртуальную машину с помощью Veeam или средств управления виртуальной средой (Hyper-V, ESXI, вписать нужное) сразу после настройки системы, и положить «на полочку», чтобы в критичный момент можно было быстро развернуть почти ничего не весящую ВМ и залить в нее бэкапы ящиков. По-моему, это наименее затратный во всех отношениях сценарий.
Читать дальше →

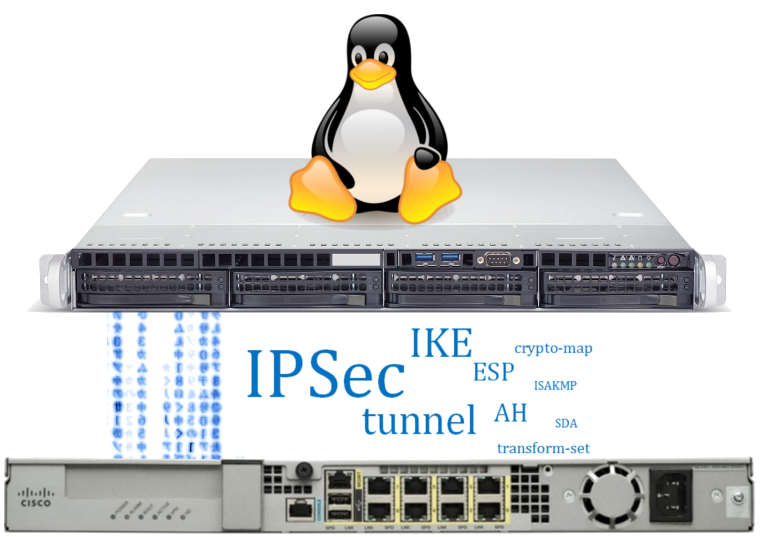
Непростой IPSec с Linux

Время на прочтение12 мин
Охват и читатели67K


Развивая IT-инфраструктуру рано или поздно приходит задача интегрироваться с какими-либо сервисами крупной организации. Это может быть, например, банк или оператор связи. Как правило в крупных организациях действуют устоявшиеся политики информационной безопасности, которые в частности требуют реализации сервиса с внешней по отношению к ним инфраструктурой через шифрованные каналы — IPSec. В то же время в небольших организациях стартапах нет опыта организации таких схем, а из оборудования есть только VDS с Linuxом на борту. Более того, к моему удивлению, в рунете практически нет материалов с описанием инструментов траблшутинга под Linux. Попробуем устранить этот пробел и описать практическую часть настроек.
Читать дальше →

OSPF (часть первая)

Время на прочтение11 мин
Охват и читатели254K
Данная статья была написана для себя, чтоб при необходимости быстро освежить память и разобраться с теорией. Решил ее опубликовать, возможно кому-то будет полезна, а может в чем то ошибаюсь.

В данной статье попытаемся разобраться с теорией работы протокола OSPF. Не будем углубляться в историю и процесс создания протокола, данная информация в изобилии есть почти в каждой статье о OSPF. Мы постараемся более детально разобраться как работает протокол OSPF и как строит свою таблицу маршрутизации. Важно дать общее определение протокола:

OSPF (англ. Open Shortest Path First) — протокол динамической маршрутизации, основанный на технологии отслеживания состояния канала (link-state technology) и использующий для нахождения кратчайшего пути алгоритм Дейкстры.

Возникает сразу вопрос — Что есть технология отслеживания состояния канала? Данное название считаю не совсем удачным. Сложилось так, что существует два типа протоколов динамической маршрутизации: Link-state и Distance-Vector. Рассмотрим их принципы работы:

В Distance-Vector протоколах, маршрутизатор узнает информацию о маршрутах посредством маршрутизаторов непосредственно подключенных в один с ним сегмент сети. То есть, маршрутизатор имеет информацию о топологии только в границах его соседних маршрутизаторов и понятия не имеет как устроена топология за этими маршрутизаторами, ориентируясь только по метрикам. В Link-state протоколах каждый маршрутизатор должен непросто знать самые лучшие маршруты во все удалённые сети, но и иметь в памяти полную карту сети со всеми существующими связями между другими маршрутизаторами в том числе. Это достигается за счет построения специальной базы LSDB, но подробнее об этом позже.
Читать дальше →

Интеграция Asterisk и Битрикс24

Время на прочтение9 мин
Охват и читатели78K

В сети есть разные варианты интеграции IP-АТС Asterisk и CRM Битрикс24, но мы, все таки, решили написать свою.

По функционалу все стандартно:

  • Кликом на ссылку с номером телефона клиента в Битрикс24, Asterisk соединяет внутренний номер пользователя, от имени которого это клик совершен, с номером телефона клиента. 
В Битрикс24 фиксируется запись о звонке и по окончании вызова подтягивается запись разговора.
  • На Asterisk поступает звонок извне — в интерфейсе Битрикс24 показываем карточку клиента тому сотруднику, на номер которого этот звонок прилетел.
    Если такого клиента нет, откроем карточку создания нового лида.
    Как только звонок завершен, отражаем это в карточке и подтягиваем запись разговора.

Под катом расскажу как все настроить у себя и дам линк на github — да-да, забирайте и пользуйтесь!
Читать дальше →

Информация

В рейтинге
Не участвует
Откуда
Новосибирск, Новосибирская обл., Россия
Дата рождения
Зарегистрирован
Активность