Обновить
-1

Пользователь

Отправить сообщение

Логика мышления. Часть 1. Нейрон

Время на прочтение10 мин
Охват и читатели329K


Года полтора назад я выкладывал на Хабр цикл видеолекций с моим видением того как работает мозг и каковы возможные пути создания искусственного интеллекта. За прошедшее с тех пор время удалось существенно продвинуться вперед. Что-то получилось глубже понять, что-то удалось смоделировать на компьютере. Что приятно, появились единомышленники, активно участвующие в работе над проектом.

В настоящем цикле статей планируется рассказать о той концепции интеллекта над которой мы сейчас работаем и продемонстрировать некоторые решения, являющиеся принципиально новыми в сфере моделирования работы мозга. Но чтобы повествование было понятным и последовательным оно будет содержать не только описание новых идей, но и рассказ о работе мозга вообще. Какие-то вещи, особенно в начале, возможно покажутся простыми и общеизвестными, но я бы советовал не пропускать их, так как они во многом определяют общую доказательность повествования.
Читать дальше →

Алгоритм Улучшенной Самоорганизующейся Растущей Нейронной Сети (ESOINN)

Время на прочтение6 мин
Охват и читатели34K

Введение


В моей предыдущей статье о методах машинного обучения без учителя был рассмотрен базовый алгоритм SOINN — алгоритм построения самоорганизующихся растущих нейронных сетей. Как было отмечено, базовая модель сети SOINN имеет ряд недостатков, не позволяющих использовать её для обучения в режиме lifetime (т.е. для обучения в процессе всего срока эксплуатации сети). К таким недостаткам относилась двухслойная структура сети, требующая при незначительных изменениях в первом слое сети переобучать второй слой полностью. Также алгоритм имел много настраиваемых параметров, что затрудняло его применение при работе с реальными данными.

В этой статье будет рассмотрен алгоритм An Enhanced Self-Organizing Incremental Neural Network, являющийся расширением базовой модели SOINN и частично решающий озвученные проблемы.
Читать дальше →

Как заработать $500K на машинном обучении и высокочастотном трейдинге — Часть 2

Время на прочтение3 мин
Охват и читатели62K

Изображение: Chris Liverani — Unsplash

Это продолжение разбора темы (часть 1), захватившей мое внимание и пришедшейся по душе на Хабре. Обсуждаем проект парня, который, применив свой опыт в IT, смог заработать полмиллиона долларов.
Читать дальше →

Введение в оптимизацию. Имитация отжига

Время на прочтение10 мин
Охват и читатели202K
В этой статье я постараюсь максимально доходчиво рассказать о таком простом, но эффективном методе оптимизации, как имитация отжига (simulated annealing). А чтобы не быть причисленным к далёким от практики любителям теоретизировать, я покажу как применить этот метод для решения задачи коммивояжёра.

Для понимания статьи Вам понадобятся минимальные навыки программирования и владение математикой на уровне 9 класса средней школы. Статья рассчитана на людей не знакомых с методами оптимизации или только делающих первые шаги в этом направлении.

image


Читать дальше →

Пару слов о распознавании образов

Время на прочтение13 мин
Охват и читатели319K
Давно хотел написать общую статью, содержащую в себе самые основы Image Recognition, некий гайд по базовым методам, рассказывающий, когда их применять, какие задачи они решают, что возможно сделать вечером на коленке, а о чём лучше и не думать, не имея команды человек в 20.
image

Какие-то статьи по Optical Recognition я пишу давненько, так что пару раз в месяц мне пишут различные люди с вопросами по этой тематике. Иногда создаётся ощущение, что живёшь с ними в разных мирах. С одной стороны понимаешь, что человек скорее всего профессионал в смежной теме, но в методах оптического распознавания знает очень мало. И самое обидное, что он пытается применить метод из близрасположенной области знаний, который логичен, но в Image Recognition полностью не работает, но не понимает этого и сильно обижается, если ему начать рассказывать что-нибудь с самых основ. А учитывая, что рассказывать с основ — много времени, которого часто нет, становится всё ещё печальнее.
Распознать

Как я сделал тестер-оптимизатор для нахождения прибыльных стратегий на бирже

Время на прочтение10 мин
Охват и читатели98K

Введение


image

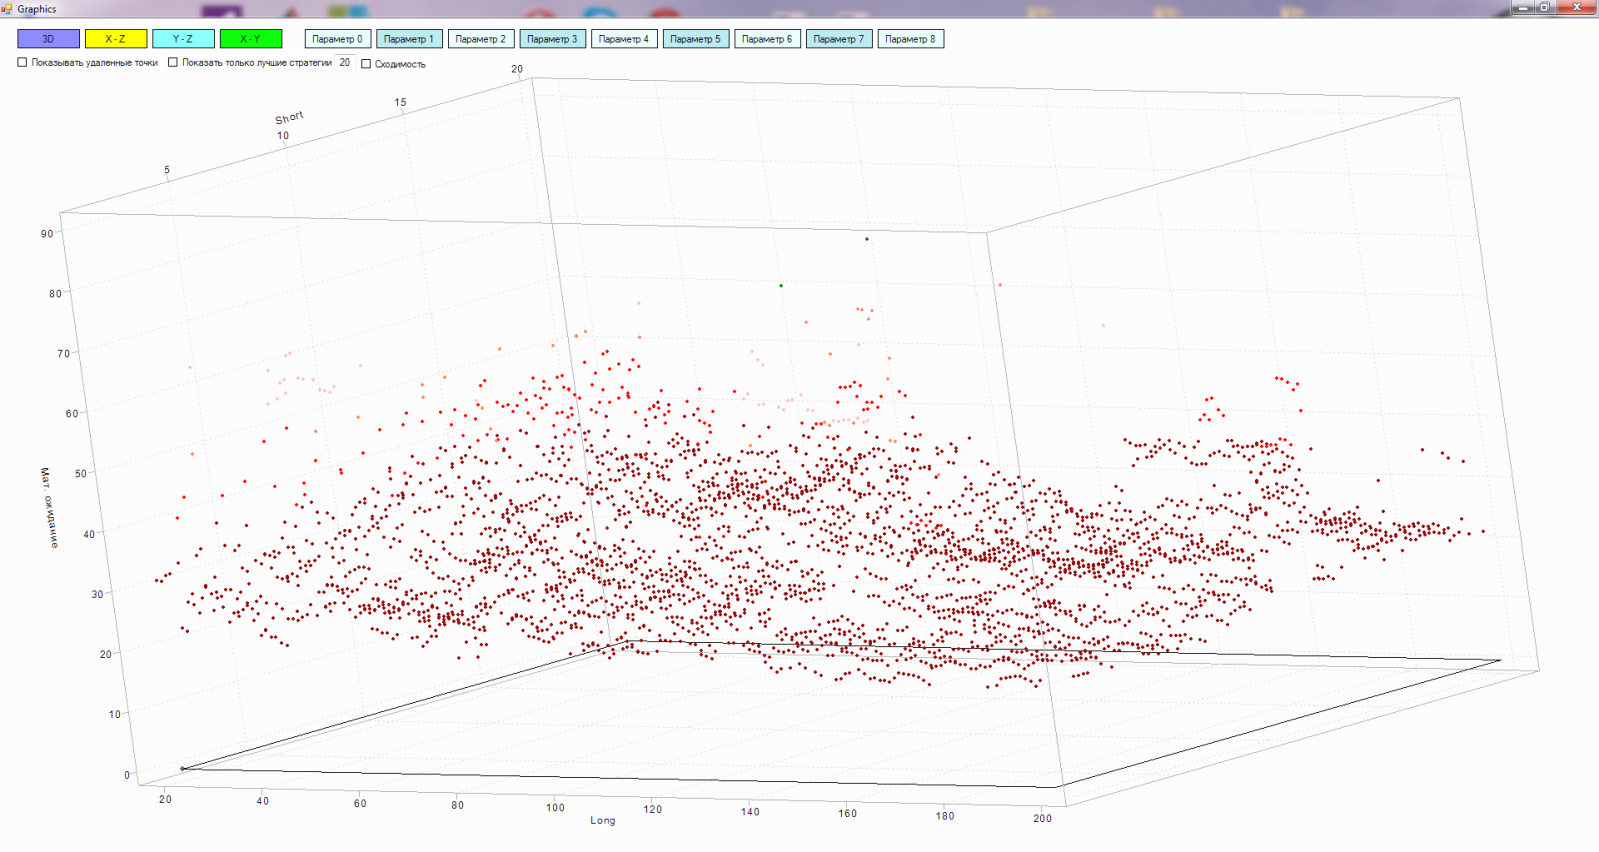
В алгоритмическом трейдинге при создании механических торговых систем (МТС) очень важен вопрос времени жизни торговых алгоритмов. Да, и найти их в принципе достаточно сложно. В условиях постоянно меняющегося рынка рано или поздно наступает момент, когда даже самый совершенный и прибыльный алгоритм начинает приносить убытки. И его нужно, что называется, «подкручивать» или оптимизировать под текущие условия рынка. Одними из самых распространенных являются торговые системы (ТС), работающие со свечными графиками с их многообразием индикаторов для технического анализа.
Читать дальше →

Как заработать $500K на машинном обучении и высокочастотном трейдинге — Часть 1

Время на прочтение5 мин
Охват и читатели182K

Изображение: Kevin Ku — Unsplash

На Хабре часто появляются материалы о том, как IT-специалисту сохранить и приумножить свои деньги. Неудивительно, что тема вызывает интерес и все больше дискуссий. На днях мне попалась статья парня, который, применив свои технологические навыки, смог за год заработать полмиллиона долларов. Мне кажется, его опыт может быть интересен многим (даже если отбросить тот факт, что он не первый день на бирже), поэтому я предлагаю обсудить его мысли. Но сделать это в два подхода — оригинальный пост достаточно объемный для одного хабратопика.
Читать дальше →

Параллельные и распределенные вычисления. Лекции от Яндекса для тех, кто хочет провести праздники с пользой

Время на прочтение3 мин
Охват и читатели83K
Праздничная неделя подходит к концу, но мы продолжаем публиковать лекции от Школы анализа данных Яндекса для тех, кто хочет провести время с пользой. Сегодня очередь курса, важность которого в наше время сложно переоценить – «Параллельные и распределенные вычисления».

Что внутри: знакомство с параллельными вычислениями и распределёнными системами обработки и хранения данных, а также выработка навыков практического использования соответствующих технологий. Курс состоит из четырех основных блоков: concurrence, параллельные вычисления, параллельная обработка больших массивов данных и распределенные вычисления.


Лекции читает Олег Викторович Сухорослов, старший научный сотрудник Центра грид-технологий и распределенных вычислений ИСА РАН. Доцент кафедры распределенных вычислений ФИВТ МФТИ. Кандидат технических наук.
Содержание и тезисы лекций

Генерация случайных чисел большой разрядности

Время на прочтение5 мин
Охват и читатели42K

imageОднажды я столкнулся с задачей генерации 128-битных случайных чисел для реализации генетического алгоритма. Из-за большой размерности задачи алгоритм гонялся долго, поэтому были повышенные требования к скорости работы. Я решил написать свой генератор специально для поставленной задачи.

В этом посте речь пойдет о применении линейного конгруэнтного метода для получения псевдослучайных чисел разрядности 64 и 128 бит с пояснением принципа работы и подбора параметров.

Если вам в тягость пользоваться ГСЧ из стандартной библиотеки, у вас к нему нестандартные требования или просто охота держать под контролем весь процесс генерации случайных чисел в своем приложении, добро пожаловать под кат.

Читать дальше →

Лекции от Яндекса для тех, кто хочет провести каникулы с пользой. Дискретный анализ и теория вероятностей

Время на прочтение3 мин
Охват и читатели145K
Для тех, кому одного курса на праздники мало и кто хочет больше, продолжаем нашу серию курсов от Школы анализа данных Яндекса. Сегодня подошла очередь курса «Дискретный анализ и теория вероятностей» – даже более фундаментального, чем предыдущий. Но без него нельзя представить ещё большую часть современной обработки данных.

В рамках курса рассматриваются основные понятия и методы комбинаторного, дискретного и асимптотического анализа, теории вероятностей, статистики и на примере решения классических задач демонстрируется их применение.


Читает курс Андрей Райгородский. Доктор физико-математических наук. Профессор кафедры математической статистики и случайных процессов механико-математического факультета МГУ им. М. В. Ломоносова. Заведующий кафедрой Дискретной математики ФИВТ МФТИ. Профессор и научный руководитель бакалавриата кафедры «Анализ данных» факультета инноваций и высоких технологий МФТИ. Руководитель отдела теоретических и прикладных исследований компании «Яндекс». (Ещё больше можно узнать в статье о нём на Википедии).

Содержание курса и тезисы лекций

STM32 и USB-HID — это просто

Время на прочтение14 мин
Охват и читатели398K
На дворе 2014 год, а для связи микроконтроллеров с ПК самым популярным средством является обычный последовательный порт. С ним легко начать работать, он до примитивности прост в понимании — просто поток байт.
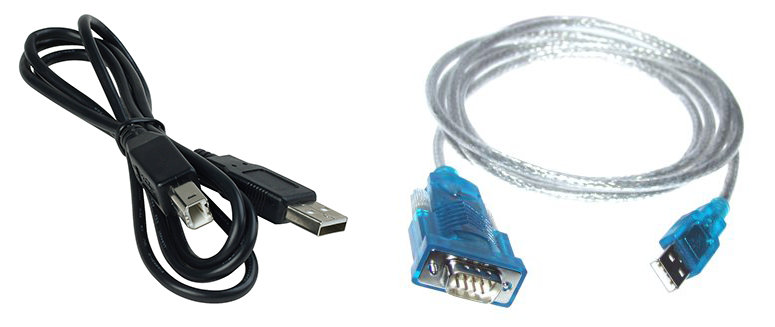
Однако все современные стандарты исключили COM порт из состава ПК и приходится использовать USB-UART переходники, чтобы получить доступ к своему проекту на МК. Не всегда он есть под рукой. Не всегда такой переходник работает стабильно из-за проблем с драйверами. Есть и другие недостатки.
Но каждый раз, когда заходит разговор о том, применять USB или последовательный порт, находится множество поклонников логической простоты UART. И у них есть на то основания. Однако, хорошо ведь иметь альтернативу?

Меня давно просили рассказать как организовать пакетный обмен данными между ПК и МК на примере STM32F103. Я дам готовый рабочий проект и расскажу как его адаптировать для своих нужд. А уж вы сами решите — нужно оно вам или нет.

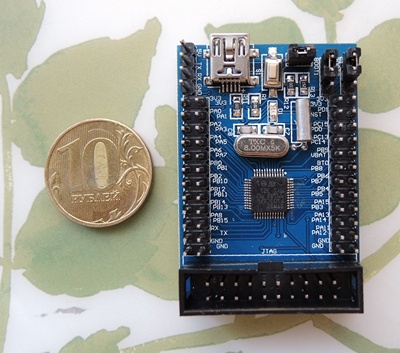
У нас есть плата с современным недорогим микроконтроллером STM32F103C8 со встроенной аппаратной поддержкой USB, я рассказывал о ней ранее

Заставим ее работать

Machine Learning. Курс от Яндекса для тех, кто хочет провести новогодние каникулы с пользой

Время на прочтение8 мин
Охват и читатели269K
Новогодние каникулы – хорошее время не только для отдыха, но и для самообразования. Можно отвлечься от повседневных задач и посвятить несколько дней тому, чтобы научиться чему-нибудь новому, что будет помогать вам весь год (а может и не один). Поэтому мы решили в эти выходные опубликовать серию постов с лекциями курсов первого семестра Школы анализа данных.

Сегодня — о самом важном. Современный анализ данных без него представить невозможно. В рамках курса рассматриваются основные задачи обучения по прецедентам: классификация, кластеризация, регрессия, понижение размерности. Изучаются методы их решения, как классические, так и новые, созданные за последние 10–15 лет. Упор делается на глубокое понимание математических основ, взаимосвязей, достоинств и ограничений рассматриваемых методов. Отдельные теоремы приводятся с доказательствами.


Читает курс лекций Константин Вячеславович Воронцов, старший научный сотрудник Вычислительного центра РАН. Заместитель директора по науке ЗАО «Форексис». Заместитель заведующего кафедрой «Интеллектуальные системы» ФУПМ МФТИ. Доцент кафедры «Математические методы прогнозирования» ВМиК МГУ. Эксперт компании «Яндекс». Доктор физико-математических наук.
Содержание и видео всех лекций курса

Создание собственных драйверов под Linux

Время на прочтение24 мин
Охват и читатели216K


Многие мои друзья и знакомые крутят пальцем у виска или задаются вопросом: не жмёт ли мне череп, когда узнают, что я пишу драйвера под Linux. Слово “драйвер” окутано каким-то почти мистическим смыслом, и постичь Дао его написания способны лишь избранные гуру.
К счастью это не так. Не знаю, как обстоят дела с написанием драйверов под другие операционные системы, в т.ч. и наиболее популярные, но под linux, вне зависимости от аппаратной архитектуры драйвера пишутся очень просто. Для написания драйвера необходимы базовые знания языка си, представление о работе ОС линукс (базовые), понимание того, что мы хотим получить, желание чтения документации и исходных кодов, ну и усидчивость. Всё.
Вы хотите посмотреть как написать драйвер для своего устройства? Тогда ныряйте под кат!
Читать дальше →

Зачем Google добавляет while(1); к своим JSON-ответам?

Время на прочтение2 мин
Охват и читатели69K
Это позволяет избежать CSRF/XSRF-атак (подделки межсайтовых запросов).

Рассмотрим следующий пример: допустим у Google есть URL вида gmail.com/json?action=inbox, который возвращает 50 первых сообщений вашего почтового ящика в формате JSON. Злоумышленник, чей сайт находятся на другом домене, не может выполнить AJAX запрос, обратившись по данному URL, чтобы получить данные, ввиду same origin policy (правило ограничения домена). Но ничто не мешает злоумышленнику включить вышеуказанный URL на свою страницу с помощью тега .
Читать дальше →

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность