Обновить
-1

Пользователь

Отправить сообщение

Как ТСПУ ловит VLESS в 2026 и почему XHTTP — следующий шаг

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели286K

Разбор методов детекции, которые работают прямо сейчас. JA3/JA4-отпечатки, поведенческий анализ и архитектура XHTTP, которая закрывает именно эти дыры

Если твой VLESS+Reality сервер лёг в последние месяцы — ты не один. В сообществах фиксируют волны блокировок, которые раньше не достигали хорошо настроенных Reality-серверов. Что конкретно изменилось, как это устроено на уровне алгоритмов — и почему XHTTP сейчас выглядит как правильный следующий шаг.

Читать далее

Проблема не в промпте: как Claude Code плывет на длинных задачах и как управлять контекстом

Уровень сложностиСредний
Время на прочтение13 мин
Охват и читатели15K

На коротких задачах coding-агент выглядит почти как живой разработчик: читает код, гоняет тесты, находит проблему, предлагает diff, но на длинной дистанции магия заканчивается. Стоит агенту или пользователю подмешать еще пару логов, несколько файлов "на всякий случай" или еще один MCP-сервер, и агент начинает забывать договоренности, повторять уже проверенные шаги и терять план.

Обычно это объясняют так: "модель тупит" или "надо лучше промптить", но на практике проблема часто в другом: мы складируем состояние задачи в историю чата и надеемся, что модель удержит его сама. Не удержит.

Контекст у LLM - это не бездонный мешок, а рабочая часть "памяти" модели, ее нужно проектировать: что хранить отдельно, что подмешивать just-in-time, что выбрасывать после шага и что обязательно возвращать после compaction.

В этой статье я разберу context engineering на примере coding agents, а конкретно на Claude Code: почему long context до сих пор деградирует, почему проблема особенно больно бьет по агентам, чем полезны /compact и Plan Mode, и как собрать минимальный контекстный конвейер без магии и лишней философии.

Читать далее

Как я построил Graph RAG систему с точностью 96.7% за 5 дней: от научных статей до production-ready пайплайна

Уровень сложностиСредний
Время на прочтение6 мин
Охват и читатели15K

Я реализовал Graph RAG систему, которая комбинирует 5 техник из свежих научных статей (KET-RAG, HippoRAG 2, VectorCypher) в единый пайплайн с декларативным Datalog reasoning-движком, полной провенансной трассировкой и типизированным API. Результат: 174/180 (96.7%) на билингвальном бенчмарке из 30 вопросов, оценённых в 6 режимах retrieval. Три режима достигли 100%. В статье — архитектура, 10 уроков оптимизации и эволюция от 38% до 96.7% за 10 итераций.

Читать далее

Мультиагентная разработка: от хотелок до продакшена

Уровень сложностиСредний
Время на прочтение14 мин
Охват и читатели19K

Мультиагентная разработка — это возможность превратить работу с AI из «вайб‑кодинга» в управляемый конвейер: от хотелок до тестов и документации.

В статье я покажу свой «велосипед»: набор специализированных агентов (PO/BA/SA/архитектор/разработчик/тестировщик/техпис) и оркестратор, который гоняет их по пайплайну с изоляцией контекста.

Читать далее

Claude Code научился запоминать задачи — но нужна одна настройка

Уровень сложностиСложный
Время на прочтение6 мин
Охват и читатели10K

Персистентные Tasks, субагенты на общем списке, зависимости между задачами — разбираем обновление и подводные камни.

Читать далее

Как оптимизировать и поднять эффективность AI-Кодинга от 2 до 8 раз используя стек MCP серверов

Уровень сложностиСредний
Время на прочтение46 мин
Охват и читатели30K

От красивых демок к законченным проектам: что я понял за полтора года работы с Claude Code

Я не программист. Я гуманитарий, который научился использовать ИИ для создания рабочих приложений. Но если эта статья поможет и вам господа разработчики, то моя гуманитарная тушонка будет вопить от счастья.

В общем с чем я столкнулся. С тем, что с виду все в ИИ кодинге красиво, но по факту большой проект, например свою LMS ты не соберешь, ИИ сдохнет.

Проблема была не в промптах и не в архитектуре. Просто процесс разработки с ИИ постоянно буксовал: Claude выдавал код с API прошлого года, поиск нужной функции занимал по 15 минут, после третьего рефакторинга я терял нить и бросал проект, начинал терять что было сделано, сколько не суй ему to-do листы.

Потом я нашёл свой стек из MCP-серверов, которые действительно повысили эффективность в разных случаях от 2 до 8 раз, позволили экономить до 80% токенов, не терять контекст и совершать на 8 из 10 ошибок меньше.

Читать далее

50 оттенков вайб-кодинга

Время на прочтение8 мин
Охват и читатели24K

Краткий обзор двух десятков AI-инструментов, которые можно использовать для написания кода (a.k.a вайб-кодинга).

Мои курсы: Разработка LLM с нуля | Алгоритмы Машинного обучения с нуля | Геопространственный анализ данных на Python

Читать далее

Можно ли научить ИИ писать более качественные тексты?

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели9.3K

Эпоха больших языковых моделей (LLM, Large Language Model) снова и снова ставит перед нами вопрос о том, что отличает великую прозу от просто хорошей.

Отвечая на этот вопрос, обычно довольно расплывчато рассуждают о «стиле»: о неуловимом, мистическом качестве, которое свойственно таким людям, как Хемингуэй, Вулф или Вудхаус. Это — как один судья сказал о порнографии: мы узнаём её, когда видим. Мы способны узнать стиль текста, мы даже можем его сымитировать. Но можем ли мы его измерить? Можем ли мы создать для него производственную функцию?

Большинство современных LLM выдаёт хорошие тексты. Даже — грамотные. Но — тексты это стандартные. Стилистически безвкусные. И что — так будет всегда? Этот вопрос меня тревожит с тех самых пор, как я начал пользоваться LLM. Они созданы из слов, и при этом не могут как следует словами пользоваться. Почему мы не способны создать ИИ, который пишет хорошие тексты?

Тут совершенно естественным образом возникает такой вопрос: можем ли мы задать какие-то (или хоть какие-нибудь) количественно измеримые, эмпирические «сигнатуры» хороших текстов? Если это возможно — значит такие вот «характеристики» можно использовать для обучения моделей, которые смогут лучше писать. Так случилось, что этот вопрос завёл меня, так сказать, в кроличью нору, породив проект, который я называю Horace.

Я выдвинул гипотезу, в соответствии с которой, приближённо говоря, волшебство текстов, написанных людьми, уместно сравнивать не с понятием «статистическое среднее», а с понятием «дисперсия». Полагаю, эту мысль нельзя назвать строгим правилом, но она, как мне кажется, ближе к истине, чем альтернативные идеи. Магия человеческих текстов заключается в осознанном, целенаправленном отступлении от ожидаемого. Речь идёт о ритме (rhythm), о темпе (pace), о музыкальности (cadence) текста.

Читать далее

Мы запретили программистам писать код и ускорили релизы в 2 раза. Как к этому пришли

Уровень сложностиСредний
Время на прочтение9 мин
Охват и читатели43K

Мы ускорили релизный цикл в 2 раза за счёт жёсткого shift‑left: запретили писать и коммитить код без ранней проверки требований и автогенерации тестов ИИ. Рассказываем, как у нас это получилось и насколько выгоден такой подход компании.

Читайте, как этого добились

Как думают ИИ-модели: раскладываем рассуждения на эпизоды

Время на прочтение3 мин
Охват и читатели10K

Последние поколения LLM умеют долго рассуждать. И вот недавно исследователи решили взглянуть на этот процесс иначе — как на развернутую историю, где каждая мысль занимает свое место в последовательности эпизодов. Оказывается, у логики моделей есть неожиданные параллели с тем, как задачи решают люди: сначала читают, потом анализируют, строят план, пробуют варианты, а иногда теряются и возвращаются на пару шагов назад. Какой путь проходит ИИ, пока ищет ответ, и насколько этот путь похож на человеческий? Новая работа с аккуратной разметкой и яркими визуализациями открывает этот скрытый внутренний театр рассуждений.

Читать далее

Запуск MacOS 13+ в VMware на процессорах AMD (OpenCore)

Время на прочтение7 мин
Охват и читатели26K

Всем привет. Делюсь своими изысканиями по запуску виртуальных машин MacOS на процессорах AMD. Возможно кому-то будет полезным.

Предыстория: в наличии несколько виртуалок, с которыми долгое время не было никаких проблем. Версии - от Mojave до Monterey, они даже обновлялись штатно. Далее, при апдейте на Ventura/Sonoma ловим кернел панику - никакие рекомендации из интернета не помогли. Глаз пал в сторону хакинтоша, но как его конфигурировать под вмварь тоже оказалось не совсем понятным, поэтому и напишу этот гайд:
вводные - Ryzen 5950X, Windows 10, VMware Workstation 16.2 (была версия 16.0, пока не столкнулись в проблемой апдейта макоси).

Читать далее

Пассивный доход от контентных сайтов: использование ИИ для бесконечного потока статей под рекламу

Уровень сложностиПростой
Время на прочтение9 мин
Охват и читатели34K

Я давно работаю SEO-специалистом и видел, как многие люди превращают простые идеи в реальный пассивный доход через контентные сайты. В этой статье я собрал весь свой опыт за многие годы - от анализа ниш и настройки сайтов до генерации тысяч статей с помощью ИИ за копейки. Здесь всё по делу: как выбрать тему с высоким CPM, оптимизировать под Яндекс, монетизировать через РСЯ и партнёрки (например, Tutu.ru), и масштабировать до сети сайтов. Плюс чек-лист с шагами, чтобы вы стартовали без ошибок и увидели первые деньги через 3-6 месяцев. Это не теория, а рабочий план, который помог десяткам моих клиентов - теперь он ваш, чтобы построить доход, который работает сам по себе.

Читать далее

Python в Enterprise-разработке: почему популярность ЯП распространилась и на корпоративный сектор. Часть 1

Время на прочтение12 мин
Охват и читатели13K

Привет! Это Леша Жиряков, я руководить бэкенд-команды витрины KION и Python-гильдии в МТС. Как раз о Python сегодня и пойдет речь. Обсудим, почему самый популярный ЯП, по версии TIOBE, так востребован в корпоративном секторе: из простого инструмента автоматизации он превратился в полноценную экосистему для создания критически важных продуктов.

Если коротко, причина успеха — в эволюции языка и его экосистемы. Аннотации типов в Python 3.5 сделали доступной статическую проверку кода без потери гибкости динамической типизации. Это решающий фактор для корпоративной разработки, ведь главные требования тут — это надежность и поддерживаемость.

Недавно я уже писал о причинах успеха Python в целом, а сегодня хочу подробно рассмотреть его современные инструменты для предприятий: типизированные структуры данных с dataclasses, высокопроизводительные системы валидации msgspec, pydantic 2 и другие библиотеки. То есть все, что помогло ему стать идеальным выбором для серьезных бизнес-решений. Информации много, так что тему разобью на две части. Погнали!

Читать далее

Как российские разработчики заставили GPT предсказывать биржевые котировки

Уровень сложностиСложный
Время на прочтение9 мин
Охват и читатели26K

18 мая 2024 на конференции «Тюльпаномания» Тихон Павлов, количественный аналитик «Финансовой компании Викинг» раскрыл секрет использования GPT-4 для прогнозирования биржевых котировок. Тема разделила аудиторию на скептиков и энтузиастов, породив жаркие дебаты о будущем трейдинга. Никто не остался равнодушным.

В статье расскажем про эксперимент, как нам удалось заставить языковую модель принимать числовые данные и предсказывать биржевые котировки.

Мы в Викинге занимаемся разработкой ПО для алгоритмической торговли на российских и зарубежных биржах. Более 20 лет помогаем трейдерам, брокерам и инвестиционным компаниям зарабатывать на финансовых рынках при помощи арбитража.

Прежде чем начнем погружаться в алхимию XXI века (где вместо превращения свинца в золото, мы превращаем массивы данных в профит), мы хотим пригласить вас на следующую конференцию ФК Викинг «Профессиональные инвестиции 2024: Визионерство», которая пройдет 14 декабря 2024 в Москве. На ней Тихон и другие спикеры продолжат удивлять вас актуальными докладами. Регистрация на мероприятие по ссылке fkviking.com/profinvest24.  

Давайте вернемся к теме ИИ.

Читать далее

Тиннитус (шум в ушах) для айтишников, геймеров, и не только

Время на прочтение16 мин
Охват и читатели91K

ВНИМАНИЕ! Если у вас нет шума в ушах (тиннитуса) и/или нейросенсорной тугоухости, но есть особенности психики в части психосоматики или подобного – покиньте данный пост не читая.

Самые важные победы в мире – победы над собой

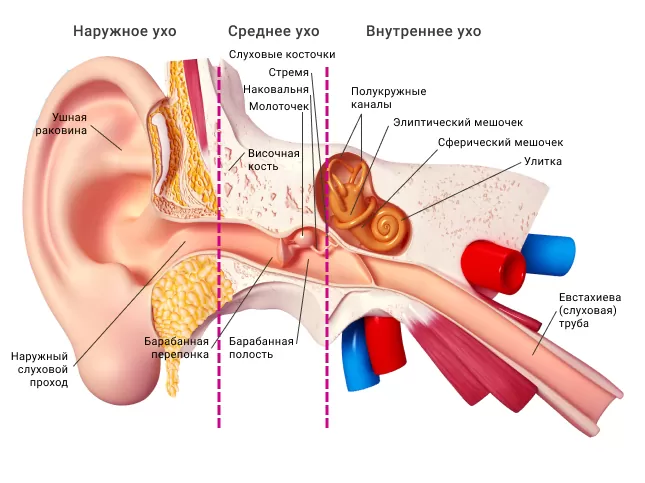
Всем привет. Меня зовут Паша Герасимов, мне 38, я – инженер в ИТ, геймер, и у меня диагноз НСТ (нейросенсорная тугоухость), а также субъективный шум в ухе (тиннитус) и гидропс правого лабиринта. По ощущениям, это комбо – шум/гул/свист в ухе, снижение слуха, чувство заложенности за перепонкой, и гиперакузия (повышенная чувствительность к некоторым звукам). Для тех, кто не в теме – представьте, что у вас ухо заложено ваткой, а внутри уха – звук неработающего канала ТВ (как видео пример, или mp3). И так – регулярно, месяцами, без возможности исправления.  

До 37 лет я практически не болел и не ходил по поликлиникам, это повлияло на всю историю с тиннитусом, поэтому для многих очевидные вещи, я понял на своей шкуре. 

Читать далее

Что делает ChatGPT… и почему это работает?

Уровень сложностиСредний
Время на прочтение75 мин
Охват и читатели190K

То, что ChatGPT может автоматически генерировать что-то, что хотя бы на первый взгляд похоже на написанный человеком текст, удивительно и неожиданно. Но как он это делает? И почему это работает? Цель этой статьи - дать приблизительное описание того, что происходит внутри ChatGPT, а затем исследовать, почему он может так хорошо справляться с созданием более-менее осмысленного текста. С самого начала я должен сказать, что собираюсь сосредоточиться на общей картине происходящего, и хотя я упомяну некоторые инженерные детали, но не буду глубоко в них вникать. (Примеры в статье применимы как к другим современным "большим языковым моделям" (LLM), так и к ChatGPT).
Читать далее

Асинхронные потоки от Стивена Клири

Время на прочтение18 мин
Охват и читатели26K


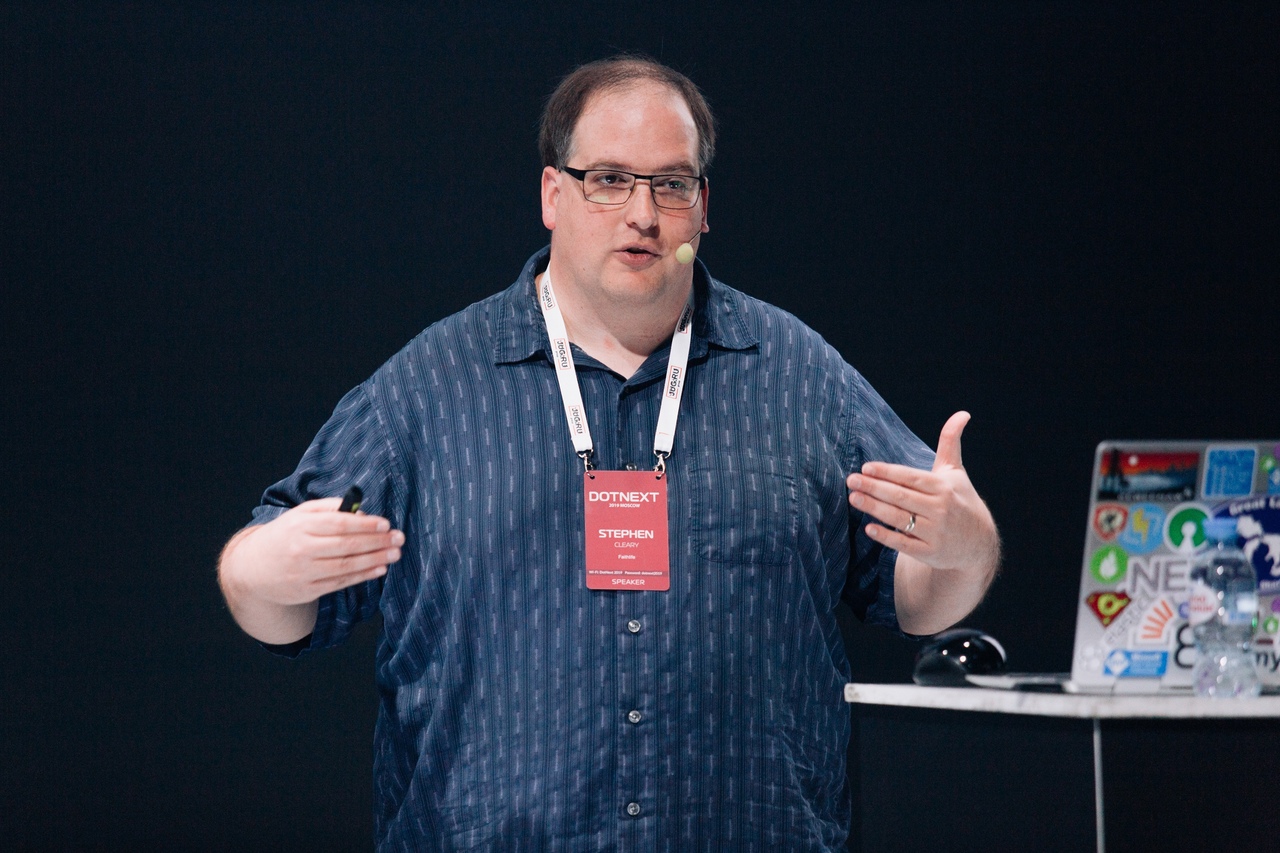
Про Стивена Клири можно сказать «он всерьез занялся многопоточным программированием еще до того, как это стало мейнстримом». Клири стал палочкой-выручалочкой для тысяч разработчиков, терпеливо объясняя на StackOverflow, почему программы не работают и как их исправить.


Еще в 2019-м на нашей конференции DotNext Стивен рассказал об асинхронных потоках: чем они могут быть полезны, чем отличаются от существующих библиотек вроде System.Reactive и RxJS, а также как задействовать их в проектах.


Спустя пару лет этот доклад остается полезным — поэтому теперь, в преддверии нового DotNext, мы решили сделать для Хабра текстовый перевод доклада Стивена. Видео тоже есть под катом. Далее повествование будет от лица спикера.
Читать дальше →

История одного фееричного провала тестового задания на C#

Время на прочтение6 мин
Охват и читатели44K

Просидев на одном предприятии несколько лет, я решил поискать альтернативы. Специально не привожу детали по моей должности, квалификации и стажу, чтобы не создавать предвзятое впечатление и не влиять на объективность оценки выполнения тестового задания. По моему профилю вакансий оказалось довольно много. Откликнулся на первую попавшуюся вакансию очень близко к дому. Перезвонили в течении нескольких часов, обрисовали буквально в двух словах чем занимается контора (обмен данными между системами разных уровней) и предложили сделать тестовое задание. Выполнив задание примерно за сутки, я его отправил и через пару часов получил ответ: «задание Вы выполнили действительно отвратительно, халтурно» и отказ от дальнейших комментариев. По месту своей основной работы я много раз выполнял очень разные задания от очень разных людей, но такого ответа никогда не было даже близко. Что же тут произошло?

Читать далее

Мониторинг WebRTC стримов с помощью Prometheus и Grafana

Время на прочтение18 мин
Охват и читатели7.3K

Системы мониторинга — очень нужная для админа вещь, ведь они позволяют получать от сервисов метрики, которые:

Читать далее

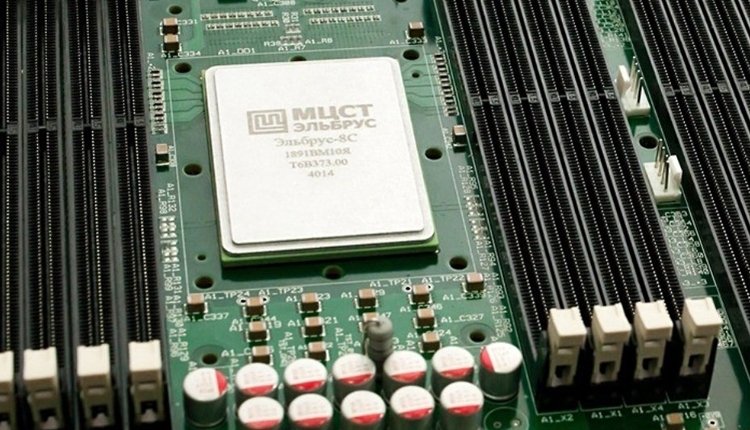
Процессор Эльбрус — почему это тупик для развития отечественной линейки general-purpose CPU

Время на прочтение8 мин
Охват и читатели167K

Последние месяцы ознаменовались бурными баталиями в отечественной индустрии разработки микроэлектроники и причастных. Государство, наконец-то пристально обратив своё око на данную, мягко скажем крайне проблемную отрасль, посулив крупные инвестиции на её развитие, в первую очередь на разработку мозга любой вычислительной техники - процессора. Прения по поводу , как правильно потратить выделенные средства, из тишины министерских кабинетов выплеснулись наружу и дошли до прессы. Не вдаваясь в политические моменты, всегда присущие такого рода дебатам, хотелось бы сконцентрироваться на технической стороне вопроса и обрисовать позицию, почему ставка на легендарный микропроцессор Эльбрус - это тупик для развития отечественного процессоростроени

Читать далее

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность