Обновить
-1

Пользователь

Отправить сообщение

Краткая история Всемирной паутины по версии веб-разработчиков

Время на прочтение1 мин
Охват и читатели25K

Веб станет намного лучше, когда мы сможем использовать изображения.


Веб станет намного лучше, когда мы сможем использовать больше 216 цветов.


Веб станет намного лучше, когда у нас появятся каскадные таблицы стилей.

Читать дальше →

Microsoft выложила на Github инструментарий CNTK для глубинного обучения

Время на прочтение2 мин
Охват и читатели17K


Microsoft выложила в открытый доступ исходный код инструментов, которые используются в компании для ускорения разработок в области искусственного интеллекта: набор Computational Network Toolkit опубликован на Github.
Читать дальше →

Рекурентная нейронная сеть в 10 строчек кода оценила отзывы зрителей нового эпизода “Звездных войн”

Время на прочтение11 мин
Охват и читатели161K
Hello, Habr! Недавно мы получили от “Известий” заказ на проведение исследования общественного мнения по поводу фильма «Звёздные войны: Пробуждение Силы», премьера которого состоялась 17 декабря. Для этого мы решили провести анализ тональности российского сегмента Twitter по нескольким релевантным хэштегам. Результата от нас ждали всего через 3 дня (и это в самом конце года!), поэтому нам нужен был очень быстрый способ. В интернете мы нашли несколько подобных онлайн-сервисов (среди которых sentiment140 и tweet_viz), но оказалось, что они не работают с русским языком и по каким-то причинам анализируют только маленький процент твитов. Нам помог бы сервис AlchemyAPI, но ограничение в 1000 запросов в сутки нас также не устраивало. Тогда мы решили сделать свой анализатор тональности с блэк-джеком и всем остальным, создав простенькую рекурентную нейронную сеть с памятью. Результаты нашего исследования были использованы в статье “Известий”, опубликованной 3 января.


В этой статье я немного расскажу о такого рода сетях и познакомлю с парой классных инструментов для домашних экспериментов, которые позволят строить нейронные сети любой сложности в несколько строк кода даже школьникам. Добро пожаловать под кат.
Читать дальше →

Автоматизированное создание NuGet-пакетов

Время на прочтение15 мин
Охват и читатели34K

Коль захотел ты сборки передать
И с ними пламенный привет
Нугетом не забудь запаковать
В пакет!


Сразу оговоримся, что в этой статье речь пойдёт о стеке технологий Microsoft .NET.

Часто так бывает, что какое-то подмножество проектов начинает использоваться в разных решениях.

Как правило, программисты, разглядев в соседнем проекте что-то полезное, первое время не заморачиваются — создают папку lib (dll, assemblies и т.п.) и складывают туда скомпилированные сборки из оригинального решения. Со временем становится понятно, что это не самый удобный вариант и вот почему:

  • оригинальное решение начинает развиваться в свою собственную сторону, без учёта «потребителей»: добавляются новые зависимости, обновляются версии .net и т.п. «приколы»;
  • если даже о «потребителях» задумываются, то забывают обновить сборки у них, когда выходит критическое обновление или просто новая версия, а потом всё становится ещё хуже, когда сборок становится больше одной и между ними возникают некоторые зависимости — обновляя одну сборку, получаем проблемы в момент исполнения, т.к. другая сборка может оказаться не той версии;
  • оригинальное решение перестаёт дальше разрабатываться.

Ответом на все эти неприятности может служить вынесение проектов в отдельное решение и создание NuGet-пакета, включающего общие сборки, и смена парадигмы развития этих сборок. По большому счёту, всё это можно сделать и без NuGet, но удовольствия в этом гораздо меньше.Как сделать так, чтобы NuGet-пакет собирался сам автоматически вместе с компиляцией проекта на сервере построения и включал все необходимые свистелки и гуделки — об этом и будет наш рассказ.
Читать дальше →

Типы CQRS

Время на прочтение5 мин
Охват и читатели30K
CQRS — довольно хорошо изученный паттерн. Часто можно слышать, что вы либо следуете CQRS, либо нет, имея ввиду что это что-то вроде бинарного выбора. В этой статье я бы хотел показать, что существует спектр вариаций этого понятия, а также как разные типы CQRS могут выглядеть на практике.
Читать дальше →

Что именно заставляет глубинное обучение и нейронные сети работать хорошо?

Время на прочтение6 мин
Охват и читатели35K
Сейчас очень много статей, рапортующих об успехах нейронных сетей, в частности, в интересующей нас области понимания естественного языка. Но для практической работы важно еще и понимание того, при каких условиях эти алгоритмы не работают, или работают плохо. Отрицательные результаты по понятным причинам часто остаются за рамками публикаций. Часто пишут так — мы использовали метод А вместе с Б и В, и получили результат. А нужен ли был Б и В остается под вопросом. Для разработчика, внедряющего известные методы в практику эти вопросы очень даже важны, поэтому сегодня поговорим об отрицательных результатах и их значении на примерах. Примеры возьмем, как известные, так и из своей практики.
Читать дальше →

C# — Моделирование «разумной» жизни на базе нейронных сетей

Время на прочтение4 мин
Охват и читатели85K
Данная статья посвящена исследованию возможностей нейронных сетей при их использовании в качестве основы для индивидуального разума моделируемого объекта.

Цель: показать, способна ли нейронная сеть (или ее данная реализация) воспринимать «окружающий» мир, самостоятельно обучаться и на основе собственного опыта принимать решения, которые можно считать относительно разумными.

image
Читать дальше →

Deconvolutional Neural Network

Время на прочтение9 мин
Охват и читатели64K
Использование классических нейронных сетей для распознавания изображений затруднено, как правило, большой размерностью вектора входных значений нейронной сети, большим количеством нейронов в промежуточных слоях и, как следствие, большими затратами вычислительных ресурсов на обучение и вычисление сети. Сверточным нейронным сетям в меньшей степени присущи описанные выше недостатки.

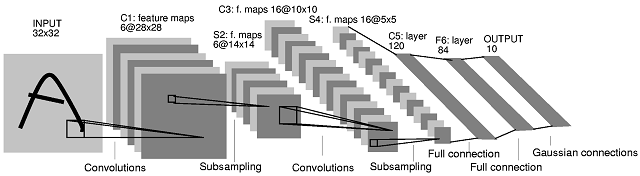
Свёрточная нейронная сеть (англ. convolutional neural network, CNN) — специальная архитектура искусственных нейронных сетей, предложенная Яном Лекуном и нацеленная на эффективное распознавание изображений, входит в состав технологий глубокого обучения (англ. deep leaning). Эта технология построена по аналогии с принципами работы зрительной коры головного мозга, в которой были открыты так называемые простые клетки, реагирующие на прямые линии под разными углами, и сложные клетки, реакция которых связана с активацией определённого набора простых клеток. Таким образом, идея сверточных нейронных сетей заключается в чередовании сверточных слоев (англ. convolution layers) и субдискретизирующих слоев (англ. subsampling layers, слоёв подвыборки).[6]
image
Рис 1. Архитектура сверточной нейронной сети

Ключевым моментом в понимании сверточных нейронных сетей является понятие так называемых «разделяемых» весов, т.е. часть нейронов некоторого рассматриваемого слоя нейронной сети может использовать одни и те же весовые коэффициенты. Нейроны, использующие одни и те же веса, объединяются в карты признаков (feature maps), а каждый нейрон карты признаков связан с частью нейронов предыдущего слоя. При вычислении сети получается, что каждый нейрон выполняет свертку (операцию конволюции) некоторой области предыдущего слоя (определяемой множеством нейронов, связанных с данным нейроном). Слои нейронной сети, построенные описанным образом, называются сверточными слоями. Помимо, сверточных слоев в сверточной нейронной сети могут быть слои субдискретизации (выполняющие функции уменьшения размерности пространства карт признаков) и полносвязные слои (выходной слой, как правило, всегда полносвязный). Все три вида слоев могут чередоваться в произвольном порядке, что позволяет составлять карты признаков из карт признаков, а это на практике означает способность распознавания сложных иерархий признаков [3].

Что же именно влияет на качество распознавания образов при обучении сверточных нейронных сетей? Озадачившись данным вопросом, наткнулись на статью Мэттью Зайлера (Matthew Zeiler).
Читать дальше →

Нейропластичность в искусственных нейронных сетях

Время на прочтение17 мин
Охват и читатели54K
Привет, Хабр, давно не виделись. В этом посте мне хотелось бы рассказать о таком относительно новом понятии в машинном обучении, как transfer learning. Так как я не нашел какого-либо устоявшегося перевода этого термина, то и в названии поста фигурирует хоть и другой, но близкий по смыслу термин, который как бы является биологической предпосылкой к формализации теории передачи знаний от одной модели к другой. Итак, план такой: для начала рассмотрим биологические предпосылки; после коснемся отличия transfer learning от очень похожей идеи предобучения глубокой нейронной сети; а в конце обсудим реальную задачу семантического хеширования изображений. Для этого мы не будем скромничать и возьмем глубокую (19 слоев) сверточную нейросеть победителей конкурса imagenet 2014 года в разделе «локализация и классификация» (Visual Geometry Group, University of Oxford), сделаем ей небольшую трепанацию, извлечем часть слоев и используем их в своих целях. Поехали.
Читать дальше →

Верстка email рассылок от А до Я для чайников

Время на прочтение9 мин
Охват и читатели427K
Уже 3 с лишним года занимаюсь дизайном и версткой почтовых рассылок, которые ориентированы на англоязычных пользователей. За время работы перелопатили огромную кучу информации, перепробовали много вариантов верстки, набили достаточное количество шишек. Были найдены и исправлены типичные баги, которые в той или иной мере повторялись во всех почтовых клиентах. Также нашлись проблемы с некоторыми CSS свойствами — различные почтовые клиенты интерпретировали их по разному. Каждое письмо тестировалось на самых популярных почтовых клиентах: Gmail, Outlook, Yahoo, Android, iOS, MozillaThunderbird, Microsoft Outlook, The Bat. Рассылки ходят на сотни миллионов пользователей и приносят очень хорошие результаты. Итак, приступим к изучению.
Читать дальше →

MongoDB от теории к практике. Руководство по установке кластера mongoDB

Время на прочтение9 мин
Охват и читатели94K
     Доброго времени суток, уважаемые читатели. В этом посте я хотел бы описать несколько примеров развертки mongoDB, отличия между ними, принципы их работы. Однако больше всего хотелось бы поделиться с вами практическом опытом шардирования mongoDB. Если бы этот пост имел план, он бы выглядел скорее всего так:

  1. Вступление. Кратко о масштабировании
  2. Некоторые примеры развертки mongoDB и их описание
  3. Шардинг mongoDB

    Пункты 1 и 2 — теоретические, а номер 3 претендует на практическое руководство по поднятию кластера mongoDB и больше всего подойдет тем, кто столкнулся с этим в первый раз.
Читать дальше →

Пишем быстрый и экономный код на JavaScript

Время на прочтение16 мин
Охват и читатели69K
Такой движок JS, как V8 (Chrome, Node) от Google, заточен для быстрого исполнения больших приложений. Если вы во время разработки заботитесь об эффективном использовании памяти и быстродействии, вам необходимо знать кое-что о процессах, проходящих в движке JS браузера.

Что бы там ни было — V8, SpiderMonkey (Firefox), Carakan (Opera), Chakra (IE) или что-то ещё, знание внутренних процессов поможет вам оптимизировать работу ваших приложений. Но не призываю вас оптимизировать движок для одного браузера или движка – не делайте так.

Задайте себе вопрос:
— можно ли что-то в моём коде сделать более эффективным?
— какую оптимизацию проводят популярные движки JS?
— что движок не может компенсировать, и может ли сборка мусора подчистить всё так, как я от неё ожидаю?


Есть много ловушек, связанных с эффективным использованием памяти и быстродействием, и в статье мы изучим некоторые подходы, которые хорошо показали себя в тестах.
Читать дальше →

И ещё раз про распознавание номеров

Время на прочтение6 мин
Охват и читатели48K
Весной администрация хабра любезно предоставила нам блог, чтобы мы рассказали о нашем экзерсисе с распознаванием номеров. Всё поддержание этой системы делалось просто из интереса и на энтузиазме, зато позволило пообщаться с интересными людьми, некоторым людям помочь, а самим найти подработку по совершенно другим тематикам.


В любых задачах обработки изображений 90% успеха — хорошая база данных. Репрезентативная и большая. Весной мы обещали выложить полную базу изображений того, что нам придёт. Подписка блога заканчивается, поэтому время выполнить обещание (блог может продлят, а может и нет). Наш сервер работал 95% времени, начиная с первого поста. Всё что пришло теперь доступно + мы сделали отдельные базы по вырезанным номерам и нарезанным символам.

Под катом ссылки на базу + её анализ + немного кода + небольшой рассказ о том, что будет сделано дальше с нашим сервером/жизнью проекта.
Читать дальше →

Интерактивное голосовое редактирование текста с помощью новых речевых технологий от Яндекса

Время на прочтение11 мин
Охват и читатели98K
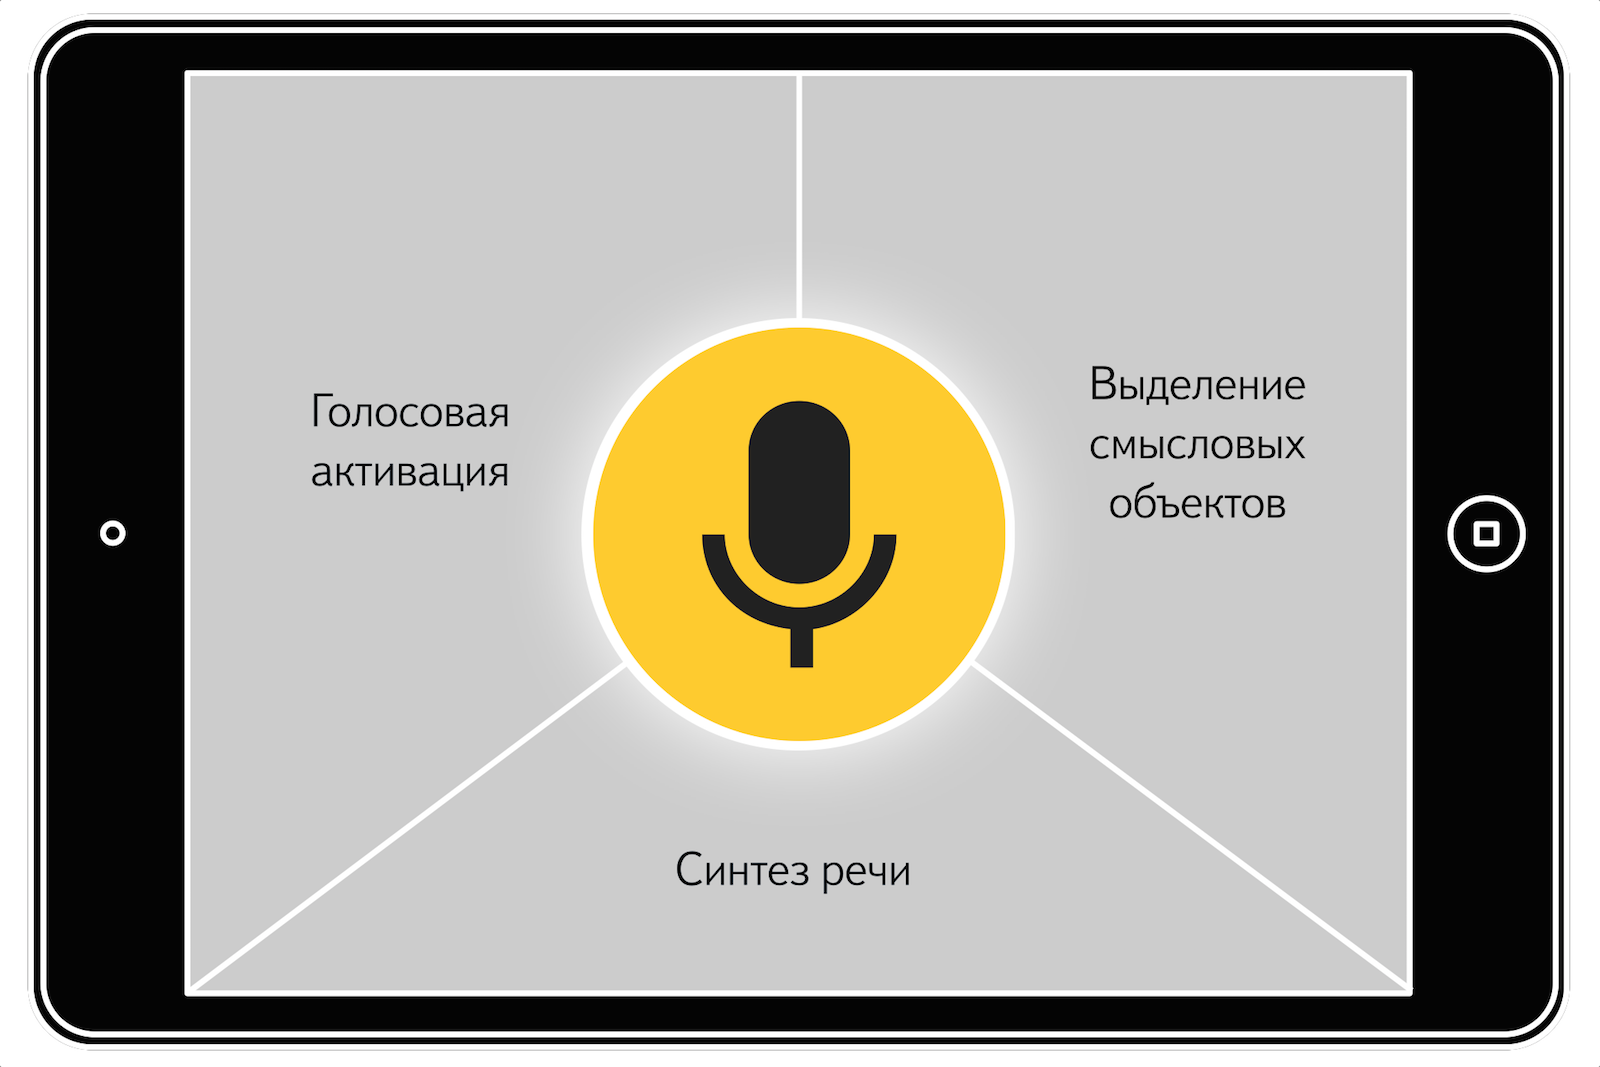
Сегодня наше приложение Диктовка для интерактивного написания и редактирования текста голосом появилось в AppStore и Google Play. Его главная задача — продемонстрировать часть новых возможностей комплекса речевых технологий Яндекса. Именно о том, чем интересны и уникальны наши технологии распознавания и синтеза речи, я хочу рассказать в этом посте.


Пара слов, чтобы вы понимали, о чём пойдёт речь. Яндекс уже давно предоставляет бесплатное мобильное API, которое можно использовать, например, для распознавания адресов и голосовых запросов к поиску. За этот год мы смогли довести его качество почти до того же уровня, на котором такие запросы и реплики понимают сами люди. И теперь мы делаем следующий шаг — модель для распознавания свободной речи на любую тему.

Кроме этого, наш синтез речи поддерживает эмоции в голосе. И, насколько нам известно, это пока первый коммерчески доступный синтез речи с такой возможностью.

Обо всём этом, а также о некоторых других возможностях SpeechKit: об активации голосом, автоматической расстановке пунктуационных знаков и распознавании смысловых объектов в тексте — читайте ниже.
Читать дальше →

Теория памяти человека, зачатки ИИ

Время на прочтение3 мин
Охват и читатели39K

Теория памяти человека, зачатки ИИ


Наверняка всем Вам очень хорошо известны такие моменты, когда нужно что-то вспомнить, но извлечь информацию из мозга становится большим пазлом.

Почему же такое происходит. Для начала немного теории работы нейрона, можно почитать тут или тут

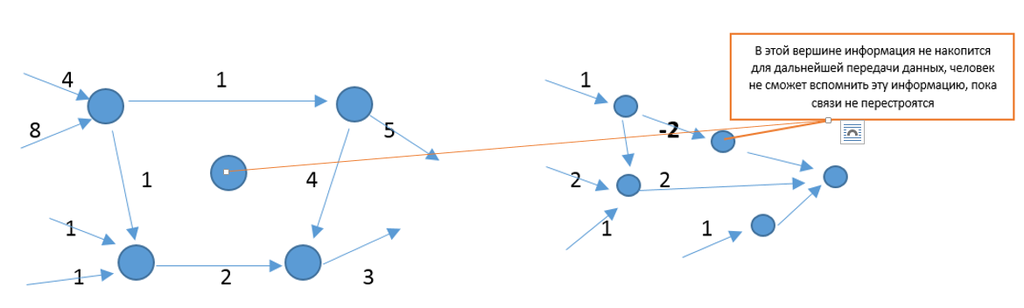
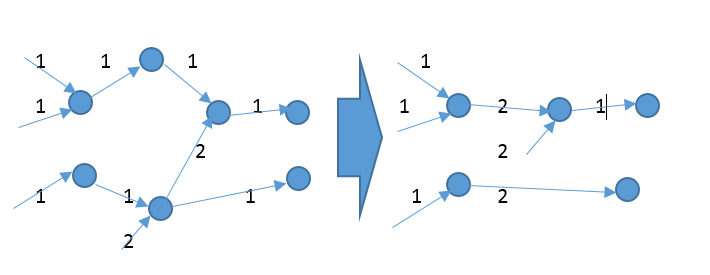
Предположим, а может так оно и есть, все нейроны объединены в одни очень большой граф со сложной структурой. Данная структура сложна и не может работать хаотично, т.е. передаваемые импульсы передаются строго в определённом порядке, поэтому тут есть 2 варианта:

  1. Ребра графа имеют только положительные веса
  2. Ребра графа могут иметь, как положительные так и отрицательные веса

Рассматривая второй случай в реальной работе памяти человека, можно предположить, что такая ситуация возникает при провалах памяти человека, т.е. к нейрону содержащему ту информацию которая нам необходимо либо поступает недостаточно сигналов, для накопления и дальнейшей передачи, либо этих сигналов вообще нет. В случае с графами это можно представить, как узел у которого мало путей, либо они отрицательны, либо их вообще нет (рис 1).
image

Что же касается первого случая, когда все ребра имеют положительные веса, т.е. головной мозг человека не поврежден. Тогда почему же человек не может вспомнить моменты из своего детства? Ответ прост: “Любое тело стремится к покою”, так же и наша с вами нейронная сеть старается оптимизировать свою работу. (Владельцам навигаторов должно быть знакомо, что прокладка маршрута, как раз таки строится на принципах работы графа, нахождения кратчайшего пути и т.д.). Мозг человека более изощренная система и его оптимизация заключается в разрыве связей с малыми весами, и построении новых связей с более высокими. (рис. 2). Таким образом объяснятся многочисленные разрывы и новые соединения нейронов. Чем больше узел имеет связей, тем легче вспомнить необходимую информацию.
image
Читать дальше →

Нейронные сети, «вредные» советы

Время на прочтение6 мин
Охват и читатели170K
Исторически, искусственные нейронные сети за свою уже более чем полувековую историю испытывали как периоды стремительных взлетов и повышенного внимания общества, так и сменявшие их периоды скепсиса и равнодушия. В хорошие времена ученым и инженерам кажется, что наконец-то найдена универсальная технология, способная заменить человека в любых когнитивных задачах. Как грибы после дождя, появляются различные новые модели нейронных сетей, между их авторами, профессиональными учеными-математиками, идут напряженные споры о большей или меньшей степени биологичности предложенных ими моделей. Профессиональные ученые-биологи наблюдают эти дискуссии со стороны, периодически срываясь и восклицая «Да такого же в реальной природе не бывает!» – и без особого эффекта, поскольку нейросетевики-математики слушают биологов, как правило, только тогда, когда факты биологов согласуются с их собственными теориями. Однако, с течением времени, постепенно накапливается пул задач, на которых нейронные сети работают откровенно плохо и энтузиазм людей остывает.
Читать дальше →

4 способa свободного скачивания суточной и пошаговой информации с фондовых бирж США

Время на прочтение2 мин
Охват и читатели47K
В оригинале способов было 6, но часть из них автор перевода не смог заставить работать, и потому упоминать смысла не видит.

Несколько месяцев назад я делал пост о том, где найти ретроспективные данные о рынках США на момент закрытия, и перечислил 10 сайтов, которые предоставляют эту информацию бесплатно. (10 ways to download historical stock quotes data for free).

Пошаговая и суточная информация так же находится в свободном сетевом доступе. Сегодня я расскажу о четырех местах, где вы можете скачать хронологические данные. Некоторые сайты популярны, о некоторых вы вероятно никогда не слышали.

Начнем с наиболее известных
Читать дальше →

Разворачиваем сервис построения маршрутов OSRM

Время на прочтение4 мин
Охват и читатели68K
Совсем недавно, в одном из проектов, нам была поставлена задача — научиться строить маршруты на карте для велосипедных прогулок.

Первым делом, мы начали смотреть маршруты Google и Яндекс. И к сожалению, пришлось от них отказаться, т.к. первые разрешали показывать их только на родных картах, вторые, не знали что есть велосипеды и даже пешеходы.

Немного изучив предметную область, мы нашли наконец что искали: Open Source Routing Machine. Проект, с открытым исходным кодом, который позволяет развернуть у себя на сервере, свой собственный сервис построения маршрутов.


Тайлы: MapBox, Яндекс-Карты
Картографические данные: участники OpenStreetMap

Разобравшись, как его настраивать и запускать, мы решили поделиться этим и пересказать своими словами процесс установки, и то с чем пришлось столкнуться в процессе.
Читать дальше →

Никогда не проверяйте e-mail адреса по стандартам RFC

Время на прочтение7 мин
Охват и читатели195K
Множество сайтов требуют от пользователя ввода адреса электронной почты, и мы, как крутые и щепетильные разработчики, всегда стремимся проверять формат введенных адресов строго по стандартам RFC. Благодаря этому наши приложения и сайты проверяют формат e-mail корректно и не имеют проблем с юзабилити, а мы сладко спим, потому что уверены, что все работает как надо.
Ага, как бы не так!

Тестирование безопасности клиент-серверного API

Время на прочтение6 мин
Охват и читатели42K
2 года назад я выступал на конференции CodeFest с темой «Пентест на стероидах. Автоматизируем процесс» и делал пересказ выступления в качестве статьи. В этом году я с большим удовольствием снова принял участие в конференции и выступил с темой «BlackBox тестирование безопасности клиент-серверного API» и, видимо уже в качестве традиции, также делаю пересказ выступления.


Уязвимости в API встречаются. Правда.

О чем разговор?


Разговор про API, но API бывает разным — API операционной системы, сайта, десктопной программы, да хоть чего. Вкратце — API это обращение к методам чего-либо (например в случае ОС — запись в файл) через определенный метод. И запуск какого-нибудь файла с т.ч. зрения разработки произойдет схожим образом (тоже через API метод ОС), хотя результат выполнения команды совершенно разный. В веб-технологиях многие тоже реализуют API к своим проектам, и если на пальцах: можно отправить сообщение в соц. сети зайдя на сайт, а можно — сформировав специальный HTTP запрос. И при реализации подобного альтернативного использования функционала допускаются (как и везде) ошибки в безопасности. Статья как раз о специфичных ошибках при реализации подобного функционала в веб-проектах.
Читать дальше →

Информация

В рейтинге
Не участвует
Зарегистрирован
Активность