Pull to refresh
13
Олег@iHun

Анализ данных

4
Subscribers
Send message

Как мы собрали LLM-пайплайн, который генерирует продуктовые гипотезы

Reading time7 min
Reach and readers5.2K

Привет! Меня зовут Иван Одинцв, я продакт-менеджер в команде товарных рекомендаций «Магнита». В какой-то момент мы упёрлись в неприятную стену: команда научилась быстро проверять гипотезы — а сами гипотезы при этом закончились. Все сильные идеи уже были в проде, а в бэклоге оседал «осадок», до которого руки не доходили неслучайно.

Читать далее

5 шагов адаптации тимлида в новой компании

Reading time11 min
Reach and readers2.8K

Быть тимлидом — это как управлять оркестром, где каждый инструмент должен звучать в нужный момент. Но что делать, когда ты становишься дирижёром в новом оркестре, где не всегда понятно, кто за что отвечает, и ты даже не знаком с музыкантами? В таких ситуациях, важность адаптации сложно переоценить.

Меня зовут Денис Кузнецов, я тимлид команды биллинга в продуктовой вертикали «Монетизация» в Циан. В этой статье я поделюсь, как успешно пройти адаптацию в роли тимлида, и покажу на примерах из своего опыта, как справиться с этой задачей.

Читать далее

Кто же такая это ваша LoRA

Level of difficultyMedium
Reading time5 min
Reach and readers119K

В сети в последнее время регулярно мелькают статьи типа - как обучить Stable Diffusion генерировать ваши фотографии/фотографии в определенном стиле/фотографии определенного лора/такие фотографии итп.

Однако к сожалению, даже на хабре, об этой технологии рассказывают супер-поверхностно - как скачать какую-то GUI программу, и куда тыкать кнопочки. Поэтому я решил исправить это недоразумение, и выпустить первую статьи на русском, где полностью рассказывается что по настоящему стоит за этими 4-мя буквами.

Читать далее

Алгоритм, сделавший ChatGPT таким «человечным» — Reinforcement Learning from Human Feedback

Reading time8 min
Reach and readers23K

ChatGPT генерирует разнообразный и привлекательный для человека текст. Но что делает текст «хорошим»? Это субъективно и зависит от контекста. Например, если вы попросите сочинить историю, нужен творческий подход. Если вы запрашиваете информацию, то хотите, чтобы она была правдивой. А если вы просите написать код, то ожидаете, что он будет исполняемым.

Вы наверняка слышали о том, что OpenAI привлекали сотрудников из Африки для помощи в разметке токсичности их ассистента. Менее известен факт найма реальных разработчиков, чтобы подготовить данные с пояснениями к коду на человечском языке.

Именно данные с фидбеком от людей позволили дообучить их языковую модель и сделать продукт таким «человечным».

Разберем алгоритм, который позволяет согласовать модель машинного обучения со сложными человеческими ценностями.

Читать далее

На пальцах: ассоциированные типы в Rust и в чём их отличие от аргументов типов

Reading time5 min
Reach and readers11K

Для чего в Rust есть ассоциированные типы (associated types), и в чём их отличие от аргументов типов (type arguments aka generics), ведь они так похожи? Разве недостаточно только последних, как во всех нормальных языках? У тех, кто только начинает изучать Rust, а особенно у людей, пришедших из других языков ("Это же дженерики!" — скажет умудрённый годами джавист), такой вопрос возникает регулярно. Давайте разбираться.


TL;DR Первые контролирует вызываемый код, вторые — вызывающий.

Научите меня плохому!

Краткосрочные и долгосрочные персональные рекомендации

Reading time4 min
Reach and readers1.9K

Автор: Роман Зыков, эксперт в области баз данных, независимый AI-консультант LENNUF.ru

Когда мы говорим про персональные рекомендации, мы часто забываем, что они бывают разного типа. В данной статье я рассмотрю основные отличия долгосрочных (long term) и краткосрочных (short term) рекомендаций.

Персональные рекомендации означают, что мы рекомендуем что-то пользователю с учетом его личных интересов учитывая его сигналы. Сами сигналы бывают двух видов - явные (explicit), когда пользователь говорит, что ему нравится (лайк, оценка к песне, отзыв на товар); и неявные (implicit), когда пользователь совершает какие-то действия (посмотрел товар, послушал песню, что-то поискал), по которым мы не можем однозначно оценить нравится/не нравится что-то пользователю. В первых версиях рекомендательных систем было принято пользоваться только явными данными, это видно и по литературе, и по научным статьям того времени. Неявных данных обычно значительно больше - вспомните, сколько товаров вы посмотрели (неявные сигналы) перед покупкой, а потом по скольким товарам вы оставили отзывы (явные сигналы)? Поэтому в последнее десятилетие пошел сдвиг в сторону неявных рекомендаций. Даже представители Netflix 5 лет назад на конференции RecSys объявили о важности таких данных. Как это мы можем заметить? Например, рекомендации на youtube постоянно подстраиваются по те ролики, которые вы смотрели, и под те ролики, которые вы оценили лайками. То же самое делают рекомендательные системы в стриминговых музыкальных сервисов, социальных сетей и интернет-магазинов.

Читать далее

Алгоритм Дейкстры. Разбор Задач

Reading time7 min
Reach and readers100K


Поиск оптимального пути в графе. Такая задача встречается довольно часто и в повседневной жизни, и в мире технологий. Справиться с такими вызовами помогает подход, который должен быть в арсенале каждого программиста — алгоритм Дейкстры.

Если вы хотите найти ответить на вопросы, чем этот алгоритм лучше BFS (поиска в ширину), при каких условиях алгоритм применим, и какие теоретические и практические задачи можно с его помощью решать, читайте далее.

Читать дальше →

Мониторинг веб-приложения на Rust с использованием Prometheus и Grafana

Reading time13 min
Reach and readers16K

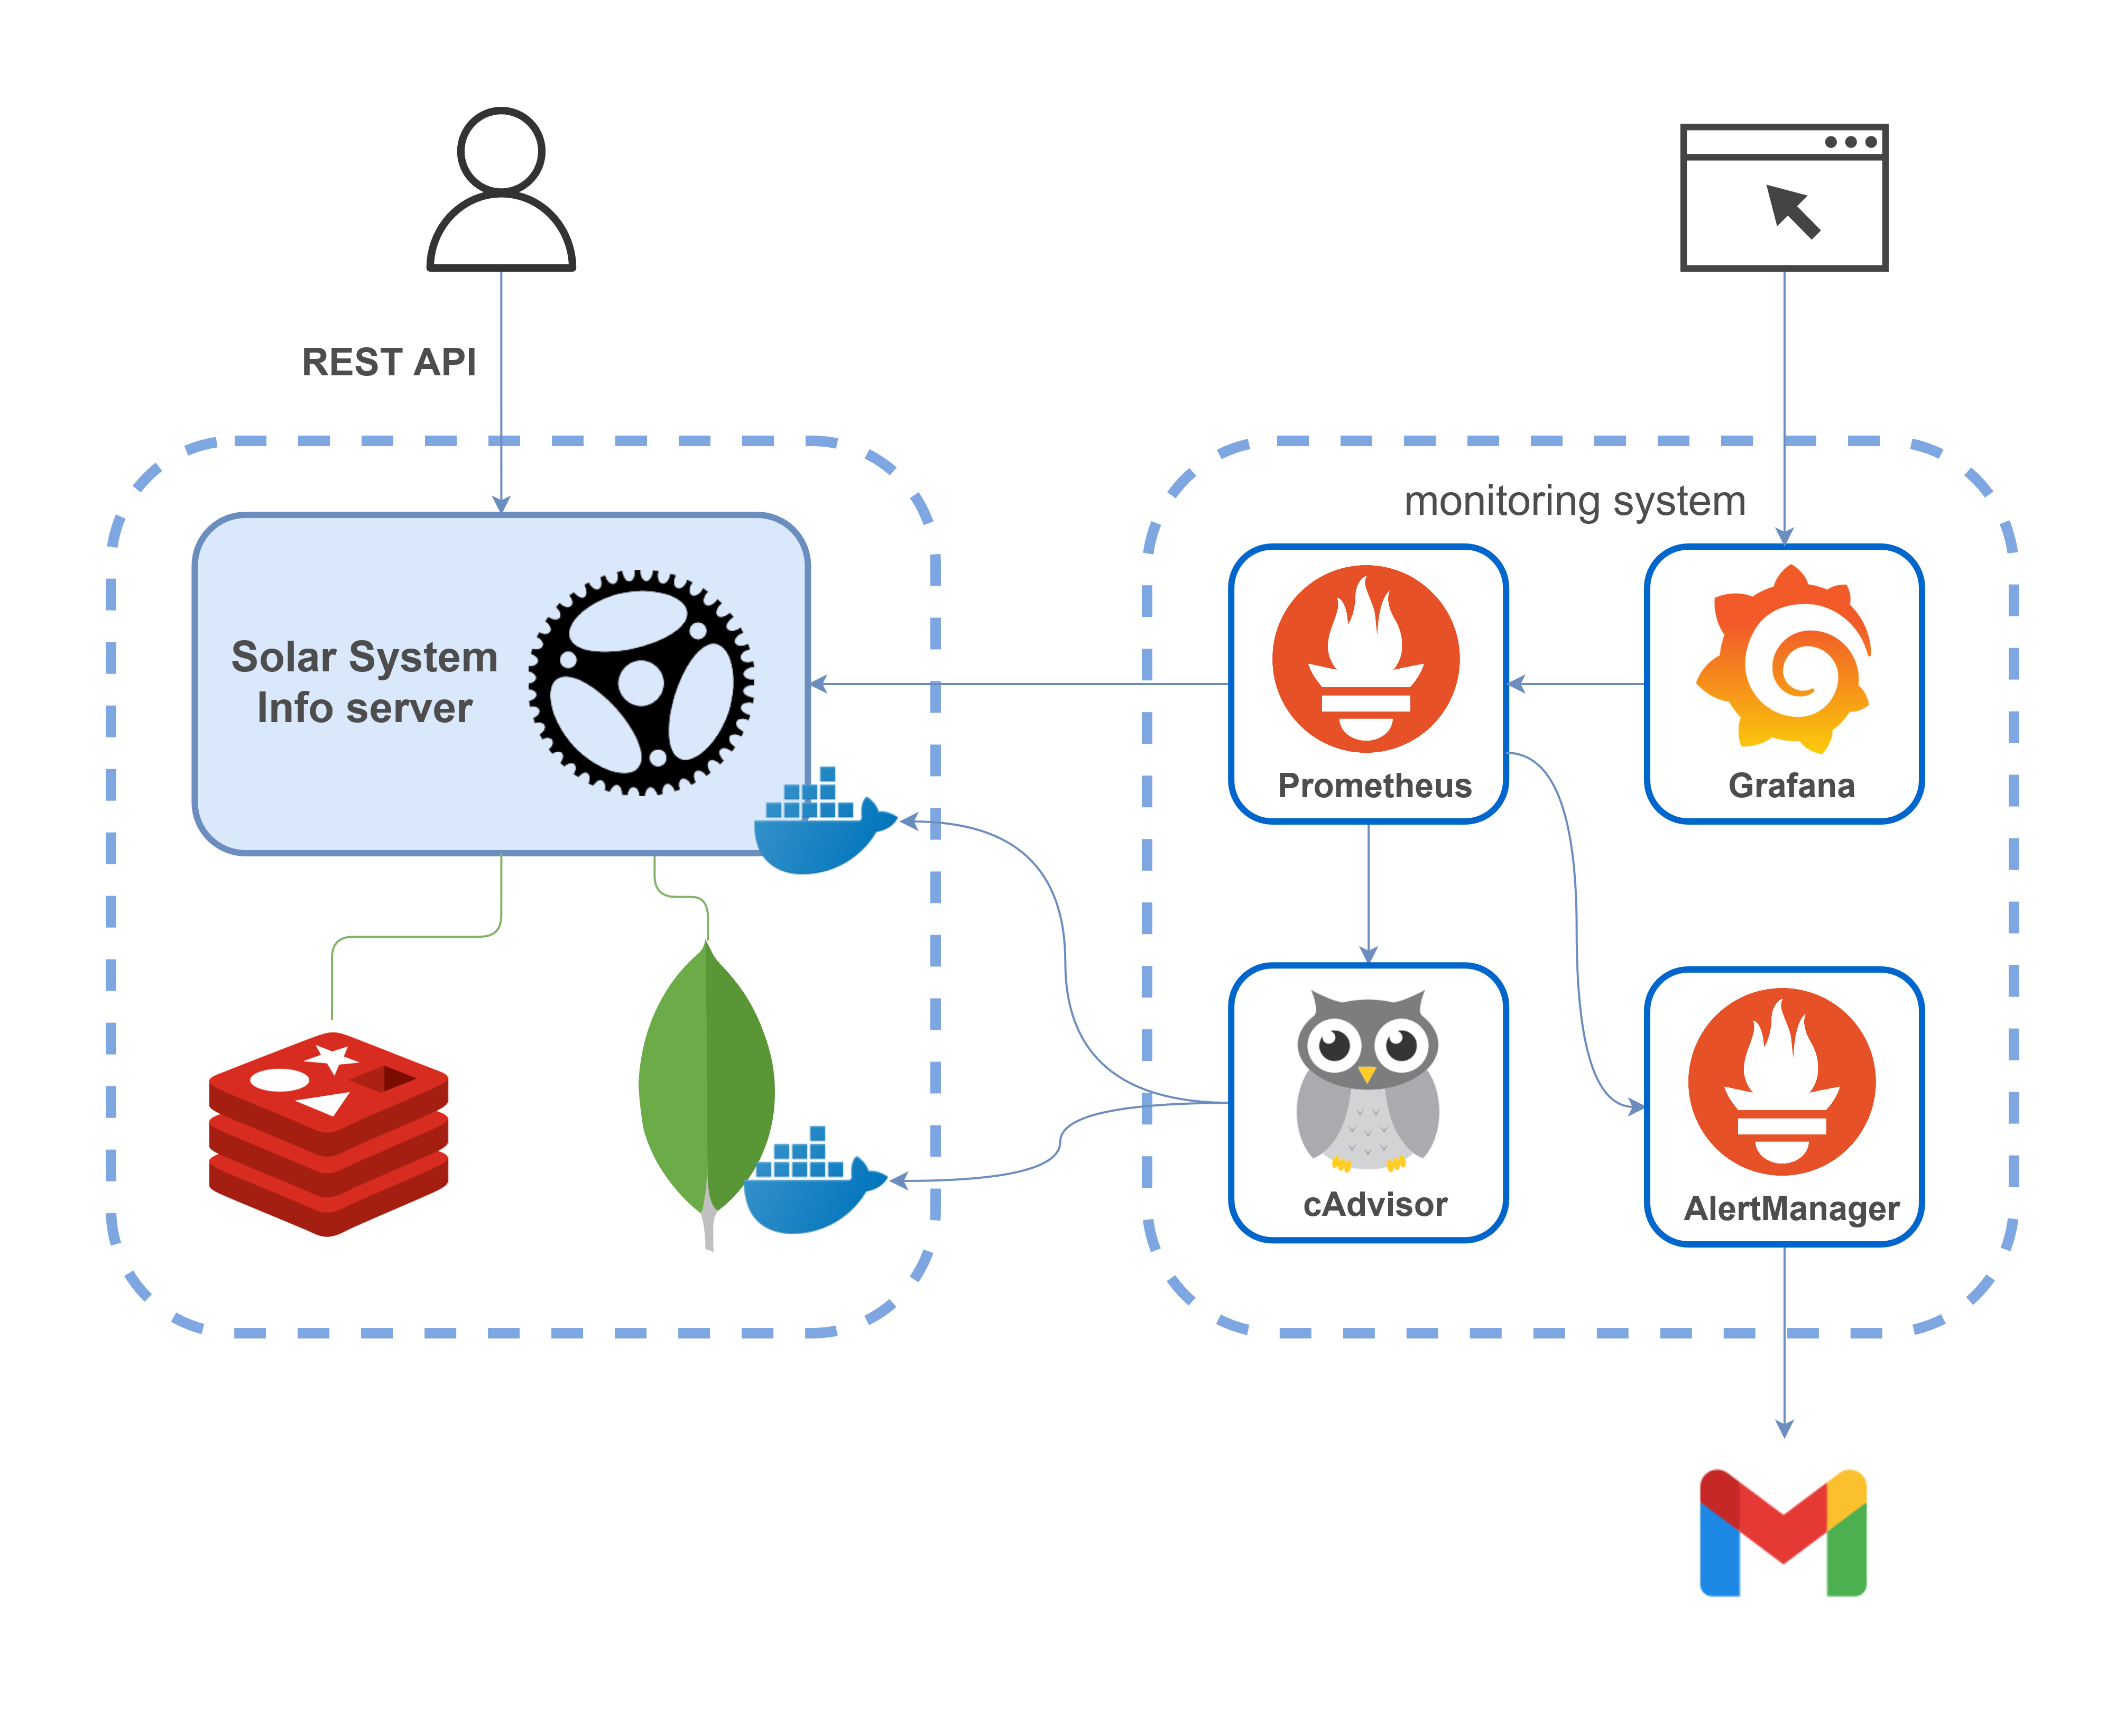
В статье показано как настроить мониторинг веб-приложения на Rust. Приложение выставляет наружу Prometheus метрики, которые визуализируются с помощью Grafana. Мониторинг осуществляется для проекта mongodb-redis demo, детально рассмотренного здесь. В итоге получена следующая архитектура:


architecture

Читать дальше →

Стратификация. Как разбиение выборки повышает чувствительность A/B теста

Reading time15 min
Reach and readers72K

Всем привет! На связи команда ad-hoc аналитики X5 Tech.

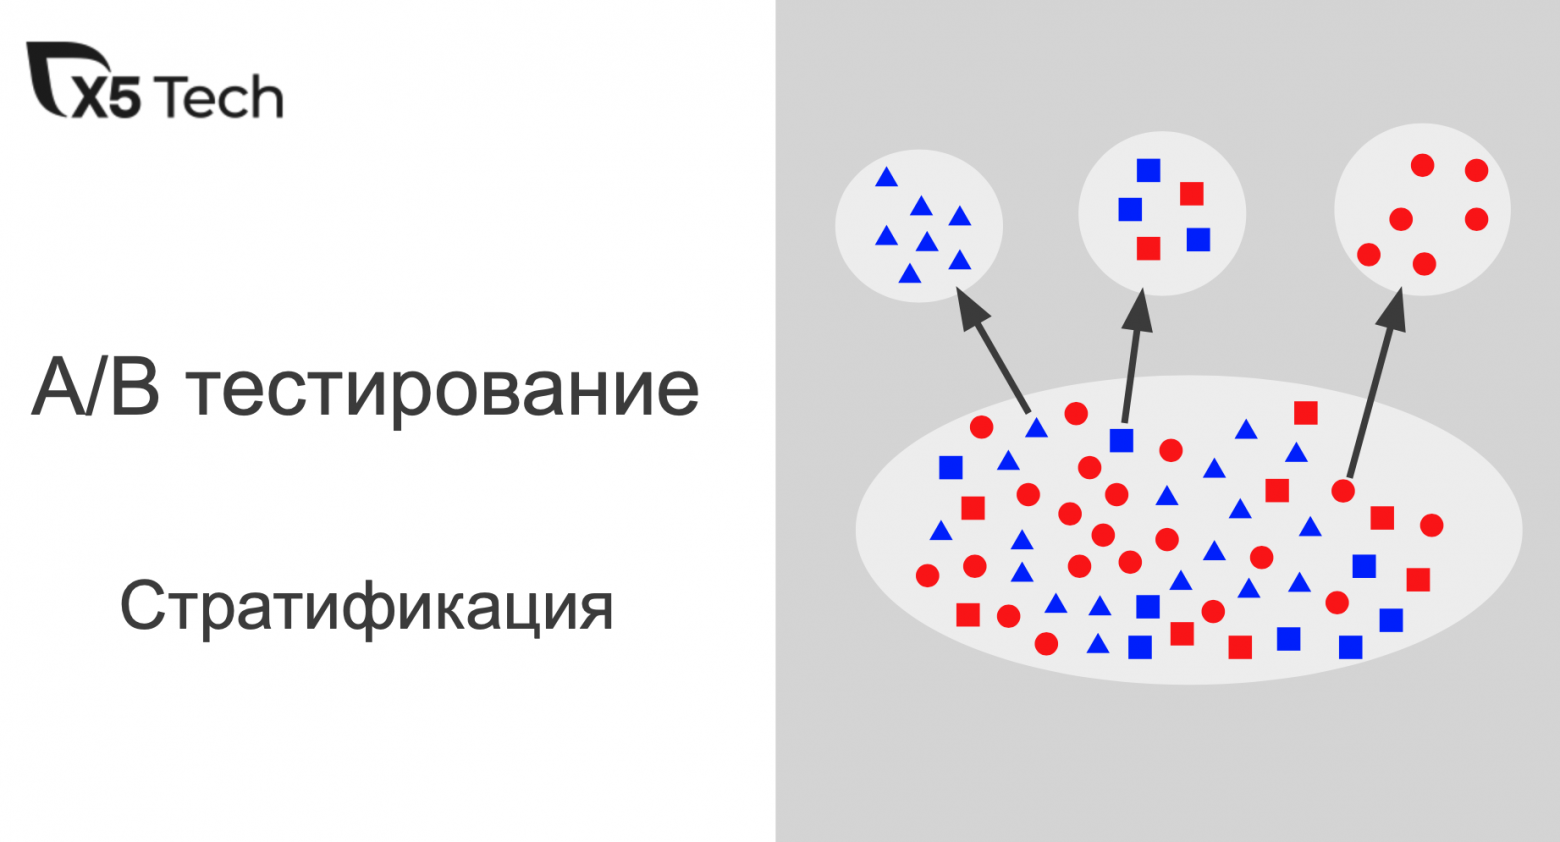
Сегодня подробно обсудим применение стратификации для повышения чувствительности оценки AB экспериментов.

Читать далее

Эксперименты в Ситимобил. Эпизод 2: Атака тестов на Switchback

Reading time10 min
Reach and readers8.3K

Всем привет! На линию выходит команда динамического ценообразования Маркетплейса СитиМобил.

В прошлый раз мы начали вести длинный рассказ о том, как правильно проводить эксперименты в многосторонних маркетплейсах. Мы рассуждали о смысле происходящего; о предпосылках, почему вообще стоит задуматься над этой темой, и почему эксперименты не классическими рандомизированными подходами едины.

Сегодня мы расскажем о практических шагах и ответим на главные, волнующие всех экспериментаторов вопросы: какими статистическими методами можно проверить switchback-тест и как выбрать подходящий.

Читать далее

Начало работы с MongoDB и Redis на Rust

Reading time13 min
Reach and readers14K

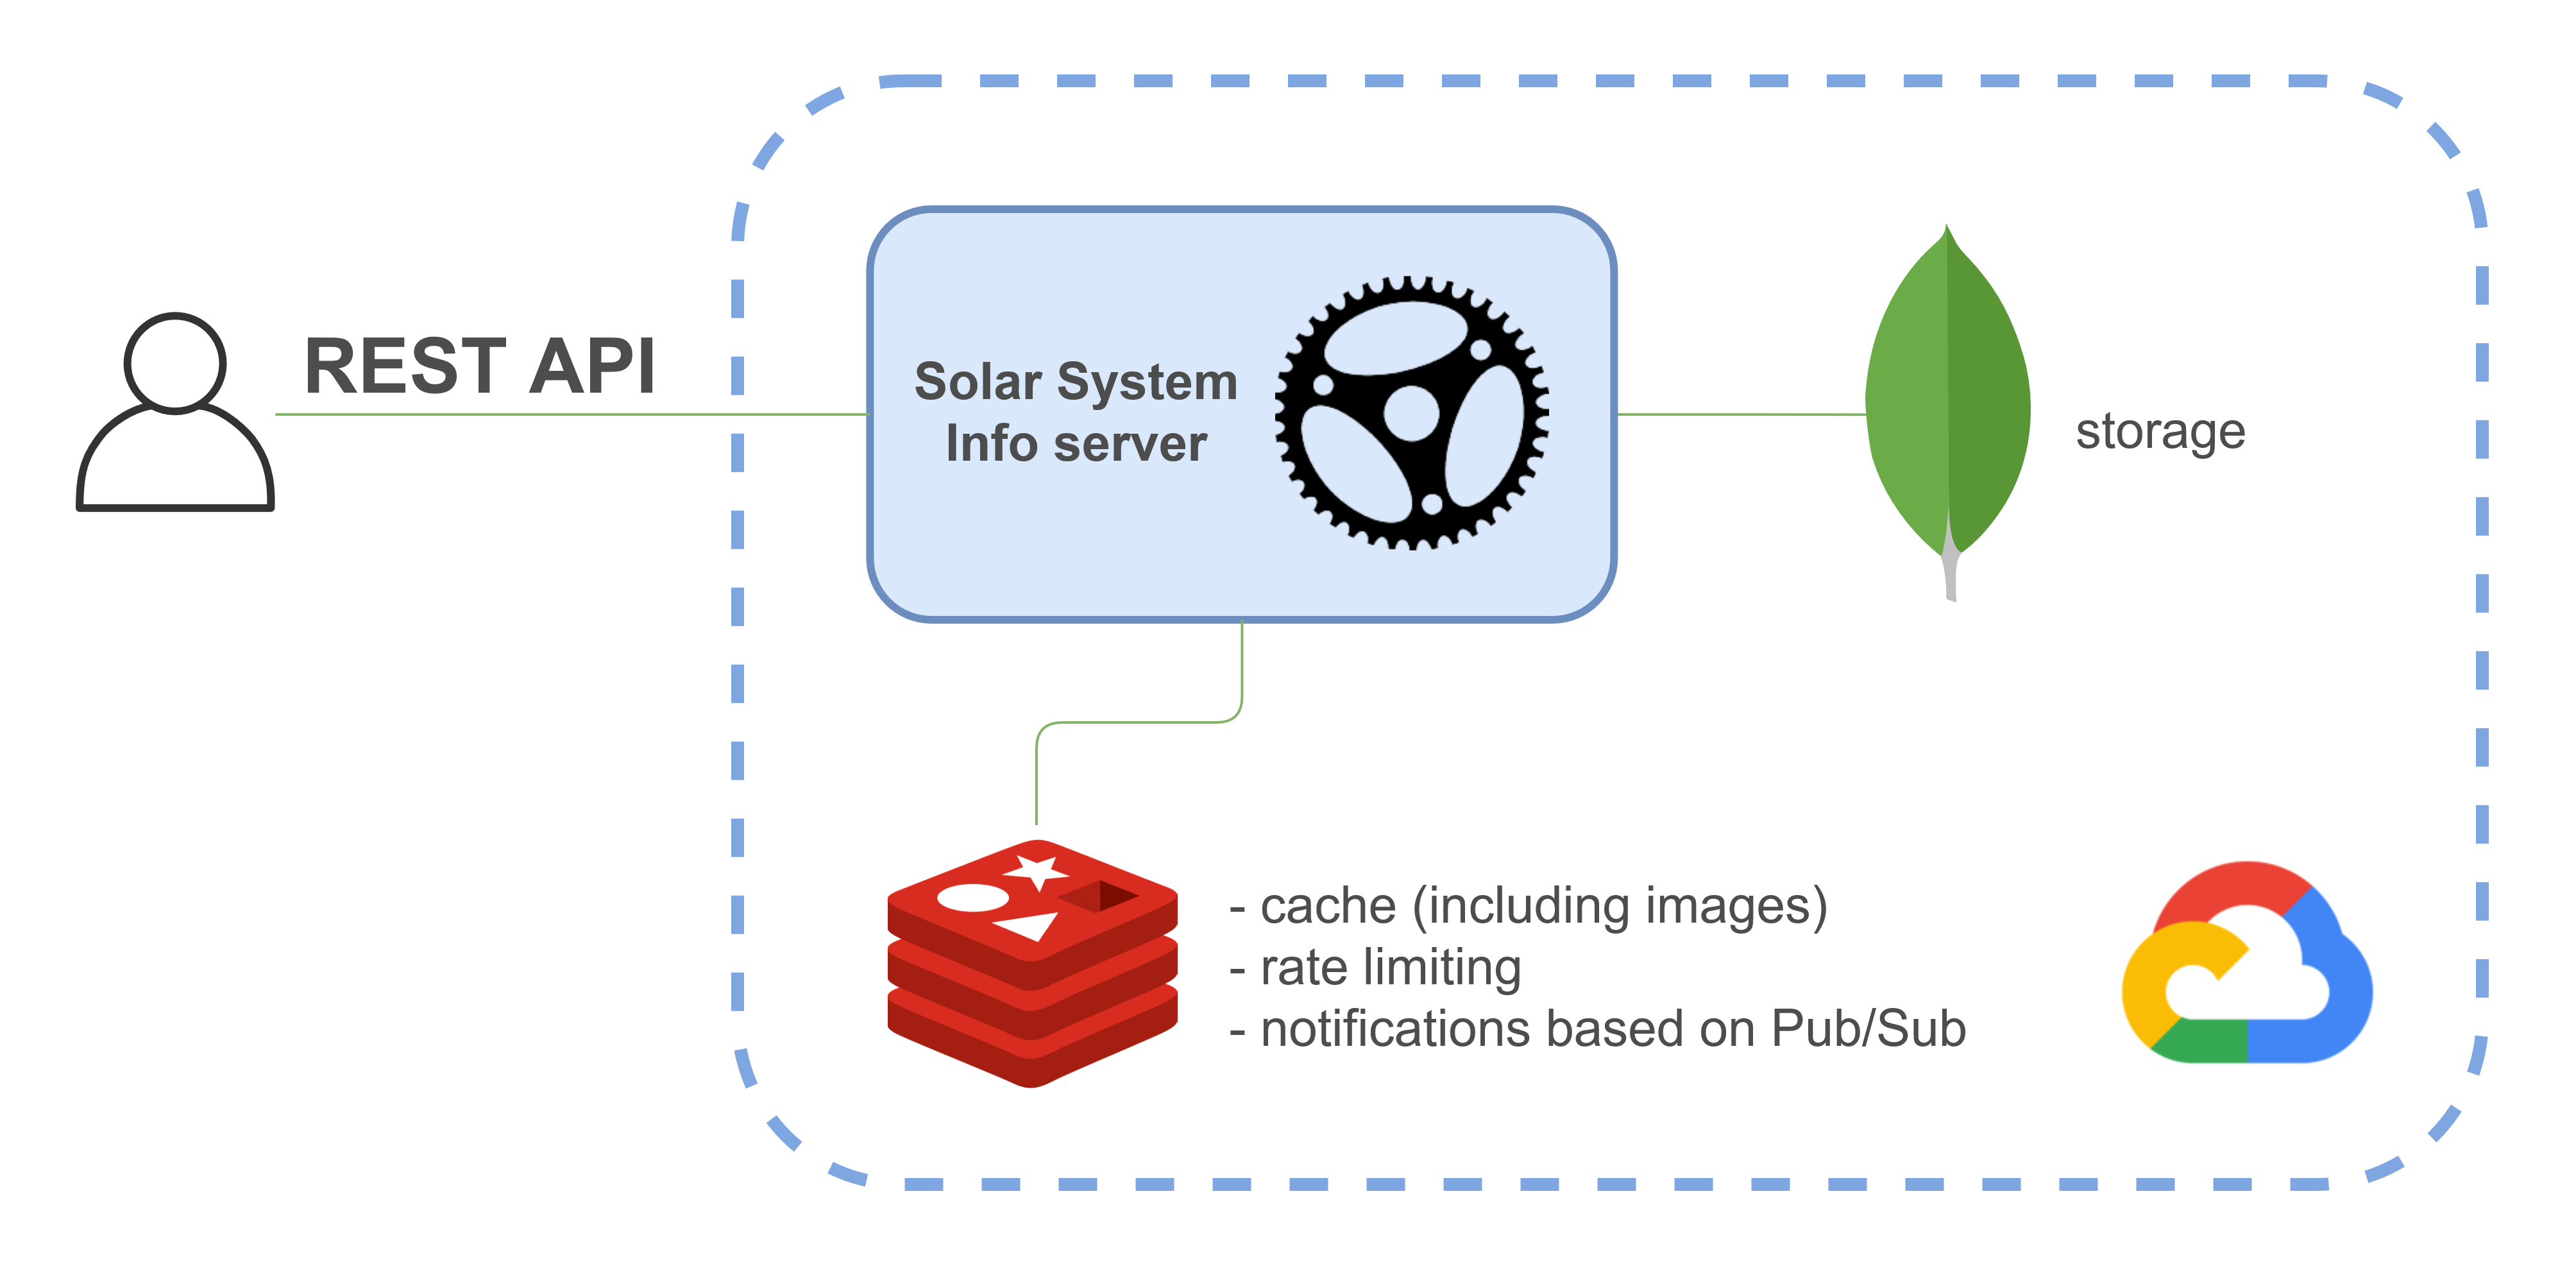
В этой статье будет показано как создать Rust бэкэнд, который использует MongoDB, документо-ориентированную БД, для хранения данных и Redis для кэширования, ограничения количества HTTP запросов и нотификаций пользователя. Для большей наглядности созданное приложение также будет предоставлять REST API. В итоге будет получена следующая архитектура:


architecture


MongoDB является хранилищем, в то время как Redis используется для следующего:


Читать дальше →

Эффективный поиск XSS-уязвимостей

Reading time21 min
Reach and readers65K


Про XSS-уязвимости известно давным-давно — казалось бы, нужен ли миру ещё один материал о них? Но когда Иван Румак, занимающийся тестированием безопасности, поделился методологией их поиска на нашей конференции Heisenbug, реакция зрителей оказалась очень положительной.


И спустя два года у этого доклада по-прежнему растут просмотры и лайки, это один из самых востребованных материалов Heisenbug. Поэтому теперь мы решили, что многим будет полезна текстовая версия, и сделали ее для Хабра.


Под катом — и текст, и видео. Далее повествование идет от лица Ивана.

Структура + предположения > ML? Моделирование продаж байесовскими методами

Reading time17 min
Reach and readers6.6K

Не так давно участвовал в проекте, где мы применяли методы байесовского моделирования для ритейлинговой сети. Тема непростая и интересная. Так как проект под NDA, решил на примере похожего гипотетического проекта показать, как мы решали поставленные перед нами задачи.

Также подробно расскажу об основах Байесовского моделирования. Ну и бонусом, тем кто дочитает до конца и захочет углубиться в эту тему – «куча» ссылок. ​

Читать далее

Рекуррентные нейронные сети (RNN) с Keras

Reading time11 min
Reach and readers107K
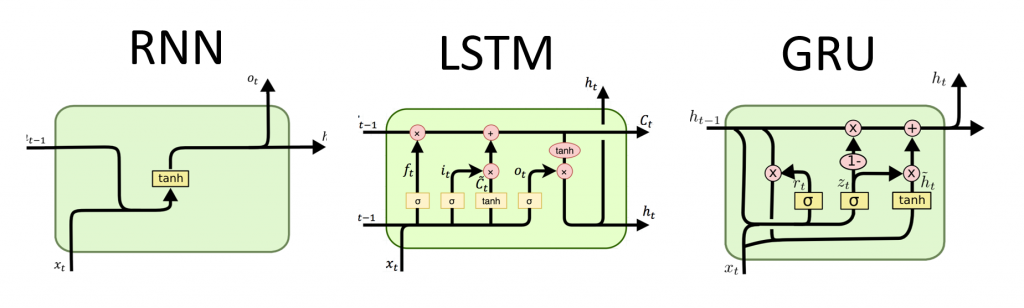
Перевод руководства по рекуррентным нейросетям с сайта Tensorflow.org. В материале рассматриваются как встроенные возможности Keras/Tensorflow 2.0 по быстрому построению сеток, так и возможности кастомизации слоев и ячеек. Также рассматриваются случаи и ограничения использования ядра CuDNN позволяющего ускорить процесс обучения нейросети.


Читать дальше →

Fastcore — недооцененная, но полезная библиотека Python

Reading time10 min
Reach and readers11K

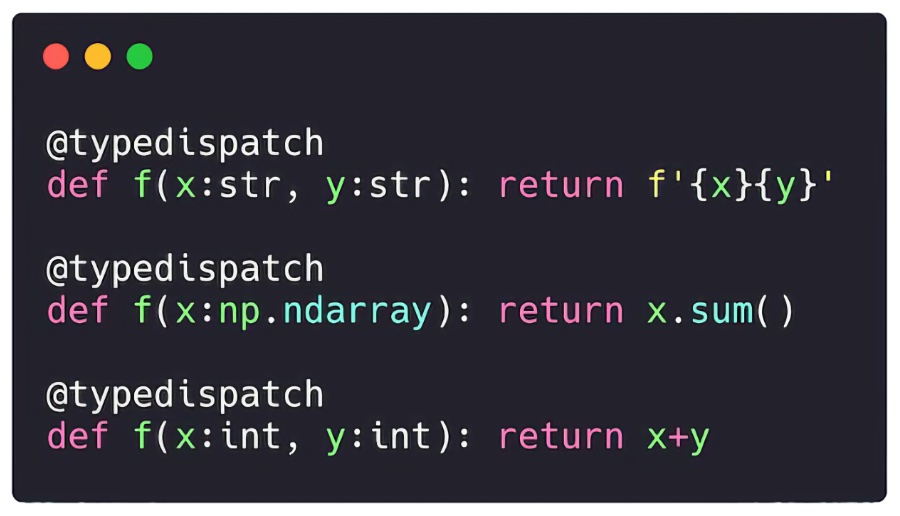
Недавно я начал оттачивать владение языком программирования Python. Я хотел изучить продвинутые паттерны, идиомы и методы программирования. Начал я с чтения книг по продвинутому Python, но информация, похоже, не откладывалась в голове без применения навыков. Хотелось иметь возможность задавать вопросы эксперту, пока учусь, а такую возможность трудно найти! Тогда ко мне и пришла идея: что, если я найду проект с открытым и достаточно продвинутым кодом и напишу документацию и тесты? Я сделал ставку, что это заставит меня изучать все очень глубоко, а поддерживающие проект люди оценит мою работу и будут готовы ответить на мои вопросы.
Возможности fascore

Покупка загородной недвижимости, выбор места

Reading time6 min
Reach and readers37K

Более 10 лет назад, мне как и многим, захотелось вырваться из «душного» города и начать жить на природе, в своем загородном доме. Как и большинство таких людей, я понятия не имел, с какими трудностями мне придется столкнуться. В данном цикле статей я хочу поделиться своим опытом проживания в загородном доме и помочь людям подготовиться к тем трудностям, которые могут возникнуть. А самое главное, помочь более трезво и расчетливо подойти к выбору объекта для покупки.

И так, начнем →

Умная нормализация данных

Reading time8 min
Reach and readers159K

Эта статья появилась по нескольким причинам.


Во-первых, в подавляющем большинстве книг, интернет-ресурсов и уроков по Data Science нюансы, изъяны разных типов нормализации данных и их причины либо не рассматриваются вообще, либо упоминаются лишь мельком и без раскрытия сути.


Во-вторых, имеет место «слепое» использование, например, стандартизации для наборов с большим количеством признаков — “чтобы для всех одинаково”. Особенно у новичков (сам был таким же). На первый взгляд ничего страшного. Но при детальном рассмотрении может выясниться, что какие-то признаки были неосознанно поставлены в привилегированное положение и стали влиять на результат значительно сильнее, чем должны.


И, в-третьих, мне всегда хотелось получить универсальный метод учитывающий проблемные места.


Читать дальше →

Вред хранимых процедур

Reading time3 min
Reach and readers58K

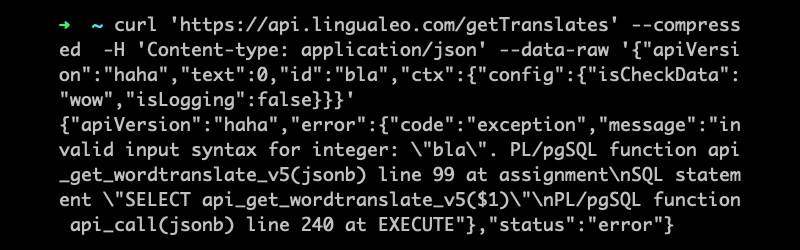
В чат подкаста «Цинковый прод» скинули статью о том, как некие ребята перенесли всю бизнес-логику в хранимые процедуры на языке pl/pgsql. И так как у статьи было много плюсов, то значит, есть люди, а может быть, их даже большинство, которые положительно восприняли такой рефакторинг.

Я не буду растекаться мыслью по древу, а сразу накидаю кучку минусов использования хранимых процедур.
Читать дальше →

Функциональное программирование в Python. Генераторы, как питонячий декларативный стиль

Reading time19 min
Reach and readers32K
  • Общее введение
  • ФП
    • Введение в ФП
    • Основные принципы ФП
    • Основные термины
    • Встроенное ФП поведение в Python
    • Библиотека Xoltar Toolkit
    • Библиотека returns
    • Литература
  • Генераторы
    • Введение в итераторы
    • Введение в генераторы
    • Генераторы vs итераторы
    • Генераторы как пайплайн
    • Концепт yield from
    • Маршрутизация данных на генераторах (мультиплексирование, броадкастинг)
    • Пример трейсинга генератора
    • Стандартные инструменты генераторы
    • Выводы
      • Плюсы
      • Минусы
    • Литература
  • Итоги

Общее введение

Читать дальше →
1
23 ...

Information

Rating
Does not participate
Location
Москва, Москва и Московская обл., Россия
Registered
Activity