Обновить
128K+

Базы данных *

Все об администрировании БД

215,41
Рейтинг
Сначала показывать
Порог рейтинга
Уровень сложности

Большая миграция АБС: c MS SQL и Windows к PostgreSQL и Linux
Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.3K

Привет, Хабр! Меня зовут Андрей, я директор департамента внутренних систем ЮMoney. Эту статью я подготовил в соавторстве с Владиславом, руководителем группы разработки и сопровождения автоматизированной банковской системы (АБС) в ЮMoney. Недавно мы завершили один из главных этапов импортозамещения ИТ-инфраструктуры: вместе с АО «ПрограмБанк» полностью перевели нашу АБС «ПрограмБанк.АБС» на ОС Linux и СУБД PostgreSQL.

В статье расскажу о технической стороне миграции: как мы строили новую инфраструктуру и переносили данные, почему автоматической конвертации кода не хватило и как мы справлялись с падением производительности. Статья может быть полезна архитекторам, разработчикам и техническим руководителям, которым предстоит перенести нагруженную систему на другой технологический стек.

Читать далее

Новости

100 байт из 10 MiB: как PostgreSQL 18 читает TOAST с EXTERNAL, PGLZ и LZ4

Уровень сложностиСредний
Время на прочтение11 мин
Охват и читатели3.9K

Представим ситуацию: в PostgreSQL хранится большое значение — документ, бинарные данные, крупный JSON или другой объект размером в несколько мегабайт. При этом приложению далеко не всегда нужен объект целиком. Иногда требуется получить лишь небольшой фрагмент.

Например, значение занимает 10 MiB, а запросу нужны всего 100 байт.

Кажется логичным, что PostgreSQL должен прочитать только эти 100 байт. Но на практике объём работы зависит от того, как значение хранится, было ли оно сжато и какой алгоритм сжатия использовался.

В этой статье проверим поведение PostgreSQL 18.6 экспериментально. Сравним EXTERNAL, PGLZ и LZ4 и посмотрим, что происходит, если читать один и тот же 100-байтовый фрагмент из начала, середины и конца большого значения.

Цель — не найти универсально «лучший» вариант хранения. Нас интересует более практический вопрос: какую работу PostgreSQL выполняет при частичном чтении большого TOAST-значения и при каких условиях различия становятся заметны.

Читать далее

35 бесплатных уроков для бэкенд-разработчиков: Java, Python, Go, архитектура и ИИ

Уровень сложностиПростой
Время на прочтение3 мин
Охват и читатели4.4K

Бэкенд-разработка давно выходит за рамки одного языка: приходится разбираться с производительностью, пересматривать архитектурные решения и осваивать новые инструменты. В подборке — 35 бесплатных уроков OTUS на октябрь и ноябрь: от практики на Python, Java и Go до работы с высокими нагрузками и интеграции ИИ.

Смотреть подборку уроков

Искали носки, получили брюки: сравнили шесть способов поиска на одном каталоге

Время на прочтение13 мин
Охват и читатели3.7K

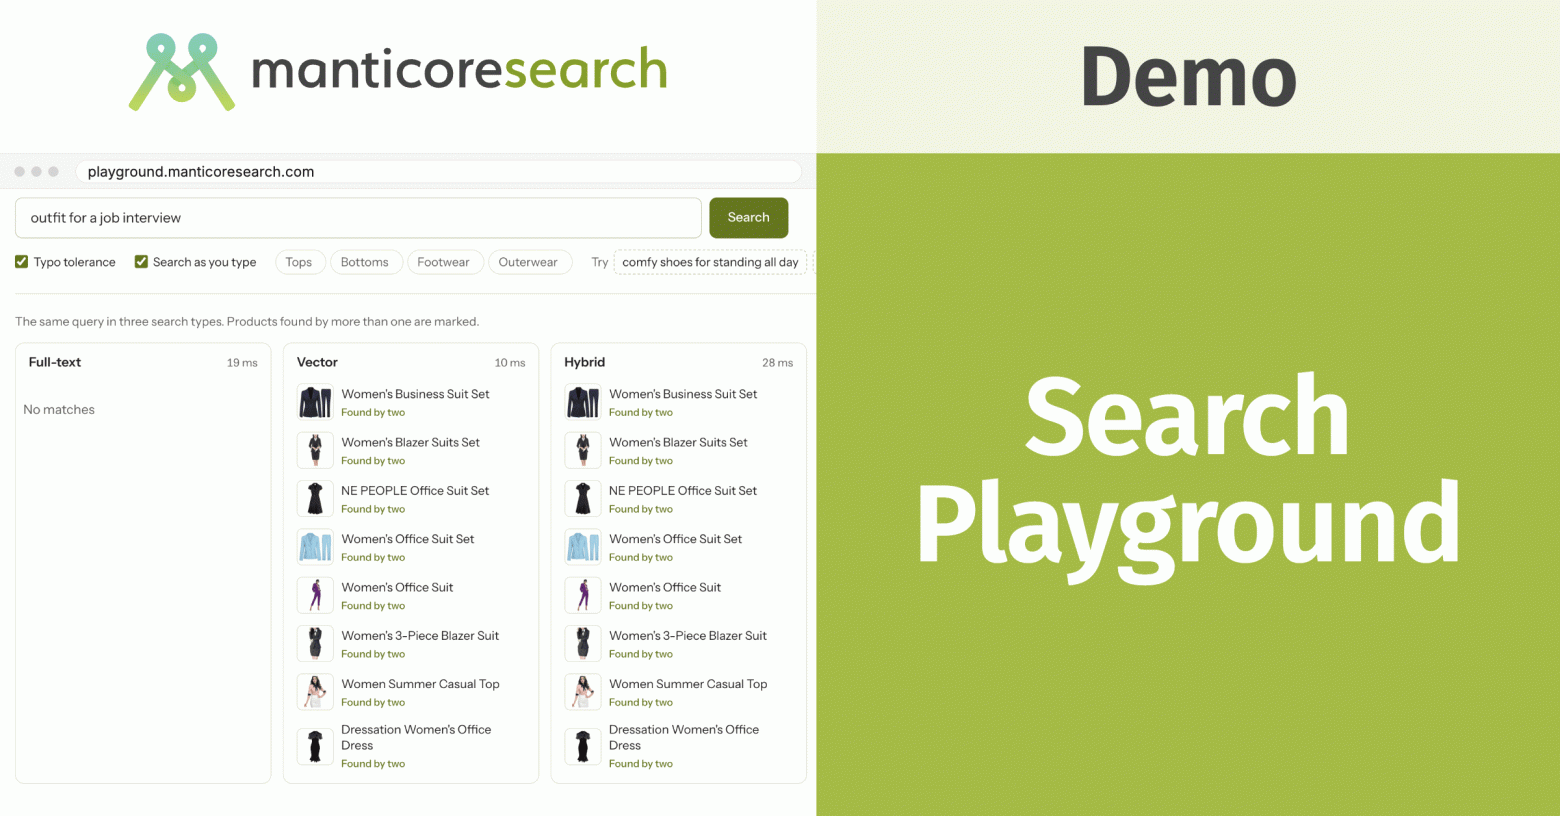
Искали носки, получили брюки: сравнили шесть способов поиска на одном каталоге

Проверили полнотекстовый, векторный, гибридный, поиск по фото, геопоиск и AI на 82 524 товарах. Показываем, где они ошибаются, что находят и какой SQL стоит за результатами.

Читать далее

ClickHouse в Zabbix 8: как устроено хранение истории и что происходит с трендами

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели5.3K

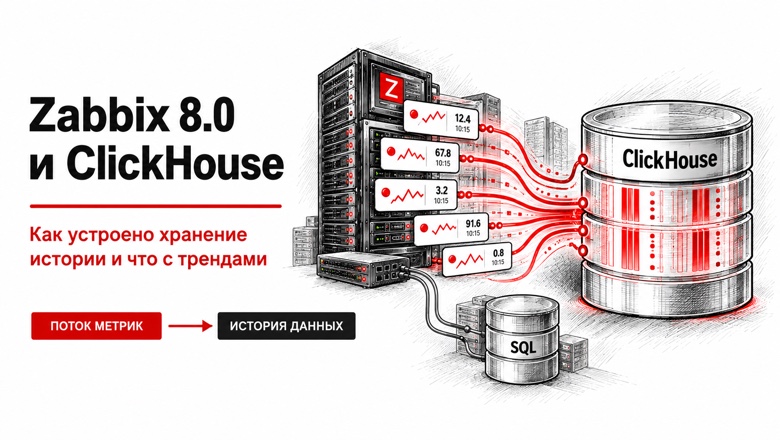
В Zabbix 8 появилась штатная возможность хранить историю элементов данных в ClickHouse. Это позволяет вынести поток измерений в отдельное хранилище, сохранив привычные механизмы сбора данных, обработки значений и проверки триггеров.

При проектировании такой системы нужно учитывать важную особенность: для числовых данных, история которых направлена в ClickHouse, Zabbix не рассчитывает новые штатные тренды. Пока что так.

Меня зовут Антон Касимов, я работаю в Gals Software, веду телеграм‑канал Zabbix Recipes, посвященный Zabbix, где делюсь своим опытом. В этой статье поговорим об особенностях работы Clickhouse с новой версией Zabbix.

В обычной установке Zabbix реляционная база обслуживает разные задачи: хранит конфигурацию мониторинга, пользователей, события, историю измерений и часовые агрегаты. С подключением ClickHouse эти обязанности разделяются. Основная PostgreSQL/MySQL остаётся необходимой, а историю выбранных типов значений можно направить в ClickHouse или ElasticSearch. Но в статье мы будем говорить только о ClickHouse.

Давайте разбираться

Управление жизненным циклом данных с pgpro_ilm

Уровень сложностиПростой
Время на прочтение8 мин
Охват и читатели6.2K

Все данные лежат на быстрых SSD, хотя заказы трёхлетней давности читают раз в квартал. Это значит, что вы платите за дорогую ёмкость там, где она не нужна. Разбираем, как в Postgres Pro Enterprise расширения pgpro_ilm и pgpro_usage сами переносят редко используемые секции, таблицы и индексы на дешёвые диски. Показываем правила, на что они реагируют и какие подводные камни есть у этого механизма.

Читать далее

Opencode, история сессий и база данных

Уровень сложностиПростой
Время на прочтение4 мин
Охват и читатели6.7K

Я обнаружил, что история работы с AI‑агентом может быть полезным источником информации. Поэтому создал инструмент, который позволяет проще исследовать эту историю и возвращаться к результатам прошлой работы.Представляю вам opencode-db — это CLI‑утилита для быстрого изучения, поиска и экспорта истории сессий OpenCode без необходимости вручную разбираться во внутреннем устройстве SQLite‑базы.

Подробности

Безопасность ИИ‑агента: больше контроля или специальная среда?

Уровень сложностиПростой
Время на прочтение12 мин
Охват и читатели7.5K

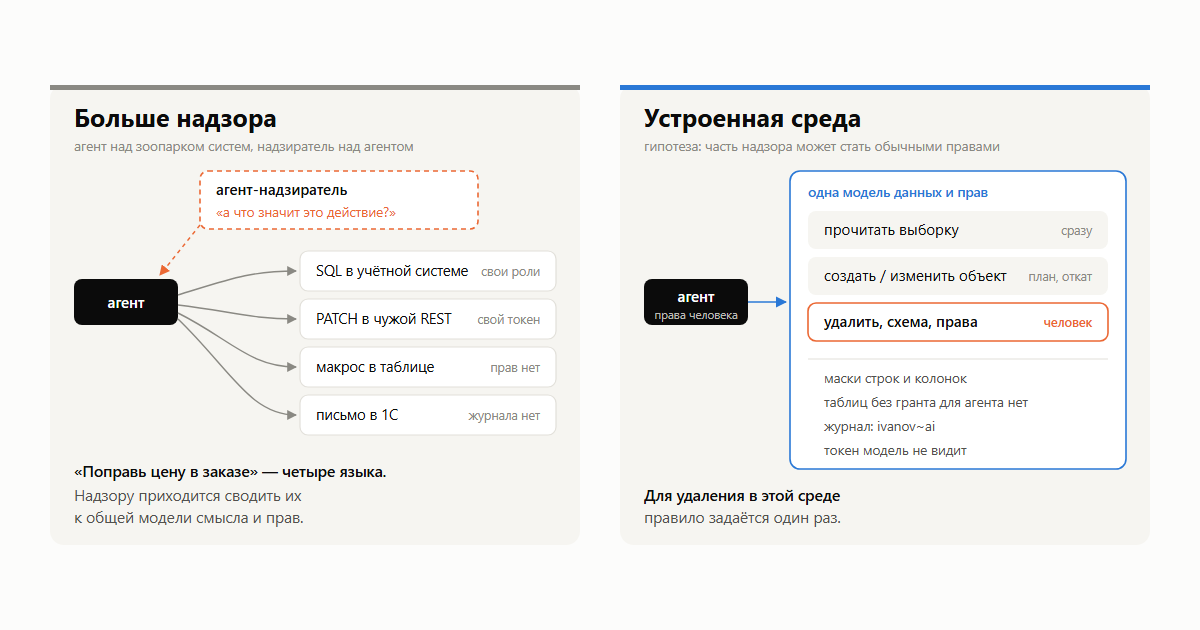
TL;DR. 19 октября из Microsoft написали, что агентов внутри компании нужно считать инсайдерами без презумпции доверия. Предложение: агенты-надзиратели, которые смотрят каждое действие каждого агента до того, как оно совершится. Я согласен с диагнозом, но сомневаюсь в рецепте. В посте есть слово overprivileged, и, по-моему, вся беда в нём: агенту выдали права с запасом, потому что точнее выдать было нельзя — права разбросаны по системам и единой модели у них нет. Моя гипотеза: часть надзора можно заменить устройством среды, в которой агент работает. Надзиратель лечит симптом: смотрит на действие и гадает, что оно значит. Если права, данные и связи описаны в одной модели, агенту можно выдать права конкретного человека, и тогда ему гадать почти не о чем, и надзора нужно меньше. Ниже — как через такую среду прошли бы известные инциденты с агентами и что нашли детерминированные пробы нашего ядра.

Читать далее

Мой PostgreSQL быстрее твоего и почти догнал ClickHouse

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели9.9K

Мой знакомый - отличный архитектор, но полнейший сноб. У него в проде четыре разных базы данных. PostgreSQL для OLTP, в ClickHouse у него лежат данные OpenTelemetry и веб аналитики, Elasticsearch для полнотекстового поиска в приложении, а MongoDB - “так исторически сложилось”.

Между всем этим ETL, CDC вместе с дежурствами разработчиков в поисках где именно результаты не сходятся. Для него это все продуманная архитектура, а для меня излишняя сложностью в поддержке и разработке.

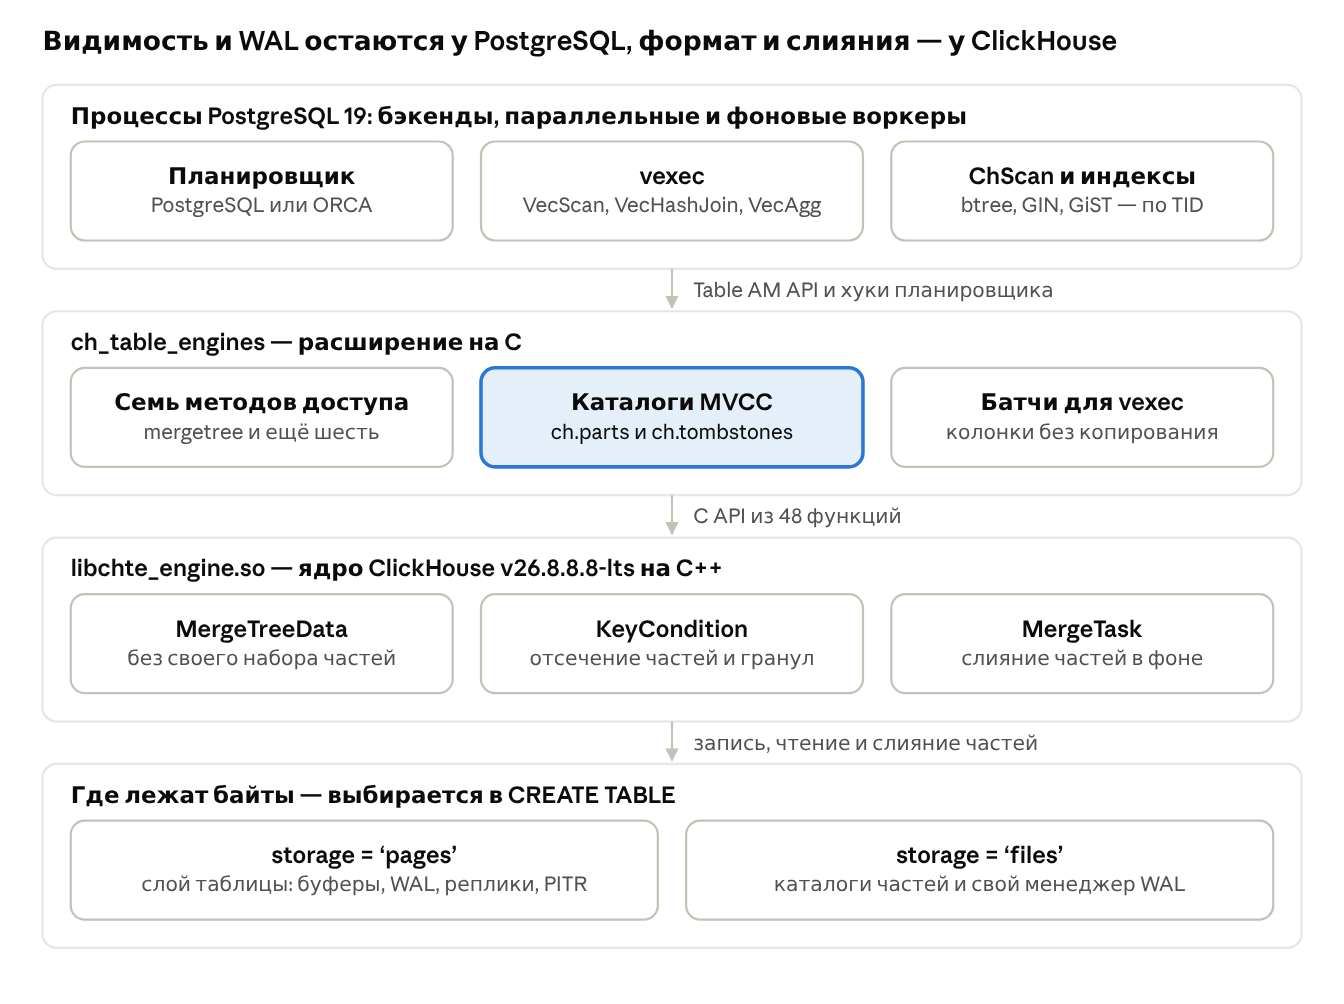
Недавно рассказал ему чем я занимался последнее время. Добавил табличный движок из ClickHouse в PG и поборол раздувание таблиц при обновлениях.

Читать далее

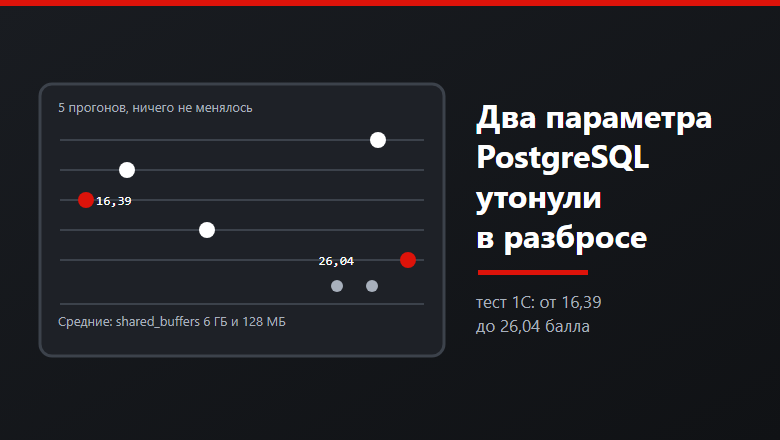
Два параметра PostgreSQL утонули в разбросе теста 1С

Уровень сложностиПростой
Время на прочтение5 мин
Охват и читатели4.5K

Два популярных совета по PostgreSQL для 1С, больше shared_buffers и выключенный synchronous_commit, мы проверили тестом Гилева. Но пять прогонов без изменений разошлись шире, чем любая из настроек. Рядом таблицы, команды смены параметров и шесть шагов для своего замера.

Как отличить эффект настройки от разброса

Поиск узких мест в Oracle с помощью ASH/AWR и LLM

Уровень сложностиСложный
Время на прочтение16 мин
Охват и читатели5.2K

Добрый день, всем любителям Oracle и пирогов из картофельных очистков!

Одна из самых часто встречающихся проблем при использовании баз данных - это поиск узких мест: нахождение долго выполняющихся запросов и их исправление.

Как часто вы сталкивались с ситуацией, когда запрос мгновенно отрабатывает в тестовом окружении, но начинает «тормозить» на боевом сервере? Или замедление запросов проявляется не сразу, а по мере роста данных?

Я написал open-source утилиту Optimus Oracle. Она получает тяжёлые SQL-запросы из ASH/AWR, собирает планы и через LLM (локальные или облачные) предлагает оптимизацию: создание индексов или изменение запроса. Дальше - реальные примеры «до/после», цифры, грабли и честный разговор о приватности.

Читать далее

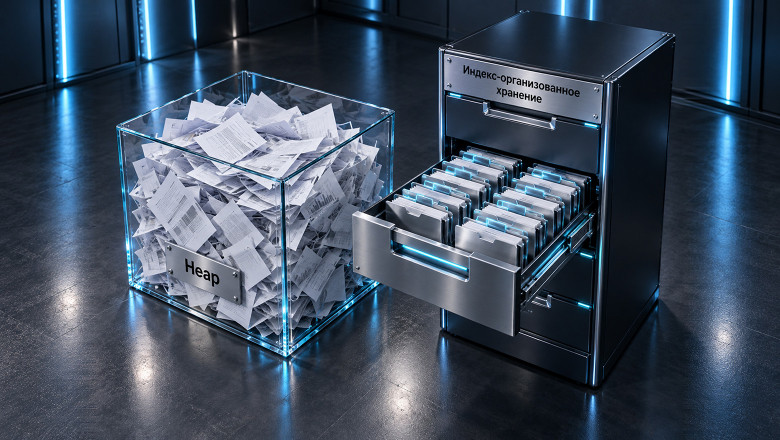
Heap умер? Или как IOT вместо heap ускорил PostgreSQL в 2 Х

Уровень сложностиСредний
Время на прочтение7 мин
Охват и читатели5.5K

Привет, Хабр! На связи Михаил Семёнов, владелец продукта СУБД Platform V Pangolin DB.

Высокая нагрузка OLTP? VACUUM необходим, но нагружает базу? Непрерывный bloat и отстающая реплика? Мы привыкли списывать это на характер нагрузки, но давайте критически посмотрим на классический heap и поддержание целостности и многозначности данных.

В статье разберу альтернативу — индекс‑организованное хранение (IOT). Покажу, как IOT решает эти проблемы, ускоряет работу с данными, не меняя интерфейса (прозрачно для клиента).

В Pangolin мы добавили новый вариант хранения (индекс-организованный), который, помимо оптимизации хранения, более чем вдвое ускорил работу с данными без изменения интерфейса PostgreSQL.

Статья будет полезна DBA, тимлидам, СТО и архитекторам Enterprise-компаний и поможет решить проблемы масштабируемости PostgreSQL без смены стека технологий и эффективно использовать бюджет на инфраструктуру.

Читать далее

«Донащупывая» Data Lineage

Уровень сложностиСредний
Время на прочтение5 мин
Охват и читатели8.9K

Добрый день, Хабр! В рамках основной деятельности — проектирования витрин данных в корпоративных хранилищах, — неизбежно сталкиваюсь с вопросом происхождения данных. Проще говоря, необходимо понять, кто и когда, как, из чего и в чьих интересах собрал попавшийся под руку датасет. Обновляется ли срез данных и есть ли у него пользователи? Для такого процесса в мире DWH давно укоренилось название «построить Data Lineage». Предлагаю вместе со мной еще раз пройтись по определению и попробовать его уточнить, так сказать, донащупать.

Читать далее

Ближайшие события

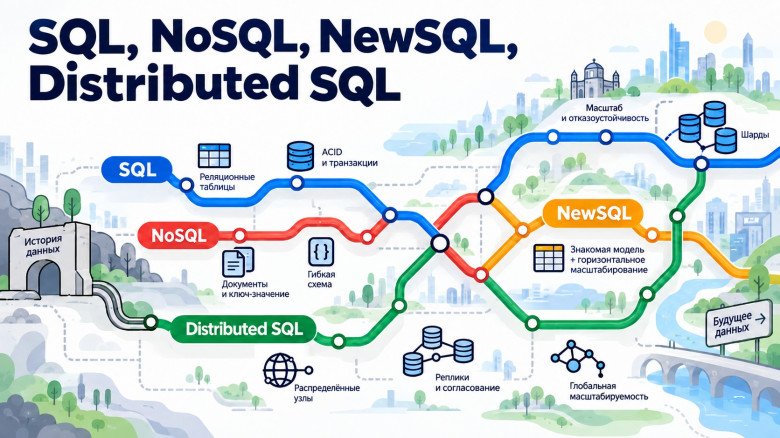
SQL, NoSQL, NewSQL, Distributed SQL: как читать архитектуру СУБД

Уровень сложностиПростой
Время на прочтение11 мин
Охват и читатели9.9K

Для человека, впервые погружающегося в историю систем управления базами данных, последовательность SQL → NoSQL → NewSQL выглядит как диалектическая триада: тезис, антитезис, синтез. Сначала традиционные реляционные СУБД стали основой большинства коммерческих информационных систем, затем на волне NoSQL появились архитектуры, которые ради горизонтального масштабирования отказывались от части привычных реляционных ограничений и гарантий, и наконец направление NewSQL попыталось взять лучшее от обоих миров: SQL и ACID – от реляционных СУБД, горизонтальное масштабирование – от NoSQL.

Читать далее

Сверка таблиц в PostgreSQL, или О том, нужны ли для этого специальные утилиты

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели9.9K

Лет десять назад я делал инструмент сверки таблиц для мультимастера — крайне неэффективным способом: брал снапшот и под ним просто шёл по таблице, матчил строки. С тех пор задача стала только актуальнее: одни и те же данные всё чаще живут в разных дата-центрах, на разных инстансах с надёжным failover’ом, и рано или поздно приходится задумываться о проверке их идентичности.

Готовые инструменты для сравнения таблиц в мире Postgres есть — pg_comparator, pgCompare, ACE. Однако давайте сегодня поразмышляем, стоит ли ради большей эффективности городить огород с дополнительным софтом. Может быть, хватит простой транзакции и golang-скрипта, выполняющего SQL на обоих инстансах?

Читать далее

DBML Diagram 1.0.1: схемы БД в продуктах от JetBrains, интеграция с dbdiagram.io и ваши идеи

Уровень сложностиПростой
Время на прочтение10 мин
Охват и читатели11K

Привет, Хабр! На связи Boost for Java.

В первой статье о DBML Diagram мы рассказали, зачем сделали open source плагин для работы с DBML прямо в IntelliJ IDEA. Тогда основой были редактор и диаграмма рядом с кодом, а интеграция с dbdiagram.io оставалась в планах.

Сейчас в JetBrains Marketplace доступна версия 1.0.1. С момента первой публикации появились обмен схемами с dbdiagram.io, экспорт DDL для трёх СУБД, ручная настройка расположения таблиц и связей, а также проверка отношений между таблицами.

В этой статье покажем, как теперь выглядит рабочий процесс и где у плагина остаются ограничения. А в конце попросим помочь с приоритетами: хочется развивать его на основе реальных схем и задач пользователей.

Установить DBML Diagram · Исходный код

Читать далее

Букмекер видит вашу ставку через 10 секунд: что real-time-аналитика делает с данными пользователей

Уровень сложностиПростой
Время на прочтение7 мин
Охват и читатели5.6K

В беттинге данные о действиях нужны почти сразу — не через час и даже не через полчаса. В нашем случае — в течение 10–15 секунд. Иначе продуктовая команда рискует поздно заметить проблему, а бизнес — потерять деньги и время, за которое конкурент уже запустит свою механику. Поэтому на связи Владимир Медников — директор по данным в PARI. Я расскажу, что происходит с событием пользователя после нажатия кнопки, зачем здесь Kafka с ClickHouse и почему именно 10–15 секунд, а не три минуты.

Читать далее

UniqueKeys — планировщик PostgreSQL учится помнить, где строки уникальны

Время на прочтение11 мин
Охват и читатели8.4K

Патч UniqueKeys для PostgreSQL предлагает научить планировщик распознавать случаи, когда строки запроса уже гарантированно уникальны. Сейчас он (планировщик) не всегда может это определить и выполняет лишнюю работу: повторно проверяет данные на дубликаты, хотя в этом нет необходимости, или упускает более дешеый план выполнения. Механизм UniqueKeys позволяет прослеживать уникальность данных через сложные соединения и подзапросы, чтобы исключать ненужные операции DISTINCT и GROUP BY и точнее оценивать стоимость запросов. В Tantor Postgres этот механизм уже реализован, а патч предложен для рассмотрения сообществом PostgreSQL в рамках CommitFest.

Читать далее

Как мы довели Postgres Pro до APDEX 0,986 на 30 000 пользователей 1С:ERP. Часть 3/3

Уровень сложностиСредний
Время на прочтение12 мин
Охват и читатели9.5K

Мы дошли до финала: 30 000 ВРМ, 4 NUMA-узла, сервер на 480 логических ядер и APDEX = 0,986 в конфигурации с асинхронной репликой. Но на последнем отрезке пути нас ждали сюрпризы. Один процесс Xorg загружал целое ядро и тормозил тонкие клиенты. INSERT на 15 строк висел больше 20 секунд из-за блокировок BufferMapping. Подключённая реплика заставила rphost съедать вдвое больше памяти и уронила кластер 1С. Рассказываем, как мы с этим справились и что вошло в Postgres Pro Enterprise for 1C 18.6.1.

Читать далее

Как мы довели Postgres Pro до APDEX 0,986 на 30 000 пользователей 1С:ERP. Часть 2/3

Уровень сложностиСредний
Время на прочтение8 мин
Охват и читатели7.7K

Тест упал на пятом часу, на переходе с 16 800 до 21 000 ВРМ. Потом запрос, который выполнялся меньше секунды, вдруг стал занимать десятки секунд. После этого отчёт вместо 5 секунд начал строиться 800. Во второй части мы разбираем, как с этим справились: от LWLock:PgStatsHash и сбежавшего плана запроса до гигабитной сетевой карты и 3 миллионов файлов временных таблиц. В итоге на 21 000 ВРМ получили APDEX = 0,975.

Читать далее
1
23 ...