Учебник по JavaFX: начало работы
Как настроить и начать работать с JavaFX, с помощью Maven, Gradle или JavaFX SDK.
Все посты в серии JavaFX:

Объектно-ориентированный язык программирования


The vlcj project provides a Java framework to allow an instance of a native VLC media player to be embedded in a Java application.Идея у ребят простая, но гениальная (реально перцовая). Вместо мучений с библиотеками FFmpeg и прочим, надо сразу вызывать


Как можно создать web приложение без использования HTML? Для этого нам понадобится: новый браузер, QML и back-end на Java.

SonarQube — отличный инструмент для внедрения статического анализа кода в процесс разработки ПО. Он поддерживает как используемую у нас в компании Java, так и большое количество других языков программирования.
На данный момент этот инструмент плотно вошёл в нашу жизнь, следя за единым стилем кода и уберегая от самых разных видов ошибок. Поиск ошибок происходит при сборке на CI или перед принятием pull request в версионное хранилище. Все найденные ошибки отображаются в Web-интерфейсе, где можно изучать их и управлять ими.
Однако беда в том, что удобный Web-интерфейс не означает удобство по устранению найденных замечаний в коде проекта. Для того, чтобы внести исправление, приходится сначала смотреть, в каком именно файле это замечание обнаружено, потом открывать этот файл и только затем вносить исправление. Также это приводит к тому, что разработчик узнает о проблеме с очень большим отставанием (иногда анализ в SonarQube может занимать десятки минут), что не способствует поддержанию чистоты кода.
Для того, чтобы облегчить жизнь разработчикам нашей компании, использующим IntelliJ IDEA, я составил инструкцию. А в дальнейшем понял, что она может быть полезной более широкому кругу специалистов, и решил выложить её в публичный доступ.

Истории по распиливанию монолита часто похожи одна на другую. Был у команды здоровенный неповоротливый монолит, решили его распилить на россыпь правильных и шустреньких микросервисов, все стало круто. Отличаются истории лишь степенью ужаса “до”, радости “после” и рядом вторичных характеристик.
У нас в RBK.money тоже микросервисы. Но пришли мы к ним немного не так, как большинство. У нас все было даже хуже монолита — у нас на старте просто все было хреново.
Под катом о том, как мы, собственно, и строили микросервисы, почему OpenSource — это не только здорово в принципе, но еще и работает как мотивационная составляющая писать хороший код.
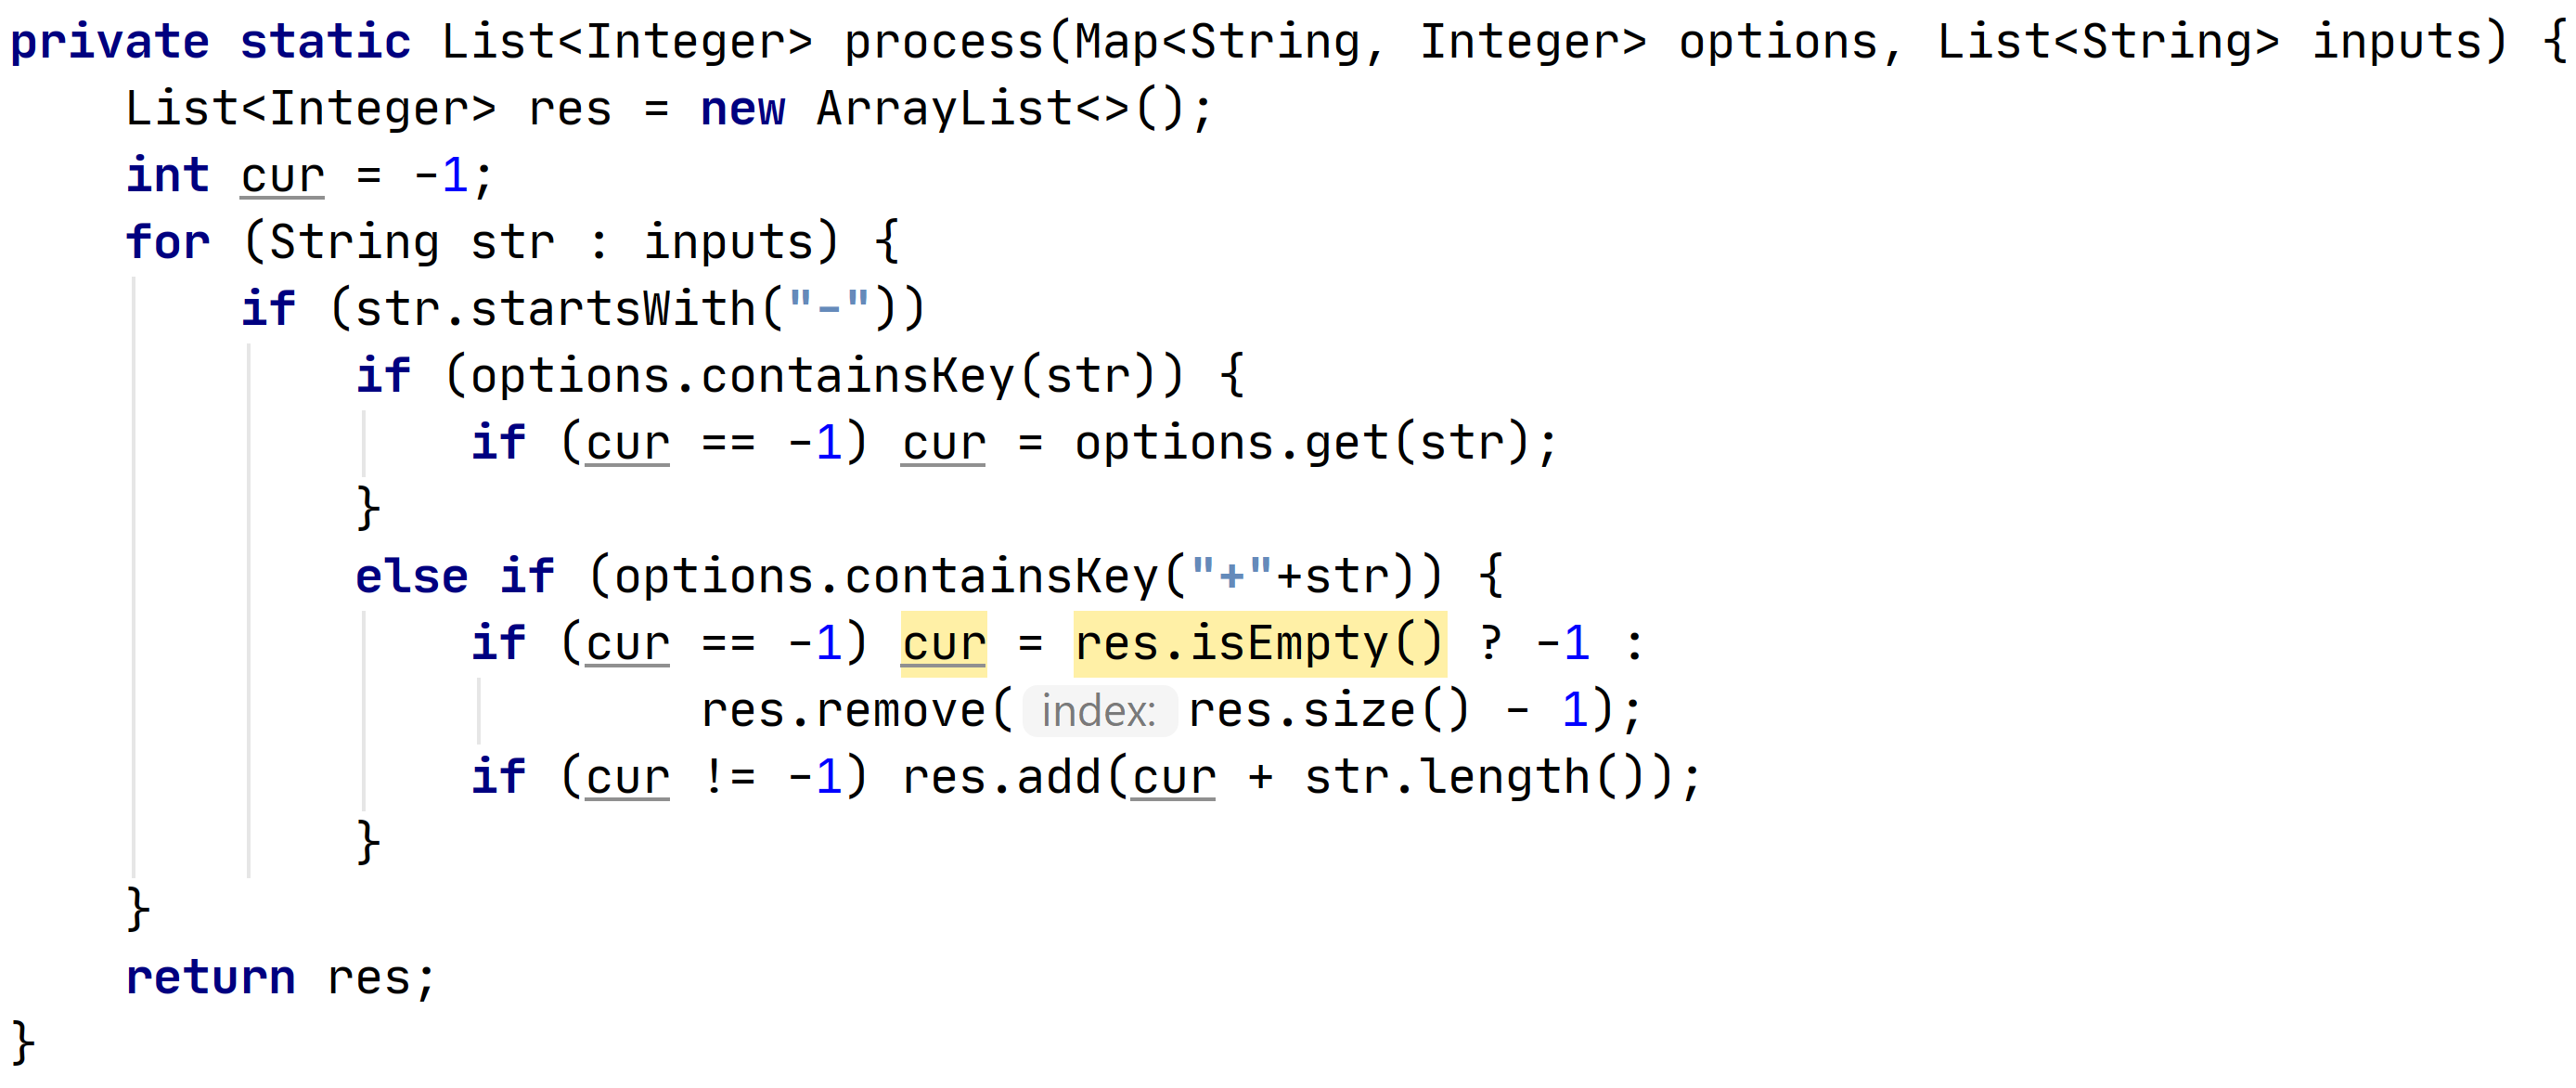
Не так давно я изучал вывод статического анализатора IntelliJ IDEA для Java-кода и наткнулся на интересный случай. Так как соответствующий фрагмент кода не является open source, я его анонимизировал и отвязал от внешних зависимостей. Будем считать, что он выглядел так:
private static List<Integer> process(Map<String, Integer> options, List<String> inputs) {
List<Integer> res = new ArrayList<>();
int cur = -1;
for (String str : inputs) {
if (str.startsWith("-"))
if (options.containsKey(str)) {
if (cur == -1) cur = options.get(str);
}
else if (options.containsKey("+" + str)) {
if (cur == -1) cur = res.isEmpty() ? -1 :
res.remove(res.size() - 1);
if (cur != -1) res.add(cur + str.length());
}
}
return res;
}Код как код, что-то преобразуется, что-то делается, но статическому анализатору он не понравился. Здесь мы видим целых два предупреждения:


Application Class Data Sharing (AppCDS) – фича JVM для ускорения запуска и экономии памяти. Появившись в HotSpot в зачаточном виде ещё в JDK 1.5 (2004 г.), она долгое время оставалась весьма ограниченной, да ещё и отчасти коммерческой. Лишь только с OpenJDK 10 (2018 г.) её сделали доступной простым смертным, заодно расширив область применения. А недавно вышедшая Java 13 попыталась сделать это применение более простым.
Идея AppCDS в том, чтобы “расшарить” однажды прогруженные классы между экземплярами одной и той же JVM на одном хосте. Кажется, это должно здорово зайти микросервисам, особенно “бройлерам” на Spring Boot с их тысячами библиотечных классов, ведь теперь эти классы не надо будет загружать (парсить и верифицировать) при каждом старте каждого инстанса JVM, и они не будут дублироваться в памяти. А значит, запуск должен стать скорее, а потребление памяти – ниже. Чудно, не правда ли?
Всё так, всё так. Но если ты, однохабрянин, привык верить не бульварным вывескам, а конкретным цифрам и примерам, то добро пожаловать под кат – попробуем разобраться, как оно на самом деле…
У меня есть маленькая библиотека StreamEx, которая расширяет возможности Java 8 Stream API. Библиотеку я традиционно собираю через Maven, и по большей части меня всё устраивает. Однако вот захотелось экспериментов.
Некоторые вещи в библиотеке должны работать по-разному в разных версиях Java. Самый яркий пример — новые методы Stream API вроде takeWhile, которые появились только в Java 9. Моя библиотека предоставляет реализацию этих методов и в Java 8, но когда расширяешь Stream API сам, попадаешь под некоторые ограничения, о которых я здесь умолчу. Хотелось бы, чтобы пользователи Java 9+ имели доступ к стандартной реализации.

Наверно, многие задумывались над тем, как можно реализовать свои знания в готовом продукте. Кто-то больше, кто-то меньше потратил на это времени. Хочу поделиться с сообществом своим опытом и видением, как это надо делать правильно, но не всегда получается.
Привет, Хабр! В этой статье я хочу рассмотреть такую библиотеку для Java, как ClusterJ, которая позволяет очень просто работать с движком MySQL NDBCLUSTER из Java кода, которая представляет собой высокоуровневое API, схожее по концепции с JPA и Hibernate.
В рамках статьи создадим простое приложение на SpringBoot, а также сделаем стартер с ClusterJ на борту для удобного использования в приложениях с использованием автоконфигурации. Напишем простые тесты с использованием JUnit5 и TestContainers, которые покажут базовое использование API.
Также расскажу о нескольких недостатках, с которыми пришлось столкнутся в процессе работе с ней.
Кому интересно, добро пожаловать под кат.