Обновить
128K+

SQL *

Формальный непроцедурный язык программирования

49,87
Рейтинг
Сначала показывать
Порог рейтинга

Семь строк в SQL — ещё не семь дней. Как пропуски дат меняют скользящую сумму

Для показателя «за последние семь дней» легко написать:

SUM(amount) OVER (  ORDER BY day  ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
)

Но ROWS отсчитывает строки. Если в таблице нет дней без продаж, семь соседних строк могут охватывать несколько недель.

Проверим на учебном примере для SQLite. В таблице одна строка на день с продажами; в остальные дни продаж действительно не было. Суммы для простоты записаны в рублях.

WITH daily(day, amount) AS (  VALUES    ('2026-10-01', 10),    ('2026-10-09', 20),    ('2026-10-10', 30)
)
SELECT  day,  SUM(amount) OVER (    ORDER BY day    ROWS BETWEEN 6 PRECEDING AND CURRENT ROW  ) AS sum_by_rows,  SUM(amount) OVER (    ORDER BY julianday(day)    RANGE BETWEEN 6 PRECEDING AND CURRENT ROW  ) AS sum_by_days
FROM daily
ORDER BY day;

Результат:
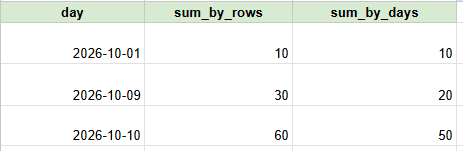
Для 10 октября нужный период — с 4 по 10 октября включительно. Продажа 1 октября в него не входит, поэтому сумма равна 50. Окно по строкам захватывает все три имеющиеся записи и возвращает 60.

В варианте с RANGE функция julianday(day) даёт числовую шкалу дней. Граница 6 PRECEDING охватывает текущий день и шесть предыдущих. Здесь используются корректные даты без времени; для временных меток сначала нужно определить часовой пояс отчёта и получить дневные итоги.

Есть и второй способ: дополнить таблицу календарём, чтобы каждому дню соответствовала строка, а подтверждённому отсутствию продаж — ноль. Тогда ROWS снова будет отсчитывать дни. Это также позволит показать на графике даты без продаж.

Для средней за семь календарных дней различие ещё заметнее. Если в том же семидневном окне заменить SUM(amount) на AVG(amount), на 10 октября получится 25 ₽: среднее по двум строкам за 9 и 10 октября. А среднее за все семь календарных дней — 50 / 7 ≈ 7,14 ₽. Этот расчёт предполагает, что данные за все семь дней полные. Для сравнения: обычный AVG(amount) по всей исходной таблице дал бы 20 ₽.

RANGE ограничивает окно, но не создаёт строки для пропущенных дат. Поэтому и в результате запроса остаются только даты, которые есть во входных данных.

Отсутствие строки из-за сбоя загрузки нельзя автоматически приравнивать к нулевым продажам. Иначе календарь сделает результат аккуратным, но неверным.

Перед проверкой формулы по идее надо проверить, что означает одна строка таблицы. Для скользящих показателей это напрямую определяет границы расчёта.

Теги:
0
Комментарии0

Покупка в сентябре, возврат в октябре. Почему два отчёта показывают разные суммы

Пример: 15 сентября покупатель заплатил 1000, а 5 октября получил частичный возврат 400. Других операций нет. Какую сумму показать за сентябрь — 1000 или 600 р.? Ответ зависит от вопроса, на который отвечает отчёт.

Разберём два управленческих отчёта по платежам. Берём только успешно проведённые оплаты и возвраты, без комиссий. Срез — на начало 28 октября 2026 года. В учебной базе даты записаны в одном часовом поясе, суммы — целыми копейками.

Данные для SQLite:

CREATE TABLE payments (  id INTEGER PRIMARY KEY,  paid_at TEXT,  amount_kopeks INTEGER
);
CREATE TABLE refunds (  id INTEGER PRIMARY KEY,  payment_id INTEGER,  refunded_at TEXT,  amount_kopeks INTEGER
);
INSERT INTO payments VALUES (1, '2026-09-15', 100000);
INSERT INTO refunds VALUES (1, 1, '2026-10-05', 40000);

Первый вопрос: сколько поступило и сколько вернули в каждом месяце? Оплату относим к дате оплаты, возврат — к дате возврата.

SELECT substr(event_at, 1, 7) AS month,       SUM(delta_kopeks) AS net_kopeks
FROM (  SELECT paid_at AS event_at,         amount_kopeks AS delta_kopeks  FROM payments  WHERE paid_at < '2026-10-28'  UNION ALL  SELECT refunded_at, -amount_kopeks  FROM refunds  WHERE refunded_at < '2026-10-28'
)
GROUP BY month
ORDER BY month;

Результат: сентябрь +100 000 копеек, октябрь −40 000. То есть +1000 ₽ и −400 ₽ соответственно.

Второй вопрос: сколько осталось от покупок каждого месяца после известных на дату среза возвратов? Здесь возврат связываем с исходной покупкой.

WITH refunded AS (  SELECT payment_id, SUM(amount_kopeks) AS returned  FROM refunds  WHERE refunded_at < '2026-10-28'  GROUP BY payment_id
)
SELECT substr(p.paid_at, 1, 7) AS purchase_month,       SUM(p.amount_kopeks - COALESCE(r.returned, 0))         AS net_kopeks
FROM payments p
LEFT JOIN refunded r ON r.payment_id = p.id
WHERE p.paid_at < '2026-10-28'
GROUP BY purchase_month
ORDER BY purchase_month;

Теперь за сентябрь получается 60 000 копеек, или 600 ₽. Октябрьской строки нет: новых покупок в октябре не было.Возвраты сначала суммируются по платежу. Поэтому несколько частичных возвратов не размножат исходную сумму при соединении таблиц. Оба результата корректны для своих вопросов. Первый показывает операции по месяцам. Второй — сумму покупок месяца после возвратов, известных на дату среза. Он может измениться, если позже появится ещё один возврат.

У первого отчёта за сентябрь останется 1000, у второго — уже 600 ₽. Поэтому рядом с показателем нужны правило отнесения возвратов и дата среза. Одной подписи «продажи за месяц» здесь недостаточно.

Теги:
0
Комментарии0

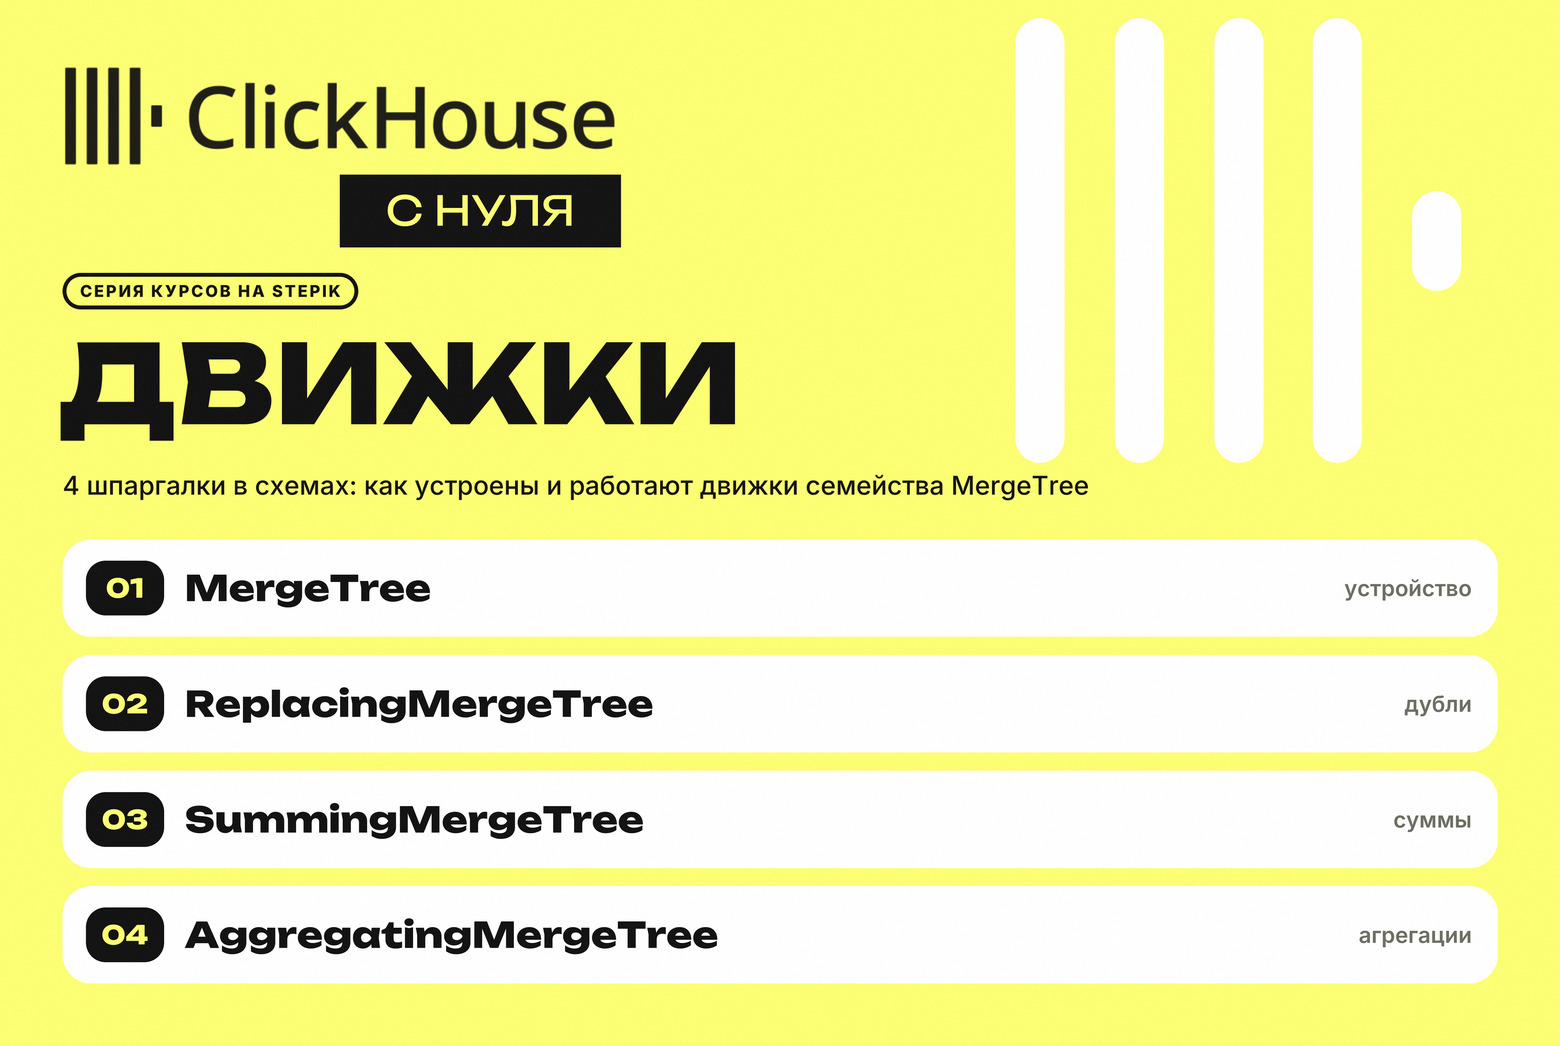
4 шпаргалки по движкам в ClickHouse

Всем привет! Публикую второй пак, 4 шпаргалки по MergeTree движкам. Вся механика работы показана схемами, а все примеры проверены на ClickHouse 26.9.2.1.

Весь набор можно скачать по ссылке.

Что внутри:

  1. MergeTree. Как устроен основной движок: колонки, гранулы и засечки, поиск по первичному индексу, порядок колонок в ключе, слияния, партиции, удаление данных и мутации.

  2. ReplacingMergeTree. Какие строки считаются дублями, какая версия остаётся, почему дубли видны до слияния, зачем FINAL и как удалять строки через is_deleted.

  3. SummingMergeTree. Какие колонки суммируются, как правильно читать сумму, когда строка исчезает, чем опасно переполнение и как хранить среднее.

  4. AggregatingMergeTree. Как хранятся промежуточные состояния агрегации, запись через -State и чтение через -Merge, почему уникальных пользователей и средние нельзя просто сложить и когда хватит SimpleAggregateFunction.

Если нужно собрать шпаргалки по другим темам, пишите в комментариях.

P.S. Систематизировать знания и получить крепкую базу по ClickHouse можно на моем бесплатном курсе «ClickHouse с нуля». 

Теги:
+2
Комментарии0

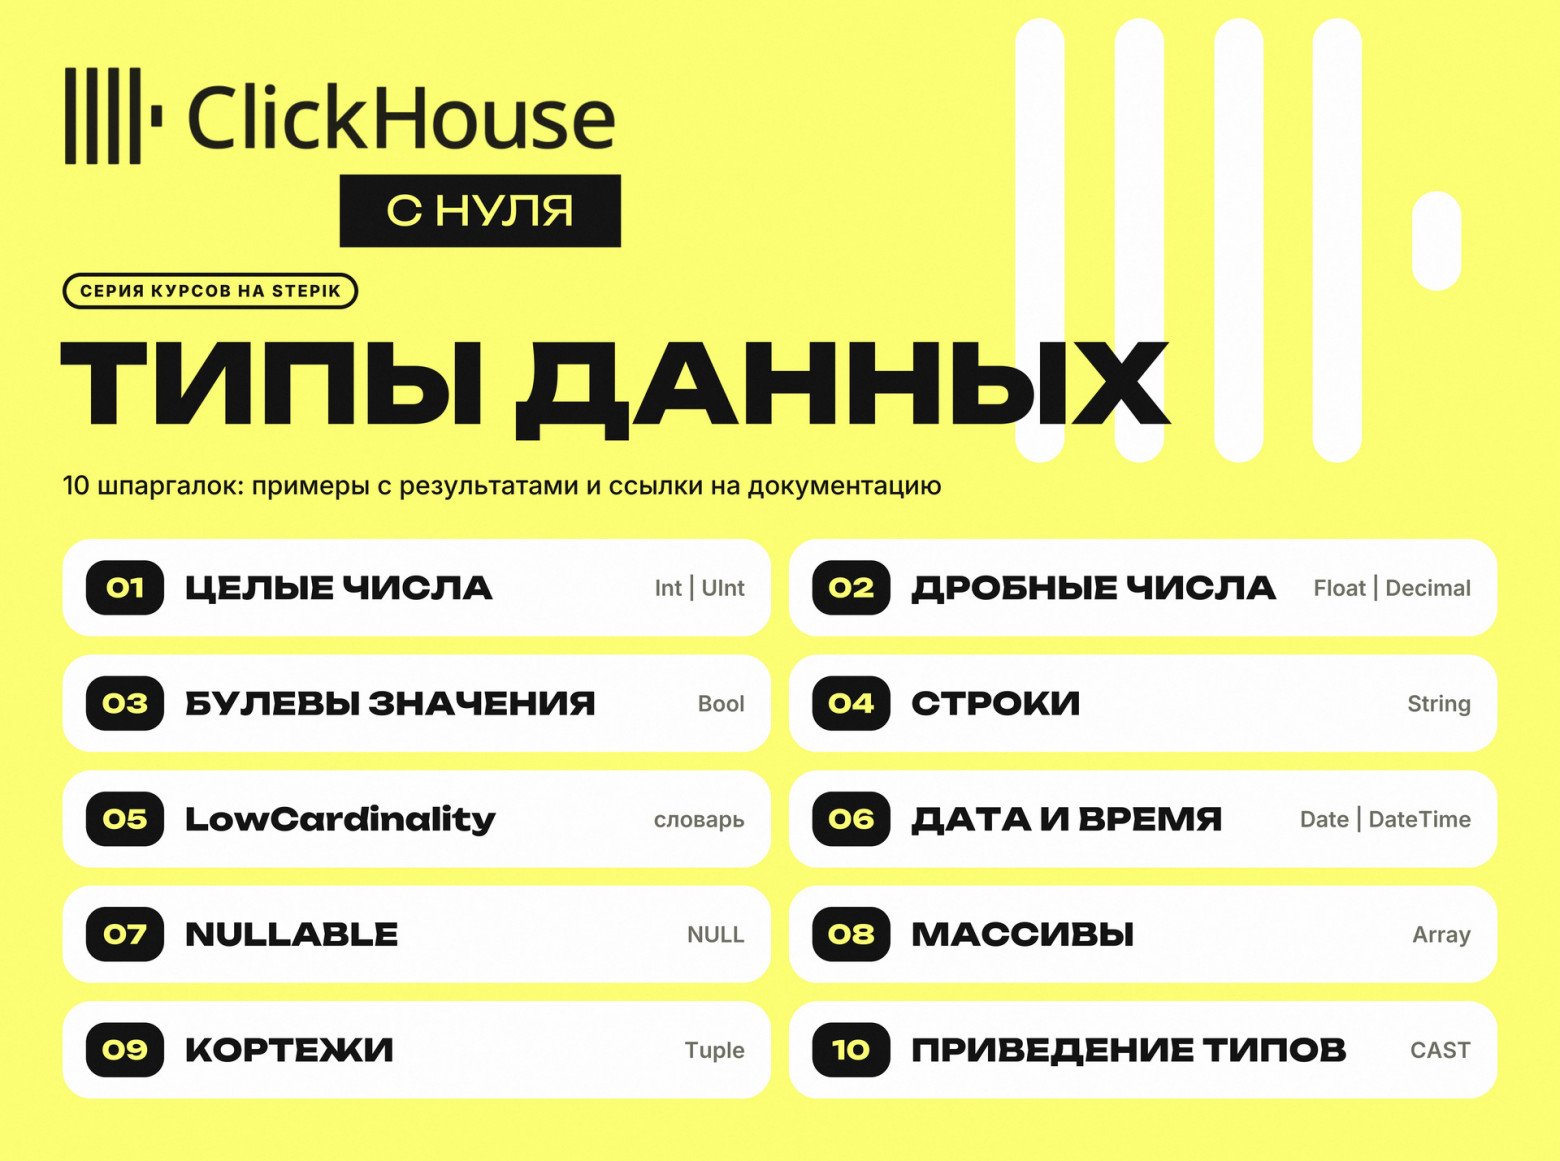
10 шпаргалок по типам данных в ClickHouse

Всем привет! Собрал 10 шпаргалок по типам данных в ClickHouse. В каждой примеры с результатом и разбор мест, где чаще всего ошибаются. Могут быть полезны как в работе так и при подготовке к собеседованиям.

Весь набор можно скачать по ссылке.

Что внутри:

  1. Целые числа. Int и UInt: диапазоны, переполнение, какой тип получится при сложении и вычитании.

  2. Дробные числа. Float и Decimal: почему 0.1 + 0.2 не равно 0.3 и в чём хранить деньги.

  3. Булевы значения. Bool: как хранится, как фильтровать и считать долю true.

  4. Строки. String и FixedString: байты против букв, функции с UTF8, поиск и конкатинация.

  5. LowCardinality. Когда словарное кодирование экономит место в десятки раз, а когда только мешает.

  6. Дата и время. Date, Date32, DateTime и DateTime64: точность, часовые пояса, разница между датами.

  7. Nullable. Как NULL ведёт себя в WHERE, count и сортировке и сколько он стоит.

  8. Массивы. Array: индексы с 1, поиск, groupArray и arrayJoin, лямбды.

  9. Кортежи. Tuple: элементы по номеру и по имени, сравнение, кортеж в колонке.

  10. Приведение типов. CAST, toInt32 и функции OrNull и OrZero.

Если нужно собрать шпаргалки по другим темам, пишите в комментариях.

Теги:
+2
Комментарии6

Всем привет! На досуге хочется поразрабатывать чё-нить, как хобби что ли. Идей просто ноль! Везде этот ЫЫ..политика и т.д. Надо отвлечься.
Не ради денег - ради программирования! Есть у кого смелые идеи?
Вот первое что в голову пришло - напиши, глядишь не только мне поможешь :)

Теги:
0
Комментарии5

Как выбрать только нужные колонки по шаблону, не перечисляя их в SELECT

В прошлом посте я рассказывал про модификатор APPLY, с помощью которого можно применять функцию ко всем колонкам сразу. Сегодня расскажу про еще один мощный инструмент — динамический выбор столбцов с помощью выражения COLUMNS.

Иногда бывают ситуации, когда в таблице десятки или сотни полей, а нам нужны только те, которые, например, начинаются с utm_ или содержат в названии слово id.

В классических базах данных мы бы сидели и вручную перечисляли названия всех нужных колонок в SELECT. В ClickHouse это делается гораздо изящнее.

Чтобы не писать десятки колонок руками, можно использовать выражение COLUMNS('regexp'). Оно автоматически находит и подставляет в выборку все столбцы, названия которых подходят под регулярное выражение.

В качестве примера рассмотрим таблицу traffic, в которой хранятся метки рекламных кампаний и метрики:

┌─utm_source─┬─utm_medium─┬─utm_campaign─┬─clicks─┬─costs─┐
│     google │        cpc │      promo_1 │    150 │    10 │
│     yandex │        cpc │      promo_2 │    200 │    15 │
└────────────┴────────────┴──────────────┴────────┴───────┘

Чтобы выбрать только utm-метки, обычно мы привыкли писать так:

SELECT 
  utm_source, 
  utm_medium, 
  utm_campaign 
FROM traffic

С использованием COLUMNS можно написать гораздо короче:

SELECT COLUMNS('utm') 
FROM traffic

┌─utm_source─┬─utm_medium─┬─utm_campaign─┐
│     google │        cpc │      promo_1 │
│     yandex │        cpc │      promo_2 │
└────────────┴────────────┴──────────────┘

Несколько нюансов:

  1. Внутри скобок пишется регулярное выражение (синтаксис re2). Например, COLUMNS('a') выберет все колонки, в названии которых есть хотя бы одна буква «a».

  2. Выбранные столбцы возвращаются в том порядке, в котором лежат в таблице (а не по алфавиту).

  3. Если регулярному выражению не соответствует ни один столбец, и кроме COLUMNS в SELECT больше ничего нет — ClickHouse выдаст ошибку.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
+1
Комментарии0

«Диасофт» приглашает на День СУБД 2026

27 октября в Кибердоме (Москва) пройдет вторая конференция «Диасофт», посвященная промышленной эксплуатации СУБД.

Почему стоит идти:

🔵 Увидеть сценарий миграции вживую

Демонстрация переноса целевой схемы с MS SQL и Oracle без переписывания кода — на сцене, с реальной консолью, а не на слайдах.

 🔵 Задать вопросы команде разработки

Архитекторы и руководители направлений Digital Q.DataBase ответят лично — без тикетов, SLA и линии поддержки.

 🔵 Забрать готовый чек-лист миграции

Участники получат методику оценки трудоемкости перехода: что считать, где закладывать запас, какие пакеты станут проблемой.

🔵 Поговорить с теми, кто уже завершил миграцию

Три часа нетворкинга с командами, которые прошли переход в 2025-2026 годах. Можно записаться на персональную консультацию прямо в форме.

 О чем поговорим:

  1. Изменение подхода к импортозамещению СУБД: от «заменить любой ценой» — к управляемой миграции.

  2. Национальная СУБД как важный элемент технологического суверенитета – итоги первого полугодия в открытом доступе.

  3. Импортозамещение СУБД в высоконагруженных системах: MPP, шардирование, терабайтные объемы данных.

  4. Кейсы клиентов и партнеров «Диасофт» по переходу на Digital Q.DataBase — с конкретными цифрами и сроками.

  5. Совместимость как продукт: диалекты Oracle и MS SQL, протокол TDS, эмуляция Instant Client.

Digital Q.DataBase — сертифицированная ФСТЭК российская СУБД на ядре PostgreSQL. Встроенная поддержка диалекта и транспортного протокола TDS позволяет перейти с MS SQL без участия разработчиков, поддержка PL/SQL и эмуляция Oracle Instant Client — быстро мигрировать с Oracle. Запись в реестре российского ПО № 15 561, сертификат ФСТЭК по 4-му уровню доверия № 4843.

 ➡️ Зарегистрироваться на мероприятие можно по ссылке

Теги:
+3
Комментарии0

Как применить одну функцию к нескольким колонкам, не перечисляя их в SELECT

В прошлом посте я рассказывал про модификатор REPLACE, с помощью которого можно менять значения «на лету», не перечисляя все колонки в SELECT. Сегодня расскажу про еще один полезный модификатор — APPLY.

Иногда бывают ситуации, когда нам нужно применить одну и ту же функцию сразу к нескольким колонкам (например, посчитать сумму).

В классических транзакционных базах, таких как PostgreSQL, мы бы вручную перечисляли в SELECT абсолютно все поля, которые хотим просуммировать.

В ClickHouse это делается проще.

Чтобы не писать десятки колонок руками, можно использовать модификатор APPLY. Он работает в связке со звездочкой * и автоматически применяет указанную функцию ко всем колонкам в выборке.

В качестве примера рассмотрим таблицу metrics, в которой хранится количество кликов, просмотров и затрат:

┌─clicks─┬─views─┬─spend─┐
│     10 │   100 │    50 │
│     15 │   150 │    70 │
└────────┴───────┴───────┘

Чтобы посчитать сумму по каждому полю обычно мы привыкли писать так:

SELECT
  sum(clicks),
  sum(views),
  sum(spend)
FROM metrics

┌─sum(clicks)┬─sum(views)─┬─sum(spend)─┐
│         25 │        250 │        120 │
└────────────┴────────────┴────────────┘

С использованием APPLY можно написать короче:

SELECT * APPLY(sum) 
FROM metrics

┌─sum(clicks)┬─sum(views)─┬─sum(spend)─┐
│         25 │        250 │        120 │
└────────────┴────────────┴────────────┘

Несколько нюансов:

  1. Правила вызова пишутся в круглых скобках. Синтаксис такой: APPLY(имя_функции) без аргументов.

  2. Передаваемая функция в APPLY должна уметь работать со всеми полями выборки и их типами данных. Например, для sum все поля должны быть числовыми.

  3. Если мы хотим применить sum, но в таблице есть нечисловые типы данных, мы можем исключить их через EXCEPT или выбрать только нужные через модификатор COLUMNS, о котором я расскажу в следующем посте.

  4. APPLY можно использовать не только для агрегации, но и для изменения типов данных. Например, APPLY(toString) быстро переведет все выбранные колонки в строковый формат.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
Всего голосов 3: ↑3 и ↓0+5
Комментарии0

Как менять значения «на лету», не перечисляя все колонки в SELECT

В прошлом посте я рассказывал про модификатор EXCEPT, с помощью которого можно исключить ненужные колонки из выборки. Сегодня расскажу про еще один полезный модификатор — REPLACE.

Возьмем все тот же пример: широкую таблицу, в которой 50 или более колонок. Часто бывают ситуации, когда нам нужно модифицировать значения только в одном-двух полях (например, привести email к нижнему регистру, округлить цену или захешировать данные), а все остальные поля вывести как есть.

В классических транзакционных базах, таких как PostgreSQL, мы бы вручную перечисляли в SELECT абсолютно все поля: и те, которые нужно просто вывести, и те, значения в которых нужно как-то изменить.

В ClickHouse это делается проще.

Чтобы не писать десятки колонок руками, можно использовать модификатор REPLACE. Он работает в связке со звездочкой * и позволяет вывести все поля, заменив значения только в конкретных.

Обычно мы пишем так:

SELECT
  id,
  category,
  user_id,
  -- ... перечисляем десятки остальных колонок руками ...
  LOWER(email) AS email
FROM table

С использованием REPLACE запрос становится короче:

SELECT * REPLACE (LOWER(email) AS email)
FROM table

А если нам надо и исключить колонки, и заменить значения, можно писать EXCEPT и REPLACE вместе:

SELECT * 
    EXCEPT (updated_at) 
    REPLACE (LOWER(email) AS email)
FROM table

Несколько нюансов:

  1. Правила замены пишутся в круглых скобках. Синтаксис такой: (выражение AS имя_существующей_колонки).

  2. Можно изменять сразу несколько колонок, перечислив их через запятую: REPLACE (LOWER(email) AS email, price * 0.85 AS price).

  3. Тип данных колонки в итоговой выборке поменяется, если ваше выражение возвращает новый тип (например, вы заменили число на строку).

Про еще один модификатор расскажу в следующем посте.

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Центр управления СУБД Digital Q.DataBase.
Продолжаю делиться выступлениями с первого сезона ДНЯ СУБД 2026.

Я рассказывал, как мы воспроизводим функциональность MS SQL Server в нашей СУБД Digital Q.DataBase (без переписывания бизнес логики), а мой коллега Илья Лебедев - как воспроизводим возможности Oracle.

Теперь - о том, как всем этим управлять.
Сразу говорю: Инструмент бесплатный.
А серверная часть нашей СУБД тоже бесплатная - до 4 ядер.
По секрету: можем легко дать и больше ядер.

Выкладываю полное видео выступления Андрея Акимова, руководителя команды «Центр управления Digital Q.DataBase». Андрей рассказывает и показывает, как объединить мониторинг, администрирование и диагностику баз данных в одном веб-интерфейсе.

В докладе - возможности продукта, поддержка Digital Q.DataBase и практические задачи администратора БД: проверить состояние баз, отследить рост таблиц и разобраться, почему тормозит запрос, с помощью трассировки сессий.

Видео с тайм-кодамина:
VK
Rutube
Dzen
YouTube

Кстати, второй сезон ДНЯ СУБД уже близко - встречаемся 27 октября. Приходите!

🔹 Бесплатное получение дистрибутива: 
https://database.diasoft.ru/?utm_source=andrei
🔹 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹 MAX: https://max.ru/channel_dqdatabase

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

СУБД, которая понимает диалекты Oracle, MS SQL и PostgreSQL,– без переписывания кода приложений.

Теги:
Всего голосов 12: ↑11 и ↓1+10
Комментарии1

Как исключить ненужные колонки из SELECT *

Когда пишешь SQL-запрос к широким таблицам (где 50 и больше колонок), часто необходимо вывести только конкретные поля исключив ненужные. В стандартном SQL для этого, как правило, приходится вручную перечислять в SELECT все необходимые колонки (например 48 из 50). Ну, либо копировать их список из DDL и удалять лишнее. А если таблица меняется, запрос приходится переписывать.

В ClickHouse можно исключать ненужные колонки проще.

Чтобы не перечислять десятки полей руками, можно использовать модификатор EXCEPT. Он работает в связке со звездочкой и позволяет вывести все колонки, исключив ненужные.

Обычно мы пишем так:

SELECT
  id,
  category,
  user_id,
  -- ... перечисляем остальные колонки руками ...
FROM table

С использованием EXCEPT запрос становится короче:

SELECT * EXCEPT (updated_at)
FROM table

Несколько нюансов:

  1. Исключаемые колонки пишутся в круглых скобках через запятую.

  2. Не путайте модификатор EXCEPT с оператором вычитания множеств.

  3. Модификатор отлично комбинируется с другими модификаторами, например с REPLACE или APPLY (напишу про них в следующих постах).

Ссылка на доку.

Мои статьи по ClickHouse на Хабре.

P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Как перенести приложение с Oracle Forms в веб, сохранив бизнес-логику и привычное поведение экранных форм?

Ранее я уже показывал, как наша СУБД исполняет PL/SQL-код на лету.

Сегодня продолжаем тему: в новом видео разбираем технологию автоматизированного переноса приложений Oracle Forms на Go и демонстрируем её работу на примере тестового приложения.

► Рассказываем, почему замены СУБД недостаточно и что усложняет ручной перенос. Показываем, как из файлов .fmb извлекаются метаданные, SQL и PL/SQL-код, как преобразуются триггеры и как связаны JSON, сервер на Go и браузерный интерфейс.

В представленном решении около 70% работ выполняется автоматически. Оставшаяся часть - адаптация интерфейса и разработка Go-компонентов для конкретных форм.

В практической части Дмитрий Пшеничный из отдела разработки сравнивает исходное и перенесённое приложения: выполнение SQL-запросов, добавление и обновление записей, вызов хранимых процедур и функций, вывод результатов в интерфейс.

Видео также доступно на (в них есть также и таймкоды):
VK
Rutube
Dzen
YouTube

► С 1 сентября 2026 года компания «Диасофт» переходит на новую лицензионную политику СУБД Digital Q.DataBase (до 4-х ядер бесплатно). 

🔹 Бесплатное получение дистрибутива: 
https://database.diasoft.ru/?utm_source=andrei
🔹
 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹
 MAX: https://max.ru/channel_dqdatabase
🔹
 RuDB : https://database.ru

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

СУБД, которая понимает диалекты Oracle, MS SQL и PostgreSQL,– без переписывания кода приложений.

Теги:
Всего голосов 10: ↑10 и ↓0+12
Комментарии0

В этом небольшом видео показываю работу службы отчётности Digital Q.DataBase и поддержку RDL (Report Definition Language) — формата описания отчётов, используемого в Microsoft SQL Server Reporting Services (SSRS).

► При миграции с Microsoft SQL Server одной из сложных задач становится сохранение существующей отчётности. В корпоративных системах могут годами накапливаться сотни и тысячи RDL-отчётов, а их перенос на другой стек способен превратиться в отдельный большой проект.

В СУБД Digital Q.DataBase (которая понимает PL/pgSQL, PL/SQL, T-SQL) реализована совместимость с RDL и привычными механизмами SSRS, чтобы существующие отчёты и интеграции можно было переносить с минимальными изменениями.

🔹 Служба отчётов Digital Q.DataBase
Аналог SQL Server Reporting Services (SSRS).
Поддержка RDL-отчётов.
Формирование отчётов в HTML и PDF.

Видео также доступно на:
VK
RuTube  
Dzen 
YouTube

► С 1 сентября 2026 года компания «Диасофт» переходит на новую лицензионную политику СУБД Digital Q.DataBase (до 4-х ядер бесплатно). 

🔹 Бесплатное получение дистрибутива: 
https://database.diasoft.ru/?utm_source=andrei
🔹
 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹
 MAX: https://max.ru/channel_dqdatabase
🔹
 RuDB : https://database.ru

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

СУБД, которая понимает диалекты Oracle, MS SQL и PostgreSQL,– без переписывания кода приложений.

Теги:
Всего голосов 12: ↑11 и ↓1+11
Комментарии3

Ближайшие события

Digital Q.DataBase 18.2 | Выполняем Oracle-скрипты в DBeaver и qclient

В этом коротком видео я демонстрирую работу модуля Onyx в Digital Q.DataBase и выполнение PL/SQL-скриптов, написанных для Oracle Database.

► В основном примере (через qclient) выполняется полноценный PL/SQL-сценарий: создаётся таблица, объявляются PACKAGE и PACKAGE BODY с процедурами, используется отдельная функция и анонимный PL/SQL-блок.

В скрипте используются характерные для Oracle механизмы: NUMBER, VARCHAR2, CLOB, SYSDATE, DUAL, ADD_MONTHS, а также пакеты DBMS_LOB и DBMS_OUTPUT. Скрипт компилируется и выполняется непосредственно в модуле Onyx.

► Также показываю, что работать с Onyx можно привычным способом через DBeaver. 

Подключаемся к Digital Q.DataBase по характерному для Oracle порту 1521 и прямо из SQL-редактора выполняем обычный PL/SQL-скрипт: создаём таблицу employees_1, хранимую процедуру add_employee_1, вызываем её через CALL и проверяем результат обычным SELECT.

То есть для разработчика работа выглядит привычно: DBeaver, PL/SQL, процедуры, Oracle-типы и Oracle-синтаксис - но исполняется всё в Digital Q.DataBase Onyx.

Это позволяет переносить существующие Oracle-приложения и PL/SQL-код с минимальным объёмом изменений.

При этом для работы с Digital Q.DataBase можно использовать и привычные специалистам по Oracle инструменты: существующие средства администрирования, разработки и подключения могут работать с модулем Onyx через Oracle-совместимый интерфейс и порт 1521.

Видео также доступно на:
VK 
RuTube  
Dzen 
YouTube

► С 1 сентября 2026 года компания «Диасофт» переходит на новую лицензионную политику СУБД Digital Q.DataBase (до 4-х ядер бесплатно). 

🔹 Бесплатное получение дистрибутива: 
https://database.diasoft.ru/?utm_source=andrei
🔹 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹 MAX: https://max.ru/channel_dqdatabase
🔹 RuDB : https://database.ru

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

СУБД, которая понимает диалекты Oracle, MS SQL и PostgreSQL,– без переписывания кода приложений.

Теги:
Всего голосов 10: ↑9 и ↓1+8
Комментарии2

Digital Q.DataBase 18.2 | Выполняем MS SQL скрипты в DBeaver и Python

В этом коротком видео я демонстрирую, как Digital Q.DataBase 18.2 исполняет нативный T-SQL скрипт через DBeaver (в SSMS тоже делает), а также как те же объекты доступны из Python через библиотеку pymssql по протоколу TDS.

► В примере используются GO, SET DATEFORMAT, OBJECT_ID, sys.objects, INFORMATION_SCHEMA, вычисляемые столбцы, хранимые процедуры GetSalesReport и CalculateManagerBonus, а также их вызов из Python с обработкой нескольких наборов результатов.

Видео также доступно на:
VK 
RuTube  
Dzen 
YouTube

► С 1 сентября 2026 года компания «Диасофт» переходит на новую лицензионную политику СУБД Digital Q.DataBase (до 4-х ядер). 

🔹 Бесплатное получение дистрибутива: 
https://database.diasoft.ru/?utm\_source=andrei
🔹
 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹
 MAX: https://max.ru/channel_dqdatabase
🔹
 RuDB : https://database.ru

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

СУБД, которая понимает диалекты Oracle, MS SQL и PostgreSQL,– без переписывания кода приложений.

#DigitalQDataBase #Diasoft #MSSQL

Теги:
Всего голосов 11: ↑11 и ↓0+14
Комментарии4

Привет!
Заметка о правильности названий ETL процессов.Расставим точки над i.
Всегда было же нормально, коротко и звучно ETL. Теперь все чаще мелькает ELT, ETLT, EtLT.

Традиционный паттерн ETL, применяет бизнес-логику во время преобразования, до загрузки в хранилище. Выбрал данные, преобразовал, положил в хранилище. ELT меняет эту последовательность, сначала загружая сырые данные в хранилище, а преобразование выполняет уже внутри. ELT подход сокращает нагрузку на систему источник, позволяет итеративно совершенствовать логику преобразования.

Имеем два противоположных метода.

Но мы то с вами знаем, что на проектах, в жизни оба метода применяются одновременно. Более того, они могут одновременно применяться в одном потоке. Выбрал данные, преобразовал, положил в хранилище на первый уровень, преобразовал и положил на второй уровень.

Например, в потоке выполняется экстракция из базы данных, непосредственно при выборке происходят предварительные преобразования (очистка, изменение типов), далее загрузка в цель - выполнился процесс ETL. Вторым этапом идут бизнес преобразования - процесс T, а вместе ETLT.

Таким образом и получается, что в большинстве случаев используется процесс ETLT, но исторически так сложилось называть все подобные процесcы просто и звучно ETL.
В аббревиатуре первая трансформация обозначается маленькой первой буквой t, и это не случайно. На данном шаге выполняются только предварительные преобразования данных: очистка, приведение типов. А вот уже вторая - это полноценная трансформация: бизнес преобразования, обогащения, расчеты и тд. Еще я встречал проставление индексов к буквам трансформаций ET1LT2.

Так же есть такое понятие как ETL++, но об этом в другой раз :-)

Теги:
Всего голосов 2: ↑1 и ↓1+2
Комментарии0

В Steam анонсирован к скорому выходу игровой квест Ghost in the SQL Data, где нужно распутывать дела через SQL-запросы и копания в базах данных с уликами. Игра проверяет результаты запросов, а не просто ключевые слова. В ходе выполнения заданий в Ghost in the SQL Data игра сама постепенно учит языку, так что начинать можно вообще без знаний SQL. Дела будут разные: поджоги, смерти, пропавшие деньги и другие преступления.

Визуально Ghost in the SQL Data выполнена в стилистике физической доски с уликами: газетные вырезки, бумажные заметки, малярный скотч, кнопки, красные нити, маркерные пометки и фотографии на клетчатой бумаге. При этом разработчики подчёркивают, что это не просто стилизация — основная механика действительно построена вокруг работы с базами данных и написания SQL-кода.

Теги:
Всего голосов 4: ↑4 и ↓0+6
Комментарии1

10 августа я провёл вебинар, посвящённый новым возможностям Digital Q.DataBase 18.2 - СУБД + AI в Digital Q.DataBase

В программе:

🔹 Развитие полиглотной платформы единая платформа для PostgreSQL, Microsoft SQL Server и Oracle; новые возможности совместимости;
🔹 Новые возможности RuDB новые пакеты; развитие функциональности;
🔹 ИИ и векторный поиск поддержка векторных операций;
🔹 KV-хранилище DGrid развитие встроенного KV-хранилища; архитектура решения;

► Бесплатная полнофункциональная версия дистрибутива (до 8 ядер) с возможностью использования в том числе в коммерческих целях.

► С 1 сентября 2026 года компания «Диасофт» переходит на новую лицензионную политику СУБД Digital Q.DataBase (до 4-х ядер). 

🔹 Бесплатное получение дистрибутива: 
https://database.diasoft.ru/?utm\_source=andrei
🔹 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹 MAX: https://max.ru/channel_dqdatabase
🔹 RuDB : https://database.ru

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

Запись вебинара доступна на следующих площадках:

RuTube
Dzen
YouTube
VK

#DigitalQDataBase #Diasoft #PostgreSQL #AI #Импортозамещение

Теги:
Всего голосов 10: ↑9 и ↓1+8
Комментарии0

Как redb хранит сложные объекты: не бесхемная свалка, а RTTI

Про redb (RedBase) есть два зеркальных заблуждения. Первое: раз объект пишется «как документ», внутри лежит сериализованный JSON или блоб. Второе, противоположное: раз всё падает в общую таблицу значений — значит это плоский мешок пар «ключ-значение» без схемы.

Оба мимо. То, что внутри — это RTTI, полноценная система типов, живущая в самой базе. И устроена она заметно сложнее, чем и блоб, и «атрибут-значение». Разбор архитектуры я подробно давал в отдельной статье на Хабре: «redb: реляционное хранилище объектов» — ниже сжатая суть.

Слой типов: база знает настоящий тип каждого поля

redb хранит не только данные, но и их описание типов — три связанных уровня:

  • types — реальные дескрипторы типов (db_type и соответствие .NET-типу);

  • _schemes — сами типы (классы), с поддержкой наследования через self-reference;

  • structures — типизированные поля схемы: имя (name), тип (_id_type, FK на types), признак коллекции (collection_type) и вложенность (_id_parent).

Значения в values всегда привязаны к конкретной структуре (id_structure, FK на structures). Поэтому строка values — это не безымянная пара «атрибут-значение»: это значение известного, именованного, типизированного, возможно вложенного поля известного класса. База в рантайме знает, что перед ней — decimal Salary в схеме Employee, а не абстрактный «атрибут №42». Это и есть RTTI.

Хранение коллекций: построчно, реляционно

Вложенные массивы, словари и глубокие иерархии redb раскладывает в _values построчно, а не строкой:

  • Никаких JSON-блобов на диске. Каждый элемент коллекции — отдельная строка с типизированными колонками (_value_long, valuestring, valuedatetime, valueguid, …), внешними ключами и обычными индексами.

  • Связь и порядок — реляционные. Вложенность собирается self-reference колонкой arrayparent_id (FK на values.id, ON DELETE CASCADE). Порядок массива и ключи словаря — в arrayindex (text: '0','1','2' для массивов, строковый ключ — для словарей).

  • Один элемент — одна строка. List<OrderItem> внутри класса не превращается ни в JSON-поле, ни в десяток физических таблиц, которые вы заводите руками.

Что это даёт на практике

  1. Честный LINQ на уровне СУБД. Данные лежат в типизированных колонках, а метаданные структур позволяют движку собрать нативный SQL: Where / OrderBy / GroupBy / оконные функции идут по реальным индексам базы, а не перебором JSON в памяти бэкенда.

  2. Загрузка за один запрос без каскада JOIN-ов. Чтобы поднять объект со всей глубиной вложенности (пусть там 20–30 списков), не нужен каскад JOIN, как у EF с .Include(). Плоская структура забирается из _values одним запросом и собирается в объект в памяти.

  3. Точечный Change Tracking (Pro). При сохранении Pro-версия строит деревья ValueTreeNode (память против БД), сравнивает их (ValueTreeBuilder / ValueTreeDiff) и шлёт UPDATE только по изменившимся узлам — граф целиком не перезаписывается.

Итог: redb совмещает удобство работы с объектами «как с документами» и фундамент реляционной СУБД — типизацию, индексы, FK и запросы, которые исполняет база, а не бэкенд. Ключ к этому — не блоб и не плоский мешок атрибутов, а persisted-RTTI: types → schemes → structures → values.

Ссылки

Теги:
Всего голосов 2: ↑2 и ↓0+4
Комментарии0

Информационные технологии. Проблемы и решения – IT'DAYS

Сегодня всё чаще говорят: импортозамещение заканчивается там, где начинается переписывание миллионов строк бизнес-логики.

Именно поэтому всё больший интерес вызывают полиглотные СУБД, которые позволяют заменить СУБД, а не приложение, сохранив привычные языки программирования и существующую бизнес-логику.

Digital Q.DataBase — именно такая СУБД. Она воспроизводит функциональные возможности Microsoft SQL Server и Oracle Database, позволяя существенно сократить объём доработок существующих информационных систем при миграции.

Отличный повод вспомнить моё выступление на международной конференции «Информационные технологии. Проблемы и решения – IT'DAYS» в Уфе.

► Бесплатная полнофункциональная версия дистрибутива (до 8 ядер) с возможностью использования в том числе в коммерческих целях.

🔹 Бесплатное получение дистрибутива: https://database.diasoft.ru/?utm\_source=andrei
🔹 Документация: доступна внутри дистрибутива
🔹 Telegram-сообщество Digital Q.DataBase: https://t.me/dqdatabase
🔹 MAX: https://max.ru/channel_dqdatabase
🔹 RuDB : https://database.ru

Подписывайтесь на наши сообщества, чтобы получать новости, технические материалы и информацию о новых вебинарах.

Теги:
Всего голосов 9: ↑7 и ↓2+5
Комментарии5