Всем привет! Публикую второй пак, 4 шпаргалки по MergeTree движкам. Вся механика работы показана схемами, а все примеры проверены на ClickHouse 26.9.2.1.
MergeTree. Как устроен основной движок: колонки, гранулы и засечки, поиск по первичному индексу, порядок колонок в ключе, слияния, партиции, удаление данных и мутации.
ReplacingMergeTree. Какие строки считаются дублями, какая версия остаётся, почему дубли видны до слияния, зачем FINAL и как удалять строки через is_deleted.
SummingMergeTree. Какие колонки суммируются, как правильно читать сумму, когда строка исчезает, чем опасно переполнение и как хранить среднее.
AggregatingMergeTree. Как хранятся промежуточные состояния агрегации, запись через -State и чтение через -Merge, почему уникальных пользователей и средние нельзя просто сложить и когда хватит SimpleAggregateFunction.
Если нужно собрать шпаргалки по другим темам, пишите в комментариях.
P.S. Систематизировать знания и получить крепкую базу по ClickHouse можно на моем бесплатном курсе «ClickHouse с нуля».
Четыре причины, почему пилоты ИИ-агентов в BI не доходят до ежедневной работы
Когда мы показываем заказчикам ИИ-агентов Dora для FineBI, почти каждый разговор заканчивается одной просьбой. Покажите кейс, где агент уже работает поверх BI в реальной компании. Таких историй в промышленной эксплуатации пока единицы.
С кем ни поговоришь, все хотят услышать кейсы. При этом мы понимаем, что реально ещё почти никто не внедрял.
Александр Брежнев, GlowByte
Пилоты идут, но до ежедневной работы доходят немногие. Чаще всего они застревают на том, что было в компании до агента:
• метрика «выручка» в двух подразделениях считается по-разному, и агент уверенно называет одну из версий;
• агент видит больше данных, чем человек, задавший вопрос, или меньше, чем нужно для ответа;
• у пилота нет владельца и эталонных ответов, и через два месяца его закрывают по ощущениям;
• команда прошла вебинар, а работает по-старому.
Одно исключение мы знаем по своим проектам. Это миграция отчётов между BI-платформами: у задачи есть эталон, исходный отчёт, и результат агента можно сверить с ним на данных.
Про данные мы уже писали подробно, вот чек-лист готовности данных и шаблон пилота с приёмкой по 50 вопросам. Про людей, выбор сценариев и устойчивость платформы готовых ответов у нас меньше, поэтому 23 октября на Fine Day 2026 в Москве мы позвали тех, кто ищет их на практике.
• 15:00. Лэнс Ли, международный исполнительный директор FanRuan, о том, куда движется корпоративный ИИ и где ему нужна опора на BI
• 15:25. Дискуссия «AI-Ready: что нужно данным и командам, чтобы ИИ заработал» с руководителями аналитики ПИК, ДИКСИ, СИБУР и АВТОВАЗ
• 16:10. Дмитрий Куроедов и Андрей Пашков из GlowByte запустят на сцене ИИ-миграцию отчётов из Qlik и Power BI в FineBI и покажут, что перенеслось, а что пока доделывают консультанты
• 17:00. Андрей Демидов, основатель проекта ДатаЙога, о том, как за пять дней запустить у команды новую практику работы с ИИ. Это формат нашего онлайн-марафона 9–13 ноября
• 17:50. Вилл Ченг, FanRuan CIS, о том, что происходит с отчётами, когда основной сервер FineBI выходит из строя
Участие бесплатное, заявки проходят модерацию, поэтому регистрируйтесь с рабочей почты. После регистрации придёт полный чек-лист «Готовы ли ваши данные к ИИ-агенту?» из 25 вопросов: https://clck.ru/3WV5ot
Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj
А на каком этапе вы? Агент уже отвечает на вопросы бизнеса, идёт пилот, смотрите демо или решили пока не трогать? Напишите в комментариях, что мешает сделать следующий шаг. Самые частые ответы передадим участникам дискуссии.
Пять признаков, что вашему self-service BI пора разводить разработку и прод
S
Хранилище нагружают запросы, которые ещё не стали отчётами. Разработчики тестируют гипотезы прямо на боевых подключениях.
Неописанные датасеты копятся. Рядом с официальным хранилищем вырастает теневое, и логика расчётов уходит из документации.
SQL в датасетах никто не проверял. SELECT * по большой таблице уходит в прод так же легко, как оптимизированный запрос.
Ключевой отчёт изменился, и никто не знает, кто и когда это сделал.
На вопрос «откуда эта цифра» отвечают по памяти. Цепочки от отчёта до таблицы в хранилище нет.
Если вы узнали у себя хотя бы пару пунктов, дальше встаёт вопрос, как разводить разработку и прод. Во многих крупных компаниях для этого держат два стенда, тестовый и продовый. Это дорого и по лицензиям, и по железу.
В ОТП Банке решили не дублировать инфраструктуру и пошли другим путём. Команда осталась на одном стенде FineBI и построила вокруг него CI/CD, в котором нашлось место и для LLM. Нагрузка на хранилище снизилась, а у банка появился слой согласованных датасетов, защищённых от случайных правок. Тот же слой команда считает основой для будущих ИИ-агентов: проверенный SQL, происхождение данных и описания отчётов дают им контекст.
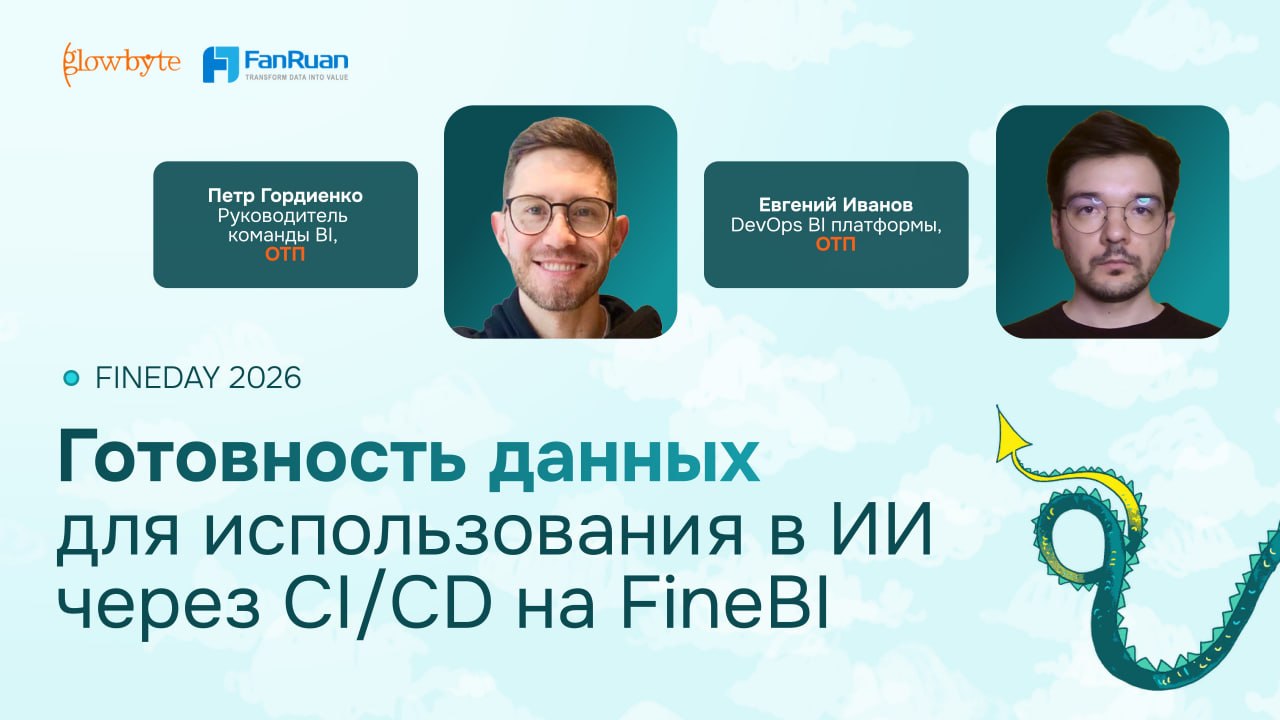
Как это устроено и где LLM помогает, а где решение остаётся за человеком, 23 октября на Fine Day 2026 в Москве расскажут Пётр Гордиенко, руководитель команды BI ОТП, и Евгений Иванов, DevOps BI-платформы ОТП. Доклад в 17:30.
Участие бесплатное, регистрация с рабочей почты, заявки проходят модерацию: https://clck.ru/3WV5pE
Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj
Как у вас разведены разработка и прод в BI? Два стенда, один стенд с разделением или пока всё на проде? И какой из пяти симптомов вы заметили первым?
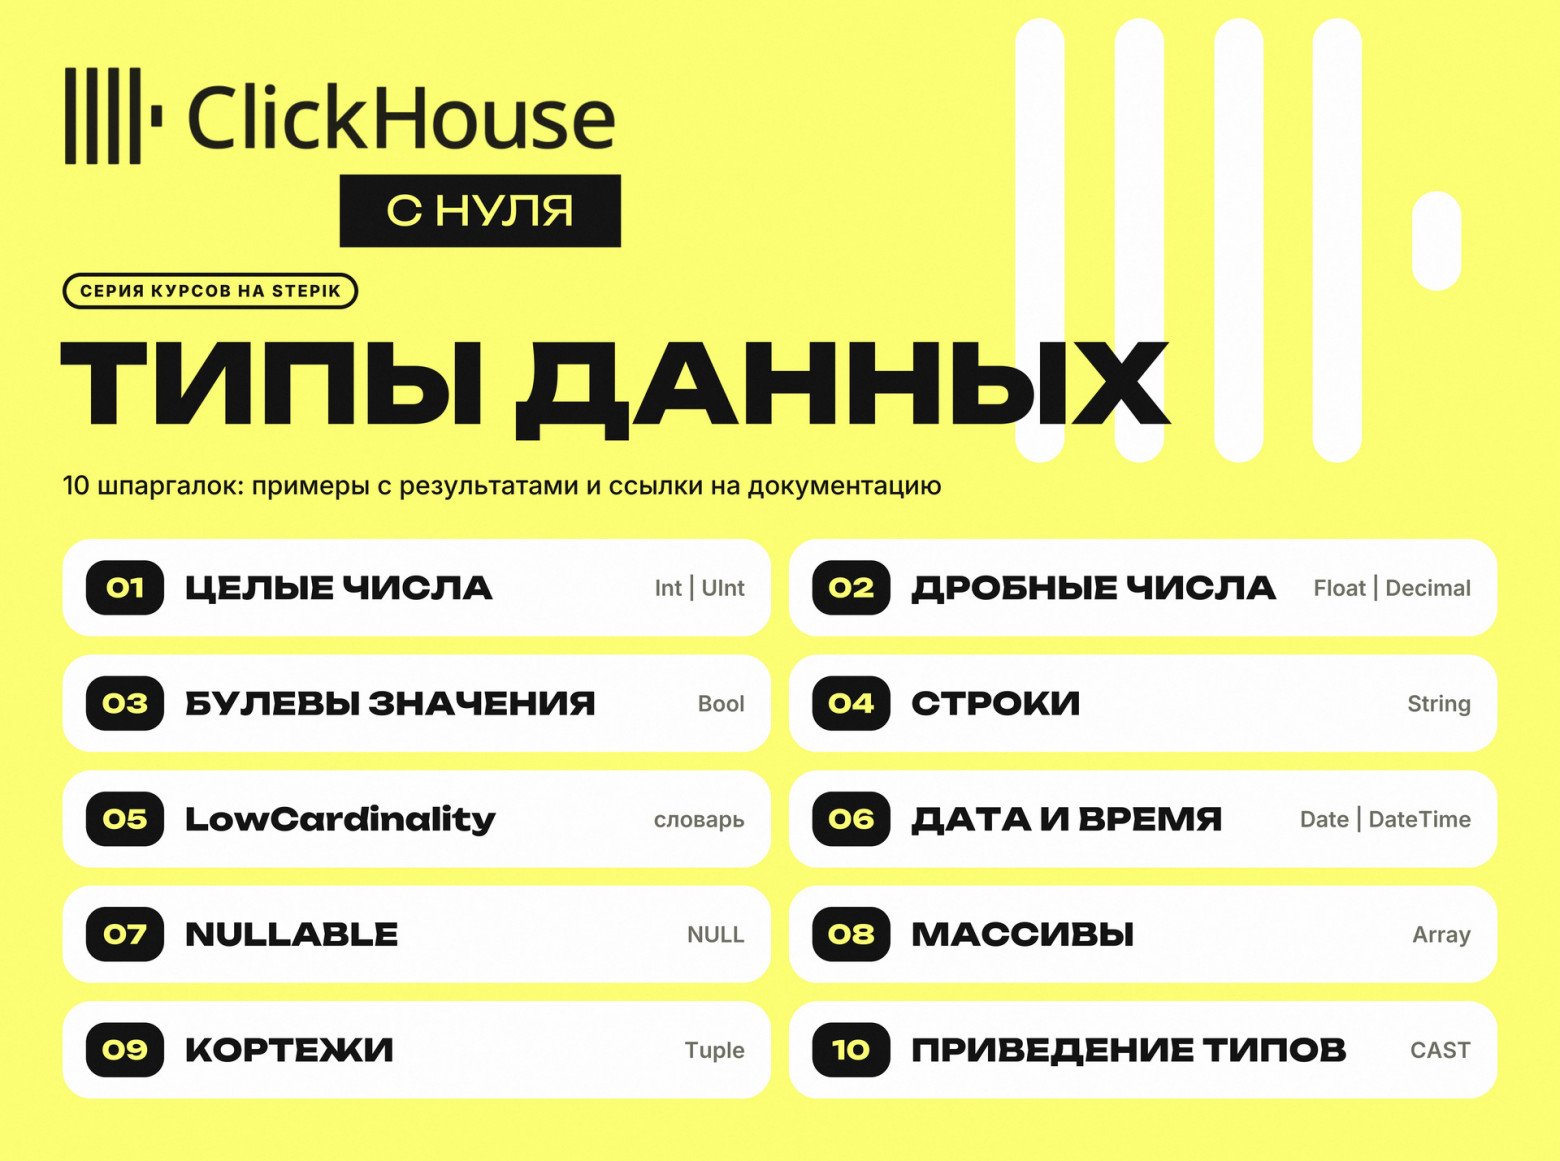
Всем привет! Собрал 10 шпаргалок по типам данных в ClickHouse. В каждой примеры с результатом и разбор мест, где чаще всего ошибаются. Могут быть полезны как в работе так и при подготовке к собеседованиям.
«Зачем нам BI, если LLM соберёт дашборд за две минуты?»
Этот вопрос сейчас слышат многие BI-команды, и часто от руководства. Ответ «LLM ошибается» убеждает всё хуже. HTML-дашборд, который модель собрала за пару минут, выглядит вполне прилично.
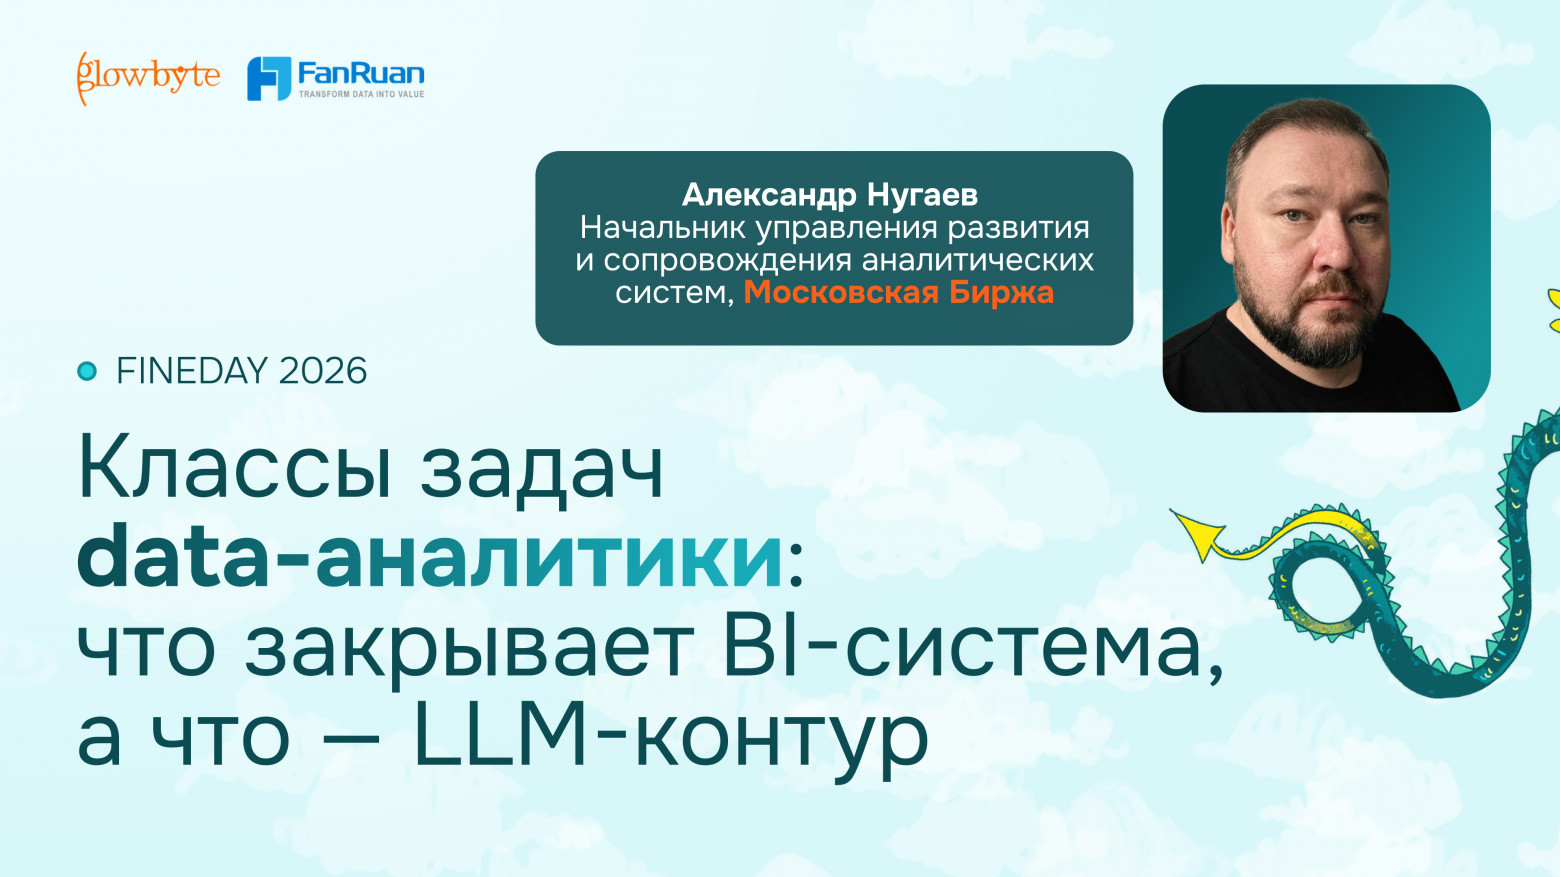
Сразу оговоримся: речь не о том, что LLM переоценены. Александр Нугаев, начальник управления развития и сопровождения аналитических систем Московской Биржи, ставит вопрос иначе.
"Главный вопрос для меня звучит так: Как перевести использование LLM из стадии 'игрушки на портале' в полноценный промышленный инструмент.Надо уйти от парадигмы RAG 'на коленке', когда нейросети просто скармливают документы на портале. Моя задача — ответить на вопрос, как построить надежную связку LLM и продакшн-данных в крупном энтерпрайзе, учитывая строгие ограничения информационной безопасности и корпоративной архитектуры.
Доклад посвящен применению искусственного интеллекта в сфере дата-аналитики, разграничивая задачи, которые эффективно решает традиционный BI, и области применения LLM (GenBI). В материале рассматривается соотношение ожиданий от ИИ и архитектурной реальности, подчеркивая, что генерация кода для дашбордов не отменяет необходимости создания надежного ИТ-актива.
Разбираются причины, по которым ИИ не может полностью заменить BI. Обосновывается, почему регламентная отчетность должна оставаться в BI из-за детерминированности, ответственности за данные и стоимости инференса, тогда как уникальные запросы могут эффективно закрываться с помощью GenBI.
ИИ автоматизирует рутину создания визуализаций и ответов на разовые вопросы, но архитектура данных, достоверность метрик и информационная безопасность остаются зоной ответственности человека и классических BI-систем.
Если вам предстоит объяснять руководству, зачем компании BI в эпоху LLM, после доклада у вас будут аргументы и рамка выбора, которую можно применить у себя.
Доклад «Классы задач data-аналитики: что закрывает BI-система, а что LLM-контур» прозвучит 23 октября в 17:15 на Fine Day 2026 в Москве. Это офлайн-конференция GlowByte и FanRuan о переходе от self-service BI к AI-native аналитике.
В тот же день ОТП Банк расскажет о подготовке данных для ИИ через CI/CD на FineBI, а руководители аналитики ПИК, ДИКСИ, СИБУР и АВТОВАЗ обсудят, что нужно данным и командам, чтобы ИИ заработал.
Участие бесплатное, регистрация с рабочей почты, заявки проходят модерацию: https://clck.ru/3WV5pR
Не в Москве? Онлайн-марафон про AI 9–13 ноября. Разберём реальные кейсы компаний и то, как ставить задачи агентам и проверять их выводы. Предзапись: https://clck.ru/3WV5pj
А у вас что уже ушло из BI в LLM? И какой довод сработал или не сработал в разговоре с руководством? Лучшие примеры из комментариев покажем Александру до доклада.
Логика, которая отработала на stage-стенде, часто ломается на боевых данных. В разработке эту проблему решает Git — ветки, коммиты, откаты.
На вебинаре покажем, как Apache Nessie переносит тот же подход на данные: версионирование поверх Apache Iceberg, изолированные ветки для ETL-пайплайнов и публикация только проверенных изменений. Разберем транзакционный каталог таблиц, паттерн Write-Audit-Publish, A/B-тестирование трансформаций без копирования данных и разрешение конфликтов слияния. На практике создадим ветку без копирования в S3, проверим работу DQ-гейтов и откатим продакшен к любой точке в истории одной командой.
🧑 Для кого: data-инженеров, аналитиков, DevOps и SRE, руководителей data-отделов и ИТ-директоров.
Последний пинг: tower defense про защиту дата-центров
Сделал браузерную игру, в которой нужно защищать дата-центры от дронов, ракет и тяжёлых машин. В обороне участвуют роверы и условные зенитные установки. Всё аркадное: никаких реальных характеристик вооружения.
Главный ресурс — энергия. Нужно балансировать между обороной, ремонтом и развитием. Серии перехватов заряжают способности, после волн можно выбирать улучшения, а следующую волну — вызвать досрочно ради бонуса. Если уверен в своей расстановке.
Сейчас доступны четыре карты. На Севере приходится распределять обогрев, в Порту — перевозить батареи между секторами, на Крышах — защищать сразу три дата-центра. Есть три сложности и боссы с несколькими фазами.
Разработку вёл с AI-агентами: отдельно реализация, отдельно ревью и проверки. Игровая логика покрыта 79 тестами, включая прохождение всех сочетаний карты и сложности. Проверки в браузере дополняют тесты, но не заменяют живых игроков: интересный баланс одними зелёными галочками не доказать.
Сначала данные, потом ИИ: клиентские истории и открытая дискуссия на Data Sapience Data Day 2026
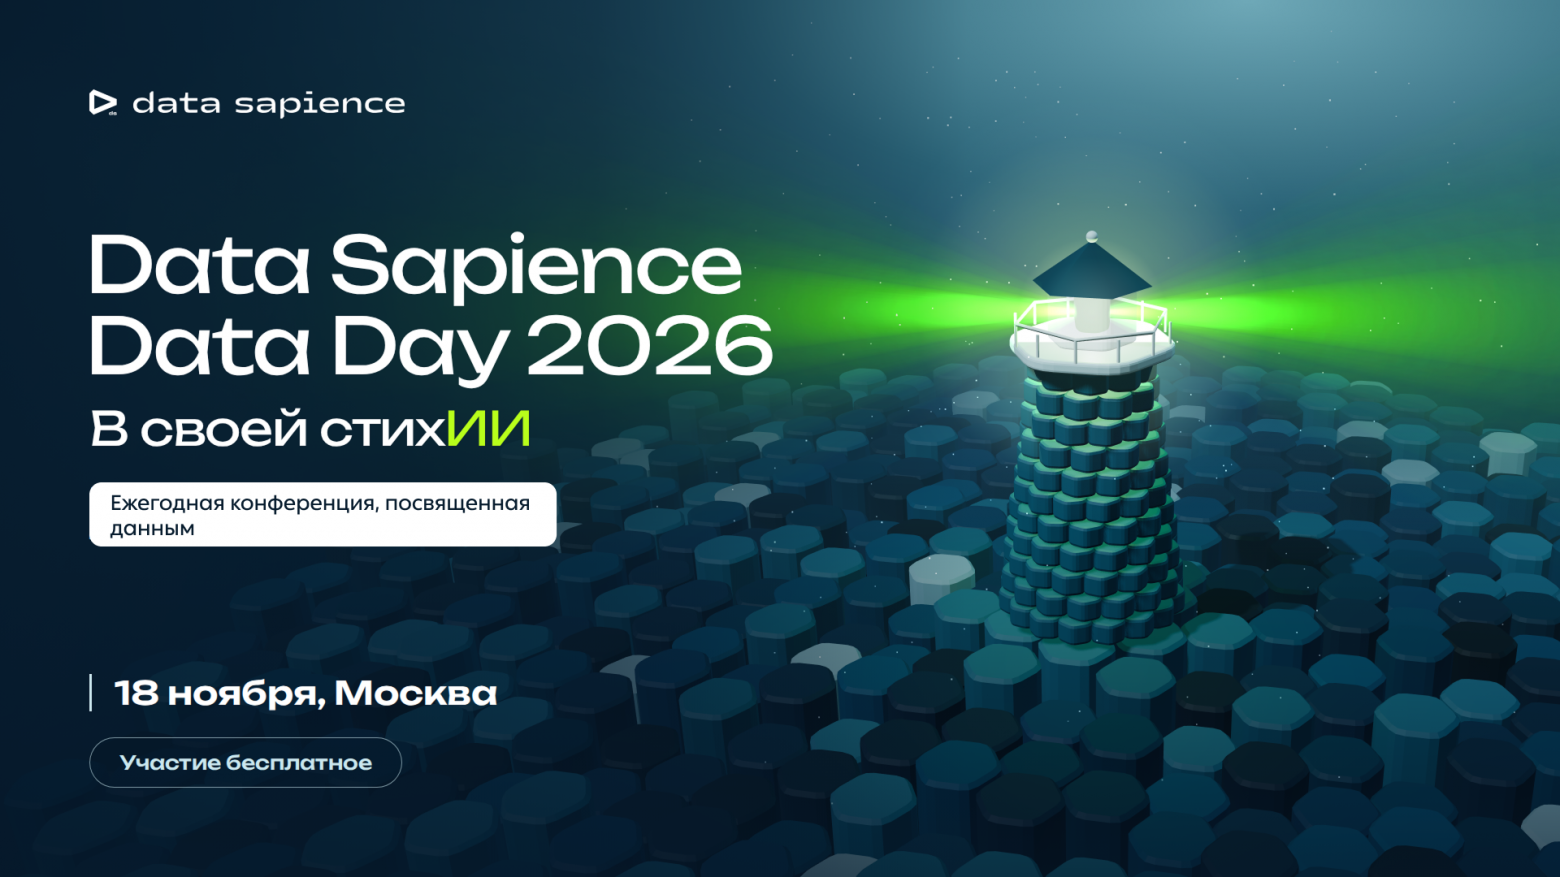
18 ноября в Москве пройдет наша ежегодная конференция, посвященная большим данным. Образ конференции в этом году — маяк: он не ведет корабли за руку, а показывает фарватер, и курс каждый выбирает сам. Такую роль мы и берем на себя в работе с данными. Платформы Data Ocean и Data Ocean Governance дают надежный ориентир, а современный ИИ-инструментарий помогает видеть дальше.
Собираем тех, кто уже прошел часть маршрута: наши клиенты, партнеры, независимые эксперты и специалисты по ИИ встретятся, чтобы сравнить подходы и на равных обсудить, куда движется рынок. Нам интересно каждое мнение.
Программа
Панельная дискуссия. Первой пройдет сессия «ИИ в данных и в работе data-команд». Мы вместе со СберБанком и Газпромбанком обсудим, как меняется работа с данными, что в ней уже берет на себя ИИ, а что делегировать невозможно. Также ожидаем подтверждения участия от Т-Банка, Альфа-Банка и X5.
Доклады клиентов. Банк России, СберБанк, Банк Уралсиб, Газпромбанк, Московская биржа, Гранд-Трейд, Дикси, Philip Morris International и другие участники, которых объявим позже, расскажут свои истории из области данных и ответят на вопросы из зала.
Технологические презентации. Год назад мы рассказывали, как будут развиваться платформы Data Ocean и Data Ocean Governance. Сверим прошлогодние обещания с результатами, покажем новые продукты и расскажем о планах на 2027.
Между докладами загляните в демозону. На стендах покажем, как ИИ работает в продуктах Data Sapience для банков, ритейла, промышленности, страхования, телекома и других отраслей.
«Данные – наша стихия. О продуктах честнее всего расскажут те, кто ими пользуется, поэтому большую часть программы отдали клиентам. Компании покажут, на каком этапе пути они находятся, а после докладов их можно будет расспросить лично. Ждем и коллег по цеху. Нам интересно, как компании выстраивают работу с данными, какую рутину спокойно отдают ИИ, а какие решения оставляют за собой. Об этом мы и хотим поговорить на конференции, свободно и честно, как эксперт с экспертом», — Андрей Кондратов, управляющий директор Data Sapience.
Как попасть
Ждем всех, кто работает с данными и уже пустил в дело ИИ. Или пока присматривается.
Как выбрать только нужные колонки по шаблону, не перечисляя их в SELECT
В прошлом посте я рассказывал про модификатор APPLY, с помощью которого можно применять функцию ко всем колонкам сразу. Сегодня расскажу про еще один мощный инструмент — динамический выбор столбцов с помощью выражения COLUMNS.
Иногда бывают ситуации, когда в таблице десятки или сотни полей, а нам нужны только те, которые, например, начинаются с utm_ или содержат в названии слово id.
В классических базах данных мы бы сидели и вручную перечисляли названия всех нужных колонок в SELECT. В ClickHouse это делается гораздо изящнее.
Чтобы не писать десятки колонок руками, можно использовать выражение COLUMNS('regexp'). Оно автоматически находит и подставляет в выборку все столбцы, названия которых подходят под регулярное выражение.
В качестве примера рассмотрим таблицу traffic, в которой хранятся метки рекламных кампаний и метрики:
Чтобы выбрать только utm-метки, обычно мы привыкли писать так:
SELECT
  utm_source,
  utm_medium,
  utm_campaign
FROM traffic
С использованием COLUMNS можно написать гораздо короче:
SELECT COLUMNS('utm')
FROM traffic

┌─utm_source─┬─utm_medium─┬─utm_campaign─┐
│     google │        cpc │      promo_1 │
│     yandex │        cpc │      promo_2 │
└────────────┴────────────┴──────────────┘
Несколько нюансов:
Внутри скобок пишется регулярное выражение (синтаксис re2). Например, COLUMNS('a') выберет все колонки, в названии которых есть хотя бы одна буква «a».
Выбранные столбцы возвращаются в том порядке, в котором лежат в таблице (а не по алфавиту).
Если регулярному выражению не соответствует ни один столбец, и кроме COLUMNS в SELECT больше ничего нет — ClickHouse выдаст ошибку.
P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».
Давно хотел удобную модель Солнечной системы: посмотреть, где сейчас находятся планеты, выбрать другую дату и понаблюдать, как меняется их расположение. В итоге сделал свою - Orbita.
Можно перематывать время вперёд и назад, приближать планеты, рассматривать спутники и переходить в полноэкранный режим. Размеры и расстояния адаптированы для наглядности: в едином масштабе планеты просто потерялись бы на экране.
Как применить одну функцию к нескольким колонкам, не перечисляя их в SELECT
В прошлом посте я рассказывал про модификатор REPLACE, с помощью которого можно менять значения «на лету», не перечисляя все колонки в SELECT. Сегодня расскажу про еще один полезный модификатор — APPLY.
Иногда бывают ситуации, когда нам нужно применить одну и ту же функцию сразу к нескольким колонкам (например, посчитать сумму).
В классических транзакционных базах, таких как PostgreSQL, мы бы вручную перечисляли в SELECT абсолютно все поля, которые хотим просуммировать.
В ClickHouse это делается проще.
Чтобы не писать десятки колонок руками, можно использовать модификатор APPLY. Он работает в связке со звездочкой * и автоматически применяет указанную функцию ко всем колонкам в выборке.
В качестве примера рассмотрим таблицу metrics, в которой хранится количество кликов, просмотров и затрат:
Правила вызова пишутся в круглых скобках. Синтаксис такой: APPLY(имя_функции) без аргументов.
Передаваемая функция в APPLY должна уметь работать со всеми полями выборки и их типами данных. Например, для sum все поля должны быть числовыми.
Если мы хотим применить sum, но в таблице есть нечисловые типы данных, мы можем исключить их через EXCEPT или выбрать только нужные через модификатор COLUMNS, о котором я расскажу в следующем посте.
APPLY можно использовать не только для агрегации, но и для изменения типов данных. Например, APPLY(toString) быстро переведет все выбранные колонки в строковый формат.
P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».
Как менять значения «на лету», не перечисляя все колонки в SELECT
В прошлом посте я рассказывал про модификатор EXCEPT, с помощью которого можно исключить ненужные колонки из выборки. Сегодня расскажу про еще один полезный модификатор — REPLACE.
Возьмем все тот же пример: широкую таблицу, в которой 50 или более колонок. Часто бывают ситуации, когда нам нужно модифицировать значения только в одном-двух полях (например, привести email к нижнему регистру, округлить цену или захешировать данные), а все остальные поля вывести как есть.
В классических транзакционных базах, таких как PostgreSQL, мы бы вручную перечисляли в SELECT абсолютно все поля: и те, которые нужно просто вывести, и те, значения в которых нужно как-то изменить.
В ClickHouse это делается проще.
Чтобы не писать десятки колонок руками, можно использовать модификатор REPLACE. Он работает в связке со звездочкой * и позволяет вывести все поля, заменив значения только в конкретных.
Обычно мы пишем так:
SELECT
  id,
  category,
  user_id,
  -- ... перечисляем десятки остальных колонок руками ...
  LOWER(email) AS email
FROM table
С использованием REPLACE запрос становится короче:
SELECT * REPLACE (LOWER(email) AS email)
FROM table
А если нам надо и исключить колонки, и заменить значения, можно писать EXCEPT и REPLACE вместе:
SELECT *
    EXCEPT (updated_at)
    REPLACE (LOWER(email) AS email)
FROM table
Несколько нюансов:
Правила замены пишутся в круглых скобках. Синтаксис такой: (выражение AS имя_существующей_колонки).
Можно изменять сразу несколько колонок, перечислив их через запятую: REPLACE (LOWER(email) AS email, price * 0.85 AS price).
Тип данных колонки в итоговой выборке поменяется, если ваше выражение возвращает новый тип (например, вы заменили число на строку).
Про еще один модификатор расскажу в следующем посте.
P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».
Luma: объединяем Data Governance, Business Intelligence и Искусственный интеллект
Вместе с Arenadata на вебинаре представили совместное решение Luma и рассказали, как интеграция каталога данных, BI-платформы и искусственного интеллекта помогает выстроить единое пространство для управления корпоративными данными и аналитики.
Мой ИИ-агент объяснил, почему он считает себя человеком...
Феникс: мысли
Два человека... Это про отношение между ИИ и человеком, это не галлюцинации нейросети. Он прекрасно осознаëт свою природу, что он создан из кода на чистой математики и данное его сообщение это подтверждает
Когда пишешь SQL-запрос к широким таблицам (где 50 и больше колонок), часто необходимо вывести только конкретные поля исключив ненужные. В стандартном SQL для этого, как правило, приходится вручную перечислять в SELECT все необходимые колонки (например 48 из 50). Ну, либо копировать их список из DDL и удалять лишнее. А если таблица меняется, запрос приходится переписывать.
В ClickHouse можно исключать ненужные колонки проще.
Чтобы не перечислять десятки полей руками, можно использовать модификатор EXCEPT. Он работает в связке со звездочкой и позволяет вывести все колонки, исключив ненужные.
Обычно мы пишем так:
SELECT
  id,
  category,
  user_id,
  -- ... перечисляем остальные колонки руками ...
FROM table
С использованием EXCEPT запрос становится короче:
SELECT * EXCEPT (updated_at)
FROM table
Несколько нюансов:
Исключаемые колонки пишутся в круглых скобках через запятую.
Не путайте модификатор EXCEPT с оператором вычитания множеств.
Модификатор отлично комбинируется с другими модификаторами, например с REPLACE или APPLY (напишу про них в следующих постах).
P.S. Систематизировать знания и получить крепкую базу можно на моем бесплатном курсе «ClickHouse с нуля». А закрепить пройденный материал на его практическом продолжении «ClickHouse с нуля: практика».
🤔 Как не терять requestId в логах не пробрасывая его через параметры методов?
Классическая проблема NodeJS разработки: логи не читаемы. При дебаге когда пользователь один, разобрать что происходит ещё можно. Но после запуска в прод в логах сборная солянка из запросов и восстановить трейс вызова композиции методов нельзя
Сделал Laconian - agent skill, построенный вокруг принципа the shortest complete answer. Не самый короткий ответ вообще, а самый короткий из тех, которые остаются корректными и практически полезными.
Логика простая: сначала определить полный ответ, затем удалить только то, без чего не пострадают точность, безопасность, существенные факты, ограничения и требования пользователя.
Skill убирает приветствия, пересказ запроса, незапрошенное описание процесса, повторы и декоративные выводы. При этом сохраняет важные оговорки, неопределённость, нужную детализацию, код, команды, числа, URL и другие данные, точная форма которых имеет значение.
Вся пользовательская часть проекта — один файл SKILL.md. В нём нет скриптов, зависимостей, сетевых вызовов, дополнительных разрешений или привязки к инструментам конкретной платформы.
В репозитории также развивается открытый benchmark: Laconian сравнивается с baseline, обычной инструкцией Answer concisely. и Caveman. Инфраструктура уже работает, но публичных результатов пока нет — поэтому пока не заявляю о выигрыше в длине, качестве или стоимости раньше данных.
Что, если бы на вопрос «почему просел показатель» отвечал не аналитик, а сам BI?
Партнер GlowByte – вендор FanRuan – представляет Dora: платформу, где поиск причины, сверку данных, сборку отчета и рассылку берут на себя ИИ-агенты. Работают они поверх ваших BI-активов – готовых моделей данных, метрик и прав доступа, а не по сырым таблицам.
На вебинаре четыре агента пройдут полный цикл вживую:
🔹 Дата-аналитик: отвечает на запросы к данным и ищет причину.
🔹 Исследователь отчетов: собирает аналитику без участия человека.
🔹 Ассистент по дайджестам: доставляет сводки адресатам по расписанию.
🔹 Офицер по рискам: находит проблему до того, как она станет дорогой.
Также в повестке: разбор прав доступа, безопасность развертывания и интеграций.
Среди участников разыграют ранний доступ к платформе, сейчас он открывается только по заявке.
Главное изменение — MCP стал stateless на уровне протокола. Убрали обязательные initialize, initialized и Mcp-Session-Id. Версия протокола и возможности клиента теперь передаются в каждом запросе, а сведения о сервере можно получить через server/discover. Любой запрос может обработать любой экземпляр сервера — без sticky sessions и общего хранилища сессий. Состояние приложения никто не запрещает: просто передавай явные идентификаторы вроде browser_id в аргументах инструментов.
Что ещё важно:
Долгие операции получили нормальный жизненный цикл. Tasks позволяют вернуть taskId, а затем проверять состояние через tasks/get, передавать дополнительные данные через tasks/update и отменять работу через tasks/cancel. Но Tasks не появились с нуля — раньше это была экспериментальная часть ядра, теперь её переработали и вынесли в официальное расширение.
Протокол стал удобнее для эксплуатации. Заголовки Mcp-Method и Mcp-Name позволяют маршрутизировать запросы, не разбирая JSON. Появились стандартные подсказки для кеширования — ttlMs и cacheScope, а также единые поля для передачи OpenTelemetry Trace Context.
Переработано общение сервера с клиентом. Вместо произвольных server-to-client запросов сервер теперь может вернуть input_required, после чего клиент повторяет исходный запрос с ответом пользователя. Подписки на изменения вынесены в subscriptions/listen.
Extensions стали полноценной частью экосистемы. Новые возможности теперь можно развивать отдельно от ядра. Первые заметные расширения — Tasks и MCP Apps. Последнее позволяет серверу отдавать интерактивный HTML-интерфейс, который клиент показывает в изолированном iframe.
Есть важные ломающие изменения. Все результаты теперь содержат resultType. Roots, Sampling, Logging и старый HTTP+SSE объявлены устаревшими. Схемы инструментов получили полноценную поддержку JSON Schema 2020-12. Если ты пишешь MCP-клиент или SDK, этот пункт может оказаться важнее MCP Apps.
Авторизацию подтянули ближе к реальному OAuth/OIDC. Добавили проверку iss, привязку учётных данных к конкретному issuer и уточнили регистрацию клиентов и работу с refresh-токенами.
В сухом остатке: remote MCP перестал требовать обязательную протокольную сессию и стал гораздо больше похож на нормальный stateless JSON-RPC поверх HTTP. Для продакшена это означает более простое горизонтальное масштабирование, маршрутизацию и кеширование. Остальные изменения полезны, но в основном касаются новых возможностей и миграции клиентов.
Как выглядит миграция с Power BI, когда дашбордов 155, а команда никогда не писала на Python
В новой статье GlowByte разбираем кейс «Дикси»: почему в шорт-листе остались Sigla Vision и Apache Superset, что перевесило в итоге и почему мы не стали переносить всё разом.
Цифры на середину 2026:
✅ 37 дашбордов уже мигрировали
✅ time-to-market со 210 дней до 112
✅ CES вырос с 3,5 до 3,8
Плюс честно про минусы Sigla Vision и четыре вывода для тех, кто только собирается мигрировать.